November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De meeste teams ontdekken op dezelfde manier dat ze een evaluatieplatform nodig hebben: een prompt-wijziging die er in een notebook goed uitzag, verslechtert ongemerkt in productie, een klant maakt een screenshot van een hallucineerd antwoord, en niemand kan zeggen of de nieuwe modelversie daadwerkelijk beter is dan de oude of alleen anders. De vraag "is deze LLM-app goed?" blijkt geen antwoord te hebben totdat je het mechanisme hebt gebouwd om het te meten.
Dat mechanisme is wat LLM-evaluatieplatformen bieden. Maar de categorie is onoverzichtelijk. Sommige tools zijn gericht op evaluatie met tracing erachteraan geplakt. Sommige zijn gericht op observabiliteit met evals erachteraan geplakt. Sommige zijn open-source libraries die je zelf host; sommige zijn beheerde SaaS-oplossingen. En de nieuwste uitdaging zijn agents: het evalueren van een enkele prompt-en-completion is één probleem, het evalueren van een agent van tien stappen die tools aanroept, documenten ophaalt en lussen uitvoert, is een veel groter probleem.
Deze gids doet drie dingen. Het definieert de eval-levenscyclus zodat je weet welke functionaliteiten je daadwerkelijk nodig hebt. Het doorloopt de belangrijkste platformen (Langfuse, Arize Phoenix, Braintrust, LangSmith, Comet Opik, Maxim, Helicone) met specifieke details over waar elk goed en slecht in is. En het legt uit waar een AI-gateway past, omdat de traces en kostengegevens die een gateway genereert de grondstof zijn die de meeste eval-platformen gebruiken.
Wil je traces per verzoek, kosten en inline guardrails naast je evals? Boek een demo.
Evaluatie is geen enkele stap die je uitvoert vóór de lancering. Het is een cyclus met vier fasen, en een serieus platform ondersteunt ze allemaal.
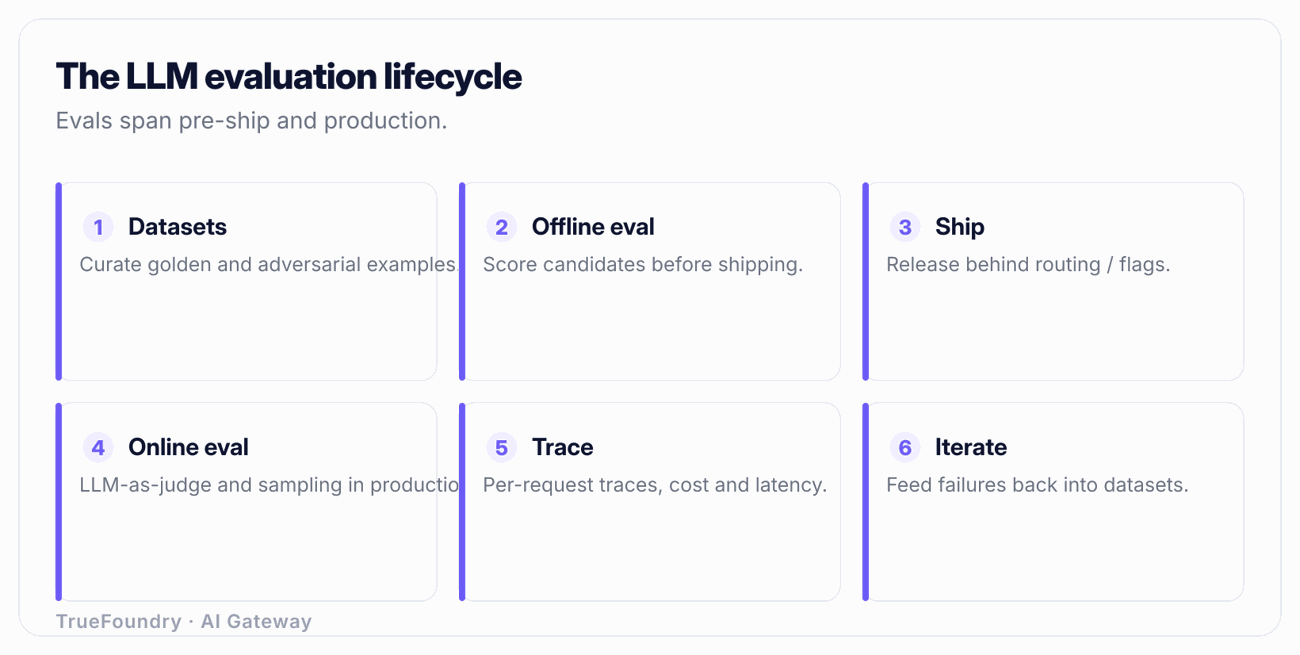
1. Datasets. Alles begint met voorbeelden. Een dataset is een verzameling invoergegevens, optioneel met verwachte uitvoer of referentie-antwoorden, die het werk vertegenwoordigt dat je app doet. De beste datasets zijn niet synthetisch, ze zijn verzameld uit de productie: de echte vragen die gebruikers stelden, vooral de vragen waar het misging. Een volwassen team voegt mislukte of laag-scorende productietraces continu toe aan de dataset, zodat de eval-suite in de loop van de tijd moeilijker wordt in plaats van te blijven steken op het niveau van de lanceringsdag.
2. Offline evaluatie. Voordat je een prompt-, model- of retrieval-wijziging doorvoert, voer je deze uit op de dataset en score je de resultaten. Scoremethoden variëren van deterministisch (exact match, regex, JSON-schema validatie, wordt de SQL uitgevoerd) doeltreffend tot model-beoordeeld (LLM-as-judge voor correctheid, relevantie, toon). Offline eval is je poortwachter vóór de merge: het beantwoordt de vraag "heeft deze wijziging de zaken beter of slechter gemaakt voor gevallen die ik al ken?"
3. Online evaluatie. Offline datasets dekken nooit alles af wat er in productie op je afkomt. Online evaluatie voert scorers uit op live verkeer, meestal op een steekproef, om regressies en nieuwe foutpatronen op te vangen die je dataset heeft gemist. Dit is waar je zaken meet zoals het hallucinatiepercentage in productie, de relevantie van antwoorden en schendingen van guardrails tijdens echte gebruikerssessies.
4. Tracing en observatie. De basis van beide is tracing: het vastleggen van elke stap van een run als gestructureerde spans. Voor een eenvoudige chatbot is dat prompt in, completion uit, plus tokenaantallen en latency. Voor een agent is het een boomstructuur: de planningsstap, elke tool call met de argumenten en het resultaat, elke retrieval met de geretourneerde chunks, elke model-call met de prompt en output. Zonder deze boomstructuur kun je het eindantwoord van een agent wel scoren, maar kun je niet zeggen waarom het fout was: of de retrieval informatie miste, de tool een fout gaf, of het model goede context negeerde.
De cyclus sluit wanneer bevindingen uit fase 3 en 4 terugstromen naar fase 1. Een goed platform maakt dat mogelijk met één klik: zie een slechte productietrace, voeg deze toe aan de dataset en voer er voortaan altijd offline evals op uit.
Evaluatie van agents voegt twee problemen toe. Ten eerste: het traject maakt uit, niet alleen het eindantwoord. Een agent kan een correct antwoord bereiken via een verkeerde route (drie overbodige tool calls, een retrieval die troep opleverde die het model per toeval negeerde) en die kwetsbaarheid zal je later opbreken. Je moet de stappen scoren, niet alleen het resultaat. Ten tweede: non-determinisme stapelt zich op. Een agent van tien stappen waarbij elke stap wat variantie vertoont, levert enorm verschillende runs op met dezelfde invoer. Je hebt dus meerdere runs per case en geaggregeerde scoring nodig, niet één enkele geslaagd-of-mislukt beoordeling.
Voor alles wat open-ended is — samenvattingen, chat-antwoorden, geëxtraheerde velden met een vage correctheid — kun je geen regex schrijven. De praktische scorer is een ander LLM dat gevraagd wordt om de output te beoordelen: LLM-as-judge.
Het werkt, maar met kanttekeningen die teams die hun evals vertrouwen scheiden van teams die voor verrassingen komen te staan:
Elk onderstaand platform biedt LLM-as-judge. De verschillen zitten in hoe eenvoudig ze kalibratie, rubric-definitie en het versiebeheer van de judge maken.
Geen enkel tool is voor iedereen de beste keuze. Hier is een eerlijk overzicht.
Langfuse. Open-source (zelf te hosten of beheerde cloud), en de meest complete OSS-optie. Het combineert tracing, evals, promptbeheer en datasets in één systeem. Sterk voor teams die zelf willen hosten vanwege eisen rondom datalocatie (data-residency) en die observabiliteit plus evaluatie willen zonder drie tools aan elkaar te knopen. Het tracingmodel is flexibel en framework-agnostisch. Als je één open-source platform wilt dat het grootste deel van de levenscyclus dekt, is dit meestal de eerste om te proberen. Zie ons overzicht van LLM-observabiliteitstools voor de positie binnen het bredere observabiliteitslandschap.
Arize Phoenix. Open-source en OpenTelemetry-native, wat het kenmerkende kenmerk is. Phoenix ondersteunt OTel-semantische conventies voor LLM-spans, waardoor traces passen in de infrastructuur die je mogelijk al gebruikt, en je een lock-in met een propriëtair trace-formaat vermijdt. Sterk op het gebied van retrieval en RAG-debugging (inspectie van embeddings en chunks). Als je organisatie gestandaardiseerd is op OpenTelemetry, is Phoenix de logische keuze. Arize verkoopt daarnaast een beheerd enterprise-product boven op de OSS-basis.
Braintrust. Managed, eval-first. De visie hier is evals-as-CI: je integreert evaluatie direct in je ontwikkelcyclus, zodat elke prompt- of codewijziging automatisch op datasets draait, waarbij scores als testresultaten worden vergeleken. Sterke experimenteer-UX om prompt- en modelvarianten zij-aan-zij te vergelijken. Het beste voor teams waarvan het voornaamste pijnpunt is: "we veranderen continu prompts en hebben geen controle op regressie." Minder gericht op zelf hosten en volledige observabiliteit dan Langfuse.
LangSmith. Beheerd, gebouwd door het LangChain-team en diep geïntegreerd met LangChain en LangGraph. Als je stack al LangChain gebruikt, is tracing vrijwel gratis, wordt instrumentatie automatisch meegenomen en zijn de weergaven van agent-trajecten erg sterk. Het nadeel is dat de meest naadloze ervaring uitgaat van het LangChain-ecosysteem; daarbuiten is het nog steeds bruikbaar, maar minder een duidelijke winst.
Comet Opik. Open source, voortgekomen uit de Comet-lijn (ML experiment tracking). Omvat tracing, evals en levert met name guardrail-achtige checks mee naast evaluatie. Een goede keuze voor teams die Comet al gebruiken voor klassieke ML experiment tracking en hun LLM-werk onder hetzelfde dak willen brengen, of die een OSS eval-tool willen met ingebouwde checks van het type moderatie.
Maxim AI. Een eval- en observabiliteitsplatform dat ook Bifrost levert, een open-source AI-gateway. De gecombineerde propositie is "evalueren, observeren en routeren bij één leverancier." Het knelpunt waar kopers tegenaan lopen is dat evals en de gateway in feite gescheiden producten zijn in plaats van één control plane, gateway-prijzen niet openbaar zijn (toegang aanvragen) en het een jongere leverancier is waarvan de benchmarks grotendeels zelf gerapporteerd zijn. Als je specifiek Maxim of de Bifrost-gateway overweegt, weeg dan de diepgang van evals en die van de gateway en governance afzonderlijk af, omdat weinig tools in beide best-in-class zijn.
Helicone. Open source, gericht op observabiliteit en proxy. Het werkt als een lichtgewicht proxy voor je modelaanroepen en legt logs, latency en kosten vast met minimale integratie (pas een base URL aan). Evals zijn aanwezig, maar lichter dan die van een toegewijd eval-platform. Het beste wanneer je prioriteit ligt bij snelle, goedkope observabiliteit met lage instelkosten en je diepgaande evaluatie als secundair beschouwt.
Hier is de vergelijking samengevat:
Bekijk hoe TrueFoundry observabiliteit en governance toevoegt aan je eval-stack. Boek een demo.
Kiezen uit de bovenstaande lijst komt neer op een handvol assen. Beoordeel kandidaten op basis hiervan in plaats van marketing op basis van het aantal functies.
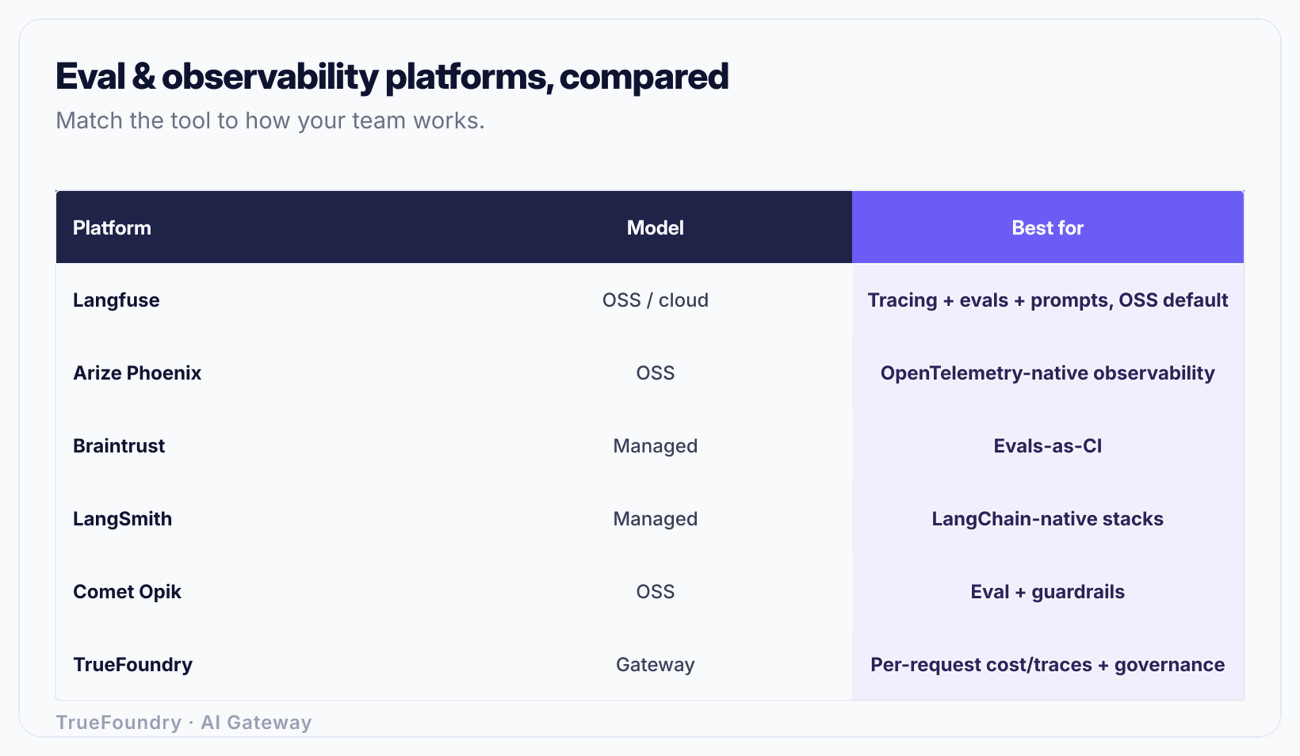
Een concrete manier om het raster te gebruiken: als je harde voorwaarde is "klantgegevens mogen onze VPC niet verlaten", heb je de opties onmiddellijk beperkt tot de self-hostable OSS-opties (Langfuse, Phoenix, Opik) of een enterprise-plan met uitrol binnen de VPC, en vallen de uitsluitend beheerde tools af, ongeacht hoe goed hun UX is. Begin bij je hardee eisen en optimaliseer vervolgens binnen wat overblijft.
Een eval-platform heeft gegevens nodig om te evalueren: traces, prompts, completions, aantallen tokens, latencies en kosten per aanroep. Waar komt dat vandaan? Voor een enkele app instrumenteer je deze rechtstreeks. Binnen een organisatie die tientallen apps en agents draait tegen vele modelproviders, is de schonere bron de laag waar elke aanroep toch al doorheen stroomt: de AI-gateway.
Een gateway zoals TrueFoundry bevindt zich voor al het model- en providerverkeer achter een universele OpenAI-compatibele API. Omdat elke aanvraag er doorheen gaat, levert het observabiliteit per aanvraag: tokens in en uit, latency, het gebruikte model en de provider, en de kosten, allemaal getagd per gebruiker, team en applicatie. Dat is precies de stroom die een eval-platform wil verwerken, en deze is beschikbaar zonder instrumentatie per app, omdat de gateway deze centraal genereert.
De gateway voert ook guardrails inline uit tijdens de aanroep: PII-detectie, checks op prompt-injectie en het scannen op geheimen, wat een andere taak is dan offline evaluatie. Guardrails blokkeren of markeren een slechte aanvraag of respons op het moment dat deze plaatsvindt; evals beoordelen de kwaliteit achteraf op basis van datasets en productie-steekproeven. Je wilt beide. De guardrail stopt de duidelijke schade in het aanvraagpad; het eval-platform vertelt je of de antwoordkwaliteit over de weken heen stijgt of daalt.
De taakverdeling is helder: de gateway is eigenaar van het aanvraagpad (routing, fallback, caching, budgetten, inline guardrails en trace-emissie); het eval-platform is eigenaar van de meetlus (datasets, offline en online scoring, LLM-as-judge, experimentvergelijking). TrueFoundry verzorgt de gateway-zijde en de observabiliteitsfeed; een toegewijd eval-platform uit de bovenstaande lijst verwerkt deze. Voor teams die kosten en governance over vele modellen heen standaardiseren, levert het koppelen van de twee een beter resultaat op dan proberen een van beide tools de taak van de ander te laten uitvoeren. Onze gids voor de beste AI-observabiliteitsplatformen voor LLM's in 2026 gaat dieper in op specifiek het observabiliteitsgedeelte.
LLM-as-judge behandelen als de absolute waarheid. De judge is een model met zijn eigen vooroordelen en foutmodi. Teams die een judge inzetten zonder deze te kalibreren tegen menselijke beoordelingen, eindigen met het optimaliseren van hun app om een verkeerd gecalibreerde beoordelaar te behagen. Dit is erger dan geen eval, omdat het rigoureus voelt terwijl het fout is. Meet altijd eerst de overeenstemming tussen de judge en de mens.
Alleen het eindantwoord van een agent evalueren. Een correct antwoord uit een defect traject is een verborgen bug. Als je de tussenstappen nooit beoordeelt, merk je niet dat je agent het juiste antwoord bereikt via drie verspillende tool-aanroepen en een retrieval die hij heeft genegeerd, totdat een kleine verandering leidt tot een fout en je geen idee hebt waarom.
De dataset bevriezen bij de lancering. Een statische eval-set meet voor altijd de moeilijkheidsgraad van de lanceringsdag, terwijl de productie ondertussen verandert. Zonder een lus die voortdurend mislukte productie-traces terughaalt naar de dataset, verliest je groene eval-dashboard langzaam zijn betekenis.
Een eval-tool kopen voor een probleem dat een guardrail zou moeten oplossen. Als je werkelijke behoefte is "PII en prompt-injectie blokkeren in het aanvraagpad", dan zijn dat inline guardrails bij de gateway, niet een offline eval-suite. Omgekeerd is het uitvoeren van offline datasets om realtime aanvallen op te vangen te traag. Stem de tool af op de vraag of de controle in het aanvraagpad of achteraf plaatsvindt.
Datagovernance negeren tot de inkoopfase. Teams kiezen een beheerde eval-tool op basis van UX en ontdekken vervolgens tijdens de beveiligingsbeoordeling dat productie-prompts met klantgegevens de VPC niet mogen verlaten. Beslis eerst over de vraag OSS-vs-beheerd en de wijze van uitrol; dit elimineert opties sneller dan welke functie dan ook.
Evaluatie is de discipline die "de AI voelt nu beter aan" verandert in een getal dat je kunt verdedigen. De platformen verschillen minder in de vraag óf ze evals uitvoeren (dat doen ze allemaal), maar in hoe ze de volledige levenscyclus afhandelen: datasetcuratie, offline kwaliteitspoorten, online monitoring, het traceren van agent-trajecten en gekalibreerde LLM-as-judge. Begin bij je harde randvoorwaarden (dataresidentie, bestaand framework, OSS vs beheerd), beoordeel de shortlist aan de hand van het selectieraster en sta erop dat de volledige lus wordt ondersteund in plaats van een eenmalige testomgeving.
En onthoud dat evaluatie niet op zichzelf staat. De gateway voor je modellen levert al de traces en kostengegevens die je eval-platform nodig heeft, en het dwingt guardrails af in het request-pad die offline evals niet kunnen bieden. Combineer een sterk eval-platform met een gateway die je schone observability per request en inline controls biedt, en je krijgt zowel het realtime veiligheidsnet als het kwaliteitssignaal voor de lange termijn die een LLM-product betrouwbaar houden.
Combineer je evals met een governed gateway. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



LLM-evaluatie is het meten van de kwaliteit van de uitvoer van een LLM-applicatie, met behulp van samengestelde datasets, scoringfuncties (deterministische controles en door een model beoordeelde LLM-as-judge), en productiemonitoring. Het beantwoordt of een wijziging in prompt, model of retrieval de resultaten daadwerkelijk heeft verbeterd, in plaats van ze alleen te veranderen.
Offline evaluatie draait uw applicatie tegen een vaste dataset voordat deze wordt uitgerold, als een regressiepoort voor merges. Online evaluatie scoort live productieverkeer (meestal een steekproef) om regressies en nieuwe faalscenario's te vangen die de dataset niet dekte. Volwassen teams draaien beide en voeden online fouten terug in offline datasets.
Dat kan, als u het kalibreert tegen menselijke labels, pairwise of rubric-scoring gebruikt in plaats van ruwe numerieke schalen, corrigeert voor positie- en breedsprakigheidsbias, en het judge-model en de prompt vastzet. Onvoorwaardelijk als grondwaarheid behandeld zonder kalibratie, drift het en geeft het vals vertrouwen.
Ja, ze vervullen verschillende functies. De gateway produceert traces per verzoek, kostengegevens en voert inline guardrails uit in het verzoekpad. Het evaluatieplatform gebruikt die traces om de kwaliteit offline en online in de tijd te scoren. De gateway is de databron en real-time controle; het evaluatieplatform is de meetlus.
Langfuse, Arize Phoenix en Comet Opik zijn open source en self-hostable, wat van belang is voor dataresidentie. Braintrust en LangSmith zijn primair managed. Helicone is open source en proxy-georienteerd met lichtere evaluaties. Kies op basis van of u productiedata uw netwerk mag laten verlaten.



Het laatste nieuws, artikelen en bronnen in je inbox