Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
AI Gateway Benchmarks: Latentie en doorvoer vergeleken
Benchmark de overhead, niet de totale verwerkingstijd. Het getal dat er toe doet is de latentie die de gateway toevoegt, afzonderlijk gemeten van de tijd bij de provider. Een goed gebouwde gateway voegt enkele tot een klein aantal tientallen milliseconden toe; de model-call duurt van enkele honderden milliseconden tot meerdere seconden. Het rapporteren van end-to-end-latentie verbergt de enige variabele waar u controle over heeft.
Meet de uitersten, nooit het gemiddelde. p50 vertelt u vrijwel niets. p95 en p99 toegevoegde latentie tonen waar uitputting van de connection pool, lock contention en garbage-collection-pauzes optreden, en zij bepalen of uw agent-loops onder belasting een time-out krijgen.
Een cache-hit maakt de request over het geheel sneller. Exact en semantic caching veranderen een multi-seconden model-call in een antwoord van enkel de gateway binnen een paar milliseconden. Benchmark cache-hit-latentie als een op zichzelf staand scenario; het draait de gebruikelijke angst voor "gateways voegen latentie toe" volledig om.
Runtime en architectuur bepalen het plafond van uw doorvoer. Een Python event loop in één proces, een worker pool gebonden aan de GIL, en een Go- of Rust-proxy vertonen heel verschillend gedrag bij concurrency. U hoeft geen specifieke taal te kiezen, maar u moet testen met realistische concurrency om te ontdekken waar de curve afbuigt.
Gebruik een template, geen marketinggetal van een leverancier. De resultatentabel in dit artikel is een methodologisch template dat u kunt invullen met uw eigen runs tegen uw eigen modellen en regio's. Elk latentiecijfer dat uit een presentatie is overgenomen, is onbetrouwbaar totdat u het formuleert en reprodiceert op uw eigen verkeer.
De meeste teams die een AI gateway evalueren, beginnen vanuit dezelfde angst: "Als ik een proxy voor elke model-call plaats, voeg ik een extra hop toe, en die hop kost latentie." Het is een logisch gevoel en een slechte reden om de gateway over te slaan. De intuïtie klopt niet wat betreft de omvang. Een model-call naar een geavanceerd LLM duurt tussen de 300 milliseconden voor een korte completion tot 20 seconden of meer voor een lange reasoning-respons. Een kundig gebouwde gateway voegt daarbovenop slechts een paar tot een klein aantal tientallen milliseconden aan eigen verwerkingstijd toe. De vraag is nooit "voegt de gateway latentie toe" (dat doet het, in geringe mate), maar "kan ik de overhead nauwkeurig meten, en blijft deze klein bij de uitersten en onder belasting."
Het probleem is dat bijna niemand dit op de juiste manier benchmarkt. Teams voeren een loop uit van 100 requests via de gateway, kijken naar de gemiddelde kloktijd, vergelijken deze met 100 rechtstreekse calls en trekken een conclusie over "prestaties" die voornamelijk wordt bepaald door providervariantie en netwerk-jitter. Het signaal waar ze echt om geven, de eigen bijdrage van de gateway, zit verborgen in seconden aan modeltijd en wordt nooit geïsoleerd.
Dit artikel biedt een leveranciersneutrale methode om een AI gateway correct te benchmarken: welke metrieken van belang zijn, hoe u de gateway-overhead kunt scheiden van de provider-latentie, hoe u test bij de uitersten en onder belasting, hoe u omgaat met streaming en caching, en hoe "goed" eruitziet. Elk numeriek voorbeeld hier is een illustratief template, geen gemeten resultaat. U dient de tabellen te vullen met cijfers uit uw eigen tests.
Wilt u de daadwerkelijke gateway-overhead op uw eigen verkeer meten? Boek een demo.
Wat u daadwerkelijk meet
Een AI gateway bevindt zich in het request-pad tussen uw applicatie en een of meer modelproviders. In het geval van TrueFoundry is het een uniforme, OpenAI-compatibele API die routing, fallback en retries, exact en semantic caching, budgetten en rate limits, guardrails, en observability per request afhandelt. Elk van die functies kost rekenkracht, en rekenkracht kost tijd. Benchmarking is de discipline van het toewijzen van tijd aan de juiste plek.
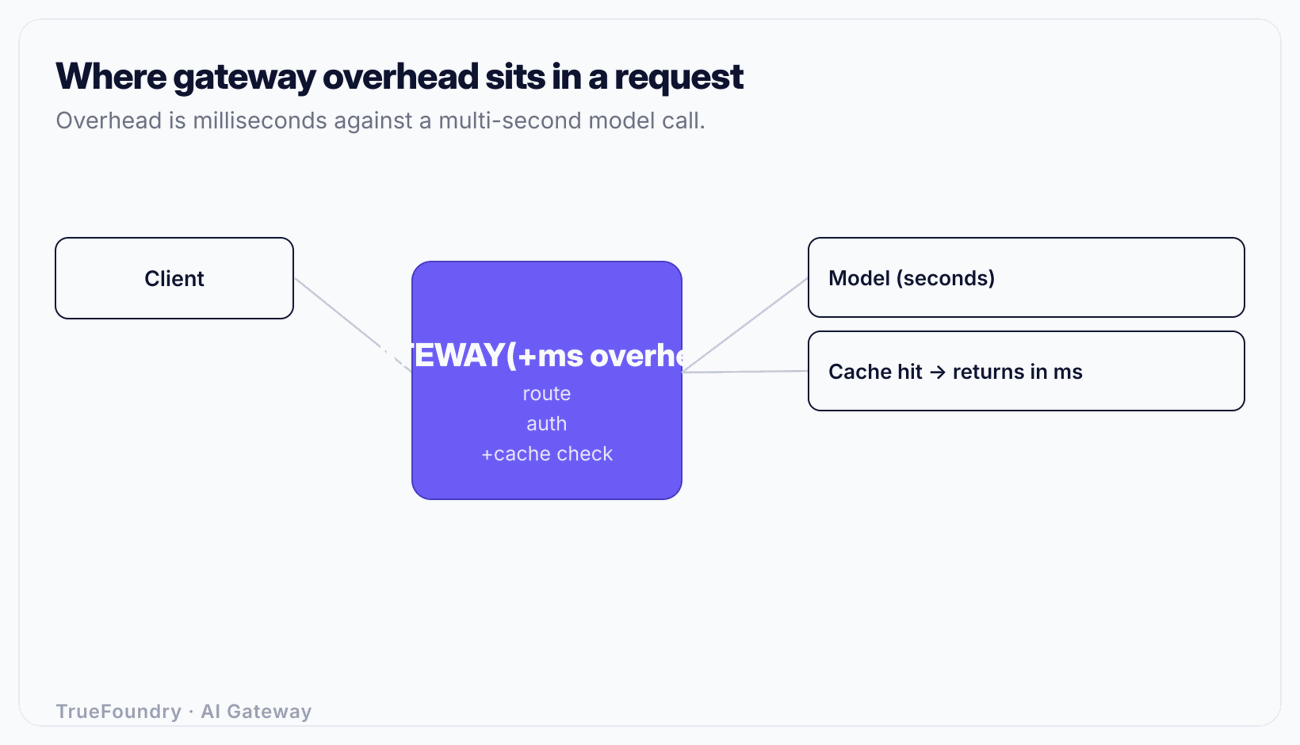
Een enkel niet-streamend request heeft een latentiebudget dat er als volgt uitziet:
Waar gateway-overhead zich bevindt in het latentiebudget van een request: overhead van client naar gateway gemeten in milliseconden, vervolgens de model-call gemeten in seconden, en weer terug; een cache-hit omzeilt het model volledig.
Verdeel de totale kloktijd van één request in vier delen:
Netwerktijd van client naar gateway. De tijd die het request nodig heeft om van uw applicatie naar de gateway te reizen. Als uw app en gateway zich in dezelfde VPC of hetzelfde cluster bevinden, is dit minder dan een milliseconde. Als u een SaaS-gateway vanuit een andere regio aanroept, kan dit al het andere overheersen.
Gateway-overhead. De tijd die de gateway besteedt aan zijn eigen taken: het request parsen, authenticeren, controleren van budgetten en rate limits, een route selecteren, guardrails op het request toepassen en de upstream call serialiseren. Dit is het getal waar u verantwoordelijk voor bent en dat u benchmarkt.
Providertijd. De tijd die het upstream-model besteedt aan het genereren van de respons. Hier heeft u geen controle over. Het varieert per model, promptlengte, uitvoerlengte en de belasting van de provider zelf.
Overhead op het responspad. Guardrails op de respons, het wegschrijven naar de cache, het vastleggen van logging en metrieken, en het opbouwen van de stream op de terugweg.
De belangrijkste metriek bij het benchmarken is toegevoegde latentie: (2) plus (4), geïsoleerd van (1) en (3). Als uw tool alleen de end-to-end-tijd rapporteert, meet u de provider en niet de gateway.
De metrieken die er toe doen
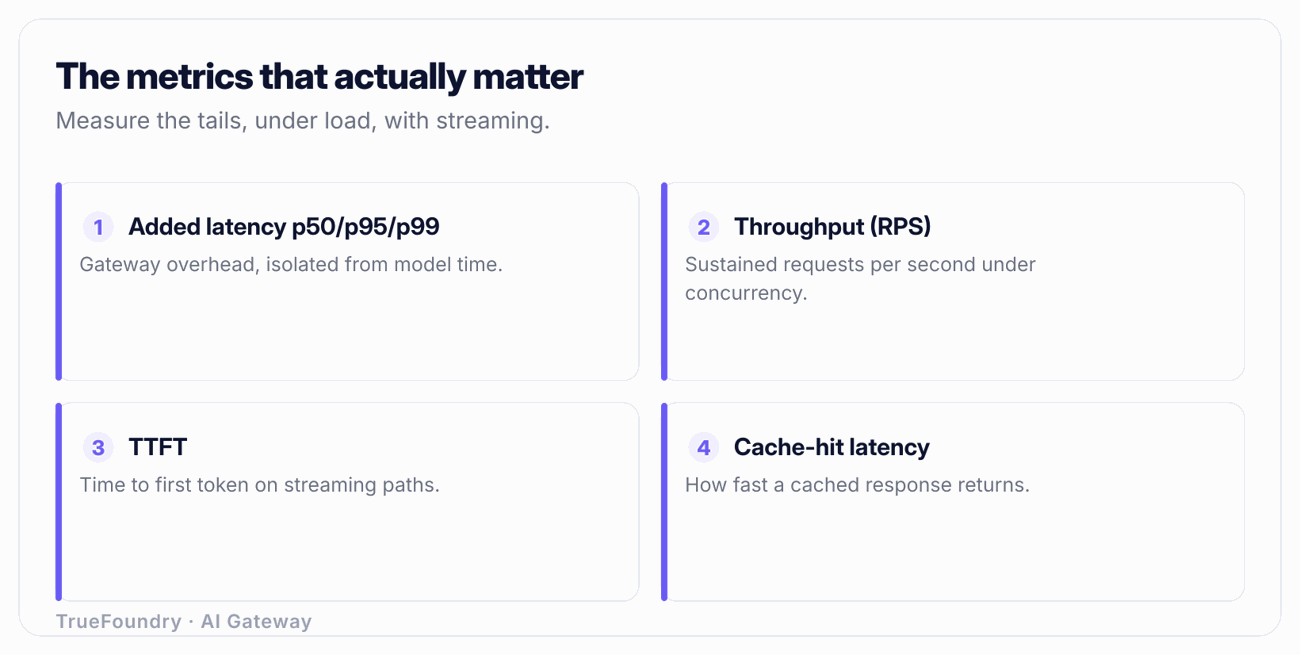
Zes getallen beschrijven de prestaties van een gateway. Leg ze alle zes vast; een enkel gemiddelde is geen benchmark.
De metrieken die er toe doen in één overzicht: p50/p95/p99 toegevoegde latentie, requests per seconde, time to first token voor streaming, en cache-hit-latentie.MetriekWaarom het er toe doetHoe te metenToegevoegde latentie p50De typische overhead die een request kost. Nuttig als ondergrens, misleidend als samenvatting.Trek een baseline van een directe provider-call af van de tijd via de gateway, request voor request, en neem de mediaan. Nog beter: laat de gateway zijn eigen interne verwerkingstijd per request exporteren.Toegevoegde latentie p95 / p99Waar resource-contention, pool-uitputting en GC-pauzes zich voordoen. De uitersten bepalen of retries en agent-loops een time-out krijgen.Zelfde aftreksom, maar rapporteer het 95e en 99e percentiel van de overheadverdeling. Voer voldoende requests uit (10.000+) zodat p99 stabiel is.Doorvoer (RPS)Hoeveel requests per seconde één gateway-instantie verwerkt voordat de overhead oploopt. Bepaalt uw berekening voor horizontaal schalen.Verhoog de concurrency totdat p95 toegevoegde latentie een door u ingestelde drempel overschrijdt (bijvoorbeeld 25 ms). De RPS op dat knikpunt is uw bruikbare doorvoer, niet het absolute maximum.Time to first token (TTFT)Bij streamende responsen is de ervaren latentie de TTFT, niet de totale tijd. Een gateway die de hele respons buffert voordat deze wordt doorgestuurd, vernietigt dit.Meet het interval vanaf het verzenden van het request tot het ontvangen van de eerste gestreamde chunk, zowel via de gateway als direct, en vergelijk deze.Cache-hit-latentieBij een exact of semantic cache-hit wordt het model volledig overgeslagen, waardoor het request sneller is dan een directe call. Dit is een functionaliteit, geen overhead.Vul de cache vooraf en meet vervolgens de latentie voor requests die de cache raken. Rapporteer dit gescheiden van cache-miss-latentie.Overhead onder belastingOverhead bij 5 RPS heeft geen betekenis als deze verdrievoudigt bij 500 RPS. De vorm van de prestatievermindering is het echte signaal.Zet p95 toegevoegde latentie uit tegen de aangeboden concurrency. Een vlakke lijn tot een scherp knikpunt is gezond; een gestaag stijgende lijn betekent dat er al sprake is van resource-contention.De twee metrieken voor de uitersten verdienen extra aandacht. Bij een op agents gebaseerde workload kan een enkele gebruikersactie uitwaaieren naar 10 tot 50 model-calls binnen een reasoning-loop. Als elke call 1 procent kans heeft om op een trage p99-route terecht te komen, raakt een loop van 30 calls dat trage pad ongeveer eenmaal per drie of vier gebruikersacties. De uitersten zijn op de schaal van agents geen zeldzame uitzondering; ze zijn de dagelijkse praktijk.Hoe u gateway-overhead isoleertDe belangrijkste methodologische stap is aftrekken, en de valkuil is dat provider-latentie schommelt, waardoor een eenvoudige aftreksom ruis in de overhead veroorzaakt.Optie A: gepaarde requests. Stuur voor elke testiteratie hetzelfde request rechtstreeks naar de provider én via de gateway, zo snel mogelijk achter elkaar, bij voorkeur om en om. Trek de directe tijd af van de gatewaytijd per paar. Deze paarsgewijze vergelijking corrigeert voor schommelingen in de providerbelasting tijdens de test, omdat beide helften van een paar ongeveer dezelfde provideromstandigheden zien. Verzamel duizenden paren en neem vervolgens de percentielen van het verschil. Dit meet de daadwerkelijke toegevoegde latentie inclusief de upstream call van de gateway, maar blijft gevoelig voor jitter bij de provider tussen de twee helften van het paar.Optie B: interne timing van de gateway. Een goede gateway registreert zijn eigen verwerkingstijd per request: het interval tussen het accepteren van het request en het verzenden van de upstream call, plus de verwerking aan de responszijde. De observability per request van TrueFoundry toont de latentie op deze wijze gesplitst, gelabeld per gebruiker, team en model. Dit geeft u direct de overhead, zonder aftreksommen en zonder ruis van de provider, en dit is het getal waarop u kunt vertrouwen als het beschikbaar is. Valideer het één keer tegenover gepaarde metingen en vertrouw vervolgens op de interne metriek voor continue monitoring.Optie C: mock de provider. Laat de gateway wijzen naar een lokale stub die een vast antwoord teruggeeft met een bekende, constante vertraging (bijvoorbeeld 200 ms). De providertijd is nu een door u gekozen constante, en alles daarboven is gateway-overhead plus netwerk. Dit is de zuiverste manier om de eigen code van de gateway te belasten bij een hoge RPS zonder te betalen voor een echte provider of door rate limits te worden beperkt. Het is het juiste hulpmiddel om het knikpunt in de doorvoer te vinden. Het simuleert geen echt providergedrag, dus gebruik het voor overhead en doorvoer, niet voor end-to-end-realisme.Gebruik alle drie de opties. Optie C vind het plafond van de doorvoer, Optie A valideert de toegevoegde latentie in de praktijk, en Optie B geeft u de waarde die u in productie in de gaten houdt. Voor meer informatie over waar de gateway zich bevindt ten opzichte van uw applicatie en waarom die positie bepalend is voor de latentie, raadpleegt u control plane vs data plane en de bredere context in hoe u een AI gateway kiest.Test met realistische concurrency, meet de uiterstenEen benchmark die wordt uitgevoerd bij een concurrency van 1 laat alleen de ondergrens zien en zegt niets over productie. Echte gateways verwerken honderden of duizenden gelijktijdige actieve requests, en het interessante gedrag is hoe de overhead verslechtert naarmate de concurrency toeneemt.Ontwerp de belastingstest als een stapsgewijze toename. Begin met een lage concurrency, houd dit vast, verhoog de stap, houd vast, en blijf verhogen totdat de p95 toegevoegde latentie uw drempelwaarde overschrijdt. Leg bij elke stap de p50, p95, p99 toegevoegde latentie en de behaalde RPS vast. De uitkomst is een curve, geen enkel datapunt. Drie vormen komen vaak voor:Vlak en daarna een knikpunt. De overhead blijft vlak over een breed concurrency-bereik en stijgt pas steil wanneer een bepaalde resource (connection pool, worker threads, CPU) verzadigd raakt. Dit is het gezonde patroon; het knikpunt geeft de capaciteit per instantie aan en vormt de trigger voor horizontaal schalen.Geleidelijke stijging. De overhead neemt vanaf een lage concurrency gestaag toe. Dit betekent meestal dat er al sprake is van schaarste aan resources, vaak door te klein gedimensioneerde connection pools naar de provider of door synchrone taken op het kritieke verwerkingspad.Klierf (plotselinge val). De overhead blijft eerst vlak, waarna de latentie explodeert en de RPS instort. Dit wijst op het opbouwen van een wachtrij, vaak veroorzaakt door een blokkerende call of uitgeputte file descriptors. Spoor de blokkerende operatie op voordat u naar productie gaat.Twee details bij het genereren van belasting veranderen de cijfers sterker dan menig engineer verwacht. Gebruik ten eerste een open-loop belastingsmodel waarbij requests volgens een vast schema binnenkomen, ongeacht of eerdere requests zijn afgerond. Gebruik geen closed-loop model waarbij een vaste pool van workers wacht op elke respons. Closed-loop testen verbergt het opbouwen van wachtrijen omdat trage antwoorden de aangeboden belasting afremmen, wat een te rooskleurig beeld van de uitersten geeft. Genereer ten tweede belasting vanuit voldoende clientverbindingen, zodat de client zelf niet de bottleneck vormt; een enkele client-process met een kleine connection pool rapporteert "gateway"-latentie die in werkelijkheid wordt veroorzaakt door wachtrijen aan de clientzijde.Streaming verandert de metingBij chat- en agent-workloads worden de meeste antwoorden gestreamd. Streaming draait om welke metriek er echt toe doet: de gebruiker ervaart de time to first token, terwijl de totale tijd vrijwel onbelangrijk is voor de ervaren snelheid.Een correct gebouwde gateway stuurt gestreamde chunks direct door zodra ze binnenkomen, met slechts een kleine, constante overhead per chunk. Een slecht gebouwde gateway buffert de volledige upstream-respons, voert de responsverwerking uit en begint pas daarna te streamen naar de client. Dit verandert een gestreamde respons van 3 seconden in een wachttijd van 3 seconden, gevolgd door het in één keer dumpen van de tekst. De TTFT-benchmark brengt dit direct aan het licht: meet het interval vanaf het versturen van het request tot het ontvangen van de eerste byte van de eerste content-chunk, zowel via de gateway als direct. De TTFT-overhead van de gateway moet dicht bij de niet-streamende overhead liggen (enkele milliseconden) en niet in de honderden milliseconden lopen.Guardrails op antwoorden maken dit complexer. Als u een guardrail op de uitvoer gebruikt die de volledige respons moet inspecteren (zoals bepaalde PII- of beleidscontroles), kunt u de volledige tekst niet tegelijkertijd streamen en scannen zonder een ontwerpkeuze te maken: optimistisch streamen en eventueel intrekken, of bufferen en vertragen. Benchmark beide modi als u uitvoer-guardrails gebruikt en rapporteer de TTFT-kosten van elke modus. Laat een leverancier u geen streaming TTFT voorspiegelen die is gemeten met uitgeschakelde guardrails als u ze in productie wel inschakelt.Ontdek hoe TrueFoundry de toegevoegde latentie binnen enkele milliseconden houdt. Boek een demo.Waarom runtime en architectuur van belang zijnU hoeft een gateway niet te selecteren op basis van de programmeertaal waarin deze is geschreven, maar u moet wel begrijpen hoe taal en architectuur de doorvoercurve beïnvloeden, omdat dit aangeeft waar de kwetsbaarheden liggen.Een gateway die is gebouwd op een single-threaded event loop kan enorm veel gelijktijdige taken afhandelen voor I/O-gebonden werk (zoals wachten op de provider), maar serialiseert alle CPU-gebonden taken op het kritieke verwerkingspad. Als het parsen van requests, het tellen van tokens of regex voor guardrails synchroon wordt uitgevoerd, strijden die stappen om die ene thread. Dit uit zich in een stijgende p99 onder belasting. Een runtime met een global interpreter lock heeft een vergelijkbare beperking: zelfs met een thread pool draaien CPU-gebonden onderdelen binnen één proces niet daadwerkelijk parallel. Hierdoor schaalt u door meer processen uit te voeren, en uw benchmark moet rekening houden met het geheugengebruik per proces en de duplicatie van connection pools. Gecompileerde, multi-threaded runtimes (Go, Rust) parallelliseren CPU-werk over meerdere cores binnen één proces. Dit verschuift het knikpunt in de doorvoer per instantie naar een hoger niveau, wat wel een ander operationeel profiel met zich meebrengt.De praktische conclusie is niet dat "Go beter is dan Python". Het gaat erom dat u identificeert wat er op het kritieke pad draait en dit test onder hoge concurrency. Het tellen van tokens bij een context van 100.000 tokens, het uitvoeren van een classifier voor prompt-injection of het berekenen van een embedding voor de semantic cache zijn allemaal CPU-intensieve taken. Als ze synchroon op het kritieke pad draaien, zullen ze de curve bij de uitersten laten afbuigen. Als ze buiten het kritieke pad of achter een snelle route draaien, gebeurt dat niet. Test met representatieve prompt-groottes en niet met eenvoudige testen van 10 tokens, omdat de contextlengte de CPU-kosten van precies deze stappen bepaalt. De taak van de gateway als LLM proxy is om die verwerkingstijd per request klein en voorspelbaar te houden.Het cache-hit scenario: wanneer de gateway u sneller maaktHet enige scenario dat het hele idee van "gateways voegen latentie toe" omdraait, is caching, en dit is het scenario dat teams het vaakst vergeten te benchmarken.TrueFoundry ondersteunt zowel exact caching (een identiek request retourneert het opgeslagen antwoord) als semantic caching (een request waarvan de embedding binnen een ingestelde drempelwaarde voor cosinus-gelijkvormigheid van een eerder request ligt, retourneert dat antwoord). Bij een hit vindt de model-call nooit plaats. De latentie van het request daalt van de honderden milliseconden tot seconden van het model naar alleen de zoektijd van de gateway zelf: de berekening van de embedding (bij semantic caching) plus het zoeken in de vector-database of sleutel-waarde-store, wat doorgaans slechts enkele tot een klein aantal tientallen milliseconden duurt.Benchmark dit als een afzonderlijk scenario:Cache-miss-latentie. Het eerste request voor een specifieke prompt. Volledige overhead plus de volledige modeltijd.Exact cache-hit-latentie. Herhaal het exact gelijke request. De modeltijd valt weg naar nul; u meet alleen de zoektijd.Semantic cache-hit-latentie. Stuur een geherformuleerde variant die binnen de drempelwaarde valt. U meet de tijd voor de embedding, het zoeken in de vector-database en het terugsturen van het opgeslagen antwoord.Een uitgewerkt voorbeeld, louter ter illustratie: stel dat een directe model-call voor uw workload op p50 gemiddeld 1.200 ms duurt. Een exact cache-hit kan binnen 6 ms reageren, en een semantic hit binnen 22 ms (waarbij de embedding-stap de meeste tijd vraagt). Bij een cache-hit ratio van 40 procent is de gecombineerde p50 ongeveer 0,6 × 1.200 + 0,4 × 15 ≈ 726 ms. Dit betekent een reductie van 40 procent in de typische latentie en een reductie van 40 percent in het tokenverbruik, beide gerealiseerd door de gateway. Wanneer dit wordt gerapporteerd als een end-to-end gemiddelde, is de gateway aanzienlijk sneller dan directe calls. Dit is waarom "de gateway voegt latentie toe" de verkeerde invalshoek is: op gecachte traffic trekt het juist latentie af. Vul uw eigen cijfers in; de opzet blijft hetzelfde, ongeacht de specifieke waarden.Een herbruikbare benchmark-checklistDoorloop deze lijst voordat u vertrouwt op een claim over gateway-latentie, inclusief die van uzelf.De overhead is geïsoleerd van de providertijd (gepaarde requests, interne timing of een gemockte provider) en niet gerapporteerd als totale kloktijd (end-to-end).p50, p95 en p99 toegevoegde latentie zijn allemaal gerapporteerd op basis van ten minste 10.000 requests.De belasting is open-loop gegenereerd vanuit voldoende clientverbindingen, zodat de client niet de bottleneck vormt.Een stapsgewijze verhoging van de concurrency geeft het knikpunt in de doorvoer aan (de RPS waarbij de p95-overhead uw drempelwaarde overschrijdt) in plaats van een enkel getal bij één concurrency-niveau.De prompt-groottes zijn representatief voor de productieomgeving en geen test-strings van 10 tokens.Streaming TTFT is afzonderlijk gemeten, met de guardrails in dezelfde configuratie als in de productieomgeving.Latenties voor cache-miss, exact-hit en semantic-hit zijn gemeten als gescheiden scenario's.Hetzelfde model, dezelfde regio en hetzelfde provider-account zijn gebruikt voor alle vergelijkende runs (anders overheerst de variantie aan de providerzijde de vergelijking).Fallback- en retry-paden zijn getest (forceer een fout bij de primaire provider en meet de toegevoegde latentie van de failover).De resultaten zijn op een tweede dag gereproduceerd; de belasting van de provider varieert, en een enkele run is slechts een momentopname, geen benchmark.Een illustratief sjabloon voor resultatenDe onderstaande tabel is een sjabloon dat u kunt invullen met uw eigen testresultaten. De getallen zijn plaatsvervangers die de verwachte structuur en grootteorde tonen, het zijn geen gemeten resultaten van een specifiek product. Vervang elke cel door de waarden die u zelf heeft gemeten voor uw modellen, regio's en verkeer.Beschouw een afzonderlijke rij als betekenisloos wanneer deze geïsoleerd wordt bekeken. De waarde zit in de vergelijking: cache-hit versus miss, streaming versus niet-streaming, lage belasting versus het knikpunt.Waar teams de mist in gaanZe rapporteren end-to-end-latentie en noemen dat gateway-prestaties. Het model bepaalt grotendeels de totale kloktijd, waardoor de "benchmark" vooral de provider en het netwerk meet. Isoleer de overhead, anders heeft u niets gemeten over de gateway.Ze benchmarken het gemiddelde en gaan op basis daarvan naar productie. p50 ziet er goed uit, maar p99 veroorzaakt time-outs in de agent-loops in productie. Bij het uitwaaieren van opdrachten door agents bepaalt het uiterste van de verdeling de daadwerkelijke ervaring. Rapporteer daarom altijd p95 en p99.Ze testen bij een concurrency van 1. Overhead bij één enkel actief request zegt niets over het gedrag bij 500 gelijktijdige requests. De curve van prestatieverslechtering, en het knikpunt daarin, is waar het om draait. Verhoog de belasting stapsgewijs.Ze vergeten de cache te benchmarken. Caching is de enige functionaliteit die de gateway sneller maakt dan directe calls, en het is het scenario dat het vaakst wordt overgeslagen. Meet de hit-latentie en de gecombineerde latentie op basis van uw werkelijke hit-ratio, anders onderschat u de waarde van de gateway met de gehele winst die caching oplevert.Ze vertrouwen op getallen van een leverancier zonder deze te reproduceren. Een latentiecijfer in een presentatie is gemeten op het model, de regio, de prompt-grootte en de guardrail-configuratie van iemand anders. Totdat u het reproduceert op uw eigen verkeer, is het slechts marketing. Doorloop de checklist zelf.ConclusieDe angst dat een AI gateway onaanvaardbare latentie toevoegt, blijft bestaan omdat teams de verkeerde zaken meten. De totale kloktijd (end-to-end) wordt gedomineerd door het model en vertelt u vrijwel niets over de gateway. Isoleer de overhead, rapporteer deze bij de uitersten en het beeld draait om: een kundig gebouwde gateway voegt slechts enkele milliseconden toe aan een request dat toch al seconden duurt. Bij gecacht verkeer maakt de gateway het request aanzienlijk sneller, terwijl het tokenverbruik daalt.Benchmark het zelf. Gebruik de checklist, vul het sjabloon in met uw eigen testruns, verhoog de concurrency om het knikpunt te vinden en meet p99- en cache-hit-latentie als primaire metrieken in plaats van als bijzaak. Een gateway die deze test doorstaat, biedt u routing, fallback, caching, budgetbeheer, guardrails en observability per request voor een latentie die verwaarloosbaar is ten opzichte van het model. De enige manier om dat te bewijzen, is door het te meten op uw eigen verkeer.Benchmark een gateway die sneller wordt wanneer caching is ingeschakeld. Boek een demo.
Scenario
p50 toegevoegde latentie
p95 toegevoegde latentie
p99 toegevoegde latentie
RPS op knikpunt
Opmerkingen
Niet-streamend, enkele provider, lage belasting
invullen (bijv. ~4 ms)
invullen (bijv. ~9 ms)
invullen (bijv. ~18 ms)
invullen
Baseline overhead; isoleer van modeltijd
Niet-streamend, op beoogde concurrency
invullen
invullen
invullen
invullen (knikpunt RPS)
Verhoog belasting tot p95 uw drempel overschrijdt
Streaming, TTFT-overhead
invullen
invullen
invullen
invullen
Meet tot eerste content-chunk, guardrails zoals in prod
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting
Een goed gebouwde gateway voegt enkele tot ruim tien milliseconden eigen verwerking toe per verzoek, tegenover modelaanroepen die honderden milliseconden tot enkele seconden duren. De overhead is reêl maar klein ten opzichte van de modeltijd, en bij gecachete verzoeken is de gateway sneller dan een directe aanroep omdat het model volledig wordt overgeslagen. Het enige betrouwbare cijfer is er één die u zelf meet, los van de tijd van de provider.
Wat is 'gateway-overhead' en hoe meet ik dit?
Gateway-overhead is de tijd die de gateway besteedt aan zijn eigen werk (authenticatie, routering, budget- en rate-limit-controles, guardrails, serialisatie, logging), los van netwerktransport en modelgeneratie. Meet dit via gepaarde verzoeken (dezelfde aanroep direct en via de gateway, verschil per paar aftrekken), via de eigen interne timing per verzoek van de gateway, of door de gateway naar een mock-provider met een vaste vertraging te sturen, zodat alles boven die vertraging overhead is.
Waarom zou ik p99 moeten meten in plaats van de gemiddelde latentie?
Agentic workloads vertakken één gebruikersactie naar veel modelaanroepen, waardoor een zeldzaam traag pad op p99 binnen een lus regelmatig wordt geraakt. Een lus van 30 aanroepen met een traag pad van 1 op 100 raakt dit ongeveer eens per drie acties. Het gemiddelde verbergt dit; p95 en p99 laten zien of uw retries en lussen onder belasting zullen timeouten.
Maakt semantisch cachen verzoeken trager door de embedding-stap?
Bij een cache-treffer is semantisch cachen nog steeds veel sneller dan een modelaanroep. U betaalt de embedding-berekening plus een vector-opzoeking, doorgaans enkele tientallen milliseconden, in plaats van de honderden milliseconden tot seconden van het model. Bij een misser betaalt u de embedding-kosten bovenop het normale pad, dus benchmark zowel de latentie bij treffers als bij missers en weeg ze volgens uw werkelijke trefferpercentage.
Hoe benchmark ik streaming-responses?
Meet de time to first token, het interval tussen het versturen van het verzoek en het ontvangen van de eerste content-chunk, zowel via de gateway als rechtstreeks. Een gateway die chunks doorstuurt zodra ze binnenkomen, voegt slechts enkele milliseconden toe aan de TTFT; een gateway die de volledige respons buffert voordat deze wordt doorgestuurd, verpest de ervaren latentie. Test met dezelfde guardrail-configuratie die u in productie zult draaien, aangezien output-guardrails die de volledige respons inspecteren, buffering kunnen afdwingen.