



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Un guardrail n'est pas un simple interrupteur de sécurité. Son hook, son mode d'opération, sa stratégie d'application, sa portée, son comportement en cas de défaillance et ses preuves déterminent ce que le système garantit réellement.
Cadrage de la source. Ce guide explicatif est basé sur la documentation de TrueFoundry « AI Gateway Guardrails Overview » et « Configure Guardrail Policies » telle que révisée le 19 septembre 2026. Il reflète les hooks documentés LLM input/output et MCP pre/post ; les modes validate et mutate ; trois stratégies d'application ; l'union des politiques correspondantes ; la validation asynchrone des entrées LLM ; les vérifications synchrones des mutations, des sorties et de MCP ; la limitation du streaming pour les guardrails de sortie LLM ; et les spans de trace. Les modèles de menace, les étapes de déploiement et les modèles d'autorisation des applications sont des pratiques d'ingénierie recommandées.
Dire « Nous avons un détecteur de PII » révèle peu de choses sur le comportement du système. Où s'exécute-t-il ? Voit-il le prompt avant le modèle, la réponse complétée, les arguments de l'outil ou les résultats de l'outil ? Peut-il réécrire les données, les bloquer uniquement, ou simplement les enregistrer ? Que se passe-t-il si le détecteur subit un timeout ? Le streaming libère-t-il du contenu avant qu'une réponse complète n'existe ?
La TrueFoundry AI Gateway expose quatre hooks de guardrail : LLM Input, LLM Output, MCP Tool Pre-Invoke et MCP Tool Post-Invoke. Cette topologie constitue la fondation. Une mutation en entrée peut caviarder les données avant leur exposition au modèle. Une vérification en sortie peut retenir une réponse complétée. Une vérification pré-outil peut arrêter une opération avant son exécution. Une vérification post-outil peut empêcher un résultat sensible d'atteindre le modèle, mais ne peut pas annuler un effet secondaire que l'outil a déjà exécuté.
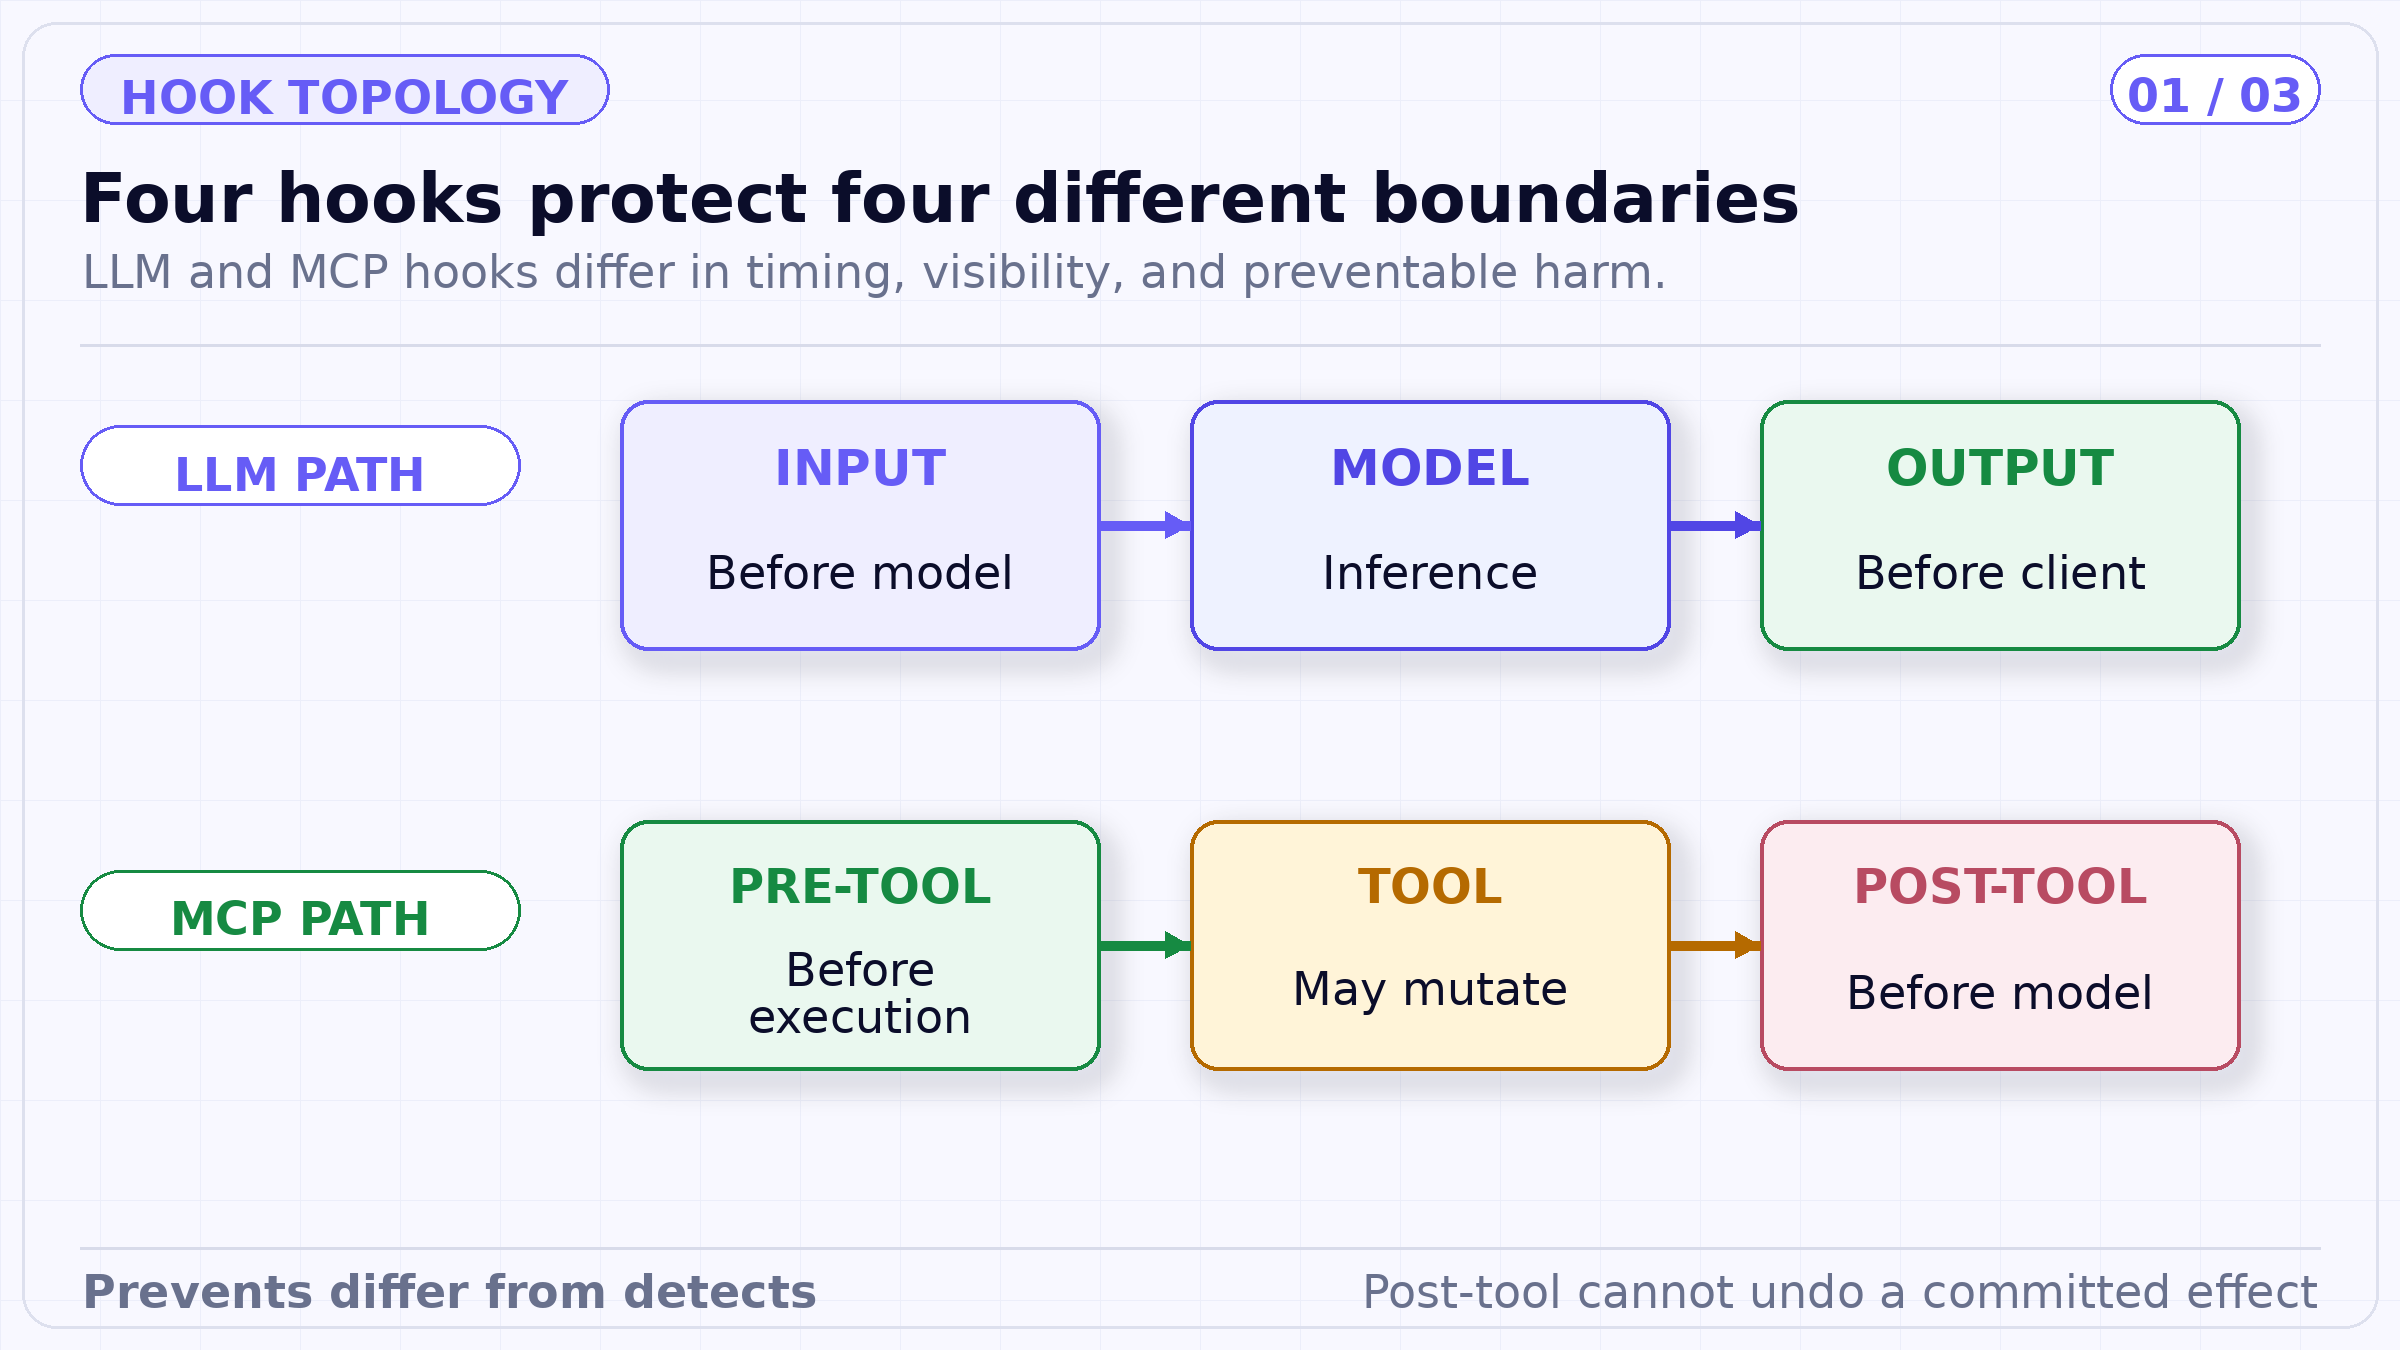
Le diagramme des hooks met l'accent sur la portée temporelle. Un contrôle placé après une opération peut régir la divulgation de son résultat mais ne peut pas empêcher rétrospectivement l'opération elle-même.
En mode Validate, un guardrail inspecte les données et peut les bloquer sans les réécrire. En mode Mutate, il peut transformer les données et peut également les bloquer. Les guardrails de mutation s'exécutent de manière séquentielle par priorité car la sortie de l'un devient l'entrée du suivant.
L'ordre importe donc. Une étape de caviardage peut supprimer des preuves dont un détecteur ultérieur a besoin, tandis qu'une étape de normalisation peut rendre une politique ultérieure plus fiable. Versionnez et testez l'ensemble de la chaîne ordonnée. N'interprétez pas « tous les guardrails ont réussi » sans savoir quelle représentation chacun a évaluée.
Pour les appels MCP, la mutation ou la validation pré-outil voit les arguments avant l'opération. Les contrôles post-outil voient le résultat après l'exécution. Si un outil SQL a déjà modifié une base de données, bloquer sa réponse protège le contexte en aval mais pas la base de données. La sécurité des effets secondaires nécessite une autorisation, des contrats d'outils contraints, l'idempotence et une réconciliation en plus des guardrails de contenu.
TrueFoundry documente trois stratégies. Enforce bloque en cas de violation et bloque également lorsque le guardrail lui-même rencontre une erreur. Enforce But Ignore On Error bloque les violations détectées mais laisse passer le trafic si le guardrail échoue. Audit laisse passer le trafic et enregistre à la fois les résultats et les erreurs de guardrail.
Ces choix doivent être faits par hook et par risque, et non comme une préférence organisationnelle universelle. Une vérification stricte d'autorisation pré-outil pour une opération de production destructrice peut nécessiter un comportement d'échec fermé (fail-closed). Un scoreur de pertinence auxiliaire sur un assistant interne à faible risque peut être autorisé à se dégrader. La décision doit désigner le préjudice d'un faux négatif, le préjudice d'un faux positif, la fiabilité du détecteur et la solution de repli disponible.
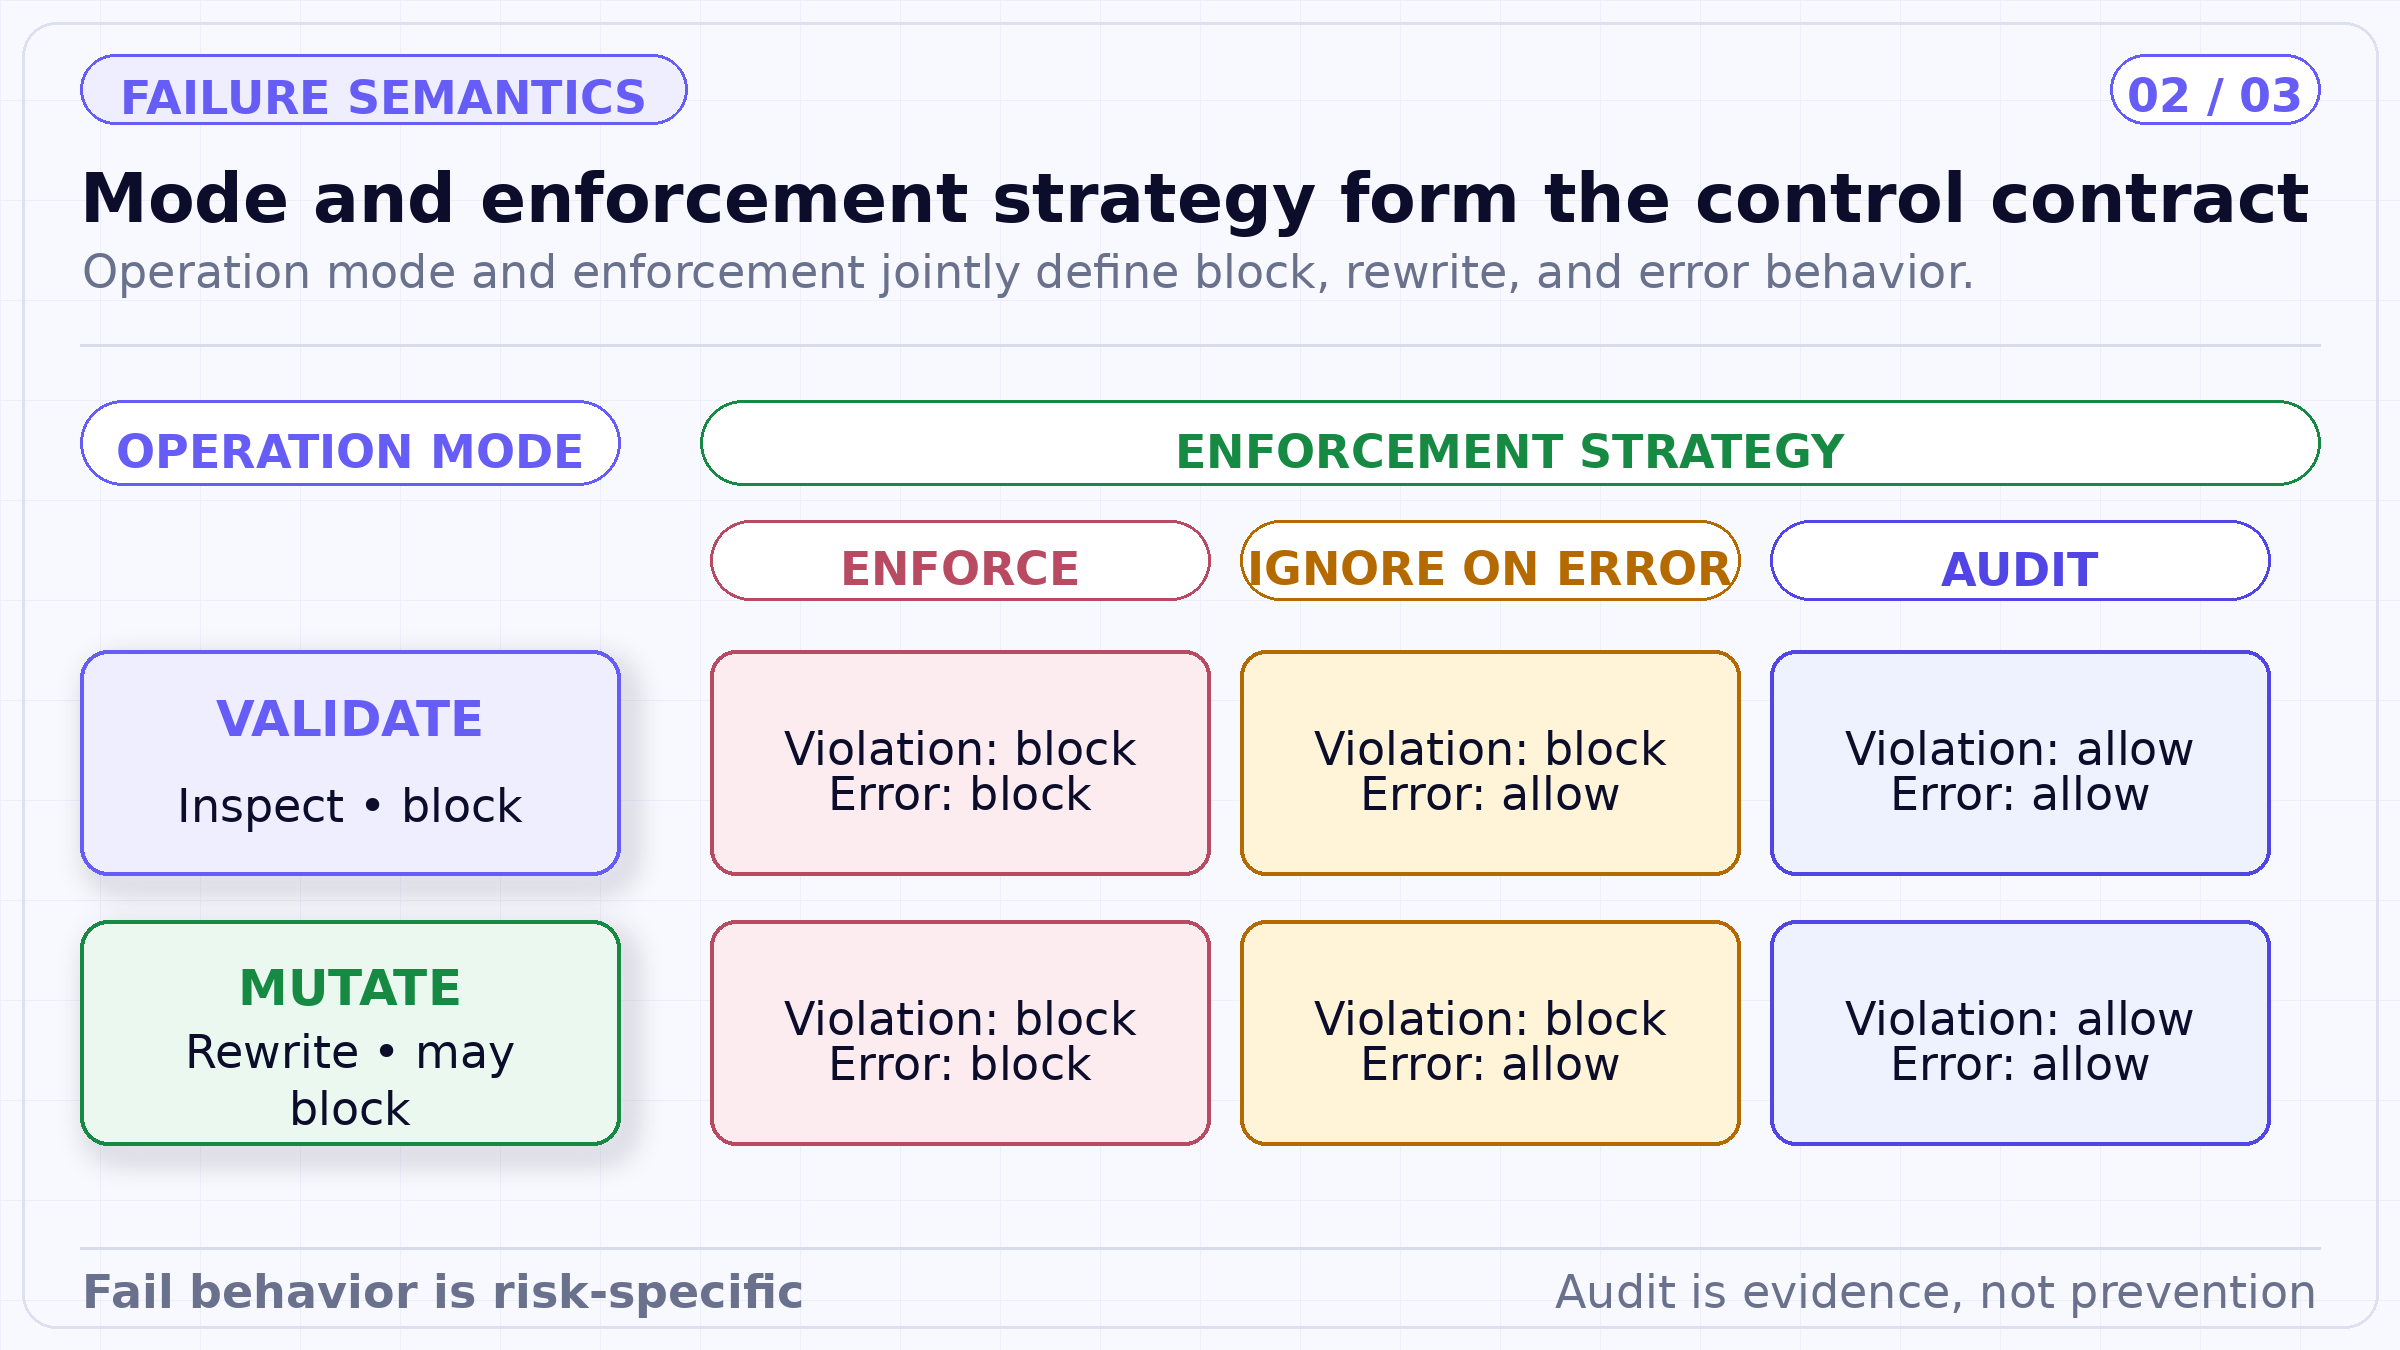
Le mode d'opération et la stratégie d'application sont orthogonaux. Les équipes ont besoin des deux axes pour savoir si les données sont réécrites, bloquées, autorisées en cas d'erreur ou seulement observées.
TrueFoundry documente la mutation d'entrée comme étant synchrone avant la requête au modèle. La validation d'entrée peut s'exécuter en parallèle avec l'appel au modèle. Si la validation échoue pendant que le modèle s'exécute, la gateway annule cette requête. La mutation et la validation de sortie se produisent après la réponse du modèle, leur latence est donc sur le chemin de retour et le coût du modèle a déjà été engagé.
Les guardrails MCP pré- et post-outil s'exécutent de manière synchrone. La latence pré-outil retarde l'exécution mais peut éviter le coût et l'effet secondaire d'un mauvais appel. La latence post-outil retarde la livraison du résultat et peut le caviarder ou le retenir, mais l'invocation de l'outil a déjà eu lieu.
La documentation actuelle de TrueFoundry indique que les guardrails de sortie LLM sont ignorés pour les réponses en streaming car la gateway ne dispose pas d'une réponse complète à évaluer avant la livraison des fragments (chunks). Les guardrails d'entrée s'appliquent toujours. Si un cas d'usage nécessite des vérifications de sortie côté gateway, la requête doit être non-streamée.
Il s'agit d'une décision d'architecture majeure, et non d'une simple note de bas de page. Un client qui assemble une sortie streamée et la valide ensuite peut détecter un problème, mais il ne peut pas rétracter le contenu déjà affiché ou traité. Les applications doivent choisir entre la livraison immédiate des tokens et l'application d'un contrôle sur la réponse complète, ou concevoir un buffer intermédiaire qui retarde la libération.
Pour les messages LLM, TrueFoundry documente un contrôle de portée (scope) couvrant l'intégralité de la conversation, le dernier message ou les N derniers messages. Une fenêtre étroite réduit les coûts et l'exposition mais peut manquer des attaques réparties sur plusieurs tours. Une vérification de l'historique complet peut être coûteuse et peut envoyer davantage de contenu sensible à un fournisseur externe de guardrails.
Les prompts système sont exclus des guardrails par défaut dans la documentation actuelle, avec une exception nommée pour l'analyse CrowdStrike AIDR. Les vérifications MCP pré/post analysent l'intégralité des arguments ou des résultats des outils plutôt que d'utiliser la portée des messages LLM. Les équipes doivent documenter explicitement ces limites de visibilité afin que « la conversation est sécurisée » ne signifie pas que chaque instruction et chaque champ ont été inspectés.
Les guardrails peuvent être rattachés par requête via un en-tête ou via des politiques de gateway. Les politiques correspondent aux modèles, aux serveurs et outils MCP, aux utilisateurs, aux équipes, aux comptes virtuels et aux métadonnées de requête. TrueFoundry documente que toutes les règles sont évaluées ; les guardrails de chaque règle correspondante sont combinés par hook.
Ce modèle d'union est additif. Une ligne de base globale peut appliquer la détection de PII tandis qu'une règle de métadonnées de production ajoute un détecteur d'injection plus strict et qu'une règle d'outil MCP spécifique ajoute une politique SQL. Les conditions d'objectif ou de sujet omises s'appliquent de manière large, de sorte qu'une règle incomplète par accident peut s'appliquer plus largement que prévu.
Les en-têtes de guardrail par requête contournent les politiques, selon la documentation de configuration. Contrôlez qui peut envoyer ces en-têtes et si les guardrails choisis par l'application sont acceptables pour la charge de travail. Une requête ne doit pas pouvoir sélectionner une politique plus faible simplement parce qu'elle connaît le nom d'une intégration.
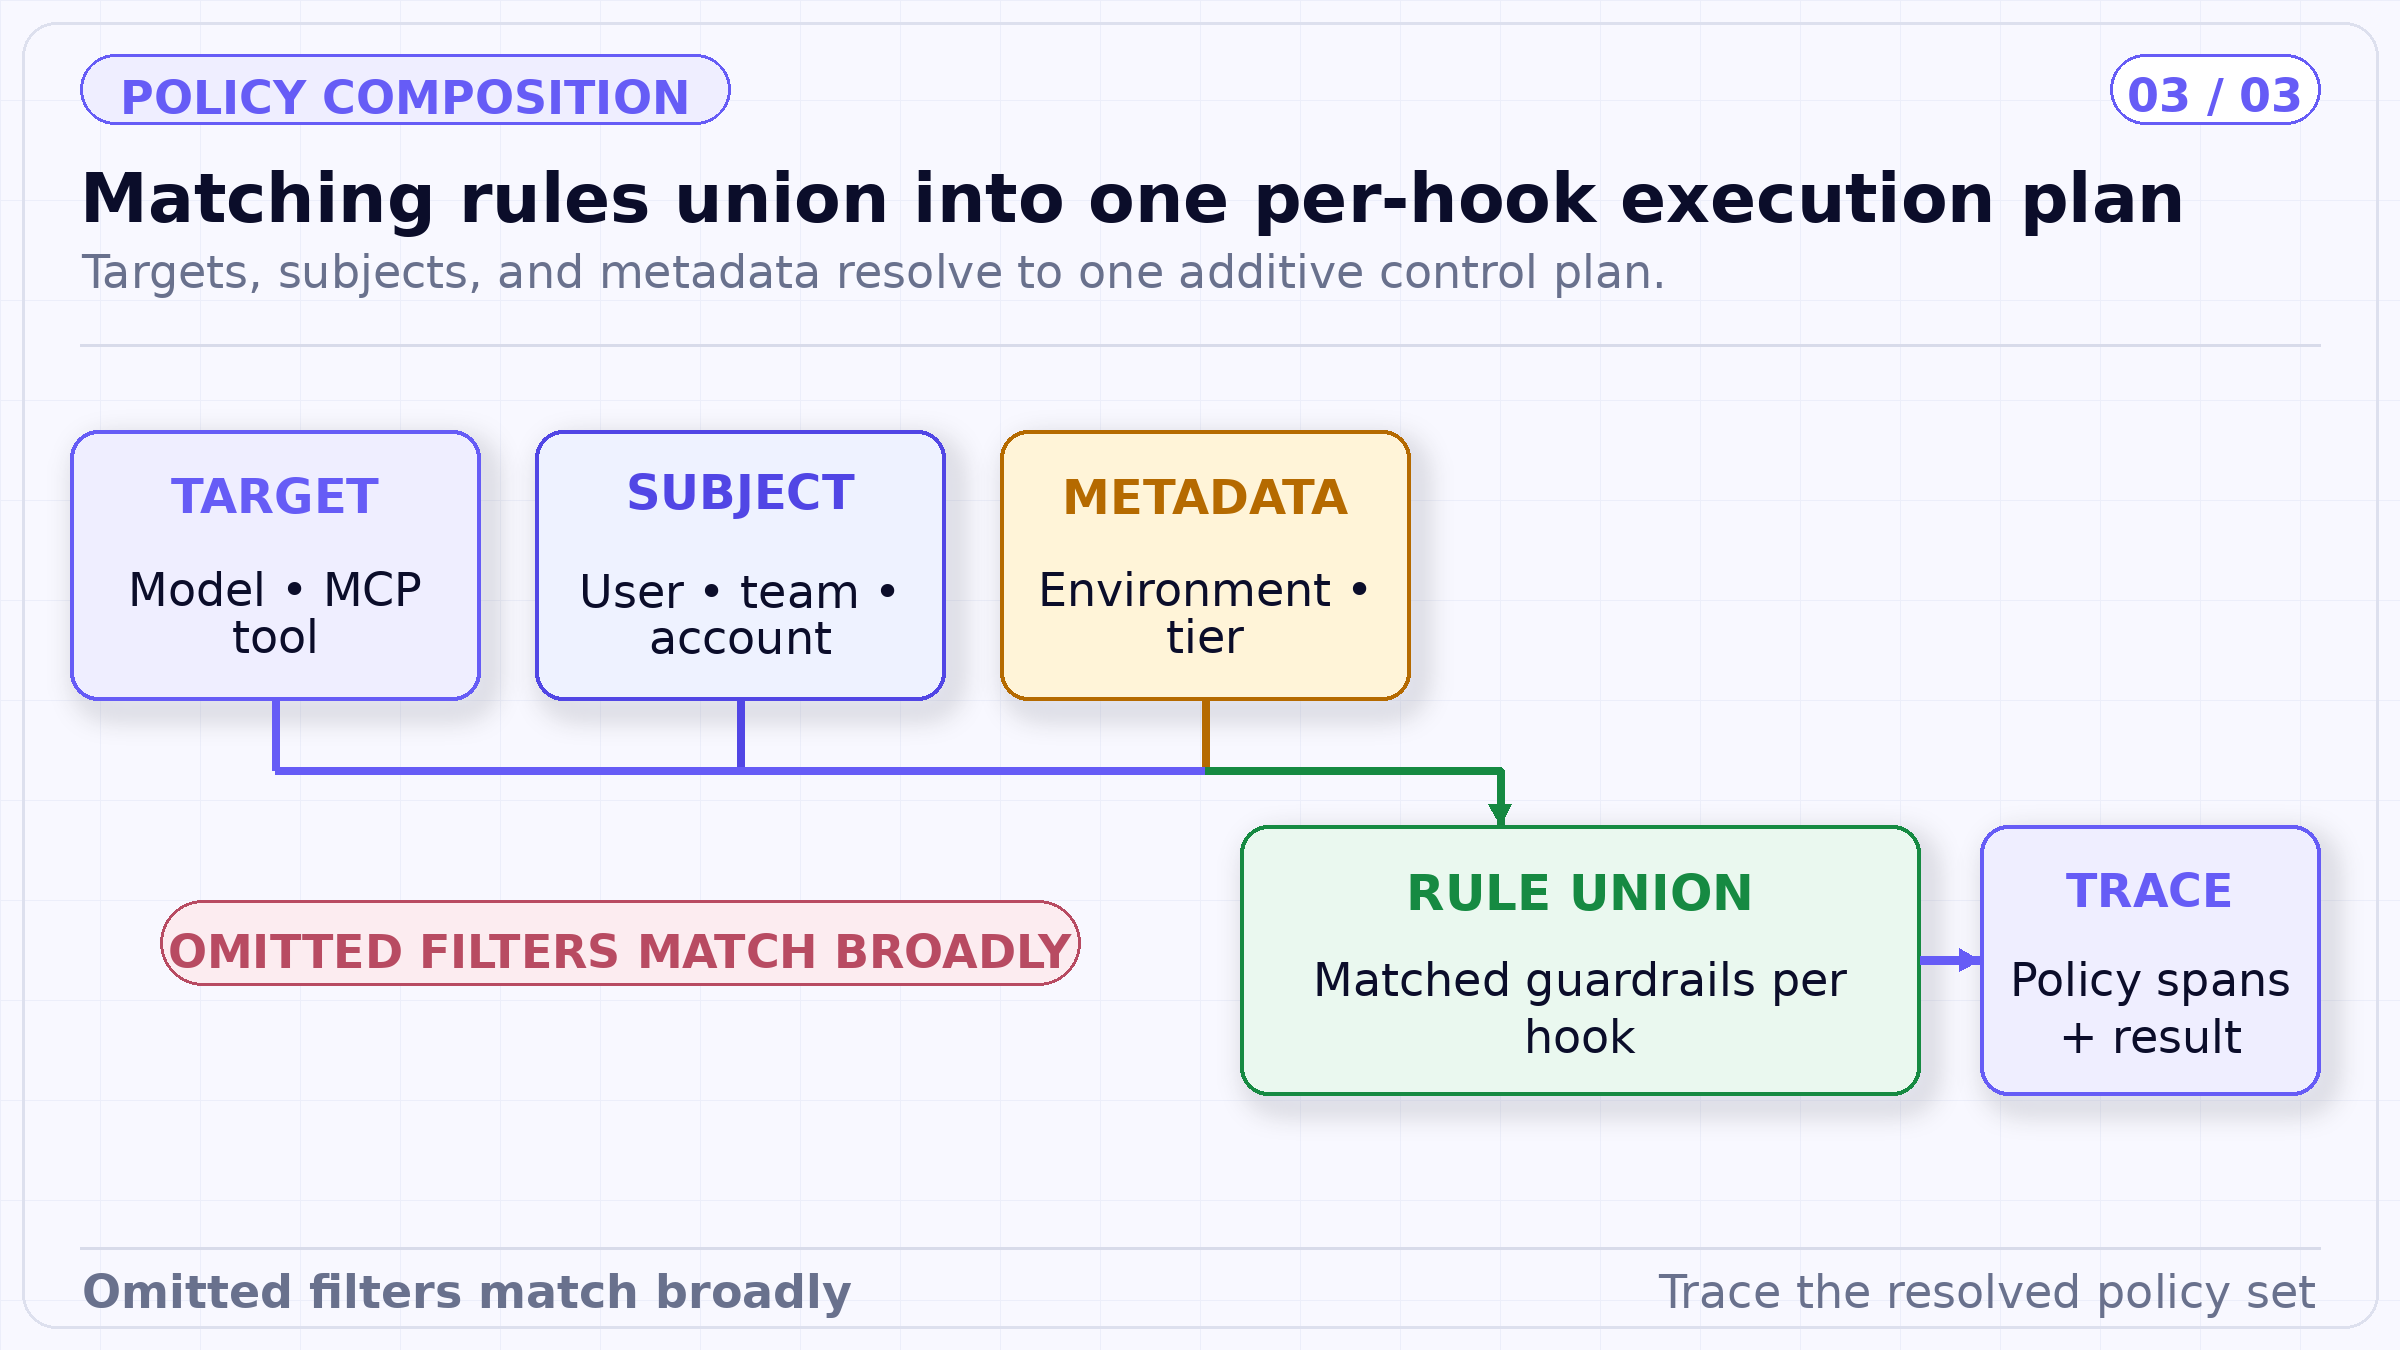
Les règles de politique se composent de manière additive. Le contrôle effectif est l'union résolue pour ce sujet, cette cible, cet outil, ces métadonnées et ce hook — et non une règle unique prise de manière isolée.
TrueFoundry enregistre l'exécution des guardrails sous forme de spans dans les traces de requête, y compris la chronologie et les résultats. Les requêtes bloquées sont également tracées. Cela rend la latence, les détections, les mutations et les résultats d'application inspectables.
Un span prouve qu'un guardrail configuré s'est exécuté et a renvoyé un résultat dans le cadre d'une configuration versionnée. Il ne prouve pas que le détecteur avait une couverture parfaite ou que l'action métier finale était sécurisée. Conservez la version du détecteur, la version de la politique, le hook, la portée, le condensat (digest) d'entrée, le condensat de mutation, le résultat d'application, l'erreur et la latence. Associez ces enregistrements aux tentatives d'outils et aux résultats faisant autorité.
Certains guardrails s'exécutent sur l'infrastructure gérée par TrueFoundry ; d'autres font appel à des fournisseurs externes ou à des services personnalisés. Le hook sélectionné et la portée du message déterminent quelles données ce processeur peut recevoir. Avant d'activer un fournisseur, documentez les champs, les régions, la rétention, le chiffrement, les sous-traitants, les identifiants, le comportement en cas de timeout et si le service utilise les entrées pour l'entraînement.
Minimisez les données avant qu'elles ne quittent la gateway lorsque cela est possible. Une étape de mutation locale peut supprimer des secrets avant qu'un classifieur externe plus large ne s'exécute, mais l'ordonnancement doit être testé afin que le caviardage ne détruise pas le signal nécessaire à la détection. Conservez la sélection du fournisseur adaptée à l'environnement : la documentation de TrueFoundry marque plusieurs éléments intégrés gérés comme étant exclusivement SaaS et oriente les déploiements auto-hébergés vers des alternatives.
Une requête peut correspondre à plusieurs règles de politique, et chaque règle peut attacher plusieurs guardrails sur plusieurs hooks. Le plan effectif est donc un ensemble résolu, et pas seulement un nom de politique. Enregistrez les identifiants de règles, la version de la politique, les versions des intégrations, les priorités, les stratégies d'application, la portée et le comportement d'erreur personnalisé qui se sont appliqués à la requête.
Promouvez les modifications de guardrails comme des versions logicielles. Testez un plan candidat en analyse d'audit ou en analyse shadow, comparez-le au plan actuel sur des entrées représentatives capturées, examinez les faux positifs et les faux négatifs, puis déployez-le sur un trafic délimité. Un rollback doit restaurer la configuration résolue complète, y compris l'ordre et la sémantique des défaillances.
Comptabilisez les requêtes évaluées, les hooks ignorés, les erreurs de guardrails, les timeouts, les violations, les mutations, les blocages, les annulations et la latence par version d'intégration et de politique. Rapportez les taux sur le trafic éligible plutôt que sur des nombres bruts de blocages. Un détecteur affichant zéro résultat n'est en bonne santé que s'il a réellement s'est exécuté sur la portée prévue.
Pour les contrôles MCP, associez les blocages pré-outil aux tentatives d'appels d'outils et les résultats post-outil aux résultats d'outils. Pour les contrôles LLM, distinguez les annulations d'entrée, les rejets de sortie et les réponses en streaming où les vérifications de sortie ont été ignorées. Échantillonnez le trafic autorisé pour un examen humain afin que les faux négatifs silencieux aient une chance de devenir visibles.
Le mode Audit est utile pour le calibrage car il montre les détections potentielles sans bloquer. Avant la promotion, étiquetez le trafic échantillonné, mesurez les faux positifs et les faux négatifs, testez les timeouts des fournisseurs et estimez la latence et le coût. Passez à une stratégie d'application uniquement après que l'organisation a choisi le comportement en cas d'échec et qu'un opérateur peut interpréter les preuves.
Ne supposez pas qu'un taux de blocage en baisse signifie que le système s'est amélioré. Cela peut aussi signifier qu'un détecteur a cessé d'exister, que la portée s'est restreinte, que le trafic a changé ou que les utilisateurs ont appris à contourner le contrôle. Surveillez la couverture et les taux d'erreur aux côtés des violations.
Le contrat réel d'un guardrail est la combinaison du hook, de la visibilité, du mode, de l'ordre, de la stratégie d'application, de la correspondance de politique et du comportement en cas de défaillance. Nommer uniquement le détecteur laisse la majeure partie du système non spécifiée.
TrueFoundry AI Gateway rend ces décisions explicites pour le trafic du modèle et de MCP et enregistre leur exécution dans les traces. L'application reste propriétaire de l'autorisation métier, de la justesse des effets secondaires et des preuves de résultat. Cette frontière n'est pas une faiblesse ; c'est ce qui empêche de confondre l'inspection du contenu avec la sécurité complète de l'agent.
Divulgation éditoriale. Cet article reflète l'interprétation technique par TrueFoundry des documents publics cités en date du 19 septembre 2026. Les capacités des produits sont limitées à la documentation liée. Les exemples et les paramètres par défaut opérationnels sont illustratifs ; ils ne constituent pas un conseil juridique, un avis d'audit, un benchmark indépendant ou une garantie de sécurité, de sûreté ou de conformité.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















