


novembre 18, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les passrelles (gateways) deviennent le plan de contrôle opérationnel des systèmes de GenAI. Elles unifient le trafic pour les API tierces (OpenAI, Anthropic, Mistral, Bedrock) et les modèles auto-hébergés, appliquent les politiques de sécurité et offrent une vue unifiée pour la latence, les erreurs, la consommation de jetons et les dépenses. Ce point de passage stratégique est l'endroit idéal pour capturer les traces, calculer des analyses au niveau du modèle et de l'utilisateur, et déclencher des garde-fous et des alertes, sans ajouter de latence au parcours de la requête.
De nombreuses entreprises l'ont appris à leurs dépens. Prenons l'exemple d'un copilot de support utilisé par des milliers d'agents. Un après-midi, une mise à jour de prompt anodine augmente la longueur de la réponse d'environ 40 %. La satisfaction des agents chute en raison des délais de réponse ; l'équipe financière s'en aperçoit lors de la réception de la facture. Avec l'observabilité de la passerelle, vous verriez la latence p95 et les jetons de sortie augmenter pour la route concernée, vous feriez le lien avec le déploiement ou la version du prompt, et vous effectueriez un retour en arrière (rollback)—idéalement avec une alerte automatisée configurée pour éviter que cela ne se reproduise.
Cet article récapitule ce qu'est une AI Gateway, pourquoi l'observabilité est critique, et les métriques, tableaux de bord et workflows concrets que les équipes devraient mettre en place. Nous montrerons également comment l'AI Gateway de TrueFoundry intègre la pile d'observabilité de manière native : analyses unifiées (latence, TTFT/ITL, erreurs), suivi granulaire des coûts, ventilations par client/utilisateur, visibilité sur le routage des requêtes réussies/échouées, et collecte évolutive à faible surcharge intégrée à l'architecture.
Une AI Gateway est une couche fine et performante qui sert de proxy pour les requêtes des applications vers un ou plusieurs fournisseurs de LLM ou modèles auto-hébergés. Elle unifie les API, centralise l'authentification et le RBAC (contrôle d'accès basé sur les rôles), applique des limites de débit et des garde-fous (guardrails), effectue le équilibrage de charge (load balancing) et le basculement automatique (failover), et capture les données d'observabilité et de coût pour chaque requête. Pensez-y comme à la couche « entrée + politique + télémétrie » pour la GenAI.
Sur le plan opérationnel, les passerelles modernes prennent en charge le routage pondéré et basé sur la latence, les contrôles de santé (health checks) et les basculements automatiques lorsqu'un modèle ou une région rencontre un problème—afin que les requêtes continuent d'être traitées même en cas de panne temporaire du fournisseur. Comme chaque requête passe par la passerelle, les équipes peuvent comparer les fournisseurs par latence et coût, faisant de l'évaluation OpenRouter vs AI gateway une démarche pratique pour décider comment gérer le routage, l'observabilité et le contrôle à grande échelle.
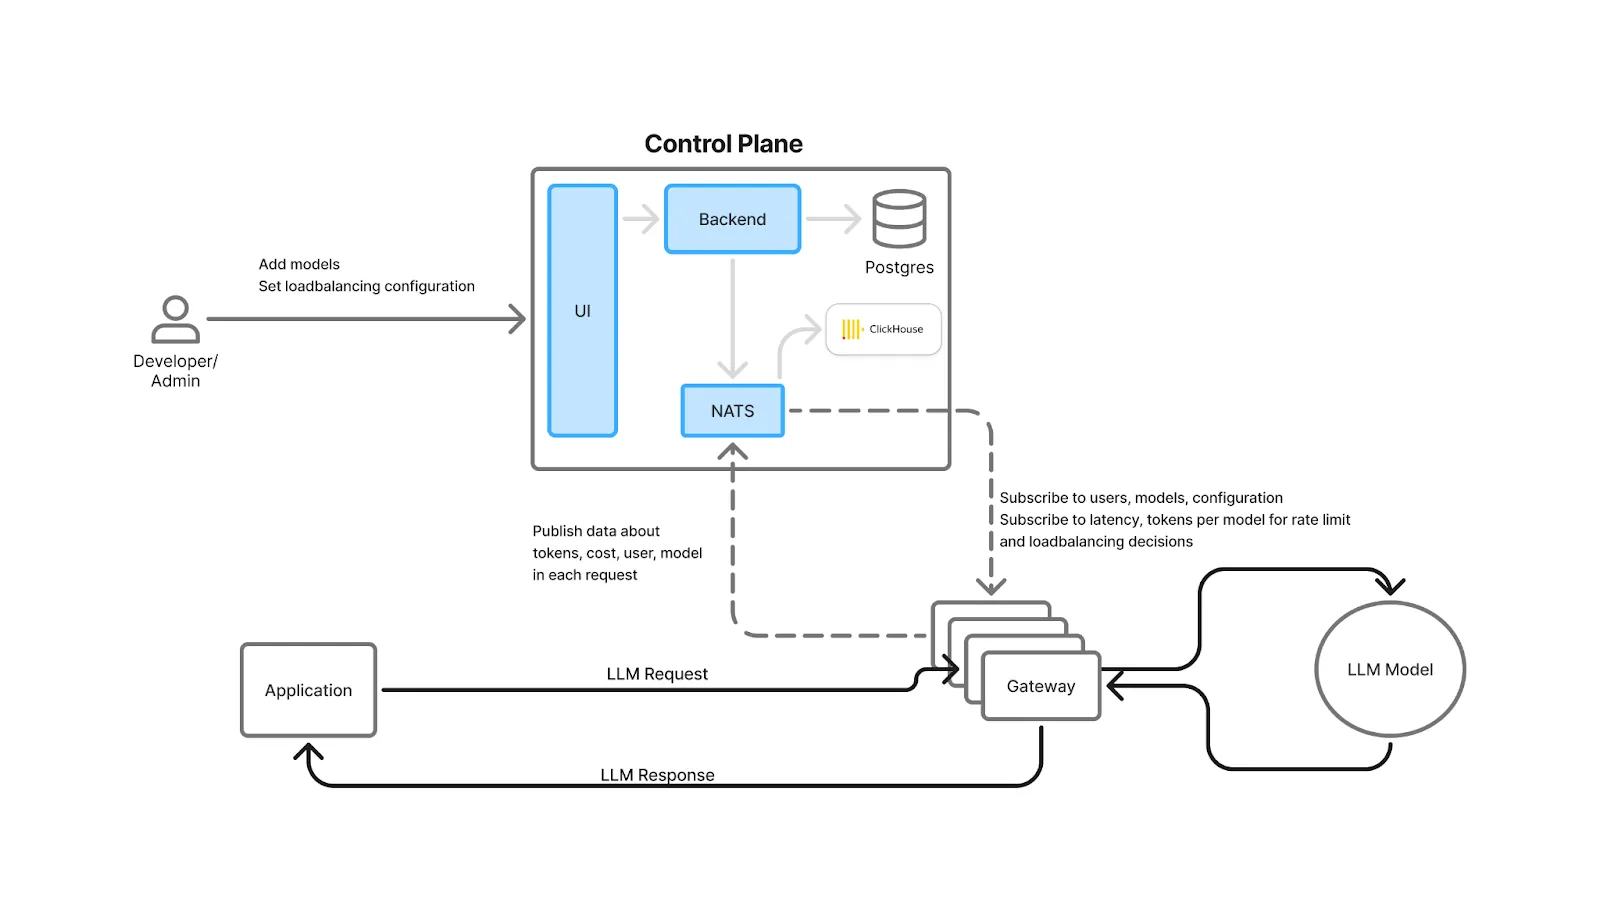
L'architecture de TrueFoundry est conçue pour que ces contrôles et métriques n'ajoutent qu'une surcharge minimale : les vérifications d'authentification, la limitation de débit (rate limiting) et l'équilibrage de charge sont effectués en mémoire ; les journaux et métriques sont écrits de manière asynchrone dans une file d'attente ; et le parcours de la requête évite les appels externes (sauf si vous optez pour la mise en cache). La passerelle offre une scalabilité horizontale et dépend principalement du processeur (CPU-bound), maintenant la surcharge de latence de bout en bout à quelques millisecondes seulement.
La latence d'un LLM est multimodale : il y a le délai avant le premier jeton (TTFT - Time to First Token), la latence entre les jetons (ITL - Inter-Token Latency) pour le streaming, et la latence totale de la requête. Chacun affecte l'expérience utilisateur perçue différemment. Les passerelles qui suivent ces trois indicateurs vous aident à diagnostiquer si les ralentissements proviennent des files d'attente des fournisseurs, du calcul du modèle, du réseau ou de la longueur du prompt—et à choisir la meilleure stratégie de routage.
Les jetons (tokens) sont les nouveaux cycles CPU. Un seul prompt peut être distribué à plusieurs outils ou étapes de recherche (retrieval), et les coûts s'accumulent selon les fournisseurs. L'observabilité doit attribuer les dépenses par modèle, fournisseur, environnement, application, client (tenant) et utilisateur, et rester à jour avec les tarifs publics des fournisseurs pour éviter les feuilles de calcul manuelles.
Les applications en production ont besoin de garde-fous contre les pannes de fournisseurs, les limitations de débit et les régressions de modèles. L'observabilité liée aux contrôles de santé, à la ventilation des codes d'erreur 4xx/5xx, aux taux de réessai/basculement et à l'utilisation des limites de débit vous permet d'appliquer des SLO et de basculer automatiquement en cas de détérioration des performances.
Les entreprises ont besoin d'une traçabilité complète des requêtes et des réponses avec des contrôles d'accès et des politiques de modération de contenu/DPI (PII). Une passerelle centralise cette application et cette journalisation afin que les équipes puissent prouver qui a appelé quel modèle, avec quelles données et ce qu'il a retourné—sans partager largement les clés d'API des fournisseurs.
La qualité, la tarification et les quotas des modèles changent fréquemment. Les organisations qui instrumentent les passerelles peuvent comparer directement les fournisseurs et réorienter le trafic en fonction de données récentes sur la latence, les coûts et les erreurs—maintenant ainsi la performance et les marges au rythme de l'évolution du marché.
Les recommandations du secteur confirment ces besoins : les leaders de l'industrie soulignent l'importance de l'observabilité IA pour réagir rapidement aux dérives, pannes et pics de coûts ; OpenAI et Azure recommandent une journalisation structurée et un réessai exponentiel (exponential backoff) pour les limites de débit, ce qu'une passerelle peut standardiser sur l'ensemble des applications.
Voici les capacités que vous devez attendre d'une AI Gateway de niveau production—et que TrueFoundry fournit en natif.
Métriques clés pour évaluer une Gateway
| Critère | Que devez-vous évaluer ? | Priorité | TrueFoundry |
|---|---|---|---|
| Latence | Ajoute <10ms de surcharge p95 pour le délai avant le premier jeton ? | Indispensable | ✅ Pris en charge |
| Résidence des données | Conserve les journaux dans votre région (UE/US) ? | Selon le cas d'usage | ✅ Pris en charge |
| Routage basé sur la latence | Réachemine automatiquement en fonction de la latence/des échecs en temps réel ? | Indispensable | ✅ Pris en charge |
| Rotation & révocation des clés | Effectue la rotation ou révoque les clés sans interruption de service ? | Indispensable | ✅ Pris en charge |
| Rotation & révocation des clés | Effectue la rotation ou révoque les clés sans interruption de service ? | Indispensable | ✅ Pris en charge |
| Rotation & révocation des clés | Effectue la rotation ou révoque les clés sans interruption de service ? | Indispensable | ✅ Pris en charge |
| Rotation & révocation des clés | Effectue la rotation ou révoque les clés sans interruption de service ? | Indispensable | ✅ Pris en charge |
| Rotation & révocation des clés | Effectue la rotation ou révoque les clés sans interruption de service ? | Indispensable | ✅ Pris en charge |

Voici comment TrueFoundry intègre l'observabilité directement au cœur du chemin de traitement des requêtes et fournit une suite analytique complète dès l'installation—sans ralentir le trafic de production.

Le tableau de bord Analytics affiche : Latence des requêtes (p50/p95/p99), Temps avant le premier jeton (TTFT/TTFS), Latence inter-jetons (ITL), coût par modèle/fournisseur, jetons d'entrée/sortie, codes d'erreur et activité des règles (limitation de débit, équilibrage de charge, basculements, garde-fous, budgets). Les vues permettent de filtrer par modèle, utilisateur, équipe, ruleId et métadonnées personnalisées ; vous pouvez également télécharger les fichiers CSV bruts.
Activez Public Cost pour remplir automatiquement le tarif par jeton à partir des prix publiés par les fournisseurs (OpenAI, Anthropic, Bedrock, etc.). Pour les modèles négociés ou affinés (fine-tuned), définissez Private Cost avec des prix personnalisés pour les jetons d'entrée et de sortie. Les deux alimentent les analyses de coûts par requête et agrégées.
Associez un contexte métier (client, fonctionnalité, environnement) et ventilez les jetons, la latence et les dépenses selon n'importe quelle dimension—idéal pour la facturation interne (chargebacks), la détection des utilisateurs gourmands en ressources (noisy neighbors) et la priorisation des optimisations.

Définissez des quotas par jetons ou par requêtes par minute/heure/jour, appliqués aux utilisateurs, modèles ou segments identifiés via des métadonnées. Les tableaux de bord affichent l'utilisation et les ralentissements afin de dimensionner correctement les limites et de protéger la capacité partagée.
Utilisez une répartition par poids pour les expérimentations ou un routage basé sur la latence en régime permanent. Les contrôles de santé marquent les backends comme indisponibles en cas de dépassement des seuils d'erreur/latence et les excluent automatiquement. Les chaînes de basculement retentent les requêtes en cas d'échec, avec des spans et des métriques montrant le chemin emprunté et son impact sur la latence et les coûts.
Centralisez les clés des fournisseurs, émettez des jetons d'accès restreints, appliquez le RBAC et conservez des journaux de requêtes/réponses immuables pour la conformité—sur l'ensemble des LLM et des serveurs MCP.
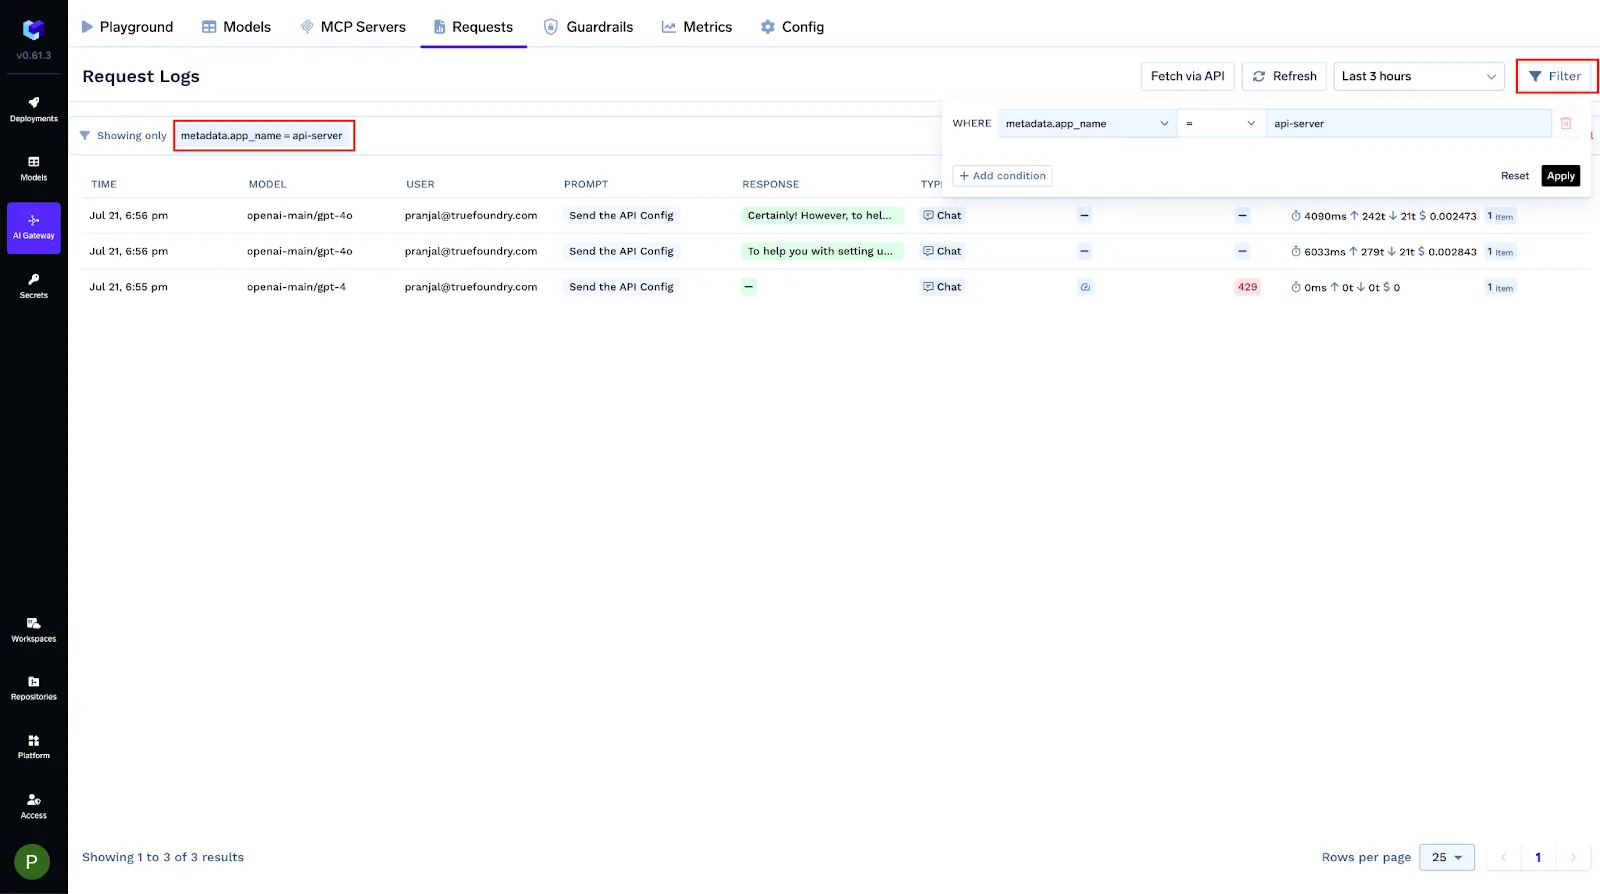
Vous pouvez taguer chaque requête avec des métadonnées structurées via l'en-tête X-TFY-METADATA . Les clés enregistrées deviennent des filtres interrogables, des étiquettes Grafana et des conditions dans les configurations de la passerelle (limites de débit, équilibrage de charge, basculements, garde-fous). Les valeurs sont des chaînes de caractères (≤128 caractères).
Le même modèle de métadonnées s'applique aux règles d'équilibrage de charge et de basculement.
La passerelle est conforme au standard OpenTelemetry. Activez l'exportation OTLP et envoyez des traces vers n'importe quel backend (Tempo, Jaeger, Datadog/New Relic via Collector, TrueFoundry Tracing). Les spans incluent des attributs genai—modèle, jetons, TTFT, ITL, paramètres, appels d'outils, erreurs—ainsi que des spans détaillés pour la limitation de débit, l'équilibrage de charge, les basculements et les appels de serveurs/outils MCP, vous permettant de corréler le comportement du fournisseur avec les spans applicatifs.
Activer le traçage
Spans représentatifs

Les clés de métadonnées répertoriées dans LLM_GATEWAY_METADATA_LOGGING_KEYS deviennent des étiquettes Prometheus llm_gateway_metadata_<key>, permettant de créer des graphiques de coût et de latence par client/fonctionnalité. (Truefoundry Docs)
Familles de métriques clés (extrait)
Un tableau de bord Grafana prédéfini en JSON est publié par TrueFoundry, organisé en vues Model, User, Config, et MCP Invocation. Ajoutez des variables pour vos métadonnées personnalisées, par ex. :

Le Model Context Protocol (MCP) d'Anthropic—annoncé le 25 novembre 2024—standardise la manière dont les assistants se connectent aux outils, prompts et ressources. L'écosystème s'est accéléré tout au long de 2025 avec de nombreux serveurs préintégrés (GitHub, Slack, Google Maps, Puppeteer, etc.).
TrueFoundry intègre le MCP de façon native :
Cela fait de la passerelle le plan de contrôle opérationnel pour les charges de travail agentiques—unifiant les politiques, l'authentification, le routage et la visibilité de bout en bout sur les appels LLM comme sur l'exécution des outils.
Voici une liste de contrôle pratique. Chaque métrique indique ce qu'elle révèle, comment l'utiliser et comment TrueFoundry la restitue.
Une modification de prompt augmente la verbosité des réponses pour les clients entreprise. Symptômes : augmentation des jetons de sortie, latence p95 plus élevée et hausse des dépenses quotidiennes. Action avec TrueFoundry : la section Analytics montre un pic de jetons générés pour l'environnement « support-prod » et une hausse des coûts pour le modèle principal. Vous comparez avec un autre fournisseur qui présente un TTFT plus bas et des jetons de sortie moins chers ; vous réorientez 30 % du trafic via le routage pondéré et définissez une alerte sur le « coût par conversation ».
À 10 h 00 IST, le taux d'erreur a grimpé avec des erreurs 429. Action avec TrueFoundry : les tableaux de bord de limitation de débit confirment les restrictions en amont. Les chaînes de basculement prennent le relais et le routage redirige le trafic vers un backend plus disponible. L'expérience utilisateur reste stable et vous ajustez ultérieurement les quotas de jetons et les paramètres de temporisation.
Les utilisateurs rapportent que « la réponse commence rapidement puis ralentit fortement ». Action avec TrueFoundry : Le TTFT est bon, mais l'ITL est élevée sur le modèle principal. Le routage basé sur la latence privilégie automatiquement un fournisseur avec un meilleur débit de streaming ; vous définissez également une alerte sur le p95 de l'ITL.
Le traitement par lot d'un client consomme une quantité excessive de jetons et ralentit tous les autres utilisateurs. Action avec TrueFoundry : les limites de débit basées sur les jetons par client garantissent un partage équitable et protègent les SLO ; les analyses vérifient l'utilisation et le nombre de rejets afin que vous puissiez proposer des quotas plus élevés.
Les applications LLM sont des systèmes dynamiques. Les modèles évoluent, les fournisseurs modifient leurs quotas et leurs prix, les prompts se transforment et le comportement des utilisateurs vous surprend. La meilleure AI gateway est celle qui vous permet d'observer, de contrôler et d'optimiser l'ensemble de ces éléments—à condition de collecter les bons signaux et de les transformer en actions.
L'AI Gateway de TrueFoundry vous offre ce centre de commandement opérationnel. Elle capture la latence (TTFT/ITL), les tokens, les coûts et les erreurs avec un overhead réduit ; applique des limites de débit basées sur les tokens, le RBAC et des guardrails ; et fournit une visibilité sur le routage, la santé et les fallbacks afin que vous puissiez maintenir des expériences rapides, fiables et rentables. Grâce à une analytique granulaire par client/utilisateur et à une attribution automatisée et actualisée des coûts, les équipes peuvent passer d'une gestion de crise réactive à une optimisation proactive.
Si vous centralisez votre stack GenAI—ou si vous démêlez un encombrement d'intégrations ponctuelles—commencez par router le trafic via la gateway, activez les tableaux de bord ci-dessus et configurez quelques alertes alignées sur vos SLO. Vous obtiendrez la visibilité nécessaire pour déployer plus rapidement, contenir les coûts et ravir vos agents et vos utilisateurs.
L'observabilité dans une AI gateway aide à tracer les raisonnements complexes en plusieurs étapes et les invocations d'outils qui sont autrement opaques. Le suivi des parcours d'exécution des agents permet de détecter en temps réel les boucles infinies, les hallucinations et l'utilisation inefficace des outils. Cette visibilité garantit que les agents autonomes restent fiables, prévisibles et respectent le budget tout en interagissant avec divers systèmes et API externes.
L'observabilité d'une AI gateway optimise les performances des LLM en fournissant un suivi en temps réel de la latence, du débit et des taux d'erreur chez les différents fournisseurs de modèles. En capturant des métriques granulaires telles que le Time to First Token (TTFT) et l'Inter-Token Latency (ITL), les équipes peuvent identifier les goulots d'étranglement spécifiques dans la chaîne d'inférence. Ces informations permettent aux développeurs de comparer objectivement la vitesse des modèles et de mettre en œuvre un routage intelligent pour garantir des performances à haute vitesse aux utilisateurs finaux.
L'observabilité d'une AI gateway réduit les coûts en offrant une visibilité granulaire sur la consommation de tokens à travers les modèles, les équipes et les utilisateurs. Le suivi des dépenses par requête et par espace de travail permet aux équipes d'identifier immédiatement les prompts incontrôlés ou les flux de travail inefficaces. Ces données prennent en charge des stratégies automatisées d'économie de coûts telles que le caching sémantique, la limitation de débit basée sur les tokens et le routage des requêtes vers des modèles plus abordables sans intervention manuelle.
L'observabilité d'une AI gateway facilite les audits de conformité en maintenant un registre centralisé et immuable de chaque requête et réponse. Les systèmes modernes enregistrent des pistes d'audit détaillées, incluant les identifiants d'utilisateurs, les horodatages et les événements de masquage des PII pour protéger les données sensibles. Ces journaux garantissent que les entreprises respectent les normes réglementaires telles que le RGPD et SOC 2 en offrant une transparence totale sur les interactions avec les modèles, tout en conservant souvent l'ensemble de la télémétrie dans l'environnement cloud sécurisé de l'organisation.
TrueFoundry simplifie la gestion de l'infrastructure IA en unifiant plusieurs fournisseurs de modèles au sein d'un plan de contrôle unique grâce à l'observabilité dans les AI gateways. TrueFoundry corréle la télémétrie au niveau de la requête avec l'utilisation des GPU et CPU afin d'optimiser l'allocation des ressources et d'éliminer le gaspillage. Cette approche intégrée permet aux équipes plateforme de gérer de manière native les déploiements, la mise à l'échelle et les politiques de sécurité sur divers environnements au sein de leurs propres comptes AWS, GCP ou Azure.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception

















