



October 27, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Las aplicaciones que utilizan modelos de lenguaje extensos dependen de proveedores de modelos de IA para cada solicitud de inferencia. OpenAI, Anthropic y Google ofrecen servicios, pero ningún proveedor de LLM elimina los límites de velocidad, las interrupciones o los picos de latencia. Por tanto, un problema del proveedor puede interrumpir las aplicaciones y los flujos de trabajo de LLM.
Sin una ruta de fallback, una solicitud puede fallar, superar los objetivos de respuesta o crear una experiencia de usuario incoherente. Este patrón envía las solicitudes afectadas a través de otro modelo o proveedor cuando la ruta inicial no cumple los requisitos definidos. Preserva la continuidad del servicio sin exponer los fallos de la infraestructura a los usuarios de la aplicación.
La implementación fiable es importante siempre que los sistemas de producción utilicen múltiples modelos, regiones o proveedores. Un puerta de enlace de LLM (LLM Gateway) puede centralizar el enrutamiento, la resiliencia y la aplicación de políticas detrás de una única interfaz. Esta arquitectura ayuda a los equipos de producción a evitar la integración de lógica de recuperación específica del proveedor en todas las aplicaciones.
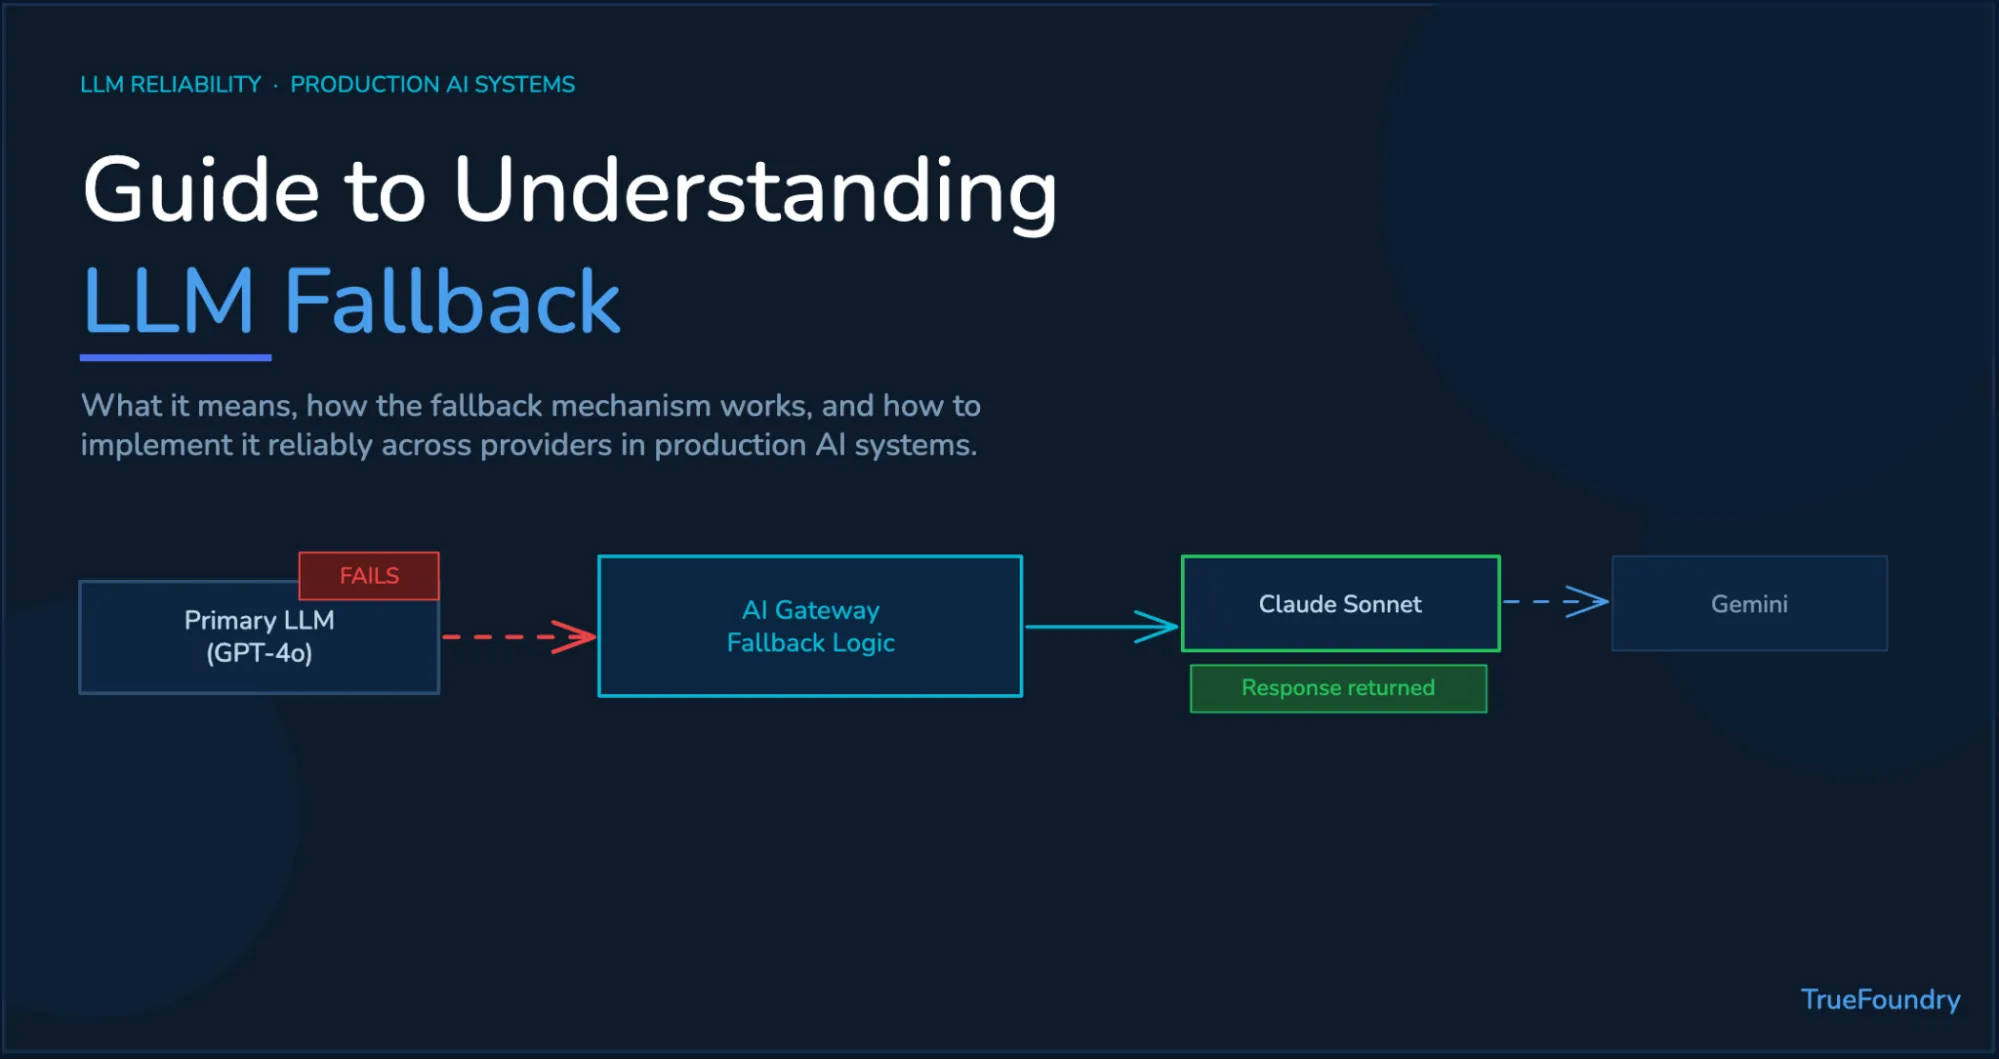
Este patrón de fiabilidad reenvía automáticamente una solicitud cuando el modelo principal no cumple los requisitos definidos de disponibilidad, latencia o calidad. Los disparadores pueden incluir una respuesta HTTP 429, un error de servidor, un error de red o un tiempo de espera configurado. A continuación, la solicitud se dirige a un modelo de fallback adecuado a través de una ruta alternativa.
El significado de fallback de LLM va más allá de la recuperación de errores aislados. Representa una capa de resiliencia dentro de la arquitectura de acceso a modelos. Este enfoque reduce la dependencia de un único proveedor de LLM a la vez que ayuda a que las aplicaciones sigan estando disponibles durante la inestabilidad del proveedor.
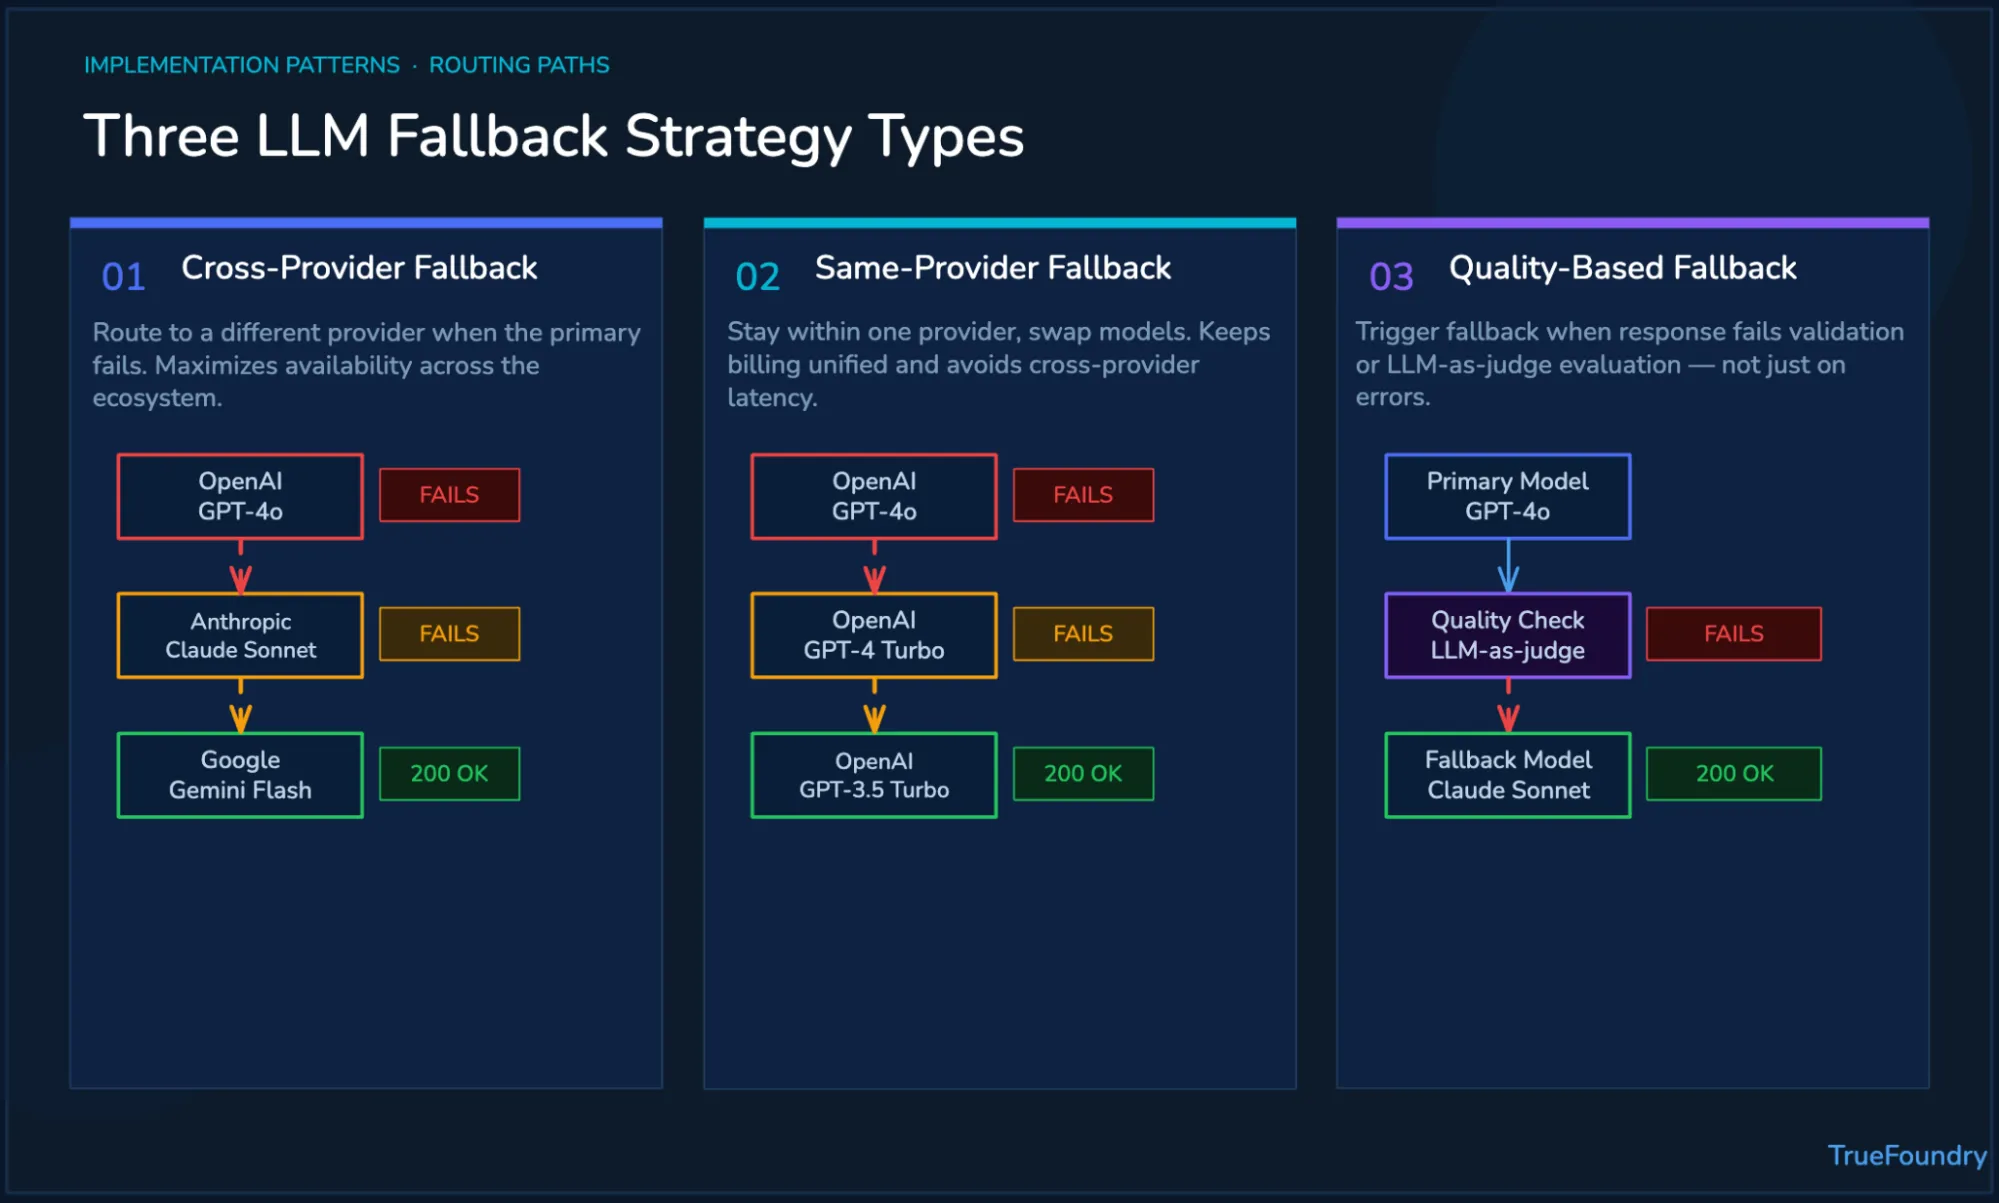
Los fallbacks pueden operar entre proveedores, modelos, regiones o umbrales de calidad. Un mismo modelo también puede recurrir a otra implementación dentro del mismo proveedor. El diseño seleccionado debe preservar la compatibilidad entre prompts, tokens, ventanas de contexto, soporte de herramientas y formatos de respuesta.
El mecanismo de fallback de LLM sigue una secuencia controlada tras el fallo de una solicitud. Su enrutador evalúa el disparador, lee la cadena de fallback configurada y selecciona el siguiente objetivo elegible. El prompt original, el contexto y los ajustes de generación viajan entonces a través de la ruta de fallback elegida.
Los reintentos deben abordar los fallos transitorios antes de cambiar de proveedor. Las políticas limitadas utilizan retroceso exponencial, fluctuación (jitter) y orientación de respuesta antes de redirigir. OpenAI recomienda el retroceso aleatorio, mientras que Anthropic documenta los límites de tasa, los tiempos de espera y las respuestas de sobrecarga.
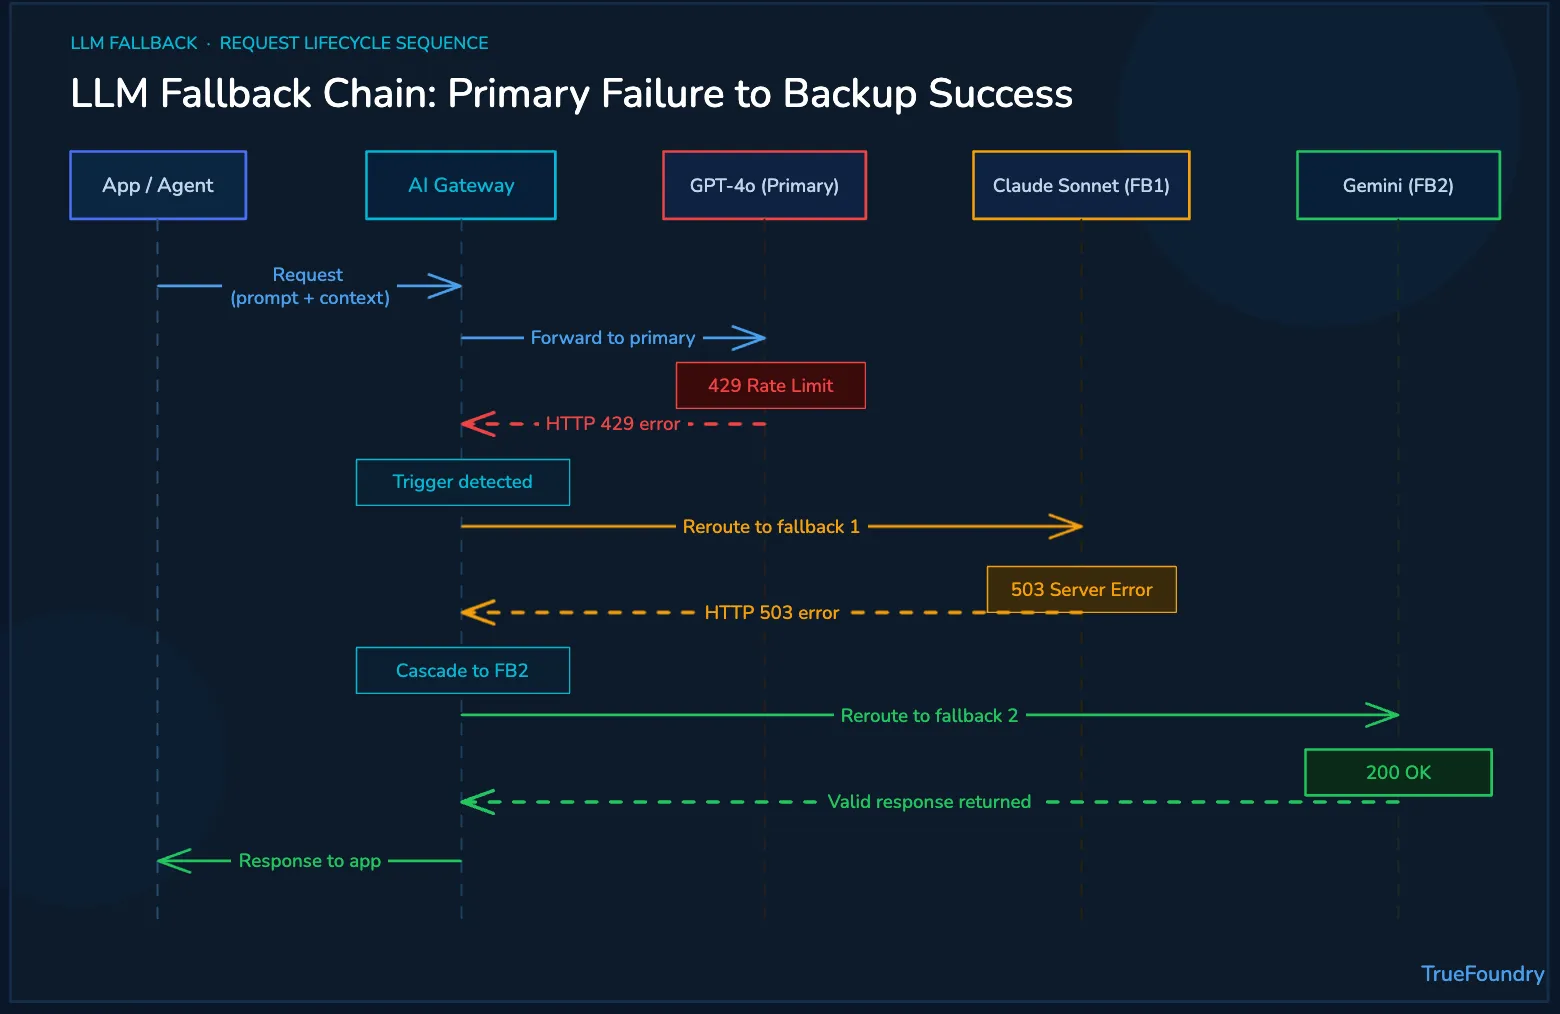
El fallback, el failover y los reintentos resuelven problemas relacionados en diferentes ámbitos operativos. El fallback gestiona los fallos de solicitudes individuales, mientras que el failover redirige el tráfico general durante una degradación sostenida. Los reintentos repiten una solicitud contra el mismo punto de conexión antes de que otro destino la reciba.
Estos patrones comunes suelen trabajar juntos dentro de arquitecturas resilientes. Los reintentos limitados pueden resolver errores de corta duración sin cambiar de proveedor. El equilibrio de carga de LLM distribuye el tráfico normal, mientras que el failover protege la continuidad durante las interrupciones sostenidas. El fallback gestiona los fallos restantes a nivel de solicitud.
Diferentes estrategias de fallback favorecen la disponibilidad, la calidad, el coste y la independencia del proveedor. Cada estrategia requiere condiciones de activación claras y capacidades de modelo compatibles. Los equipos deben comparar la latencia esperada, la calidad de salida, los límites de contexto y el soporte de herramientas antes de definir las prioridades de ruta.
Una limitación de tasa eficaz debe coordinarse con cada estrategia en lugar de activar un redireccionamiento descontrolado. Central controles de limitación de tasa pueden aplicar cuotas entre usuarios, modelos, aplicaciones y entornos. Google documenta las respuestas HTTP 429 cuando las cargas de trabajo de Gemini superan las cuotas aplicables.
Implementar la lógica de respaldo dentro del código de la aplicación parece manejable durante las primeras etapas de desarrollo. La complejidad aumenta cuando la configuración abarca varios proveedores, versiones de modelos y entornos. Cada SDK expone errores, valores predeterminados, estructuras de respuesta y comportamientos de reintento diferentes.
Los equipos pueden evaluar Portkey, Bifrost o Vercel al comparar opciones de pasarelas. Independientemente de la plataforma que elijan, las mejores prácticas requieren reintentos limitados, enrutamiento basado en el estado de salud, credenciales seguras y una recuperación medible. Una sólida observabilidad de LLM debería mostrar la latencia, los errores, la frecuencia de respaldo y la tasa de éxito final.
ElTrueFoundry AI Gateway centraliza el acceso a los modelos, el enrutamiento, los controles de fiabilidad y la observabilidad. Su configuración de enrutamiento global admite reglas de equilibrio de carga, respaldo y reintento desde una única capa de gobierno. Las aplicaciones pueden utilizar una única API sin tener que reconstruir la lógica de recuperación para cada proveedor.
La plataforma admite cadenas entre un proveedor principal y objetivos alternativos. Los reintentos automáticos gestionan los errores temporales del proveedor antes de redirigir el tráfico. El monitoreo continuo del estado de salud reduce la recuperación tardía durante las interrupciones.
Para los agentes de IA, la pasarela de agentes (Agent Gateway) gestiona la ejecución en varios pasos. El MCP Gateway controla el acceso a través de las herramientas empresariales conectadas. Juntos, protegen todo el sistema cuando una ruta de modelo deja de estar disponible.
Cree aplicaciones de IA resilientes con la pasarela de IA de TrueFoundry. Centralice el enrutamiento, los reintentos, la observabilidad y las alternativas de LLM entre proveedores. Reservar una demostración gratuitahoy mismo para empezar.
El uso de alternativas (fallback) para LLM es un requisito arquitectónico para aplicaciones fiables que utilizan modelos externos. Los proveedores pueden imponer restricciones o experimentar fallos temporales durante las operaciones. Las aplicaciones deben absorber esas condiciones sin trasladar cada interrupción a los usuarios.
La implementación a nivel de aplicación es posible, pero la complejidad aumenta en entornos con múltiples modelos. Una pasarela puede centralizar las reglas de reintento, el orden de las alternativas, las comprobaciones de estado, las credenciales y la supervisión. Este enfoque mejora la resiliencia y mantiene el código de la aplicación independiente del comportamiento específico de cada proveedor.
Los equipos deben definir los activadores, validar la compatibilidad de los modelos y supervisar cada ruta tras la implementación. También deben probar las cadenas agotadas y el comportamiento de recuperación antes de ampliar el tráfico de producción. TrueFoundry proporciona un plano de control único para gestionar las decisiones de acceso a los modelos.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada
















