



November 16, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Una herramienta puede devolver los datos correctos pero con una estructura inadecuada para el razonamiento del modelo. La gestión de respuestas de gran tamaño separa la posesión de la carga útil de la atención inmediata a cada uno de sus bytes.
Una herramienta MCP puede responder con éxito y, aun así, perjudicar la ejecución. La API de un repositorio puede devolver cientos de solicitudes de extracción (pull requests) con descripciones extensas. Una herramienta de métricas puede emitir todas las series temporales. Una búsqueda en un CRM puede adjuntar historiales anidados a cada cuenta. La carga útil es relevante en teoría, pero es posible que el modelo solo necesite tres campos.
Si el resultado completo ingresa al contexto, suceden varios problemas a la vez: la entrada aumenta, el razonamiento posterior hereda la sobrecarga, los datos importantes compiten con campos irrelevantes y las llamadas de seguimiento pueden llevar la ejecución al límite del modelo. Solicitar menos datos a la herramienta es preferible cuando su API admite proyección, paginación o filtrado. Aun así, el entorno de ejecución necesita un mecanismo de reserva (fallback) porque muchas herramientas no ofrecen los controles adecuados.
La gestión de respuestas documentada de TrueForge escribe los resultados de tamaño excesivo en un archivo dentro de un entorno aislado (sandbox) y coloca una breve previsualización junto con la ruta del archivo en el contexto. El agente conserva el acceso sin verse obligado a procesar toda la carga útil.
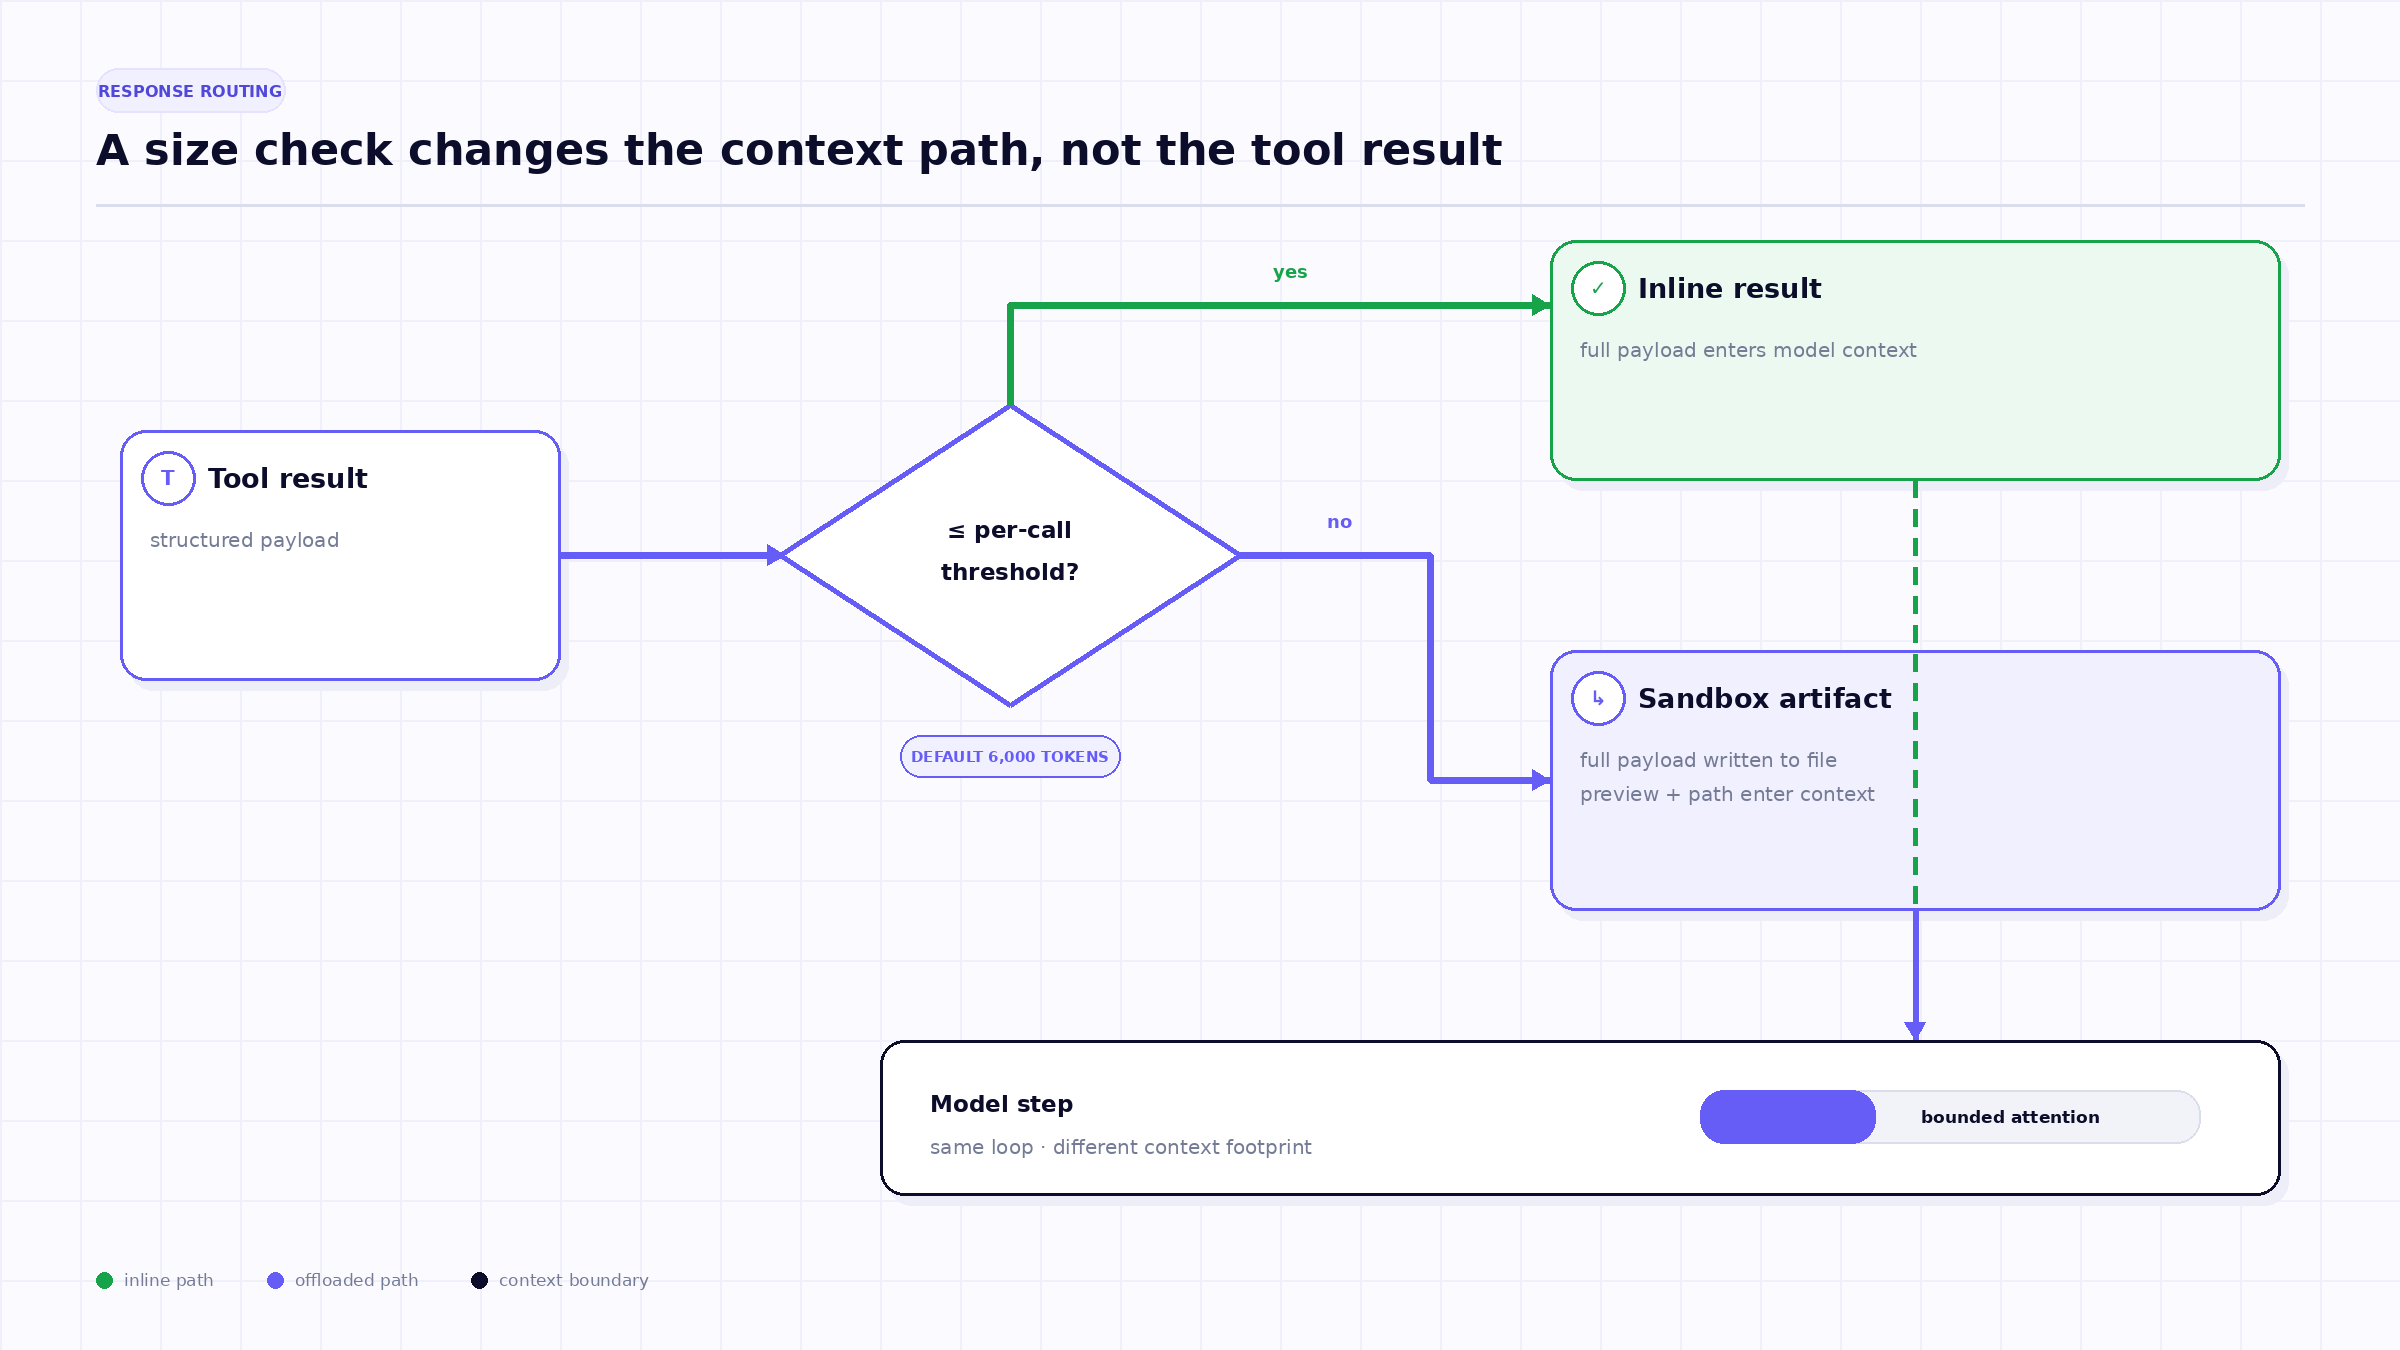
La primera regla se aplica al resultado de una sola herramienta. Si la respuesta estimada supera el umbral configurado por llamada, TrueForge escribe el resultado completo en el sandbox. El contexto recibe una notificación, la ruta del archivo y una previsualización delimitada. El umbral predeterminado actual es de 6000 tokens; la previsualización predeterminada actual contiene los primeros y últimos 100 caracteres.
La previsualización sirve para la navegación, no como un resumen. Los caracteres límite pueden revelar el tipo de objeto, las claves de nivel superior, el recuento total o los metadatos finales, pero pueden omitir los registros exactos que requiere la tarea. Un paso posterior adecuado consiste en inspeccionar la estructura, buscar un objetivo o ejecutar un analizador sintáctico (parser) pequeño, en lugar de inferir todo el contenido a partir de la previsualización.
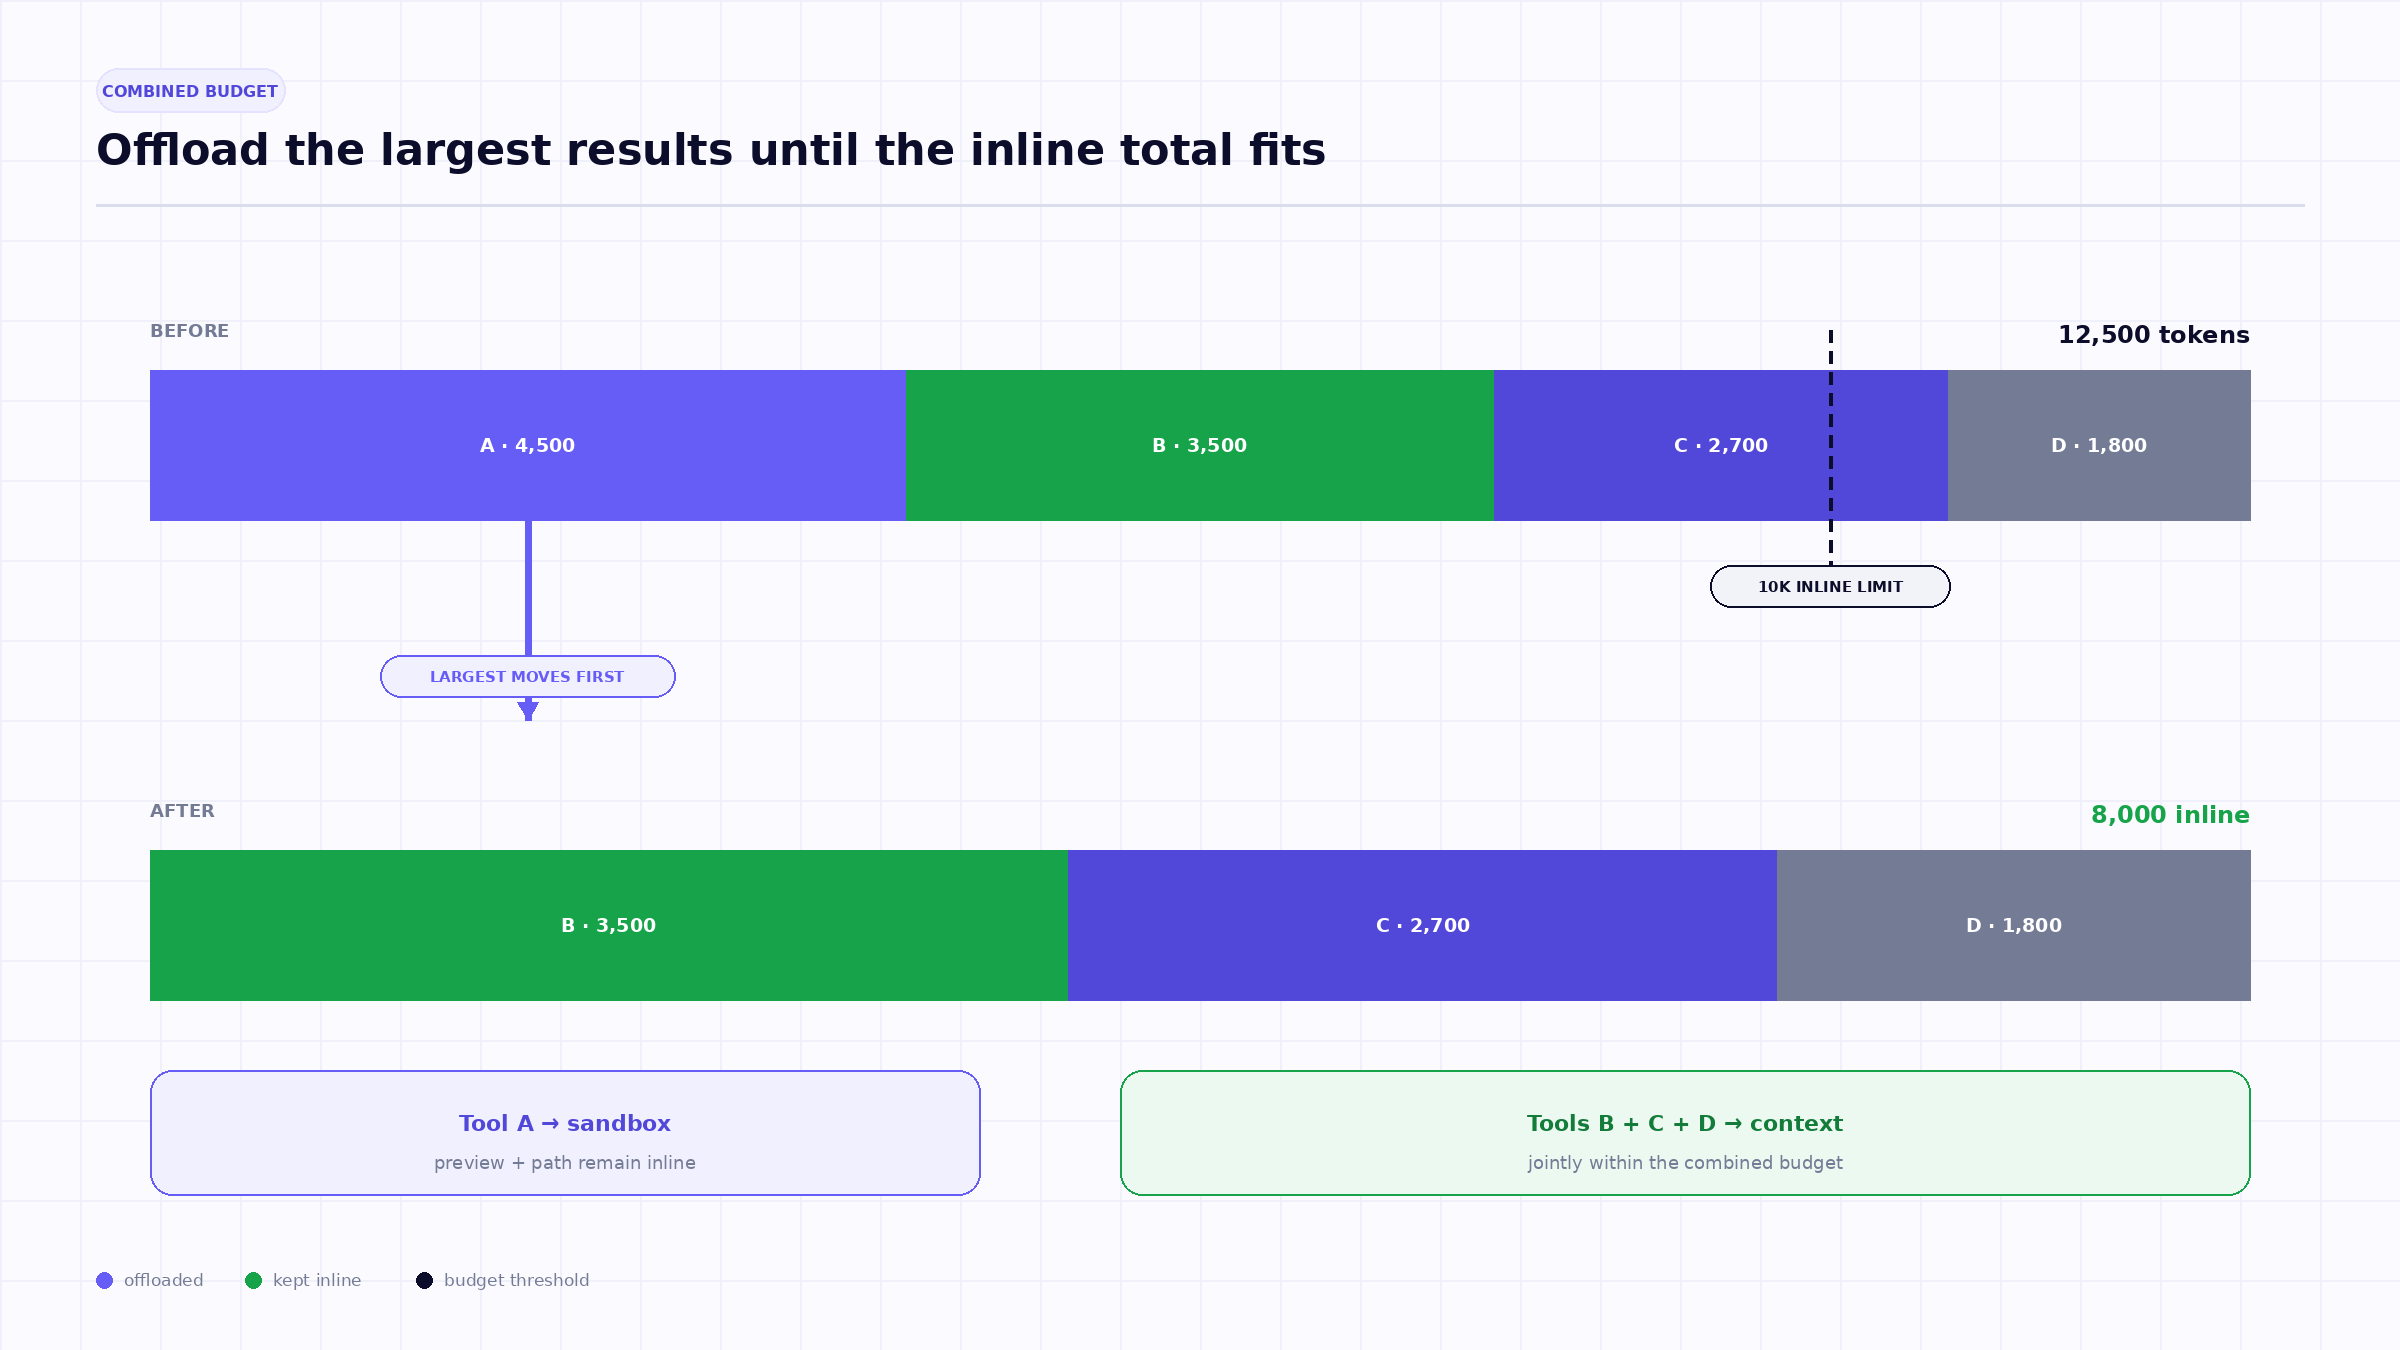
Los límites por llamada resultan insuficientes cuando un agente ejecuta herramientas de manera concurrente. Cuatro resultados de 4000 tokens superan individualmente la verificación de un umbral de 6000 tokens pero, en conjunto, inyectan 16 000 tokens en un solo paso del modelo.
Por esta razón, TrueForge documenta un segundo umbral para el contenido combinado de las llamadas a herramientas devueltas al mismo tiempo. El valor predeterminado actual es de 10 000 tokens. Cuando la suma supera dicho límite, el entorno de ejecución descarga las respuestas una a una, comenzando por la más grande, hasta que el contenido integrado restante quede por debajo del umbral.
Esta directiva que prioriza las respuestas de mayor tamaño conserva más resultados pequeños de forma integrada mientras elimina rápidamente los elementos que más espacio consumen. Se trata de una heurística de contexto, no de un juicio de relevancia. La respuesta más grande podría contener la evidencia más importante; la ruta del archivo permite recuperarla cuando sea necesario.
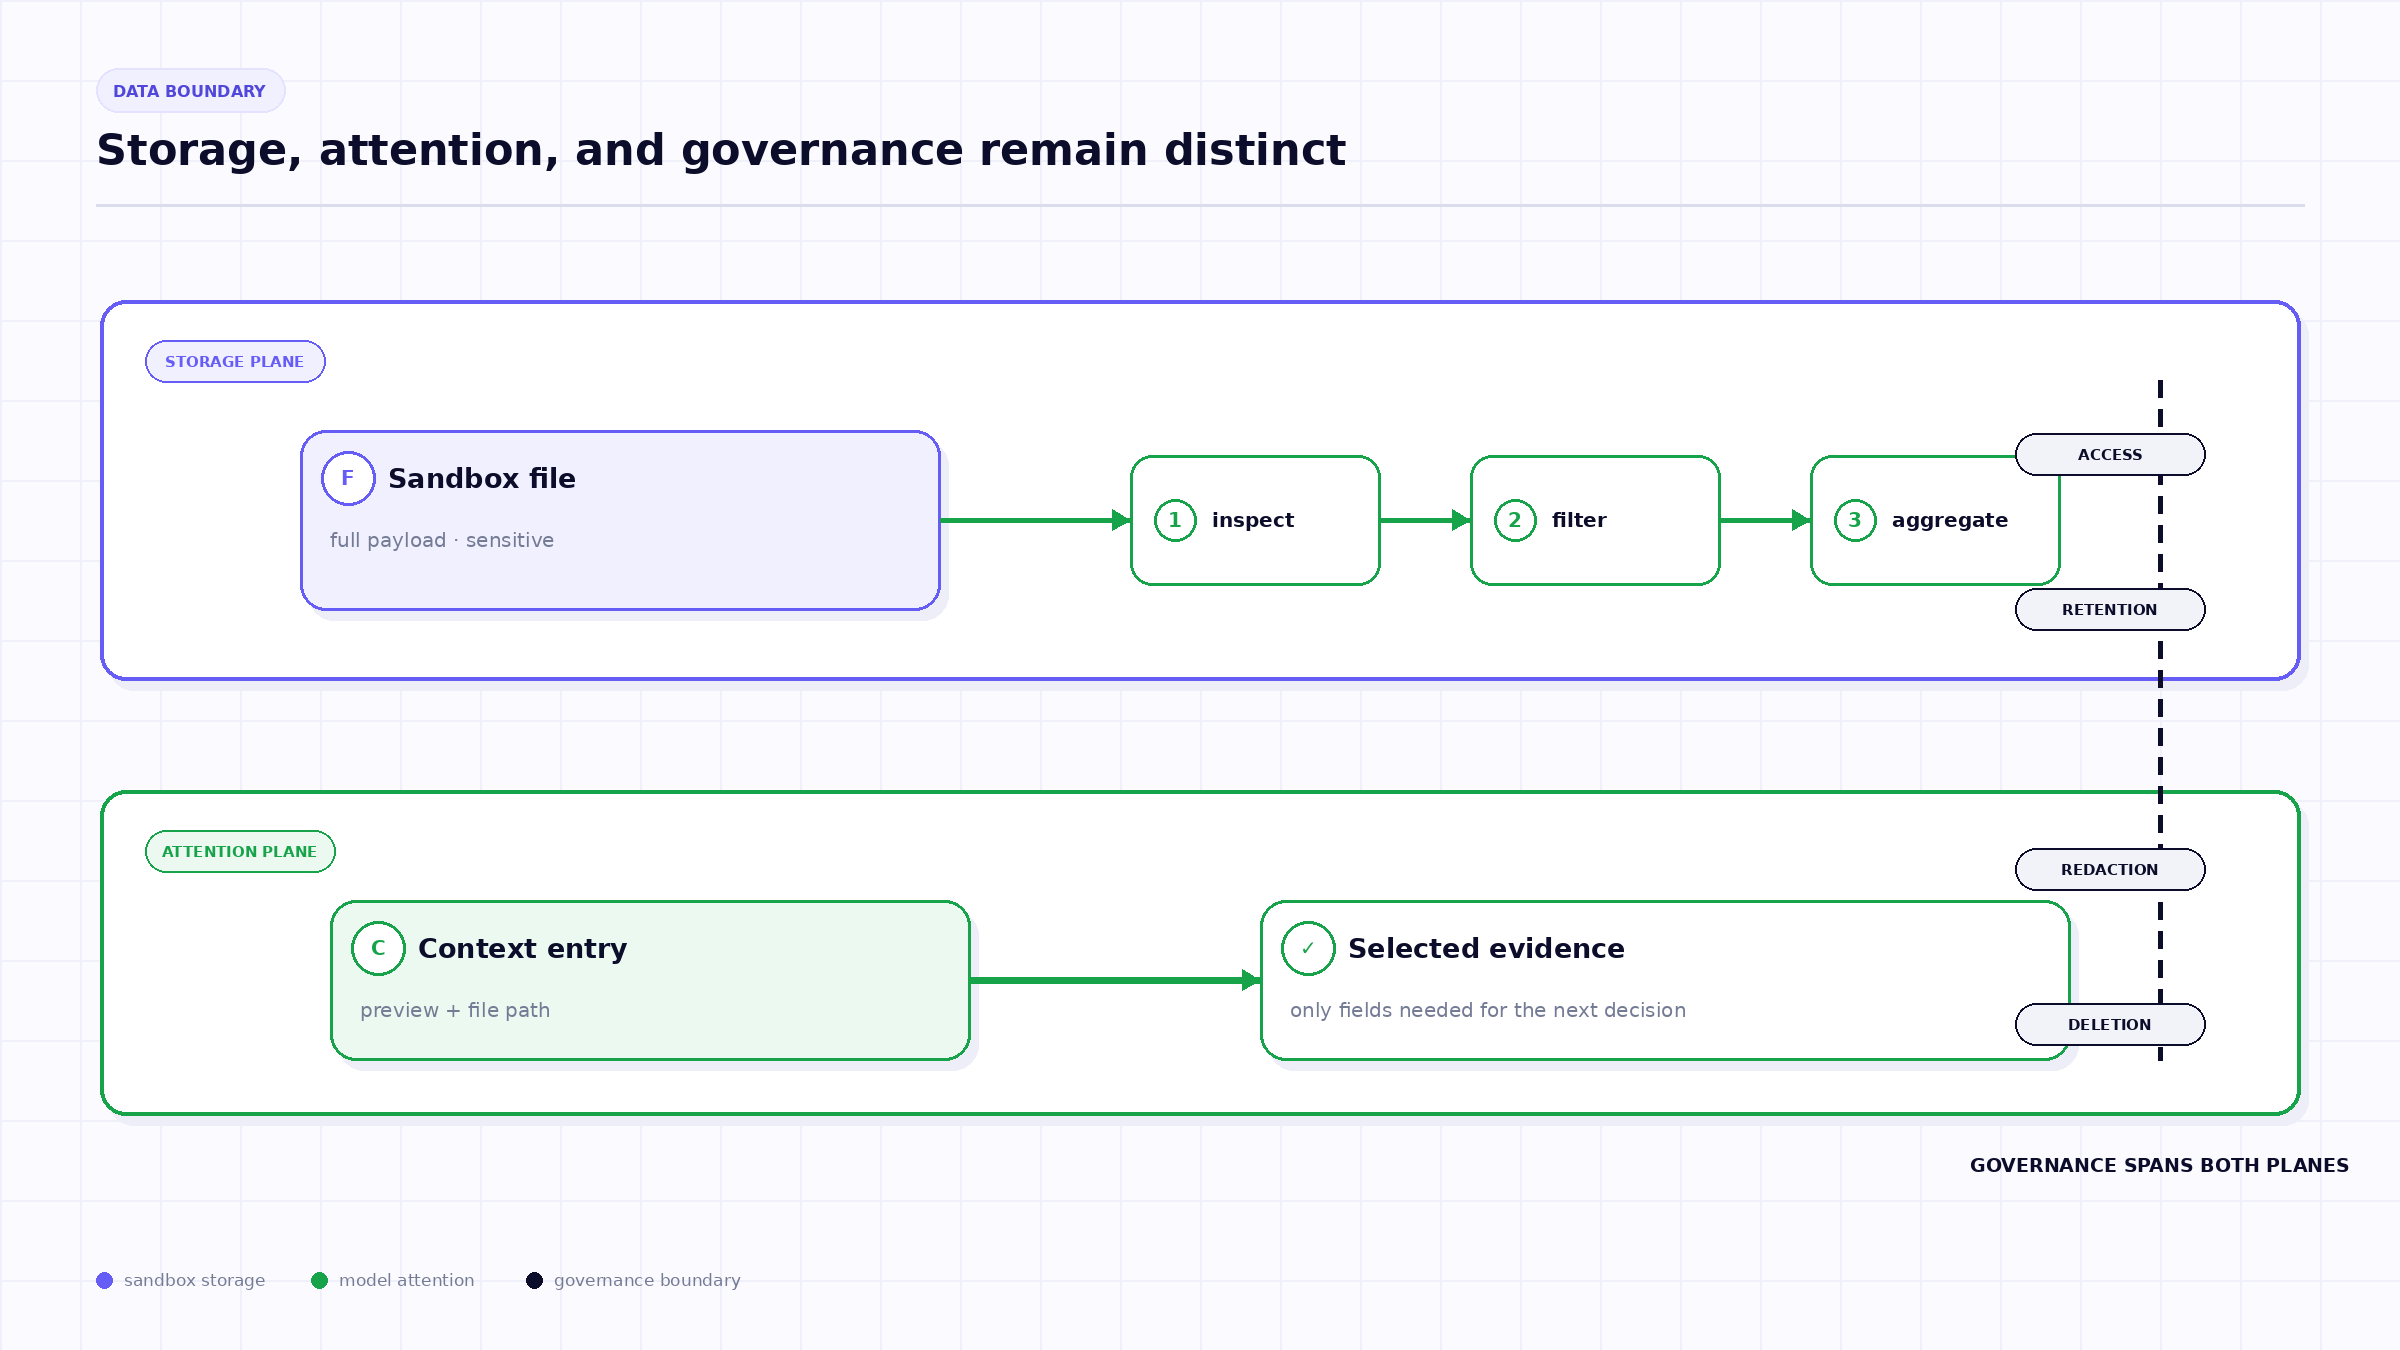
La carga útil completa requiere una superficie de ejecución duradera que el agente pueda inspeccionar. La función de TrueForge está activada de forma predeterminada, pero requiere que el sandbox del agente esté habilitado, ya que el resultado descargado se almacena como un archivo en dicho entorno.
El sandbox no es el lugar donde se ejecuta todo el bucle del agente. La documentación de TrueForge lo describe como un entorno aislado utilizado para código, archivos y trabajo en shell, que se aprovisiona según sea necesario. El modelo recibe una ruta y puede utilizar operaciones de sandbox para inspeccionar o transformar el archivo.
Este diseño ofrece una separación muy útil: el entorno de ejecución controla el flujo y las credenciales, mientras que el sandbox gestiona el procesamiento de la carga útil. Esto también plantea una cuestión sobre el ciclo de vida: si la tarea, el usuario o la directiva de retención manejan datos confidenciales, los equipos deben saber cuánto tiempo se conserva el archivo, quién puede descargarlo, qué telemetría hace referencia a él y cómo se propaga su eliminación.
Una vez que se descarga una respuesta, el agente debe delimitarla de forma deliberada:
La documentación de TrueForge vincula explícitamente este patrón con el Code Mode. Un script puede leer el archivo descargado, calcular un resultado y devolver únicamente las líneas imprimibles al contexto del modelo.
La descarga resulta atractiva porque conserva la carga útil original. No obstante, no permite búsquedas automáticas, ni está normalizada o verificada por defecto. Para un uso empresarial recurrente, una canalización de datos (data pipeline) diseñada a medida puede ser una solución más adecuada que solicitar a cada ejecución que analice la misma exportación de datos sin procesar.
Los umbrales dependen de la estimación de tokens. El recuento exacto de tokens facturables puede variar según el tokenizador del proveedor, el enmarcado del mensaje y la serialización. Esta función necesita una señal de tamaño lo suficientemente confiable para proteger el contexto, no una conciliación perfecta de facturas.
La supervisión operativa debe separar el tamaño de la carga útil original de la herramienta, el tamaño de la previsualización integrada, los tokens enviados realmente al modelo y el consumo notificado por el proveedor del modelo. Cada una de estas mediciones responde a preguntas diferentes.
La descarga de datos puede reducir la cantidad de información confidencial expuesta a un paso del modelo, pero no elimina los datos. El archivo permanece en un sandbox y puede ser referenciado por eventos, registros o artefactos descargables.
Aplique la misma clasificación al archivo del sandbox que a la respuesta original de la herramienta. Limite quién puede acceder a él, evite imprimir credenciales o secretos innecesarios de vuelta al contexto, defina políticas de retención y eliminación, y asegúrese de que la telemetría exportada no capture la carga útil completa por accidente.
Ninguna capa establece el gobierno de datos por sí sola. El valor radica en poder gestionar el volumen de la carga útil sin eludir los límites gobernados de las herramientas y los modelos.
Comience con los valores predeterminados documentados y, a continuación, realice pruebas con distribuciones representativas de cargas útiles. Un umbral demasiado alto permite picos de contexto. Un umbral demasiado bajo genera operaciones de E/S de archivos innecesarias y pasos de inspección adicionales. La configuración adecuada depende de la longitud de contexto del modelo, la estructura típica de los resultados, la latencia del sandbox y la utilidad de mantener los resultados pequeños directamente visibles.
Las directivas de umbrales también pueden variar según el rol del agente. Un agente dedicado a la respuesta de incidentes específicos puede beneficiarse de mantener resultados de diagnóstico moderados de forma integrada para una síntesis inmediata, mientras que un agente de análisis de carteras que procesa habitualmente miles de registros puede realizar descargas de datos de forma más agresiva. Mantenga una configuración explicable y observable en lugar de optimizar únicamente para obtener el menor recuento de tokens.
La documentación actual de TrueForge indica que sí, siempre que el sandbox del agente esté habilitado.
La documentación detalla 6000 tokens por respuesta, 10 000 combinados en respuestas paralelas y una previsualización de los primeros y últimos 100 caracteres.
Si el contenido combinado supera el umbral total, TrueForge descarga primero las respuestas más grandes hasta que el total integrado permanezca por debajo del límite.
No. El resultado se almacena en un archivo del sandbox que el agente puede inspeccionar, buscar o analizar mediante código.
No de forma automática. Modifica la ruta de procesamiento, pero el archivo sigue requiriendo políticas específicas de acceso, retención, enmascaramiento y eliminación.
Nota editorial: El comportamiento del producto se describe a partir de la documentación pública de TrueForge y TrueFoundry disponible a 10 de septiembre de 2026. Los ejemplos son ilustrativos y deben adaptarse a los requisitos de autorización, privacidad, fiabilidad y cumplimiento de cada aplicación.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




















