October 14, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


Published: October 7, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
A medida que los agentes de IA se vuelven más capaces, el reto ya no es crearlos, sino ejecutarlos de forma fiable en producción. Los desarrolladores necesitan infraestructura para bucles de agentes, gestión de estado, ejecución de herramientas, entornos aislados (sandboxing) y escalado, pero la forma en que se gestionan estas responsabilidades varía significativamente entre plataformas.
Claude Managed AgentsyVercel eve adoptan enfoques fundamentalmente distintos para resolver este problema. Anthropic ofrece un entorno de ejecución totalmente gestionado donde todo el ciclo de vida del agente se opera por ti, mientras que Vercel Eve es un framework de código abierto que te permite controlar el entorno de ejecución y el despliegue, manteniendo la independencia respecto al modelo.
En esta guía, compararemos Claude Managed Agents y Vercel Eve en cuanto a arquitectura, experiencia del desarrollador, herramientas, seguridad y preparación para empresas, para ayudarte a determinar qué plataforma se adapta mejor a tus aplicaciones de IA.
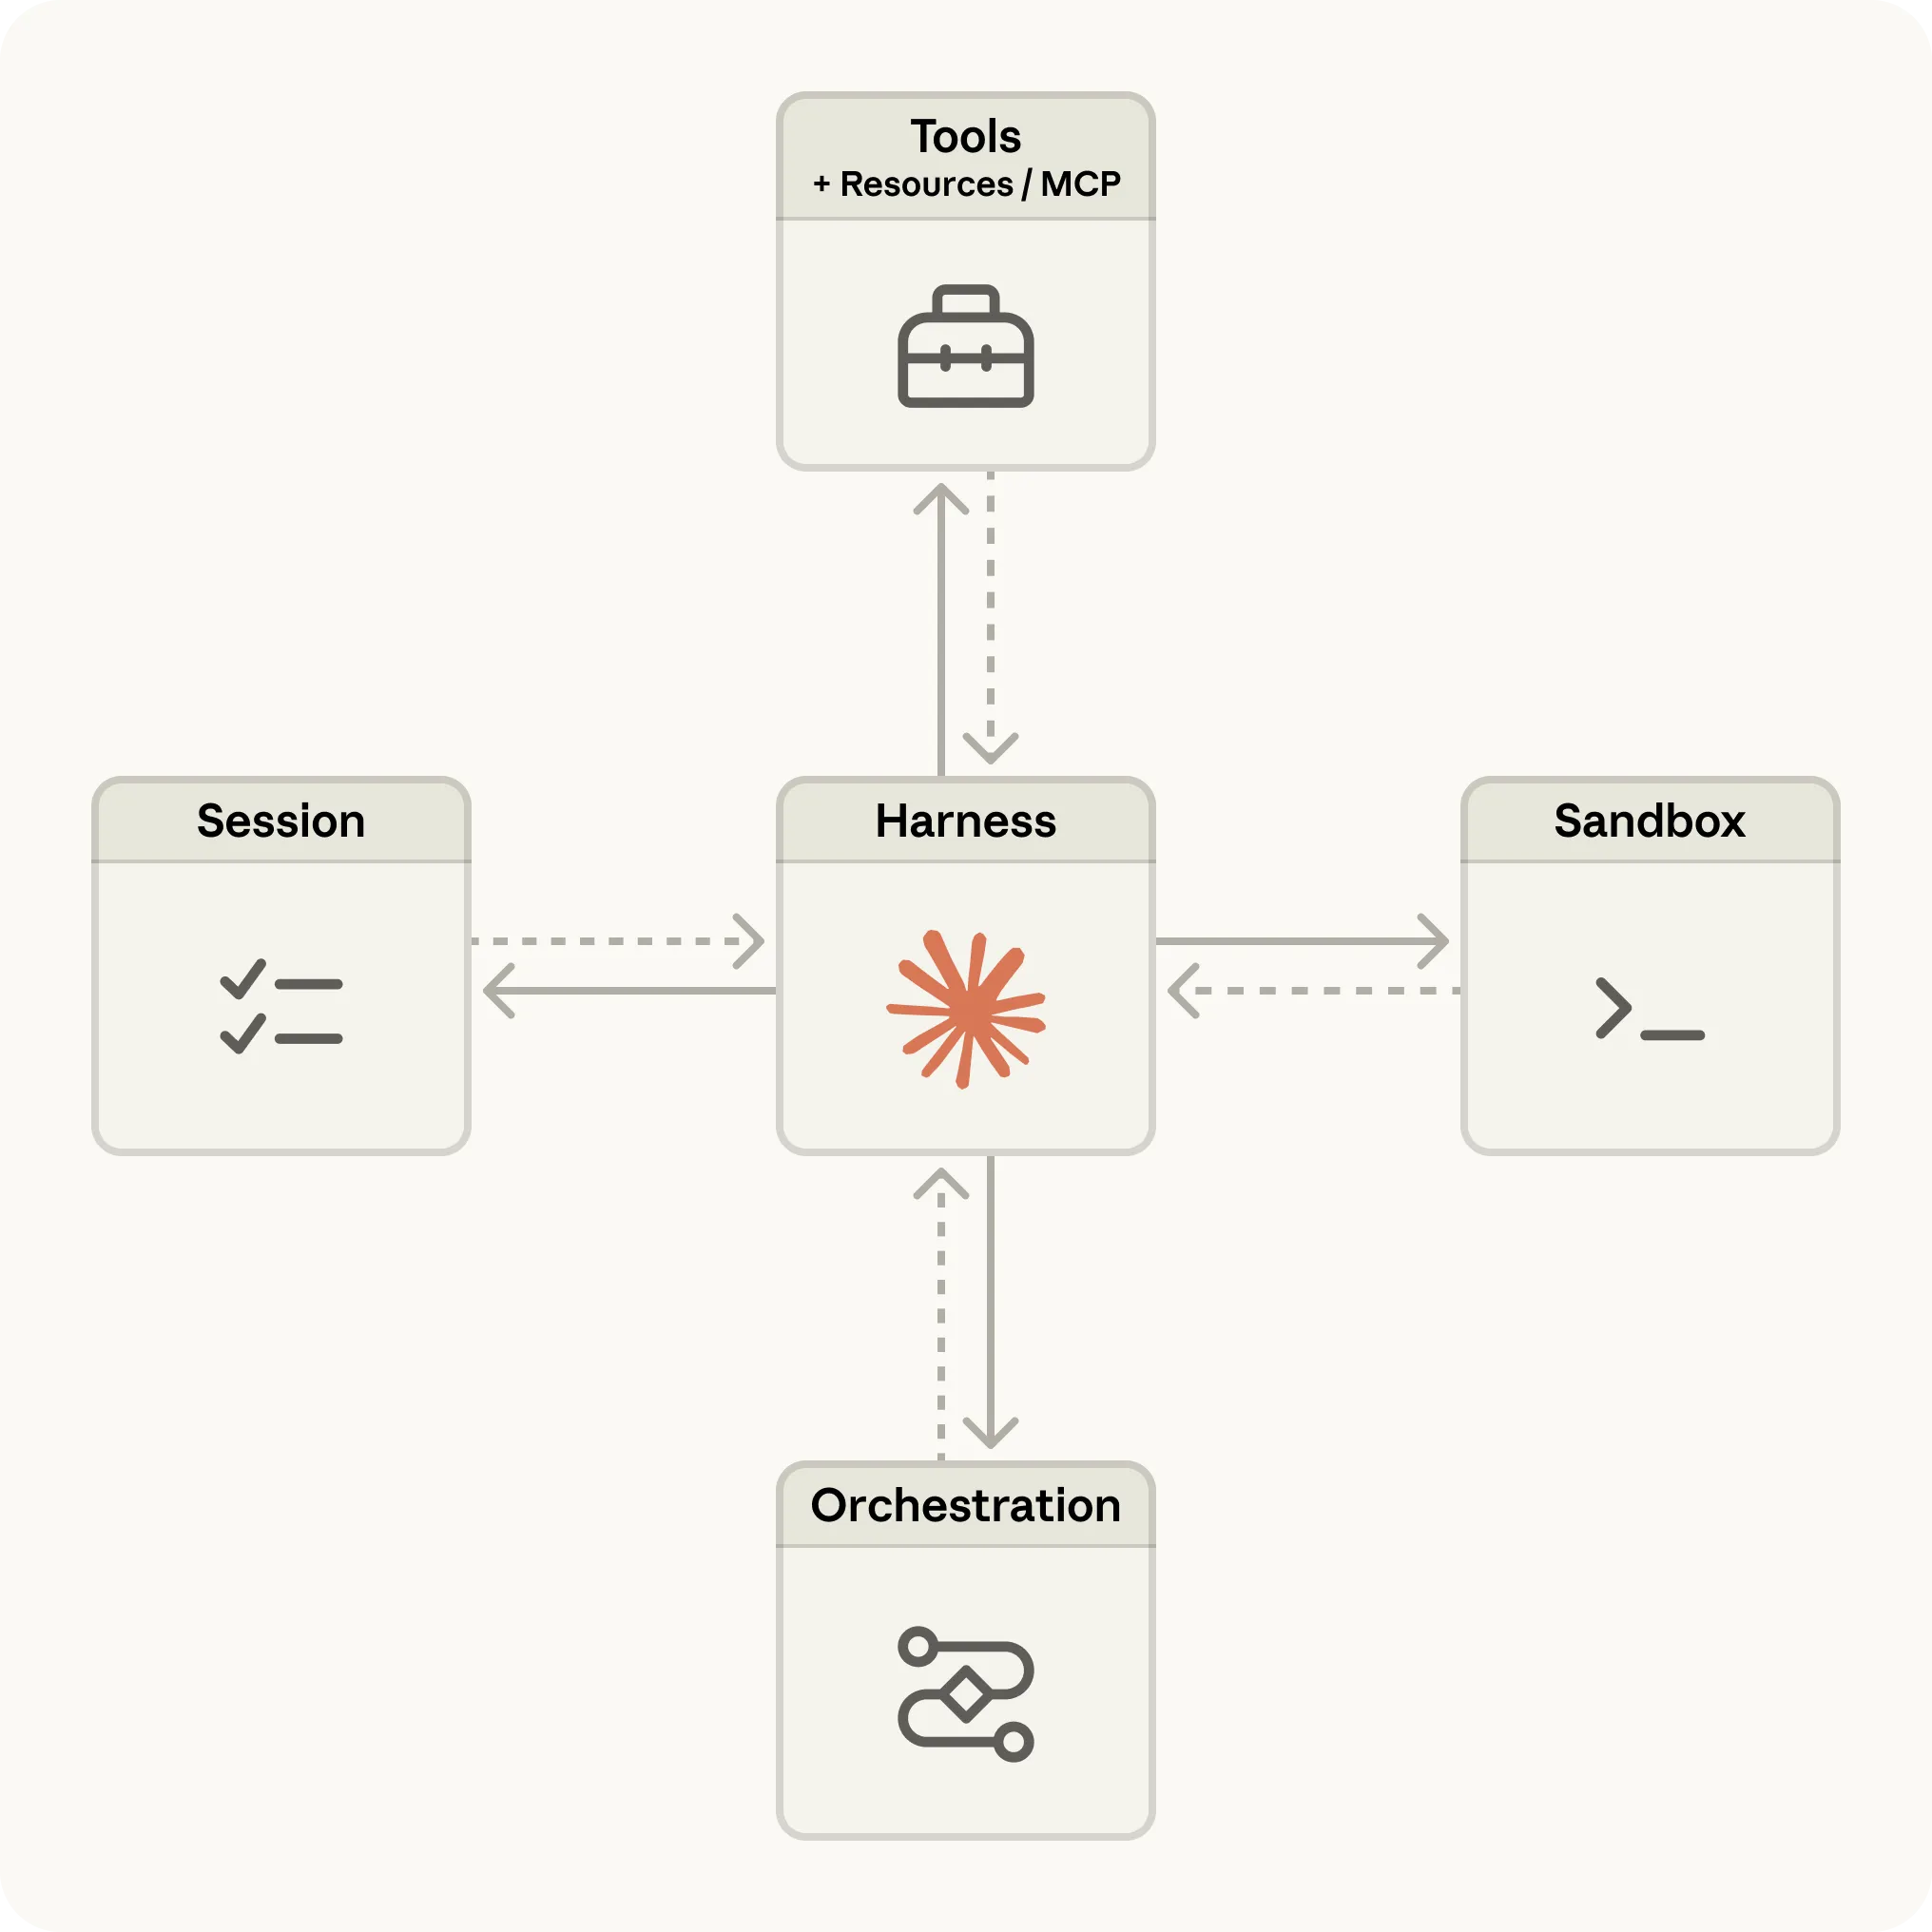
El modelo se basa en tres conceptos: un Agente (modelo, prompt del sistema, herramientas, servidores MCP, habilidades), un Entorno (una plantilla de contenedor que define los recursos del sandbox, paquetes y acceso a la red) y una Sesión (una instancia en ejecución con un sandbox persistente e historial de conversación). Creas el agente una vez y luego inicias sesiones que hacen referencia a él. Las sesiones son controladas por eventos y tienen estado: envías un evento de usuario y luego recibes eventos en streaming (contenido, llamadas a herramientas, estado, uso de tokens) hasta que la sesión queda inactiva. El estado —conversación, sandbox, resultados— se mantiene en el servidor y se reanuda limpiamente tras una pausa.
Anthropic gestiona todo el bucle. No tienes que escribir el ciclo de razonar-actuar-observar; simplemente envías mensajes y lees eventos.
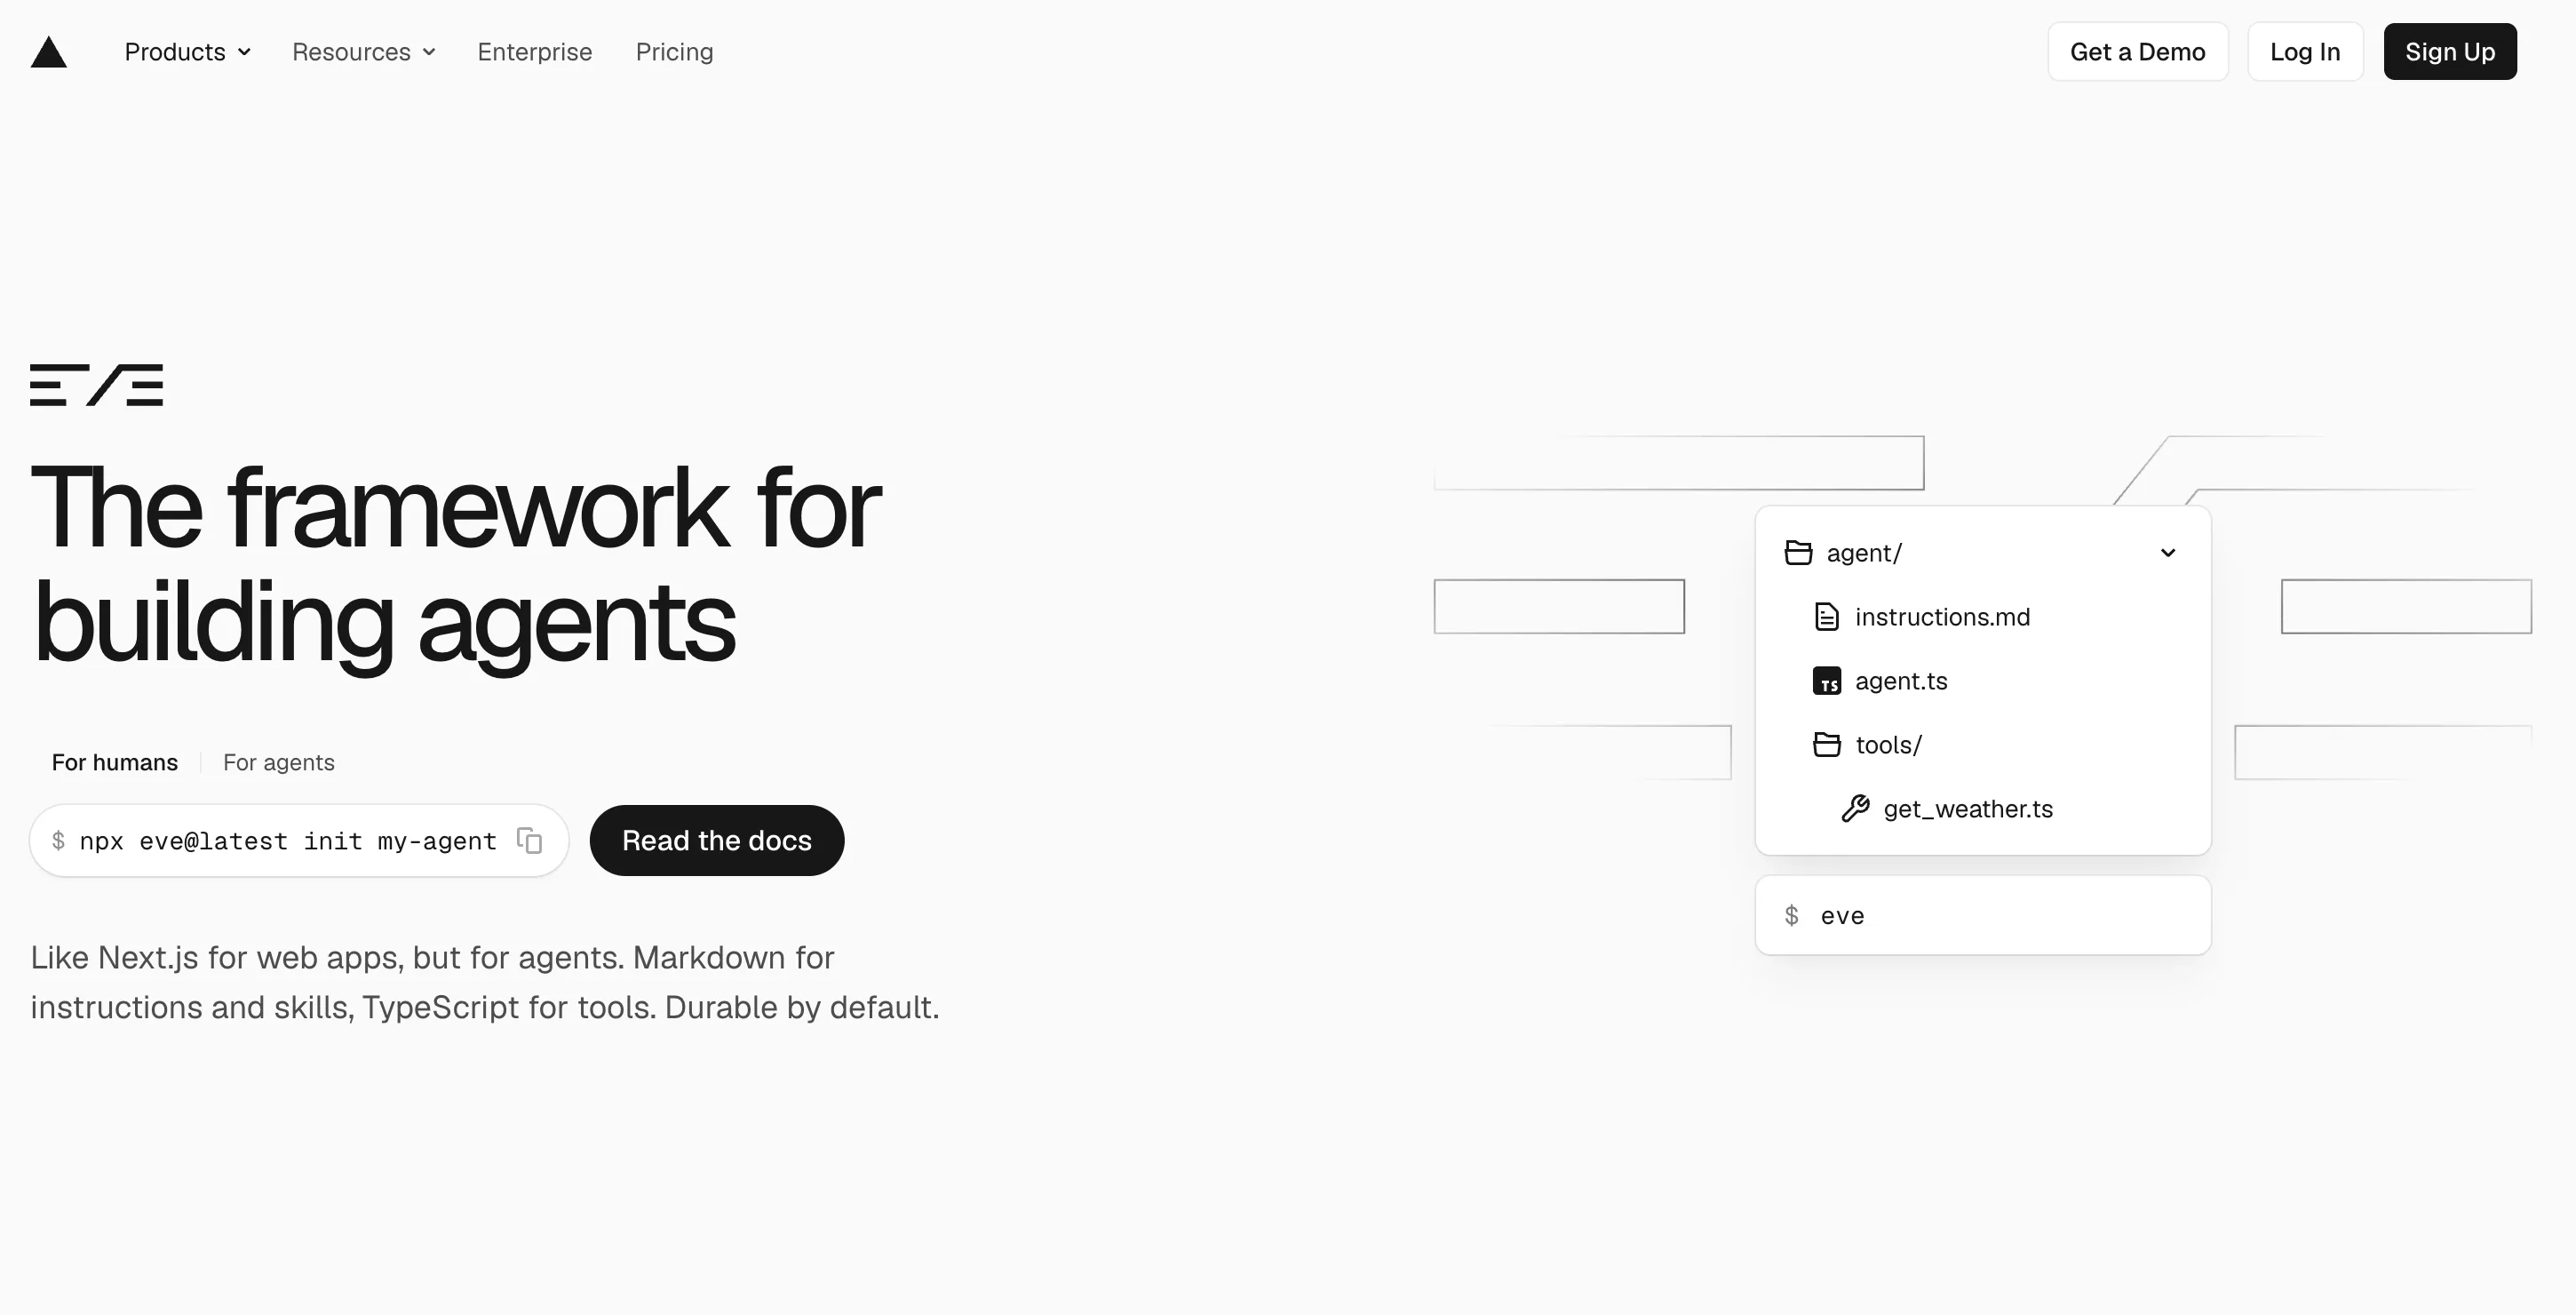
Eve prioriza el sistema de archivos: el directorio es el agente. agent.ts define el modelo, instructions.md es el prompt del sistema, y las carpetas para tools/, skills/, connections/, subagents/, channels/ y schedules/ se asignan a una capacidad de ejecución sin necesidad de código de registro: el nombre y la ubicación del archivo en el árbol definen su función. Eve te proporciona una ruta de mensajes HTTP estable, un flujo de sesión reconectable y un estado de sesión duradero.
La durabilidad es el eje del diseño. Cada conversación es un flujo de trabajo duradero (basado en el SDK de Workflow de código abierto) con cada paso marcado, de modo que una sesión puede pausarse, sobrevivir a un fallo o a un despliegue, y reanudarse exactamente donde se detuvo. Eve expone dos identificadores: un continuationToken para el siguiente mensaje del usuario y un sessionId para streaming e inspección.
Agentes gestionados se configura mediante objetos de API. client.beta.agents.create() acepta el modelo, el prompt del sistema, herramientas, hasta 20 servidores MCP y habilidades; client.beta.sessions.create() hace referencia al agente y a un entorno, y permite sobrescribir el modelo, el sistema, las herramientas, los servidores MCP o las habilidades por sesión sin necesidad de una nueva versión del agente. La experiencia de desarrollo se basa en API y consola: lo gestionas mediante programación e inspeccionas las ejecuciones en la consola de Claude.
Eve se configura mediante código y archivos. Una herramienta es un archivo TypeScript tipado (defineTool con un esquema Zod); una habilidad es un archivo markdown con una descripción; una conexión, subagente, canal o programación es, asimismo, un único archivo. El bucle es eve dev: un servidor local con una interfaz de terminal que muestra cada carga de habilidad, llamada a herramienta y comando de sandbox a medida que ocurren. Dado que el agente son archivos en un repositorio, un cambio en el prompt o en la herramienta es un commit normal con su diff, revisión y despliegue de vista previa.
Agentes gestionados mantiene el estado de la sesión en el servidor y añade almacenes de memoria: colecciones de documentos de texto con ámbito de espacio de trabajo (máximo 2000 memorias, ~100 kB cada una) montadas como solo lectura o lectura-escritura al inicio de la sesión. Una función asíncrona independiente, Dreams, se ejecuta en segundo plano durante minutos u horas para desduplicar y reorganizar un almacén de memoria a partir de transcripciones anteriores. La ejecución asíncrona y de larga duración son elementos de primer nivel.
eve estructura el estado como un estado de flujo de trabajo duradero en lugar de como un producto de memoria. Las sesiones guardan puntos de control en cada paso y sobreviven a fallos y despliegues: una sesión a mitad de tarea finaliza en la versión en la que comenzó. Los agentes pueden esperar a un humano o a un sistema lento durante el tiempo que sea necesario sin consumir capacidad de cómputo. El conocimiento persistente suele llevarse en habilidades, almacenes respaldados por herramientas o en el espacio de trabajo aislado (sandbox) en lugar de en una API de memoria dedicada.
Ambos admiten subagentes. En los Agentes gestionados, un coordinador orquesta a especialistas que comparten un sandbox y credenciales de almacén, pero cada uno se ejecuta en un hilo de sesión con contexto aislado; los agentes pueden actuar en paralelo y el coordinador delega mediante eventos de uso de herramientas personalizadas. En eve, un subagente tiene la misma estructura de directorio un nivel más abajo (sus propias instrucciones, herramientas y sandbox) y el padre lo invoca como si fuera una herramienta; el hijo comienza con una ventana de contexto limpia y devuelve el resultado.
Aquí es donde eve es más amplio. eve trata los canales como elementos de primer nivel: el mismo agente sirve para HTTP, Slack, Discord, Teams, Telegram, Twilio, GitHub y Linear, cada uno con un adaptador de un solo archivo, y las sesiones pueden moverse entre superficies. La aprobación humana es un campo en una herramienta (needsApproval): el agente se pausa indefinidamente, sin consumir cómputo, hasta que se aprueba. Los programas son archivos cron que inician el agente según su propio reloj.
Claude Managed Agents no tiene canales de usuario final integrados; es una API que integras en tus propias superficies. Proporciona políticas de aprobación MCP por llamada (always_ask) como primitiva de aprobación, y la ejecución asíncrona cubre el trabajo programado o en segundo plano, pero la entrega a Slack, Discord, etc., es algo que debes construir tú.
Agentes gestionados factura en dos ejes: tokens de modelo a tarifas estándar más tiempo de ejecución de la sesión (un medidor por segundo para el tiempo de actividad del sandbox); la búsqueda web en la sesión tiene un coste estándar de 10 $ por cada 1000 búsquedas. Se mide por organización con límites de gasto, solo en AWS y restringido mediante cabeceras beta. No hay nada que desplegar: Anthropic lo aloja.
Eve es gratuito y de código abierto; tu coste es la inferencia del modelo (a través de AI Gateway) más la infraestructura en la que lo ejecutes. En Vercel se despliega como un proyecto normal (vercel deploy: los programas se convierten en Cron Jobs, el sandbox cambia a Vercel Sandbox, reversión instantánea disponible); los adaptadores para otras plataformas están en camino. Como es tu código, asumes la responsabilidad operativa que la documentación detalla: las aprobaciones, la salida de red y las restricciones de herramientas dependen de ti.

TrueForge es el entorno de ejecución de agentes de código abierto y neutral respecto al proveedor de TrueFoundry. Gestiona el bucle del agente en torno al modelo, incluyendo la planificación, las llamadas a herramientas, la gestión del contexto, la ejecución en sandbox, las aprobaciones y el estado de la sesión, permitiéndote utilizar tus propios modelos, servidores MCP e infraestructura. Puedes ejecutarlo localmente con npx @truefoundry/trueforge o desplegarlo para un equipo mediante Docker Compose o Helm.
La elección del modelo permanece separada del entorno de ejecución. En la comparativa de TrueFoundry frente a los agentes gestionados de Claude, TrueForge alcanzó aproximadamente la misma precisión en las tareas utilizando cerca de un 40 % menos de tokens al ejecutar ambos en Opus 4.8, lo que supone un ahorro de aproximadamente el 30 % por ejecución. Cuando se realizó la misma comparativa con GLM-5.2 en TrueForge, se obtuvo la misma puntuación de ~11/14 en las tareas con un coste de unos 2,90 $ por ejecución frente a los 11,80 $ de los agentes gestionados de Claude, aproximadamente un 75 % menos de coste.
TrueFoundry también ofrece una segunda palanca para reducir los costes de los modelos mediante el enrutamiento automáticode AI Gateway. En lugar de enviar cada solicitud a un modelo de vanguardia, el enrutamiento automático clasifica las solicitudes según su complejidad y las dirige a diferentes niveles de modelos. En la comparativa de TrueFoundry con 550 prompts, el enrutamiento entre Haiku, Sonnet y Opus redujo el coste en un 69 % manteniendo el 98 % de la calidad base, y la latencia media se redujo de 7,6 segundos a 4,0 segundos. En tráfico de producción, la reducción de costes global alcanzó el 80 %.
Estas dos capas abordan diferentes partes de la ecuación de costes. TrueForge reduce la sobrecarga de ejecutar el propio agente, mientras que el enrutamiento de modelos te permite evitar el uso de un modelo costoso cuando la tarea no lo requiere. Para los equipos que ejecutan agentes a gran escala, disponer de ambos controles puede ser más importante que el precio del modelo por sí solo.
TrueForge es de código abierto y cuenta con licencia MIT, mientras que AI Gateway de TrueFoundry añade la capa operativa que los equipos necesitan al pasar de agentes individuales a producción: acceso centralizado a modelos, presupuestos, medidas de seguridad, gestión de credenciales y trazas unificadas.
Si estás comparando los agentes gestionados de Claude con una arquitectura más configurable, merece la pena considerar TrueFoundry cuando la flexibilidad del modelo, el control de la infraestructura y la optimización de costes de los agentes importan tanto como el propio tiempo de ejecución del agente.
Claude Managed Agents, Vercel eve y TrueForge adoptan enfoques diferentes para ejecutar agentes de IA. Claude Managed Agents prioriza una experiencia totalmente gestionada, mientras que eve ofrece a los desarrolladores más control a través de un marco de trabajo de código abierto centrado en el código.
TrueForge se sitúa entre ambos enfoques: mantiene el arnés del agente de código abierto y agnóstico al modelo, al tiempo que añade la infraestructura y los controles operativos necesarios para los despliegues en producción. Los equipos pueden elegir sus modelos y su entorno de despliegue sin tener que construir ellos mismos los sistemas periféricos para el acceso a MCP, el sandboxing, las aprobaciones, la observabilidad y la gobernanza.
La elección correcta depende, en última instancia, de cuánta infraestructura quieras gestionar. Si la prioridad es minimizar la carga operativa, Claude Managed Agents es la opción más sencilla. Si buscas un marco de trabajo ligero y controlado por el desarrollador, eve es una opción atractiva. Si quieres ejecución de agentes de código abierto con infraestructura empresarial, flexibilidad de modelos y control de costes, merece la pena considerar TrueForge.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada