October 29, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
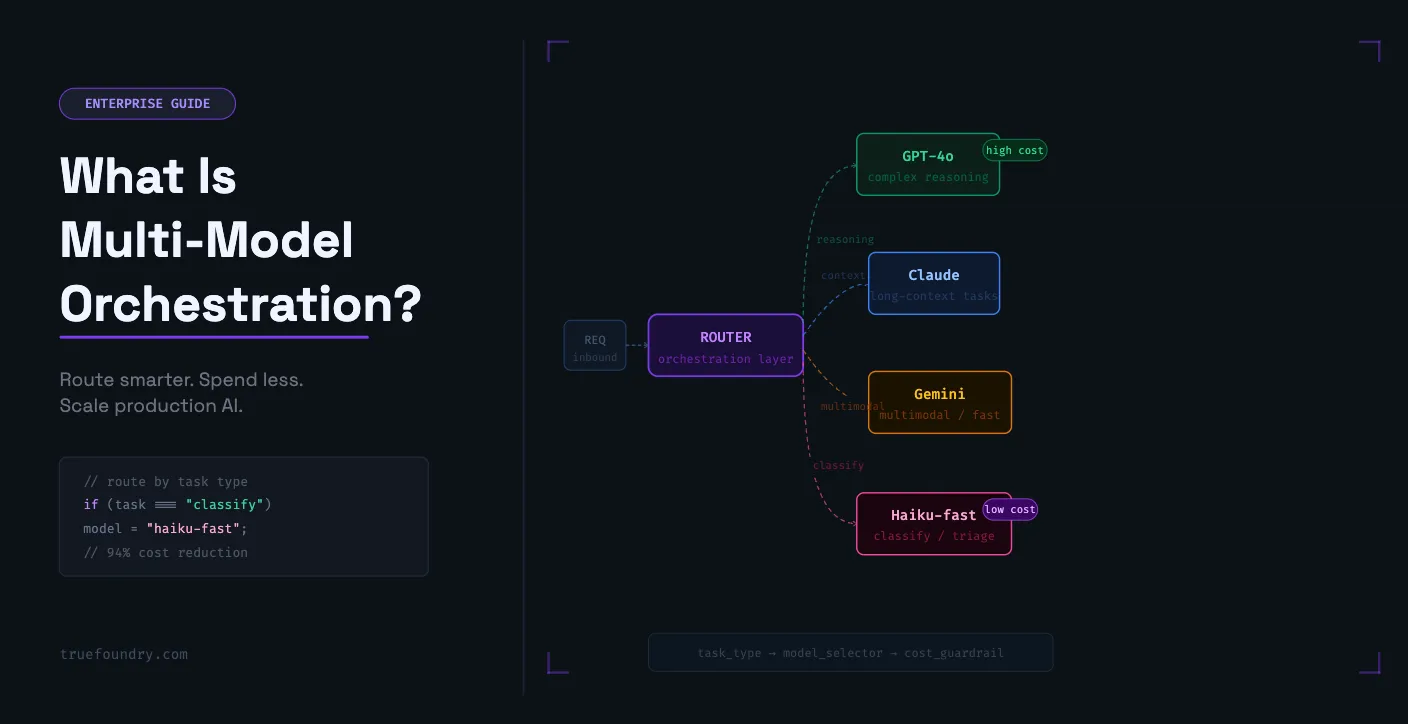
Kein einzelnes Modell ist für jede Aufgabe optimal. GPT-4o eignet sich hervorragend für komplexes Schlussfolgern, während kleinere Sprachmodelle Aufgaben wie Klassifizierung, Routing und Extraktion oft kostengünstiger erledigen. Jede Anfrage an das teuerste Modell zu senden, führt zu unnötigen Ausgaben und beeinträchtigt die Ressourcenallokation in KI-Produktionsteams.
Multi-Model-Orchestrierung operationalisiert diese Unterscheidung. Anstatt jeden Workload an einen einzigen Anbieter zu binden, werden Anfragen basierend auf Aufgabentyp, Kosten, Latenz und Qualitätsanforderungen auf verschiedene Modelle verteilt. Für Produktionsteams ist dies keine bloße Optimierung mehr, sondern die grundlegende Betriebsebene für Enterprise-KI.
Unternehmen betreiben heute KI-Anwendungen über OpenAI, Anthropic, Google, Azure, AWS Bedrock und selbst gehostete Modelle hinweg. Multi-LLM-Orchestrierung hat sich von einem hilfreichen Routing-Muster zu einer zentralen Infrastrukturanforderung entwickelt. Dieser Leitfaden erklärt die Funktionsweise, die Grenzen dieses Ansatzes und wie TrueFoundry durch eine Enterprise-Gateway-Ebene Governance ermöglicht.
Multi-Model-Orchestrierung ist die Praxis, eine Anwendung, einen einzelnen KI-Agenten oder einen Workflow mit mehreren KI-Modellen zu verbinden. Die Orchestrierungsebene leitet jede Anfrage an das Modell weiter, das am besten zur spezifischen Aufgabe, zum Kostenziel, zur Latenzanforderung oder zum Qualitätsschwellenwert passt.
Der Begriff umfasst sowohl statisches als auch dynamisches Routing. Beim statischen Routing werden verschiedene Aufgaben vordefinierten Modellen zugewiesen. Zusammenfassungen können an ein kosteneffizientes Modell gehen, Code-Vervollständigungen an ein spezialisiertes Programmiermodell und tiefgehende Recherchen an ein leistungsfähigeres Reasoning-Modell.
Dynamisches Routing bewertet Benutzereingaben zur Laufzeit. Die Orchestrierungs-Engine kann vor der Weiterleitung Komplexität, Anbieterstatus, Latenz, Kosten und verfügbare Routing-Richtlinien prüfen. Die meisten realen Systeme nutzen beide Ansätze, um ein Gleichgewicht zwischen Geschwindigkeit, Qualität, Ausfallsicherheit und Kosten zu finden.
In beiden Fällen fungiert der zentrale Orchestrator als Schnittstelle zwischen der Anwendung und den zugrunde liegenden Modellen. Er abstrahiert anbieterspezifische APIs, übernimmt das Routing, normalisiert Antworten und verwaltet Failover-Prozesse. Ihre Anwendung hat einen einzigen Einstiegspunkt, während das Gateway die Modellauswahl und das Anbieterverhalten steuert.
Multi-Model-Orchestrierung ist essenziell geworden, da sich KI-Workloads heute stark in Bezug auf Kosten, Risiko, Komplexität und Latenz unterscheiden. Ein Chatbot, der einfache Kundenanfragen beantwortet, benötigt nicht dasselbe Modell wie ein Agent, der regulierte Entscheidungen trifft oder komplexen Code generiert.
Frontier-Modelle sind auf Reasoning-Qualität und Vielseitigkeit optimiert. Kleinere Sprachmodelle sind auf Geschwindigkeit und Kosten bei klar definierten Aufgaben ausgelegt. Die Bindung jedes Workloads an eine einzige Stufe lässt in beiden Fällen ungenutztes Potenzial liegen.
Den gesamten Datenverkehr standardmäßig an große Flaggschiff-Sprachmodelle zu leiten, bedeutet, bei einem Großteil der Anfragen zu viel zu bezahlen. Ein kleineres Modell kann viele Routineanfragen mit derselben Genauigkeit und schnelleren Antwortzeiten bearbeiten. Der umgekehrte Fall führt zu einem anderen Problem: Die Standardisierung auf ein günstigeres Modell kann dazu führen, dass bei wirklich schwierigen Anfragen nur oberflächliche oder inkorrekte Antworten geliefert werden.
Wenn Sie schon einmal beobachtet haben, wie eine Ausgabenkurve ohne erkennbaren Grund ansteigt, ist die Ursache oft simpel: Ein Standardmodell, eine Routing-Regel und keine Möglichkeit, einfachere Aufgaben kostengünstiger zu verarbeiten. Multi-Model-Orchestrierung ist die strukturelle Lösung, da sie jede spezifische Aufgabe dem passenden Modell zuweist.
LLM-API-Anbieter erleben Ausfälle, Ratenbegrenzungen und Leistungsabfälle, die sich direkt auf Produktionsanwendungen auswirken. Die Gateway-Dokumentation von TrueFoundry verweist auf die Statusseiten von OpenAI und Anthropic zwischen Februar und Mai 2025, die wiederholte Vorfälle über einen Zeitraum von vier Monaten belegen.
Das ist kein Einzelfall, sondern die Betriebsumgebung für generative KI-Systeme in der Produktion.
Die Multi-Modell-Orchestrierung mit automatischem Failover leitet Produktions-Workloads an einen verfügbaren Anbieter weiter, sobald der primäre Endpunkt beeinträchtigt ist. Die Anwendung bleibt ohne menschliches Eingreifen oder dringende Maßnahmen des Bereitschaftstechnikers verfügbar. Das Prinzip entspricht dem jeder kritischen Abhängigkeit: Redundanz, Gesundheitsprüfungen und automatisches Fallback.
Regulierte Unternehmen können nicht jede Anfrage an jedes Modell senden. Manche Workloads beinhalten sensible Daten, vertrauliche Informationen, Kundendatensätze oder unterliegen regionalen Datenbeschränkungen. In diesen Fällen müssen Routing-Entscheidungen Richtlinienvorgaben berücksichtigen, nicht nur Kosten oder Latenz.
Eine kontrollierte Steuerungsebene kann Anfragen basierend auf Metadaten, Geografie, Team, Umgebung oder Datenklasse weiterleiten. Dies ist entscheidend, wenn externe Daten, private Datensätze oder eingeschränkte Workflows innerhalb genehmigter Grenzen bleiben müssen.
Bei TrueFoundry können Sie metadata_match-Regeln an ein Ziel binden, sodass dieses nur dann Datenverkehr empfängt, wenn die Anfragemetadaten (oder das eigene tfy_gateway_region-Tag des Gateways) mit einem konfigurierten Wert übereinstimmen, inklusive eines Auffangziels für alle Regionen, die nicht explizit zugeordnet sind.
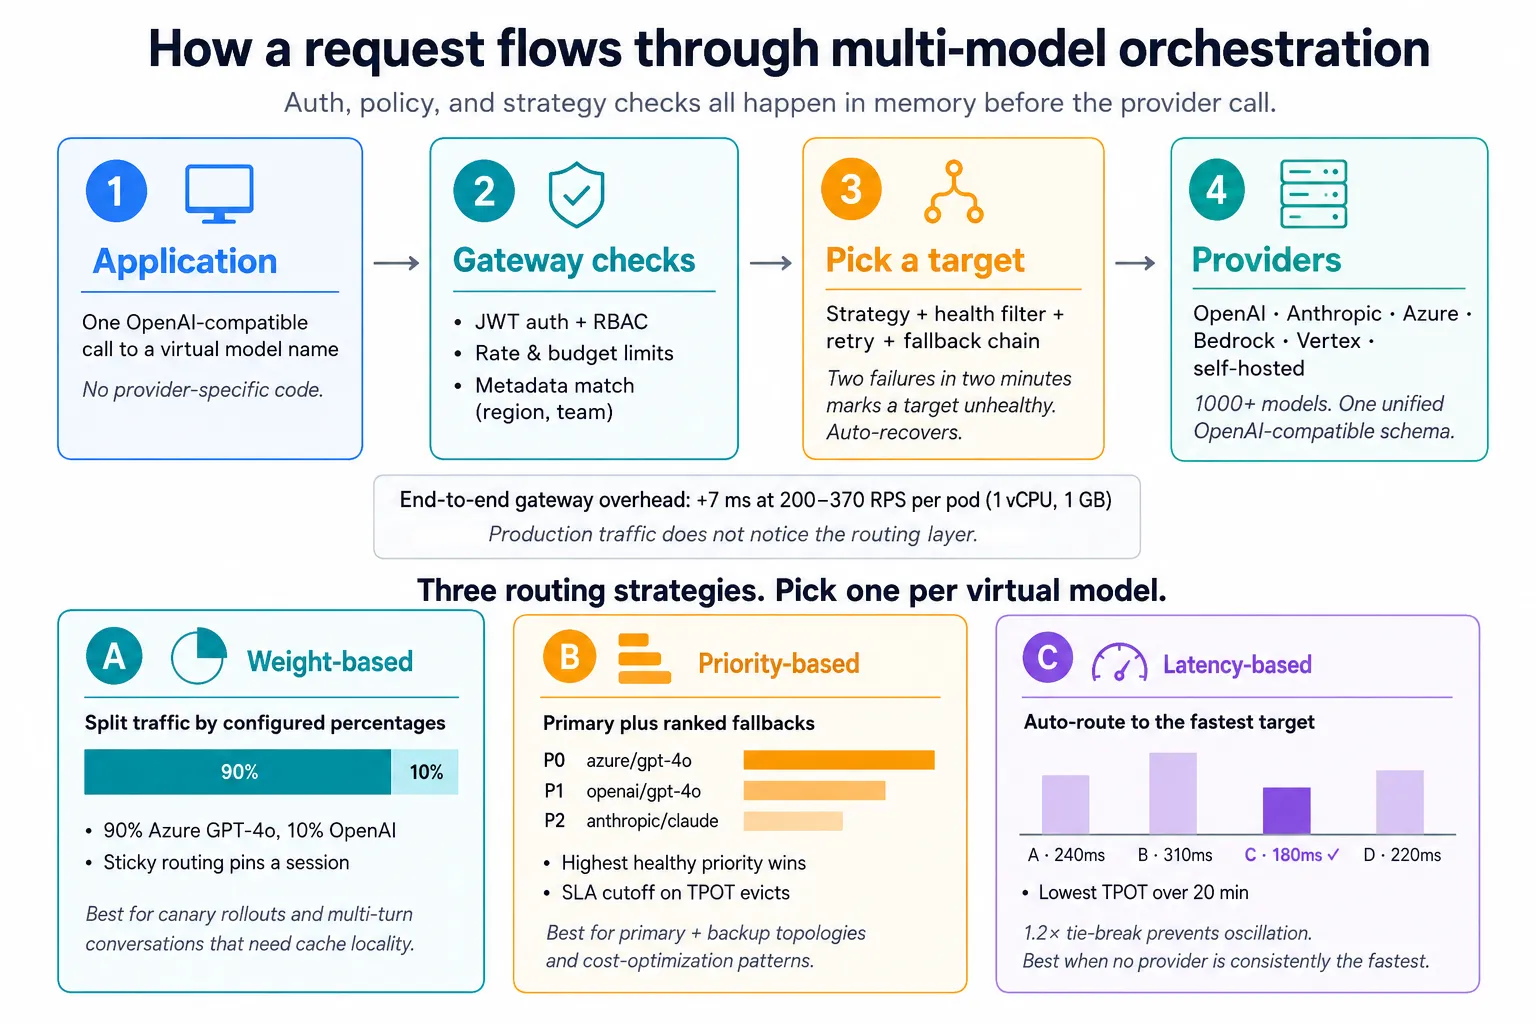
Die Multi-Modell-Orchestrierung basiert in der Regel auf vier Kernkomponenten: einer einheitlichen API-Schicht, Routing-Logik, Failover-Ketten und Antwort-Normalisierung. Gemeinsam ermöglichen sie es Teams, mehrere Anbieter zu nutzen, ohne jede Integration fest in den Anwendungscode zu programmieren.
Jeder Anbieter verwendet unterschiedliche Anfrageformate, Parameternamen, Fehlercodes und Antwortstrukturen. Das KI-Orchestrierungs-Framework normalisiert diese Unterschiede hinter einer einzigen API. Dies bietet Anwendungen eine konsistente Schnittstelle für gehostete, Open-Source- und selbst gehostete Modelle.
TrueFoundrys LLM Gateway stellt ein OpenAI-kompatibles Schema für über 1.000 Modelle bereit. Dadurch können Teams Anbieter hinzufügen oder austauschen, ohne jeden nachgelagerten Dienst ändern zu müssen. Zudem vereinfacht es Prompt-Engineering, Tests und Rollout-Management teamübergreifend.
Diese einheitliche API-Schicht verbessert zudem die Benutzerfreundlichkeit für Entwickler und Plattformteams. Sie vereinfacht Prompt-Engineering, Integrationstests und das Rollout-Management über verschiedene Anwendungen hinweg. Anstatt für jeden Dienst separate, anbieterspezifische Logik zu entwickeln, nutzen Teams einen konsistenten Einstiegspunkt für den Modellzugriff.
Hier verdient die Multi-Modell-Orchestrierung ihren Namen. Die virtuellen Modelle von TrueFoundry unterstützen drei Routing-Strategien, von denen Sie eine pro virtuellem Modell auswählen können:
In TrueFoundry sieht die Konfiguration für ein typisches virtuelles Modell mit Primär- und Fallback-Option wie folgt aus:
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: azure/gpt-4o
      priority: 0
      retry_config:
        attempts: 3
        delay: 200
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai/gpt-4o
      priority: 1
      retry_config:
        attempts: 2
        delay: 100
    - target: anthropic/claude-sonnet
      priority: 2
      fallback_candidate: false
In dieser Konfiguration gehen Anfragen zuerst an azure/gpt-4o. Gemäß dem retry_config-Block versucht das Gateway bei Rate-Limit-Fehlern bis zu 3-mal mit einer Verzögerung von 200 ms, bevor es auf openai/gpt-4o ausweicht. Das Anthropic-Ziel wird nur ausgeführt, wenn es das gesunde Ziel mit der höchsten Priorität ist, niemals als Fallback für die anderen beiden.
All dies geschieht im Arbeitsspeicher.
Keine externen Aufrufe im Anfragepfad.
Diese Routing-Muster unterstützen verschiedene Anwendungen, darunter Kundenservice, Kundensupport, Konfliktlösung, Programmierassistenten, Compliance-Workflows und interne Unternehmens-Copiloten.
Failover-Ketten definieren eine nach Priorität geordnete Liste von Anbietern für jede Routing-Regel. Wenn das primäre Ziel einen Fallback-Statuscode zurückgibt (TrueFoundry-Standards: 401, 403, 404, 429, 500, 502, 503), versucht das Gateway das nächste geeignete Ziel, anstatt den Fehler an die Anwendung weiterzuleiten.
Dieses Muster ist besonders nützlich für komplexe Workflows und autonome Agenten. Wenn ein Agent auf mehrere Modellaufrufe angewiesen ist, kann ein einzelner Anbieterausfall den Workflow unterbrechen. Automatisches Failover schützt die Benutzererfahrung ohne menschliches Eingreifen.
Es gibt auch eine Wiederholungslogik für dasselbe Ziel, bevor ein Fallback greift. Die Standardeinstellungen des Gateways sind 2 Wiederholungsversuche mit einer Verzögerung von 100 ms bei 429, 500, 502, 503. Jedes Ziel kann diese Standards innerhalb seines eigenen retry_config-Blocks überschreiben. Im obigen YAML überschreibt azure/gpt-4o diese Standards auf 3 Wiederholungen bei 200 ms, während openai/gpt-4o sie explizit auf 2 Wiederholungen bei 100 ms festlegt (entspricht den Standards). anthropic/claude-sonnet hat keinen retry_config-Block und übernimmt daher die Standards. Das Gateway verfolgt Fehler kontinuierlich. Wenn ein Ziel innerhalb eines gleitenden 2-Minuten-Fensters 2 oder mehr Fehler verursacht, wird es als nicht gesund markiert und übersprungen, bis die Fehler veraltet sind, gefolgt von einer automatischen Wiederherstellung. Kein menschliches Eingreifen und keine manuellen Konfigurationsänderungen, wenn eine Störung behoben ist.
Verschiedene Modelle liefern Antworten in unterschiedlichen Formaten, mit unterschiedlichen Metadaten, Abschlussgründen und Token-Zählformaten. Die Orchestrierungsschicht normalisiert all dies. Ihr Code liest dieselbe Antwortstruktur, egal ob die Anfrage an OpenAI, Anthropic oder ein selbst gehostetes Llama ging.
Zur Fehlerbehebung gibt TrueFoundry das tatsächliche Ziel, das die Anfrage bedient hat, im Antwort-Header x-tfy-resolved-model zurück. So können Sie nachverfolgen, welches Modell eine bestimmte Ausgabe erzeugt hat, selbst wenn der Name des virtuellen Modells zehn mögliche Ziele abdeckt. Diese Transparenz ist wichtig, wenn Sie eine Qualitätsverschlechterung untersuchen und wissen müssen, ob Ihre Sticky-Routing-Konfiguration den Benutzer beim gleichen Anbieter gehalten oder mitten in einer Sitzung gewechselt hat.
Multi-Modell-Orchestrierung schafft Wert, wenn Teams Routing-Entscheidungen mit Geschäftsergebnissen verknüpfen. Das Ziel ist nicht, mehr Modelle zu verwenden. Das Ziel ist es, für jede Anfrage das richtige Modell anzuwenden und gleichzeitig Kosten, Qualität, Verfügbarkeit, Compliance und Governance zu verbessern.
Ein Support-Workflow kann beispielsweise routinemäßige Kundenanfragen an ein kleineres Modell weiterleiten. Komplexe Abrechnungsstreitigkeiten oder technische Supportfälle können an ein leistungsfähigeres Modell gesendet werden. Dies verbessert die Kostenkontrolle, ohne die Antwortqualität zu beeinträchtigen.
In einem anderen Anwendungsfall kann ein Unternehmens-Forschungsassistent ein Modell für das Verständnis natürlicher Sprache, ein weiteres für den Datenabruf und ein drittes für die Generierung natürlicher Sprache verwenden. Die Orchestrierungslogik entscheidet, welches Modell oder welcher Agent zur endgültigen Antwort beiträgt.
Diese Architektur verschafft Unternehmen einen Wettbewerbsvorteil, da die Modellwahl operativ wird. Teams können Routing-Regeln anpassen, Anbieter testen, Kosten senken und die Antwortqualität verbessern, ohne jede KI-Anwendung neu erstellen zu müssen.
Routing allein ist noch keine Governance.
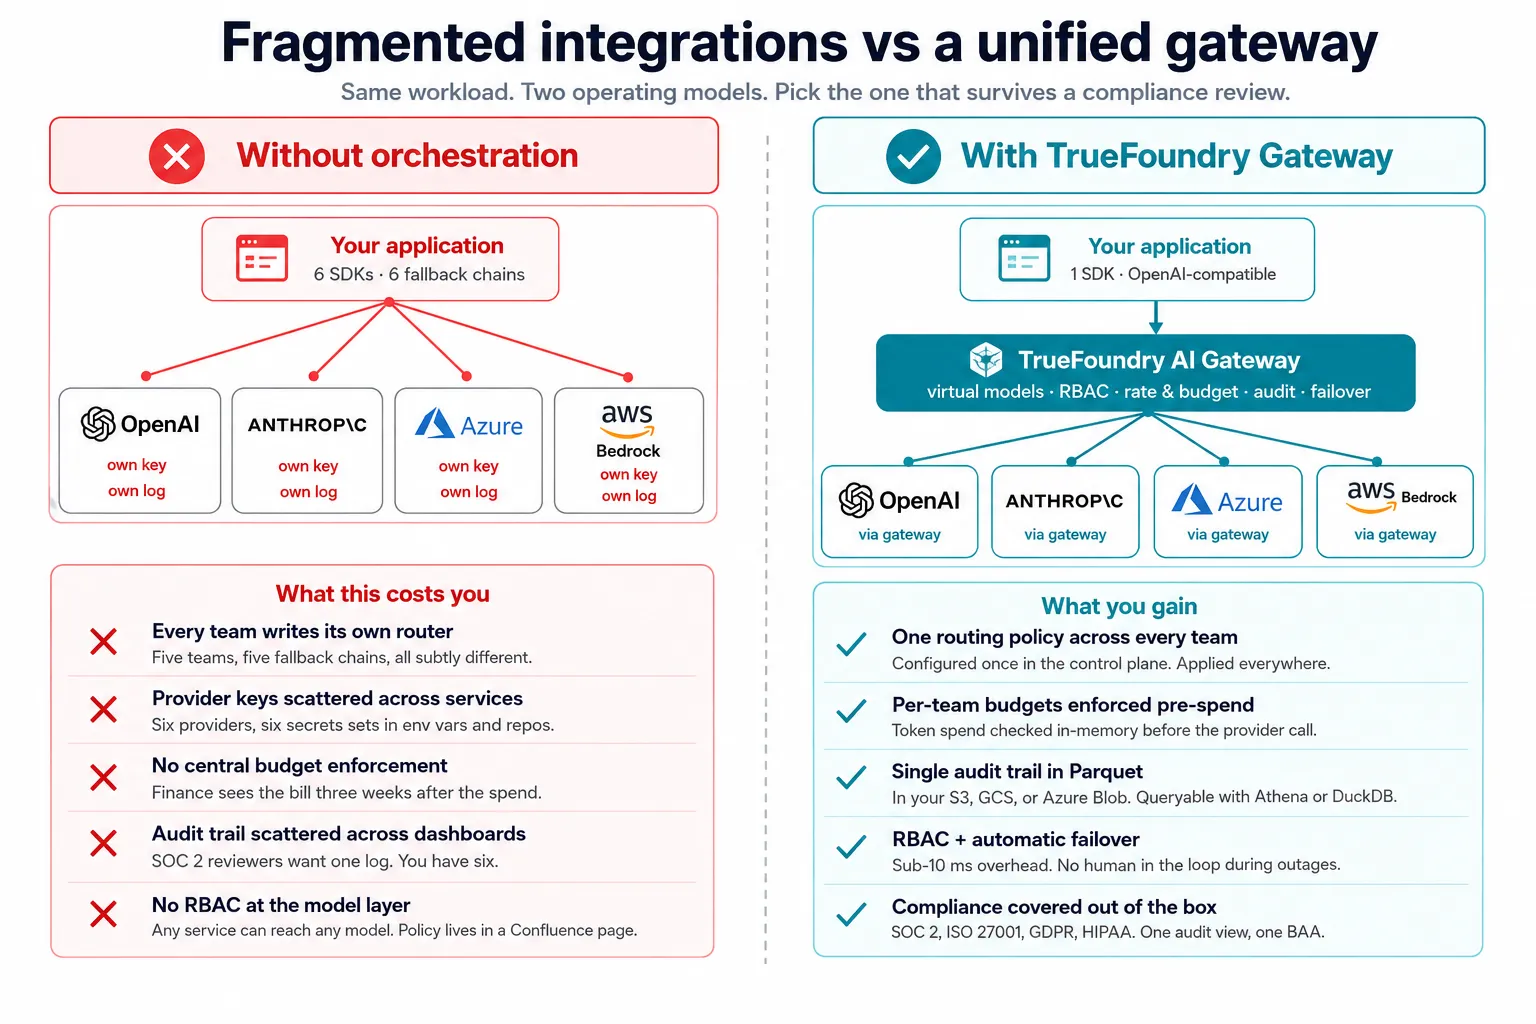
Viele Teams entwickeln ihren eigenen Router, bekommen die Lastverteilung mathematisch in den Griff und stehen dennoch plötzlich vor vier Problemen, die sie nicht auf dem Schirm hatten.
Anwendungsspezifisches Routing bedeutet, dass jedes Team seine eigene Version derselben Logik schreibt. Fünf Teams, fünf leicht unterschiedliche Fallback-Ketten, fünf Sätze von Provider-Schlüsseln, die in Umgebungsvariablen herumschwirren. Diese Inkonsistenz summiert sich auf Unternehmensebene und macht aus „Wir haben Multi-Modell-Orchestrierung“ ein „Jedes Team hat seine eigene Multi-Modell-Orchestrierung“.
Kein Routing-Framework erzwingt teamweite Budgetlimits, bevor Anfragen ausgeführt werden. Die Token-Kosten summieren sich über alle gerouteten Provider hinweg. Wenn die Finanzabteilung fragt, warum sich die OpenAI-Rechnung verdreifacht hat, ist das Gespräch über das Budget bereits drei Wochen zu spät geführt worden.
Multi-Provider-Routing schafft ein Multi-Provider-Audit-Problem. Protokolle im OpenAI-Dashboard, Protokolle in der Anthropic-Konsole, Protokolle im Azure-Portal. Nichts davon lässt sich zu einem einheitlichen, nutzerbezogenen Audit-Trail zusammenfügen, den SOC 2- und HIPAA- Prüfungen tatsächlich sehen wollen.
Verfügbarkeit ist nicht gleich Zugriffskontrolle. Failover bedeutet, dass jeder verfügbare Provider eine Anfrage bearbeiten kann. Ohne RBAC am Gatewaykann jeder verfügbare Provider auch für Ingenieure oder KI-Agenten erreichbar sein, die eigentlich keinen Zugriff darauf haben sollten. Wenn ein Marketing-Prompt niemals ein Modell erreichen darf, das nur für klinische Arbeitsabläufe zugelassen ist, muss diese Richtlinie am Gateway verankert sein und nicht auf einer Confluence-Seite.
Hier werden auch Context Engineering und State Management zu operativen Herausforderungen. Ein System kann relevante Informationen aus Datenquellen, Wissensdatenbanken, Vektordatenbanken und externen Quellen abrufen. Ohne eine kontrollierte Steuerungsebene kann das gesamte System Informationen preisgeben oder Anfragen falsch routen.
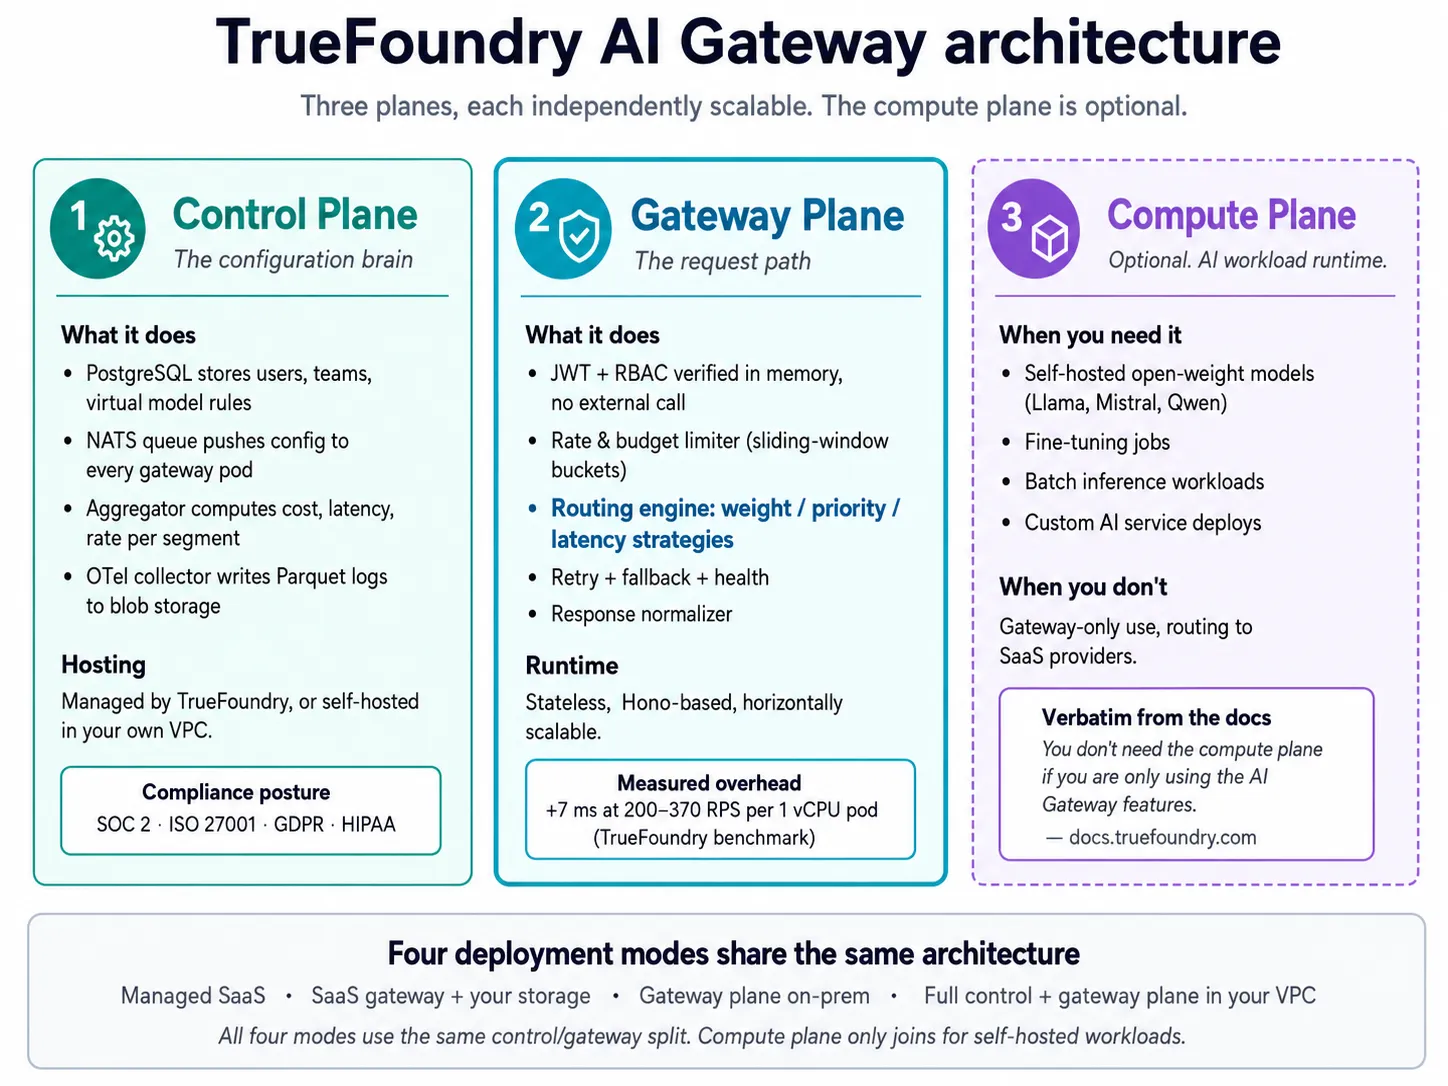
Das LLM Gateway von TrueFoundry bietet Multi-Modell-Orchestrierung als eine über die Control Plane verwaltete Routing-Schicht, die als Managed SaaS, hybrid oder vollständig in Ihrer eigenen VPC betrieben werden kann. Vier Eigenschaften sind für produktive Implementierungen entscheidend.
Das AI Gateway bietet umfassendere Governance, Ratenbegrenzung, Budgets, Leitplanken und Observability für KI-Workloads in der Produktion. Das MCP Gateway steuert den Werkzeugzugriff, die Authentifizierung und die Sichtbarkeit von MCP-Servern für modellbasierte Anwendungen. Das Agent Gateway steuert autonome Agenten, spezialisierte Agenten und komplexe Workflows, bei denen ein einzelner KI-Agent mehrere Modell- oder Werkzeugaufrufe tätigen kann.
Buchen Sie eine Demo, um zu sehen, wie TrueFoundry Multi-Modell-Routing, Agenten, MCP-Tools und Audit-Trails innerhalb Ihrer VPC steuert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet