



October 28, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Ein Agent, der mit Hunderten von Tools verbunden ist, benötigt nicht bei jedem Modellaufruf Hunderte von Tool-Schemata. Durch verzögertes Laden bleibt der Katalog verfügbar, ohne permanent im Kontext präsent zu sein.
Die Verbindung eines Agenten mit einem Tool-Server beantwortet eine Frage: Welche Funktionen kann die Laufzeitumgebung erreichen? Das Laden jeder Tool-Definition in den Modellkontext beantwortet eine andere: Welche Beschreibungen und Schemata muss das Modell in diesem Schritt berücksichtigen?
Diese Fragen werden oft vermischt. In einer kleinen Demo stellt ein Server eine Handvoll Tools bereit, und das Vorladen ist unbedenklich. In einem Unternehmenskatalog kann ein Agent jedoch mit vielen MCP-Servern verbunden sein, von denen jeder Dutzende von Operationen bietet. Jede Definition bringt einen Namen, eine Beschreibung, ein Eingabeschema und potenziell ein Ausgabeschema mit sich. Das Modell zahlt diesen Kontext-Preis, bevor es überhaupt weiß, ob der Benutzer eines dieser Tools benötigt.
Das verzögerte Laden von Tools in TrueForge trennt die Erreichbarkeit von der unmittelbaren Sichtbarkeit. Die dokumentierte Standardeinstellung ist: Vorladen deaktiviert. Beim Start sieht das Modell lediglich den Namen und die Beschreibung des MCP-Servers. Einzelne Tool-Schemata werden erst dann erkannt, wenn die Aufgabe sie erfordert.
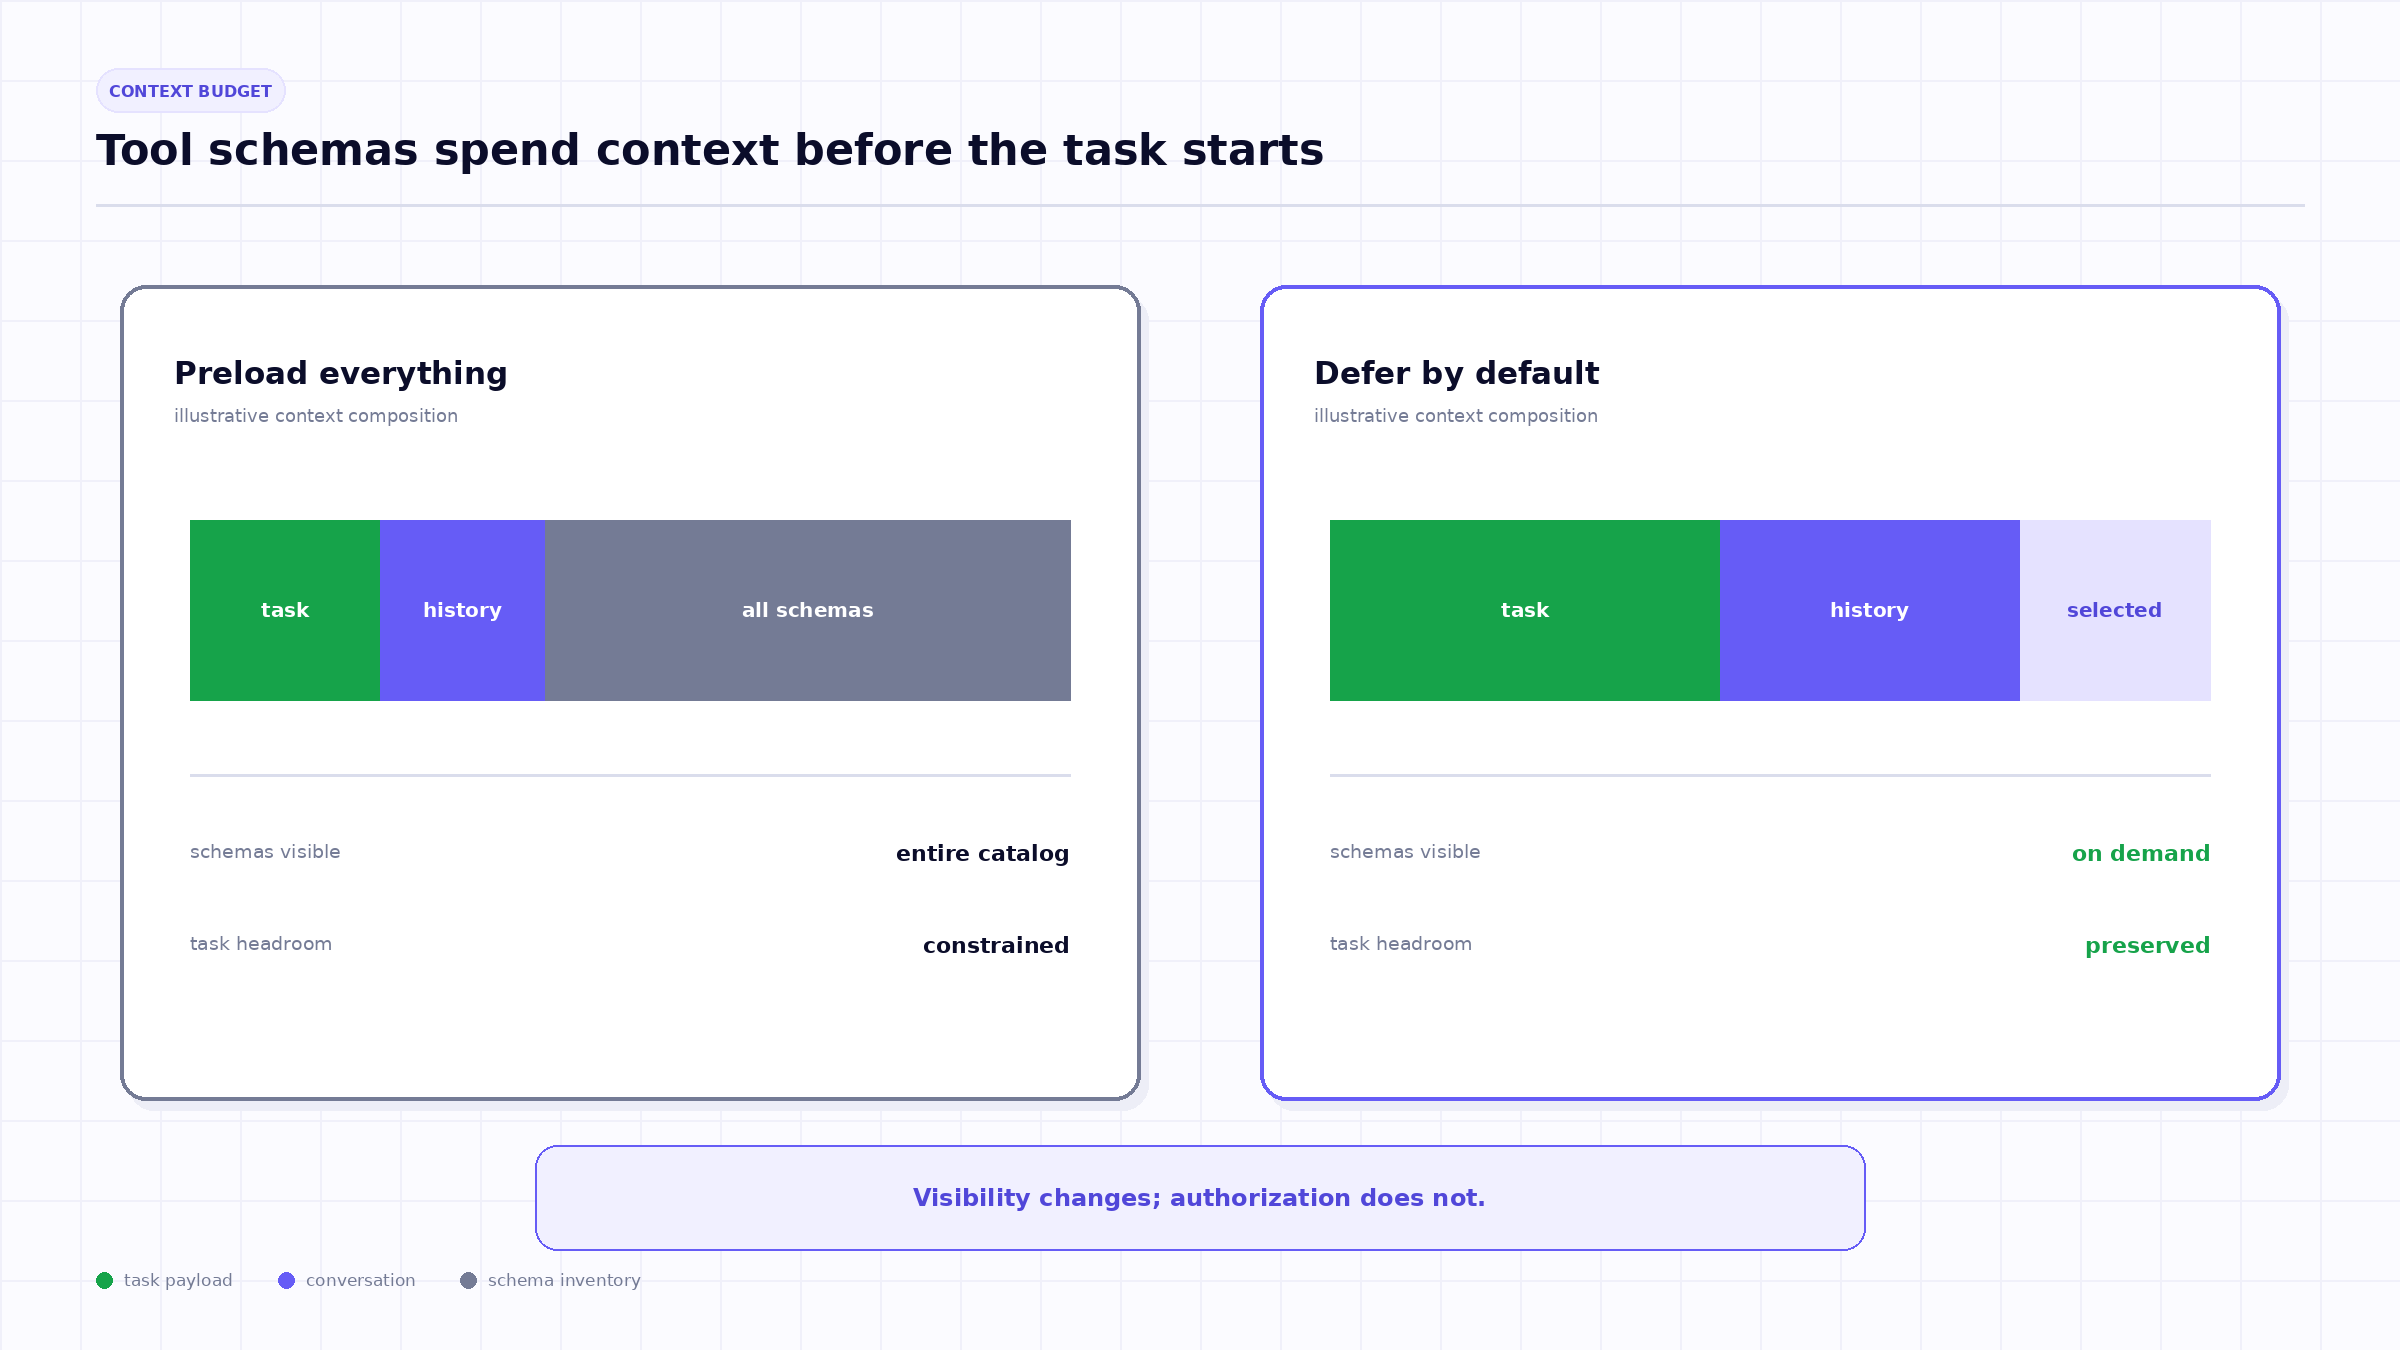
Eine Tool-Definition ist ausführbares Vokabular. Sie teilt dem Modell mit, welche Aktion existiert, wie sie aufgerufen wird und welche Struktur zu erwarten ist. Diese Information kann essenziell sein. Sie kann aber auch bei Tausenden von Anfragen, die das Tool nie nutzen, redundant sein.
Die wiederkehrenden Kosten haben vier Dimensionen:
Das bedeutet nicht, dass „weniger Tools immer besser“ ist. Das Ziel ist die richtige Information zur richtigen Zeit. Vorladen (Preloading) ist nützlich, wenn eine kleine Auswahl an Tools bei fast jedem Schritt benötigt wird und deren Schemata dem Modell helfen, von Anfang an korrekt zu planen.
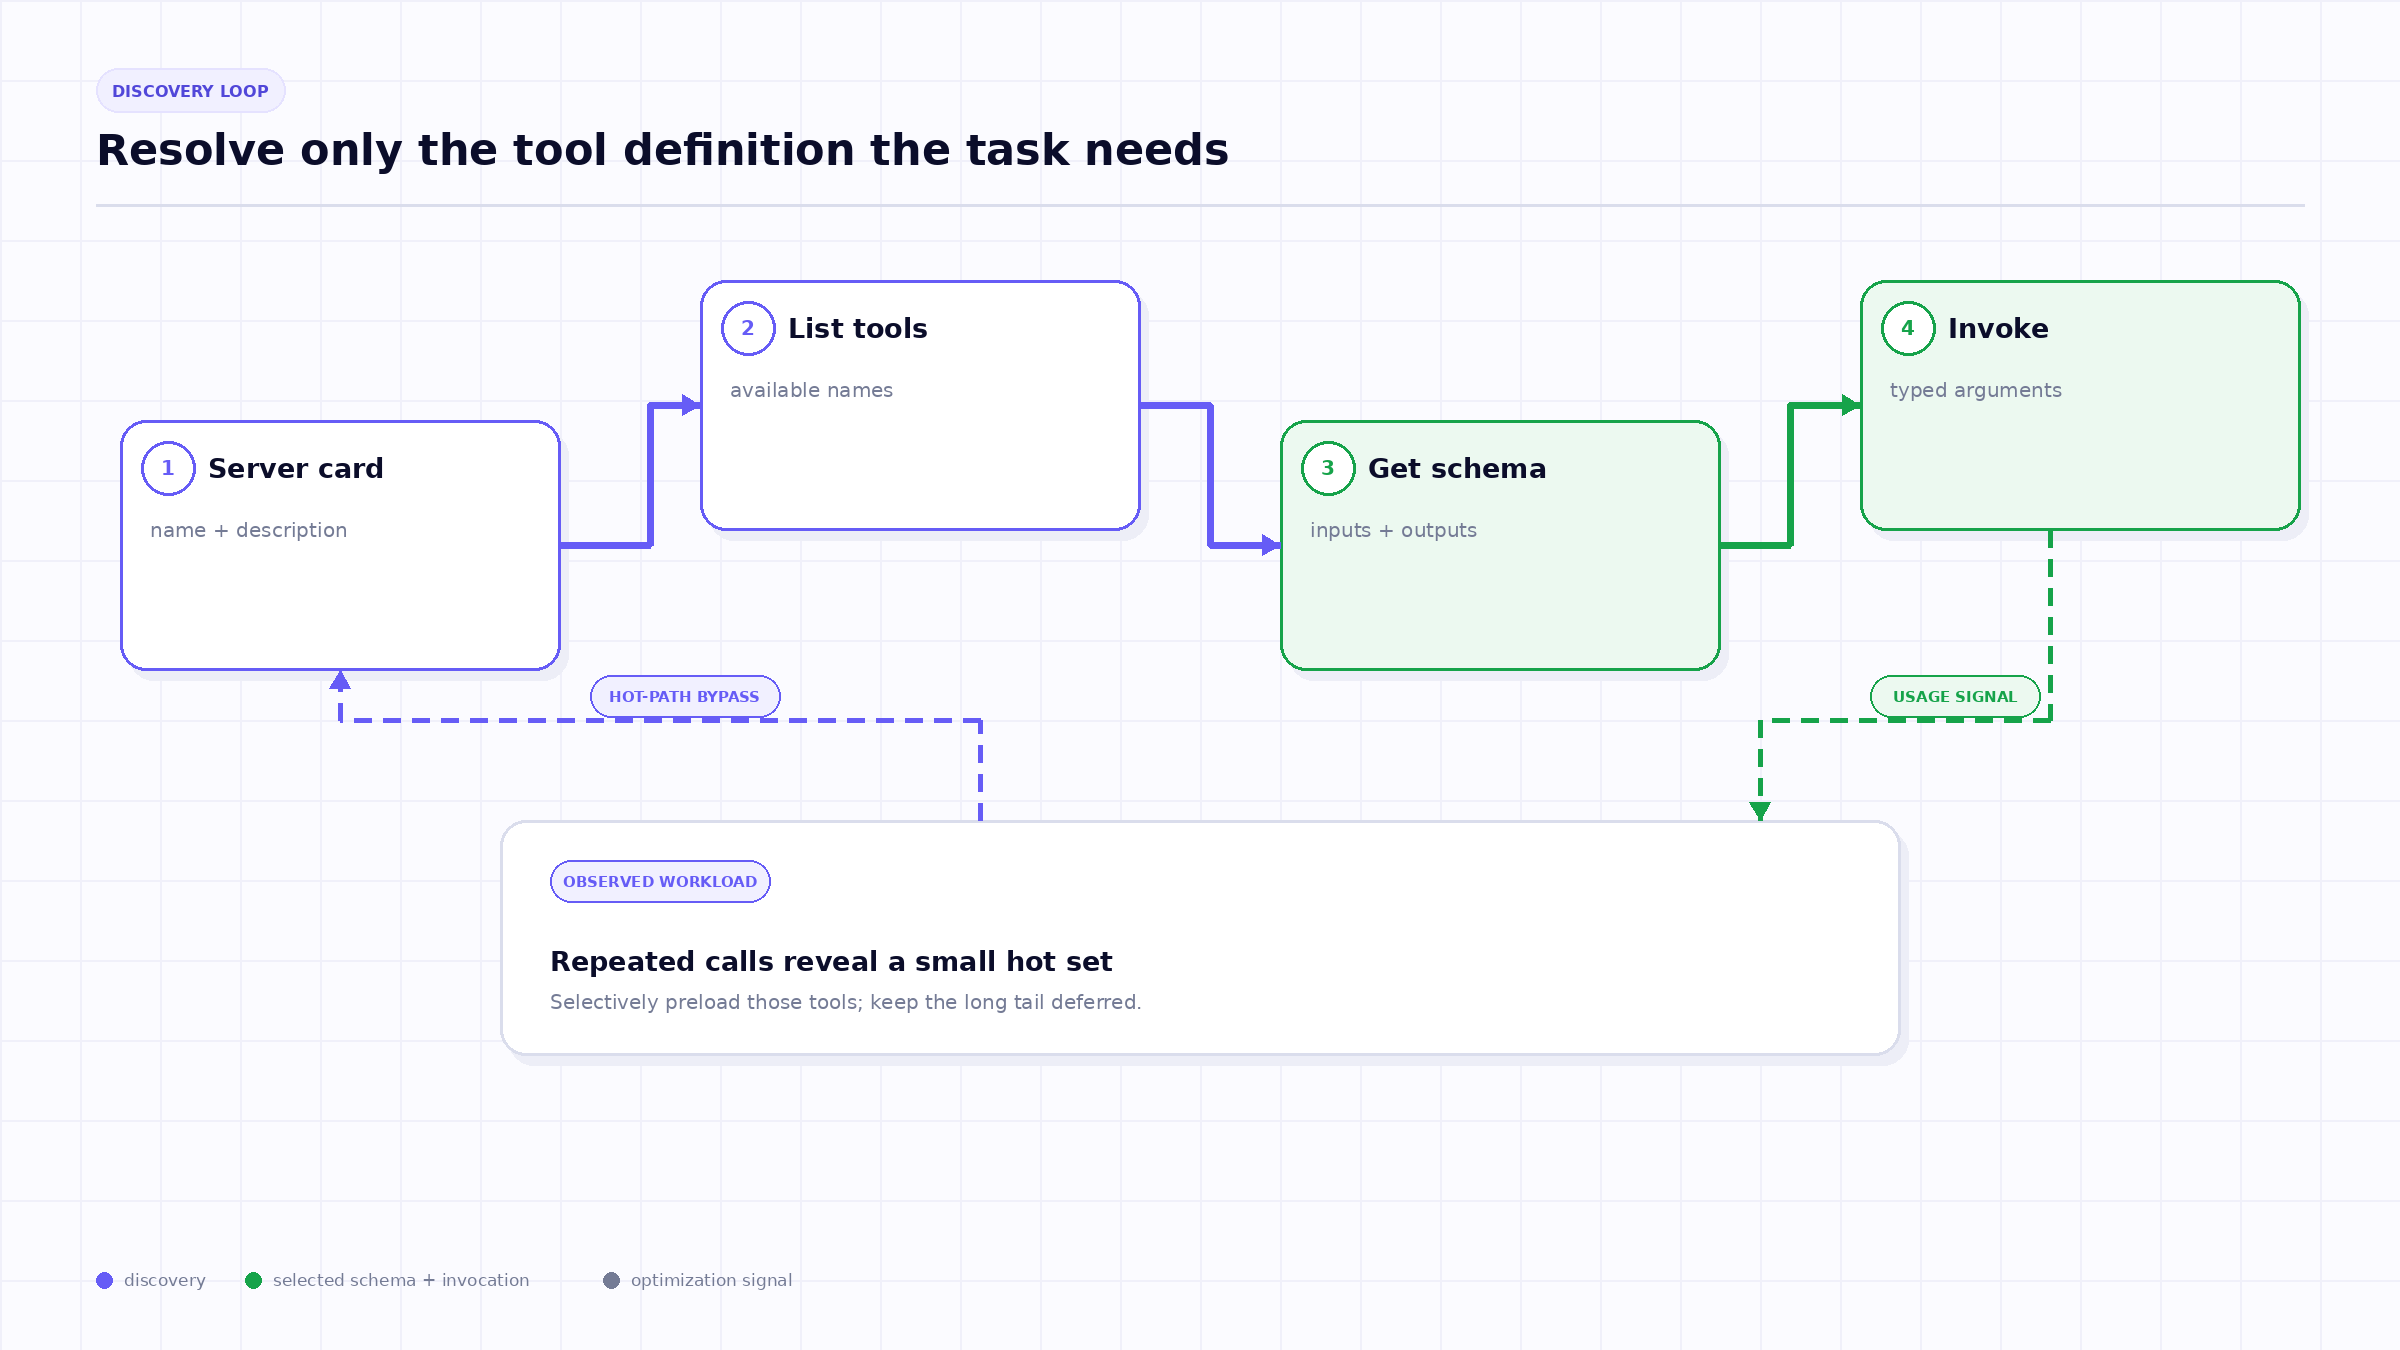
Wenn das Vorladen deaktiviert ist, stellt TrueForge anstelle jeder einzelnen Definition vier Meta-Tools bereit:
Die erste Verwendung erfordert daher eine kurze Planungsschleife. Das Modell erkennt den relevanten Server, listet dessen Tools auf, prüft einen Kandidaten und ruft ihn auf. Die TrueForge-Dokumentation weist darauf hin, dass diese Discovery-Roundtrips beim ersten Bedarf eines Tools stattfinden und kostengünstiger sind, als alle Schemata bei jedem Modellaufruf mitzuführen.
Das ist eine Einschätzung zur Arbeitslast, kein mathematisches Gesetz. Eine schlechte Serverbeschreibung kann das Modell zum falschen Katalog führen. Mehrdeutige Tool-Namen können mehrere Prüfungen erforderlich machen. Ein häufig genutztes Tool neu zu entdecken, kann teurer sein als es vorzuladen. Messen Sie reale Abläufe.
TrueForge erzwingt keine Alles-oder-Nichts-Entscheidung. Die dokumentierte Konfiguration unterstützt es, einen Server zurückgestellt zu lassen, während benannte Tools vorgeladen werden. Dies ist der praktische Mittelweg für einen Server mit einer langen Liste seltener und einer kleinen Menge häufig genutzter Tools.
{
  "mcp_servers": [
    {
      "name": "github",
      "preload": false,
      "preload_tools": ["search_pull_requests"]
    }
  ]
}
Nun ist das häufig verwendete Suchschema sofort verfügbar, während Dutzende administrativer oder selten genutzter Operationen weiterhin entdeckbar bleiben. Die Konfiguration macht die beobachtete Nutzung zu einer Kontextrichtlinie.
Entscheiden Sie nicht allein anhand der Anzahl der Tools. Ein Server mit 100 Tools, der einmal im Monat genutzt wird, sollte in der Regel zurückgestellt bleiben. Ein Server mit 30 Tools, dessen zwei Leseoperationen bei jedem Durchlauf erscheinen, könnte von selektivem Vorladen profitieren. Die relevante Einheit ist die wiederkehrende Kontextbelastung multipliziert mit der tatsächlichen Nutzung – nicht das Prestige des Katalogs oder theoretische Fähigkeiten.
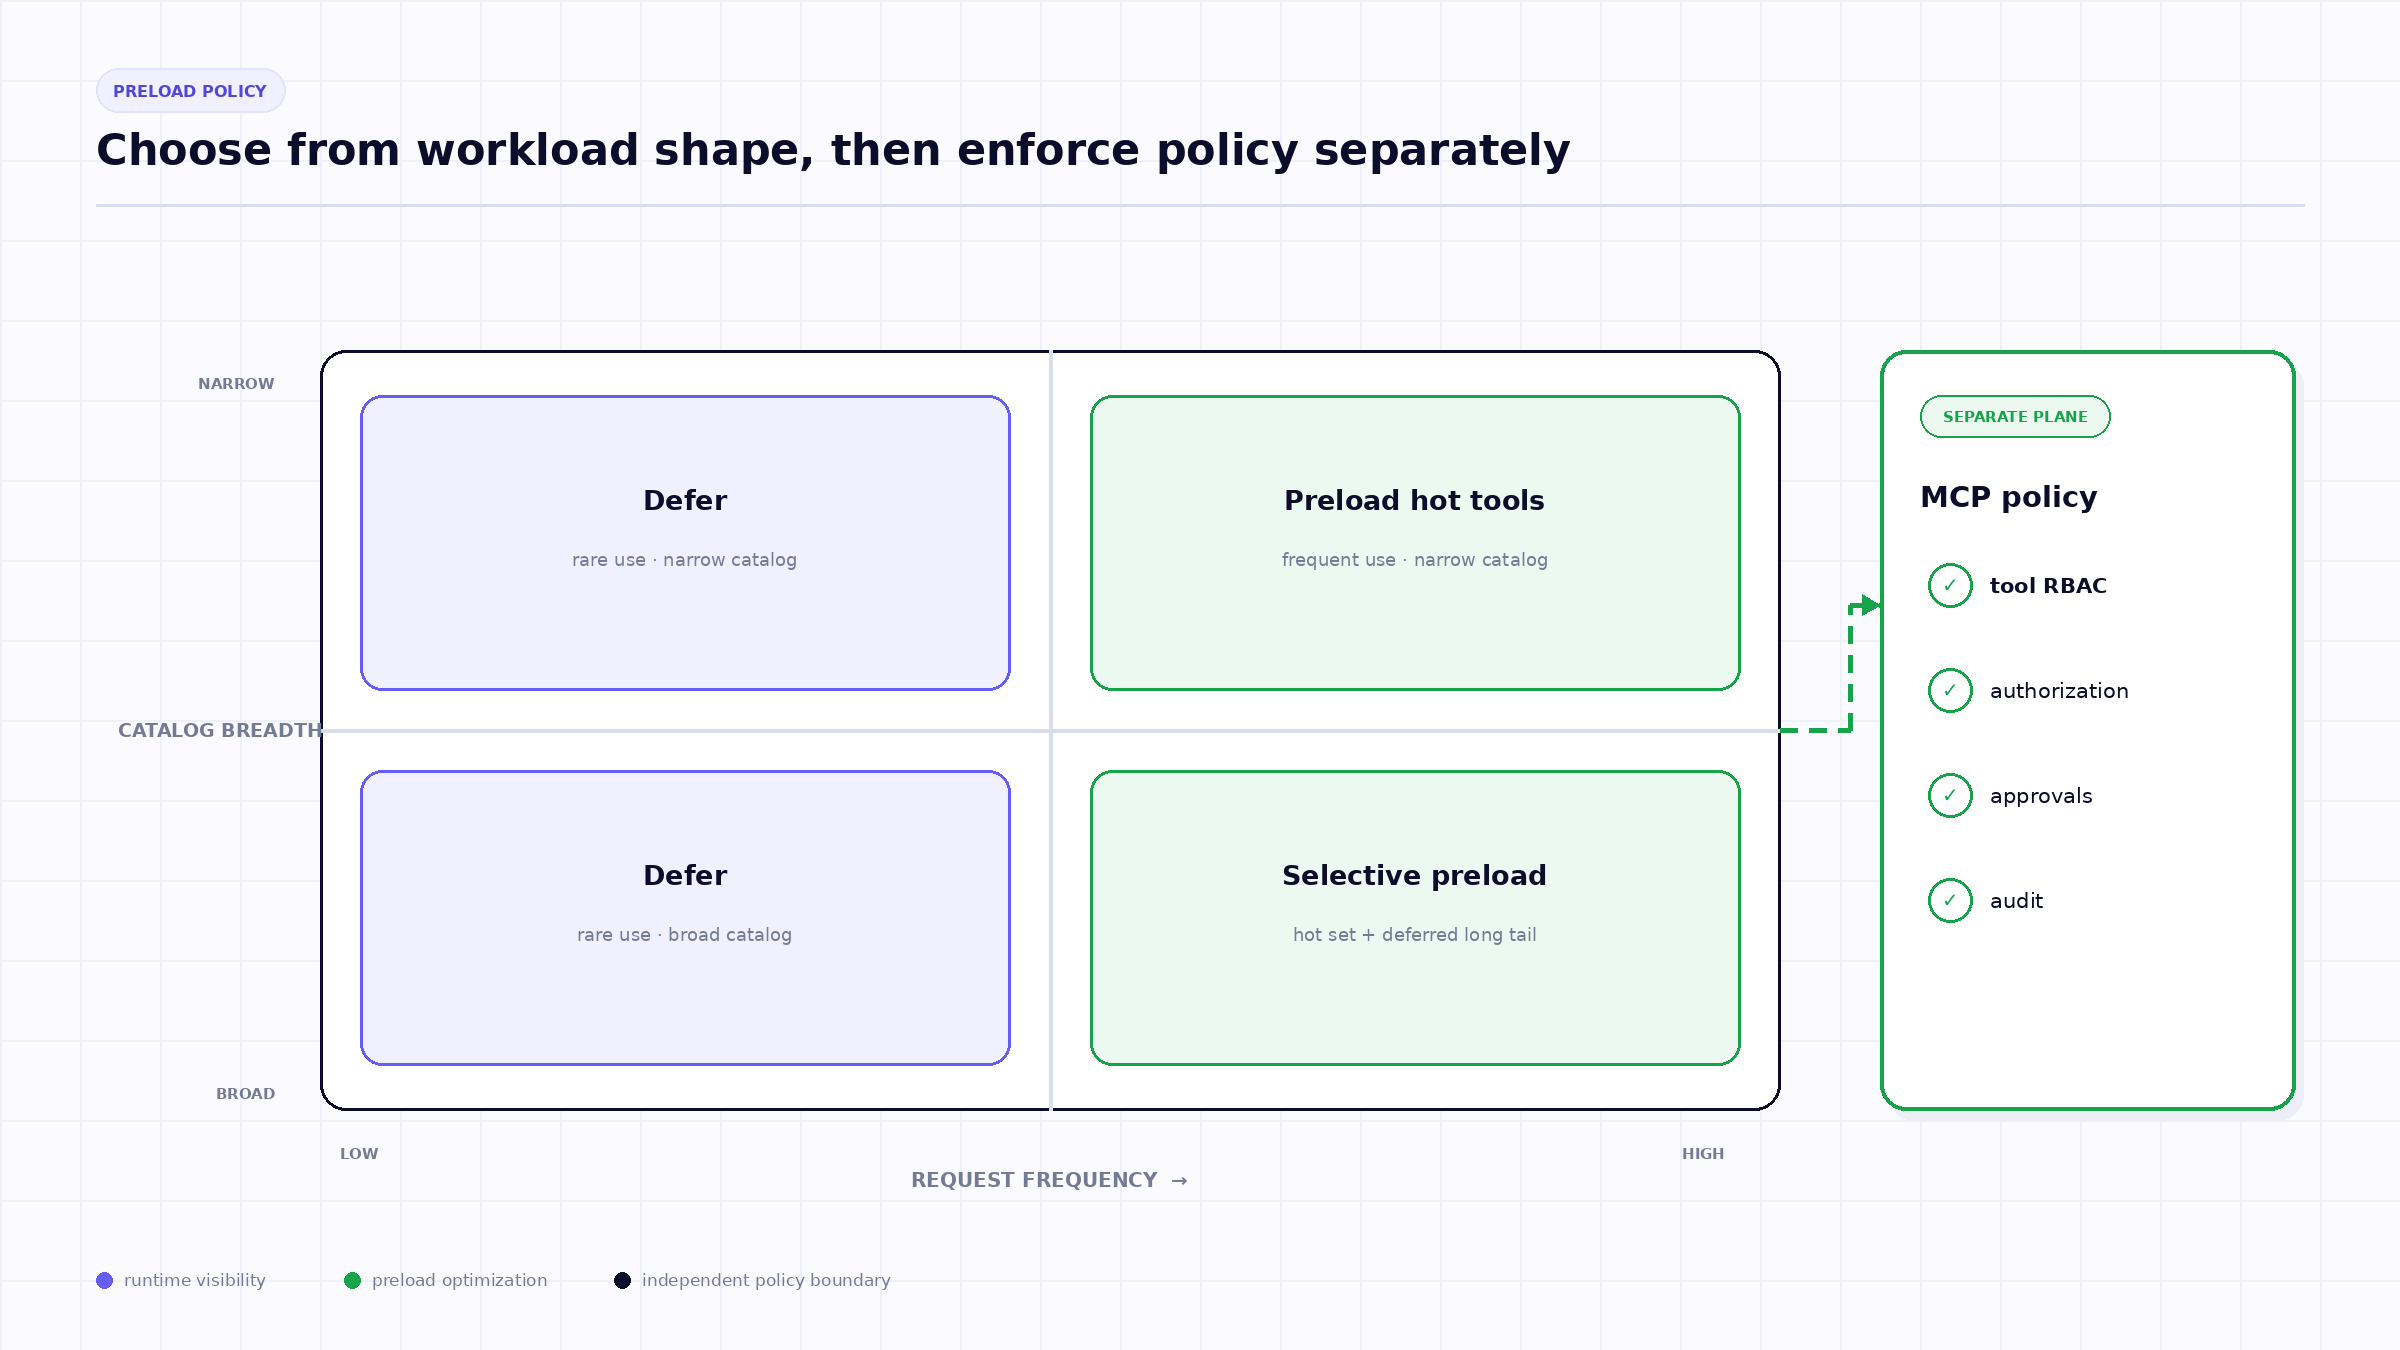
Das Verbergen eines Schemas vor dem initialen Prompt entzieht das Tool nicht. Wenn der Agent es entdecken und aufrufen kann, bleibt die Funktion erreichbar. Die Vorlade-Einstellung von TrueForge steuert die Kontextzusammensetzung. Tool-Freischaltung, MCP-Server-Zusammenarbeit, Identität, Autorisierung, Sicherheitsvorkehrungen und Genehmigungen gehören zu anderen Kontrollebenen.
Diese Unterscheidung ist bei der Untersuchung von Vorfällen wichtig. „Das Schema war nicht vorgeladen“ ist kein Beweis dafür, dass der Agent das Tool nicht aufrufen konnte. Prüfen Sie den effektiven Tool-Katalog, die Zugriffsrichtlinie, die Identität des Anfragenden, die Genehmigungskonfiguration sowie die tatsächlichen Gateway-/Laufzeitereignisse.
Wenn der gesamte Katalog zurückgestellt wird, tragen Servernamen und -beschreibungen mehr Verantwortung. Sie sollten die Domäne, die wichtigsten Aufgabenbereiche und wesentliche Ausschlüsse identifizieren. „Interne Tools“ ist schwach. „Bereitstellungsstatus und Servicemetriken lesen; Produktionsänderungen erfordern einen separaten Operations-Server“ gibt dem Modell eine nutzbare Routing-Grenze.
Tool-Beschreibungen sollten zudem unterscheidbar sein. Zwei Operationen namens „suchen“ und „finden“ mit nahezu identischem Text führen zu vermeidbarem Suchaufwand. Gute Beschreibungen nennen das Objekt, den Umfang, die Nebenwirkungen und wichtige Einschränkungen, ohne zu Mini-Handbüchern zu werden.
Ein entdecktes Schema kann sich ändern. Gehen Sie nicht davon aus, dass ein Schema, das zu einem bestimmten Zeitpunkt geprüft wurde, für immer gültig bleibt oder dass jede Laufzeitumgebung die Erkennung identisch zwischenspeichert. Bewahren Sie die effektiven Server- und Tool-Versionen auf, wenn Reproduzierbarkeit wichtig ist, und behandeln Sie Schema-Diskrepanzen als gewöhnliche Laufzeitfehler.
Prompt-Caching kann bei einigen Modellanbietern die abgerechneten oder rechnerischen Auswirkungen wiederholter statischer Schemata reduzieren, macht irrelevante Definitionen jedoch nicht semantisch kostenlos. Sie prägen weiterhin die Eingabe des Modells und können mit aufgabenrelevanten Informationen konkurrieren. Bewerten Sie die Auswirkungen auf Token-Verbrauch, Latenz und Aufgabenqualität separat.
Die Katalog-Governance sollte auch Änderungen an Beschreibungen berücksichtigen. Wenn eine Serverbeschreibung der erste Hinweis für das Routing ist, den das Modell erhält, kann eine Änderung dieser Beschreibung beeinflussen, welchen Katalog der Agent durchsucht, selbst wenn sich das Tool-Schema nicht geändert hat. Behandeln Sie Beschreibungen als versionierte Laufzeiteingaben: Überprüfen Sie diese, protokollieren Sie die effektive Version und beziehen Sie repräsentative Routing-Aufgaben in Regressionstests ein.
Verzögertes Laden von Tools steuert Definitionen. Die Verarbeitung großer Antworten steuert Ergebnisse. Der Code-Modus steuert Zwischenberechnungen. Sub-Agenten isolieren Arbeitsabläufe. Komprimierung fasst ältere Verläufe zusammen. Jeder dieser Mechanismen wirkt auf eine andere Quelle des Kontextwachstums ein.
Führen Sie Vergleiche anhand repräsentativer Aufgaben durch. Eine geringere Token-Anzahl ist kein Gewinn, wenn die Tool-Auswahl darunter leidet. Ein schnellerer erster Aufruf ist kein Gewinn, wenn jeder nachfolgende Modellschritt neunzig ungenutzte Schemata mitschleppt.
Eine sinnvolle Einführung beginnt mit einer Schattenanalyse. Erfassen Sie, welche vorab geladenen Definitionen vorhanden waren, welche Tools tatsächlich aufgerufen wurden und welche Discovery-Aufrufe bei verzögerter Bereitstellung nötig gewesen wären. Aktivieren Sie dann die verzögerte Bereitstellung für einen begrenzten Agenten und vergleichen Sie die Qualität der Abläufe. So vermeiden Sie, dass eine Kontextoptimierung ohne Belege zu einer flächendeckenden Verhaltensänderung führt.
Verfolgen Sie Fehler auch nach Phasen. „Aufgabe konnte nicht abgeschlossen werden“ ist zu ungenau: Der Agent hat möglicherweise den falschen Server gewählt, das Tool nicht gefunden, das richtige Schema geladen, aber ungültige Argumente erstellt oder das richtige Tool aufgerufen, aber dessen Ergebnis falsch interpretiert. Belege auf Phasen-Ebene zeigen, ob die Preload-Richtlinie für den Fehler verantwortlich ist oder nur in dessen Umfeld liegt.
Die aktuelle Dokumentation besagt, dass Preload standardmäßig deaktiviert ist: Servername und -beschreibung werden zuerst geladen, Tool-Definitionen werden bei Bedarf ermittelt.
Ja. Die dokumentierte Liste preload-tools kann ausgewählte Tools vorab laden, während der Rest des Servers verzögert bereitgestellt wird.
Nein. Es verändert die Kontextzusammensetzung. Deaktivieren Sie Tools oder setzen Sie Zugriffsrichtlinien durch, wenn eine Funktion nicht aufrufbar sein sollte.
Nein. Es ist meist bei großen, dünn besetzten Katalogen attraktiv. Häufig verwendete Tools sollten besser vorgeladen werden. Messen Sie die gesamte Arbeitslast.
Der Agent kann ein Ausgabeschema abrufen, bevor er ein Skript schreibt, wodurch der Code-Modus eine Tool-Antwort verarbeiten kann, ohne deren Struktur erraten zu müssen.
Redaktioneller Hinweis: Das Produktverhalten wird auf Basis der öffentlichen TrueForge- und TrueFoundry-Dokumentation vom 10. September 2026 beschrieben. Die Beispiele dienen der Veranschaulichung und sollten an die jeweiligen Anforderungen der Anwendung in Bezug auf Autorisierung, Datenschutz, Zuverlässigkeit und Compliance angepasst werden.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















