



November 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Oracle Cloud Infrastructure (OCI) verfolgt bei KI-Rechenleistung einen anderen Ansatz als die VM-zentrierten Hyperscaler. Die differenzierende Ebene ist Bare-Metal: Die GPU-Shapes von OCI – wie BM.GPU.H100.8 – laufen ohne Hypervisor-Overhead und verbinden sich über NVIDIA ConnectX SmartNICs mittels eines benutzerdefinierten RDMA over Converged Ethernet (RoCE v2) Clusternetzwerks.
Diese Leistungsgrenze bringt bei der Verwaltung von Cloud-Infrastruktur auf Bare-Metal betriebliche Anforderungen mit sich. Bare-Metal bedeutet, dass Sie nun für die Ebene verantwortlich sind, die normalerweise von VMs abstrahiert wird: GPU-Treiber und der OFED-Stack, Scheduling innerhalb der Topologie-Beschränkungen des Clusternetzwerks, Identitätsföderation über OCI IAM sowie die Auswahl zwischen verschiedenen Speicherpfaden für Modellgewichte. Nichts davon ist exotisch, aber es ist ein erheblicher Kubernetes-Aufwand, der bei verwalteten VM-Angeboten nicht anfällt.
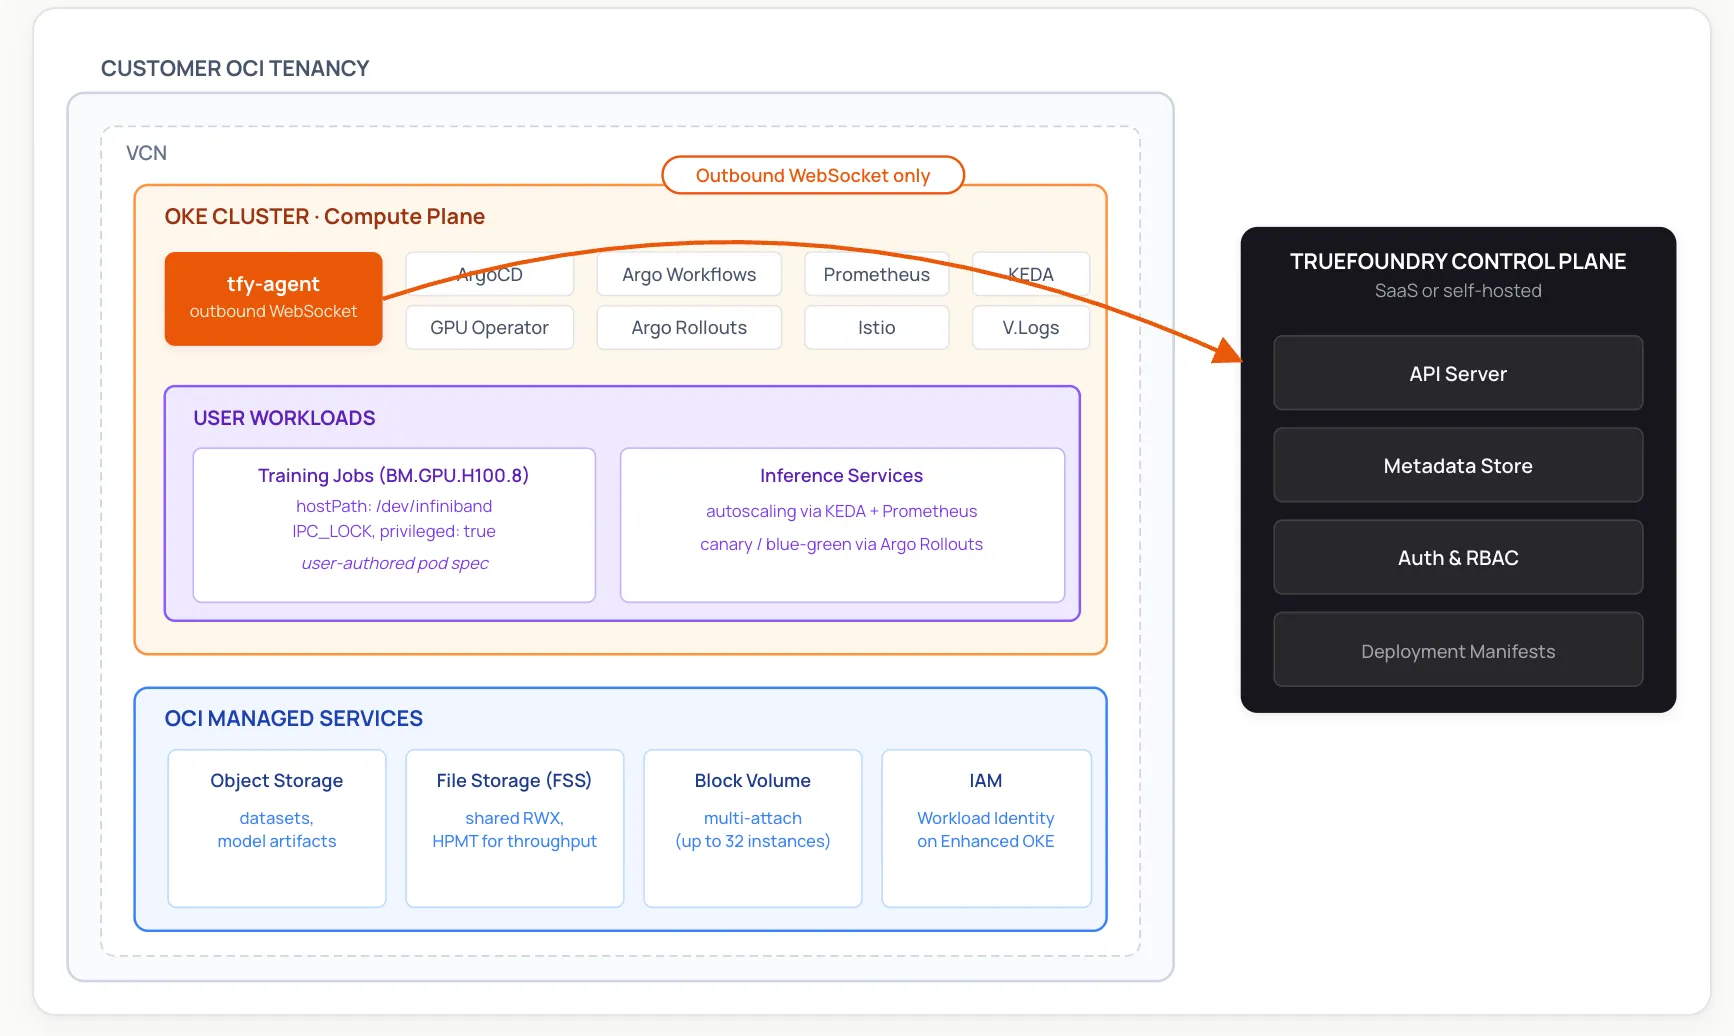
Die Rolle von TrueFoundry in diesem Stack ist die Kubernetes-native Betriebsebene. Die Compute Plane ist Ihr eigenes Oracle Cloud Infrastructure Kubernetes Engine (OKE) Cluster, das auf OCI Bare-Metal läuft. Die Plattform bündelt eine Reihe von Open-Source- und CNCF-zugehörigen Komponenten (ArgoCD, Argo Workflows, NVIDIA GPU Operator, Prometheus, KEDA, Istio und andere) in einer verwalteten Bereitstellung, fügt eine einheitliche Benutzeroberfläche sowie einen GitOps-Workflow hinzu und bietet Observability für Dienste, Jobs und GPU-Auslastung. Sie ersetzt nicht die OCI-Primitive – sie baut auf ihnen auf.
Dieser Beitrag erläutert die Architektur, die Sie erhalten, wenn Sie TrueFoundry auf OCI Bare-Metal ausführen: die Trennung von Control Plane und Compute Plane, wie RDMA-Training in Kubernetes integriert wird, wie Workload-Identität funktioniert und die praktischen Muster für das Laden von Modellgewichten in großem Maßstab.
TrueFoundry verwendet eine Split-Plane-Architektur. Die Control Plane (von TrueFoundry verwaltet oder selbst gehostet) enthält Metadaten, RBAC, den API-Server und den Speicher für Bereitstellungs-Manifeste. Die Compute Plane besteht aus einem oder mehreren Kubernetes-Clustern in Ihrer eigenen Cloud-Umgebung – in diesem Fall ein OKE-Cluster auf OCI Bare-Metal. Workloads, Modellgewichte und Kundendaten verbleiben in Ihrer Tenancy.
Die Verbindung zwischen beiden ist der tfy-agent, der auf dem Compute-Plane-Cluster läuft und ein ausgehendes WebSocket zur Control Plane öffnet. Der Agent ruft Bereitstellungs-Manifeste ab und sendet Kubernetes-Ressourcen-Updates zurück. Da die Verbindung ausgehend ist, müssen Sie keine eingehenden Ports in Ihrer VCN öffnen oder den Cluster-API-Server dem öffentlichen Internet aussetzen.
Wenn TrueFoundry eine Compute Plane einrichtet, installiert und verwaltet der Agent eine Reihe von Open-Source-Add-ons über ArgoCD:
Sie können auch Ihre eigenen bestehenden Instanzen dieser Dienste einbinden – TrueFoundry dokumentiert die Konfiguration, die für die Koexistenz mit einer bestehenden ArgoCD-, Prometheus- oder Istio-Installation erforderlich ist.
Das Cluster-Netzwerk von OCI ist die differenzierte Netzwerkschicht, die groß angelegtes verteiltes Training erst praktikabel macht. Oracle hat interne Messungen veröffentlicht, die eine Latenz im einstelligen Mikrosekundenbereich in diesem Fabric zeigen – bis zu 2 Mikrosekunden bei Single-Rack-Clustern und typischerweise 2,5 bis 9 Mikrosekunden bei Multi-Rack-Superclustern – unter Verwendung von RoCE v2 über NVIDIA ConnectX SmartNICs. Die tatsächlichen Werte in der Produktion hängen von der Cluster-Topologie, der Nachrichtengröße und der Auslastung ab; Oracles Dokumentation zu den First Principles behandelt das zugrunde liegende Design.
Damit RDMA effektiv genutzt werden kann, müssen zwei Voraussetzungen erfüllt sein:
oci.oraclecloud.com/rdma.local_block_id,network_block_idsowiehpc_island_id – und Oracles oci-hpc-oke-Quickstart zeigt, wie diese mit der topologiebewussten Planung von Kueue für eine optimale NCCL-Leistung verwendet werden. Für eng gekoppelte Trainingsvorgänge sollten Sie die Pods bevorzugt innerhalb desselben Local Block platzieren./dev/infiniband/ bereit (die Pfadbenennung spiegelt die zugrunde liegende IB-Verbs-API wider, obwohl der Transport über RoCE v2 via Ethernet erfolgt).Das Standard-Pod-Muster aus dem Quickstart von Oracle sieht wie folgt aus:
spec:
  hostNetwork: true
  dnsPolicy: ClusterFirstWithHostNet
  containers:
  - name: trainer
    securityContext:
      privileged: true
      capabilities:
        add: ["IPC_LOCK"]
    volumeMounts:
    - { mountPath: /dev/infiniband, name: devinf }
    - { mountPath: /dev/shm, name: shm }
  volumes:
  - { name: devinf, hostPath: { path: /dev/infiniband }}
  - { name: shm, emptyDir: { medium: Memory, sizeLimit: 32Gi }}
Diese erweiterten Berechtigungen – privileged: true,IPC_LOCK, Host-Netzwerk – sind spezifisch für HPC/RDMA-Workloads. Isolieren Sie diese Pods in der Produktion in dedizierte GPU-Namespaces mit Zulassungsrichtlinien (z. B. Pod Security Admission auf privilegiert auf Namespace-Ebene, eingeschränkt an anderer Stelle; oder eine OPA/Kyverno-Richtlinie, die auf einem Label basiert), damit nicht zusammengehörige Workloads nicht denselben Kontext erben können.
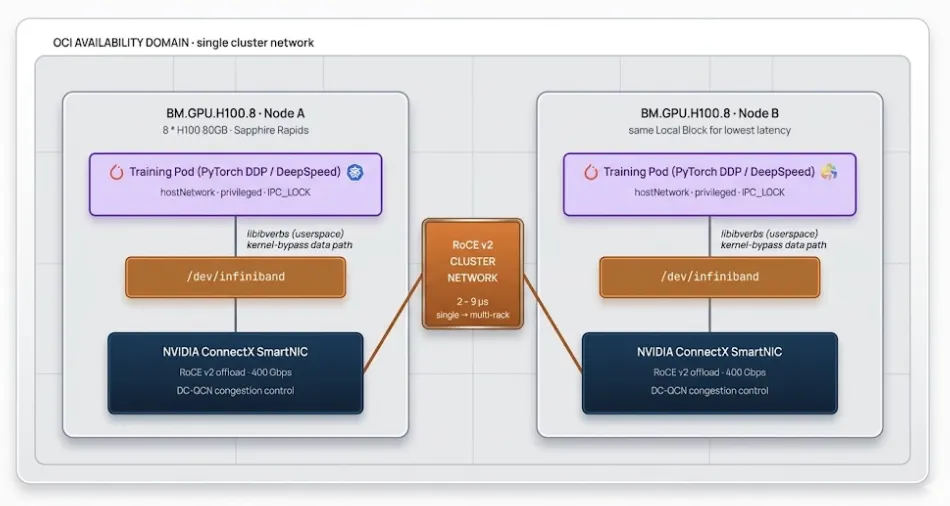
Die Rolle von TrueFoundry besteht hier darin, das Ausführen dieser Training-Pods zu einem normalen Deployment-Workflow zu machen – Sie erstellen die Workload, die Plattform leitet sie durch Argo Workflows, Prometheus erfasst GPU-Metriken vom DCGM Exporter, der mit dem GPU Operator ausgeliefert wird, und ArgoCD versioniert die Manifeste. Workload-spezifische Signale wie NCCL-Zähler werden nur erfasst, wenn die Anwendung sie bereitstellt. Die RDMA-spezifischen Komponenten (hostPath-Mounts, IPC_LOCK, Topologie-Affinität) werden in Ihrer Job-Spezifikation gemäß dem oben genannten Standardmuster konfiguriert; die Plattform ersetzt diese Felder nicht, sondern stellt bereit, was auch immer Sie angeben.
Speziell für verteiltes Training über mehrere Knoten hinweg installieren Sie in der Regel einen Operator über dessen Helm-Chart auf dem Cluster – MPI Operator für MPIJob-basierte Ausführungen (PyTorch DDP, DeepSpeed, NCCL), Kubeflow Training Operator für PyTorchJob/TFJob oder KubeRay für Ray-basiertes Training. TrueFoundry bündelt diese standardmäßig nicht. Sobald sie installiert sind, stellt die Plattform MPIJob/PyTorchJob/RayJob-Ressourcen wie jede andere Kubernetes-Workload bereit, mit demselben GitOps- und Observability-Ansatz. Verteiltes Training mit RDMA auf OCI ist derzeit kein natives TrueFoundry-Feature – es handelt sich um ein Implementierungsmuster, das auf den veröffentlichten Referenzmanifesten von Oracle basiert, wobei die Plattform den umgebenden operativen Stack verwaltet und nicht die RDMA-spezifische Orchestrierung.
Für unterstützte Clustertypen empfiehlt OCI mittlerweile OKE Workload Identity anstelle der Verteilung langlebiger API-Schlüssel an Pods. Der Mechanismus funktioniert ähnlich wie AWS IRSA oder GKE Workload Identity: Ein Kubernetes-ServiceAccount wird einer OCI-IAM-Richtlinie zugeordnet, und das OCI-SDK tauscht das projizierte ServiceAccount-Token des Pods zum Zeitpunkt des Aufrufs gegen ein kurzlebiges OCI-Zugriffstoken aus. Es befinden sich keine statischen Anmeldeinformationen im Pod.
Zwei wichtige Einschränkungen aus Oracles Dokumentation:
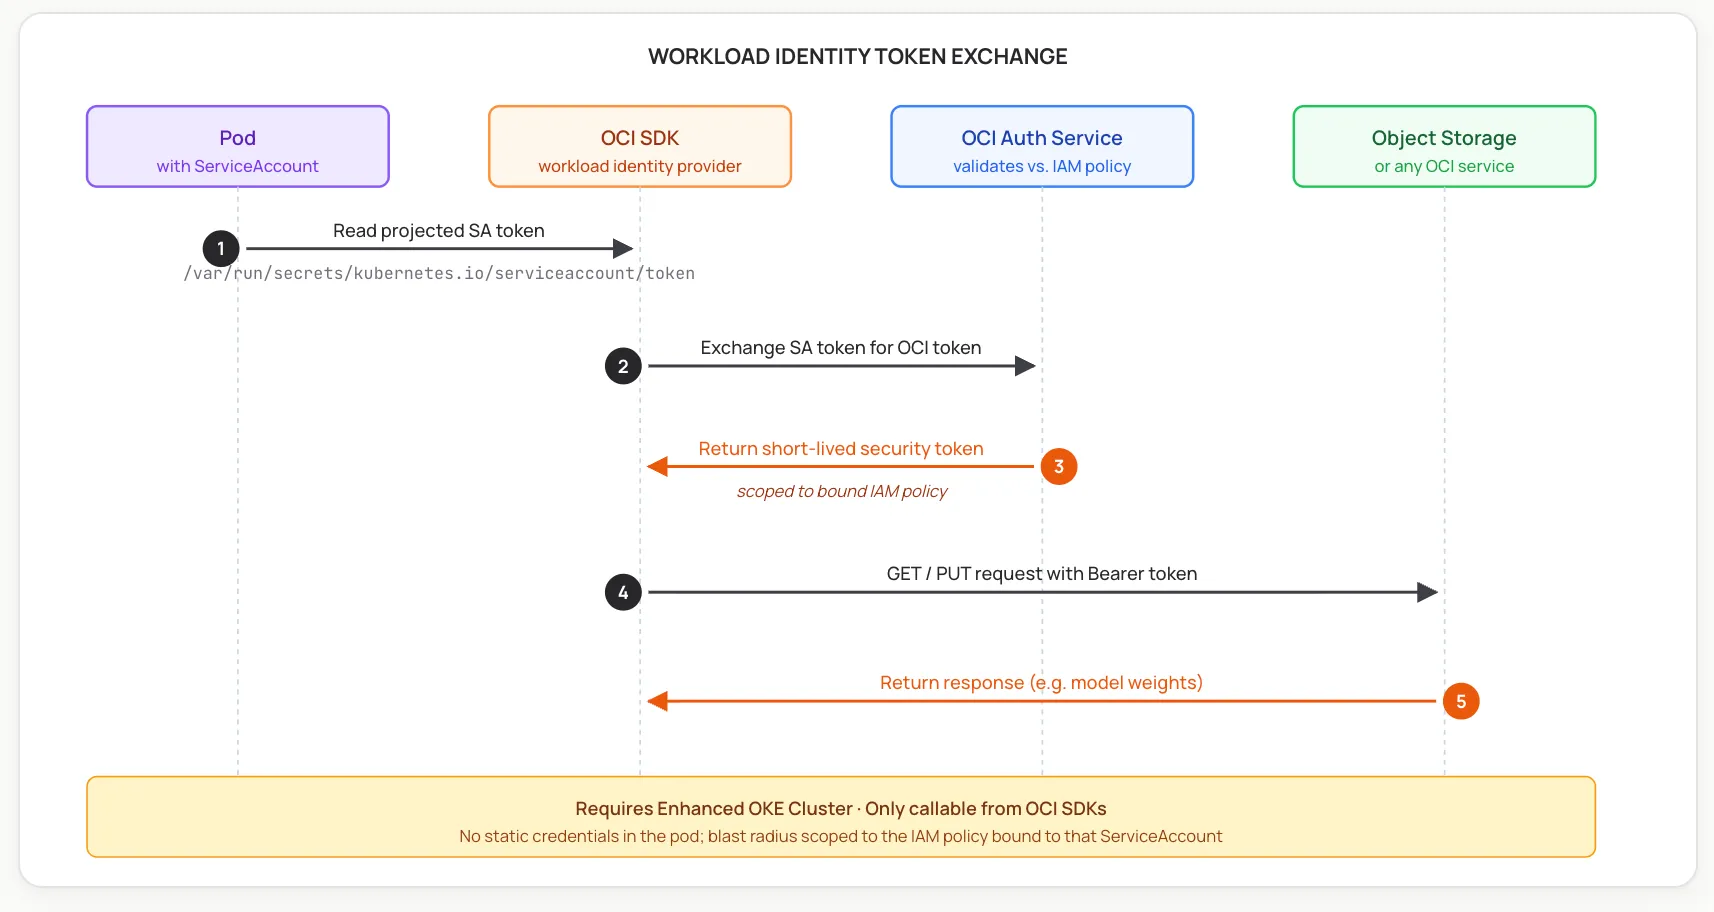
Auf Kubernetes-Seite sind Workloads an ServiceAccounts mit Namespace-Gültigkeitsbereich gebunden, und die Plattform kann deren Erstellung als Teil des Deployment-Prozesses automatisieren. Die OCI-Seite – die IAM-Richtlinie mit der request.principal.type='workload' Regel sowie den Selektoren für Cluster/Namespace/ServiceAccount – wird gemäß der Standard-Workload-Identity-Einrichtung von Oracle konfiguriert. Sobald beide Seiten eingerichtet sind, erhalten Deployments, die OCI-Zugriff benötigen, transparent über das SDK kurzlebige Token.
OCI Bare Metal bietet Ihnen verschiedene Speicheroptionen, um Modellgewichte in den VRAM zu laden. Jede hat ihre Vor- und Nachteile, und die Volume-Abstraktionen von TrueFoundry (PVCs, Volume Mounts, Init-Container) funktionieren mit allen – das richtige Muster hängt von Ihrer Workload ab:
Das richtige Muster hängt vom jeweiligen Workload ab. Für die meisten Trainingsläufe ist die Kombination aus lokalem NVMe-Speicher (für kurzlebige, hochperformante Daten) und FSS (für gemeinsam genutzte Checkpoints und Gewichte) das Standard-Setup für die Produktion. Die Multi-Attach-Funktion von Block Volumes ist eine Option für spezifische Fälle, in denen ein einzelnes, unveränderliches Artefakt für viele Lesezugriffe wie eine lokale Festplatte erscheinen muss.
Der Betrieb von Bare-Metal-GPU-Workloads auf nativen OCI-Grundlagen ist machbar – Oracle stellt einen Terraform-basierten HPC-Stack sowie den oci-hpc-oke Quickstart bereit –, erfordert jedoch, dass Sie sich um eine beträchtliche Kubernetes-Betriebsschicht kümmern. Die folgende Tabelle beschreibt, was TrueFoundry zusätzlich bietet.
Das Muster ist konsistent: OCI stellt die Bare-Metal-Compute- und Netzwerk-Grundlagen bereit; TrueFoundry liefert die darüber liegende Kubernetes-Betriebsschicht.
TrueFoundry auf OCI ist eine Kubernetes-native Plattform, die auf dem Bare-Metal-Stack von Oracle läuft. Die Compute-Ebene ist Ihr OKE-Cluster, die Workloads nutzen das RoCE v2-Cluster-Netzwerk von OCI sowie Workload Identity über Standard-Kubernetes-Muster, und die Plattform bündelt die Open-Source- und CNCF-konforme Betriebsschicht – GitOps, Observability, Autoscaling, GPU-Operator – in einer verwalteten Bereitstellung. Das Ergebnis ist ein geringerer Plattform-Engineering-Aufwand für den Betrieb von Bare-Metal-GPU-Workloads, wobei die OCI-spezifische Konfiguration transparent bleibt, anstatt verborgen zu werden.
Ein praktischer Evaluierungspfad ist eine Referenzbereitstellung auf einem kleinen OKE-Cluster – typischerweise ein oder zwei BM.GPU-Shapes plus ein CPU-Pool für die Plattform-Add-ons –, um die Architektur zu validieren, bevor eine Skalierung auf ein vollständiges Supercluster erfolgt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















