



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Aktualisiert: November 3, 2026
Published: April 20, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Da große Sprachmodelle (LLMs) die Art und Weise, wie Anwendungen wie AI-Copiloten und Enterprise-Chat-Schnittstellen entwickelt werden, grundlegend verändern, steigt der Bedarf an strukturierter Infrastruktur und Prozessen zu deren effizienter Verwaltung. Diese neu entstehende Disziplin ist als LLMOps bekannt. Ähnlich wie MLOps Disziplin in traditionelle Machine-Learning-Workflows gebracht hat, konzentriert sich LLMOps auf die Lösung der spezifischen operationalen Herausforderungen beim skalierten Einsatz von Foundation-Modellen.
LLMOps beschränkt sich nicht darauf, ein Modell über eine API bereitzustellen. Es umfasst den gesamten Lebenszyklus, einschließlich Prompt-Engineering, Fine-Tuning, Retrieval-Augmented Generation (RAG), Versionskontrolle, Leistungsüberwachung, Kostenoptimierung und Durchsetzung von sicherem Zugriff. Aufgrund der Größe und Komplexität von LLMs ist eine dedizierte Architektur erforderlich, um zuverlässige, skalierbare und wartbare Bereitstellungen zu gewährleisten.
Dieser Artikel untersucht die Grundlagen der LLMOps-Architektur. Wir werden ihre Schlüsselkomponenten aufschlüsseln, Referenzmuster aus der Praxis analysieren und die Tools hervorheben, die eine schnelle Entwicklung und Governance unterstützen. Egal, ob Sie einen Kundensupport-Assistenten, eine Engine zur Wissensbeschaffung oder eine KI-gestützte Agentenplattform bauen – das Verständnis der LLMOps-Architektur ist essenziell, um effiziente, skalierbare und produktionsreife Lösungen zu erstellen.
LLMOps-Architektur bezeichnet das strukturierte Design und die Gesamtheit der Komponenten, die erforderlich sind, um den Lebenszyklus großer Sprachmodelle in Produktionsumgebungen zu verwalten. Sie ist das Fundament, das es Teams ermöglicht, vom Experimentieren mit LLMs zum Bau skalierbarer, sicherer und wartbarer Anwendungen überzugehen, die von diesen Modellen angetrieben werden.
Im Gegensatz zu traditionellem MLOps, das sich in erster Linie mit strukturierten Datensätzen und Modell-Trainings-Pipelines befasst, muss LLMOps einzigartige Herausforderungen wie Prompt-Orchestrierung, Retrieval-Augmented Generation, Modellversionierung im großen Maßstab und Echtzeit-Inferenzlatenz berücksichtigen. Die Architektur muss zudem dynamische Workloads, Multi-Modell-Routing und sicheren Zugriff über verschiedene Benutzer und Teams hinweg unterstützen.
Eine LLMOps-Architektur kombiniert Infrastruktur, Automatisierung und Observability, um eine zuverlässige Bereitstellung und Governance zu gewährleisten. Sie umfasst typischerweise:
Diese Architektur ist so konzipiert, dass sie sowohl vortrainierte Modelle unterstützt, die als API bereitgestellt werden, als auch maßgeschneiderte, feingetunte Modelle, die in privaten Umgebungen eingesetzt werden. Da die Nutzung von LLMs über alle Branchen hinweg zunimmt, wird eine gut strukturierte Architektur unerlässlich für schnelle Iteration, Kosteneffizienz und Benutzervertrauen.
Das Verständnis der LLMOps-Architektur hilft Teams beim Aufbau von Systemen, die skalierbar sind und gleichzeitig flexibel, compliant und an realen Geschäftsergebnissen ausgerichtet bleiben.
Eine LLMOps-Architektur bringt Struktur und Skalierbarkeit in die Bereitstellung großer Sprachmodelle. Im Gegensatz zu traditionellem MLOps adressiert sie die spezifischen Komplexitäten rund um Prompt-Orchestrierung, Retrieval-Pipelines und das Modellverhalten zur Laufzeit. Eine robuste Architektur verbindet mehrere Kernschichten, die jeweils eine kritische Funktion erfüllen.
Datenmanagement
LLMs sind auf vielfältige, hochqualitative Daten angewiesen, um eine gute Leistung zu erbringen. Diese Komponente umfasst die Beschaffung, Bereinigung, Formatierung und Speicherung umfangreicher Text- oder Dokumentendaten. Für feingetunte Modelle können auch gelabelte Datensätze erforderlich sein. Datenversionierung und Lineage-Tracking sind entscheidend, um die Rückverfolgbarkeit über Modelliterationen hinweg zu gewährleisten.
Modellentwicklung
Diese Schicht konzentriert sich auf die Auswahl des Basismodells und die Anpassung durch Fine-Tuning, Instruction-Tuning oder Prompt-Engineering. Benchmarking-Frameworks werden verwendet, um die Leistung bei verschiedenen Downstream-Aufgaben zu validieren. Tools wie LoRA und PEFT helfen, Kosten und Rechenaufwand bei Modellaktualisierungen zu reduzieren.
Inferenz und Bereitstellung
Die Bereitstellung von LLMs erfordert eine skalierbare Infrastruktur. Dazu gehören optimierte APIs, Modellquantisierung, Token-Level-Streaming und Autoscaling auf GPUs. Observability-Tools überwachen Inferenzkosten, Latenz und Durchsatz. Produktionssetups umfassen häufig A/B-Tests, Rollback-Strategien und Multi-Modell-Routing.
Sicherheit und Compliance
LLMOps muss Sicherheitsanforderungen auf Enterprise-Niveau erfüllen. Verschlüsselung, Zugriffskontrolle, Datenpseudonymisierung und Audit-Trails sind unerlässlich, um Compliance-Standards wie HIPAA, DSGVO oder SOC 2 zu entsprechen.
Governance und Responsible AI
Diese Schicht verwaltet Prompt-Versionierung, Halluzinations-Tracking und Bias-Erkennung. Das Protokollieren aller Interaktionen und das Anwenden von Filtern für schädliche Inhalte gewährleisten ein ethisches und konsistentes Verhalten in der Produktion.
Best Practices und Zukunftsfähigkeit
Effektives LLMOps umfasst modulare Pipelines, Evaluierungsschleifen und Prompt-Rückverfolgbarkeit. Mit Blick auf die Zukunft entwickeln sich Architekturen weiter, um Echtzeit-Retrieval, kontinuierliches Fine-Tuning und die Koordinierung von Multi-Agenten-Systemen zu unterstützen.
Durch die Abstimmung dieser Komponenten können Teams LLM-Anwendungen bereitstellen, die robust, anpassungsfähig und bereit für den Unternehmenseinsatz sind.
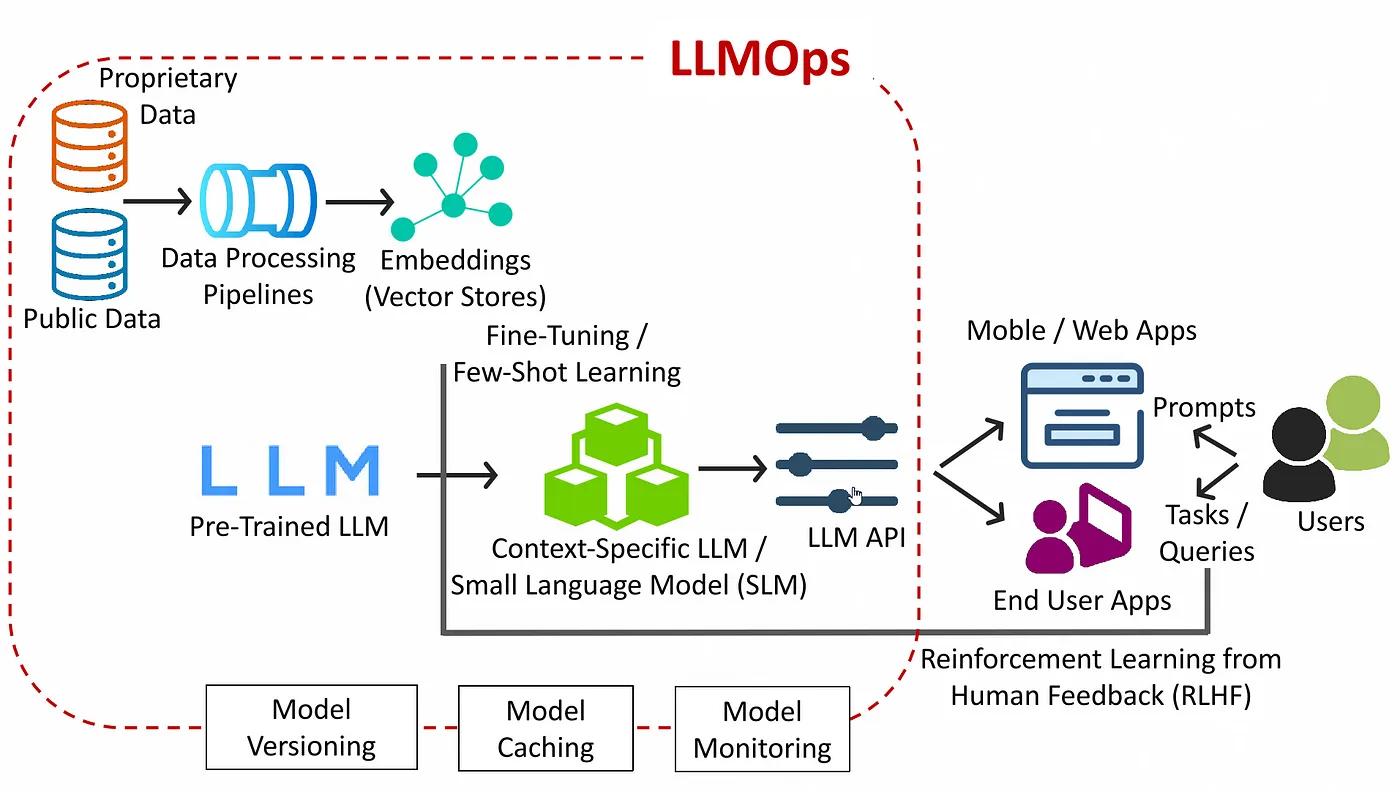
Diese Darstellung zeigt eine moderne LLMOps-Architektur, die die gesamte Pipeline von der Erfassung von Rohdaten bis hin zur Produktionsbereitstellung, Benutzerinteraktion und feedbackgesteuertem Lernen abdeckt. Sie spiegelt wider, wie reale Systeme für große Sprachmodelle über Teams und Umgebungen hinweg aufgebaut und gewartet werden.
Datenerfassung und -verarbeitung: Die Architektur beginnt mit öffentlichen und proprietären Datenquellen. Dazu können Textkorpora, Dokumente, CRM-Daten, interne Wissensdatenbanken oder Kunden-Gespräche gehören. Alle Daten durchlaufen eine Datenverarbeitungspipeline, in der sie bereinigt, normalisiert und für nachgelagerte Aufgaben angereichert werden. Dies beinhaltet die Umwandlung von Text in Vector Embeddings, die in Vektordatenbanken oder Embedding-Stores für eine schnelle inhaltsbasierte Ähnlichkeitssuche gespeichert werden.
Modellauswahl und -anpassung: Ein vortrainiertes LLM (wie GPT, LLaMA oder Falcon) wird als Basismodell ausgewählt. Durch Fine-Tuning oder Few-Shot-Learning erstellen Teams ein kontextspezifisches LLM oder Small Language Model (SLM), das auf ihre Domäne oder ihren Anwendungsfall zugeschnitten ist. Dies ermöglicht eine bessere Abstimmung auf die spezifische Sprache, den Ton, die Aufgaben und die Datenstruktur der jeweiligen Anwendung.
LLM Gateway
Das LLM Gateway bildet das Herzstück der Architektur. Es bietet eine einheitliche API-Oberfläche für alle Modell-Endpunkte und übernimmt Authentifizierung, Routing, Batching und Protokollübersetzung. Das Gateway setzt Rate-Limits und Quoten durch, wendet Prompt-Templates an und orchestriert Fallback- oder A/B-Routing zwischen Modellversionen. Es erfasst außerdem detaillierte Metriken zu Anfragezahlen, Latenzen und Fehlerraten, bevor es Aufrufe an die Inferenzschicht weiterleitet.
LLM API Serving: Das angepasste Modell wird über eine LLM API bereitgestellt, die als primäre Schnittstelle für Anwendungen dient. Diese APIs sind für Echtzeitinteraktionen ausgelegt und verwalten die Inferenzoptimierung durch Batching, Quantisierung und Latenzkontrolle. Die Architektur umfasst außerdem Modell-Caching zur Reduzierung von Redundanzen sowie Modellüberwachung zur Gewährleistung von Zuverlässigkeit und Kosteneffizienz.
Benutzeranwendungen und Feedbackschleife
Mobile und Web-Clients senden Prompts an das Gateway, empfangen die generierten Antworten und präsentieren sie den Endbenutzern. Interaktionsdaten werden für RLHF oder offlines Retraining erfasst, um den Kreis zur kontinuierlichen Modellverbesserung zu schließen.
Governance und Lifecycle Management: Die Architektur umfasst zentrale betriebliche Funktionen wie Modellversionierung, Audit-Trails, Prompt-Tracking und sichere Zugriffsrichtlinien. Diese stellen sicher, dass LLM-Systeme im Laufe der Zeit reproduzierbar, interpretierbar und compliant bleiben.
Dieses Diagramm erfasst effektiv den gesamten Lebenszyklus der LLM-Bereitstellung und -Optimierung innerhalb einer produktionsreifen LLMOps-Pipeline.
Die LLMOps-Architektur beginnt damit, dass öffentliche und proprietäre Daten durch Verarbeitungspipelines fließen, um Embeddings zu generieren, die in Vektordatenbanken gespeichert werden. Ein vortrainiertes großes Sprachmodell wird anschließend feingetunt oder mittels Few-Shot-Learning angepasst, um ein kontextspezifisches Modell zu erstellen. Dieses Modell wird hinter einer optimierten LLM API bereitgestellt, die Mobile- und Webanwendungen in Echtzeit bedient. Benutzer interagieren mit diesen Anwendungen, indem sie Prompts senden und intelligente Antworten erhalten. Feedback aus Benutzerinteraktionen wird über Reinforcement Learning from Human Feedback (RLHF) genutzt, während Modellversionierung, Caching und Überwachung die Systemleistung, Rückverfolgbarkeit und Governance sicherstellen.
Eine LLMOps-Architektur ist keine Einheitslösung. Je nach Größe, Domäne und regulatorischen Anforderungen einer Organisation entstehen unterschiedliche Muster, um LLMs effektiv zu operationalisieren. Diese Muster helfen Teams, Leistung, Kosten, Governance und Entwicklungsgeschwindigkeit in Einklang zu bringen. Nachfolgend finden Sie einige weit verbreitete Referenzmuster aus der Praxis.
API-Zentrierte LLM-Bereitstellung
Dies ist das gebräuchlichste Muster für Teams in frühen Phasen oder für einfache Anwendungsfälle. Ein vortrainiertes oder feingetuntes LLM wird hinter einer REST-API gehostet, und nachgelagerte Anwendungen stellen synchrone Anfragen. Prompt-Templates werden versioniert, und es wird minimale Orchestrierung eingesetzt. Dieses Muster ist einfach zu implementieren und eignet sich gut für Generierung von Inhalten, Zusammenfassungen oder einfache Chat-Schnittstellen.
Retrieval-Augmented Generation (RAG) Muster
Diese Architektur wird in wissensintensiven Umgebungen eingesetzt und kombiniert ein LLM mit einer Vektordatenbank, die kontextrelevante Informationen abruft. Eingaben werden zunächst durch embedding-basierte Abfragen aus internen oder externen Wissensdatenbanken angereichert und dann an das LLM übergeben. Dieses Muster verbessert die faktische Fundierung und Domänenspezifität. Es ist ideal für Kundensupport, rechtliche Dokumentenanalyse oder Unternehmenssuchen.
LLM + Workflow-Orchestrierungsmuster
In komplexeren Systemen werden LLMs mithilfe von Orchestrierungs-Frameworks wie LangChain, LangGraph oder Airflow in größere Workflows eingebettet. Diese Architekturen verknüpfen mehrere Schritte – Retrieval, Prompt-Formatierung, Inferenz, Nachbearbeitung und Aktionsauslöser. Dies ermöglicht dynamische Entscheidungsfindung, Multi-Agenten-Systeme und autonome Aufgabenausführung. Es wird in Agentic AI, AI-Copiloten und mehrstufigen Dialoganwendungen verwendet.
Muster für feingetunte private LLMs
Für stark regulierte Branchen oder Anwendungsfälle mit sensiblen Daten können Unternehmen Open-Source-LLMs feintunen und in ihrer eigenen Infrastruktur oder VPC hosten. Die Architektur umfasst Datenanonymisierung, Fine-Tuning-Pipelines, isolierte Inferenzumgebungen sowie vollständige Überwachung und Zugriffskontrolle. Dieses Muster ist im Gesundheitswesen, im Finanzwesen und im Verteidigungssektor verbreitet.
Hybrid-Cloud-Edge-Muster
Dieses Muster, das in Edge-AI-Szenarien an Bedeutung gewinnt, belässt das Haupt-LLM in der Cloud, verlagert jedoch leichte Modelle oder Prompt-Verarbeitungslogik auf Edge-Geräte. Es reduziert Latenz und Bandbreitennutzung, während sensible Daten lokal bleiben. Es wird zunehmend in IoT-, Automotive- und mobilen Anwendungen eingesetzt.
Diese Muster spiegeln die Flexibilität und Anpassungsfähigkeit von LLMOps wider und bieten Pfade für
Das LLMOps-Ökosystem wächst rasch, und kein einzelnes Tool kann jeden Bedarf abdecken. Leistungsstarke Teams bauen modulare Stacks auf, die zu ihrer Infrastruktur und ihren Workflows passen. Im Zentrum vieler unternehmensweiter Stacks nimmt TrueFoundry eine zentrale Rolle ein, indem es Unterstützung über Bereitstellungs-, Observability-, Orchestrierungs- und Automatisierungsschichten hinweg bietet. Nachfolgend finden Sie eine Aufschlüsselung der Kernschichten und der darin eingesetzten Tools.
1. Daten- & Embedding-Schicht
Diese Schicht übernimmt Datenbereinigung, Transformation, Chunking und Embedding für Retrieval-Augmented Generation (RAG). Sie ermöglicht es LLMs, mit Kontextbewusstsein zu agieren.
Diese Tools ermöglichen es Modellen, zur Inferenzzeit relevante Informationen abzurufen, was die faktische Fundierung und Ausgabequalität verbessert.
2. Model-Serving- & Inferenz-Schicht
Dies ist das Rückgrat des LLMOps-Stacks. Es umfasst die Komponenten, die benötigt werden, um Modelle effizient zu hosten und bereitzustellen, die GPU-Nutzung zu verwalten und APIs zu skalieren.
Diese Schicht stellt sicher, dass LLM-Antworten auch unter Produktionslast schnell und kosteneffizient geliefert werden.
3. Prompt- & Orchestrierungsschicht
Diese Schicht verwaltet Prompt-Templates, Agenten-Flows und dynamische Interaktionen. Sie hilft bei der Logiksteuerung und der Verkettung mehrstufiger Prozesse innerhalb von LLM-Anwendungen.
Prompt-Orchestrierung gibt Teams die Kontrolle darüber, wie sich LLMs über komplexe geschäftliche Anwendungsfälle hinweg verhalten.
4. Überwachungs-, Feedback- und Governance-Schicht
Zuverlässigkeit, Transparenz und Ethik erfordern robuste Überwachungs- und Governance-Systeme. Diese Schicht erfasst Ausgaben, Benutzerfeedback und Leistungsmetriken.
5. Workflow- & Automatisierungsschicht
Diese letzte Schicht verwaltet Training, Evaluierung, Bereitstellungsautomatisierung und CI/CD. Sie ermöglicht nachvollziehbare, wiederholbare Workflows, die eine iterative Entwicklung unterstützen.
Wenn diese Tools über die Schichten hinweg aufeinander abgestimmt sind, verwandeln sie LLMOps von verstreuten Experimenten in eine wiederholbare, skalierbare Engineering-Disziplin. Anstatt sich auf eine einzige End-to-End-Lösung zu verlassen, stellen moderne Teams komponierbare Stacks zusammen, die genau ihren Anforderungen an Infrastruktur, Skalierung und Compliance entsprechen.
Der Schlüssel liegt in der Interoperabilität – der Auswahl von Tools, die sich reibungslos integrieren lassen, Schlüsselschritte automatisieren und Transparenz über den gesamten Modelllebenszyklus bieten. Mit dem richtigen Stack können sich LLMs von Prototypen zu produktionsreifen Systemen entwickeln, die einen echten geschäftlichen Mehrwert schaffen.
LLMOps entwickelt sich rasch zu einer grundlegenden Disziplin für Teams, die Anwendungen auf Basis großer Sprachmodelle entwickeln. Da LLMs von der experimentellen Nutzung zu produktionskritischen Systemen übergehen, benötigen Unternehmen eine strukturierte Architektur, spezialisierte Tools und wiederholbare Workflows, um Komplexität, Kosten und Leistung zu steuern. Eine gut gestaltete LLMOps-Architektur beschleunigt nicht nur die Bereitstellung, sondern gewährleistet auch ethische Ausrichtung, Daten-Governance und kontinuierliche Verbesserung durch Feedback.
Durch den Einsatz modularer Tools über Datenmanagement-, Inferenz-, Orchestrierungs- und Überwachungsschichten hinweg gewinnen Teams Flexibilität und Kontrolle über jeden Aspekt des LLM-Lebenszyklus. Unabhängig davon, ob Sie ein Open-Source-Modell bereitstellen oder ein proprietäres Modell feintunen, bilden skalierbare LLMOps-Praktiken das Rückgrat nachhaltiger KI-Systeme.
Die Zukunft von LLMOps liegt in der Fähigkeit, mit der raschen Modellentwicklung, neuen Risiken und steigenden Unternehmensanforderungen Schritt zu halten. Für Unternehmen, die bereit sind, verantwortungsvoll zu skalieren, ist die Investition in eine LLMOps-Architektur keine Option mehr, sondern ein strategischer Vorteil.
Eine LLMOps-Architektur ist das strukturelle Framework zur Verwaltung des gesamten Lebenszyklus großer Sprachmodelle in einer Produktionsumgebung. Sie bietet die notwendige Infrastruktur für Datenerfassung, Prompt-Versionierung und Modellorchestrierung und überführt KI aus einfachen Experimenten in eine zuverlässige Unternehmensbereitstellung. Diese Architektur stellt sicher, dass Anwendungen im Zuge ihrer Weiterentwicklung skalierbar, sicher und wartbar bleiben.
Eine LLMOps-Architektur besteht aus mehreren kritischen Schichten: Vektordatenbanken für RAG-basierten Kontext, Prompt-Management-Systemen für Versionskontrolle und einem zentralen AI Gateway für das Model Serving. Zudem muss sie Observability-Module zur Verfolgung von Latenz und Token-Nutzung sowie Fine-Tuning-Pipelines für spezialisierte Aufgaben enthalten. TrueFoundry vereint diese Komponenten in einer einzigen Control Plane und vereinfacht so die Komplexität eines fragmentierten KI-Stacks.
Der Hauptunterschied der LLMOps-Architektur liegt in der Verlagerung von trainingsintensiven Workflows hin zu orchestrierungsintensiven Pipelines. Während sich traditionelles MLOps auf das Erstellen eigener Modelle und Feature Engineering konzentriert, priorisiert LLMOps die Verwaltung vortrainierter Foundation-Modelle durch Prompt-Engineering und Retrieval-Augmented Generation (RAG). TrueFoundry bietet eine Plattform, die beide Paradigmen unterstützt und es Teams ermöglicht, zu generativer KI zu wechseln, ohne etablierte Betriebsstandards aufzugeben.
Zu den Standard-Tools in einer LLMOps-Architektur gehören Vector Stores wie Pinecone oder Weaviate, Orchestrierungs-Frameworks wie LangChain und spezialisierte Monitoring-Suites. Die getrennte Verwaltung dieser einzelnen Komponenten führt jedoch häufig zu Integrationssilos. TrueFoundry fungiert als umfassende Orchestrierungsschicht und bietet die erforderliche Infrastruktur zur Verwaltung von Modellbereitstellungen, Secret-Rotation und kostenoptimiertem Routing über jeden Cloud-Anbieter hinweg.
TrueFoundry ist eine ideale Plattform für LLMOps-Architekturen, da es eine entwicklerzentrierte Control Plane bietet, die nativ in Ihrer eigenen sicheren Cloud-Umgebung läuft. Es abstrahiert die Komplexität von Kubernetes und Infrastruktur-Bereitstellung und bietet gleichzeitig hochleistungsfähige Gateways sowie tiefe Observability. Indem es Daten innerhalb Ihrer VPC belässt und die Ressourcenoptimierung automatisiert, stellt es sicher, dass die Skalierung von Enterprise-KI sowohl sicher als auch kosteneffizient bleibt.
Eine LLMOps-Architektur besteht typischerweise aus mehreren Schichten: der Datenschicht, der Modellschicht, der Anwendungsschicht und der Infrastrukturschicht. Die Datenschicht verwaltet Datensätze, die Modellschicht übernimmt Training oder Inferenz, die Anwendungsschicht integriert KI in Produkte und die Infrastrukturschicht unterstützt Bereitstellung, Skalierung, Überwachung und Systemverwaltung.
LLMOps umfasst strukturierte Versionierung für Prompts, Modelle und Fine-Tuning-Iterationen. Die Versionskontrolle stellt die Reproduzierbarkeit sicher, erleichtert Rollbacks und ermöglicht Experimente, ohne Produktionssysteme zu stören. Teams können Verbesserungen nachverfolgen, die Modellleistung vergleichen und die Einhaltung von Audit- und Regulierungsanforderungen sicherstellen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















