



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Eine LLM-Anwendung in der Produktion fällt auf Weisen aus, die herkömmliche Softwareingenieure verunsichern würden. Ihr Chatbot beginnt, Produktinformationen zu halluzinieren, Ihr RAG-System liefert irrelevante Dokumente zurück, oder Ihr KI-Assistent führt teure API-Aufrufe in einer Endlosschleife aus. Im Gegensatz zu Webservern, die sichtbar abstürzen, oder Datenbanken, die eindeutige Fehlermeldungen ausgeben, zeigen sich LLM-Fehler oft als schleichende Verschlechterung der Antwortqualität, die Stunden andauern kann, bevor es jemand bemerkt.
Diese grundlegende Herausforderung der Observability betrifft jedes Unternehmen, das KI in der Produktion einsetzt. Anders als bei traditioneller Software, bei der Sie jede Datenbankabfrage und jeden API-Aufruf zurückverfolgen können, arbeiten LLM-Anwendungen in einer Blackbox, in der ein einzelner Benutzer-Prompt Dutzende von Modellaufrufen, komplexe Retrieval-Operationen und mehrstufige Argumentationsketten auslösen kann. Wenn etwas schiefgeht, müssen Teams im Dunkeln auf Fehlersuche gehen.
Der Markt für LLM-Observability hat mit Dutzenden von Lösungen reagiert, aber zwei Plattformen haben sich in letzter Zeit als besonders populär erwiesen: Langfuse, der Open-Source-Favorit mit 15,5K GitHub-Sternen, und Portkey, die umfassende Plattform, die über 2,5 Billionen Token verarbeitet. Beide verfolgen einen grundlegend unterschiedlichen Ansatz zur Lösung desselben kritischen Problems: Wie sieht man, was die eigene KI tatsächlich tut?
Langfuse ist eine Open-Source-Plattform für Observability und Analytik von LLM-gestützten Anwendungen. Sie ermöglicht es Ihnen, Prompts, Antworten, Kosten und Benutzer-Feedback an einem zentralen Ort zu überwachen. Mit Langfuse können Teams ihre KI-Workflows besser verstehen, debuggen und optimieren.
Langfuse hat sich zur bevorzugten Wahl für Teams entwickelt, die eine umfassende LLM-Observability ohne Vendor-Lock-in wünschen. Entwickelt von einem Team in Berlin nach der Teilnahme am Y Combinator, hat die Plattform über 40.000 aktive Nutzer gewonnen und 4,5 Millionen US-Dollar an Finanzierung eingeworben – beeindruckend für ein Open-Source-Projekt.
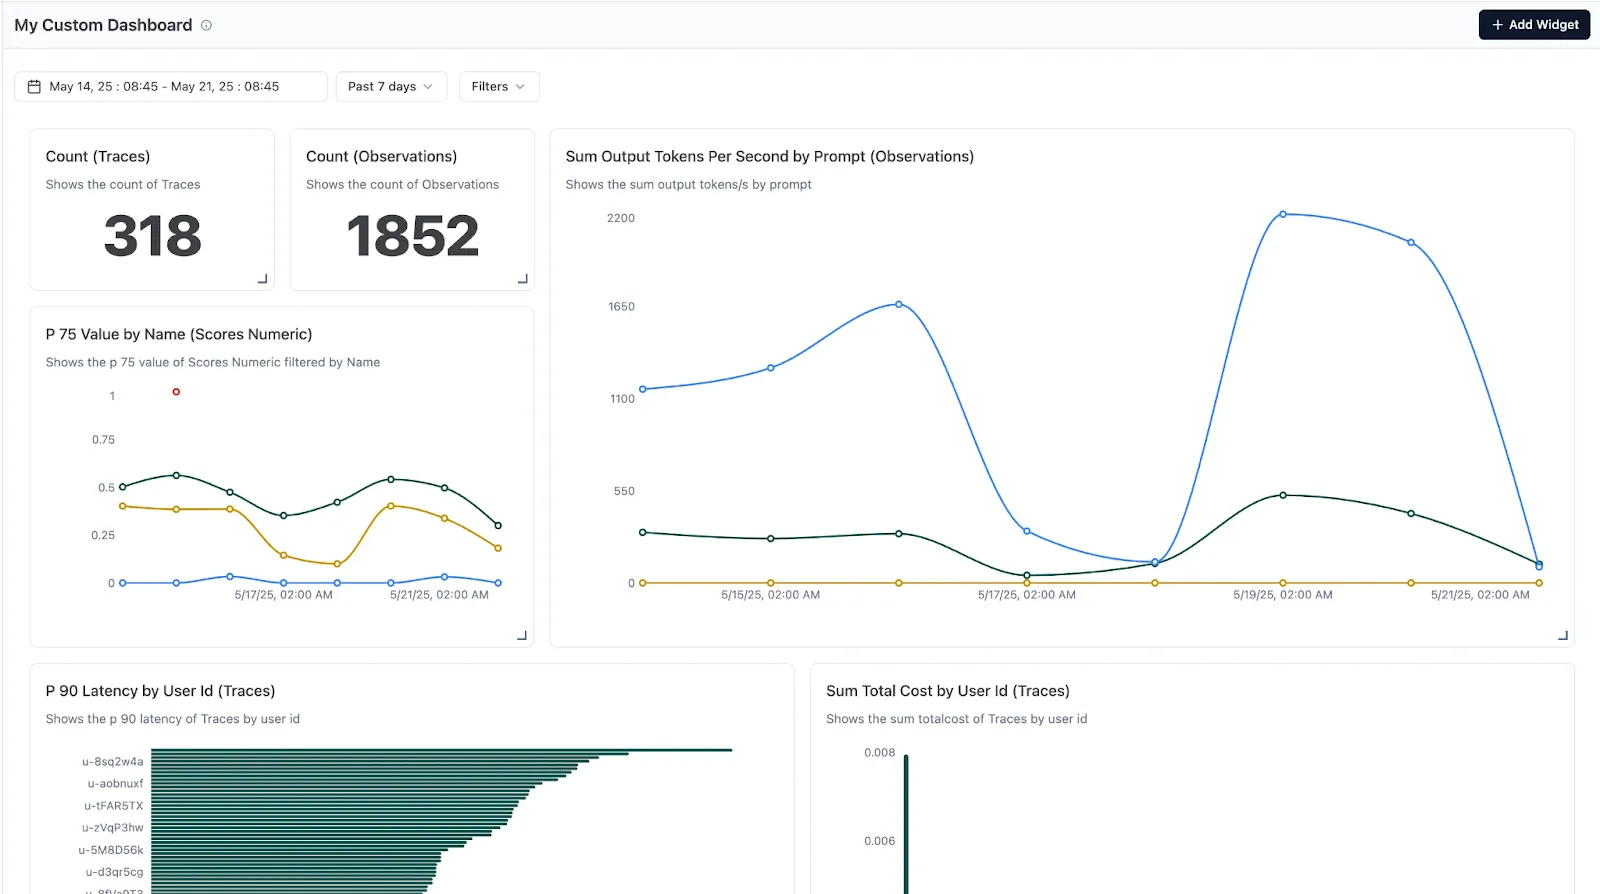
Erweiterte Tracing-Architektur
Das hierarchische Tracing-System von Langfuse erstellt eine umfassende Karte jeder Interaktion innerhalb Ihres LLM-Anwendungsstacks. Jeder Trace repräsentiert eine vollständige Benutzersitzung oder einen Workflow, wobei verschachtelte Spans einzelne Operationen wie Modellaufrufe, Retrievals, Funktionsausführungen und Datentransformationen erfassen. Diese baumartige Struktur spiegelt den tatsächlichen Ausführungsfluss komplexer KI-Anwendungen wider.
Skalierbare technische Architektur
Die neue ClickHouse-basierte Architektur von Langfuse ist auf Leistung und Skalierbarkeit ausgelegt. Sie bietet eine deutlich schnellere Verarbeitung für die meisten Abfragen und bewältigt über eine Milliarde Zeilen und zehntausende Gigabyte an Daten pro Server und Sekunde. Dies ermöglicht Unternehmenskunden wie Twilio und Khan Academy den Betrieb von Produktions-Workloads in großem Maßstab – Khan Academy nutzt das System für über 100 Benutzer in 7 Produkten und 4 Infrastruktur-Teams.
Sicherheit auf Enterprise-Niveau
Für ein Open-Source-Projekt nimmt Langfuse Sicherheit sehr ernst. Das Unternehmen hat SOC 2 Type II- und ISO 27001-Zertifizierungen erreicht, wobei HIPAA-Konformität für Gesundheitsanwendungen verfügbar ist. Die Plattform unterstützt sowohl Cloud- als auch Self-Hosted-Deployments, was sicherheitsbewussten Unternehmen die vollständige Kontrolle über ihre Daten gibt.
Der Open-Source-Vorteil
Was Langfuse auszeichnet, ist sein Engagement für Offenheit. Der gesamte Codebase ist auf GitHub verfügbar, die Datenexport-APIs unterliegen keinen Einschränkungen, und es gibt keine künstliche Funktionssperre zwischen kostenlosen und kostenpflichtigen Tarifen. Diese Philosophie findet großen Anklang bei Engineering-Teams, die schlechte Erfahrungen mit Vendor-Lock-in gemacht haben.
Die Community hat begeistert reagiert. Die Dokumentation enthält Integrationen für jedes große LLM-Framework: LangChain, LlamaIndex, OpenAI SDK, Anthropic SDK und Dutzende andere. Von der Community beigesteuerte Konnektoren decken Spezialfälle ab, die proprietäre Plattformen oft ignorieren.
Einschränkungen in der Praxis
Trotz seiner Stärken steht Langfuse vor Herausforderungen, die bei großer Skalierung auftreten. Die Lernkurve ist steil. Teams berichten, dass sie Wochen damit verbringen, den vollen Funktionsumfang zu verstehen, bevor sie einen Mehrwert sehen. Die Benutzeroberfläche kann für einfache Anwendungsfälle, bei denen Teams nur eine grundlegende Kosten- und Leistungsüberwachung wünschen, überfordernd wirken.
Die Ressourcenanforderungen steigen mit der Nutzung rasch an. Während die Mindestspezifikationen angemessen erscheinen, benötigen Produktionsumgebungen oft erheblich mehr Arbeitsspeicher und Rechenleistung als angegeben. Die Anforderung von ClickHouse ist zwar leistungsstark, bringt jedoch eine betriebliche Komplexität mit sich, die nicht alle Teams verwalten möchten.
Der kritischste Punkt ist, dass Langfuse eine reine Observability-Plattform ist. Teams benötigen separate Lösungen für LLM-Routing, Fallback-Handling, Rate Limiting und Kostenkontrolle. Dies funktioniert gut für Organisationen mit starken Infrastruktur-Teams, schafft aber Integrationsherausforderungen für andere.
Wichtige Metriken zur Evaluierung eines Gateways
| Kriterium | Was sollten Sie bewerten? | Priorität | TrueFoundry |
|---|---|---|---|
| Latenz | Fügt <10ms p95-Overhead für Time-to-First-Token hinzu? | Must Have | ✅ Unterstützt |
| Datenresidenz | Behält Logs innerhalb Ihrer Region (EU/US)? | Abhängig vom Anwendungsfall | ✅ Unterstützt |
| Latenzbasiertes Routing | Routet automatisch um basierend auf Echtzeit-Latenz/Fehlern? | Must Have | ✅ Unterstützt |
| Schlüssel-Rotation & Widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüssel-Rotation & Widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüssel-Rotation & Widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüssel-Rotation & Widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüssel-Rotation & Widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |

Portkey ist eine Plattform, die bei der Verwaltung und Optimierung der LLM-Nutzung über verschiedene Anbieter hinweg hilft. Sie bietet Funktionen wie Caching, Fallback, Rate Limiting und Observability, um KI-Apps zuverlässiger und kosteneffizienter zu machen. Teams nutzen Portkey, um ihre KI-Infrastruktur zu rationalisieren und vertrauensvoll zu skalieren.
Portkey hat eine umfassende KI-Infrastrukturplattform aufgebaut, die weit über Observability hinaus in den Bereich der LLM-Operations in der Produktion reicht. Mit über 650 bedienten Organisationen und mehr als 2,5 Billionen verarbeiteten Token positioniert sich Portkey als Lösung für Enterprise-KI-Teams.
Umfassende Funktionsabdeckung
Im Gegensatz zu reinen Observability-Plattformen bietet Portkey den vollständigen Stack an LLM-Infrastrukturfunktionen (eine komplette AI Gateway-Infrastruktur). Der konfigurationsgesteuerte Ansatz der Plattform ermöglicht es Teams, komplexe Routing-Logik, Fallback-Strategien und Governance-Richtlinien ohne Codeänderungen zu definieren. Dies spricht Organisationen an, die anspruchsvolle LLM-Operations benötigen, aber nicht über die Engineering-Ressourcen verfügen, um alles von Grund auf neu zu bauen.
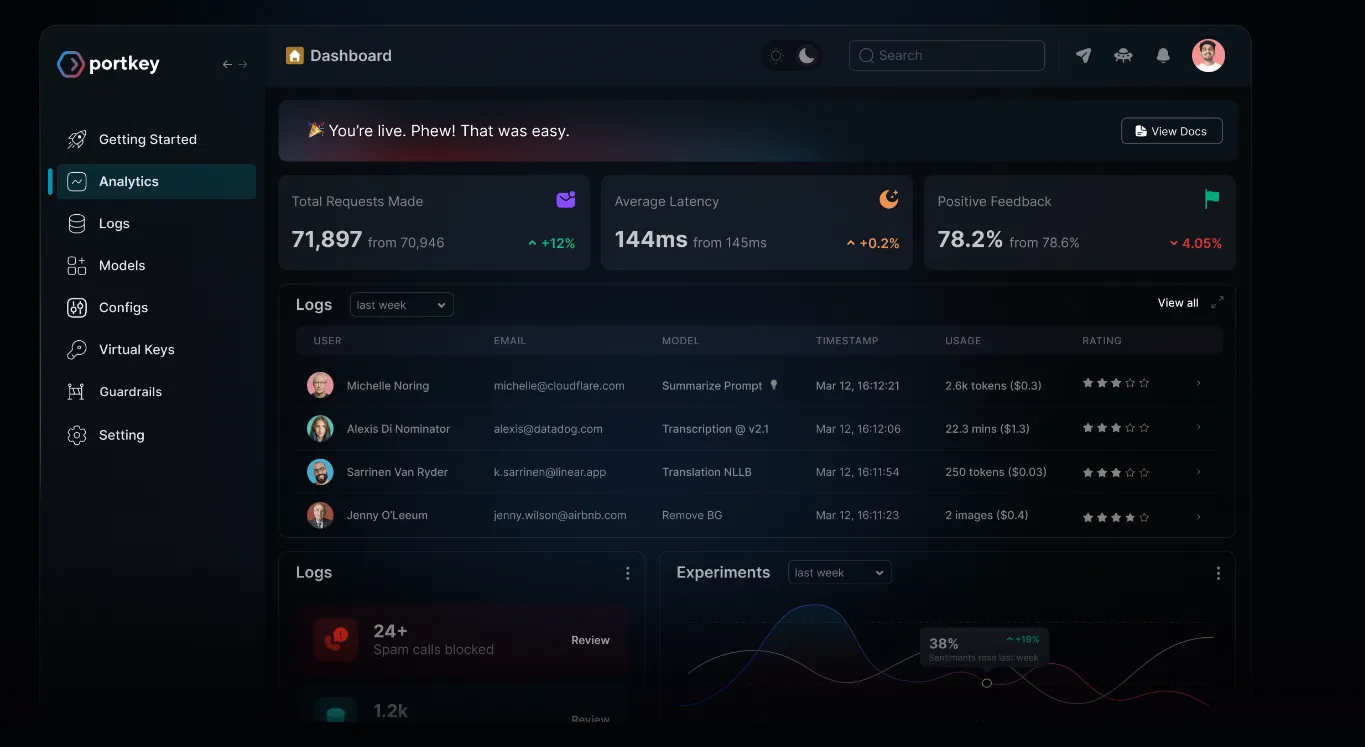
Enterprise-First-Design
Der Enterprise-Fokus von Portkey zeigt sich in seinen umfassenden Compliance-Zertifizierungen: SOC 2 Type II, ISO 27001, HIPAA und GDPR. Die Plattform unterstützt Bereitstellungsmodelle von SaaS bis hin zu vollständig isolierten (Air-Gapped) On-Premises-Installationen.
Rollenspezifische Zugriffskontrollen (RBAC) lassen sich in Identity-Provider von Unternehmen integrieren, Audit-Logging erfüllt regulatorische Anforderungen, und die Plattform bietet eine detaillierte Zuordnung von Kosten zu Teams, Projekten und Kostenstellen. Diese Funktionen sind von enormer Bedeutung für große Organisationen, in denen die LLM-Nutzung schnell unüberschaubar werden kann.
Realitätscheck bei der Leistung
Hier zeigen sich die Kosten des umfassenden Ansatzes von Portkey. Unabhängige Benchmarks zeigen, dass Portkey deutlich langsamer abschneidet als spezialisierte Gateways, mit einer um 228 % höheren Latenz im Vergleich zum Kong AI Gateway in standardisierten Tests. Selbst Portkeys eigene Angaben von 20–40 ms zusätzlicher Latenz können für latenzempfindliche Anwendungen problematisch werden.
Der Leistungsnachteil resultiert aus der funktionsreichen Architektur von Portkey. Jede Anfrage durchläuft mehrere Schichten: Routing-Logik, Guardrails-Evaluierung, Prompt-Management, Observability-Erfassung und Kostenberechnung. Während jede Funktion einen Mehrwert bietet, erzeugen sie gemeinsam einen erheblichen Overhead.
Der Ressourcenverbrauch spiegelt diese Komplexität wider. Portkey-Deployments in der Produktion erfordern deutlich mehr Rechenleistung und Speicher als reine Gateway-Lösungen. Teams berichten von Schwierigkeiten bei der Leistungsoptimierung für Anwendungen mit hohem Durchsatz.
Komplexität der Preisgestaltung
Das Preismodell von Portkey spiegelt seine Umfassendheit wider, schafft aber Herausforderungen bei der Vorhersehbarkeit. Die Plattform bietet mehrere Stufen:
Das nutzungsbasierte Modell der Portkey-Preise kann bei großer Skalierung zu Budgetüberraschungen führen, was viele Unternehmen dazu veranlasst, sich nach Portkey-Alternativen umzusehen. Im Gegensatz zu einfachen Preisen pro Anfrage variieren die Kosten bei Portkey je nach Funktionsnutzung, Datenaufbewahrungsfristen und Compliance-Anforderungen. Teams berichten von Schwierigkeiten bei der Vorhersage monatlicher Kosten, insbesondere in Entwicklungsphasen mit unvorhersehbaren Verkehrsmustern.
Fokus der Plattform auf die Orchestrierung externer APIs schränkt zudem die Flexibilität ein. Organisationen, die selbst gehostete Modelle bereitstellen oder benutzerdefinierte Routing-Logiken implementieren möchten, sehen sich möglicherweise durch die Architekturentscheidungen von Portkey eingeschränkt.
Beim Vergleich von Langfuse und Portkey laufen die Hauptunterschiede auf den Schwerpunkt und den Umfang hinaus. Langfuse wurde als Open-Source-Observability- und Evaluierungsschicht entwickelt, die Entwicklern detaillierte Einblicke in Prompts, Kosten und Modellleistung bietet.
Portkey hingegen positioniert sich als vollständiges AI Gateway, das Observability mit erweiterten Funktionen wie Multi-Modell-Routing, Caching, Guardrails und Governance kombiniert. Im Wesentlichen geht es bei Langfuse mehr um Transparenz und Debugging, während es bei Portkey um Zuverlässigkeit und Skalierung von Produktions-Workloads geht.
Hier sind die wichtigsten Unterschiede zwischen den beiden Plattformen:
Sowohl Langfuse als auch Portkey bringen einzigartige Stärken in die LLM-Entwicklung ein. Langfuse eignet sich am besten für Teams, die Open-Source-Observability, detaillierte Evaluierung und die vollständige Kontrolle über ihre Workflows wünschen. Portkey ist hingegen die stärkere Wahl für Organisationen, die sich auf Skalierung, Zuverlässigkeit und die Verwaltung von Multi-Modell-Infrastrukturen auf Produktionsebene konzentrieren.
Portkey wurde für Teams entwickelt, die über die Experimentierphase hinausgehen und LLMs in die Produktion bringen. Es dient als universelles AI Gateway, Observability-Schicht und Governance-Tool, was es ideal macht, wenn Zuverlässigkeit, Skalierbarkeit und Flexibilität bei mehreren Anbietern entscheidend sind.
Multi-Modell- und Multi-Anbieter-Zugriff: Wenn Ihre Anwendung mit mehreren LLMs arbeiten muss (OpenAI, Anthropic, Cohere, Mistral oder Open-Source-Modellen), hebt die einheitliche API von Portkey den Vendor-Lock-in auf. Sie können zwischen 250+ Modellen wechseln oder routen, ohne Code neu zu schreiben, was für Ausfallsicherheit und Leistungsoptimierung entscheidend ist.
Zuverlässigkeit bei Skalierung: Für Produktions-Workloads bietet Portkey automatische Wiederholungsversuche (Retries), Failover, Circuit Breaker und bedingtes Routing. Diese Funktionen stellen die Betriebszeit und eine konsistente Leistung auch bei hohem Datenverkehr oder Latenzspitzen eines Anbieters sicher.
Kosten- und Latenzoptimierung: Integriertes einfaches und semantisches Caching reduziert redundante Anfragen, senkt die Inferenzkosten und beschleunigt die Antworten. Dies ist besonders nützlich für Apps mit sich wiederholenden Abfragen oder einer Nutzerbasis mit hohem Datenverkehr.
Sicherheit und Governance: Portkey verwaltet API-Anmeldeinformationen über virtuelle Schlüssel, wendet Rate Limits an und setzt Budgetkontrollen durch. Es enthält außerdem über 50 Guardrails zum Filtern unsicherer oder nicht konformer Ausgaben, was es einsatzbereit für Unternehmen macht.
Agentische und komplexe Workflows: Beim Bau von KI-Agenten oder Multi-Agenten-Systemen bietet Portkey die Orchestrierungsschicht, die Routing, Observability und Guardrails über Agenten hinweg verwaltet und die Workflows bei der Skalierung stabil hält.
Nutzen Sie Portkey, wenn Sie LLM-Anwendungen zuverlässig skalieren, Kosten optimieren, mehrere Anbieter verwalten und Enterprise-Governance durchsetzen müssen – alles über eine zentrale Steuerungsebene (Control Plane).
Langfuse ist für Teams konzipiert, die tiefe Einblicke in das Verhalten ihrer LLM-Anwendungen wünschen. Es ist eine Open-Source-Plattform für Observability und Evaluierung, die sich ideal eignet, wenn das Debuggen, Überwachen und Verbessern der Modellleistung oberste Priorität haben.
Tracing und Observability: Nutzen Sie Langfuse, wenn Sie detaillierte Traces jeder Interaktion, Prompts, Antworten, Werkzeugaufrufe, Retries und Latenzen benötigen. Es hilft Entwicklern, den gesamten Weg einer Anfrage zu sehen, was das Identifizieren von Engpässen oder Fehlern in komplexen LLM-Workflows erleichtert.
Prompt-Management und Experimentieren: Wenn Ihre Anwendung stark von Prompt Engineering abhängt, ist Langfuse von unschätzbarem Wert. Es unterstützt Versionskontrolle, Playground-Tests und Side-by-Side-Prompt-Experimente. Dies erleichtert das schnelle Iterieren, während Sie stets den Überblick behalten, was am besten funktioniert.
Evaluierungs- und Feedback-Schleifen: Langfuse verfügt über integrierte Evaluierungs-Pipelines, von automatisierter LLM-as-a-Judge-Bewertung bis hin zu manuellem Labeling und strukturierten Datensätzen. Verwenden Sie es, wenn Sie Genauigkeit, Zuverlässigkeit oder Benutzerzufriedenheit systematisch messen möchten.
Open-Source und selbst hostbar: Wenn Ihr Team Wert auf Transparenz und Kontrolle legt, ist Langfuse vollständig Open-Source und kann selbst gehostet werden. Das macht es besonders attraktiv für Start-ups und Unternehmen mit strengen Anforderungen an die Data Governance.
Debugging und kontinuierliche Verbesserung: Langfuse glänzt, wenn Ihr Fokus auf der Qualitätsverbesserung und nicht nur auf der reinen Skalierung liegt. Es fungiert als „Blackbox-Rekorder“ für Ihr KI-System und hilft Ihnen, Fehler zu verstehen, Prompts zu verfeinern und bessere Erlebnisse zu liefern. Wählen Sie Langfuse, wenn Sie detaillierte Einblicke, Evaluierungen und die Flexibilität von Open Source benötigen, um Ihre LLM-Anwendungen kontinuierlich zu verbessern.
Die LLM-Infrastrukturlandschaft ist heute fragmentiert – Teams nutzen oft separate Tools für Observability, Gateways und Modellbereitstellung, was zu Kompromissen bei Leistung und Funktionalität führt. TrueFoundry löst dies durch die Bereitstellung einer einheitlichen Plattform, die Geschwindigkeit, Enterprise-Funktionen und Kostenoptimierung kombiniert.
Im Kern erreicht TrueFoundry eine Latenz von unter 3 ms und bietet gleichzeitig vollständige Gateway- und Observability-Funktionen. Von Grund auf für Unternehmen entwickelt, verwaltet es Authentifizierung, Autorisierung und Rate Limiting im Arbeitsspeicher (in-memory) und stellt so die Leistung sicher, selbst wenn Agenten hunderte von Tool-Aufrufen pro Konversation tätigen. Intelligentes Routing steigert die Effizienz weiter, indem es dynamisch das beste Modell für jede Anfrage basierend auf Kosten, Leistung und Compliance-Anforderungen auswählt.
Die Plattform unterstützt zudem flexible Bereitstellungsmodelle – Cloud-native, On-Premises, Air-Gapped oder Hybrid – abgesichert durch SOC 2 Type 2- und HIPAA-Zertifizierungen. Sein Kubernetes-natives Design sorgt für eine reibungslose Integration in die Unternehmensinfrastruktur.
Auf der Kostenseite geht TrueFoundry über den einfachen Anbieterwechsel hinaus und bietet semantisches Caching, automatische Skalierung und verkehrsbewusstes Ressourcenmanagement – was Organisationen hilft, Kosten zu senken und gleichzeitig die Zuverlässigkeit zu wahren.
Ein wichtiges Alleinstellungsmerkmal ist die Exzellenz bei selbst gehosteten Modellen. TrueFoundry unterstützt führende Serving-Frameworks, GPU-Optimierung und einheitliche APIs für Cloud- und On-Premise-Modelle. Dies ermöglicht es Unternehmen, proprietäre Modelle sicher bereitzustellen, Vendor-Lock-in zu reduzieren und Datensouveränitätsanforderungen zu erfüllen – alles auf einer konsolidierten Plattform.
Die Entscheidung zwischen Langfuse und Portkey hängt von den technischen Fähigkeiten und Leistungsanforderungen Ihrer Organisation ab. Langfuse glänzt bei Teams, die Open-Source-Flexibilität priorisieren und die betriebliche Komplexität verwalten können. Portkey eignet sich für Organisationen, die umfassende LLMOps-Funktionen benötigen und dafür Leistungskompromisse für den Funktionsreichtum in Kauf nehmen.
TrueFoundry beseitigt diese Grundentscheidung, indem es eine Latenz von unter 3 ms zusammen mit Enterprise-Observability, einheitlicher Modellbereitstellung und umfassender Governance bietet. Anstatt Teams in komplexe Multi-Tool-Infrastrukturen zu drängen, bietet die einheitliche Architektur von TrueFoundry die Leistung, Sicherheit und betriebliche Tiefe, die für missionskritische KI-Deployments erforderlich sind. Da KI-Funktionen rasch zur Dutzendware werden, wird die Infrastruktur, die eine zuverlässige, beobachtbare und kosteneffiziente Bereitstellung ermöglicht, zum wahren Differenzierungsmerkmal.
Beim Vergleich von Langfuse vs. Portkey liegt der Hauptunterschied in ihrem funktionalen Schwerpunkt: Langfuse ist eine spezialisierte Plattform für Observability und Tracing, während Portkey in erster Linie ein AI Gateway ist. Langfuse zeichnet sich durch das Debuggen komplexer LLM-Ausgaben über tiefe Tracing- und Evaluierungs-Frameworks aus, während Portkey die Systemzuverlässigkeit durch automatische Fallbacks, Lastverteilung und Anbietermanagement in den Vordergrund stellt, um eine hohe Verfügbarkeit zu gewährleisten.
TrueFoundry dient als umfassende Alternative zu Langfuse vs. Portkey, indem es Observability und Infrastrukturmanagement auf einer einzigen Steuerungsebene vereint. Im Gegensatz zu eigenständigen Proxys oder Tracing-Tools wird TrueFoundry nativ in Ihrer privaten VPC bereitgestellt, um sicherzustellen, dass sensible Daten niemals Ihre Grenzen verlassen. Es bietet die Tracing- und Evaluierungsfunktionen von Langfuse zusammen mit dem hochperformanten Routing von Portkey, während es gleichzeitig die zugrunde liegende GPU-Orchestrierung verwaltet.
Bei der Bewertung von Langfuse vs. Portkey für agentische Workflows wird Langfuse oft zur Visualisierung mehrstufiger Gedankengänge ("Chains of Thought") bevorzugt, während Portkey gewählt wird, um Agentenausfälle bei Anbieterausfällen zu verhindern. TrueFoundry verbessert diese agentischen Architekturen durch native Unterstützung für das Model Context Protocol (MCP), wodurch Agenten sicher mit internen Tools interagieren können. Dies bietet eine sicherere Umgebung für Agenten, um Entscheidungen zu treffen und Aufgaben mit zentraler Sicherheits- und Kostengovernance auszuführen.
Keine von beiden ist vollständig der Kostenverwaltung gewidmet. Langfuse schätzt die Kosten basierend auf der Token-Nutzung, während Portkey Gateway-Nutzungsanalysen bietet. Für eine robuste Kostengovernance und Budgetierung werden dedizierte Tools wie AI Cost Board empfohlen, die detaillierte Einblicke, Berichte und Anomalieerkennung bieten, um LLM-Betriebskosten effektiv zu verwalten.
Ja, Langfuse ist Open-Source und unterstützt Self-Hosting, was die volle Kontrolle über Bereitstellung, Sicherheit und Konfiguration ermöglicht. Portkey hingegen ist in erster Linie ein verwalteter Dienst (Managed Service) mit Enterprise-Optionen, was bedeutet, dass ein Self-Hosting Enterprise-Lizenzen oder Workarounds erfordert. TrueFoundry unterstützt private Bereitstellungen von Haus aus und kombiniert selbst gehostete Kontrolle mit Enterprise-Zuverlässigkeit.
Langfuse zeichnet sich bei Evaluierungs-Workflows aus und bietet Tracing auf Token-Ebene, Output-Scoring und Debugging-Pipelines. Portkey konzentriert sich auf betriebliche Zuverlässigkeit, Routing und Fallback-Mechanismen, wodurch es weniger für tiefe Evaluierungen geeignet ist. TrueFoundry schlägt die Brücke zwischen beiden Anforderungen und bietet umfassende Observability und Evaluierung gepaart mit hochperformanter Bereitstellung und automatisiertem KI-Workflow-Management.
Portkey verwaltet das Routing über mehrere Anbieter hinweg mit automatischer Lastverteilung, Failovers und Anbieterauswahl. Langfuse hingegen verfolgt Ausgaben und Leistung über mehrere Modelle hinweg, orchestriert jedoch kein Routing. TrueFoundry kombiniert beides: Es überwacht LLM-Ausgaben und verteilt Anfragen intelligent auf verschiedene Anbieter, um Effizienz und Zuverlässigkeit zu maximieren.
Ja. TrueFoundry integriert optimierte Inference-Engines, GPU-Orchestrierung und intelligentes Routing, um Antwortzeiten zu minimieren. Im Gegensatz zu Langfuse, das sich auf Observability konzentriert, und Portkey, das Zuverlässigkeit gewährleistet, bringt TrueFoundry Geschwindigkeit, Skalierbarkeit und Monitoring in Einklang und liefert KI-Antworten mit geringer Latenz in Produktionsumgebungen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















