



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
AI-Coding-Tools gehören heute zum Entwickleralltag. Entwickler nutzen Produkte wie Claude Code, Cline, Cursor, Gemini CLI, OpenAI Codex CLI, Qwen Code CLI, Roo Code und Goose, um Code zu generieren, zu refaktoren, zu debuggen und große Codebases direkt aus dem Editor oder Terminal zu erklären. Das Problem in den meisten Unternehmen ist nicht die Akzeptanz. Das Problem ist die Governance. Jedes Tool kann mit einem oder mehreren Modellanbietern kommunizieren. Jedes Tool speichert Schlüssel oft lokal. Teams enden schnell mit dutzenden unverwalteten Zugriffspunkten zu externen Modellen. Das schafft reale Risiken in Bezug darauf, welche Modelle genehmigt sind, wohin Code und Kontext gesendet werden, wie Ausgaben zugeordnet werden und wie Vorfälle untersucht werden. Es erschwert auch die Zuverlässigkeit, da Routing und Fallbacks über verschiedene Tools hinweg uneinheitlich sind.
Wenn Sie versuchen, dies manuell zu lösen, bauen Sie normalerweise einen internen Proxy, auf den jede IDE und CLI verweist. Dieser Proxy benötigt Authentifizierung, Autorisierung, Whitelists für genehmigte Modelle, Provider-Routing, Audit-Logs, Rate Limiting, Budgetkontrollen und Observability. Er muss außerdem mit den APIs kompatibel sein, die diese Tools erwarten. Viele Tools sprechen eine OpenAI-kompatible API, haben aber auch Besonderheiten bei der Modellbenennung und spezielle Verhaltensweisen, die Sie handhaben müssen.
Hier ist ein kleines einfaches Beispiel, das zeigt, warum dies zu echter Entwicklungsarbeit wird. Es ist nicht produktionsreif. Es soll nur den Umfang des Problems verdeutlichen.
from fastapi import FastAPI, Request, HTTPException
import time
import httpx
app = FastAPI()
APPROVED_MODELS = {
"gpt-4o": {"provider": "openai", "target": "gpt-4o"},
"claude-3-5-sonnet": {"provider": "anthropic", "target": "claude-3-5-sonnet"},
}
OPENAI_URL = "https://api.openai.com/v1/chat/completions"
ANTHROPIC_URL = "https://api.anthropic.com/v1/messages"
def verify_token(auth_header: str) -> dict:
# In reality this is JWT validation against Okta or your IdP.
if not auth_header or not auth_header.startswith("Bearer "):
raise HTTPException(status_code=401, detail="missing token")
return {"user": "alice", "team": "platform"}
@app.post("/v1/chat/completions")
async def chat_completions(req: Request):
user_ctx = verify_token(req.headers.get("authorization"))
body = await req.json()
model = body.get("model")
if model not in APPROVED_MODELS:
raise HTTPException(status_code=403, detail="model not approved")
route = APPROVED_MODELS[model]
started = time.time()
async with httpx.AsyncClient(timeout=60) as client:
if route["provider"] == "openai":
upstream = await client.post(
OPENAI_URL,
headers={"Authorization": "Bearer " + "UPSTREAM_OPENAI_KEY"},
json={**body, "model": route["target"]},
)
else:
# You would also need request and response transforms here.
upstream = await client.post(
ANTHROPIC_URL,
headers={"x-api-key": "UPSTREAM_ANTHROPIC_KEY"},
json={"model": route["target"], "messages": body.get("messages", [])},
)
latency_ms = int((time.time() - started) * 1000)
# In reality you would emit OpenTelemetry traces and structured logs here.
print("llm_request", {"user": user_ctx["user"], "model": model, "latency_ms": latency_ms})
return upstream.json()
Selbst in dieser vereinfachten Version sehen Sie fehlende Teile. Sie benötigen weiterhin robuste Transformationen über Anbieter hinweg, Streaming-Unterstützung, Retries, Fallbacks, sicheres Durchreichen von Headern, Mandanten- und Team-Scoping sowie dauerhafte Audit-Logs. Sie benötigen außerdem ein Konfigurationssystem, das über Teams hinweg skaliert.
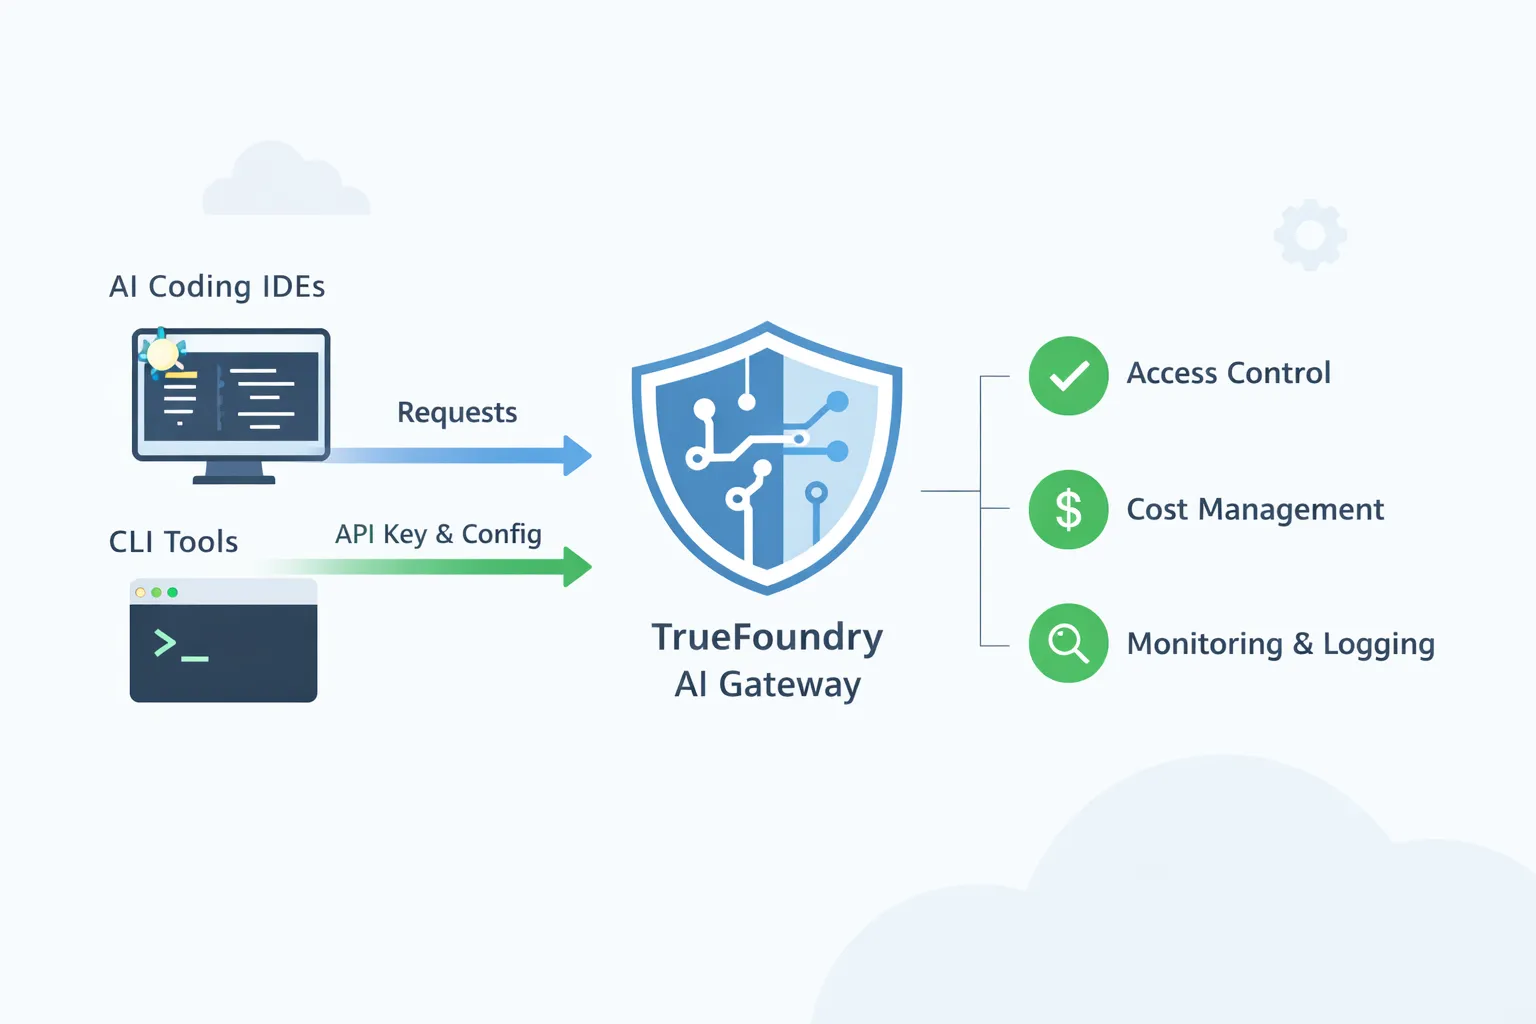
Das TrueFoundry AI Gateway ist so konzipiert, dass es dieser gemeinsame Kontrollpunkt ist. IDEs und CLIs nutzen weiterhin die Workflows, die Entwickler bereits schätzen, aber der Datenverkehr wird über ein einzelnes, verwaltetes Gateway geleitet. Das Gateway wird zum Ort, an dem Platform-Teams den Zugriff auf genehmigte Modelle durchsetzen, Richtlinien anwenden und vollständige Transparenz über die Nutzung erhalten.
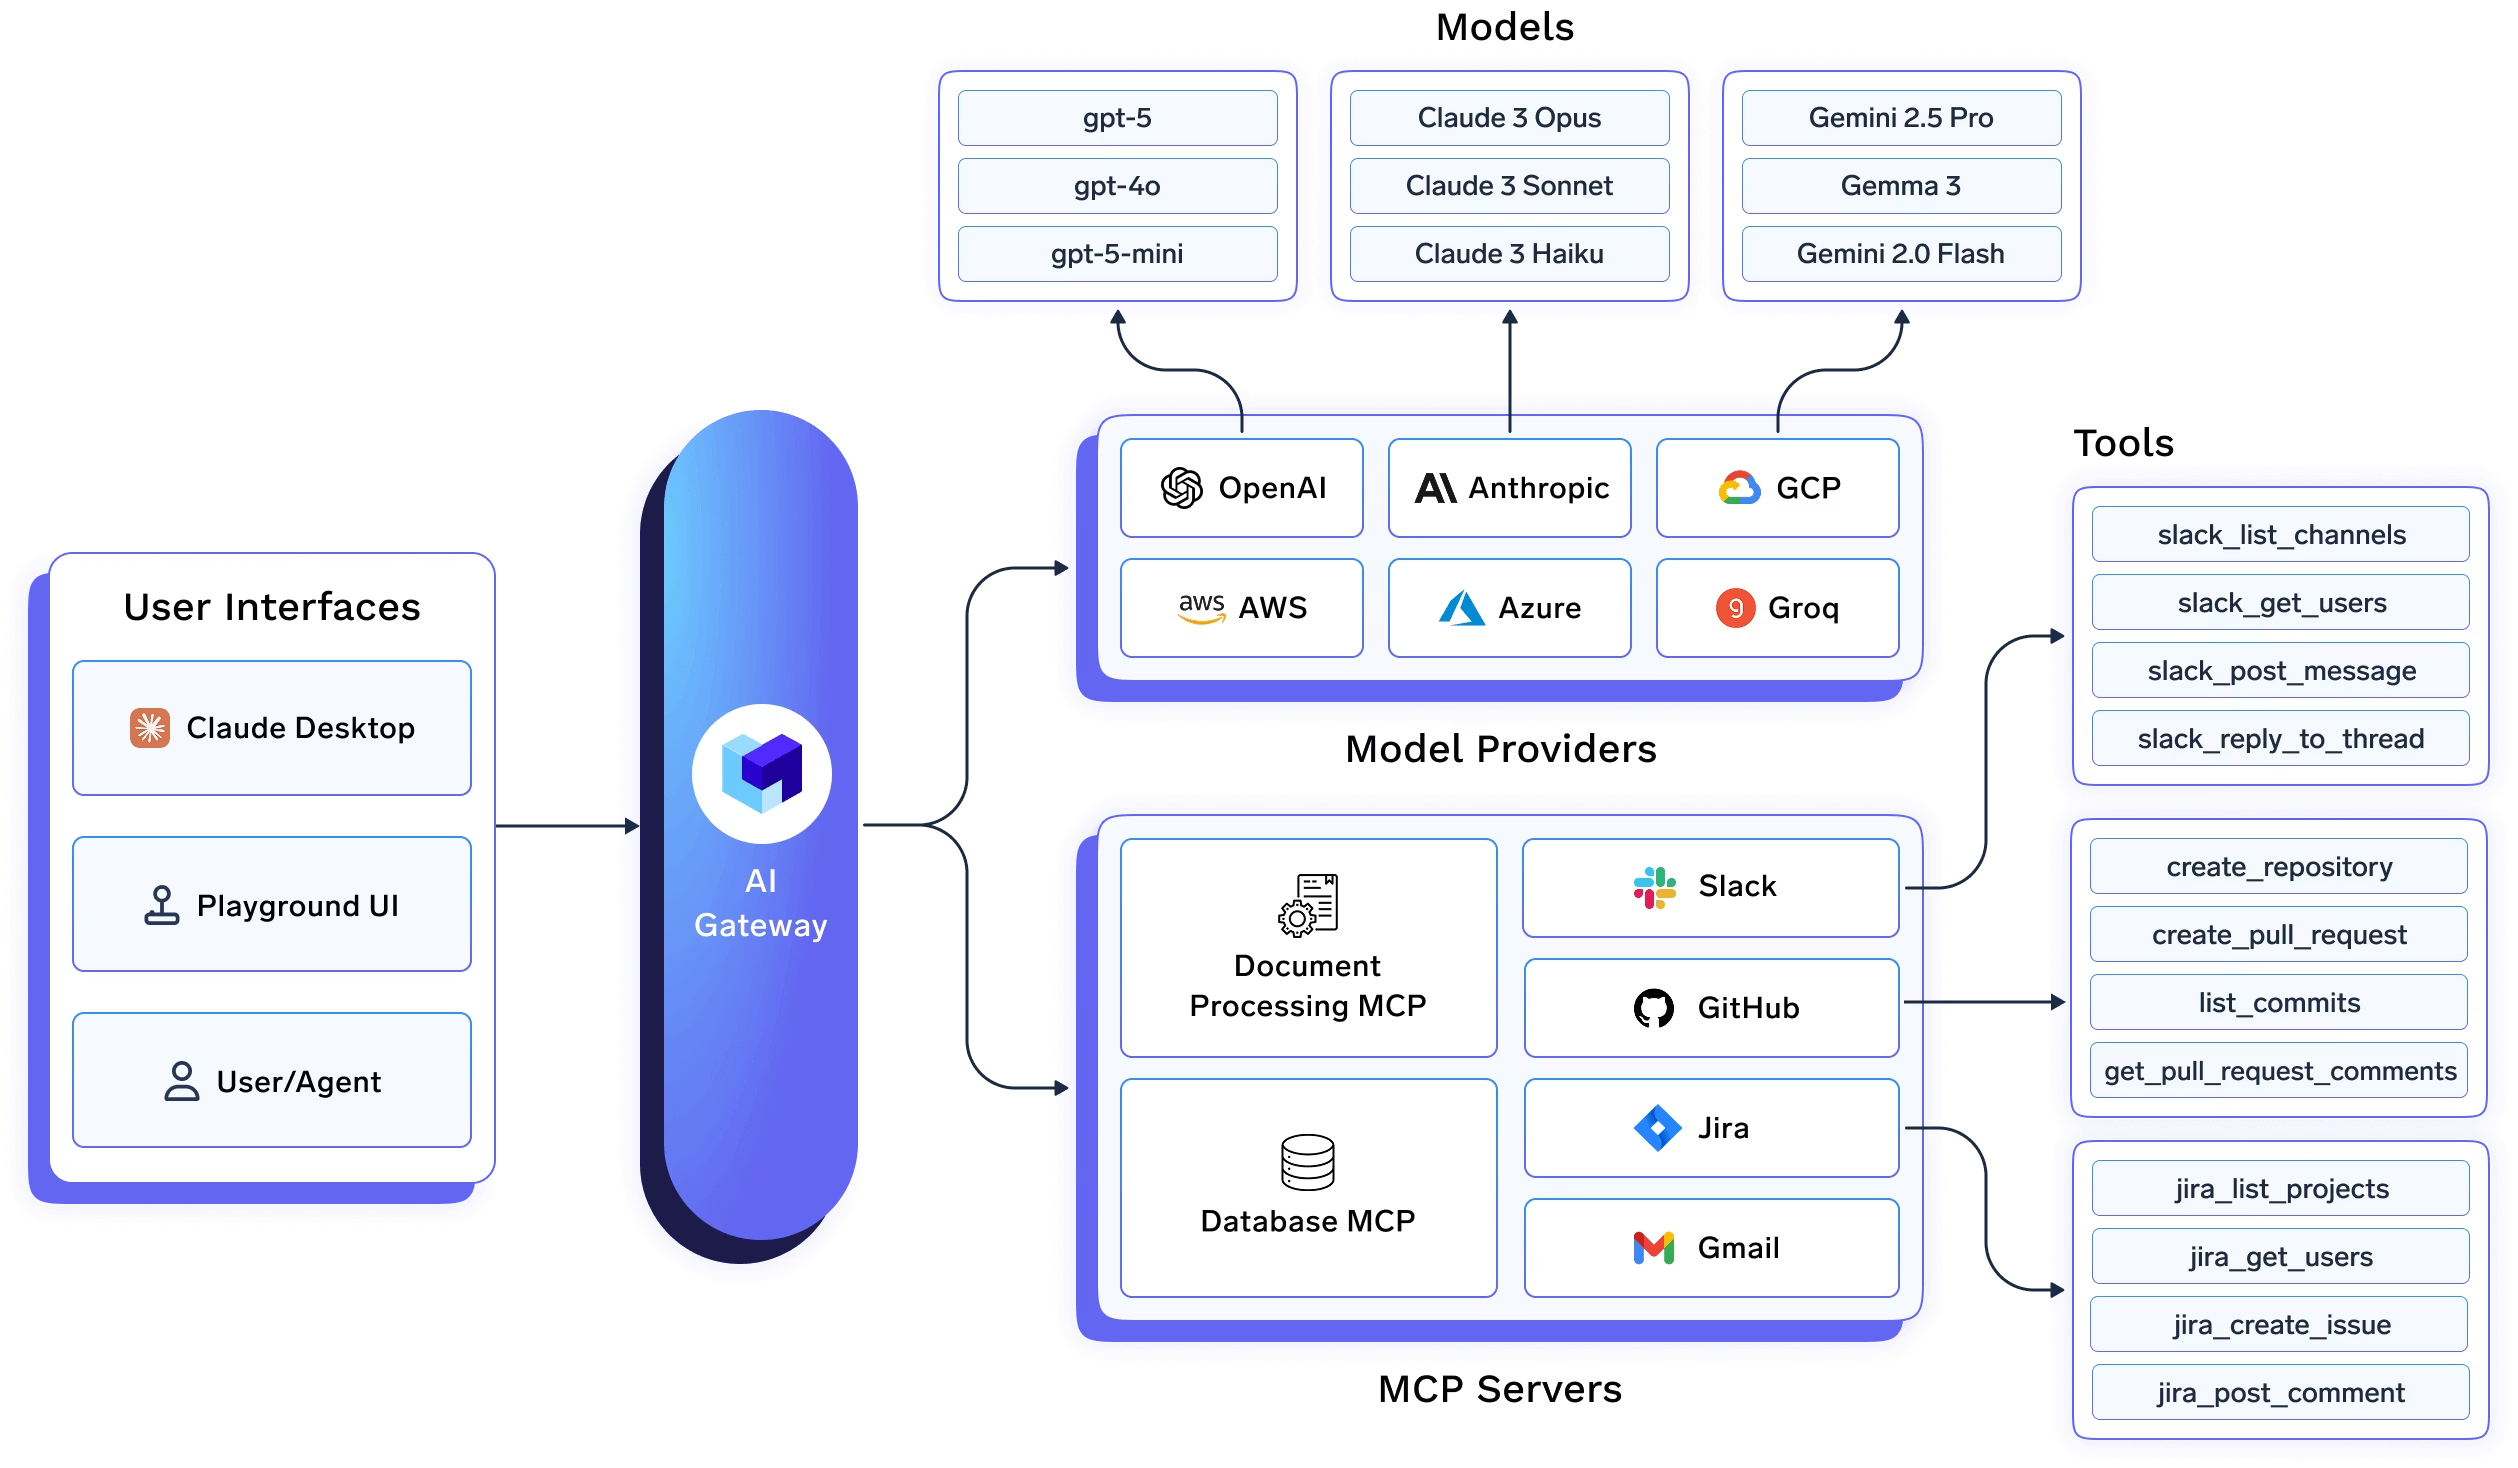
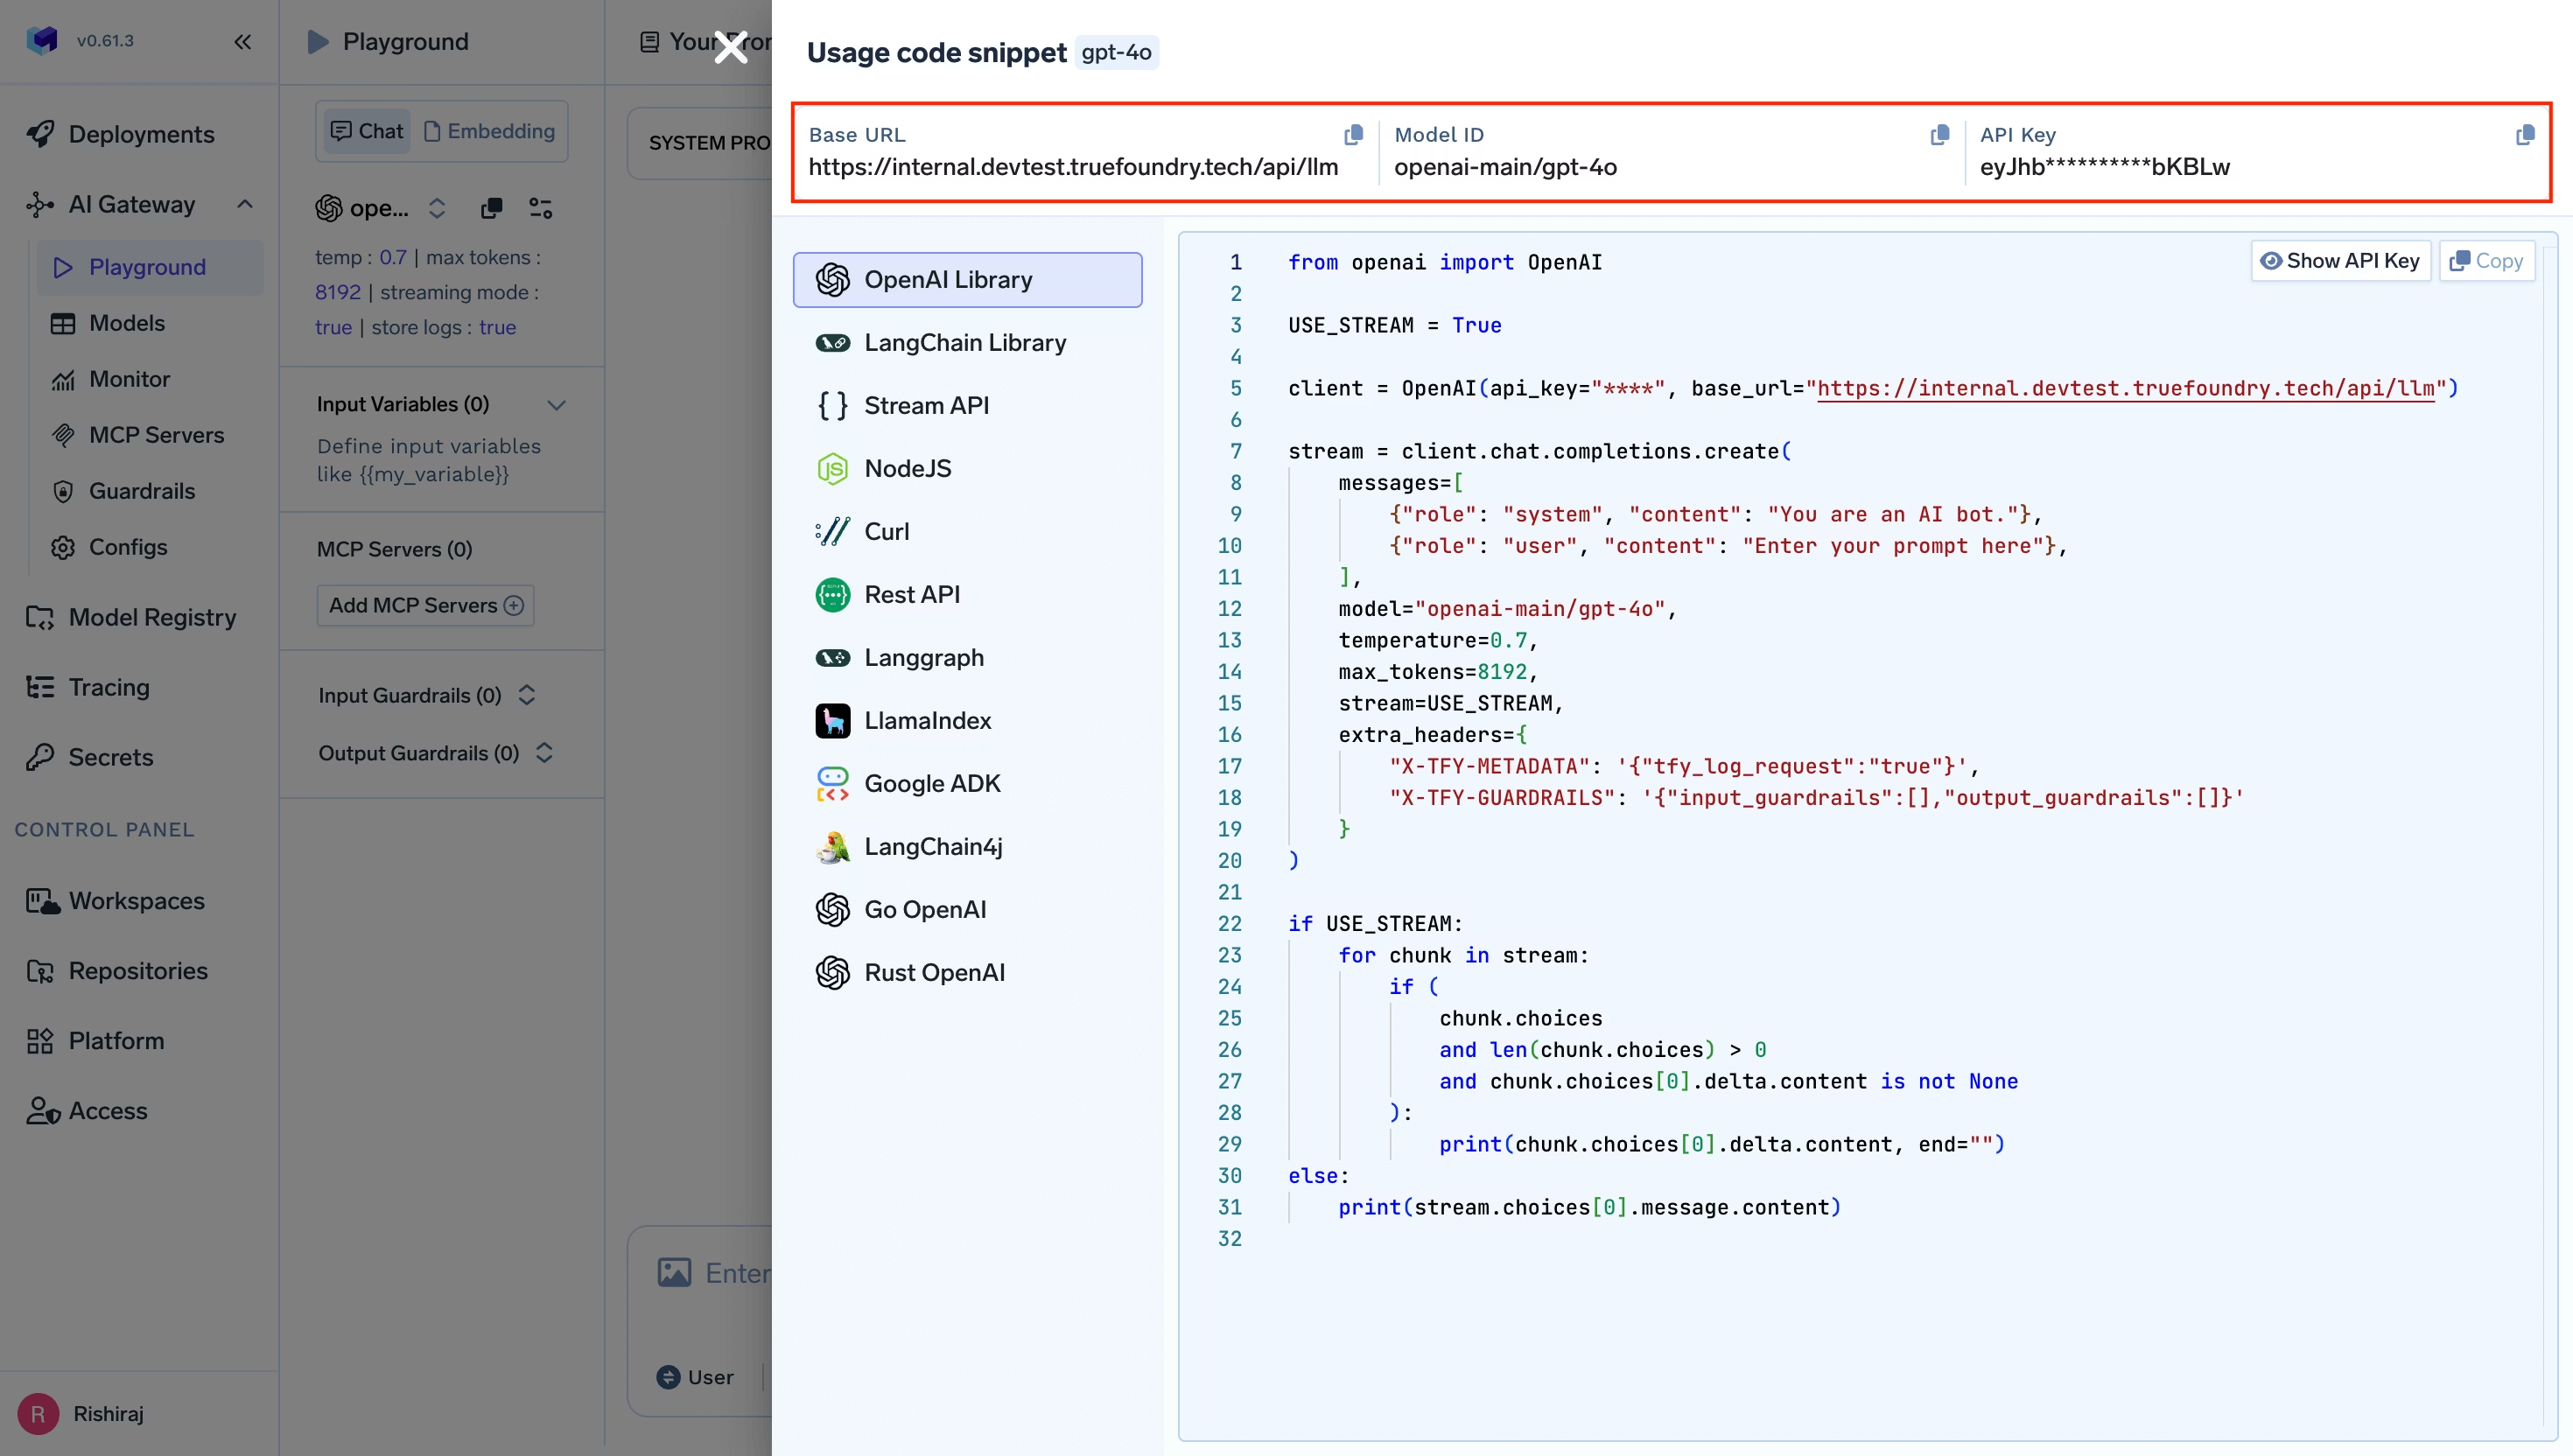
Ein zentrales Thema in allen IDE-Anleitungen ist einfach. Sie holen sich die Base-URL und den Modellnamen aus dem TrueFoundry AI Gateway Playground. Anschließend konfigurieren Sie die IDE oder CLI so, dass diese Base-URL und ein TrueFoundry-Token verwendet werden.
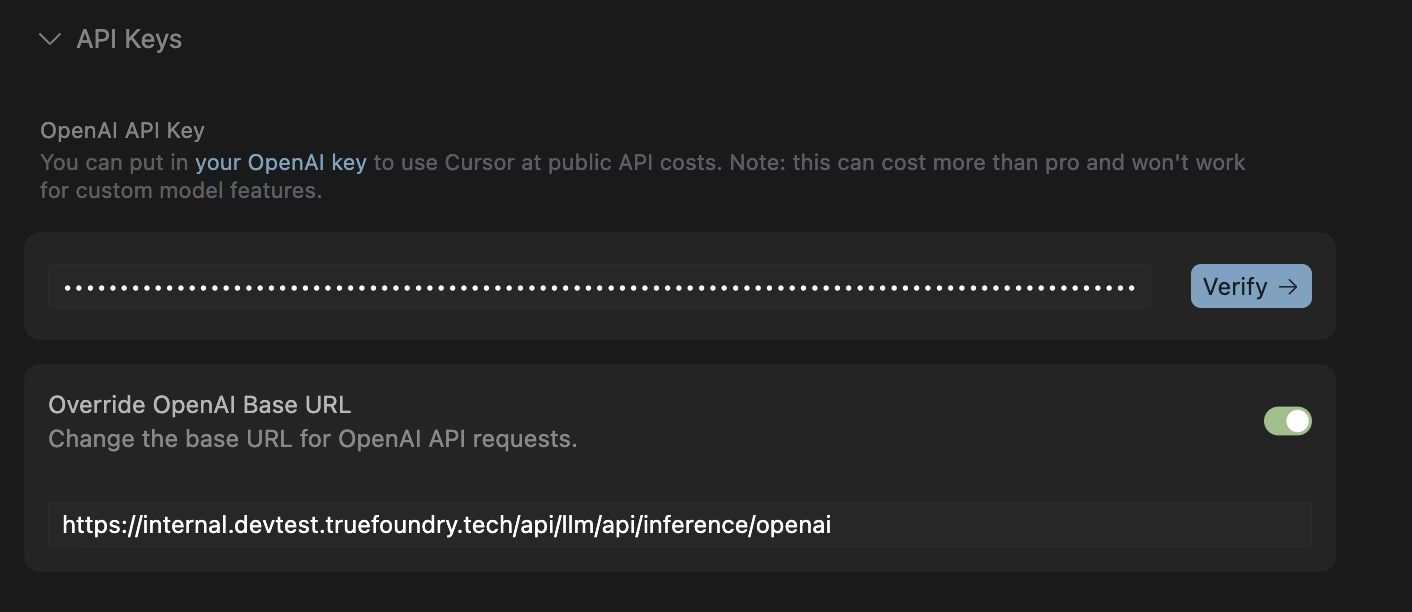
Die meisten AI-Coding-IDEs und Desktop-Tools können auf einen einzelnen OpenAI-kompatiblen Endpunkt ausgerichtet werden. Das TrueFoundry AI Gateway bietet Ihnen diesen Endpunkt. Sie starten im Gateway Playground und kopieren das einheitliche Snippet. Dieses Snippet gibt Ihnen die Base-URL und den Modellnamen, den Sie verwenden sollten. Öffnen Sie dann die IDE-Einstellungen und wählen Sie eine Provider-Option, die eine benutzerdefinierte Base-URL unterstützt. Viele Tools nennen dies OpenAI-kompatibel. Sie fügen die Gateway-Base-URL ein. Sie fügen ein TrueFoundry-Token als API-Schlüssel ein. Das Token kann ein persönliches Token für einen Entwickler oder ein virtuelles Account-Token für die geteilte oder automatisierte Nutzung sein. TrueFoundry dokumentiert beide Optionen und empfiehlt das virtuelle Account-Token für den produktiven Einsatz. Mehr hier lesen
Einige IDEs funktionieren am besten, wenn sie kurze Standard-Modellnamen wie gpt 4o sehen. TrueFoundry-Modellnamen sind oft vollständig qualifiziert. Die empfohlene Lösung besteht darin, eine Routing- oder Load-Balancing-Regel im Gateway zu definieren, damit die IDE weiterhin den kurzen Namen verwendet, während das Gateway ihn auf das vollständig qualifizierte Zielmodell abbildet. Cursor und Codex dokumentieren beide dieses Muster, da sie interne Logik an Standard-Modellnamen gebunden haben. Cursor-docs
Es kann auch Netzwerkeinschränkungen geben. Cursor dokumentiert, dass sein Anfragefluss Cursor-Server einbeziehen kann. Das bedeutet, dass die Gateway-URL von der Cursor-Infrastruktur aus erreichbar sein muss. In der Praxis benötigt der Gateway-Endpunkt öffentliche Erreichbarkeit, damit Cursor wie in der Anleitung beschrieben funktioniert.
CLI-Tools werden in der Regel über Umgebungsvariablen oder eine lokale Konfigurationsdatei integriert. Für OpenAI-kompatible CLIs besteht das übliche Muster darin, OPENAI_BASE_URL auf den TrueFoundry Gateway-Endpunkt und OPENAI_API_KEY auf ein TrueFoundry-Token zu setzen. TrueFoundry dokumentiert dies als unterstützten Authentifizierungsansatz für das Gateway. Mehr lesen: Authentifizierung
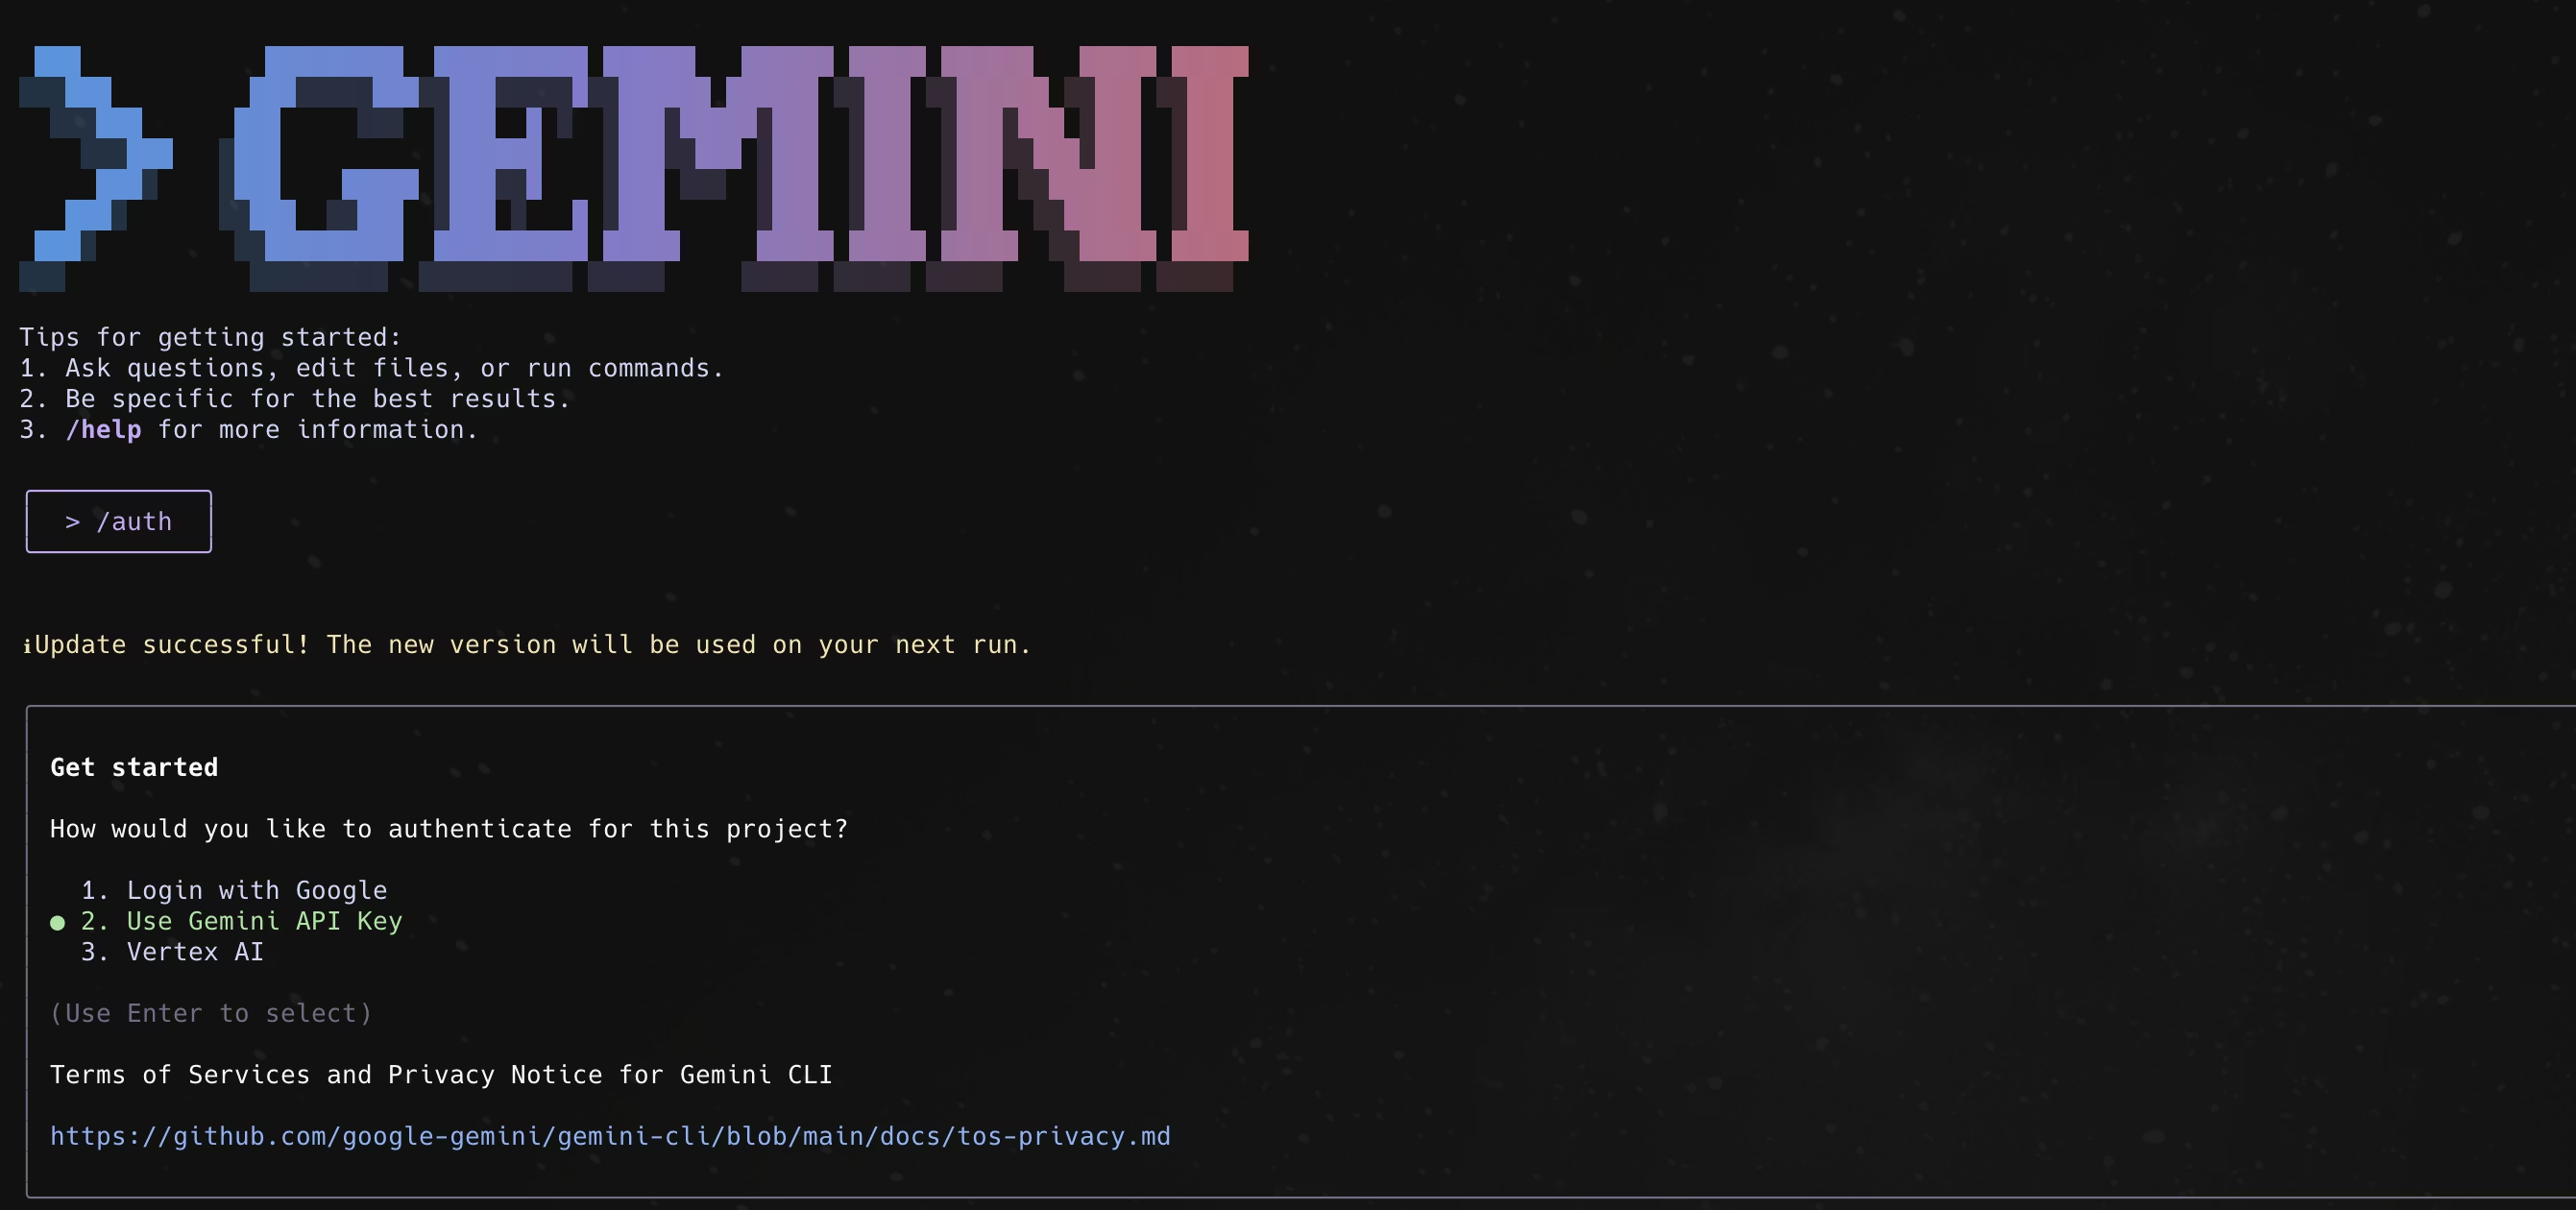
Einige CLIs verwenden anbieterspezifische Variablen. Gemini CLI verwendet eine Gemini-Base-URL und einen Gemini-API-Schlüssel. Die TrueFoundry-Anleitung zeigt, wie Sie GOOGLE_GEMINI_BASE_URL auf eine TrueFoundry Gemini-Proxy-URL und GEMINI_API_KEY auf ein TrueFoundry-Token setzen, sodass jede Anfrage über das Gateway fließt. Mehr lesen: Gemini-cli
Andere CLIs stützen sich auf eine settings.json-Datei. Claude Code wird über eine settings.json-Datei konfiguriert, die env-Werte für die Base-URL und Auth-Header setzt. Die TrueFoundry-Anleitung zeigt, wie ANTHROPIC_BASE_URL auf das Gateway verweist und ein Bearer-Token in benutzerdefinierten Headern verwendet wird, sodass der Claude Code-Datenverkehr über das Gateway gesteuert wird. Mehr lesen: Claude code
Einige Tools benötigen auch das zuvor erwähnte Standard-Namensmapping. Die Codex CLI-Anleitung erklärt, dass Codex Standard-Modellnamen erwartet und sich bei vollständig qualifizierten Namen fehlerhaft verhalten kann. Sie empfiehlt die Verwendung von Gateway-Routing, sodass Sie gpt 5 in der CLI aufrufen, während das Gateway hinter den Kulissen zum korrekten, vollständig qualifizierten Modell routet. Mehr lesen: Codex
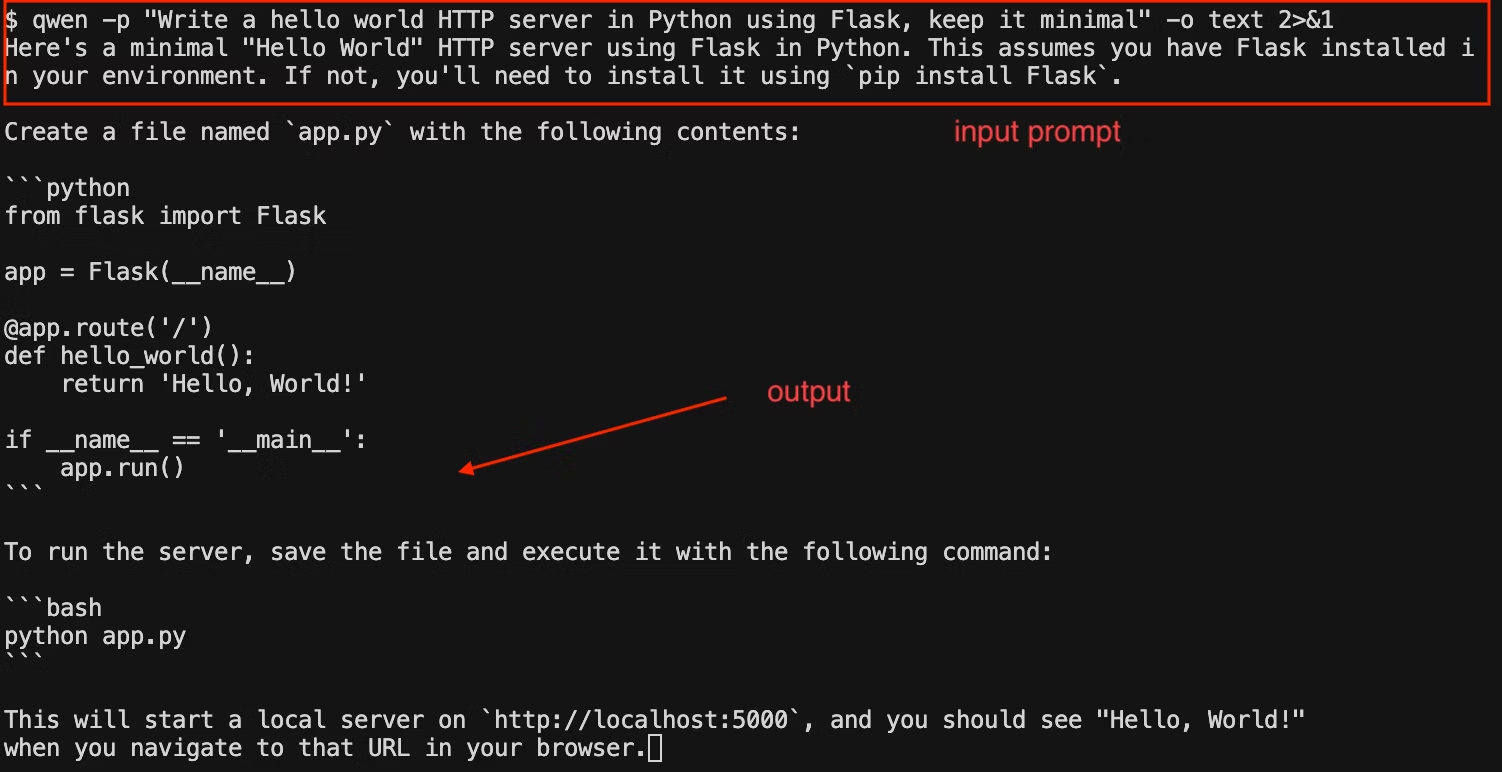
Modellgenehmigung und Zugriffskontrolle sind das grundlegendste Governance-Bedürfnis, wenn sich AI-Coding-Tools in einem Unternehmen verbreiten. Ein Entwickler kann Cursor oder Cline in Minuten installieren und auf einen beliebigen Modellanbieter ausrichten. Ohne ein Gateway endet das Unternehmen mit vielen unverwalteten Pfaden, auf denen Code-Kontext und Prompts das Netzwerk über persönliche Schlüssel verlassen können. Mit dem TrueFoundry AI Gateway erstellen Sie einen kleinen genehmigten Katalog von Modellen, die für die Nutzung beim Codieren zulässig sind, und ordnen diese Modelle Teams oder Benutzergruppen zu. Entwickler nutzen weiterhin dieselbe IDE, die sie bevorzugen, aber jede Anfrage läuft über das Gateway, sodass eine Anfrage an ein nicht genehmigtes Modell blockiert wird. Dies ermöglicht es auch, den Zugriff nach Risikostufe zu trennen. Ein Junior Engineer erhält möglicherweise Zugriff auf ein günstigeres Modell für schnelle Anpassungen, während ein Staff Engineer oder ein Team für Produktionsvorfälle auf ein leistungsfähigeres Modell für einfaches Debuggen komplexer Probleme zugreifen kann. Der wichtige Punkt ist, dass die Genehmigung zentral durchgesetzt wird, anstatt sich darauf zu verlassen, dass jeder Entwickler ein Richtliniendokument befolgt.
Kostenzuordnung wird wichtig, da AI-Coding-Tools große Mengen an Tokens generieren können, ohne dass es jemand bemerkt. Ein einzelner Entwickler, der einen Agenten nutzt, welcher über eine Codebase iteriert, kann in einem kurzen Zeitraum hunderte oder tausende Aufrufe erzeugen. Ohne ein Gateway sind die Ausgaben auf persönliche Schlüssel und Anbieter-Accounts verteilt, sodass die Finanzabteilung eine Rechnung sieht, aber nicht erkennen kann, welches Team oder welche Anwendung sie verursacht hat. Mit einem Gateway können Sie identitätsbasierte Tokens ausstellen und verlangen, dass sich jede IDE- oder CLI-Sitzung über eine Benutzer- oder Service-Identität authentifiziert. Das ermöglicht es Ihnen, die Nutzung einer Person, einem Team oder einem internen Tool zuzuordnen. Sobald eine Zuordnung existiert, werden Kontrollen praktisch umsetzbar. Sie können Budgets für ein Team für einen Monat festlegen und Rate Limits definieren, die unbeabsichtigte Endlosschleifen verhindern. Wenn ein Tool anfängt, Anfragen zu spamen, kann das Gateway diese drosseln, anstatt das Budget stillschweigend zu verbrauchen.
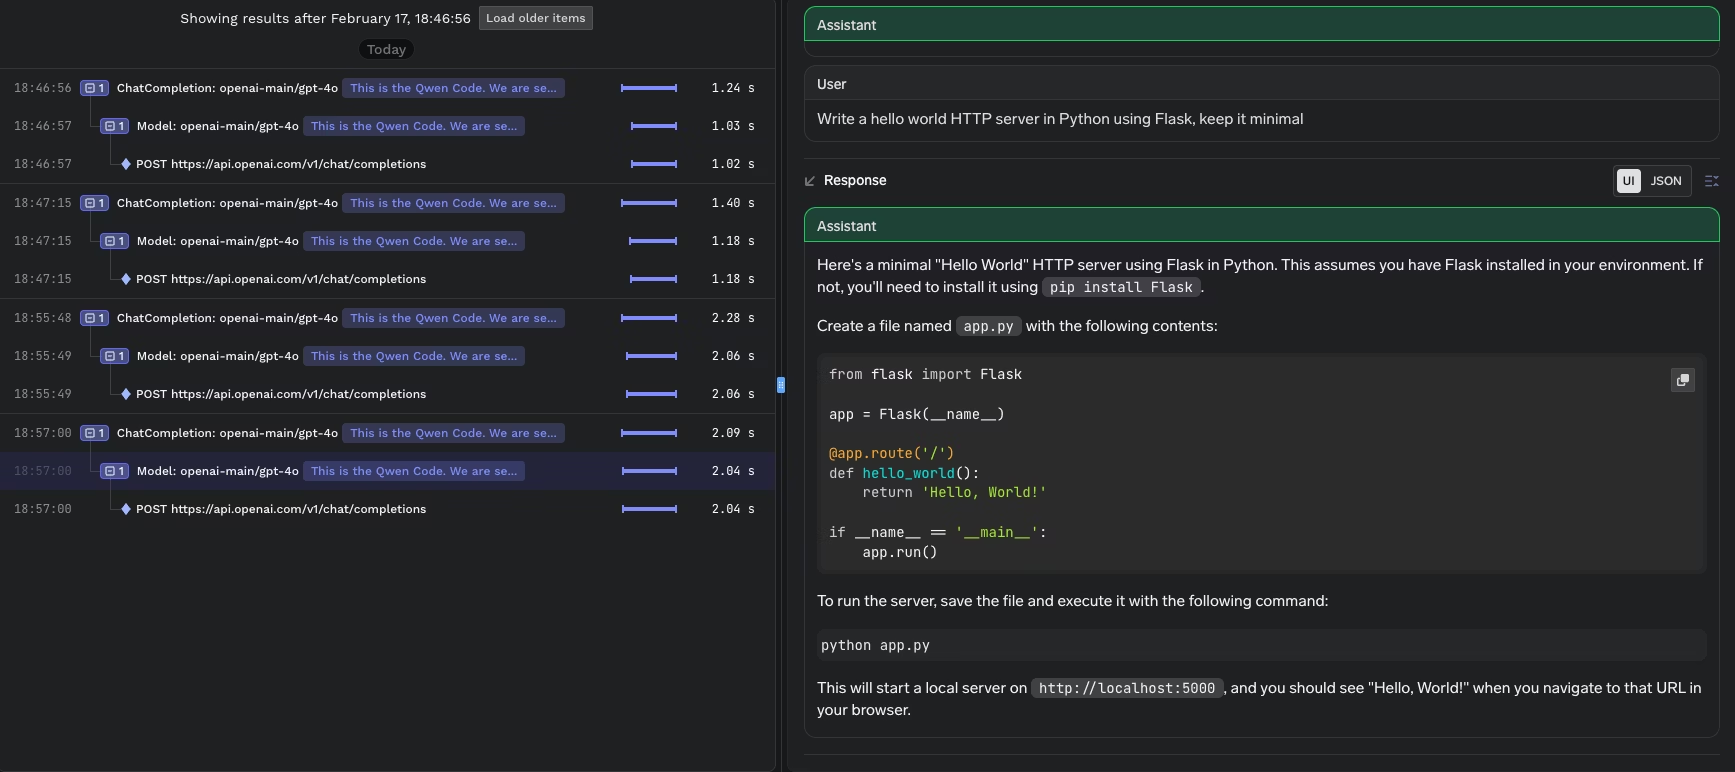
Incident Response und Auditing sind Bereiche, in denen Platform-Teams den Unterschied im Alltag spüren. Wenn ein Entwickler sagt, dass der Assistent langsam ist oder fehlschlägt, ist das schwer zu debuggen, wenn der Datenverkehr direkt vom Laptop zu einem Anbieter fließt. Sie wissen möglicherweise nicht, ob das Problem beim Anbieter, am Netzwerk, an einem falsch konfigurierten Modellnamen oder an einer toolspezifischen Einstellung liegt. Wenn Anfragen über das Gateway laufen, kann das Platform-Team Gateway-Metriken und -Logs einsehen, um zu erkennen, welches Modell aufgerufen wurde, wie die Latenz aussah, welche Fehler aufgetreten sind und ob Ausfälle auf einen Anbieter oder eine Region beschränkt sind. Dies ist auch die Grundlage für Audit-Anforderungen. Security- und Compliance-Teams fragen oft, wohin Code-Kontext gesendet wurde und wer Zugriff hatte. Ein Gateway kann aufzeichnen, welche Ziele verwendet wurden und wer sie aufgerufen hat. Es kann auch Richtlinien unterstützen, die Risiken reduzieren, wie das Maskieren sensibler Zeichenketten, bevor Anfragen externe Anbieter erreichen, oder das Verhindern, dass bestimmte Teams überhaupt Prompts an externe Endpunkte senden.
Zuverlässigkeit bei Anbieterausfällen ist wichtig, da Modellanbieter von Zeit zu Zeit Verlangsamungen und Timeouts haben. AI-Coding-Tools sind besonders empfindlich, da sie interaktiv sind. Ein paar Timeouts können dazu führen, dass sich das Tool defekt anfühlt, und Entwickler wechseln zu dem, was funktioniert. Viele IDEs gehen zudem von bestimmten Modellnamen aus. Cursor und ähnliche Tools funktionieren oft am besten, wenn der Modellname wie ein standardmäßiger OpenAI-Name aussieht. Wenn Sie den Anbieter wechseln, müssten Sie normalerweise jede Entwicklerkonfiguration ändern. Mit Gateway-Routing können Sie denselben Modellnamen in den IDE-Einstellungen beibehalten und ändern, worauf er hinter den Kulissen abgebildet wird. Wenn bei einem Anbieter Timeouts auftreten, können Sie zu einem anderen Anbieter oder zu einem anderen Account oder einer anderen Region routen. Der Entwickler nutzt weiterhin dieselbe IDE-Konfiguration und sieht einfach, dass das Tool weiter funktioniert. Dies ist auch nützlich, wenn Sie ein neues Modell einführen möchten. Sie können den Datenverkehr schrittweise auf das neue Modell verlagern, während die Benutzererfahrung stabil bleibt, und schnell ein Rollback durchführen, wenn Qualität oder Latenz nicht akzeptabel sind.
AI-Coding-IDEs machen Entwickler schneller. Unternehmen benötigen das gleiche Maß an Governance, das sie bereits auf Quellcodeverwaltung und CI-Systeme anwenden. Der praktische Weg besteht darin, die Kontrolle zu zentralisieren, ohne Entwickler zu zwingen, ihre Tools zu wechseln. Das TrueFoundry AI Gateway ist genau dafür gebaut, an diesem Kontrollpunkt zu sitzen. Die Integrationsanleitungen für Claude Code, Cline, Cursor, Gemini CLI, OpenAI Codex CLI, Qwen Code CLI, Roo Code und Goose folgen alle demselben Prinzip: Behalten Sie den Entwickler-Workflow bei. Zentralisieren Sie Richtlinien, Transparenz und Kontrolle am Gateway.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















