November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Zuerst zur Abgrenzung, da der Suchbegriff weiter gefasst ist als das Produkt. Ein Firebase MCP server könnte jedem Firebase-Dienst vorgeschaltet sein. Der von TrueFoundry dokumentierte deckt Crashlytics ab. Wenn Ihr Agent Firestore-Dokumente oder Remote Config-Werte benötigt, reicht dieser nicht aus.
Model Context Protocol ist der offene Standard, der es einem Agenten ermöglicht, Tools auf einem externen System zu entdecken und aufzurufen. Ein Crashlytics MCP Server verwandelt Ihren Crash-Datensatz in aufrufbare Tools. Laut Dokumentation können Agents Crash-Probleme, Stack Traces, Crash-Events und Berichte untersuchen.
Die Dokumentation beschreibt die Funktionen eher nach IAM-Rolle als durch Benennung von Tool-Funktionen. Betrachten Sie die Schnittstelle daher nach Rolle:
Diese dritte Zeile beinhaltet die gesamte Sicherheitsentscheidung. Die Dokumentation sagt es explizit: Verwenden Sie Viewer-Rollen, es sei denn, Agents müssen den Problem-Status ändern. Für Triage und Berichterstattung wird die User-Rolle niemals benötigt. Sie trotzdem zu vergeben, führt dazu, dass ein Agent ein aktives P0-Problem schließt, nur weil ein Prompt ihm gesagt hat, er solle aufräumen.
Er läuft als Remote- oder gehosteter Server, sodass kein lokaler Prozess überwacht werden muss – dieselbe Form wie bei anderen remote MCP servers, mit einem Unterschied: Die Anmeldeinformation ist ein Service Account Key und keine OAuth-Gewährung pro Benutzer.
Die interessanten Workflows verketten mehrere Lesezugriffe und enden in einem geschriebenen Artefakt.
Die Aufteilung sieht hier ungewöhnlich aus: Mit Viewer-Rollen ist fast alles ein Lesezugriff, was sicher klingt. Aber Nur-Lese-Zugriff ist nicht harmlos. Ein einzelnes Crash-Event kann eine Gerätekennung, einen App-Status-Snapshot, eine Benutzer-ID und benutzerdefinierte Log-Breadcrumbs enthalten, die Ihre Entwickler hinzugefügt haben – und genau in den Breadcrumbs gelangen personenbezogene Daten nach außen, da wer auch immer sie geschrieben hat, nach Fehlern suchte und keine Datenrichtlinie verfasste. Das Einlesen von hundert Crash-Events in den Kontext eines Modells ist eine Datenübertragungsentscheidung, nicht nur eine Abfrage.
Wenn ein einzelner Entwickler dies gegen ein Dev-Projekt ausführt, ist das in Ordnung. Die Einbindung in einen gemeinsamen Agenten für ein Mobile-Team ist es nicht.
Der Service Account Key ist ein geteiltes Passwort. Laut Dokumentation sollte er genau so behandelt werden. Es ist eine langlebige, sich nicht automatisch rotierende Datei, die jedem, der sie besitzt, die zugewiesenen Rollen gewährt. Sie läuft nicht ab und gibt keinen Aufschluss darüber, wer sie verwendet hat.
Geteilte Anmeldeinformationen heben die Identität auf. Mit einem einzigen Service Account anstelle von OAuth pro Benutzer erhält jeder Aufrufer identischen Zugriff, und das Upstream-Audit-Log sieht nur einen Principal. Es kann Ihnen nicht sagen, ob der Release-Agent diesen Aufruf für einen bestimmten Entwickler getätigt hat. Diese Zuordnung stammt vom Gateway oder überhaupt nicht.
Zu weit gefasste Rollen sind der Standardweg. Das Hinzufügen von firebasecrashlytics.user „für alle Fälle“ erfordert nur einen Klick und vergrößert dauerhaft den Schadensradius.
Crash-Payloads sind ein Datenausschleusungspfad. Da nichts geschrieben wird, fühlt es sich nach geringem Risiko an – das ist die Falle. Jede Tool-Antwort fließt in einen Modellkontext, dann in Logs, Traces und was auch immer der Agent als Nächstes schreibt. Wenn Breadcrumbs E-Mail-Adressen oder Benutzerkennungen enthalten, überträgt eine unbereinigte Pipeline diese Daten an einen Ort, den niemand überprüft hat. Die Kontrolle, die Sie benötigen, ist die Redaktierung beim Ausgang.
Nichts davon spricht gegen die Anbindung von Crashlytics. Es spricht für eine Control Plane davor, genau das, was ein MCP gateway ist.
Crashlytics ist nicht im TrueFoundry Managed MCP-Katalog enthalten. Es gibt keine Schaltfläche zum Anklicken und keine plattformverwalteten Anmeldeinformationen. Laut Dokumentation stellen Sie ihn selbst bereit und registrieren ihn.
Schritt 1 — Erstellen Sie den Service Account. Wählen Sie in der Google Cloud Console das Projekt aus, das Ihrem Firebase-Projekt zugrunde liegt, und erstellen Sie einen Service Account namens crashlytics-mcp. Gewähren Sie roles/firebase.viewer und roles/firebasecrashlytics.viewer, und fügen Sie roles/firebasecrashlytics.user nur hinzu, wenn Ihre Tools den Problem-Status aktualisieren müssen. Erstellen Sie einen JSON Key und speichern Sie ihn sicher.
Schritt 2 — Stellen Sie den Server bereit. Führen Sie ihn als Remote Service oder gehosteten Stdio-Server aus, wobei der Service Account JSON und die Firebase Project ID als Umgebungsvariablen oder geheimnisbasierte Konfiguration bereitgestellt werden.
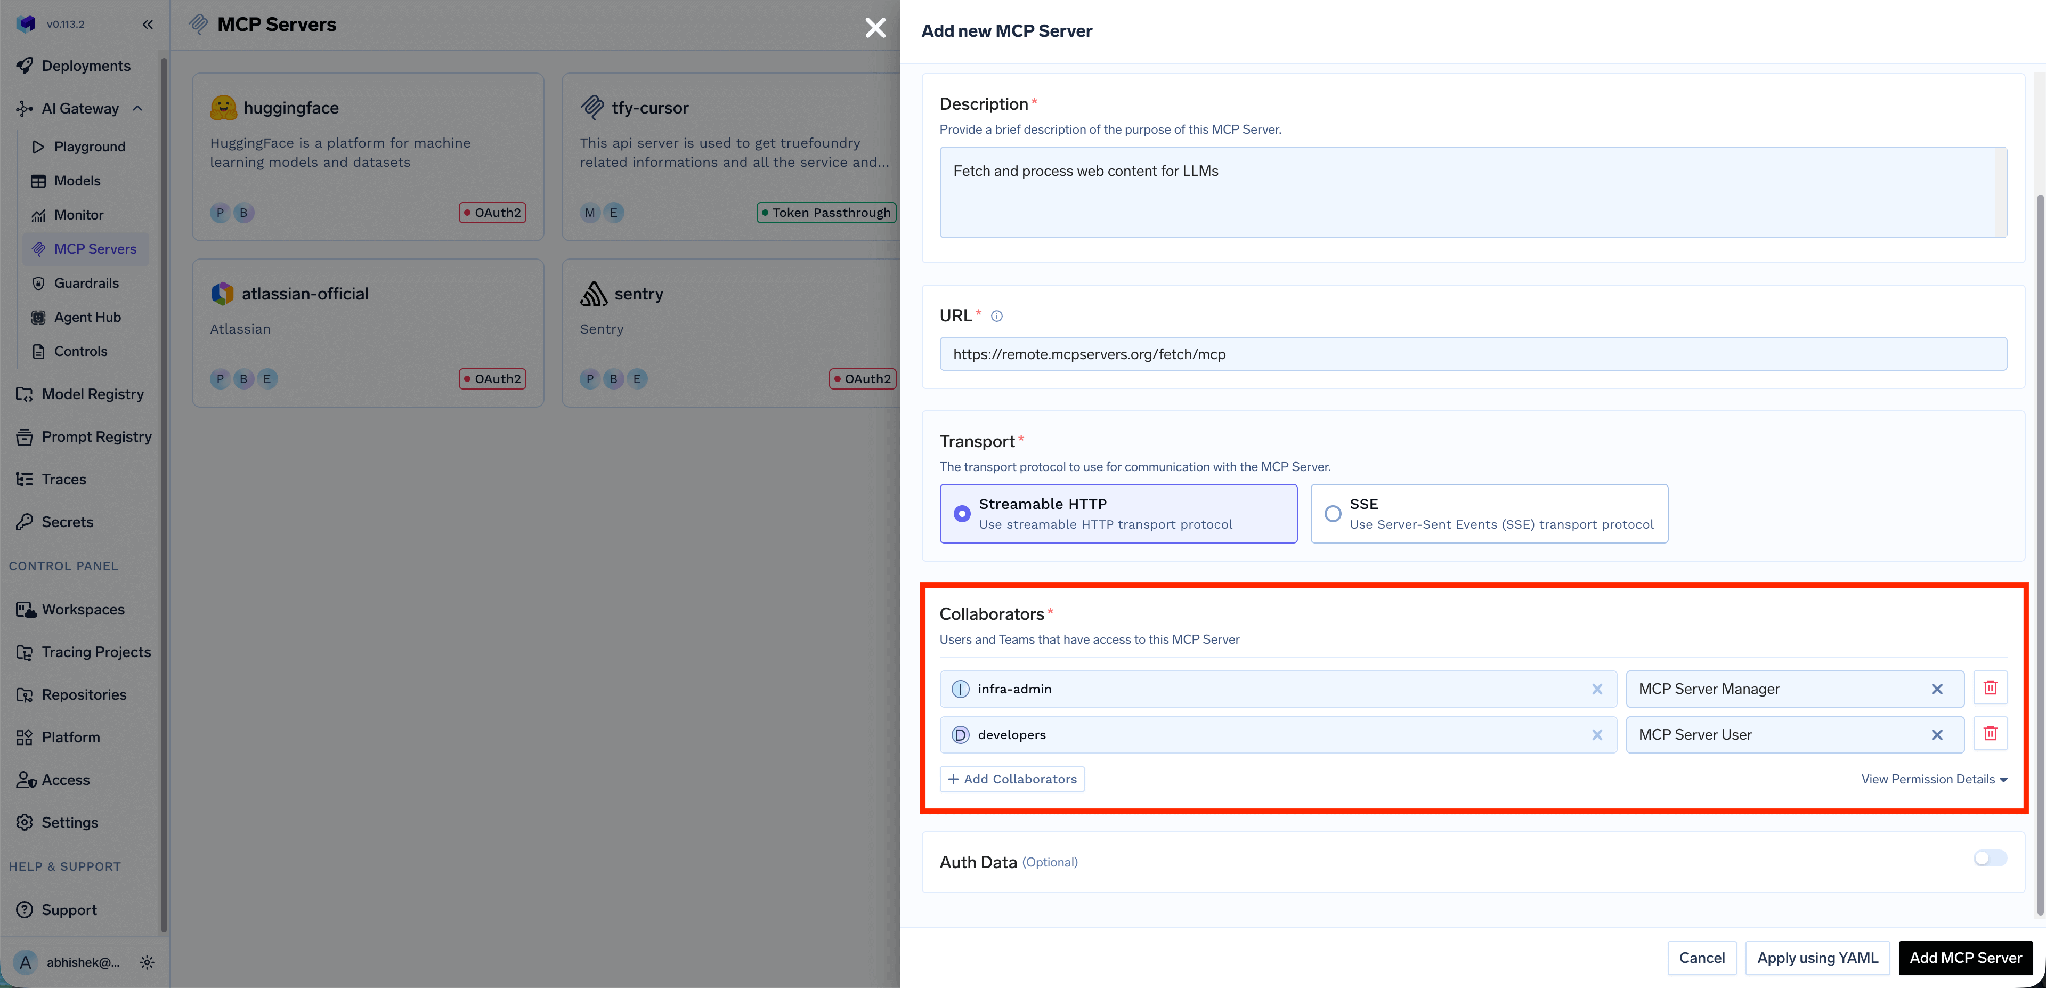
Schritt 3 — Registrieren Sie ihn. Gehen Sie zu MCP Gateway und klicken Sie auf Add Server. Da dies Ihre eigene Bereitstellung ist, wählen Sie Connect any Remote MCP Server oder Create a Hosted STDIO-based MCP Server.
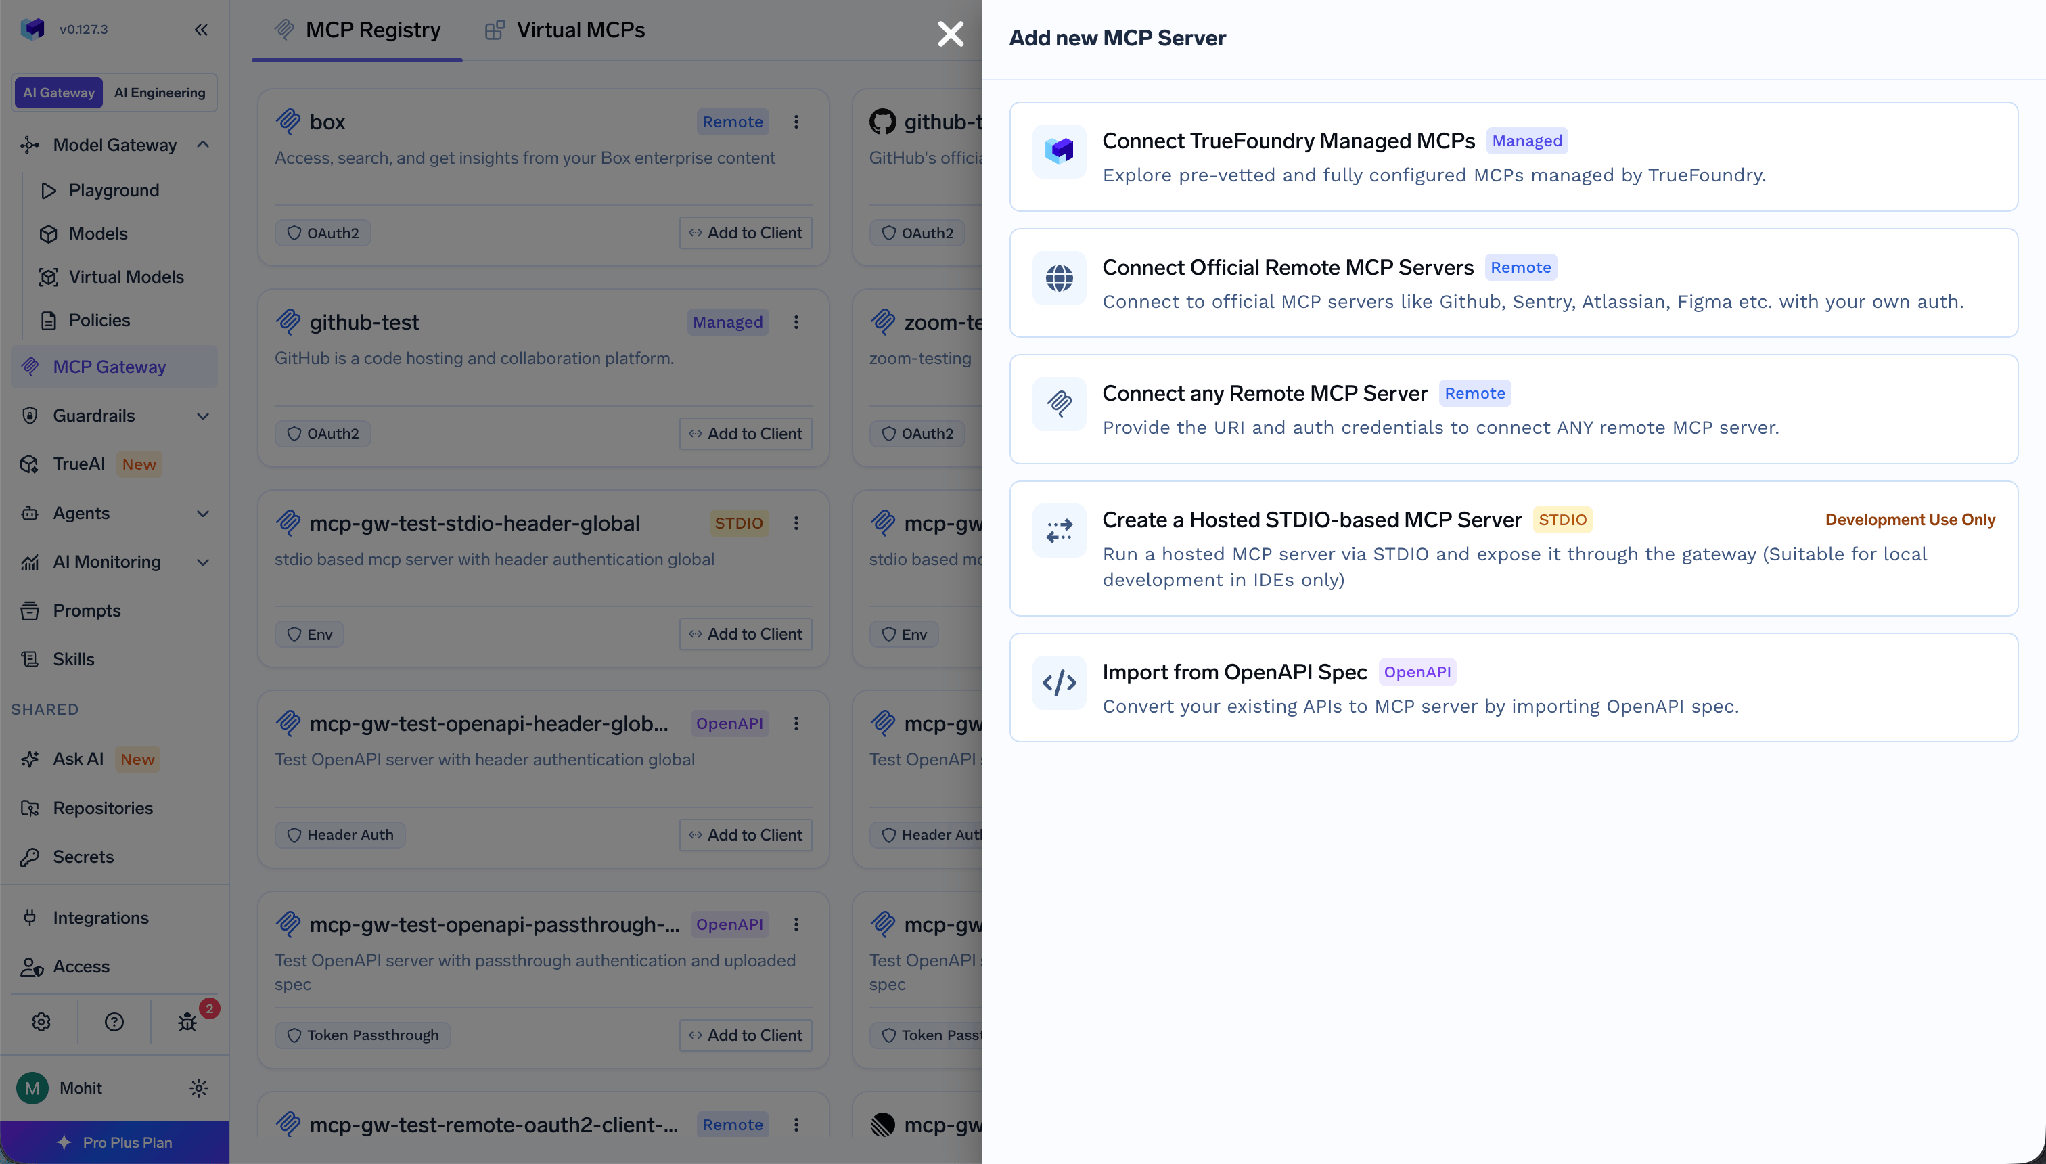
Der Remote-Pfad fragt nach einem Name, einem optionalen Display Name, einer Description, der Server-URL, Collaborators und Auth Data.
Schritt 4 — Collaborators hinzufügen und überprüfen. Fügen Sie die Benutzer und Teams hinzu, die den Server erreichen können sollen, bestätigen Sie, dass die Tools unter Tools angezeigt werden, und testen Sie eines im Playground.
TrueFoundry trennt die Inbound-Authentifizierung (wie sich ein Client gegenüber dem Gateway ausweist) von der Outbound-Authentifizierung (wie sich das Gateway gegenüber Ihrem Server ausweist).
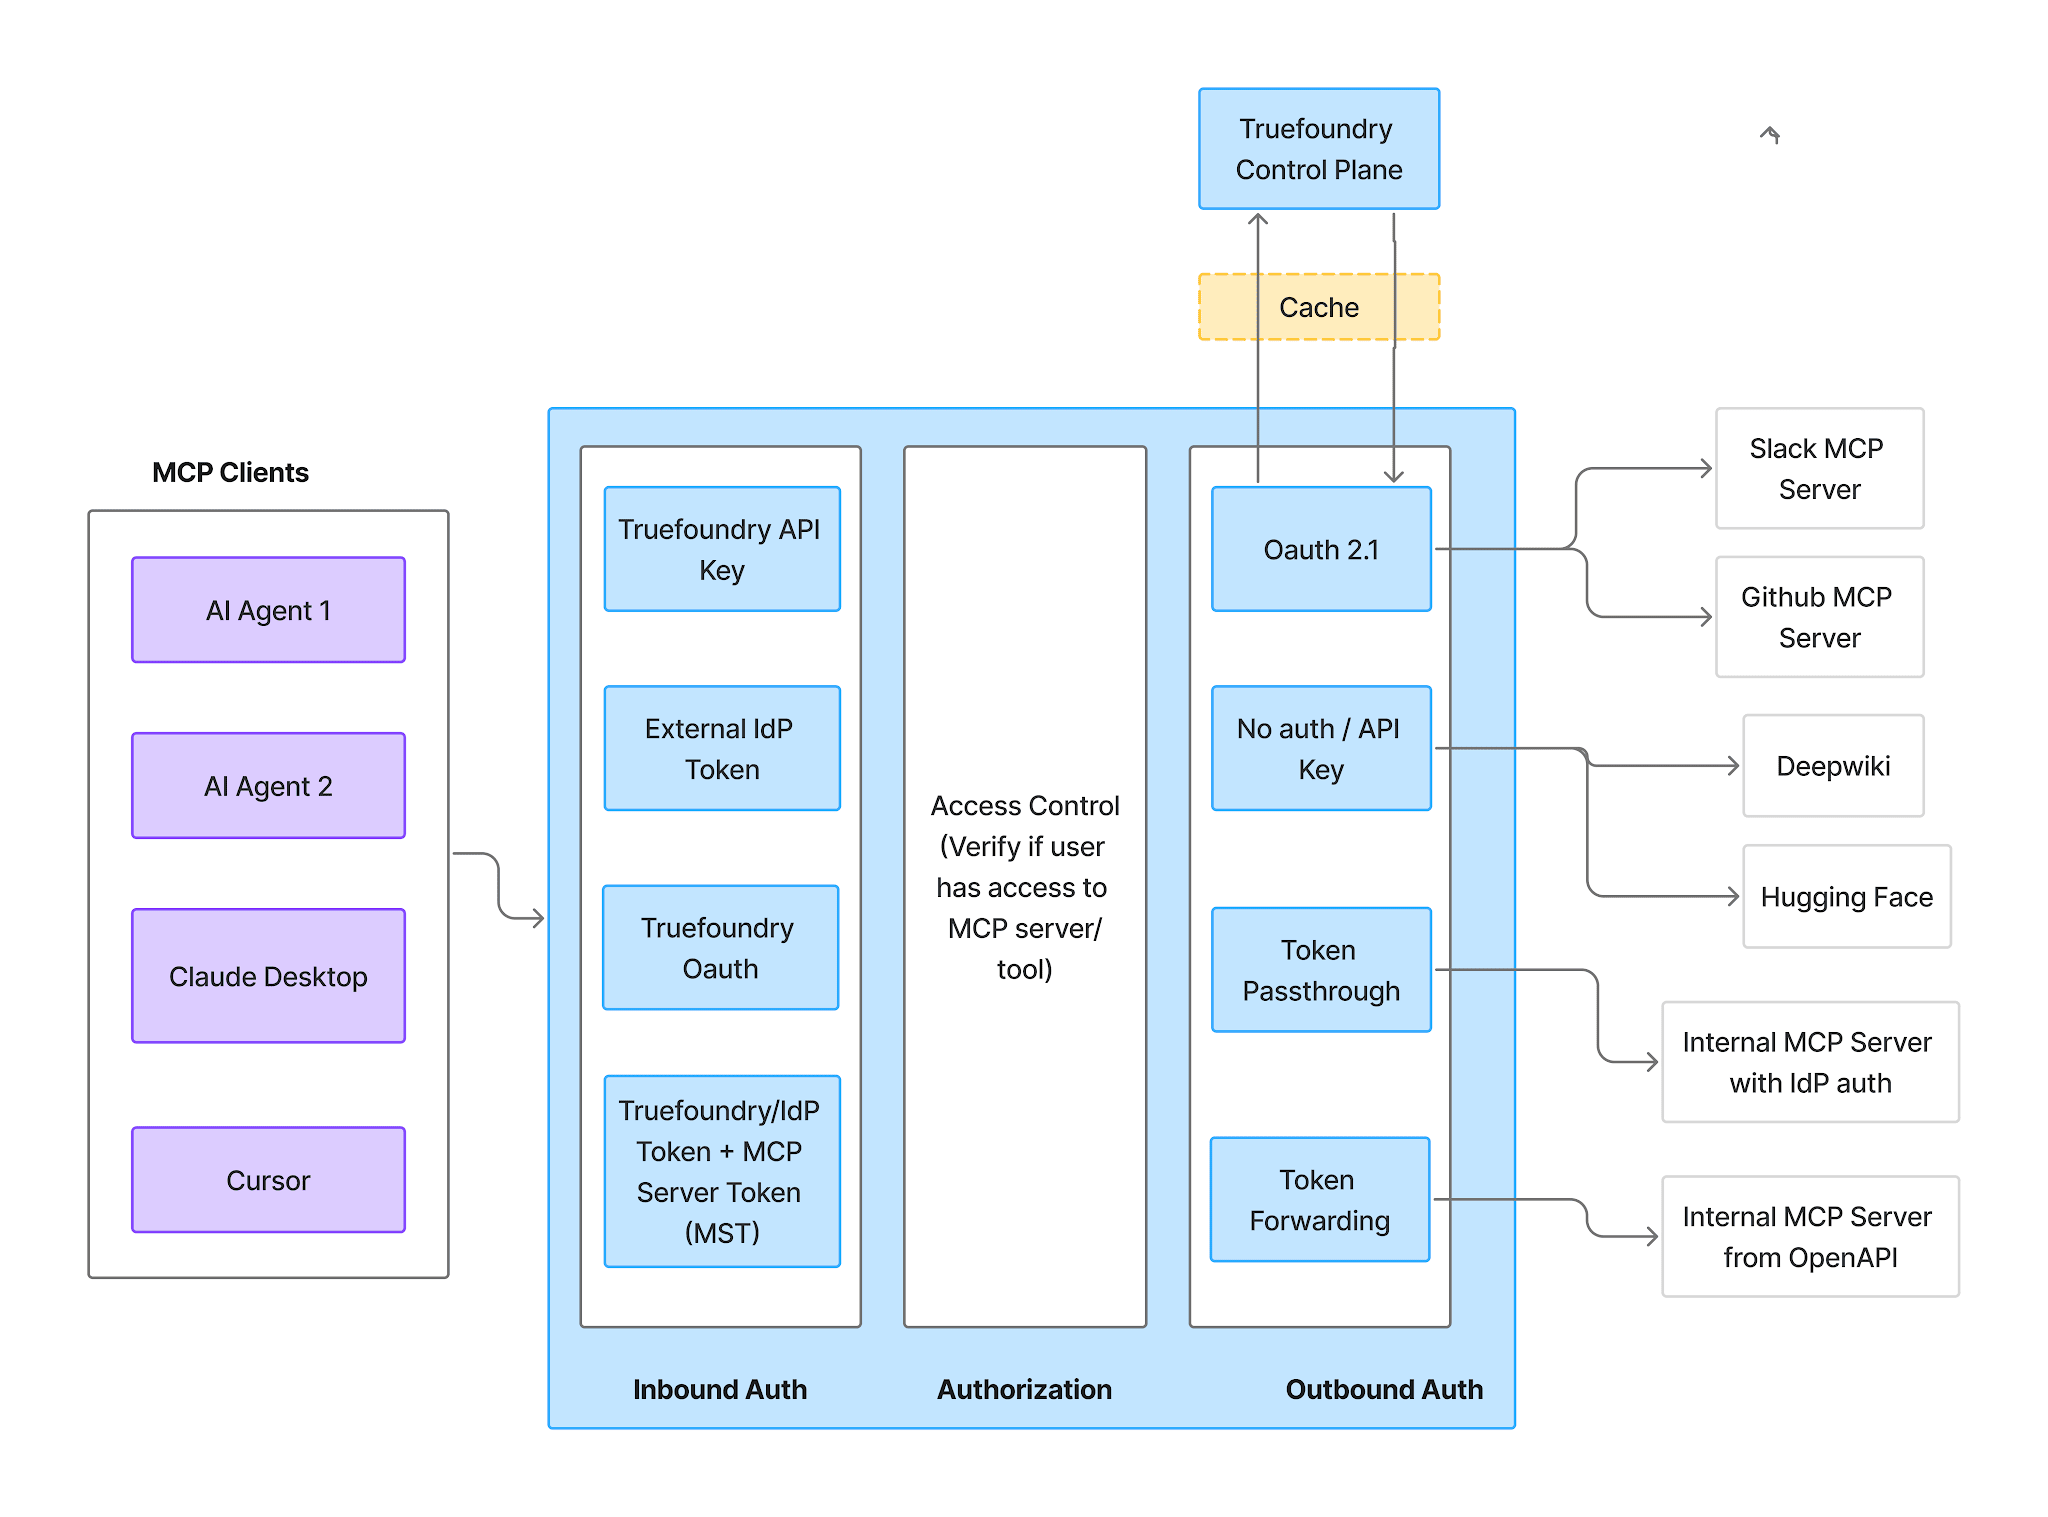
Inbound — vier unterstützte Methoden:
Outbound — hier unterscheidet sich Crashlytics von OAuth-basierten Servern. Die Dokumentation beschreibt Service-Account-Anmeldeinformationen, keinen Consent-Flow. Wählen Sie den Auth-Typ, der dazu passt, wie Ihr Server die Anmeldeinformationen erwartet: TrueFoundry unterstützt API Key, OAuth2, AWS SigV4 und Token Passthrough. API Key bietet zwei Anmeldeinformations-Modi.
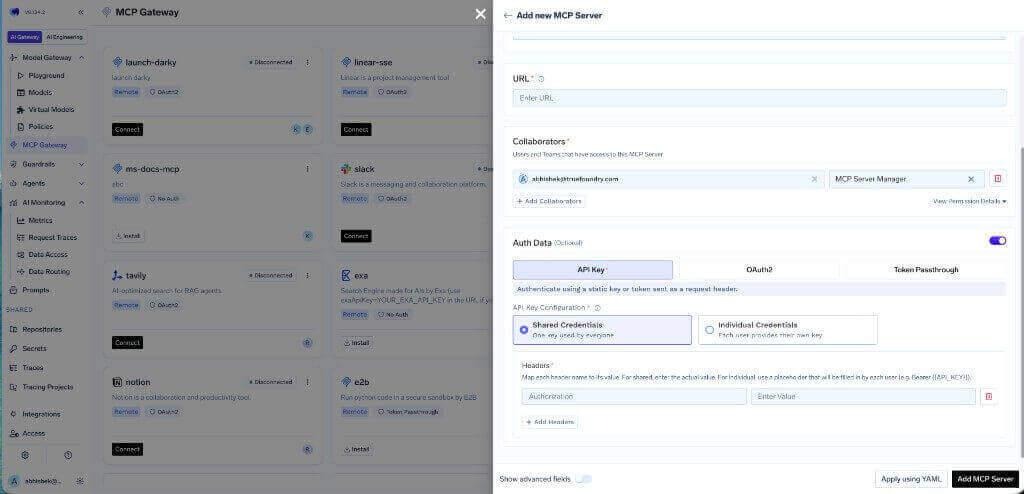
Shared Credentials bedeutet ein Schlüssel für alle – die natürliche Wahl für einen Service Account und der Grund, warum Inbound-Identität wichtig ist. Jeder Aufrufer erreicht Crashlytics als derselbe Google Cloud Principal, sodass das Request-Log des Gateways der einzige Ort ist, an dem eine Zuordnung pro Benutzer existiert. Individual Credentials ermöglicht es jedem Benutzer, seinen eigenen Schlüssel über die Registerkarte Auth Overrides bereitzustellen, was nützlich ist, wenn Sie Service Accounts pro Team ausgeben.
Virtual Account Token geben jedem Request identischen Zugriff, sodass sie keine Trennung pro Benutzer bieten können. Und ohne Consent-Schritt wird der Zugriff vollständig über Ihre Collaborator-Liste und die von Ihnen aktivierten Tools bestimmt.
Wenn Sie Ihrer Bereitstellung stattdessen OAuth2 Authorization Code vorschalten, verwenden selbst registrierte Server einen anderen Callback als verwaltete Server. Setzen Sie die Redirect-URI im Portal Ihres Anbieters auf https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback. Der auth.truefoundry.com Callback gilt nur für TrueFoundry Managed MCPs, was hier nicht zutrifft.
Die Registerkarte Tools listet alles auf, was Ihr Server bereitstellt, und hier entscheiden Sie, was Agents tun können.
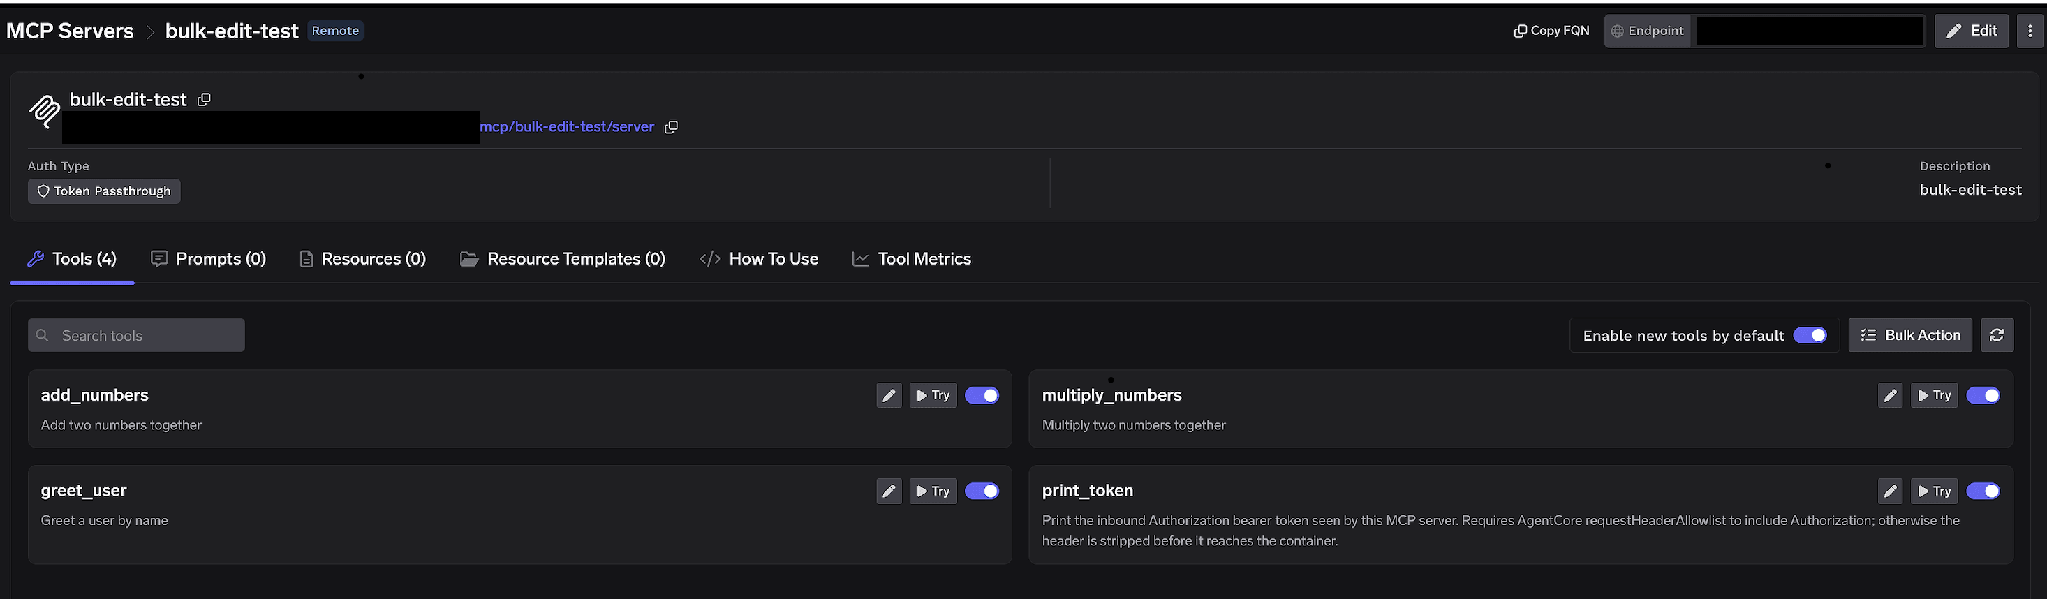
Schalter pro Tool. Schalten Sie ein Tool aus, wird es vollständig aus tools/list entfernt – Clients sehen es nie und es kann nicht aufgerufen werden. Das ist keine Filterung auf Prompt-Ebene. Für Crashlytics ist das Muster eine doppelte Absicherung: Viewer-only-Rollen in Google Cloud und deaktivierte Issue-Mutations-Tools am Gateway, sodass eine fehlkonfigurierte IAM-Bindung einem Agenten nicht stillschweigend Schreibzugriff gewährt.
Enable new tools by default. Bleibt dies aktiviert, werden Tools, die Ihr Server später hinzufügt, automatisch angezeigt. Ist es deaktiviert, sind nur Tools verfügbar, die Sie explizit aktiviert haben – die vernünftige Standardeinstellung für einen Server, an dem Sie iterativ arbeiten.
Bulk Action. Schaltet Zeilen auf Kontrollkästchen mit Select all um, sodass Sie eine Gruppe auf einmal umschalten und speichern können.
Klicken Sie auf den Stift bei einem beliebigen Tool, um anzupassen, wie es dem Modell präsentiert wird:
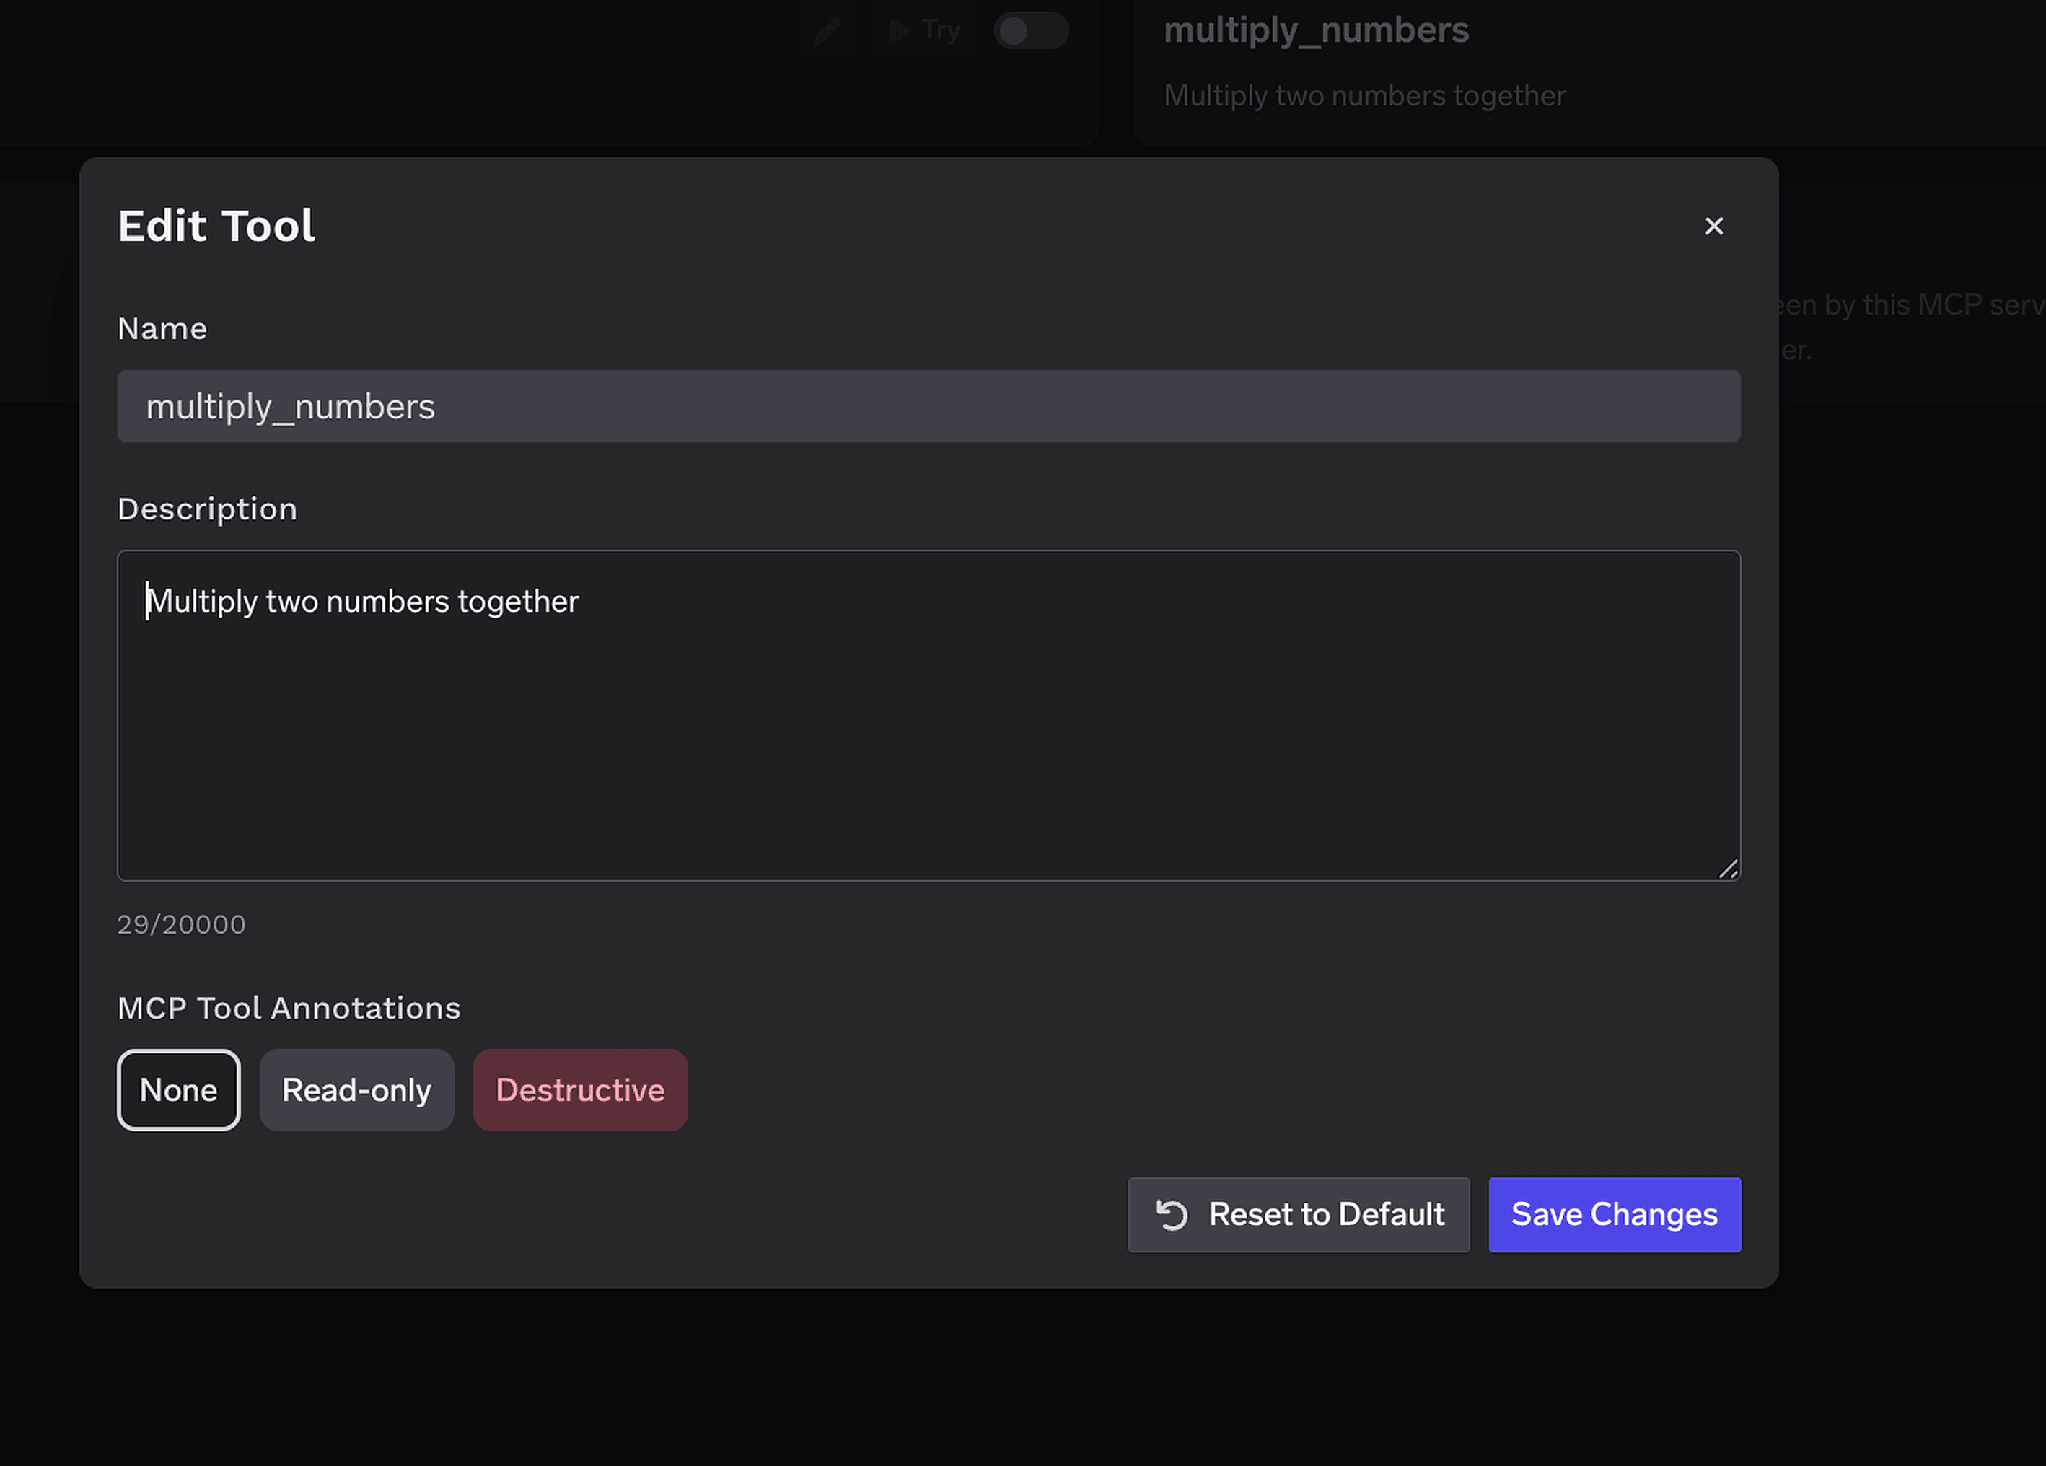
Die Überschreibung der Description (bis zu 20.000 Zeichen) steuert die Tool-Auswahl, wenn die eigene Formulierung Ihres Servers dünn ist, was bei einem selbst gebauten Server oft vorkommt. MCP Tool Annotations markieren ein Tool als Read-only oder Destructive und setzen readOnlyHint oder destructiveHint. Die Kennzeichnung von Problem-Status-Tools als Destructive ist die Voraussetzung dafür, dass die folgenden Genehmigungsrichtlinien funktionieren.
Die Zugriffskontrolle wird Benutzern, Teams oder Virtual Accounts in zwei Dimensionen zugewiesen: welche Server eine Identität erreichen kann und welche Tools sie aufrufen kann.
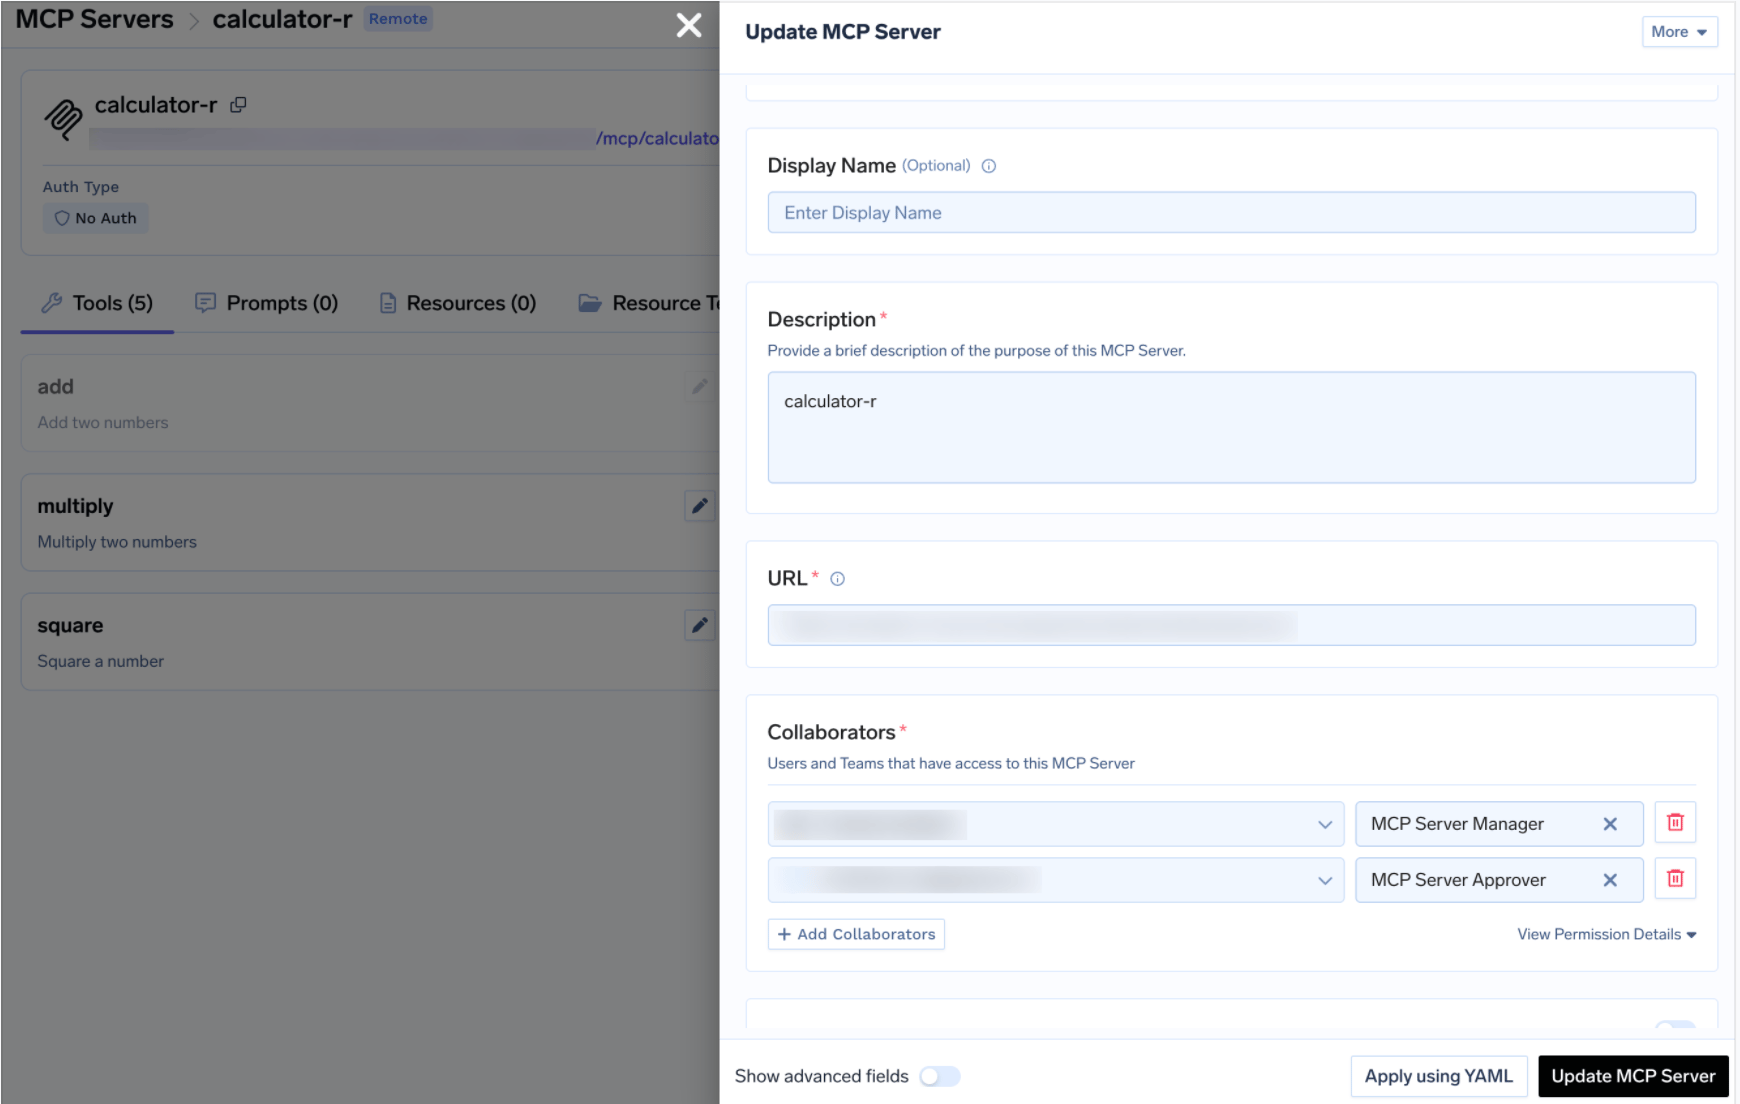
Mit Upstream-Shared-Credentials ist die Collaborator-Liste Ihre tatsächliche Zugriffsgrenze – jeder darauf erreicht Crashlytics mit den vollen Berechtigungen des Service Accounts. Beschränken Sie sie auf Personen, die Crash-Payloads lesen sollten. Dasselbe MCP access control-Modell wie bei jedem anderen Server in Ihrer Registry.
Wenn Sie firebasecrashlytics.user gewährt haben, weil ein Agent gelöste Probleme schließen muss, lassen Sie ihn nicht unbeaufsichtigt. Genehmigungsrichtlinien halten den Aufruf an, anstatt ihn auszuführen, erstellen eine Anforderung und benachrichtigen Genehmiger. Nach der Genehmigung sind passende Aufrufe für ein konfigurierbares Zeitfenster erfolgreich, danach ist eine erneute Genehmigung erforderlich.
Erstellen Sie eine Richtlinie unter AI Gateway → Policies → MCP Tool Approval (in der Konsole als Beta gekennzeichnet):
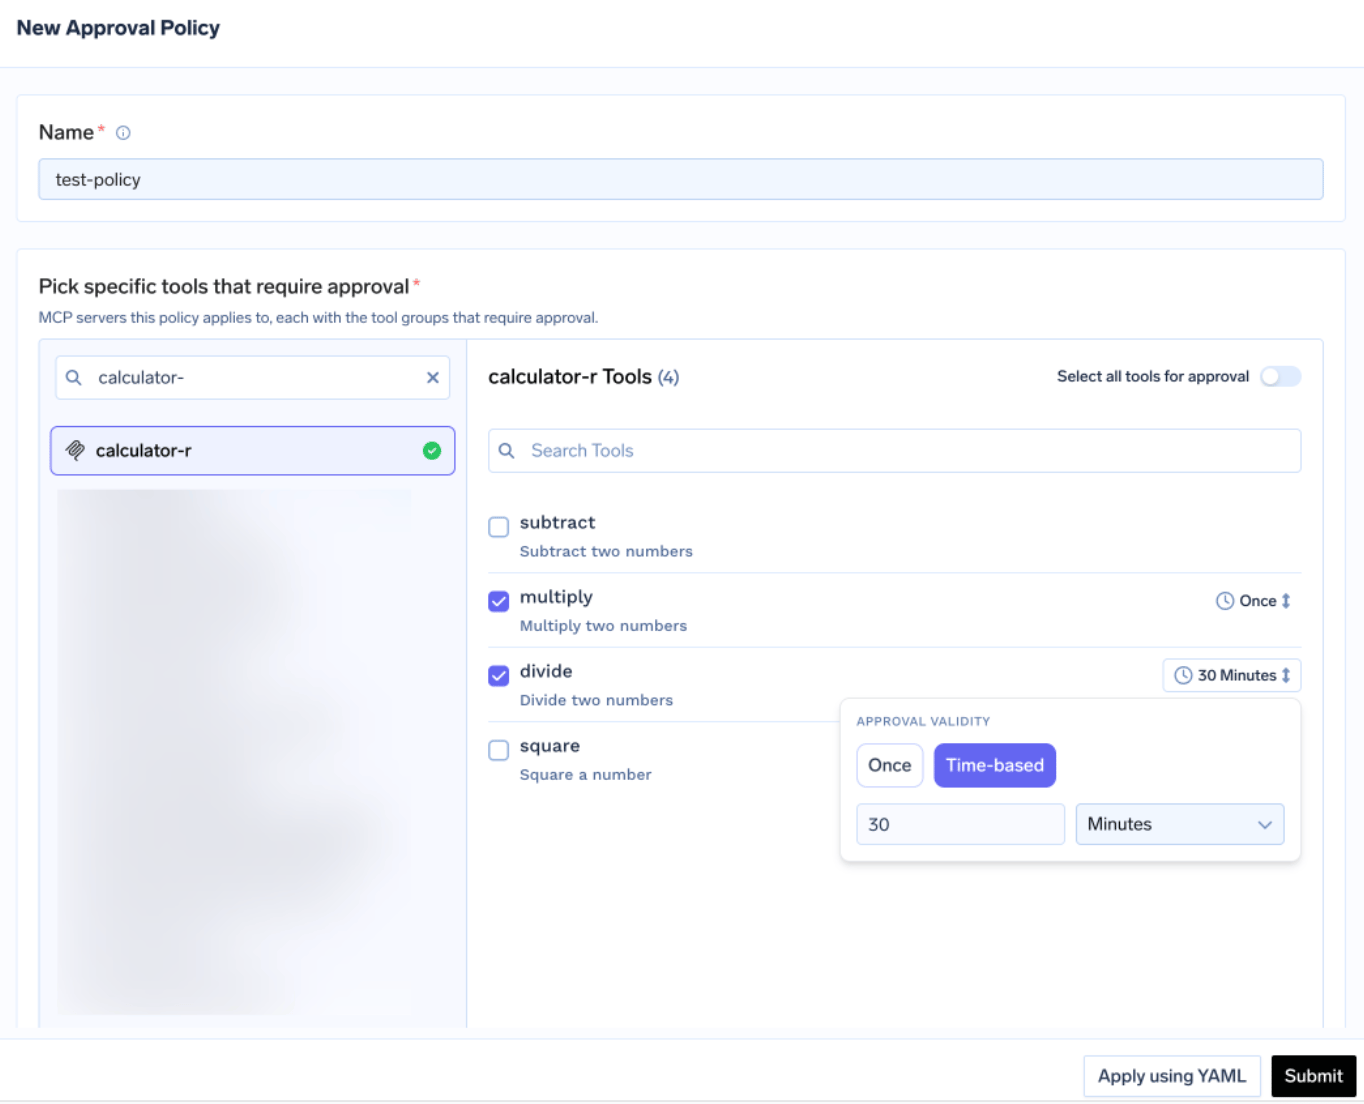
Jede Richtlinie benennt die Server, die sie schützt, und wählt einen Approval Scope:
Wenn sich Scopes überschneiden, gewinnt der spezifischste: named > destructive > all. Die Validity ist Once oder zeitbasiert in Minuten. Bei Richtlinienkonflikten gilt die restriktivste Einstellung – Once schlägt 10 Minuten schlägt 30 Minuten. Genehmiger werden per E-Mail, Slack, PagerDuty oder MS Teams benachrichtigt:
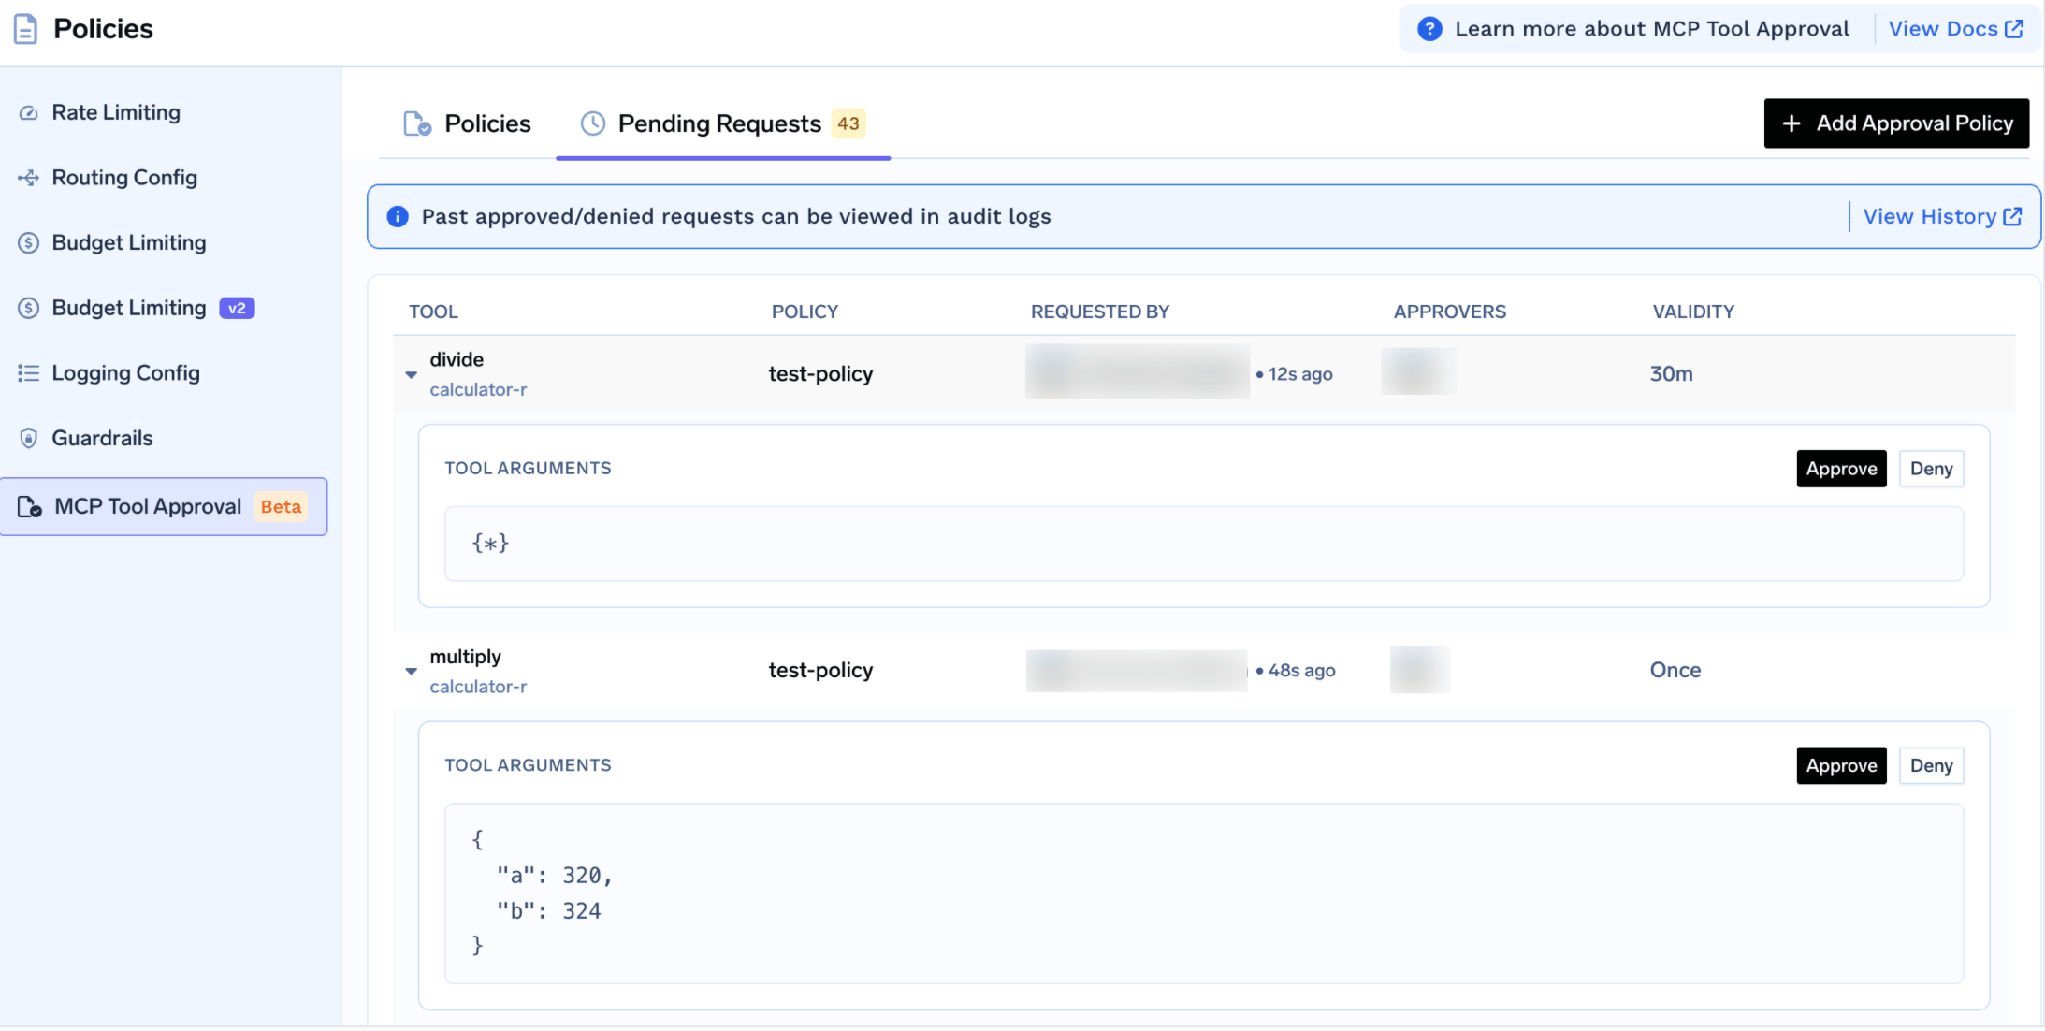
Jede Anforderung zeigt die Tool-Argumente, sodass ein Genehmiger sieht, welches Problem ein Agent ändern möchte. Während der Prüfung erhält der Aufrufer ein JSON-RPC-Ergebnis mit _meta.approval_status: "pending" anstelle eines Fehlers, sodass ein gut konfigurierter Agent es erneut versuchen kann. Freigaben werden pro Anforderer gewährt. Eine Ablehnung blockiert niemanden dauerhaft – um dauerhaft zu blockieren, deaktivieren Sie das Tool oder entfernen Sie den Benutzer.
Testen Sie zuerst manuell. Klicken Sie auf der Server-Detailseite auf Try neben einem beliebigen Tool, füllen Sie die Parameter aus, führen Sie es aus und lesen Sie das JSON. Try ist für von Ihnen deaktivierte Tools ausgeblendet.
Hier finden Sie heraus, ob dem Service Account eine Rolle fehlt oder die Project ID nie gesetzt wurde – und es ist der Moment, eine rohe Crash-Event-Antwort zu lesen und zu sehen, was sich in den Breadcrumbs befindet, bevor Sie entscheiden, wie viel Redaktierung Sie benötigen.
Öffnen Sie die Registerkarte How To Use für Ihre mandantenspezifische Gateway-URL und direkt verwendbare Code-Snippets.
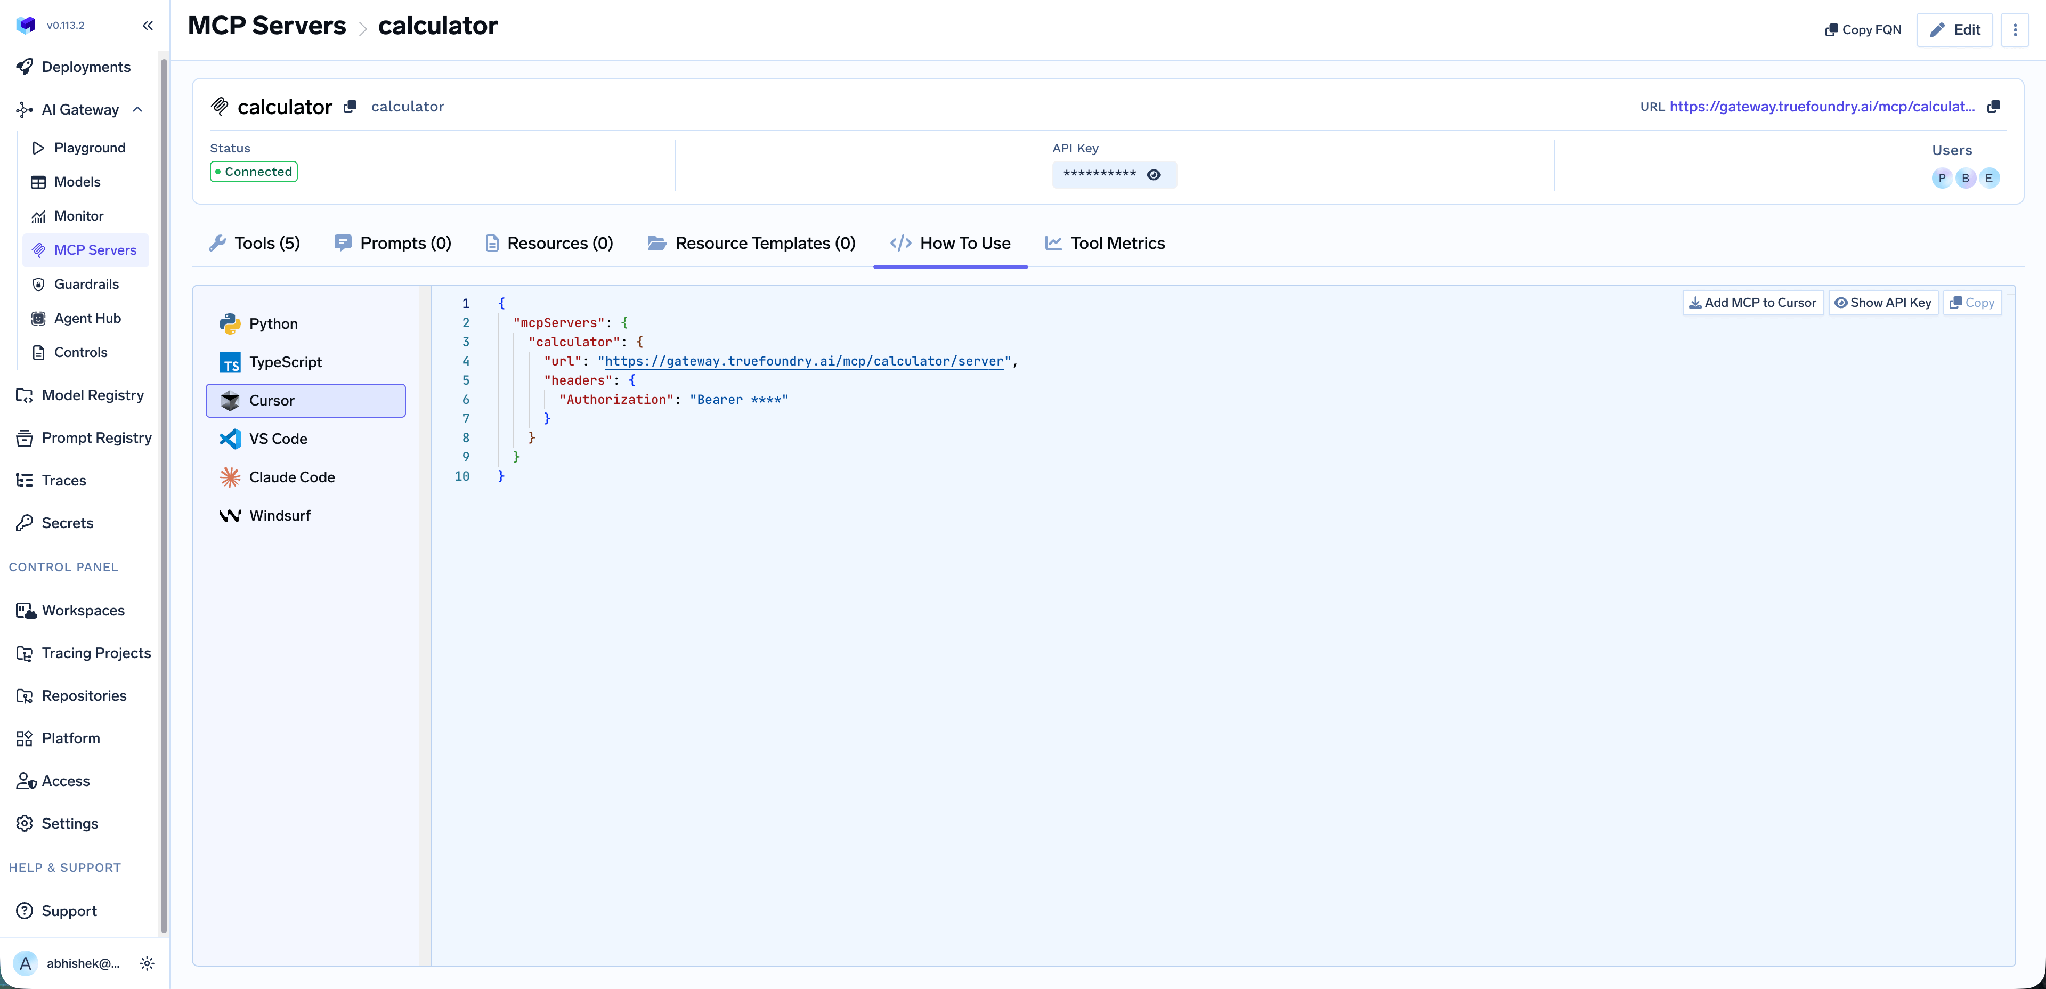
Sie deckt Claude Code, VS Code, Cursor, Windsurf, Codex sowie die Python- und TypeScript-MCP-SDKs ab. Nehmen Sie die URL aus dieser Registerkarte, anstatt sie manuell zusammenzustellen – ein manuell erstellter Endpunkt ist die häufigste Ursache für einen Client, der sich verbindet, aber keine Tools auflistet.
PII-Redaktierung bei der Tool-Ausgabe. Die Kontrolle, die hier am meisten zählt. TrueFoundrys integrierte PII/PHI Detection Guardrail gilt für vier Hooks: LLM Input, LLM Output, MCP Pre Tool und MCP Post Tool. Post Tool ist der Hook, den Sie benötigen – er bereinigt erkannte Entitäten aus der Tool-Ausgabe, bevor sie das Modell erreichen.
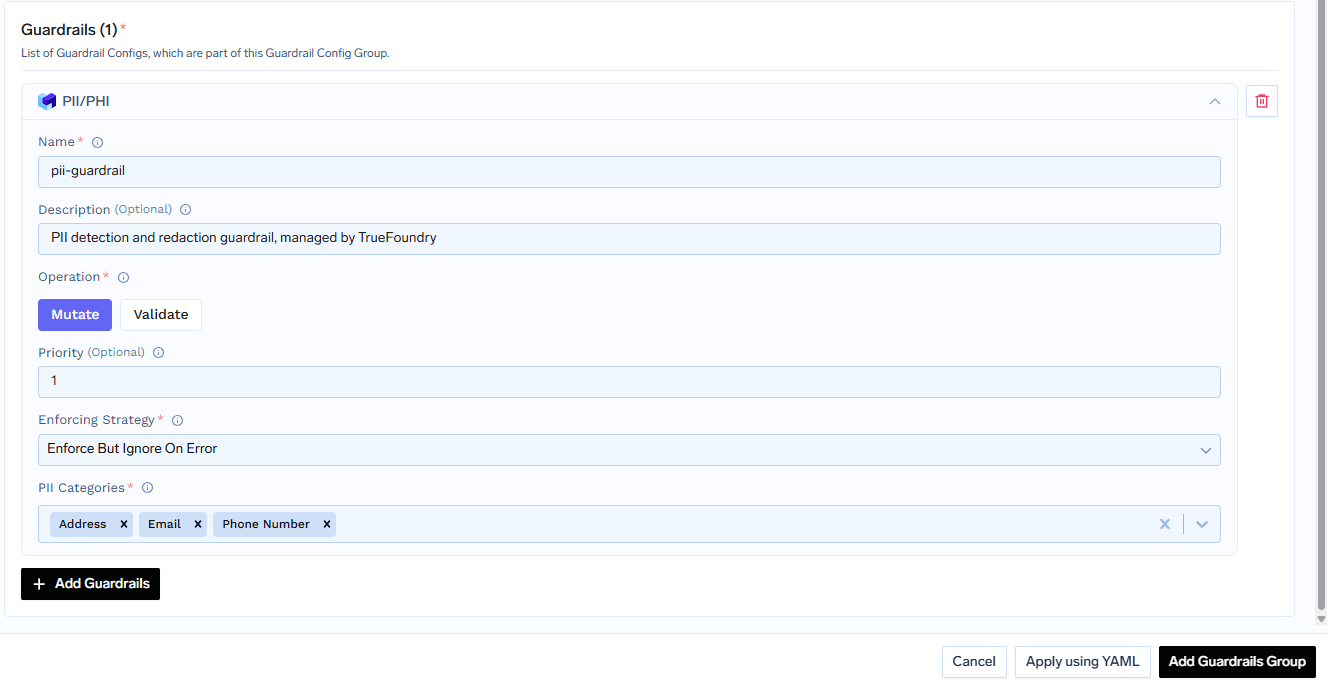
Sie wird von Azure AI Language PII Detection angetrieben, läuft auf von TrueFoundry verwalteter Infrastruktur ohne Schlüssel von Drittanbietern und arbeitet nur im Mutate-Modus – erkannte Entitäten werden durch Sternchen ersetzt und die Anfrage wird fortgesetzt. Wählen Sie die Entitätskategorien aus oder wählen Sie alle, und entscheiden Sie sich für enforce oder enforce_but_ignore_on_error. Konfigurieren Sie dies unter Guardrails.
Für einen Crash-Triage-Agenten verwandelt dies einen ungeprüften Datenpfad in einen geprüften: Der Agent erhält weiterhin den benötigten Stack Trace und die Geräteverteilung, während Kennungen, die in die Breadcrumbs gelangt sind, bei der Übertragung maskiert werden.
Metriken auf Tool-Ebene. Das MCP Metrics Dashboard schlüsselt Anfragen pro Sekunde, Latenz von P50 bis P99, Fehlerrate nach Fehlertyp und Anzahl der Anfragen pro Tool auf.
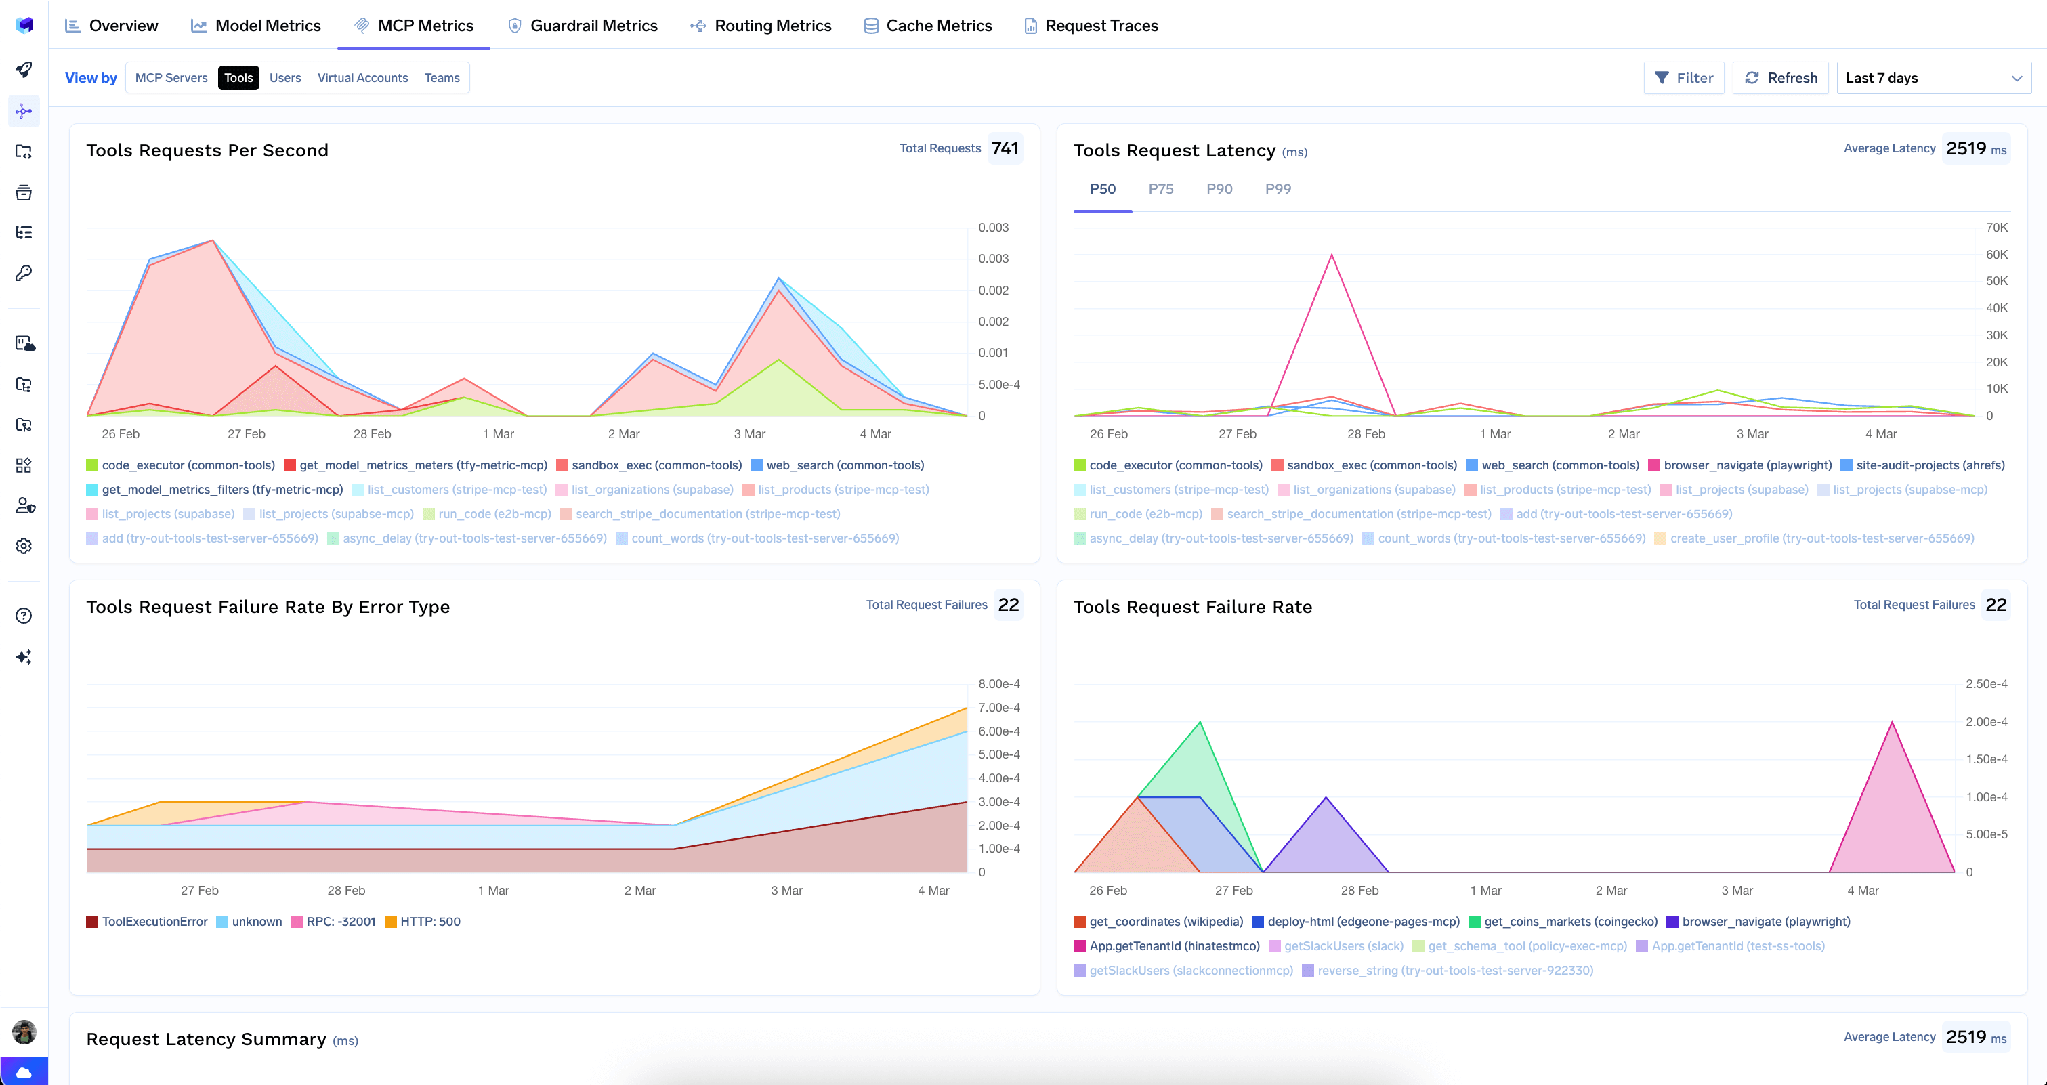
So erfahren Sie, ob ein Triage-Agent pro Durchlauf zweitausend Crash-Events abruft, obwohl fünfzig ausreichen würden.
Observability für die gesamte Anfrage. Jeder Aufruf wird mit Aufruferidentität, Tool-Namen, Eingaben und Latenz zurückverfolgt und über OpenTelemetry nach Grafana, Datadog oder Prometheus exportiert. Bei einem geteilten Upstream-Service-Account sind diese Traces der Ort, an dem die Zuordnung pro Benutzer stattfindet.
Geringer Overhead. Das Gateway fügt etwa 3–4 ms Latenz hinzu und verarbeitet 350+ RPS auf einer einzelnen vCPU.
Eine zentrale Registry. Triage endet selten bei Crashlytics. Bündeln Sie Tools von mehreren Servern hinter einem Endpunkt mit einem Virtual MCP Server, sodass ein Triage-Agent Lesezugriff auf Crashlytics und die benötigten Repository-Tools erhält.
Zwei Wege, die nicht austauschbar sind.
Bei Google Cloud. Die Dokumentation stellt klar, dass dies der eigentliche Weg ist: Löschen Sie den Service Account Key in der Google Cloud Console. Da er die Anmeldeinformation darstellt, stoppt sein Löschen jeglichen Zugriff.
Am Gateway. Tenant Admins löschen gespeicherte Anmeldeinformationen über das Drei-Punkte-Menü neben Edit:
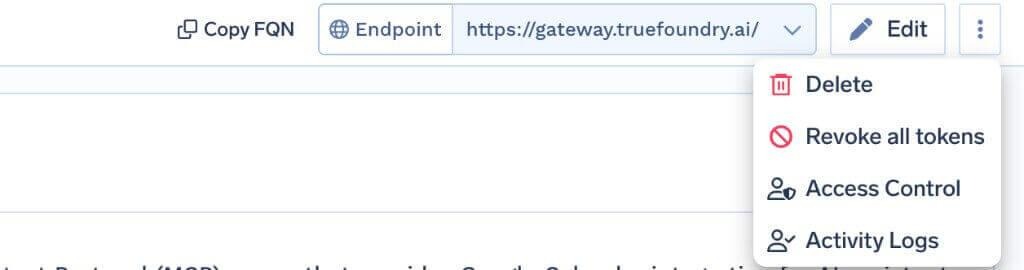
Revoke all tokens löscht jede Auth-Überschreibung und jedes gespeicherte Token für alle Benutzer und Virtual Accounts auf diesem Server. Es wird bei der nächsten Anfrage wirksam, in den Activity Logs aufgezeichnet und ist unwiderruflich. Nur für Tenant Admins. Es löscht die Anmeldeinformationen nur am Gateway – in Google Cloud ändert sich nichts. Löschen Sie im Falle eines Vorfalls daher auch den Schlüssel.
Es ist Crashlytics, nicht Firebase. Es lohnt sich zu wiederholen, da der Suchbegriff irreführend ist: Kein Firestore, Auth, Remote Config oder Hosting.
Sie sind für die Bereitstellung verantwortlich. Im Gegensatz zu Katalog-Servern aktualisiert diesen Server niemand für Sie – wenn sich die Upstream-API ändert, bricht Ihr Dienst ab.
Nur-Lese-Zugriff bewegt dennoch Daten. Viewer-Rollen sind nicht das Ende der Sicherheitsbetrachtung. Sie begrenzen, was ein Agent ändern kann, nicht was er lesen und weiterleiten kann.
Crash-Triage ist genau die Art von Arbeit, die Agents erledigen sollten. Einen Cluster lesen, einen Stack Trace mit einer Geräteverteilung korrelieren, den Build finden, in dem eine Signatur zuerst aufgetreten ist, und alles dokumentieren – monoton und genau das, was ein Modell mit den richtigen Tools gut beherrscht.
Der Crashlytics MCP Server macht das möglich, mit zwei Einschränkungen, die in der Dokumentation offen angesprochen werden: Die Anmeldeinformation ist ein geteilter Service Account Key, daher müssen Identität und Zuordnung vom Gateway kommen. Und Nur-Lese-Zugriff bedeutet nicht risikofrei: Crash-Payloads enthalten Gerätekennungen, App-Status, Benutzer-IDs und Breadcrumbs, die ohne eine AI-Pipeline im Hinterkopf geschrieben wurden. Viewer-Rollen, Scoping pro Tool und Redaktierung nach dem Tool-Aufruf ermöglichen Ihnen den Triage-Agenten ohne Wildwuchs bei den Daten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




In der Dokumentation von TrueFoundry ist es ein Firebase-Crashlytics-MCP-Server: ein Server für das Model Context Protocol, mit dem Agenten Absturz-Issues, Stack Traces, Absturzereignisse und Berichte einsehen können. Er authentifiziert sich mit einem JSON-Schlüssel eines Google-Cloud-Dienstkontos und wird als Remote-Server oder gehosteter stdio-Server bereitgestellt, statt aus einem Katalog provisioniert zu werden. Andere Firebase-Produkte stellt er nicht bereit.
Die Dokumentation beschreibt die Fähigkeiten nach IAM-Rolle, statt Funktionen zu benennen: Projektmetadaten über roles/firebase.viewer, Lesen von Absturzdaten über roles/firebasecrashlytics.viewer und optionale Aktualisierungen des Issue-Status über roles/firebasecrashlytics.user. Die genaue Liste hängt von Ihrer Implementierung ab und erscheint im Tab Tools.
Mit sauber eingegrenztem Umfang ja. Vergeben Sie ausschließlich Viewer-Rollen, deaktivieren Sie ändernde Tools am Gateway, halten Sie die Liste der Mitwirkenden klein und aktivieren Sie PII/PHI Detection am Hook MCP Post Tool, damit Absturz-Payloads geschwärzt werden, bevor sie das Modell erreichen.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet