November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Der dbt MCP Server ist ein von dbt Labs im Rahmen von dbt Cloud betriebener Remote MCP Server. Model Context Protocol ist der offene Standard, mit dem ein Agent Tools auf einem externen System entdecken und aufrufen kann, und die Implementierung von dbt stellt Ihr dbt Cloud-Projekt als aufrufbare Tools bereit. Laut TrueFoundry-Dokumentation kann er Metriken über den Semantic Layer abfragen, Modell-Metadaten prüfen und SQL ausführen.
Die meisten Data MCP Server geben einem Agenten Daten — Snowflake liefert Zeilen, Postgres liefert Zeilen. Der dbt MCP Server liefert die Karte: welche Modelle existieren, woraus sie aufgebaut sind, was jede Spalte bedeutet, welche Tests sie absichern und wie Ihre Organisation eine Metrik definiert.
Ein ehrlicher Hinweis: Die Dokumentation beschreibt Funktionsbereiche, keine Funktionsliste, und nennt ein einzelnes Tool, execute_sql. Lesen Sie alles, was über die oben genannten Familien hinausgeht, in der Registerkarte Tools ab. [VERIFY] Die Dokumentationsseite beschreibt keine Tools zur Job-Auslösung oder Run-Orchestrierung, daher erheben wir hier keine Ansprüche.
Hier ist das Fehlermuster, das jedes Analytics-Team kennt. Jemand fragt einen Agenten: „Wie hoch war die Net Revenue Retention im letzten Quartal?“ Der Agent verfügt über Zugangsdaten zum Abfragen einer SQL database. Er sieht fct_subscriptions, dim_customers und vierzig Spalten mit Namen wie mrr_amt und mrr_amount_usd. Also schreibt er eine Abfrage. Eine Zahl wird zurückgegeben. Sie ist falsch, und nichts deutet darauf hin.
Der Agent ist nicht an SQL gescheitert. Er ist an der Definition gescheitert. Er hat geraten, welche Spalte was bedeutet, wie Churn behandelt werden soll, ob Downgrades einzubeziehen sind, und hat eine selbstbewusste Antwort geliefert, die auf vier Vermutungen basiert. Der dbt MCP Server beseitigt dieses Raten auf zwei Arten.
Lineage und Spaltenkontext. Ein Agent kann fragen, woraus fct_subscriptions aufgebaut ist, was jede Spalte bedeutet und welche Tests dafür erfolgreich sind — genau der Kontext, den ein menschlicher Analyst hat und den eine direkte Data Warehouse-Verbindung nicht bietet.
Benannte Metriken. Wenn Net Revenue Retention im Semantic Layer definiert ist, stellt der Agent sie überhaupt nicht selbst zusammen. Er ruft die Metrik beim Namen mit einer Granularität und einer Dimension auf, und dbt kompiliert das SQL. Die Definition verbleibt in der Versionskontrolle, geprüft von den Verantwortlichen. Das ist der Grund, warum semantic layer MCP ein eigener Suchbegriff ist: Es trennt einen Agenten, der Abfragen schreibt, von einem, der Ihre vereinbarten Antworten liest.
Das ist das Argument dafür, dbt vor einem Data Warehouse zu verbinden. Ein Text-to-SQL-Agent ohne Semantic Layer ist eine Halluzinationsmaschine mit Abfrageberechtigungen. Mit vorgeschaltetem dbt verfügt er über ein Wörterbuch.
Die nützlichen Workflows verketten Tools, anstatt nur eines aufzurufen:
Drei dieser vier Anwendungsfälle benötigen lediglich Metadaten, weshalb diese Integration leicht abgesichert werden kann.
Wir werden uns hier präziser ausdrücken als bei einem Data Warehouse Server; das Risiko aufzubauschen wäre unehrlich.
Das Lesen von Metadaten ist risikoarm. Modellnamen, Spaltenbeschreibungen, Lineage-Kanten und Testergebnisse sind keine Kundendaten. Nichts wird offengelegt und nichts verursacht Kosten.
execute_sql ist der Punkt, an dem Konsequenzen beginnen. Die Dokumentation ist eindeutig: Deaktivieren Sie es, es sei denn, Agenten benötigen die direkte SQL-Ausführung. Es erfordert eine Entwicklungsumgebungs-ID und eine Benutzer-ID, um überhaupt zu funktionieren, was selbst schon ein Signal ist. Ein Agent, der in einer Schleife eine Abfrage gegen eine große Tabelle ausführt, verursacht Warehouse-Kosten und stellt je nach Token-Reichweite einen Egress-Pfad dar.
Semantic Layer-Abfragen sind der zweite Bereich. Sicherer als rohes SQL, da die Definition feststeht, aber nicht kostenlos. Eine Metrikabfrage führt zu Data Warehouse-Workloads, und ein Agent, der diese über jede Dimension über drei Jahre hinweg auf Tagesbasis fächert, erzeugt einen teuren Scan.
Token-Scopes vervielfachen beides. Ein Personal Access Token erbt die Berechtigungen des Benutzers; ein Service Token nutzt zugewiesene Berechtigungssätze. Ein PAT eines Account Admins, das in eine Agentenkonfiguration kopiert wird, verleiht diesem Agenten Admin-Reichweite. Die Dokumentation verweist auf ein Service Token für gemeinsamen Lesezugriff, der richtige Standardwert für alles Unbeaufsichtigte. Und drei Header plus ein Token, die auf das Notebook jedes Analysten kopiert werden, sind bei fünfzehn Personen nicht mehr überprüfbar.
Nichts davon spricht gegen die Anbindung von dbt. Es spricht für eine Control Plane davor, wofür ein MCP gateway gedacht ist.
dbt ist keine Ein-Klick-Auswahl aus dem Managed MCPs-Katalog. Es wird über Connect any Remote MCP Server hinzugefügt, da es ein von Ihnen erstelltes Token und Header benötigt, die nur Sie kennen.
Voraussetzungen: Ein dbt Cloud-Konto auf Starter, Team oder Enterprise; Account Admin-Zugriff; eine Produktionsumgebung sowie eine Entwicklungsumgebung für execute_sql; aktivierte dbt AI-Funktionen.
Schritt 1 — Erstellen Sie ein dbt-Token. Verwenden Sie ein Personal Access Token für individuellen Zugriff oder wenn Sie execute_sql benötigen; ein Service Token für gemeinsamen Lesezugriff. Kopieren Sie es sofort.
Schritt 2 — Erfassen Sie die numerischen IDs aus den dbt Cloud-URLs:
Schritt 3 — Öffnen Sie die Auswahl. Klicken Sie im MCP Gateway auf Add Server und wählen Sie Connect any Remote MCP Server.
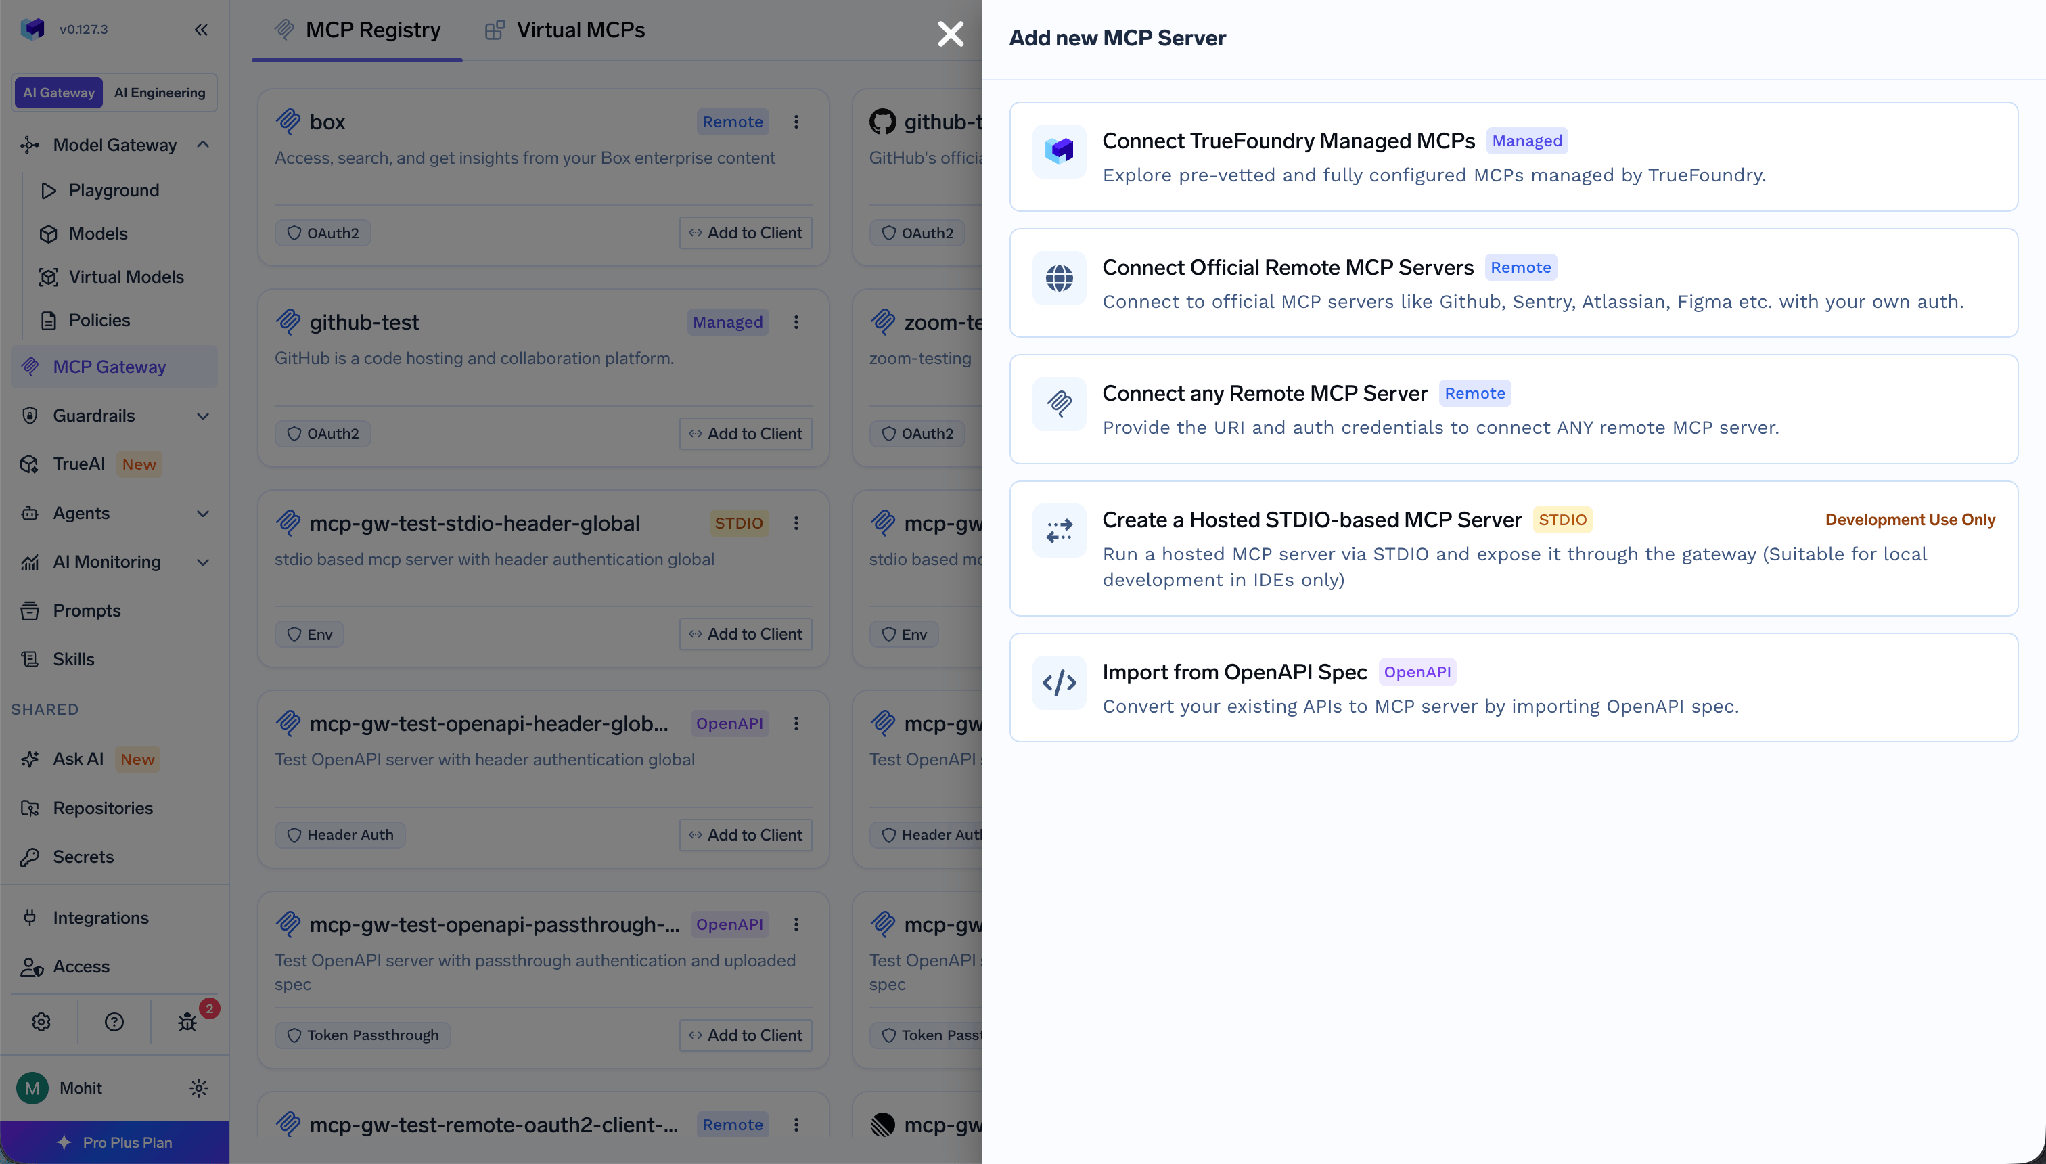
Schritt 4 — Füllen Sie die Serverdaten aus. Geben Sie Name, Description, URL, Collaborators und Auth Data an. Die URL ist der Standard-dbt-MCP-Endpunkt:
https://cloud.getdbt.com/api/ai/v1/mcp/
Für Multi-Cell-Konten verwenden Sie Ihren Cell-Hostnamen, beispielsweise https://abc123.us1.dbt.com/api/ai/v1/mcp/.
Schritt 5 — Konfigurieren Sie Authentifizierung und Header. Fügen Sie Bearer-Token-Authentifizierung hinzu, konfigurieren Sie das dbt-Token und legen Sie die x-dbt-*-Header fest. Um risikoreiche Tools direkt bei der Verbindung zu verbergen, fügen Sie x-dbt-disable-toolsets oder x-dbt-disable-tools hinzu — zwei unabhängige Stellen zum Entfernen eines Tools, was Defense-in-Depth bietet.
TrueFoundry trennt Inbound-Authentifizierung (wie sich ein Client gegenüber dem Gateway ausweist) von Outbound-Authentifizierung (wie sich das Gateway gegenüber dbt ausweist).
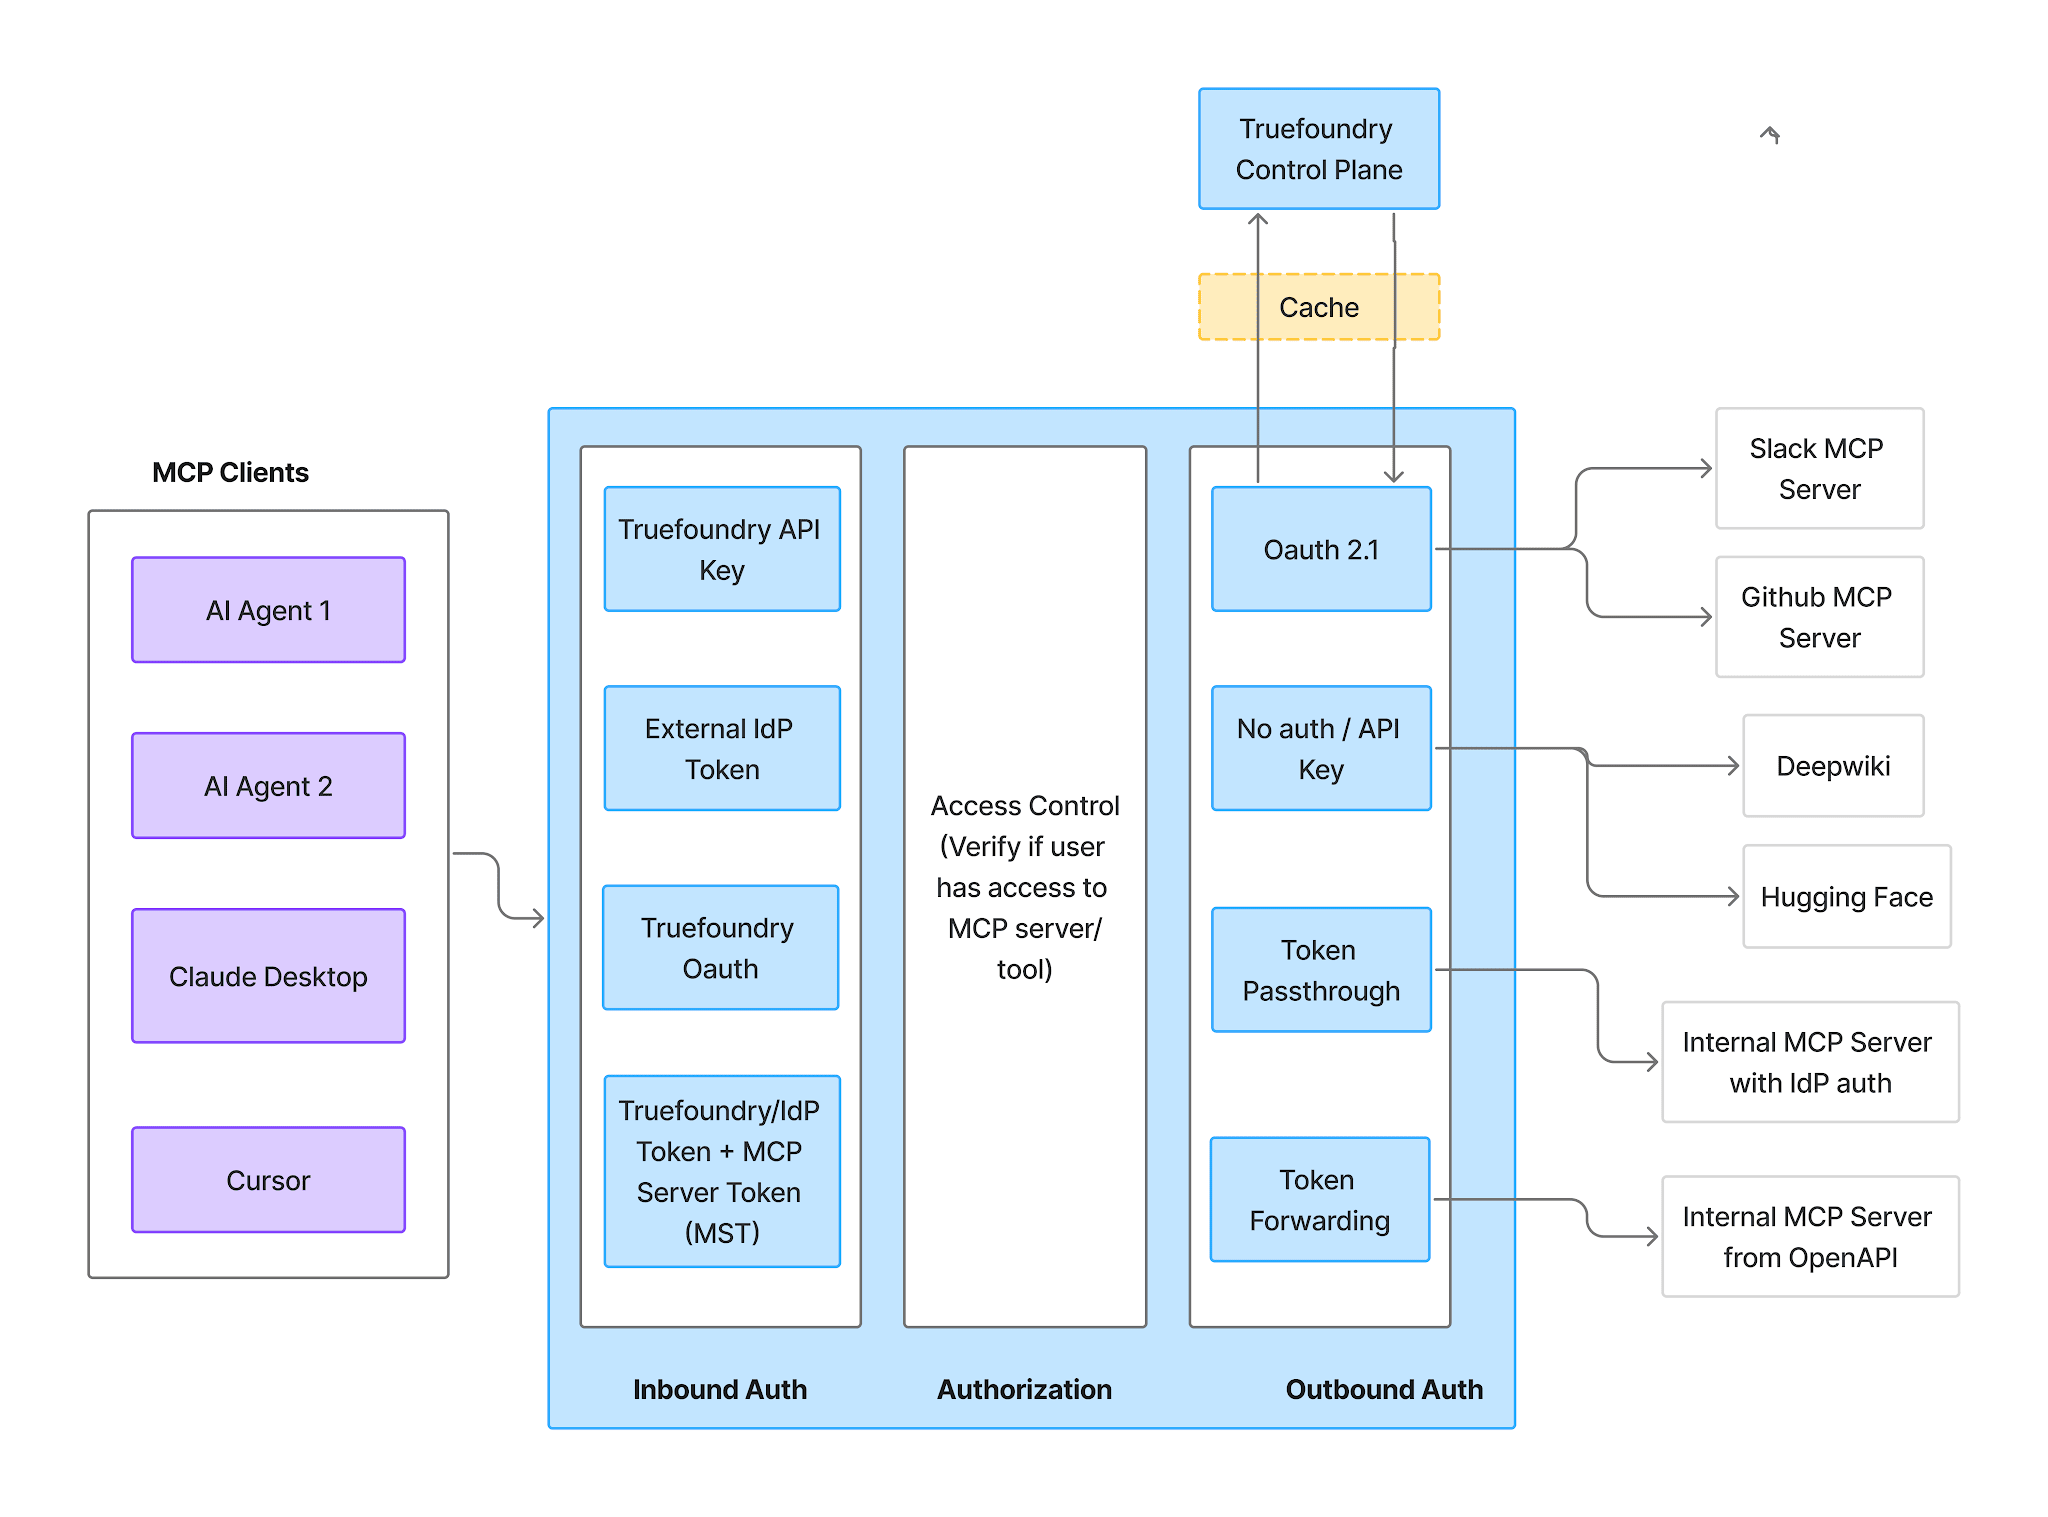
Inbound unterstützt TrueFoundry API Keys, Virtual Account Tokens für Service-to-Service-Aufrufer, Identity Provider Tokens für JWTs von Ihrem eigenen IdP (Okta, Entra, Auth0, Cognito) und TrueFoundry OAuth für IDE-Tools. Eine Einschränkung: Virtual Account Tokens verleihen jedem Request identischen Zugriff, sodass sie keine benutzerspezifische Reichweite abbilden können.
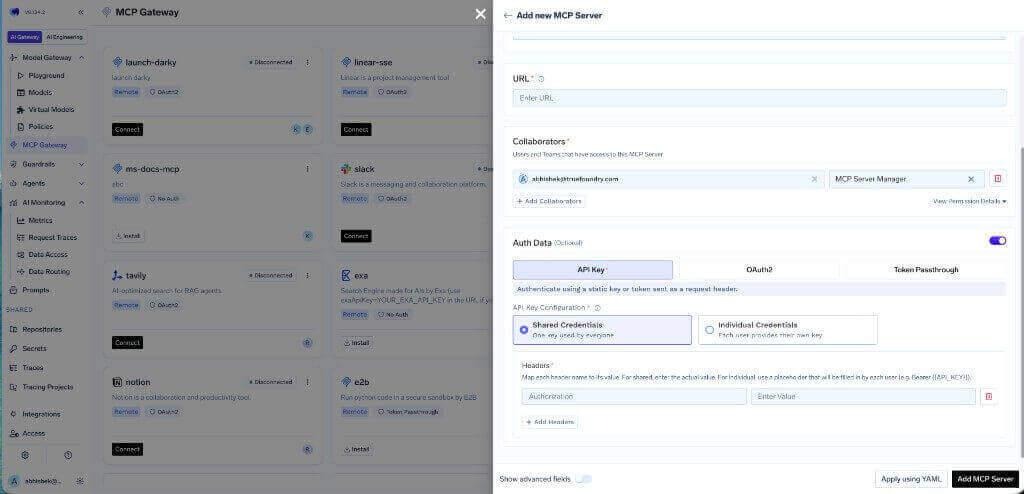
Outbound für dbt ist der Typ API Key mit zwei Anmeldedaten-Modi.
Shared Credentials bedeutet ein Schlüssel für alle: Konfigurieren Sie Header-Name und -Wert einmalig. Dies ist der Modus für ein Service Token mit Beschränkung auf schreibgeschützte Metadaten.
Individual Credentials bedeutet, dass jeder Benutzer seinen eigenen Schlüssel bereitstellt: Konfigurieren Sie den Header mit einem Platzhalter wie Bearer {{API_KEY}}, und jede Person fügt ihr Token über die Registerkarte Auth Overrides hinzu.
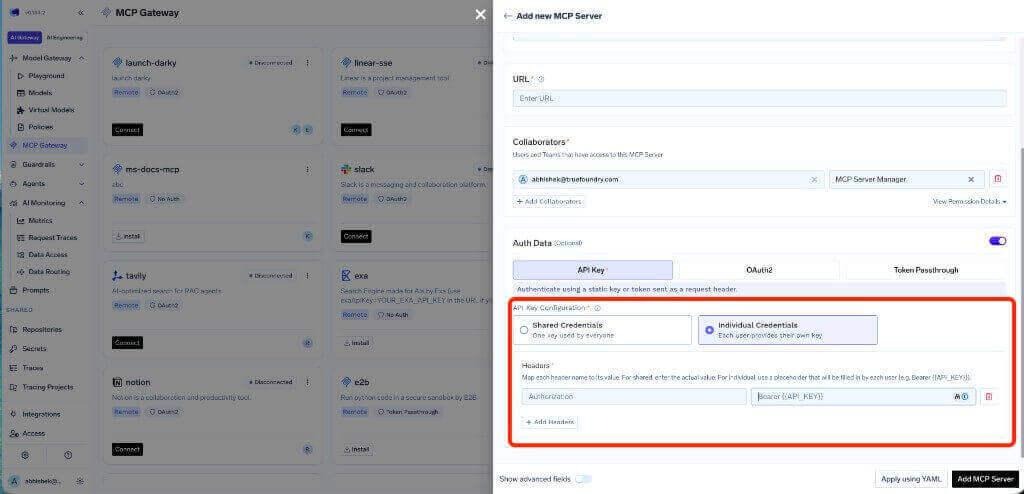
Die Zuordnung ist direkt: Shared Credentials werden mit einem Service Token kombiniert; Individual Credentials mit PATs — dies ist die bevorzugte Option, wenn execute_sql überhaupt aktiviert ist, da die SQL-Ausführung so auf die Person beschränkt bleibt, die sie gestartet hat.
Da dbt Bearer-Token-Auth nutzt, gibt es hier keinen OAuth-Zustimmungsbildschirm oder Redirect-URI. Wenn Sie OAuth2 auf einem selbst registrierten Remote Server konfigurieren, ist die Redirect-URI der Callback Ihrer Control Plane, https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback, und nicht der von Managed MCPs verwendete Callback auth.truefoundry.com.
Auf der Registerkarte Tools entscheiden Sie, was Agenten tun können — bei dbt die wertvollsten fünf Minuten der Einrichtung.
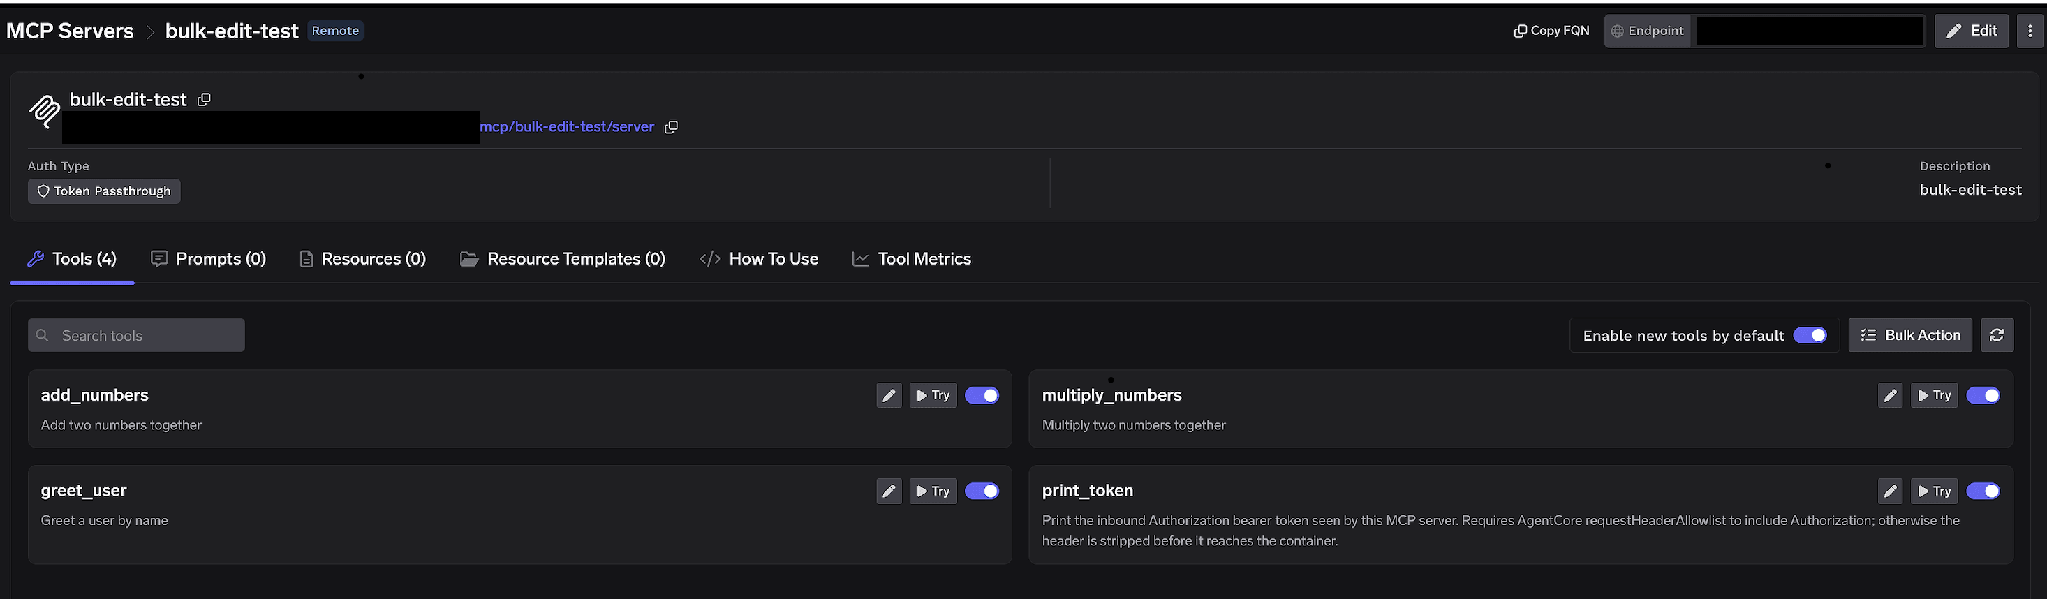
Schalter pro Tool. Schalten Sie ein Tool aus, wird es vollständig aus tools/list entfernt; Clients sehen es nie und es kann nicht aufgerufen werden. Das ist kein Filtern auf Prompt-Ebene. Die empfohlene dbt-Konfiguration ist trivial: Lassen Sie Metadaten- und Discovery-Tools aktiviert und schalten Sie execute_sql aus, es sei denn, ein spezifischer Agent benötigt es. Ein Agent, der execute_sql nicht aufrufen kann, kann nicht zu einer ausufernden Abfrage verleitet werden.
Enable new tools by default. Wenn aktiviert, erscheinen neue Upstream-Tools automatisch. Wenn deaktiviert, sind nur von Ihnen aktivierte Tools verfügbar, sodass eine zukünftige dbt-Version die Handlungsspielräume der Agenten nicht stillschweigend erweitern kann.
Bulk Action. Wandelt jede Zeile in ein Kontrollkästchen um, sodass Sie viele Tools gleichzeitig umschalten können.
Klicken Sie auf das Stiftsymbol bei einem Tool, um dessen Darstellung gegenüber dem Modell zu überschreiben:
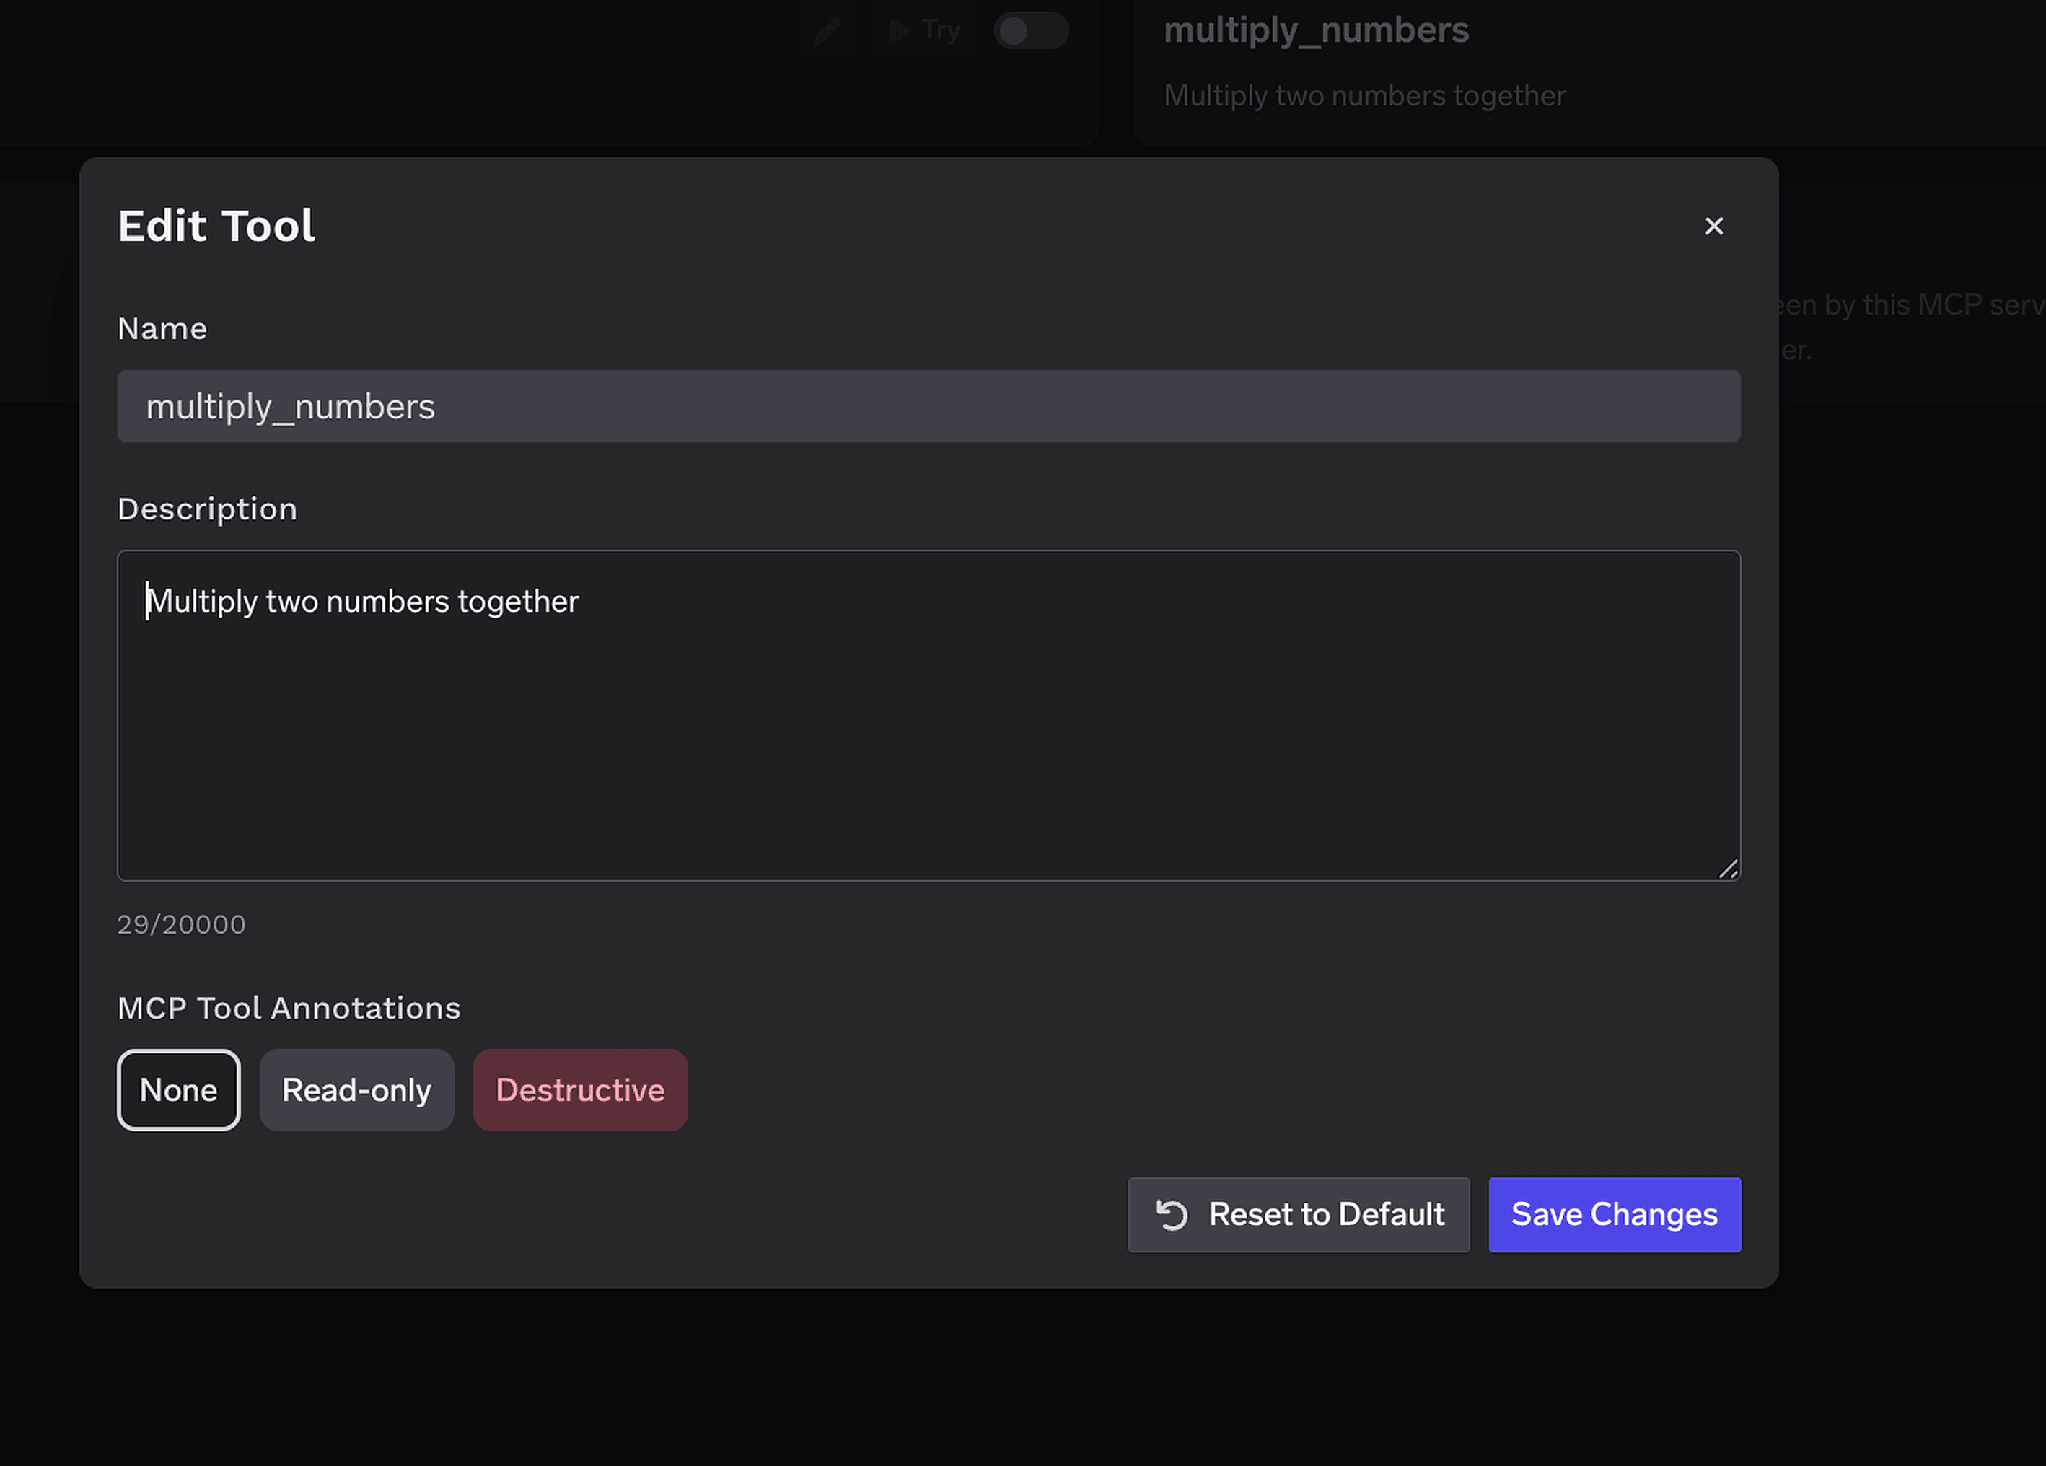
Das Description-Override von bis zu 20.000 Zeichen steuert die Tool-Auswahl. Schreiben Sie ein Metrik-Abfragetool so um, dass es heißt: „Rufen Sie immer dies auf, anstatt SQL für eine bekannte Metrik zu verfassen“, und Sie lenken das Modell in Richtung der von Ihnen verwalteten Definition. MCP Tool Annotations markieren ein Tool als Read-only oder Destructive, indem readOnlyHint oder destructiveHint gesetzt wird.
Die Zugriffskontrolle ist an Benutzer, Teams oder Virtual Accounts auf zwei Dimensionen gebunden: welche Server eine Identität erreicht und welche Tools innerhalb eines Servers sie aufruft.
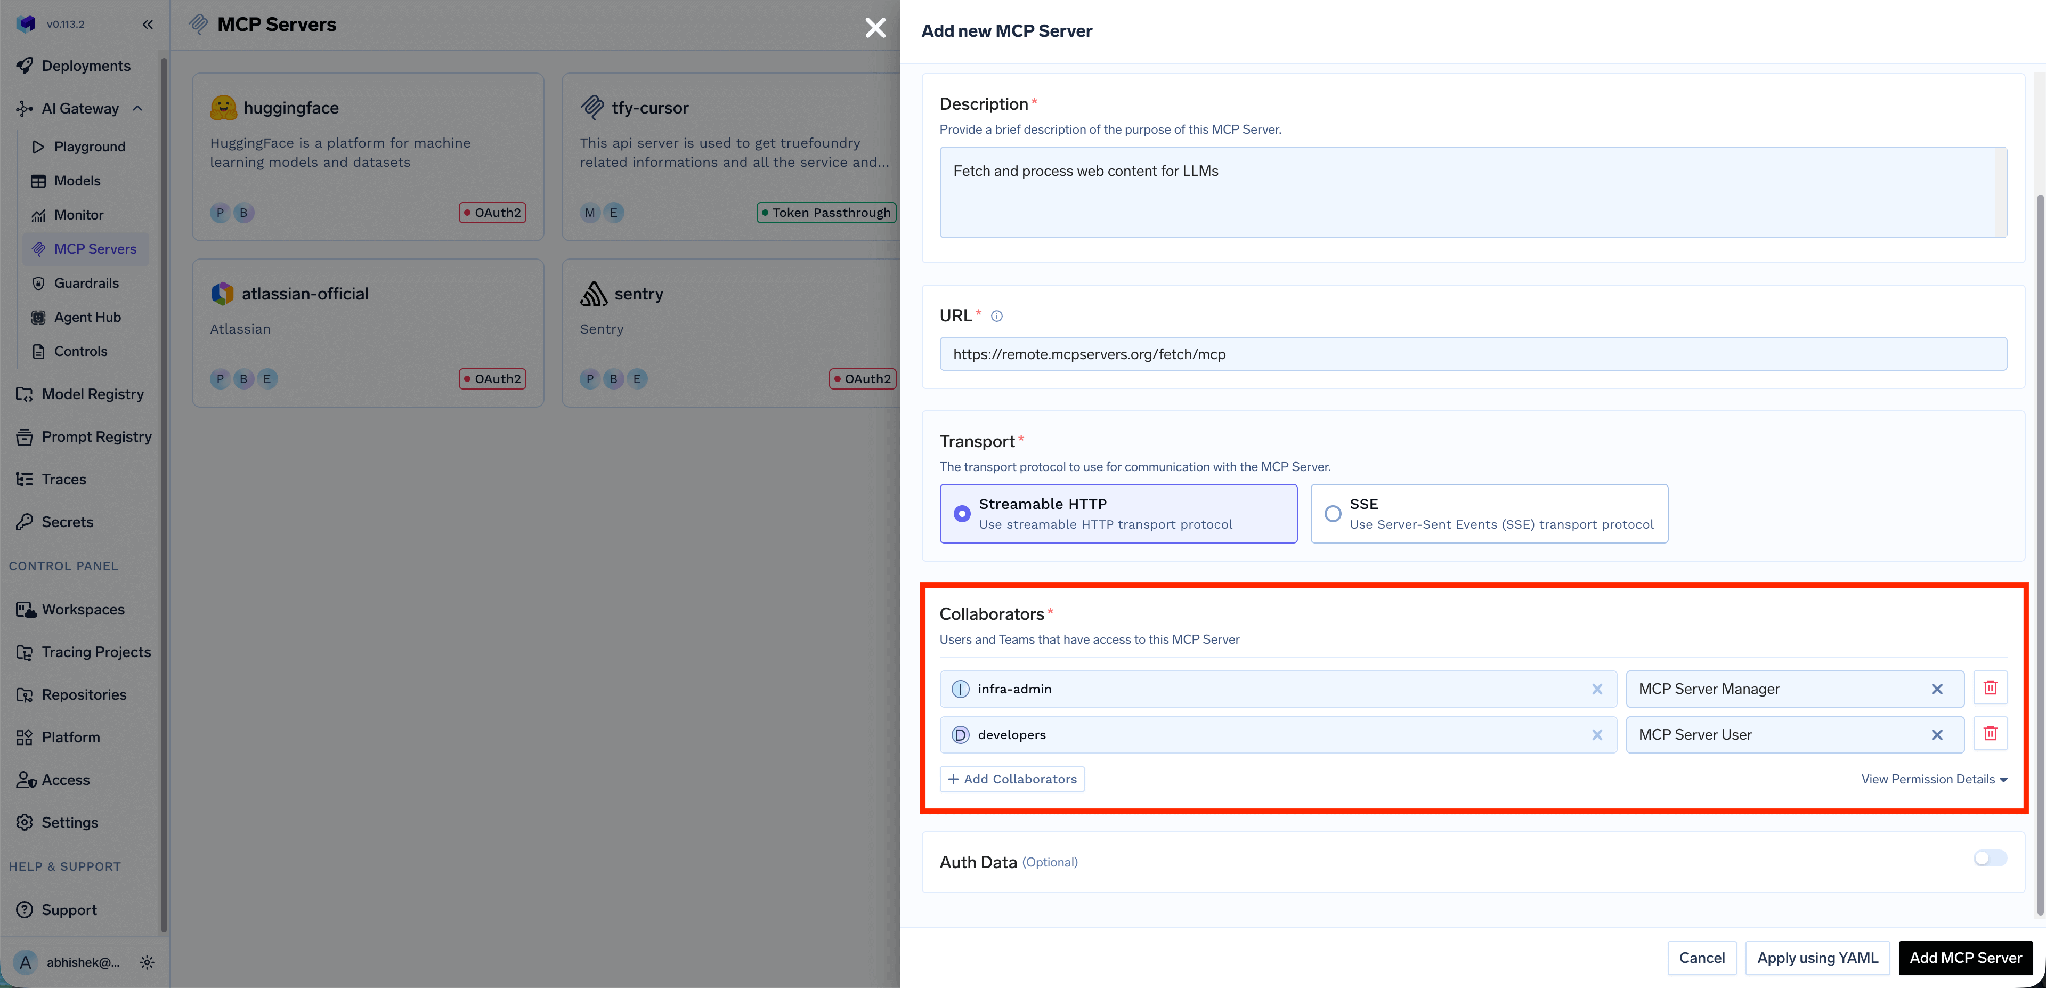
Das Platform-Team legt somit fest, welche dbt-Tools existieren, und andere Teams nutzen diese — dasselbe MCP access control-Modell, angewendet über Ihre gesamte Registry.
Das Deaktivieren von execute_sql ist das grobe Instrument. Manchmal möchten Sie, dass ein Agent SQL ausführt oder eine teure Metrikabfrage auffächert, nur nicht unbeaufsichtigt. Genau dafür sind Tool-Approval-Policies gedacht, und sie passen zu dbt, da die abzusichernde Menge klein ist.
Wenn ein geschütztes Tool aufgerufen wird, wird der Aufruf angehalten, eine Anfrage erstellt und Genehmiger werden benachrichtigt. Nach der Genehmigung sind Aufrufe für ein konfigurierbares Zeitfenster erfolgreich, danach ist eine erneute Genehmigung erforderlich.
Erstellen Sie eine Policy unter AI Gateway → Policies → MCP Tool Approval, derzeit als Beta gekennzeichnet:
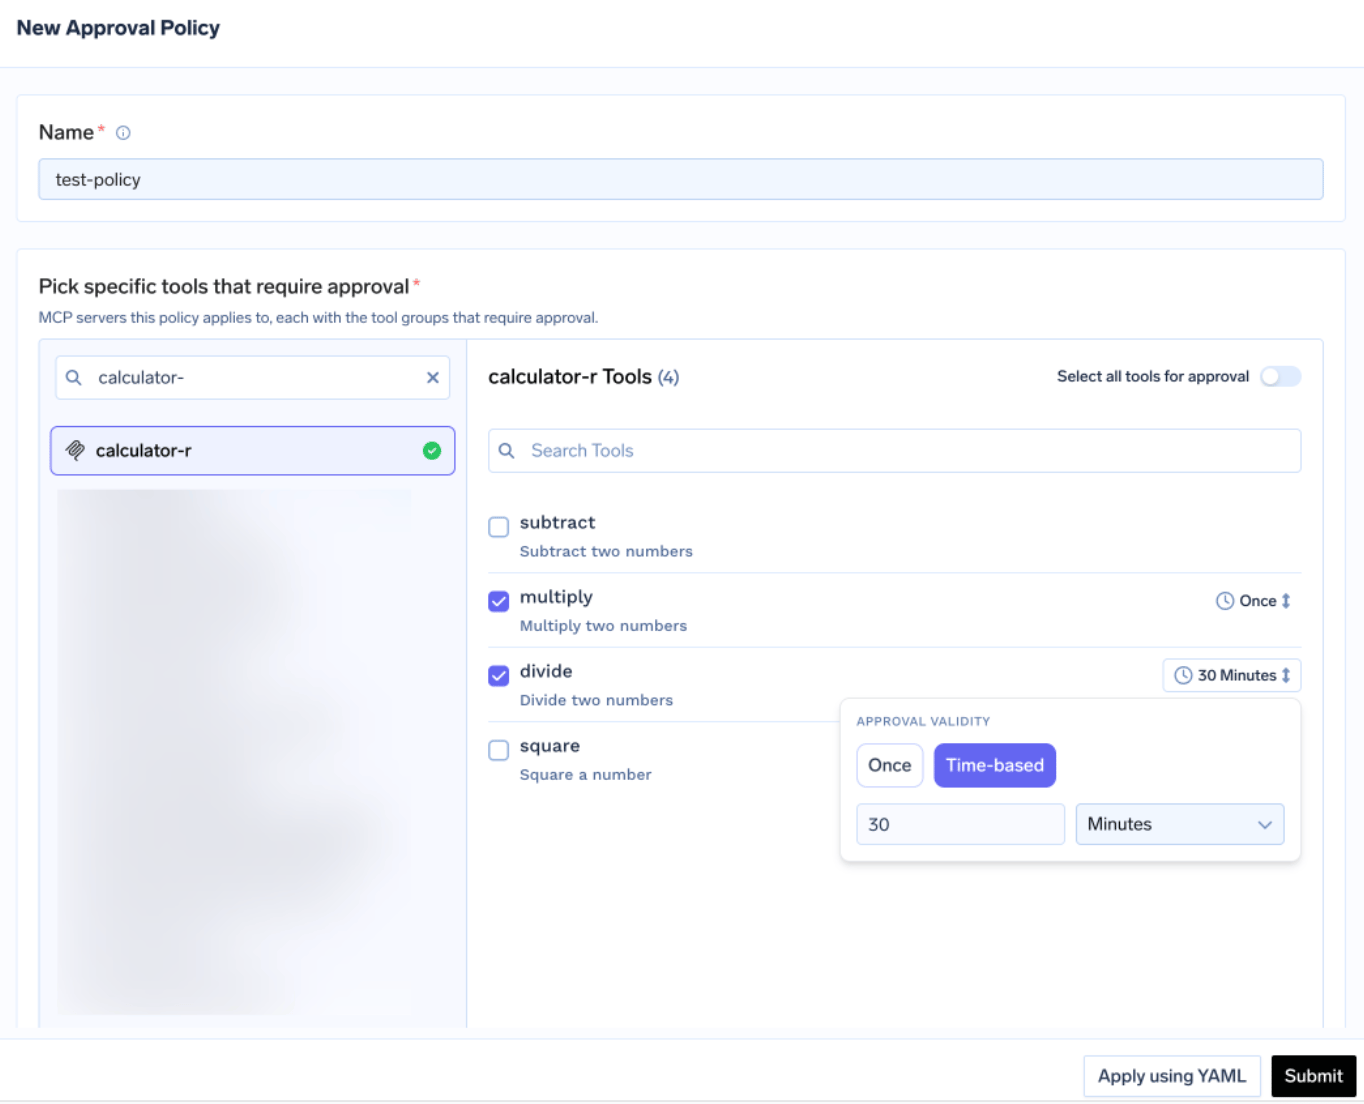
Jede Policy benennt die von ihr geschützten Server und wählt einen Approval Scope: named schützt nur die von Ihnen aufgelisteten Tools, destructive schützt jedes mit destructiveHint: true markierte Tool, all schützt alles. Bei Überschneidungen gewinnt das Spezifischste: named > destructive > all. Für dbt ist named meist die ehrliche Wahl: Zwei oder drei Tool-Namen decken das reale Risiko ab, und ein pauschales Schützen aller Tools würde dazu führen, dass Genehmiger selbst für Lineage-Lesezugriffe klicken müssten.
Validity ist entweder Once (eine einzelne Ausführung) oder zeitbasiert (eine Dauer in Minuten). Bei Regelkonflikten gewinnt die restriktivste Einstellung: Once schlägt ein 10-Minuten-Fenster, das wiederum ein 30-Minuten-Fenster schlägt. Genehmiger werden per E-Mail, Slack, PagerDuty oder MS Teams benachrichtigt:
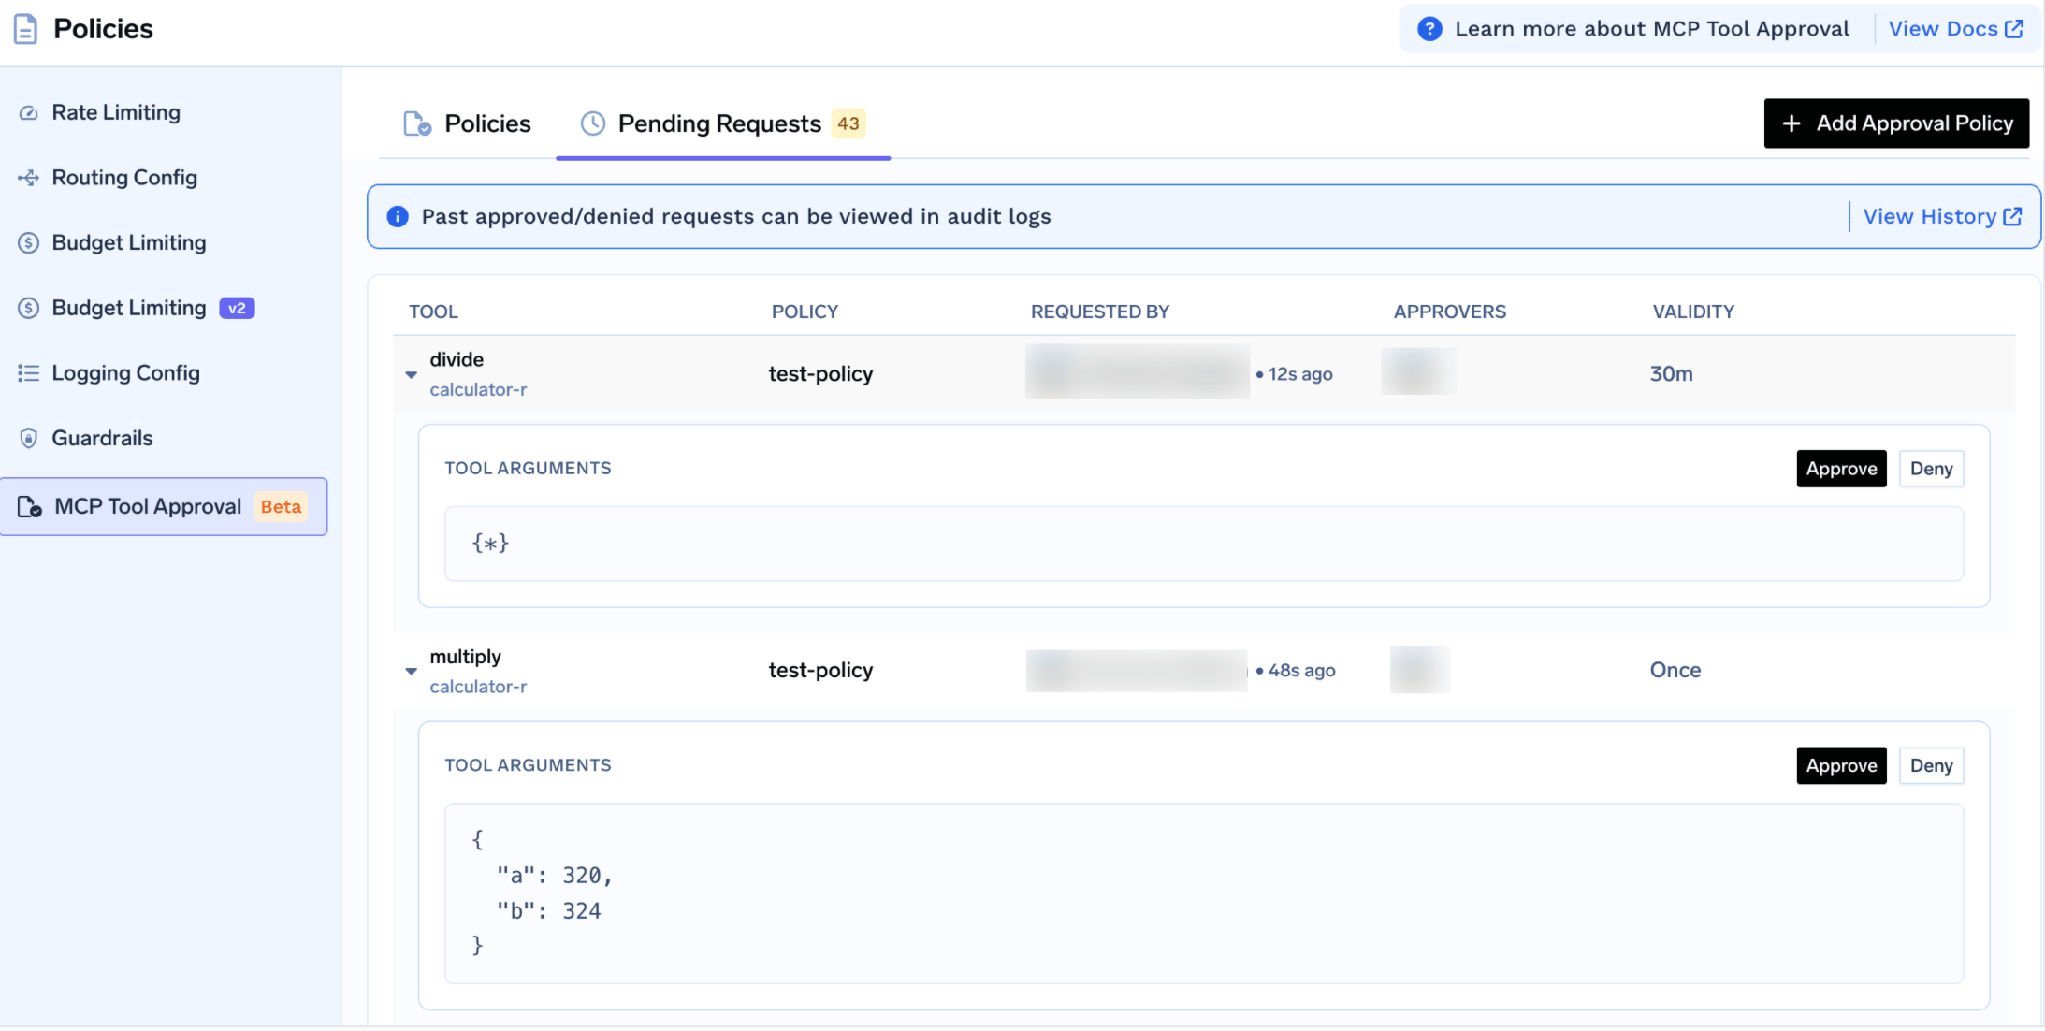
Jede Anfrage zeigt das Tool, die Policy, den Anforderer und die tatsächlichen Argumente, sodass ein Genehmiger das SQL lesen kann, bevor er es freigibt. Während des Wartenzustands erhält der Aufrufer ein JSON-RPC-Ergebnis mit _meta.approval_status: "pending" anstelle eines Fehlers, sodass ein gut konfigurierter Agent wartet und es erneut versucht. Freigaben gelten pro Anforderer, und eine Ablehnung blockiert niemanden dauerhaft — um dies zu tun, deaktivieren Sie das Tool oder entfernen Sie den Benutzer.
Testen Sie zuerst manuell. Klicken Sie auf der Serverdetailseite auf Try neben einem Tool, füllen Sie die Parameter aus und lesen Sie das JSON; Try ist für deaktivierte Tools deaktiviert. Dies deckt typische dbt-Fehler frühzeitig auf: eine falsche Umgebungs-ID, nicht aktivierte dbt AI-Funktionen oder ein abgelaufenes Token.
Öffnen Sie die Registerkarte How To Use für Ihre mandantenspezifische Gateway-URL und Snippets.
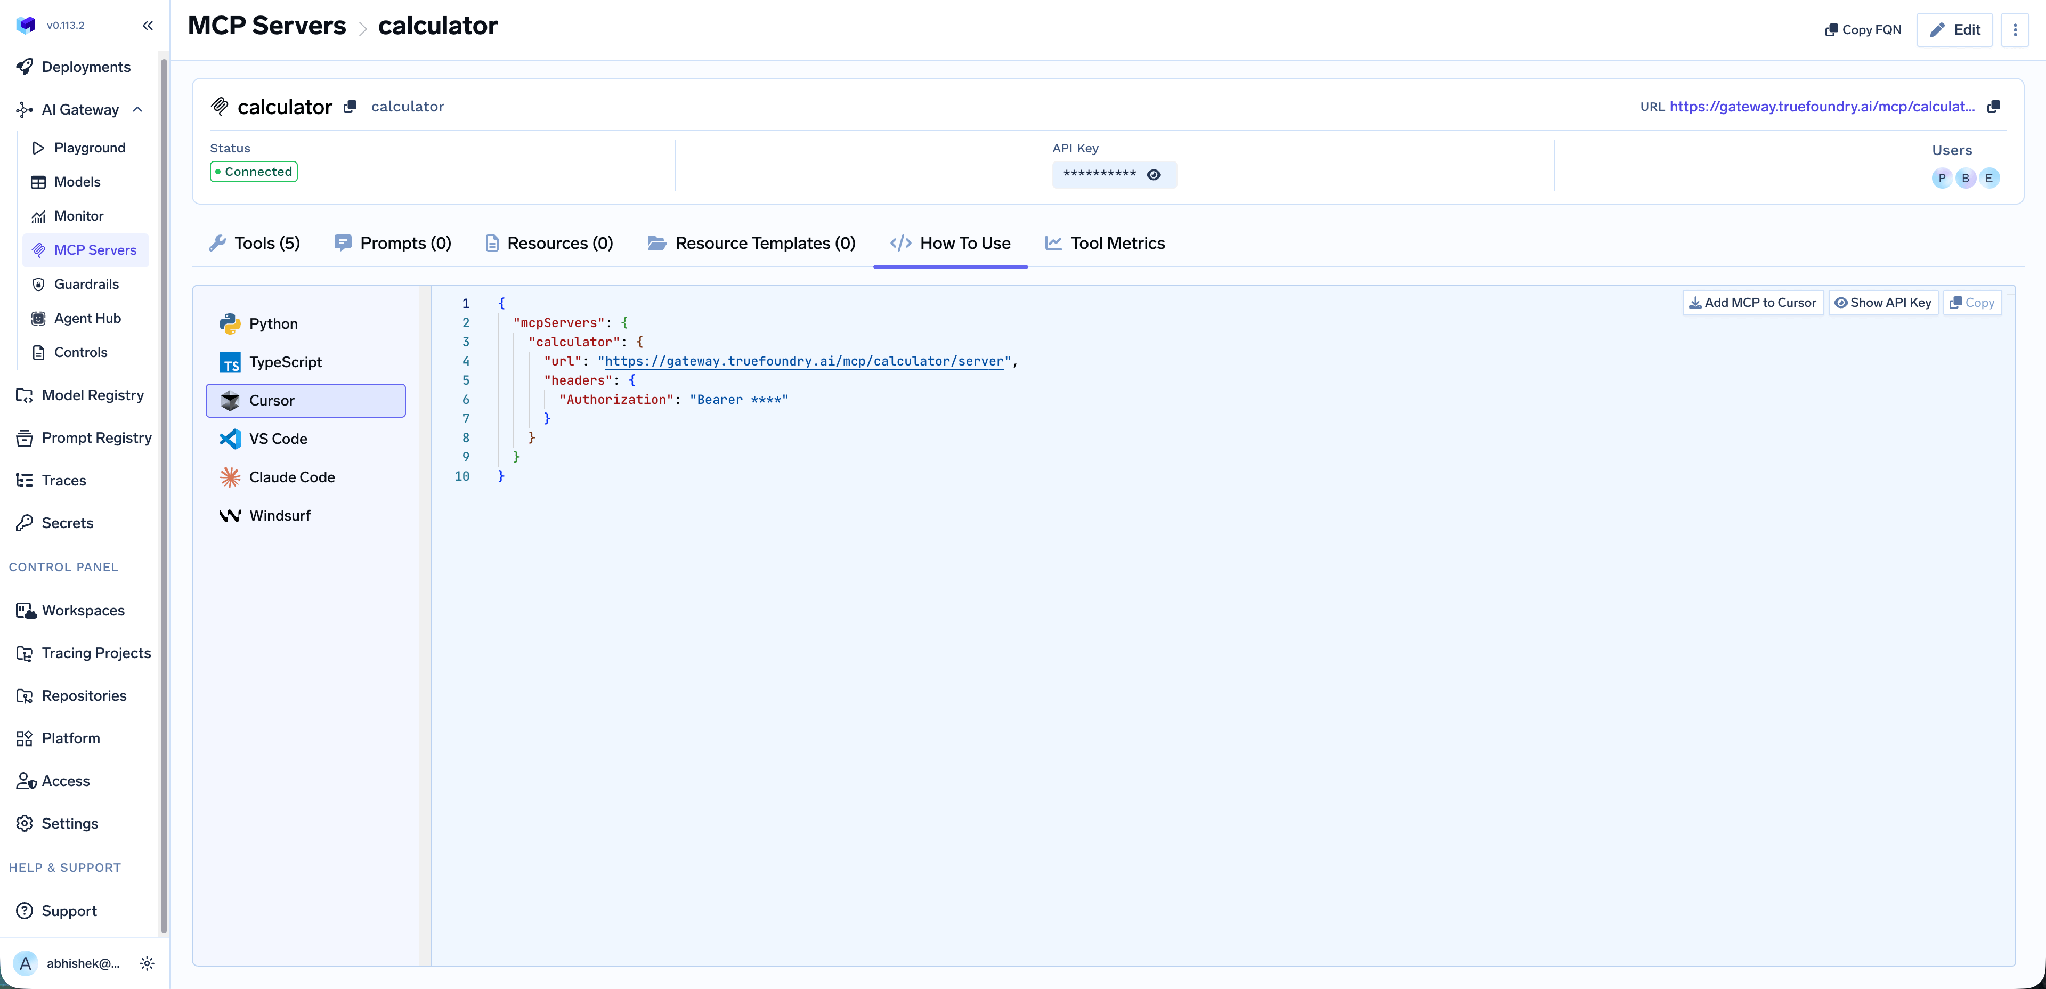
Sie deckt Claude Code, VS Code, Claude Desktop, Cursor, Windsurf, Codex sowie die Python- und TypeScript-MCP-SDKs ab. Add MCP to Cursor schreibt die Konfiguration; Show API Key zeigt das Token an.
Verwenden Sie die URL aus dieser Registerkarte, anstatt sie selbst zusammenzustellen — sie ist mandantenspezifisch, und ein manuell erstellter Endpunkt ist die häufigste Ursache für einen Client, der sich verbindet, aber keine Tools auflistet. Der Nebeneffekt ist wichtig: Analysten konfigurieren einen TrueFoundry-Endpunkt, sodass die dbt-Zugangsdaten niemals ein Notebook erreichen.
Metriken auf Tool-Ebene. Das Dashboard schlüsselt Anfragen pro Sekunde, Latenz von P50 bis P99, Fehlerrate nach Fehlertyp und Anzahl der Anfragen pro Tool auf.
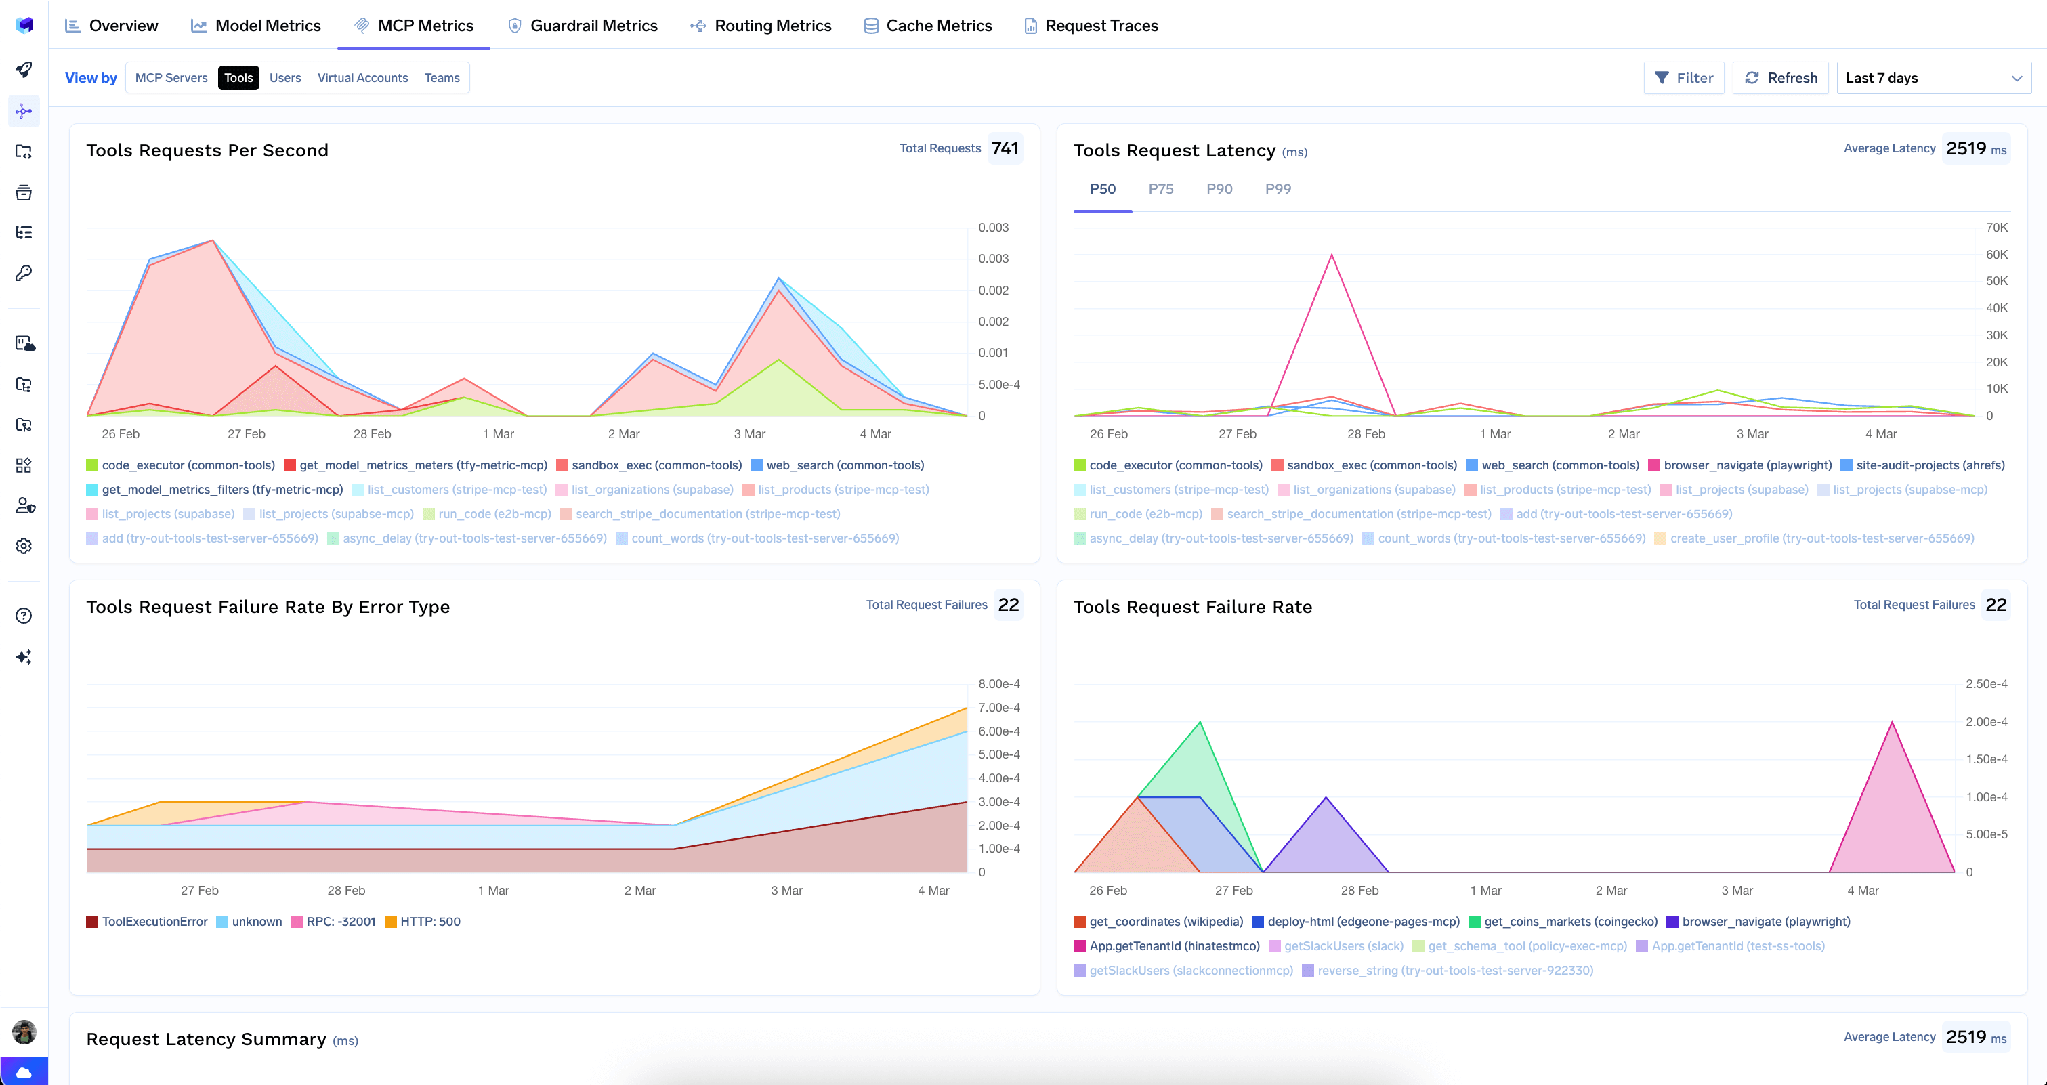
Für einen Datenserver ist das Kostenkontrolle, nicht nur ein Dashboard: So finden Sie heraus, ob ein Agent eine Metrikabfrage zweihundertmal pro Durchlauf aufruft.
Observability für vollständige Requests. Jeder Tool-Aufruf wird mit der Identität des Aufrufers, dem Tool-Namen, den Eingaben und der Latenz nachverfolgt und über OpenTelemetry exportiert. Die Frage „Welcher Agent hat diese Abfrage für wen mit welchen Argumenten ausgeführt?“ wird zu einer einfachen Suche statt zu einer langwierigen Untersuchung.
Guardrails. Pre-Tool- und Post-Tool-Guardrails wenden Richtlinien auf MCP-Tool-Aufrufe an.
Geringer Overhead. Das Gateway fügt lediglich etwa 3-4 ms Latenz hinzu und verarbeitet 350+ RPS auf einer einzelnen vCPU, parallel zu 1.000+ LLMs.
Eine zentrale Registry. Sobald mehrere Server registriert sind, können Sie eine kuratierte Teilmenge von Tools hinter einem einzigen Endpunkt mit einem Virtual MCP Server bündeln — dbt-Metadaten-Tools plus ein Warehouse-Lese-Tool, sonst nichts. Das ist die Struktur eines vertrauenswürdigen Analytics-Agenten: dbt liefert die Definitionen, das Data Warehouse liefert die Zeilen.
Mandanten-Admins können alle gespeicherten Zugangsdaten über das Drei-Punkte-Menü neben Edit löschen:
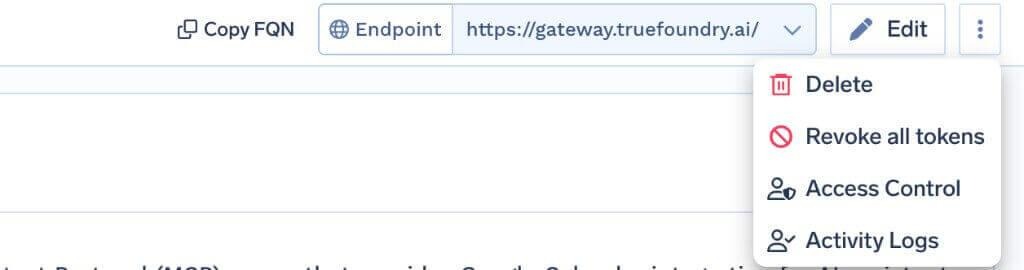
Revoke all tokens löscht jedes Auth Override und gespeicherte Token für alle Benutzer und Virtual Accounts auf diesem Server, wird bei der nächsten Anfrage wirksam und in den Activity Logs aufgezeichnet. Es ist unumkehrbar, jeder muss danach erneut Zugangsdaten eingeben, und nur Mandanten-Admins können dies sehen. Eine Einschränkung ist wichtig: Es löscht Tokens nur am Gateway, nicht in dbt Cloud; erneuern Sie bei einem Sicherheitsvorfall das dbt-Token daher auch dort.
Die Header machen die Einrichtung aus. Die meisten fehlgeschlagenen ersten Versuche liegen an einer fehlenden oder falschen x-dbt-*-ID, nicht an einem Authentifizierungsproblem. Die Dev-Umgebungs-ID und Benutzer-ID werden nur für SQL- und Fusion-Tools benötigt, sodass eine Verbindung gesund aussieht, bis der erste SQL-Aufruf erfolgt.
Account Admin ist für die Einrichtung erforderlich, nicht für die Nutzung. Sie benötigen Account Admin in dbt Cloud, um das Token zu erstellen und die IDs auszulesen. Das bedeutet nicht, dass der Agent Admin-Rechte besitzen sollte — erstellen Sie es als Admin und übergeben Sie dem Agenten dann ein entsprechend eingeschränktes Service Token.
Metadaten sind nur so gut wie Ihr Projekt. Ein Agent, der Lineage in einem undokumentierten Projekt liest, erhält eine Karte ohne Beschriftungen.
Der dbt MCP Server ist die am meisten unterschätzte Integration im Data Stack, eben weil er auf den ersten Blick unscheinbar wirkt. Er liefert keine Daten zurück. Er liefert Definitionen, Lineage und Dokumentation — genau den Kontext, der einen Agenten, der eine geschäftliche Frage korrekt beantwortet, von einem unterscheidet, der plausibles SQL gegen geratene Spalten schreibt.
Er lässt sich zudem außergewöhnlich einfach absichern. Das Risiko konzentriert sich auf execute_sql und teure Semantic Layer-Abfragen, und beides lässt sich in Minuten regeln: Ein eingeschränktes Service Token anstelle eines Admin-PATs, Schalter pro Tool, die Metadaten offen und SQL geschlossen halten, Approval Gates und ein protokolliertes Aufruf-Log.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Es ist der Remote-Server für das Model Context Protocol von dbt Cloud. Er ermöglicht es einem Agenten, Metriken über den Semantic Layer abzufragen, Modellmetadaten und Lineage einzusehen und SQL gegen ein dbt-Cloud-Projekt auszuführen. Sein Wert liegt in den Metadaten: Ihrem Modellgraphen und Ihren Metrikdefinitionen statt in Rohdatenzeilen.
Laut Dokumentation drei Funktionsbereiche: Metrikabfragen über den Semantic Layer, Einsicht in Modellmetadaten und SQL-Ausführung über execute_sql. dbt gruppiert Tools außerdem in Toolsets, die Sie mit den Headern x-dbt-disable-toolsets und x-dbt-disable-tools ausblenden können. Ihre genaue Liste erscheint im Tab Tools.
Registrieren Sie ihn als Remote-MCP-Server mit https://cloud.getdbt.com/api/ai/v1/mcp/, Bearer-Token-Authentifizierung und den x-dbt-*-Headern. Verwenden Sie ein eingeschränktes Service-Token statt eines Admin-PAT, deaktivieren Sie execute_sql, sofern kein Agent es benötigt, und legen Sie eine Freigaberichtlinie auf die Tools, die Sie beibehalten.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Ja. Es umfasst ein MCP Gateway, ein Agent Gateway und eine MCP & Agents Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten auf Basis von LangGraph, CrewAI, AutoGen oder einem eigenen Framework lassen sich alle zentral steuern.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet