



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
AWS Bedrock dient als verwaltete Schicht für den Zugriff auf Foundation Models innerhalb der AWS VPC-Grenze. Für Engineering-Teams entfällt der operative Aufwand für die Bereitstellung von GPU-Instanzen oder die Verwaltung von Kubernetes-Clustern für Inference. Der Dienst bietet sofortigen Zugriff auf Modelle wie Claude 3.5 Sonnet, Llama 3 und Amazon Titan über eine einheitliche API.
Die AWS Bedrock Preisgestaltung ist jedoch keine Flatrate. Sie funktioniert wie ein komplexes Menü, bei dem die Endkosten von der Modellvarianz, der Token-Verteilung, den regionalen Verkehrskapazitäten und dem operativen Aufwand unterstützender Dienste wie CloudWatch und OpenSearch abhängen. Dieser Bericht analysiert die Unit Economics von AWS Bedrock, identifiziert Kosten-Spitzen bei Skalierung und untersucht die architektonischen Trade-Offs zwischen managed Inference und selbst gehosteten Alternativen unter Verwendung von Plattformen wie TrueFoundry.
Bevor wir uns die detaillierten Kosten ansehen, ist es wichtig, das allgemeine AWS Bedrock Preismodell zu verstehen. AWS Bedrock folgt einem rein nutzungsbasierten Pricing-Ansatz ohne Vorab-Plattform- oder Abonnementgebühren.
Sie zahlen nicht dafür, den Dienst einzuschalten. Stattdessen wird Ihnen in erster Linie die Modell-Inference berechnet, gemessen in Tokens oder generierten Outputs. Der Preis pro Einheit unterscheidet sich jedoch erheblich je nach Anbieter des Foundation Models; ein Anthropic-Modell kostet deutlich mehr als ein Meta- oder Mistral-Modell, selbst wenn die Token-Anzahl identisch ist.
Die Preisgestaltung von AWS Bedrock wird davon getrieben, wie Modelle während der Inference Ressourcen verbrauchen. Während die meisten Textmodelle pro Token abrechnen, unterscheiden sich multimodale Modelle.
Sie müssen zwischen Input Tokens und Output Tokens unterscheiden. Input-Tokens bestehen aus dem Prompt-Payload, einschließlich Systemanweisungen, Benutzeranfragen und — ganz entscheidend — abgerufenen Kontexten aus RAG-Pipelines. Output-Tokens sind die generierte Antwort.
Die betriebliche Realität diktiert, dass Output-Tokens deutlich teurer sind, da die Rechenkosten der Generierung (Next-Token-Prediction) höher sind als die Verarbeitung des Input-Kontexts. Beispielsweise zahlen Sie bei Claude Sonnet 4.5 in us-east-1 3,00 $ pro Million Input-Tokens, aber 15,00 $ pro Million Output-Tokens — ein 5-facher Multiplikator. Bei multimodalen Modellen wie Amazon Titan Image Generator wechselt die Abrechnung auf eine Pro-Bild-Basis, berechnet nach Auflösung und Anzahl der Schritte.
Abb. 1: Der Kostenmultiplikator-Effekt
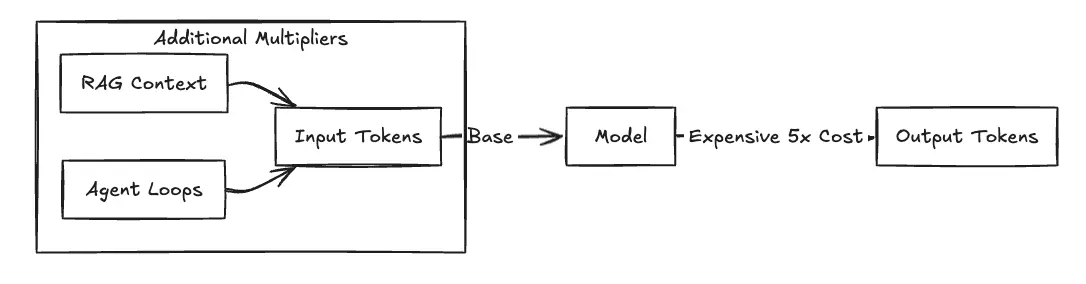
Die Preisgestaltung von AWS Bedrock bedeutet nicht nur „Pay-per-Token“. Teams müssen zwischen zwei Preismethoden wählen, die Flexibilität gegen garantierte Kapazität abwägen.
Abb. 2: Dekompensation der Gesamtrechnung
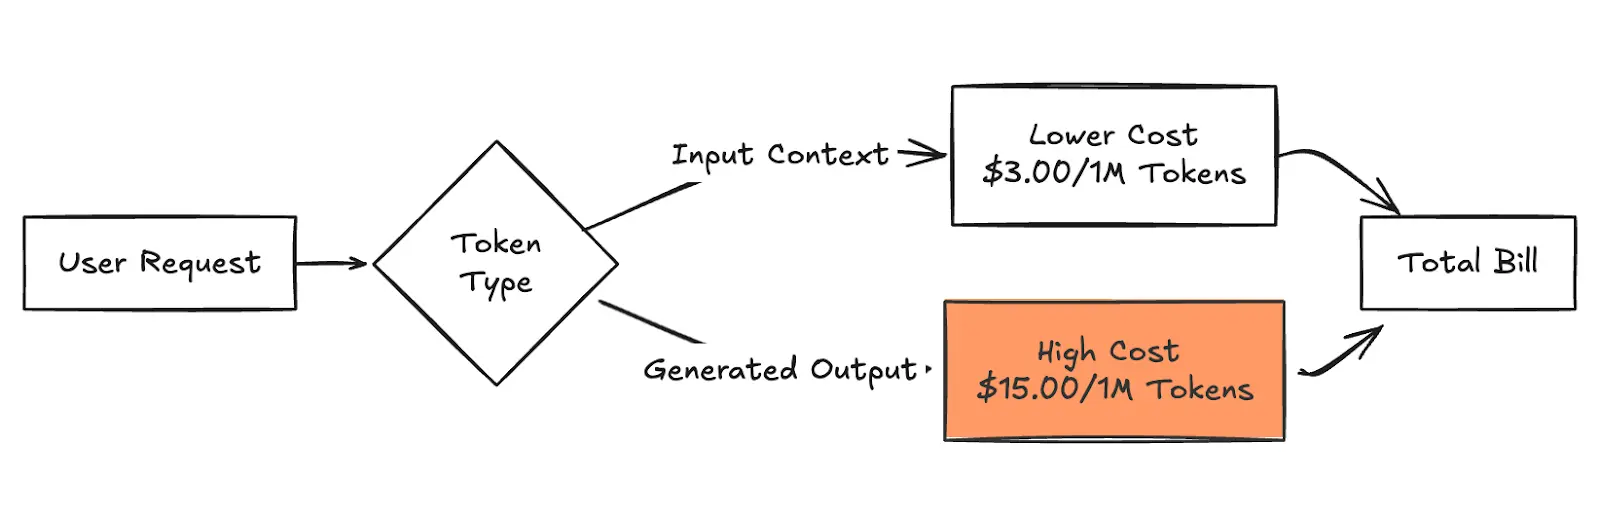
Preise spiegeln die AWS Bedrock On-Demand-Tarife für Anthropic Claude 3.5 Sonnet in der Region us-east-1 (Stand: Januar 2026) wider. Die Preise können je nach Region oder Modellversion variieren.
Die On-Demand-Preisgestaltung ist die Standardoption für die meisten AWS Bedrock-Nutzer. Sie bietet Flexibilität, birgt jedoch operative Risiken. Die Abrechnung erfolgt strikt pro 1.000 verarbeiteter Tokens, was sich perfekt für schwankende Traffic-Muster oder frühe Experimente mit sprunghaftem Nutzungsverhalten eignet. Der Nachteil ist jedoch die Verlässlichkeit. AWS setzt Throttling-Limits durch, was bedeutet, dass Ihre Anfragen in Spitzenzeiten gedrosselt werden können.
Die Provisioned Throughput-Preisgestaltung ist für Teams konzipiert, die eine garantierte Modellverfügbarkeit im großen Maßstab benötigen. Sie schafft Vorhersehbarkeit, erfordert jedoch eine finanzielle Verpflichtung. Anstatt pro Token zu zahlen, erwerben Sie eine dedizierte Modelleinheit, um Inference-Kapazität zu reservieren und eine bestimmte Durchsatz-Preiskategorie zu garantieren.
Der Haken ist, dass Ihnen eine feste stündliche Gebühr berechnet wird, unabhängig davon, ob Sie null Anfragen senden oder die Einheit voll auslasten. Dieses Modell funktioniert ähnlich wie eine Reserved Instance; es erfordert in der Regel eine Bindung von 1 bis 6 Monaten, was Ihre Möglichkeit einschränkt, schnell zu einem besseren Modell zu wechseln, das vielleicht nächste Woche erscheint.
Im Gegensatz zu OpenAI, wo Sie an einen einzigen Anbieter zahlen, ist Bedrock ein Marktplatz. Die Preisstrategien unterscheiden sich je nach Anbieter.
Amazon Titan Modelle sind AWS-eigene Foundation Models, die für allgemeine AI-Workloads entwickelt wurden. Da es sich um First-Party-Modelle handelt, sind sie in der Regel günstiger als Alternativen von Drittanbietern. Das macht sie ideal für kostensensible Produktions-Anwendungsfälle wie die Erstellung von Embeddings oder einfache Klassifizierungen, bei denen eine „gut genuge“ Leistung zu einem niedrigen Preis das Ziel ist.
AWS Bedrock bietet auch Zugriff auf Modelle von externen Anbietern wie Anthropic, Cohere und AI21 Labs. Die Preise sind hier aufgrund der fortgeschrittenen Fähigkeiten und der externen Lizenzierung generell höher. Beachten Sie den Aufpreis für Modelle mit hoher Schlussfolgerungslogik wie Claude 4.5 Sonnet, bei denen Output-Tokens erheblich teurer sind. Die Kosten können hier bei chat-intensiven Anwendungen, bei denen das Modell „nachdenkt“ oder lange, ausführliche Antworten generiert, schnell steigen.
Ihr Anwendungsdesign beeinflusst Ihre Rechnung genauso stark wie das Preisschild des Modells.
Der Basis-Token-Preis ist oft nur die Spitze des Eisbergs. Reale AI-Anwendungen nutzen „Knowledge Bases“ und „Agents“, die über eigene, separate Zähler abgerechnet werden.
Abb. 3: Der zusätzliche Kosten-Stack
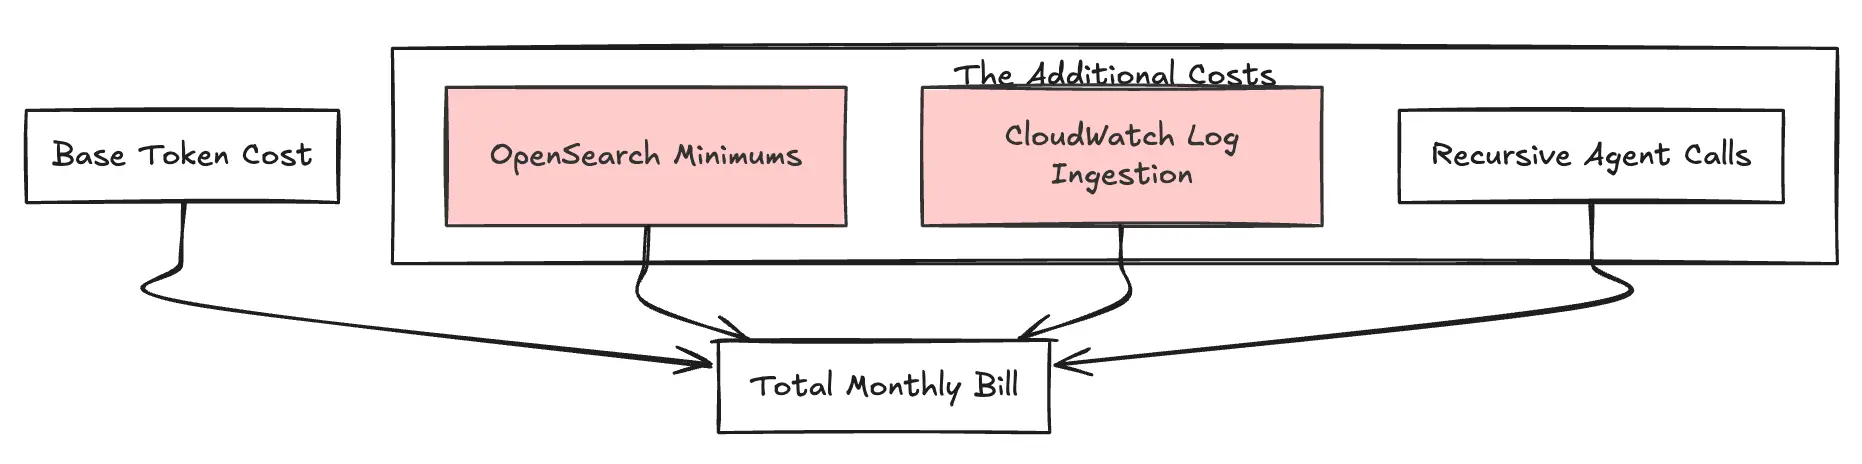
Bedrock Knowledge Bases abstrahieren die RAG-Pipeline, stellen jedoch Infrastruktur im Hintergrund bereit. Typischerweise wird hierfür ein OpenSearch Serverless Vektorspeicher gestartet. Engineering-Teams übersehen oft die Mindest-Grundkosten: OpenSearch Serverless erfordert für die Redundanz in der Produktion mindestens 2 OCUs (OpenSearch Compute Units). Bei ~0,24 $ pro OCU/Stunde (in us-east-1) führt dies zu Sockelkosten von ungefähr 350 $/Monat (für ein relatives Standard-Setup) allein dafür, dass der Index existiert — selbst bei absolut null Abfrage-Traffic.
„Agents“ führen mehrere Schritte aus, um eine einzelne Benutzeranfrage zu beantworten (Denken → Suchen → Zusammenfassen). Die Auswirkung ist, dass eine einzige Benutzerfrage aufgrund dieser internen Schleifen und Denkprozesse 10x mehr Tokens verbrauchen kann als erwartet. Sie zahlen für den Input und Output jedes Zwischenschritts, was einen Multiplikatoreffekt auf Ihrer Rechnung erzeugt.
Nachvollziehbarkeit ist für Enterprise AI zwingend erforderlich, aber die Integration von Bedrock mit CloudWatch Logs ist sehr ausführlich. Es werden vollständige Prompt- und Response-Payloads protokolliert. Die Datenerfassung in CloudWatch kostet in Regionen wie us-east-1 0,50 $ pro GB, und die Speicherung schlägt mit weiteren 0,03 $ pro GB zu Buche. Anwendungen mit hohem Textgenerierungs-Volumen können problemlos Hunderte von Gigabytes an Log-Daten erzeugen, was die monatliche Rechnung stillschweigend erheblich ansteigen lässt.
Viele Teams unterschätzen die Preise von AWS Bedrock in der ersten Testphase, weil die Variablen schwer zu isolieren sind. Der Token-Verbrauch variiert stark je nach Benutzerverhalten; ein Benutzer stellt eine einfache Frage, während ein anderer ein 50-seitiges PDF zur Zusammenfassung einfügt. Darüber hinaus experimentieren Entwickler gerne: Der Wechsel von Claude Haiku zu Claude Sonnet ändert Ihre Preisstufe sofort — oft ohne dass die Finanzabteilung dies bis zum Monatsende merkt. Schließlich arbeiten AWS-Budgets auf Kontoebene, was es ohne komplexe Tagging-Strategien sehr schwierig macht zu sehen: „Wie viel hat der Marketing-Bot im Vergleich zum Engineering-Bot verbraucht?“
Trotz ihrer Komplexität funktioniert die Preisgestaltung von AWS Bedrock für bestimmte Szenarien gut. Wenn Sie bereits auf AWS standardisiert sind, lohnt sich der Preis für die „native Integration“ aufgrund der Sicherheits- und Compliance-Vorteile wie IAM und PrivateLink. Für Anwendungen mit unregelmäßigem Traffic, die selten oder unvorhersehbar genutzt werden, ist das On-Demand-Modell perfekt, da Sie nichts zahlen, wenn die App stillsteht. Es ermöglicht Projekten in der Frühphase einen schnellen Start ohne die Verwaltung von GPUs oder Kubernetes-Clustern, um den Product-Market-Fit zu validieren, bevor die Kosten optimiert werden.
Mit zunehmender Reife der AI-Workloads stoßen Teams oft an strukturelle Grenzen. Bei hohem Volumen (Millionen von Anfragen) wird der Aufschlag pro Token im Vergleich zum Besitz der eigenen Rechenkapazität teuer. Fine-Tuning auf Bedrock erfordert oft den Kauf von Provisioned Throughput, was die Einstiegshürde im Vergleich zum Fine-Tuning von Llama 3 auf einer eigenen GPU drastisch erhöht. Darüber hinaus fehlt es in Multi-Team-Umgebungen an einer feingranularen Budgetdurchsetzung auf Anwendungsebene, was zu einer Übernutzung führt, bei der ein Team das gemeinsame Budget aufbraucht.
TrueFoundry bietet ein alternatives Architekturmuster für Teams, die an die Grenzen der Unit Economics von Bedrock stoßen. Anstatt die Modell-API mit einem Preisaufschlag zu mieten, orchestriert TrueFoundry die Bereitstellung von Open-Source-Modellen (Llama 3, Mistral, Qwen) direkt auf Ihren eigenen AWS EC2- oder EKS-Clustern.
Dies eröffnet die Möglichkeit, AWS Spot-Instanzen zu nutzen. Indem Sie die Inference auf Spot-Kapazitäten ausführen — ungenutzte AWS-Rechenleistung, die mit steilen Rabatten verfügbar ist —, können Sie die reinen Inference-Kosten um 60-70% im Vergleich zu den On-Demand-Tarifen von Bedrock senken. TrueFoundry verwaltet das operative Risiko von Spot-Unterbrechungen durch die automatische Bereitstellung eines Fallbacks auf On-Demand-Instanzen, wenn Spot-Kapazität zurückgefordert wird — und garantiert so Zuverlässigkeit ohne die 6-monatige Bindung von Provisioned Throughput.
Dies ist ein sachlicher Vergleich, der sich auf die Wirtschaftlichkeit der Modellbereitstellung konzentriert.
Mit der zunehmenden Einführung von AI wird Preistransparenz für eine nachhaltige Skalierung entscheidend. Die Preisgestaltung von AWS Bedrock sollte Sie nicht zwingen, zwischen Innovation und Insolvenz zu wählen.
TrueFoundry gibt Ihnen die Kontrolle über Ihre AI-Ausgaben zurück, bietet feingranulare Transparenz für jedes Modell und die Flexibilität, Workloads auf der kosteneffizientesten verfügbaren Infrastruktur auszuführen.
Die Preisgestaltung von AWS Bedrock variiert je nach Foundation Model und Token-Nutzung. Während die Inference bei geringem Volumen erschwinglich ist, wird sie bei großem Maßstab aufgrund der Aufschläge für den verwalteten Dienst teuer. TrueFoundry ermöglicht eine bessere Kostenoptimierung, indem Modelle auf AWS Spot-Instanzen ausgeführt werden, was Ihre monatlichen Gesamtkosten im Vergleich zu den Tarifen von Bedrock erheblich senkt.
Ja, die AWS Bedrock-Kosten folgen einem Pay-as-you-go-Preismodell. Ihnen wird jede Anzahl verarbeiteter Tokens für Input- und Output-Tokens berechnet. Für intensive Generative AI-Anwendungen summieren sich diese Gebühren schnell. TrueFoundry bietet einen wirtschaftlicheren Ansatz, indem reine Rechenleistungstarife auf Ihrer eigenen Infrastruktur genutzt werden.
Die Preisgestaltung von Amazon Bedrock beinhaltet keine dauerhaft kostenlose Stufe. Während ein neues AWS-Konto allgemeine Credits bieten kann, berechnet Bedrock die Modell-Inference sofort. TrueFoundry hilft, Bedrock-Kosten zu minimieren, indem Sie günstigere Spot-Instanzen für Ihre spezifischen Anwendungsfälle und Batch-Jobs nutzen können.
Es gibt kein dediziertes Free Tier für AWS Bedrock. Benutzer zahlen für die gesamte Nutzung der Text- und Bildgenerierung. Um unvorhersehbare AWS Bedrock-Kosten zu vermeiden, wechseln Teams zu TrueFoundry, das Autoscaling und Batch-Inference nutzt, um die Ausgaben für Generative AI effektiver zu verwalten als der verwaltete Dienst.
TrueFoundry ist ein überlegenes Äquivalent zu diesem vollständig verwalteten Dienst. Es ermöglicht Ihnen, jedes benutzerdefinierte Modell (wie Mistral AI) oder ein Amazon Titan-Modell in Ihrer eigenen Cloud bereitzustellen. Im Gegensatz zu Bedrock vereinfacht es das Kostenmanagement durch die Nutzung von Spot-Instanzen und Datenautomatisierung, wodurch ein Vendor Lock-in beim Import benutzerdefinierter Modelle vermieden wird.
Es gibt keine kostenlose Version von Amazon Bedrock; Sie zahlen für den Zugriff auf jedes Foundation Model. Für einen besseren langfristigen Wert ermöglicht Ihnen TrueFoundry die Ausführung von Open-Source-Modellen mit Prompt Caching und Modell-Distillation auf Ihrer eigenen Hardware, was die Einstiegshürde für die Einführung von Generative AI drastisch senkt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















