


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
يظهر Bifrost في كل قائمة تقريبًا لـ "بوابات AI" في عام 2026، وعادةً ما يكون مجاورًا لكلمتي الأسرع ومفتوح المصدر. لا يصمد أي من الادعاءين أمام قراءة مباشرة لأرقام البائع نفسه، لذا قمنا بالتحقق من ذلك بالطريقة الصعبة: قمنا باختباره بأنفسنا على بيئة محددة بسعة 1 vCPU.
تغطي هذه المقالة ما تصمد أمامه ادعاءات أداء Bifrost تحت القياس الفعلي — على بيئة اختبار ثابتة بسعة 1 vCPU / 2 GB، وهو نفس المعيار الذي نطبقه على كل بوابة في هذه المقارنة.
هذا هو القسم الذي يجب أن يجيب عليه كل ادعاء لـ "أسرع بوابة".
رقم البائع: ~5,000 RPS عند متوسط نفقات إضافية يبلغ ~11 ميكروثانية — على t3.xlarge (4 vCPU)، مقابل upstream وهمي. قبل مقارنة ذلك بأي شيء، اقرأ ما يقيسه بالفعل. وفقًا لمصدر Bifrost نفسه، يتم أخذ رقم الميكروثانية بدون معالجة طلبات HTTP وتجميع JSON — لذا فهو الوقت المستغرق داخل خط الأنابيب الداخلي للبوابة، وليس زمن الانتقال الصافي المضاف إلى طلب المتصل. يضعه نفس المصدر عند 59 ميكروثانية على t3.medium، لذا فهو يتراجع بالفعل بمقدار 5 مرات تقريبًا على جهاز أصغر. كما أنه متوسط، وليس نسبة مئوية، على 4 أضعاف الحوسبة التي تمنحها معظم الفرق لـ gateway container بالفعل.
لا شيء من هذا يجعل الرقم غير صادق؛ إنه يجيب فقط على سؤال مختلف عن "كيف يبدو p99 الخاص بي؟" كل ما يلي هو الرقم الآخر: زمن الانتقال المضاف من البداية إلى النهاية لأحجام حمولة حقيقية وموثقة، مع تضمين التجميع وHTTP — الضريبة الكاملة التي يدفعها المتصل لكون البوابة في المسار. الميكروثانية والميلي ثانية كلاهما صحيحان هنا، لأنهما يقيسان أشياء مختلفة.
لقد قمنا ببناء بيئة اختبرا ثابتة (fixed harness) — تتكون من 1 vCPU، و2 GB RAM، وحمل دائر مفتوح (open-loop load)، وهو نفس المعيار الذي نطبقه على كل gateway في هذه المقارنة — وقسنا أداء Bifrost مباشرةً عبر ثلاثة أحجام من الحمولة (payload): صغيرة (200 input / 100 output tokens)، ومتوسطة (2,000/500)، وكبيرة (20,000/1,000). كما تم تثبيت mock upstream خلف Bifrost لضمان أن أي تباطؤ يعود إلى Bifrost نفسه وليس بسبب تذبذب بيئة الاختبار: زمن "تفكير" 50 ms + 50 ms حتى أول token للمكالمات غير التدفقية (non-streaming)، ونطاق تدفق ثابت بقدر 500 ms للمكالمات التدفقية (streaming) — وهذا هو الحد الأدنى البالغ ~55 ms و~530–627 ms الذي ستراه في الرسوم البيانية أدناه، والموجود عند كل حجم حمولة.
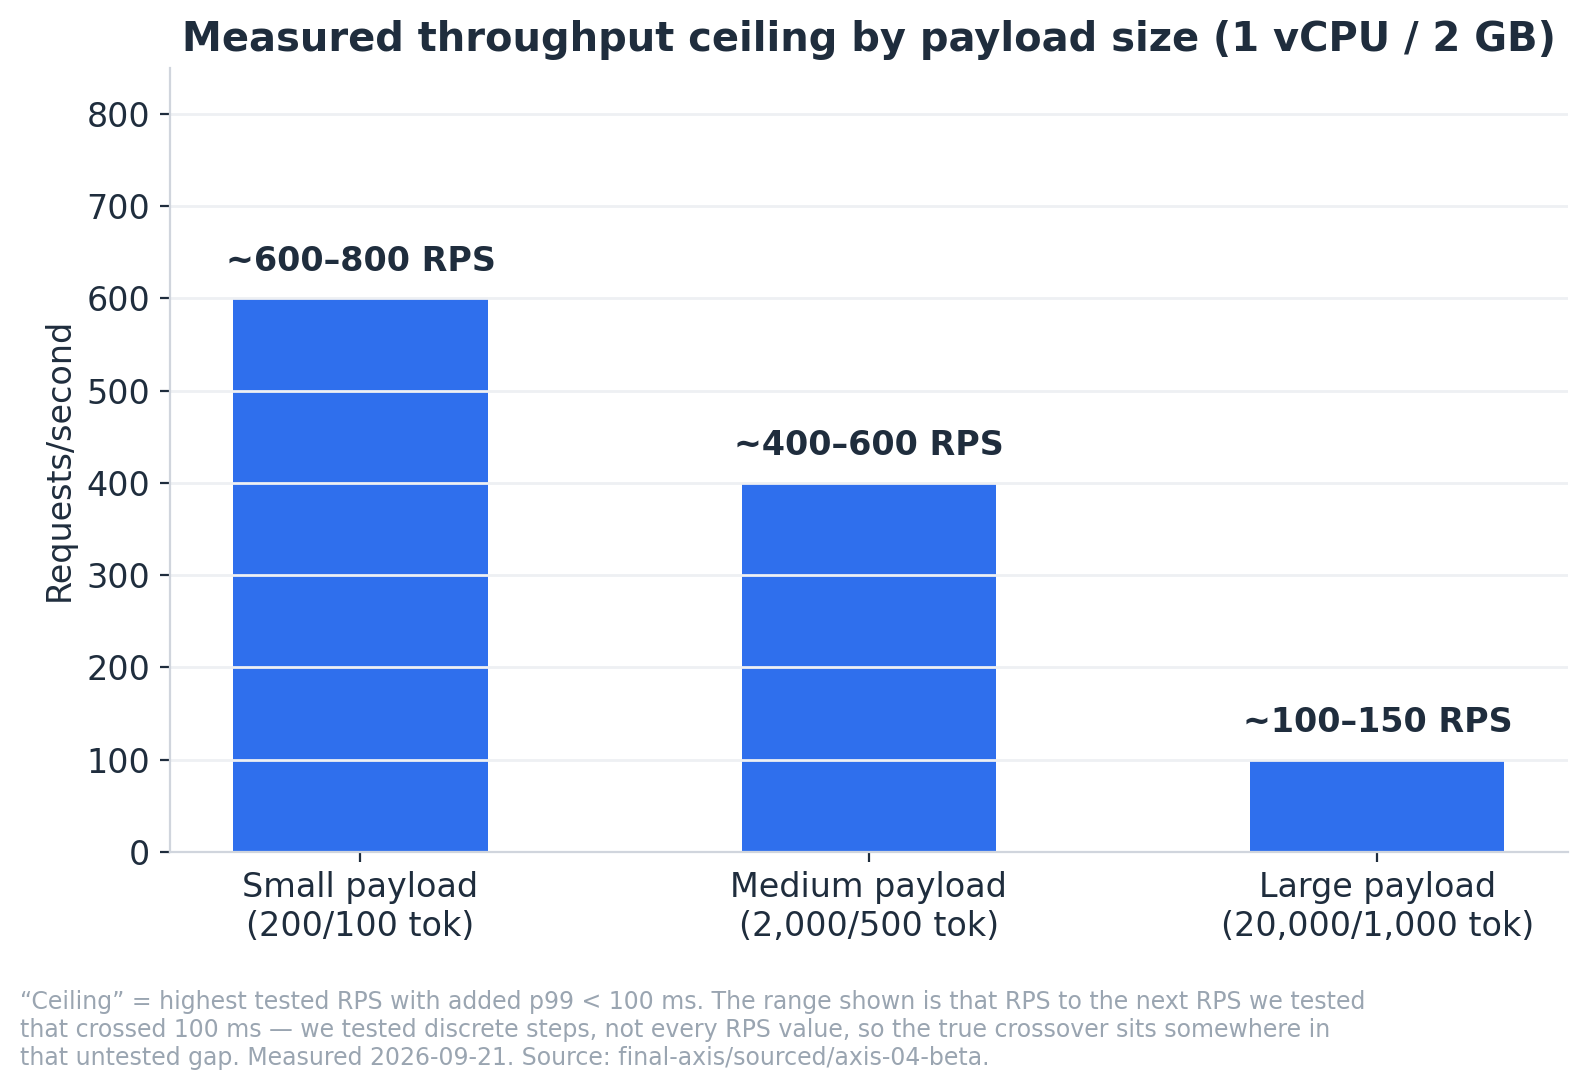
الحدود القصوى الحقيقية للإنتاجية، عند ميزانية زمن استجابة إضافي تبلغ 100ms: حوالي 600–800 RPS للحمولات الصغيرة، و~400–600 للمتوسطة، و~100–150 للكبيرة. هذه عبارة عن نطاقات وليست أرقامًا دقيقة عن قصد — فقد اختبرنا خطوات RPS منفصلة، وليس كل قيمة، لذا فإن كل حد أقصى هو فعليًا "آخر RPS تأكدنا من جودته، وصولاً إلى الرقم التالي الذي تأكدنا من عدم مناسبته." أسفل الحد الأدنى لتلك النطاقات، تدفع الطلبات الوسطية (median) ما بين 2–6 ms للـ gateway. هذا الرقم المتوسط هو الأكثر ملاءمة في هذا القسم ولكنه الأقل فائدة لتخطيط السعة (capacity planning): فهو يركد تقريبًا مع الحمل — من 2.1 إلى 3.1 ms للحمولات الصغيرة عبر نطاق 60x من الحركة المعروضة — لذا يظل مطمئنًا حتى اللحظة التي ينهار فيها الـ gateway. الرقم الذي يتحرك فعليًا هو p99. حيث يرتفع p99 المضاف من +5.6 ms (صغيرة)، و+7.5 ms (متوسطة)، و+15.2 ms (كبيرة) عند 10 RPS إلى +60 ms للصغيرة عند 600 RPS، و+75 ms للمتوسطة عند 400، و+41 ms للكبيرة عند 100 فقط — ثم يتجاوز ميزانية 100 ms عند الخطوة التالية مباشرة التي اختبرناها في جميع الحالات الثلاث. فوق الحد الأعلى، لا تتدهور أي من أحجام الحمولات الثلاثة بشكل سلس، وكل منها ينكسر بطريقة مختلفة. إليك كل حمولة جنباً إلى جنب، الـ gateway مقابل قياسه المباشر الحقيقي مقابل الـ mock (وليس خط أساس تقريبي واحد مشترك بين الأحجام — الصغيرة والمتوسطة والكبيرة لكل منها حد أدنى مباشر مختلف بحق يتراوح بين ~55–62 ms، ويوضح الرسم البياني الرقم الفعلي لكل منها):
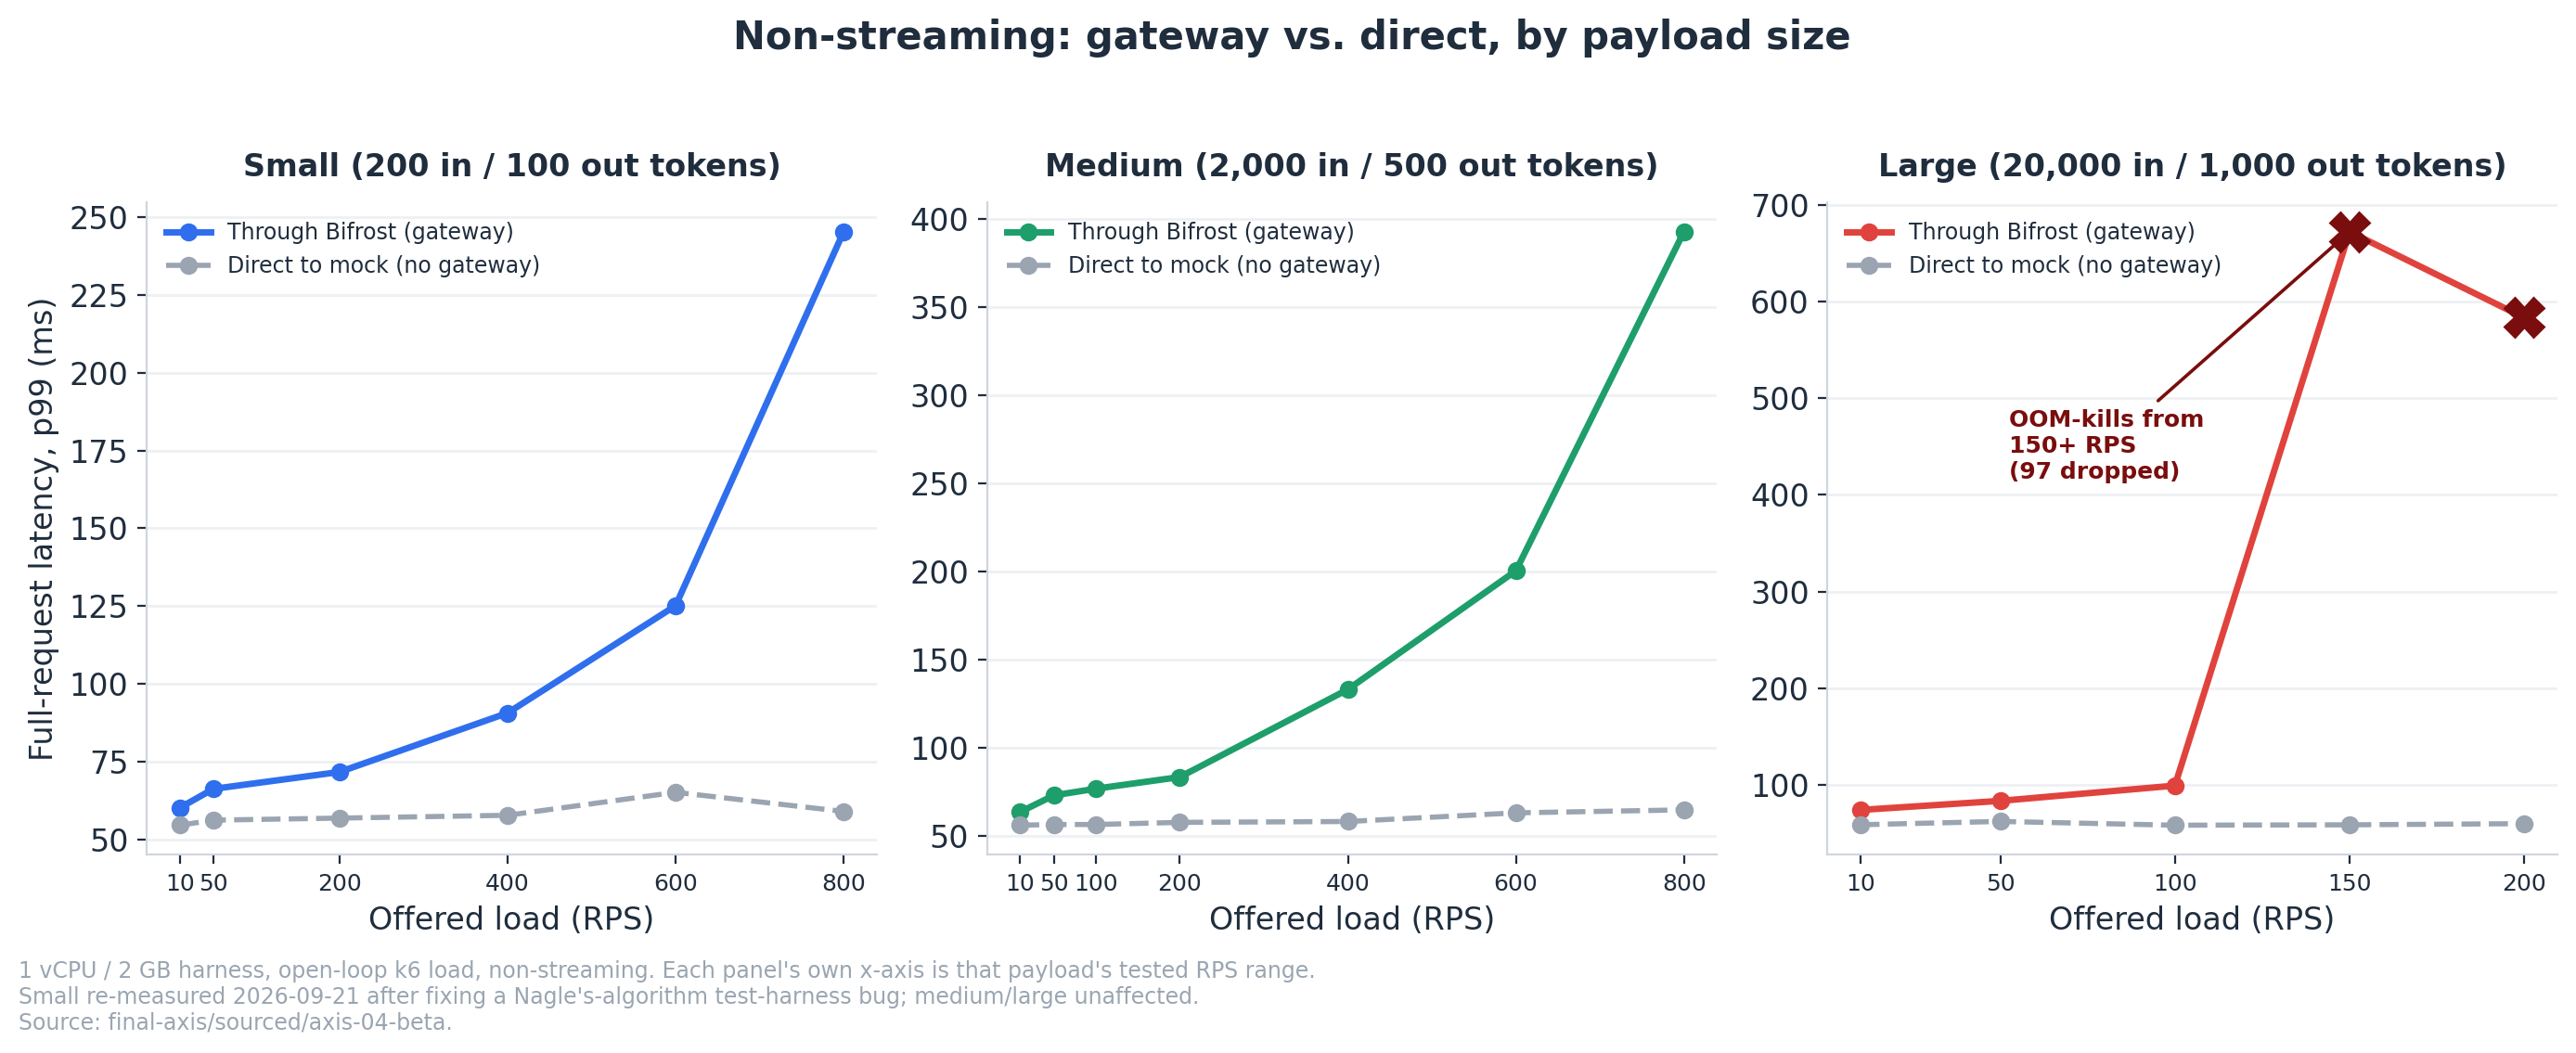
تتبع الحمولات الصغيرة والمتوسطة نفس الشكل — استقرار، ثم ذيل p99 متصاعد — ولكن عند معدلات RPS مختلفة. يبدأ صعود الحمولة الصغيرة حوالي 400–600 RPS؛ بينما يبدأ صعود المتوسطة في وقت أسبكر لكل طلب، لكن جدارها الأقوى يقع في مكان أبعد (400+ RPS) لأن مدخلات 2,000-token الخاصة بها تبقي التكلفة لكل طلب أعلى طوال الوقت. أما الحمولة الكبيرة فلا تتصاعد تدريجيًا على الإطلاق: فهي مستقرة من 10 إلى 100 RPS، ثم تسقط بشكل حاد عند 150 RPS، حيث تبدأ الـ pod بالتعرض لإيقاف OOM-killed أثناء التشغيل (61 طلبًا مفقودًا عند 150 RPS، و97 طلبًا إضافيًا عند 200). هذا ليس منحنى انتظار (queueing knee) مثل الحمولات الصغيرة/المتوسطة — بل هو جدار موارد صلب، ويظهر كقفزة شبه عمودية بدلاً من منحنى.
يواجه البث التدفيقي (Streaming) العقبة نفسها، ولكن بشكل أسرع، لأن كل بث مفتوح يحتفظ بذاكرته المؤقتة (buffers) لفترة أطول — النتيجة واحدة، البوابة (gateway) مقابل الاتصال المباشر، لكل حمولة (payload):
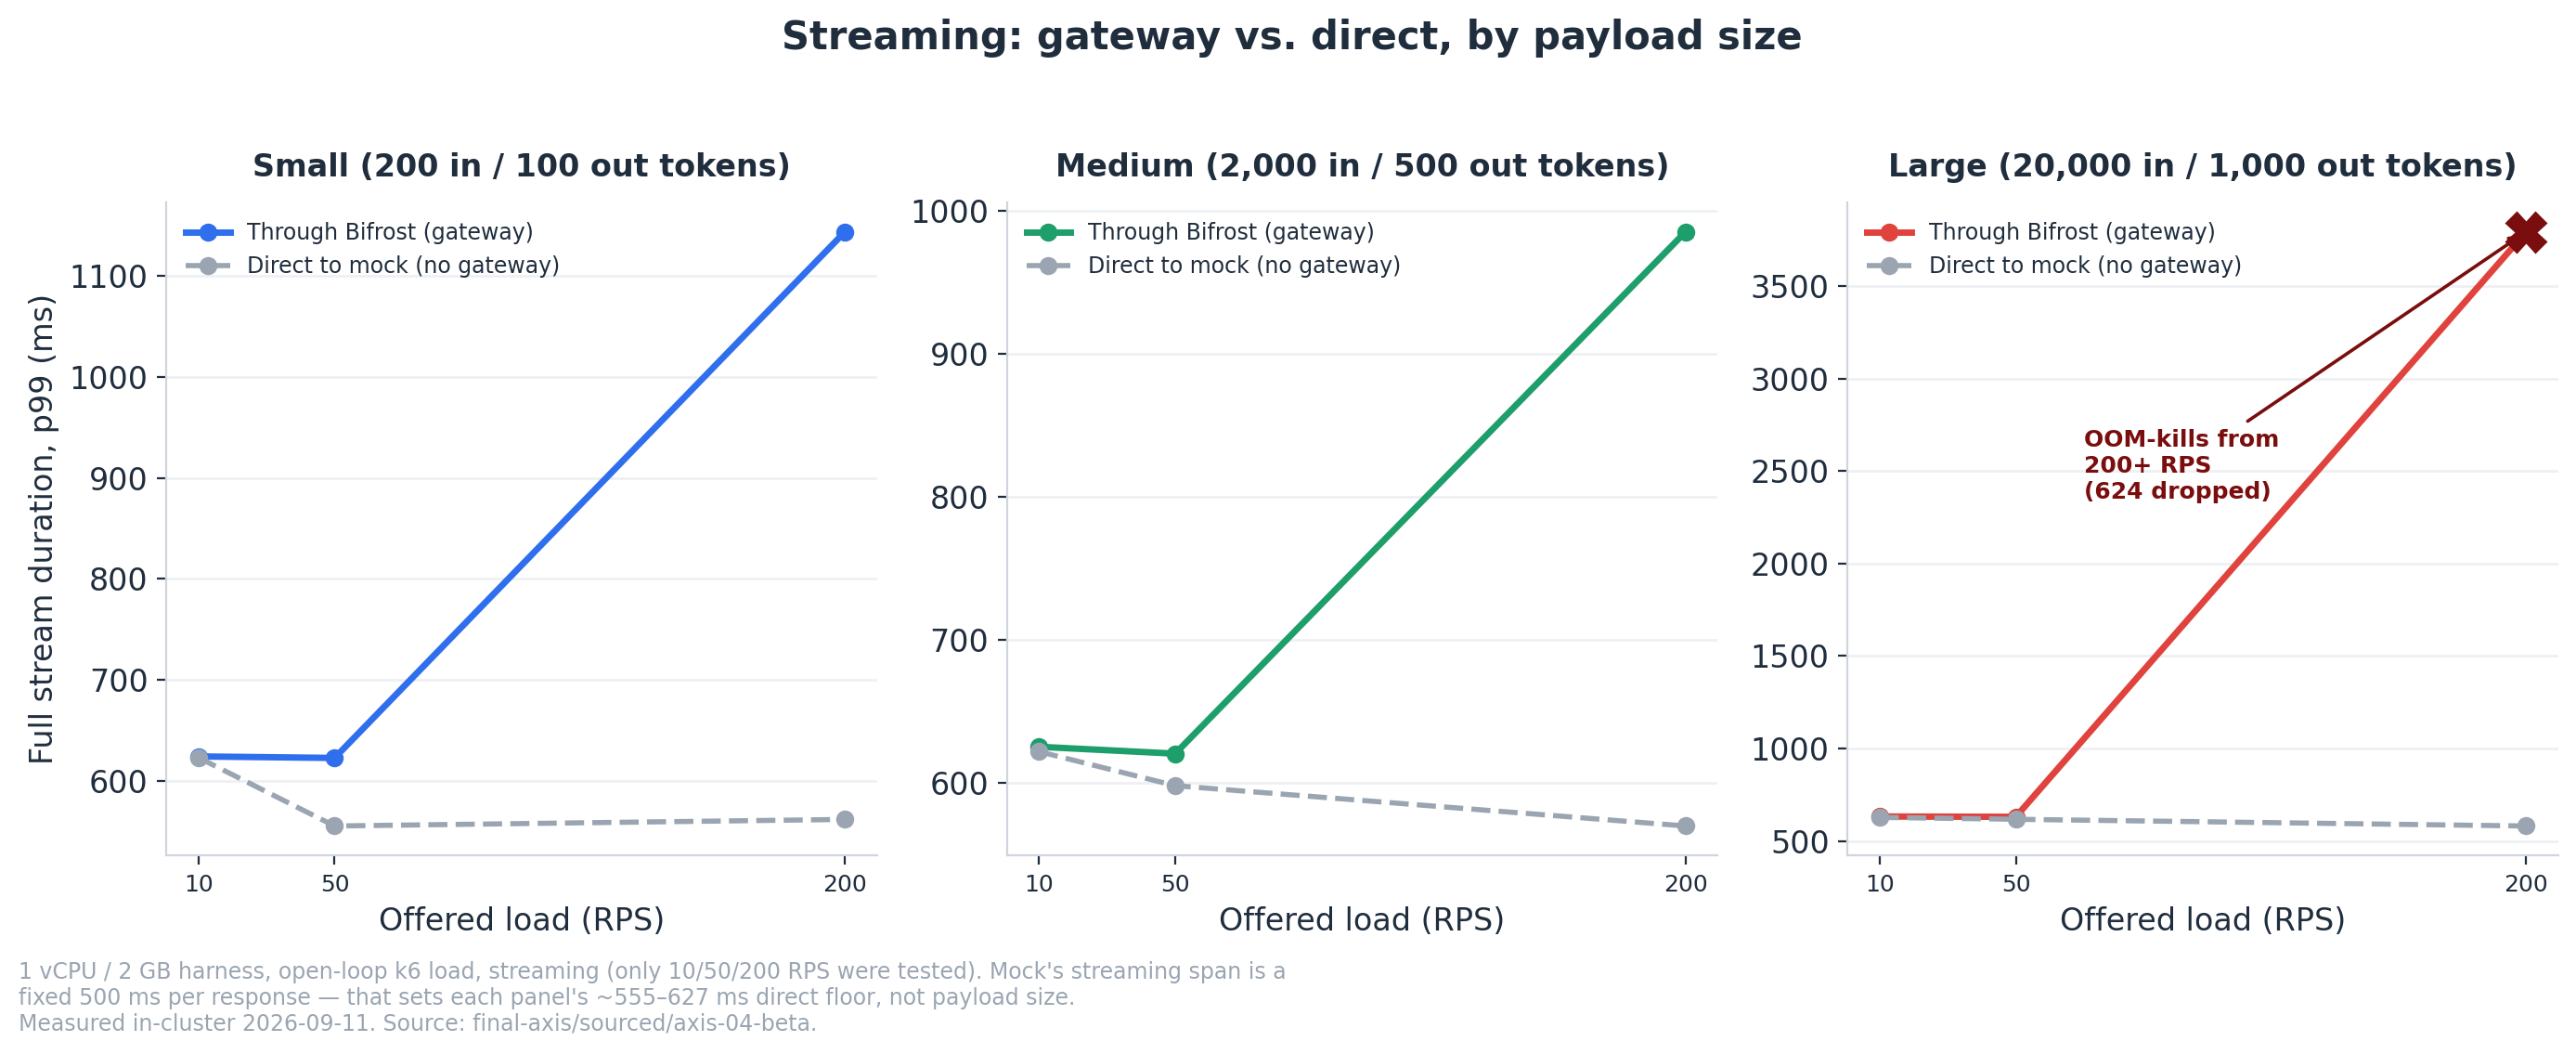
يتتبع البث التدفقي الصغير والمتوسط حدهما الأدنى المباشر الخاص البالغ ~555–627 ملي ثانية بدقة حتى 50 RPS، ثم يبدآن في الارتفاع بحلول 200 RPS (يصل p99 للصغير إلى ~1.14 ثانية، والمتوسط إلى ~985 ملي ثانية — وكلاهما بسبب الانتظار في الصف، وليس OOM). أما البث التدفقي الكبير فلا يحصل على هذا الارتفاع التدريجي أيضاً: بحلول 200 RPS ينهار بسبب OOM في منتصف التشغيل، مما يؤدي إلى سقوط 624 من أصل 12,001 تدفقاً معه وتضخم p99 إلى ~3.8 ثانية. إذا كان عبء العمل لديك يقوم بيبث مستندات كبيرة، فإن 200 RPS على vCPU واحد ليست فئة "أبطأ" — بل هي فئة "تنهار بالكامل".
ومع ذلك، فإن مدة البث الكاملة ليست هي الرقم المهم إذا كانت واجهة المستخدم الخاصة بك تحتاج فقط إلى ظهور الرمز المميز (token) الأول — لذلك قمنا بقياس ذلك بشكل منفصل، باستخدام مسبار غير متزامن مقترن يقيس وقت الرمز المميز الأول الفعلي للمحتوى، وليس TTFB الخاص بـ k6 (وهو غير صالح لـ SSE هنا، لأن المحاكي يقوم بتفريغ الرؤوس قبل وجود أي رمز مميز):
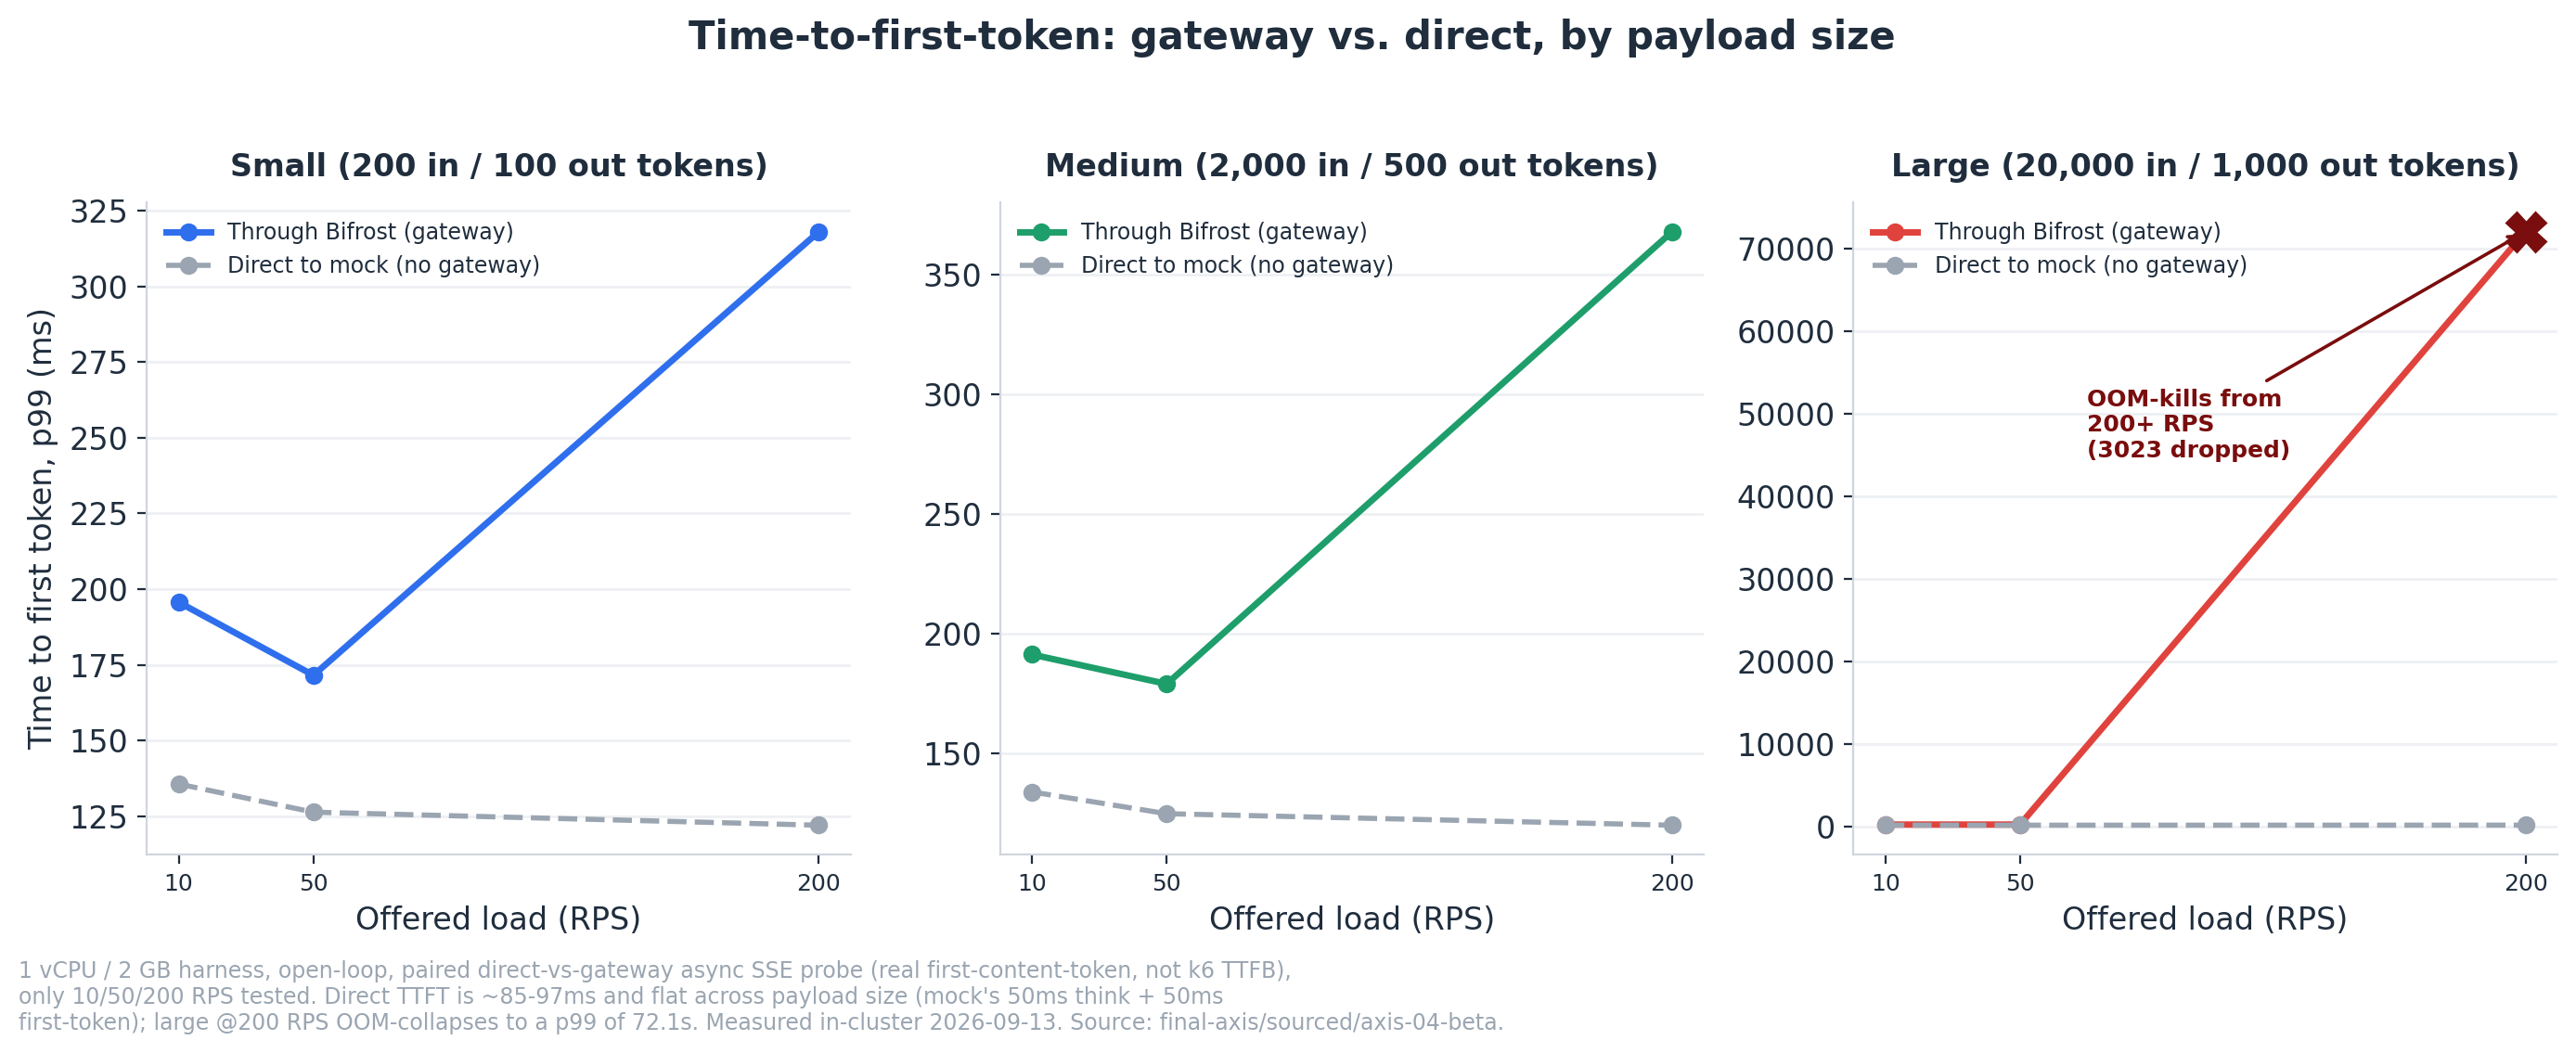
يبلغ TTFT المباشر ~85–97 ملي ثانية ومستقر عبر جميع أحجام الحمولة الثلاثة — مما يؤكد أن طول المدخلات لا يغير وقت الرمز المميز الأول، لذا فإن كل شيء فوق ذلك الحد الأدنى هو تكلفة إعداد البث التدفقي الخاصة بـ Bifrost لكل طلب. هذه التكلفة المضافة هي ~27–46 ملي ثانية ومستقلة عن الحجم عند 10–50 RPS (الحجم الكبير عند 10 RPS يضيف +46 ملي ثانية، والصغير عند 10 RPS يضيف +43 ملي ثانية — نفس الترتيب، حمولة مختلفة). عند 200 RPS، لا تزال الوسائط للصغير والمتوسط ثابته (+57 إلى +71 ملي ثانية)، لكن الذيل ينفجر — يصل p99 المضاف إلى +196 إلى +248 ملي ثانية — وتفشل 10–13% من تدفقات البوابة بشكل مباشر، وهو نفس انحناء الانتظار في الصف الظاهر في مخطط البث الكامل أعلاه. الحجم الكبير عند 200 RPS لا يعاني من مشكلة في الذيل، بل يعاني من انهيار: يتم تقديم 128.8 فقط من أصل 200 RPS معروضة، ويتضخم TTFT p99 إلى 72.1 ثانية، وتفشل 3,023 من أصل 12,001 تدفقاً — جدار OOM، وشوهد هذه المرة من جانب الرمز المميز الأول بدلاً من جانب الاستجابة الكاملة.
وتحت اندفاع حمولة زائدة متعمدة، ظل كلاً من وضعي Bifrost آمنين من حيث الذاكرة: الوضع "الحاجز" يخدم الجميع في النهاية (انتظر أبطأ طلب ~5 ثوانٍ)، والوضع "الإسقاط" يفشل بسرعة مع خطأ 503 نظيف.
سقف الحمولة الكبيرة له سبب مختلف تماماً عن الحمولات الصغيرة/المتوسطة. إنه ليس بسبب CPU — وأوضح طريقة لرؤية ذلك هي النظر إلى الذاكرة و CPU بشكل منفصل، مقسمة حسب حجم الحمولة والحمل المعروض، وليس مجرد رقم ذروة واحد لكل حمولة:
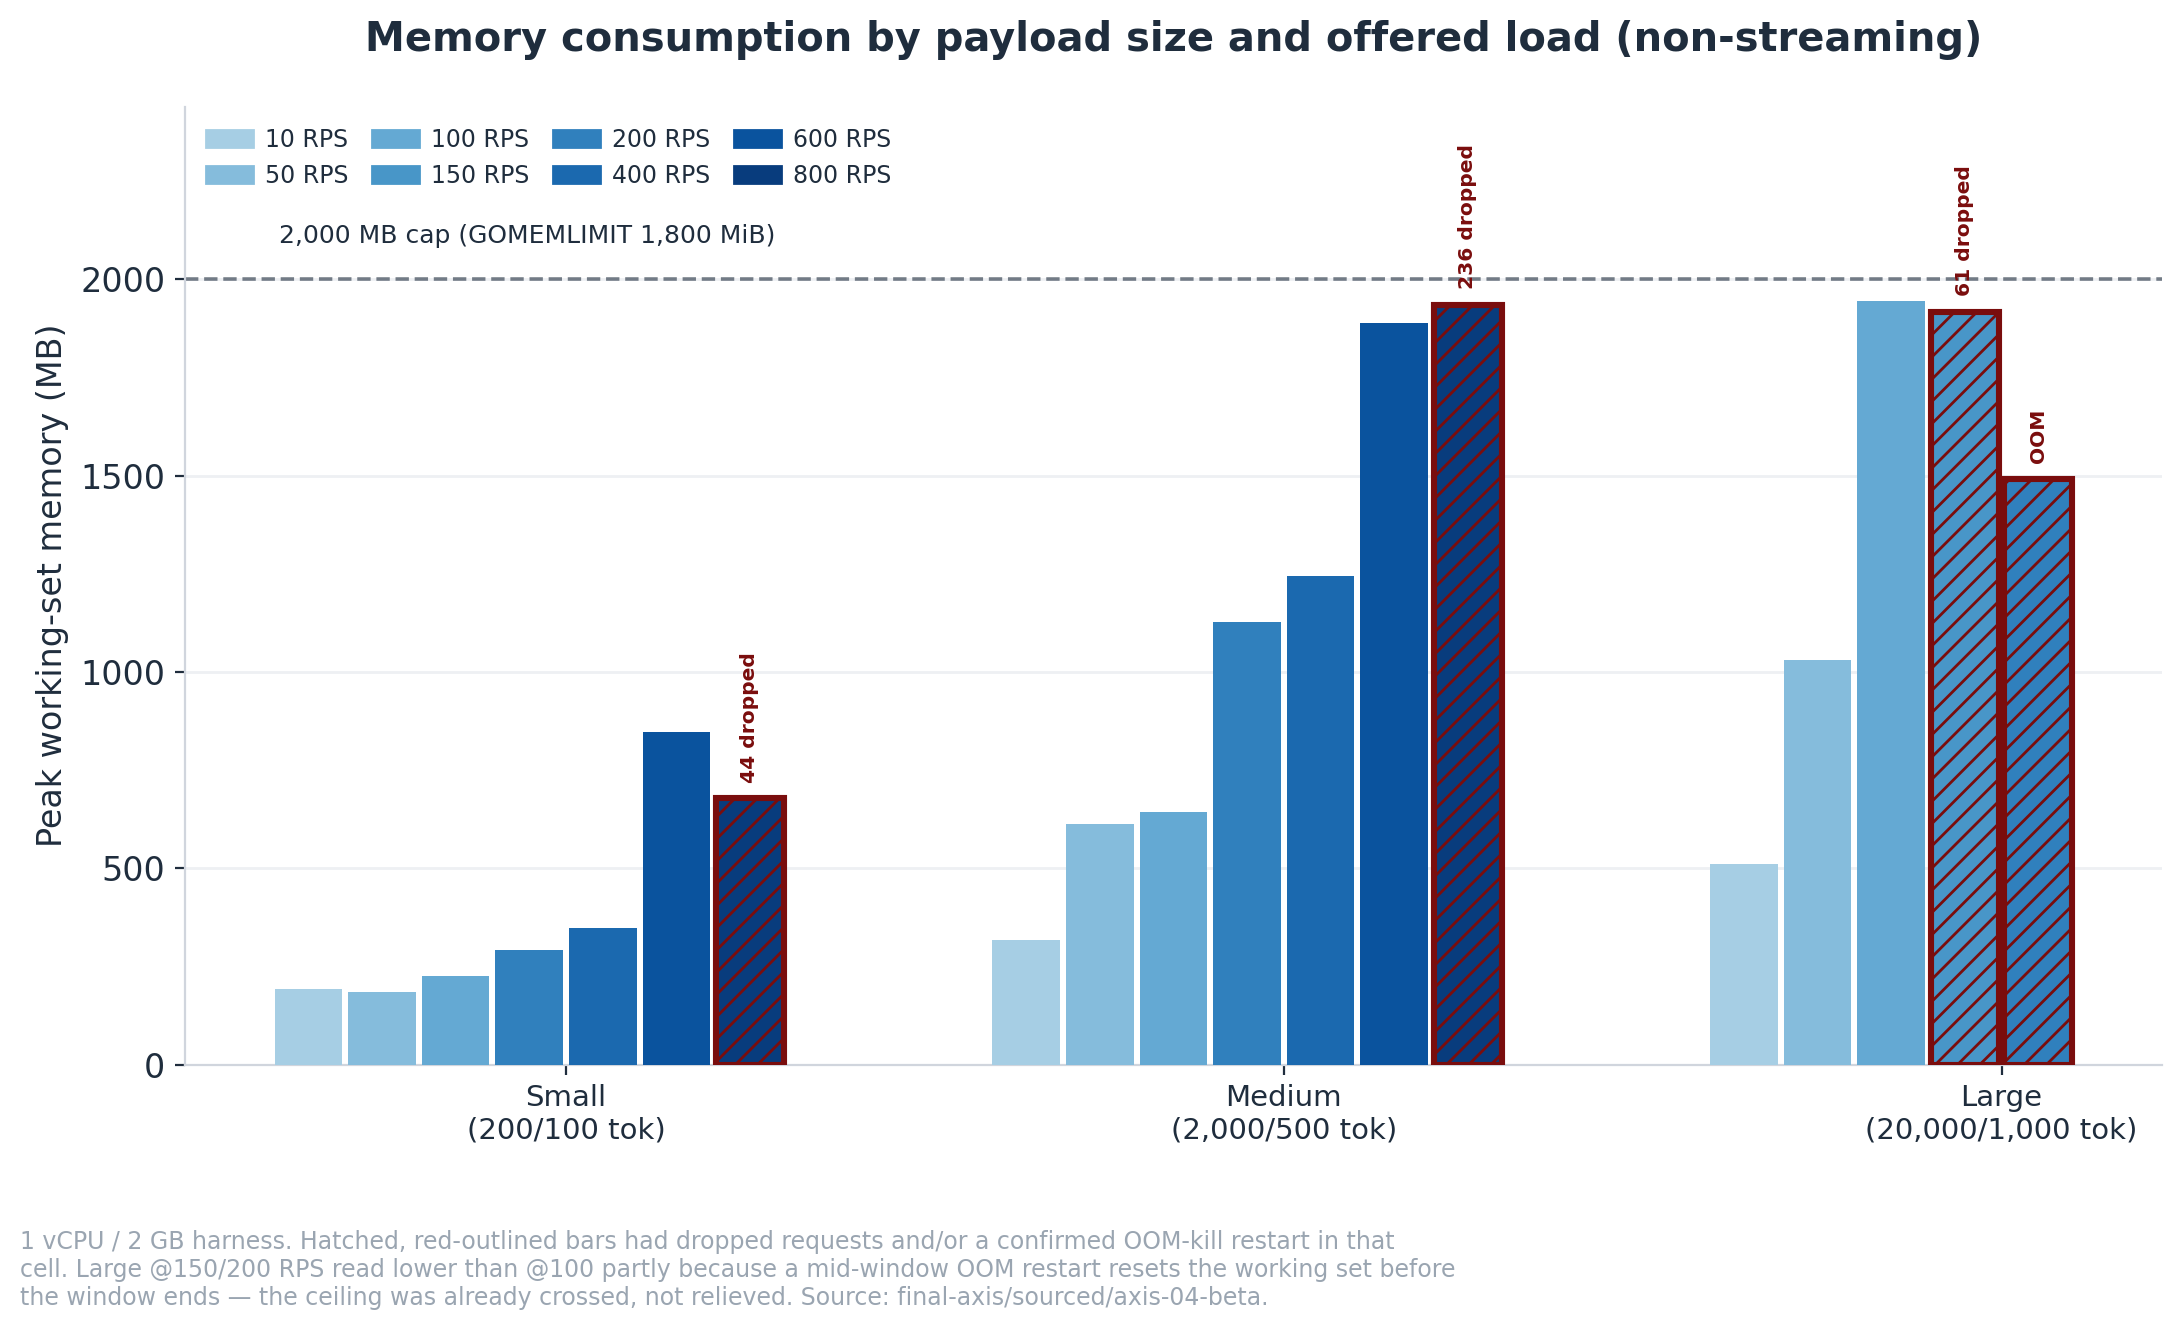
ترتفع الحمولات الصغيرة والمتوسطة تدريجياً ولا تقترب أبداً من الحد الأقصى البالغ 2,000 MB حتى عند أعلى معدل RPS تم اختباره (848 MB و 1,935 MB على التوالي). الحجم الكبير قصة مختلفة: فهو بالفعل عند 1,944 MB — 97% من الحد الأقصى — بحلول 100 RPS، أي قبل 50–700 RPS من "سقفه" المقاس. الأشرطة المحددة والمظللة باللون الأحمر (الكبير عند 150، 200) تقرأ في الواقع أقل من شريط 100 RPS، وهو ما يبدو وكأنه تعافٍ ولكنه ليس كذلك — إن إيقاف OOM-kill في منتصف النافذة يعيد تشغيل الـ pod ويعيد ضبط عداد مجموعة العمل قبل انتهاء نافذة القياس، لذا فإن تلك الأشرطة تقلل من حساب الذروة الحقيقية، ولا تبالغ فيها.
يخبرنا CPU بالقصة المعاكسة تماماً، وهذا هو المغزى بالتحديد:
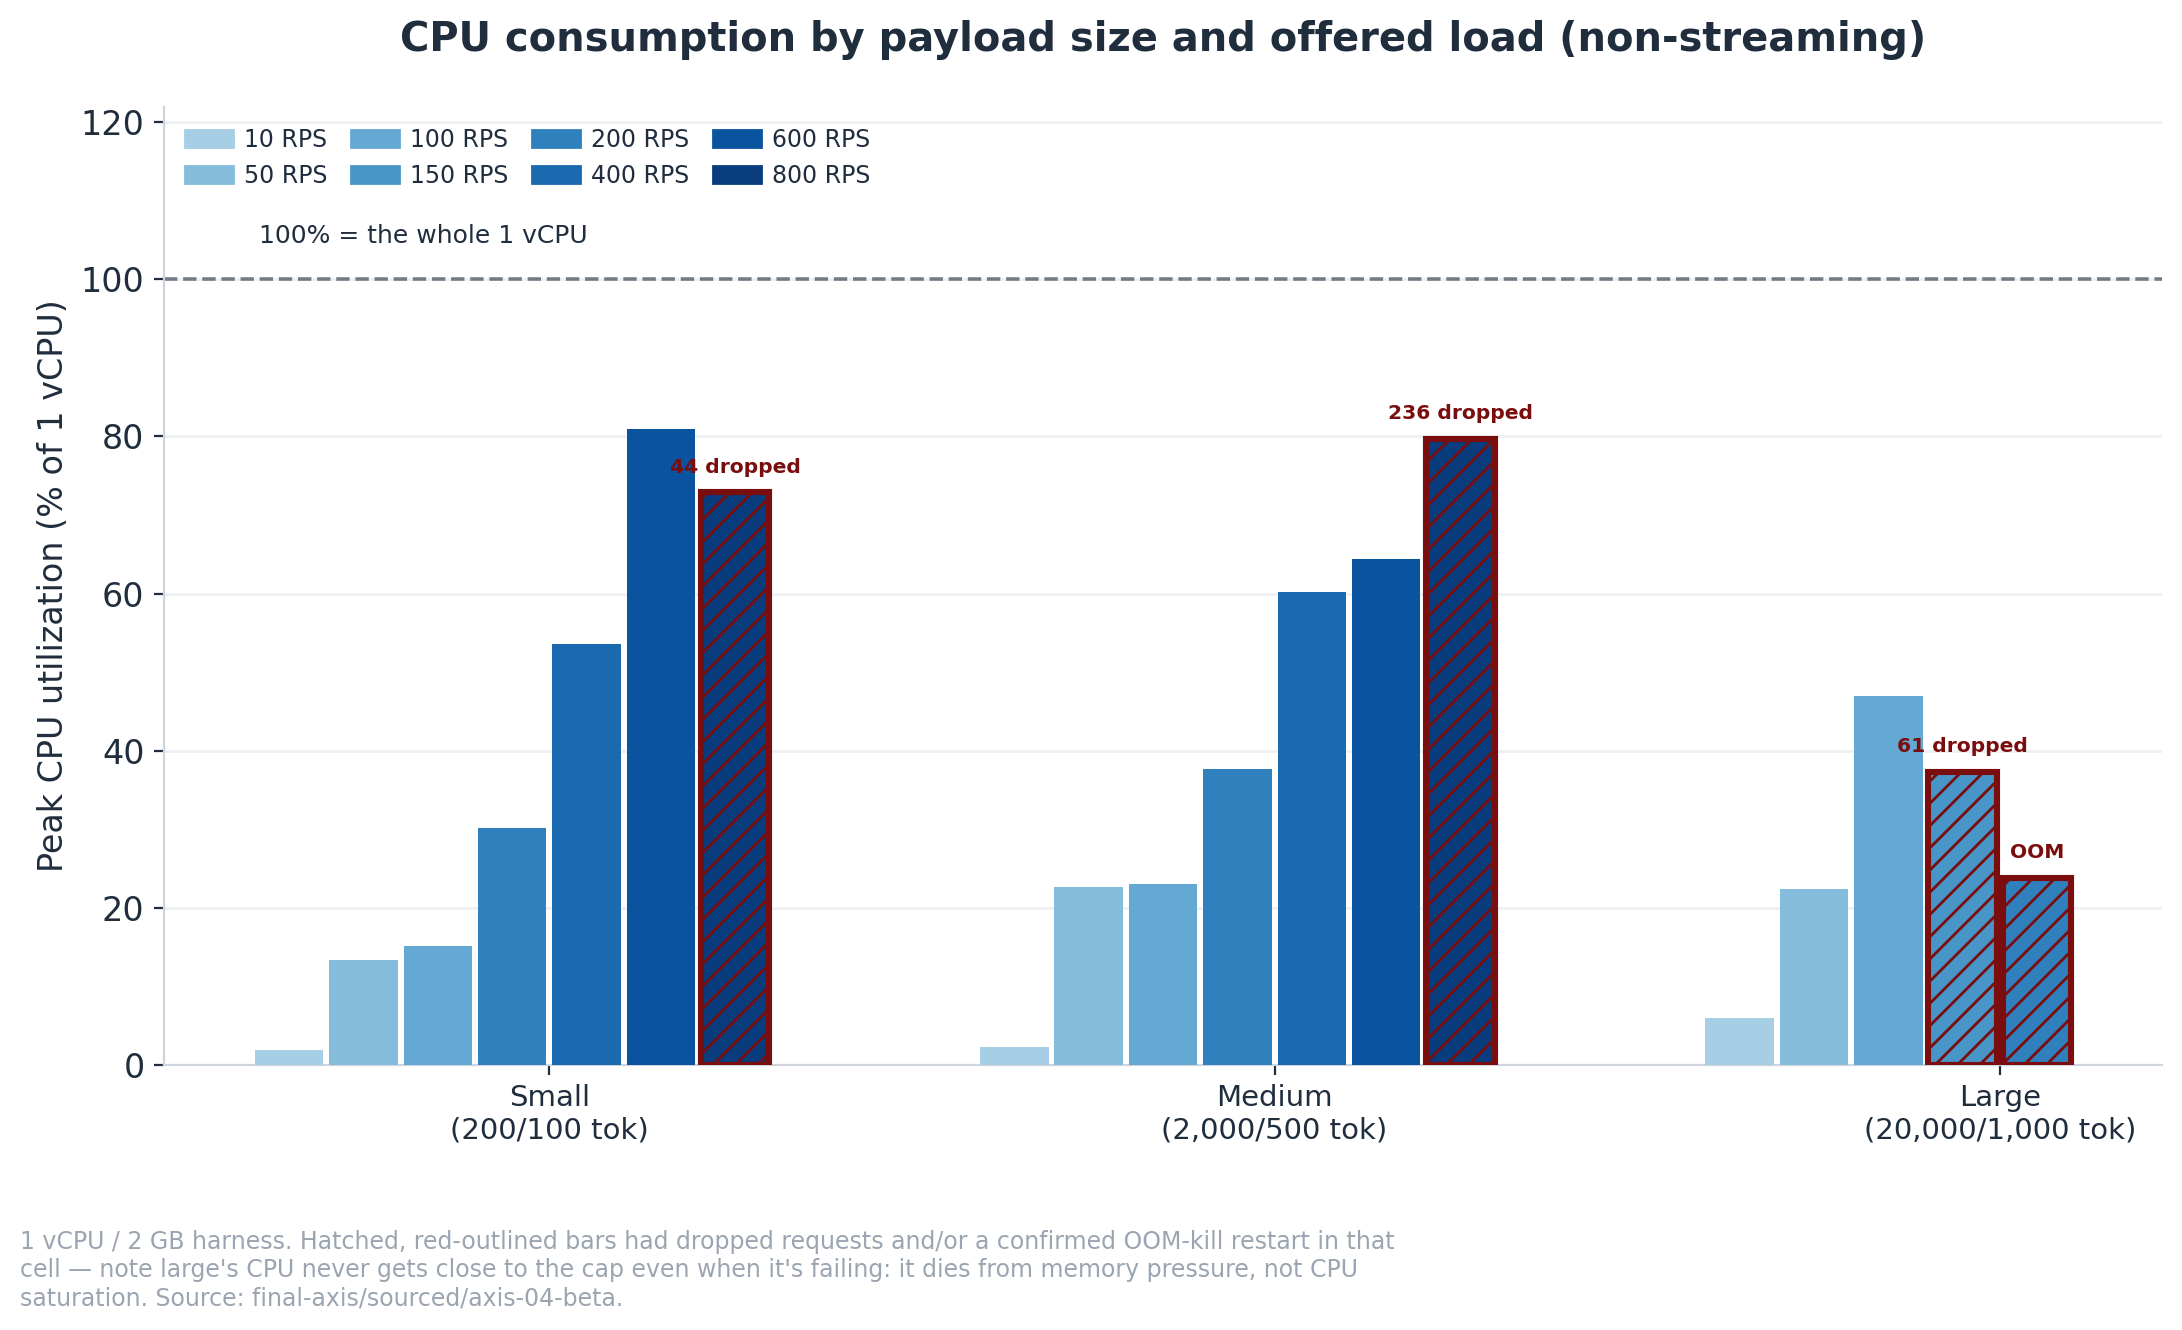
ترتفع الحمولات الصغيرة والمتوسطة إلى نطاق 73–80% عند أعلى معدل RPS لها — وهي مقيدة حقاً بـ CPU، مما يضغط على vCPU الواحد بشدة. أما الحجم الكبير فلا يفعل ذلك أبداً: حتى في الخلايا التي يسقط فيها الطلبات بنشاط ويتعرض لإيقاف OOM-killed (المحددة والمظللة باللون الأحمر)، فإن ذروة CPU تصل إلى 37% و 24%. الحجم الكبير لا يفشل بسبب نفاد مساحة CPU — بل يفشل بسبب نفاد الذاكرة، بينما كان لدى CPU سعة فائضة. إذا كان عبء العمل لديك عبارة عن مستندات طويلة، فهذا هو الرقم الذي يجب التخطيط بناءً عليه، وليس عدد vCPU.
تحول إصابة التطابق التام المكالمة التي تستغرق ~59 ملي ثانية إلى ~4 ملي ثانية. أما التخزين المؤقت الدلالي — الذي يلتقط تكراراً مصاغاً بشكل مختلف لنفس السؤال — فيكلف ضريبة تضمين (embedding) حقيقية ولكنه يظل أفضل من مكالمة جديدة بالنصف:
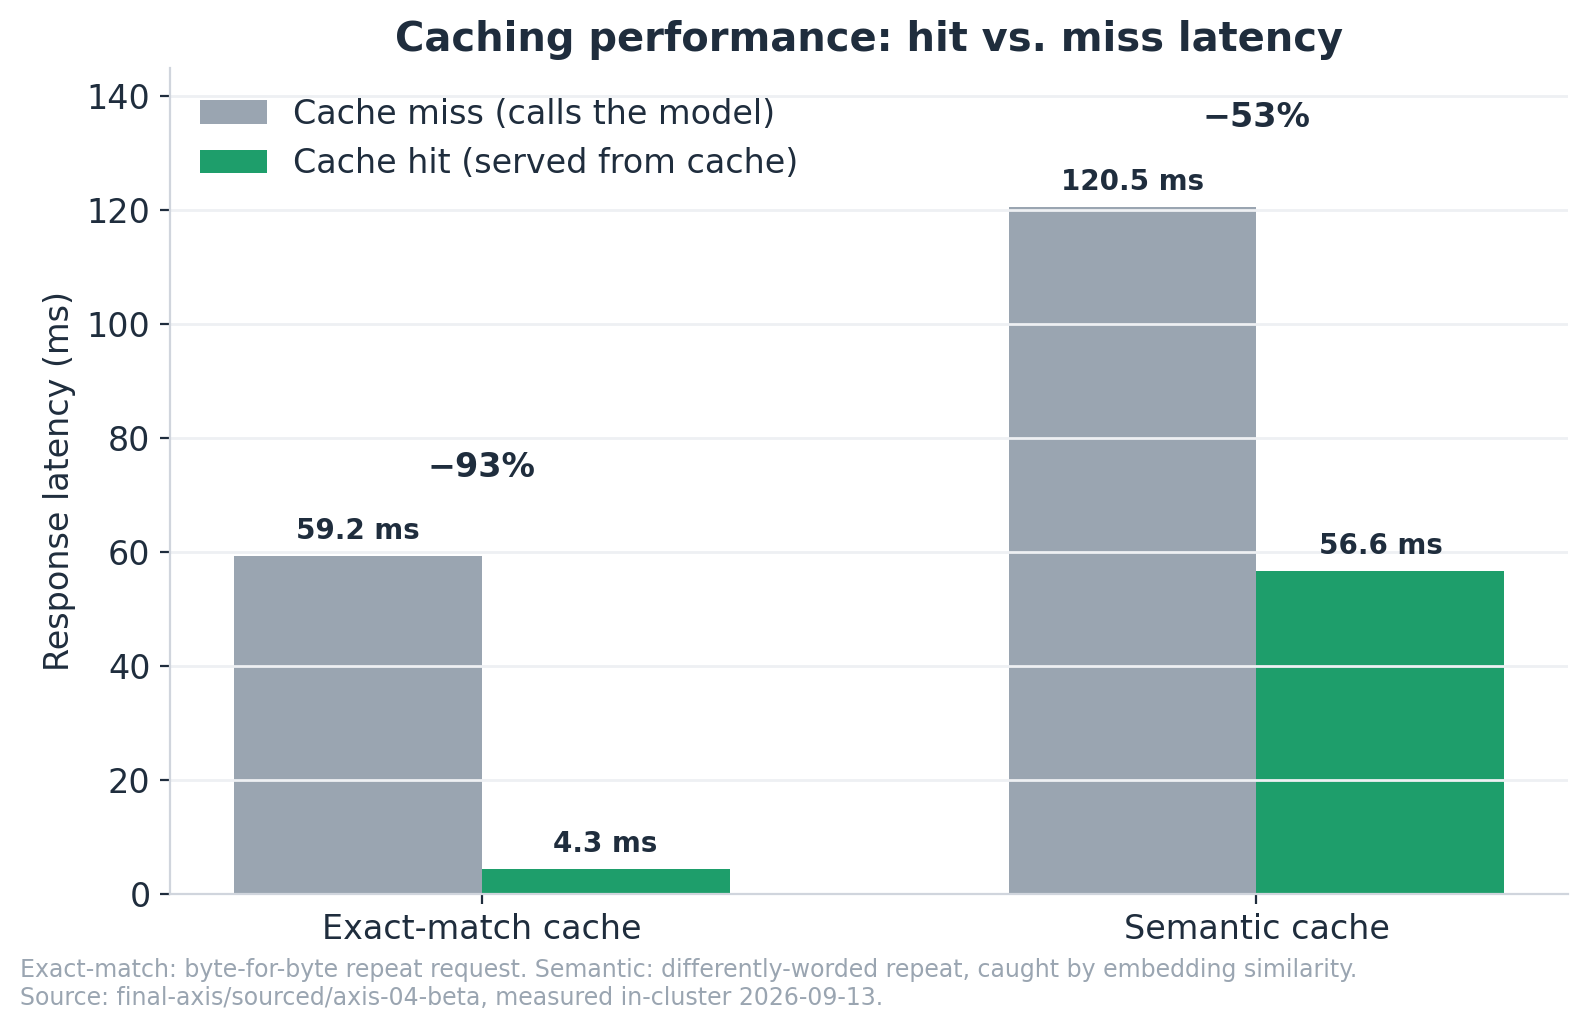
لا تعد أي من النتيجتين مفاجئة في حد ذاتها — فمن المفترض أن يكون التخزين المؤقت أسرع من استدعاء النموذج، وهو كذلك بالفعل. الأرقام هنا هي مجرد قياس عملي لمقدار السرعة بالضبط: 93% لإصابة التطابق التام، و 53% للإصابة الدلالية بمجرد دفع تكلفة التضمين.
رقمان إضافيان قبل الانتقال: البداية الباردة تستغرق وسيطاً قدره 8.7 ثانية، و 8.2 من تلك الثواني هي إعادة تنزيل إلمزامية للكتالوج عند كل إعادة تشغيل في إعداد حاويات نموذجي — يمكن إصلاحها باستخدام تخزين دائم، ولم يتم إعادة اختبارها بشكل مستقل هنا.
ملاحظة شفافية واحدة بشأن الأرقام أعلاه: في خلية الحمولة الصغيرة تحديداً، اكتشفنا وقحمنا خطأً في منصة الاختبار الخاصة بنا (تفاعل شبكي لخوارزمية Nagle كان يجعل خط الأساس الخاص بنا مليئاً بالضوضاء) — بعد إصلاحه، ارتفع سقف الحمولة الصغيرة لـ Bifrost في الواقع إلى الأعلى، من ~400 إلى ~600–800 RPS. نذكر هذا لأنه من أنواع الأشياء التي يسهل الوقوع في خطئها عند اختبار أي بوابة، بما في ذلك Bifrost، ونفضل إظهار عملنا بدلاً من إخفاء التصحيح.
على جهاز واحد، تكون التكلفة الإضافية لـ Bifrost منخفضة بحق عند الوسيط: 2–6 ملي ثانية بالإضافة إلى مكالمة صاعدة تستغرق ~55 ملي ثانية، ومستقرة عبر أحجام الحمولة ومستقرة تقريباً عبر الحمل. هذا هو الإصدار القابل للدفاع عنه لادعاء "أسرع بوابة"، وهو يستحق شيئاً — كحصة من مكالمة LLM حقيقية، فإنه يؤول إلى مجرد ضوضاء. لكن الذيل قصة مختلفة. p99 المضاف حساس للحمل، حيث يصل إلى +41 إلى +75 ملي ثانية عند الأسقف التي قسناها، والحمولات الكبيرة لا تتباطأ تدريجياً بقدر ما تتوقف: يتم إنهاؤها بـ OOM-killed عند 150 RPS، وتسقط الطلبات. يعمل التخزين المؤقت كما هو معلن عنه (تخفيضات في زمن الانتقال بنسبة 93% و 53%، تم قياسها). يصف رقم البائع البالغ 5,000 RPS جهازاً أكبر وعبء عمل مختلفاً عما تشغله معظم الفرق. لذا بالنسبة لعقدة واحدة: السرعة المتوسطة ليست هي المشكلة — بل زمن الانتقال في الذيل تحت الحمل، والمساحة المتاحة للذاكرة في حركة المرور الكثيفة المستندات.
السؤال الأصعب هو ماذا يحدث عندما تشغل أكثر من عقدة واحدة. يجب على بوابة الإنتاج أن تتوسع أفقياً، وتتقلص، وتتحمل موت pod دون أن يلاحظ أحد. في الإصدار مفتوح المصدر، هذا هو المكان الذي تصبح فيه الأمور صعبة. لا تنتشر تغييرات التكوين مباشرة عبر النسخ المماثلة؛ النمط الموثق هو ملف تكوين مشترك بالإضافة إلى إعادة التشغيل. لذا فإن كل تغيير في التوجيه أو تدوير المفاتيح أو تحديث الميزانية يتحول إلى نشر منسق عبر pods البوابة الخاصة بك بدلاً من إعداد تقوم بتبديله. أضف لوحة تحكم إدارية مفتوحة لأي شخص يمكنه الوصول إليها حتى يتم إنشاء أول حساب مسؤول، ويكون الإصدار مفتوح المصدر أنسب لعقدة واحدة تراقبها عن كثب، وليس لأسطول.
يغطي Bifrost Enterprise معظم هذه الفجوة: حيث تبث شبكة gRPC الخاصة به تغييرات Config إلى كل النسخ المتماثلة في غضون ثوانٍ، دون الحاجة إلى إعادة التشغيل. ولكن حتى إصدار Enterprise لا يزال عبارة عن البنية التحتية التي تقوم بنشرها وتوسيع نطاقها وتطبيق التحديثات عليها ومراقبتها بنفسك. إن شراء الترخيص لا ينقل العبء التشغيلي إلى شخص آخر.
لذا فإن القرار الحقيقي لا يتعلق بما إذا كان "Bifrost سريعًا؟" بل يتعلق بـ "من سيقوم بتشغيله؟" يمكن للفريق الذي يمتلك سعة مخصصة للمنصة/DevOps، أو الذي لديه متطلبات صارمة للإبقاء على كل شيء داخل بيئته الخاصة، تشغيل Bifrost بشكل جيد، ويفضل أن يكون ذلك على إصدار Enterprise إذا كان يحتاج إلى أكثر من نسخة متماثلة واحدة. بينما الفريق الصغير الذي يحتاج فقط إلى بوابة موثوقة أمام استدعاءات LLM الخاصة به سيستفيد عادةً بشكل أكبر من العروض المدارة مقارنة بإدارة عمليات البوابة بنفسه.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




