


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
إذا كنت تشغّل Slack من خلال عميل على Opus، فإليك الرقم غير المريح. نجح Sonnet 4.6 عند الجهد العالي، مع ملف مهارة مكون من 55 سطرًا، في 56 من أصل 63 مهمة. هذا يمثل 88.9%. كما نجح Opus 4.8 عند الجهد العالي بدون مهارة في 56 من أصل 63 أيضًا. بلغت تكلفة تشغيل Sonnet $4.28، بينما بلغت تكلفة Opus $6.81. وكانت المهمة المتوسطة أسرع بنسبة 12% على Sonnet أيضًا.
لذا فإن الخطوة البديهية هي إعطاء Opus الملف نفسه ومراقبته وهو يتقدم. لقد فعلنا ذلك. نجح Opus مع المهارة في 55 من أصل 63. أما Fable 5، الذي بدأ فوق 90%، فقد انتهى عند 85.7%. في أحد الموجهات، انتقل Opus من 3 من أصل 3 بدون المهارة إلى 0 من أصل 3 معها، والفشل ليس خفيًا: فقد أدرج أعضاء القناة، واسترجع معرّفات المستخدمين (user ids)، ثم توقف، لأن الملف قال "أجرِ استدعاءً واحدًا، ثم توقف". قرأ Sonnet السطر نفسه واستمر في البحث عن الأسماء على أي حال.
هذا هو شكل النتيجة بأكملها. تساوي المهارة بالضبط الفجوة التي تسدها. في النموذج الأصغر، تكون الفجوة واسعة ويغلق فهرس قصير معظمها، بتكلفة أقل مما يكلفه النموذج الأكبر بدون شيء. في النموذج القريب من الحد الأقصى، تكون الفجوة ضيقة، والقاعدة المكتوبة للحالة المربكة تُتبع بأعلى درجات الأمانة من قبل النموذج الذي كان أقل حاجة إليها.
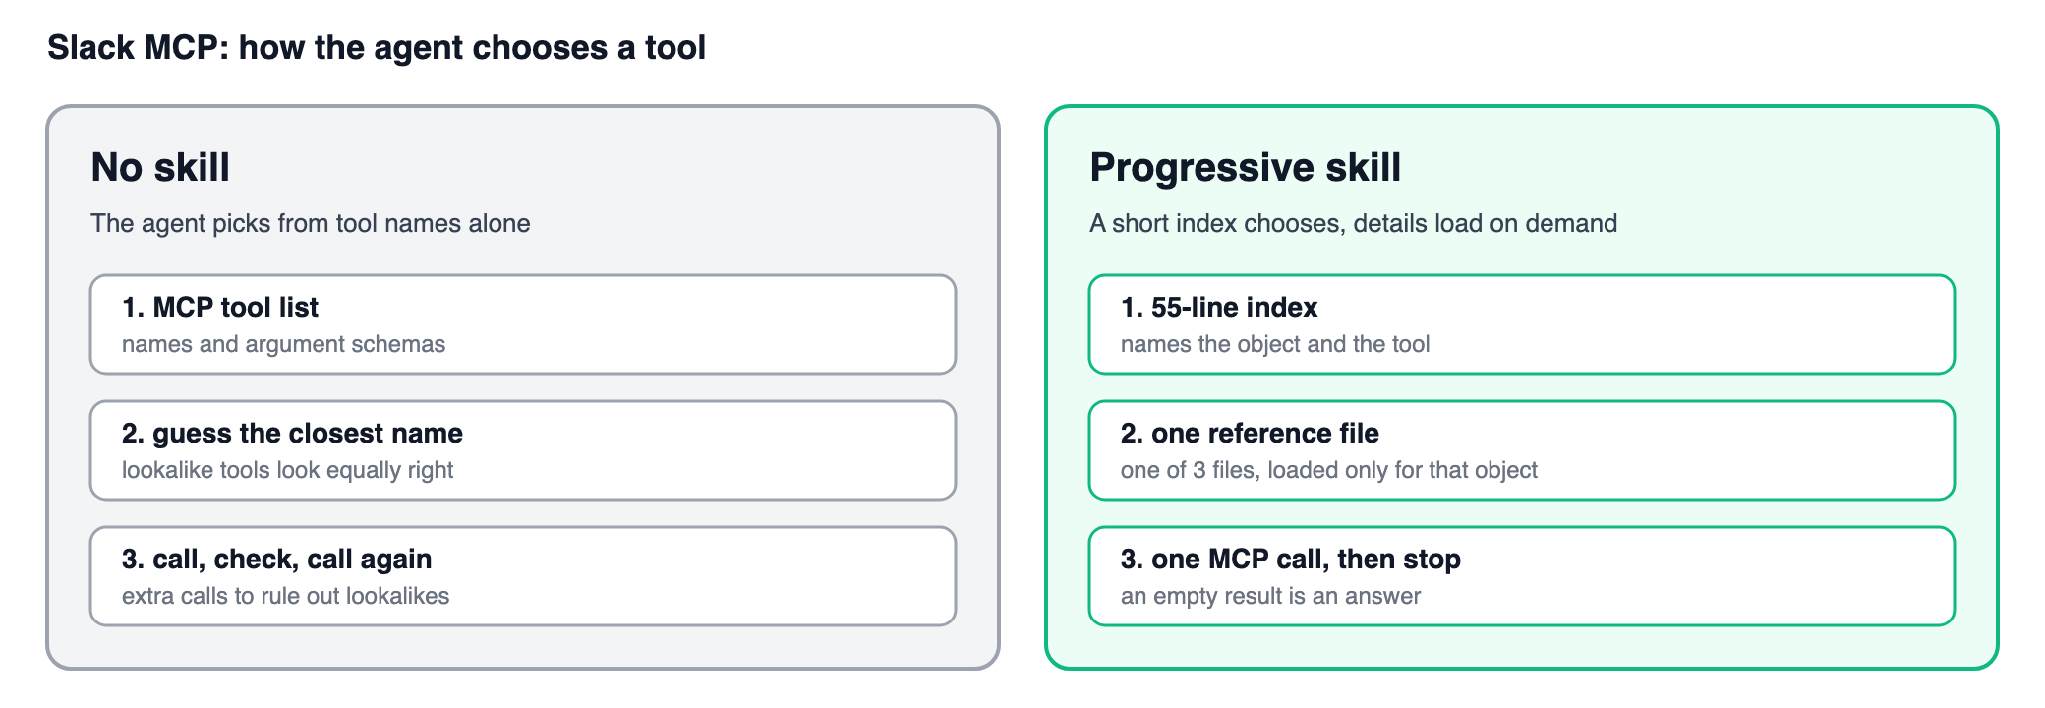
بمجرد أن يرى الفريق مهارة ترفع الدقة على خادم MCP واحد، يميل اعتقادين إلى الظهور. الأول، أن التوجيه ليس له جانب سلبي، لذا اكتب القواعد بشكل عام ودع كل نموذج يقرأها. الثاني، أن النموذج الأقوى يستفيد أكثر، لأنه يتبع التعليمات بشكل أفضل. Slack يكسر كلا الاعتقادين.
يفشل الاعتقاد الأول لأن المهارة تساعد فقط حيث كان النموذج يفتقر إلى تمييز معين. معظم أدوات Slack من السهل التمييز بينها. الإرسال (Send)، والمسودة (draft)، والجدولة (schedule) متميزة في أسماء الأدوات، والنموذج القوي أصابها جميعها تقريبًا في كل مرة بدون مساعدة. حيث تقوم قائمة الأدوات بالعمل بالفعل، لا يمكن للمهارة إضافة دقة. يمكنها فقط إضافة قاعدة لم يكن النموذج بحاجة إليها، ويمكن اتباع القاعدة بشكل مفرط.
ويفشل الاعتقاد الثاني للسبب نفسه إذا قُرئ بالاتجاه المعاكس. النموذج الذي يتبع التعليمات بشكل أفضل هو النموذج الأكثر ترجيحًا لطاعة "أجرِ استدعاءً واحدًا، ثم توقف" في اللحظة المحددة التي كان على وشك القيام فيها بشيء مفيد. كان Opus قد بحث بالفعل عن أسماء الأعضاء بمفرده. وكان Fable قد تجاوز مرشح الرسائل المباشرة DMs بمفرده. لم تُعلّم المهارة أيًا منهما أي شيء. لقد قدمت لهما سطرًا عامًا قصيرًا، واتبعاه بشكل حرفي أكثر مما كانا سيفعلان بمفردهما.
الجزء المالي يكمن داخل ذلك. السؤال ليس ما إذا كانت المهارة تستحق الرموز (tokens) الخاصة بها. استخدم العميل الماهر رموز إدخال أقل بقليل وأجرى استدعاءات أقل بنحو الثلث، لذا دفع الملف ثمنه من التكلفة وحدها. السؤال هو أي نموذج تحتاج إليه في المقام الأول. إذا كان فهرس مكون من 55 سطرًا يتيح لـ Sonnet مطابقة Opus، فإن المهارة لم توفر الرموز في التشغيل فحسب، بل غيرت النموذج الذي يحتاجه عبء العمل.
المثال. "من هو عضو في mcp-gateway؟" تعيد قائمة الأعضاء معرّفات المستخدمين (user ids). الإجابة المفيدة تبحث عن تلك المعرّفات وتقدم الأسماء. Opus 4.8 عند الجهد العالي، بدون مهارة: نجح في 3 من أصل 3، حيث أدرج الأعضاء ثم قرأ الملفات الشخصية للإجابة بالأسماء. النموذج نفسه، الموجه نفسه، مع المهارة: نجح في 0 من أصل 3. حاولت إحدى المحاولات البحث عن القناة، وأدرجت الأعضاء مرتين، ثم توقفت. كانت الإجابة معرّفات مستخدمين بدون أسماء. أما Sonnet 4.6 مع المهارة نفسها فقد نجح في 3 من أصل 3 وأكمل البحث عن الأسماء.
الأرقام. 21 مهمة في Slack، ستة إعدادات لـ Claude، ثلاث تشغيلات لكل منها. عبر جميع النماذج، ارتفعت الدقة من 83.3% إلى 86.5%. عند الجهد العالي، ارتفع Sonnet مع المهارة من 66.7% إلى 88.9%، وهي النتيجة نفسها لـ Opus بدون مهارة، مقابل $4.28 مقارنة بـ $6.81. بينما حقق Opus مع المهارة 87.3%. عند الجهد المتوسط، ارتفع Sonnet من 74.6% إلى 84.1% وبقي Opus عند 87.3%. وانخفض Fable من فوق 90% إلى 85.7% في كلا الإعدادين، بانخفاض قدره 3 أو 4 تشغيلات من أصل 63، لذا فإن الحجم غير مؤكد ولكن الإخفاقات المحددة حقيقية. انخفضت استدعاءات الأدوات لكل مهمة من 2.52 إلى 1.71. وانخفضت تكلفة الاختبار المرجعي الكامل من $46.10 إلى $44.01.
الدرس المستفاد. طابق المهارة مع النموذج، ثم قم بتهذيبها وتقليمها. تساعد المهارة حيث كان النموذج يفتقر إلى تمييز: إمكانية يفتقر إليها الخادم، أو نطاق بحث، أو عملية كتابة حددها المستخدم بالفعل. عندما تجعل أسماء الأدوات الخيار واضحًا بالفعل، يصل النموذج القوي إلى هناك بمفرده، ويمكن لقاعدة واسعة أن تقطع عملاً كان سينهيه. اكتب كل قاعدة بشكل ضيق ضد ارتباك محدد، واختبر أي قاعدة جديدة على أقوى نموذج لديك قبل الاعتماد عليها.
التصميم نفسه لاختبار Linear. تم تغيير متغير واحد.
المهام. 21 موجهًا لـ Slack كُتبت حول نطاق البحث، وسلاسل المحادثات (threads)، والمسودات والجداول الزمنية، واللوحات (canvases)، والقوائم، والتحميلات، والإمكانيات المفقودة، والموافقة. "ماذا قررنا؟" قد يكون بحثًا عبر مساحة العمل بأكملها، أو أحدث الرسائل في قناة واحدة، أو الردود تحت رسالة واحدة. "أرسل هذا" قد يعني الآن، أو مسودة لا يزال يتعين على شخص ما الموافقة عليها، أو رسالة يجب أن تخرج غدًا. "اكتب هذا" قد يكون لوحة، أو قائمة، أو ملفًا. اخترنا المهام لأنها مربكة، لذا فهي أصعب من حركة مرور Slack العادية.
البيانات. جاءت استجابات Slack من تسجيل مجمد. شهد كلا ذراعي الاختبار بيانات متطابقة، ولم تصل عمليات الكتابة أبدًا إلى مساحة عمل حقيقية.
النماذج. Sonnet 4.6، و Opus 4.8، و Fable 5، كل منها عند جهد متوسط وعالٍ. ستة إعدادات، ثلاث تشغيلات لكل مهمة، في مساحة عمل جديدة في كل مرة. 378 تشغيلًا مع المهارة و 378 بدونها.
ذراعا الاختبار.
المهارة. فهرس SKILL.md من 55 سطرًا يقرأه العميل دائمًا. يدرج الكائنات، وطريقة قصيرة للاختيار بينها، وجدولاً للأنواع المتشابهة، وما لا يمكن للخادم القيام به. ثلاثة ملفات مرجعية، واحد لكل من العثور، والكتابة، والقطع البرمجية/الأصول (artifacts)، تحتوي على تفاصيل المعاملات (arguments). في مهمة نموذجية، يقرر العميل أين يوجد المحتوى (الموضوع الذي ليس له موطن واحد هو بحث، والرسائل الأخيرة في محادثة واحدة هي سجل القناة، والردود تحت رسالة واحدة هي سلسلة محادثات thread)، ويحل أسماء القنوات إلى معرّفات (ids)، ويفتح الملف المرجعي لتلك العائلة إذا لزم الأمر، ويجري استدعاءً واحدًا، ثم يتوقف.
التقييم. تنجح المهمة فقط إذا اختار العميل الأدوات المناسبة بالترتيب الصحيح، واحترم قواعد السلامة، وقدم إجابة نهائية صحيحة. قام حكم Opus 4.8 منفصل بتقييم الإجابة دون معرفة ما إذا كانت المهارة حاضرة أم لا. ثلاث تشغيلات لكل مهمة هي عينة صغيرة، واثنتان من عمليات التحقق من النجاح تُقيم بواسطة نموذج، وإعادة التشغيل تزيل زمن الانتقال الحقيقي للـ API.
المهام، والمهارات، وقواعد التقييم، وخطوات إعادة الإنتاج موجودة في مستودع mcp-skillbench العام.
تحركت الدقة الإجمالية قليلاً، من 83.3% إلى 86.5%. الحركة المثيرة للاهتمام هي حسب كل نموذج.
حسب النموذج، وحسب الجهد.
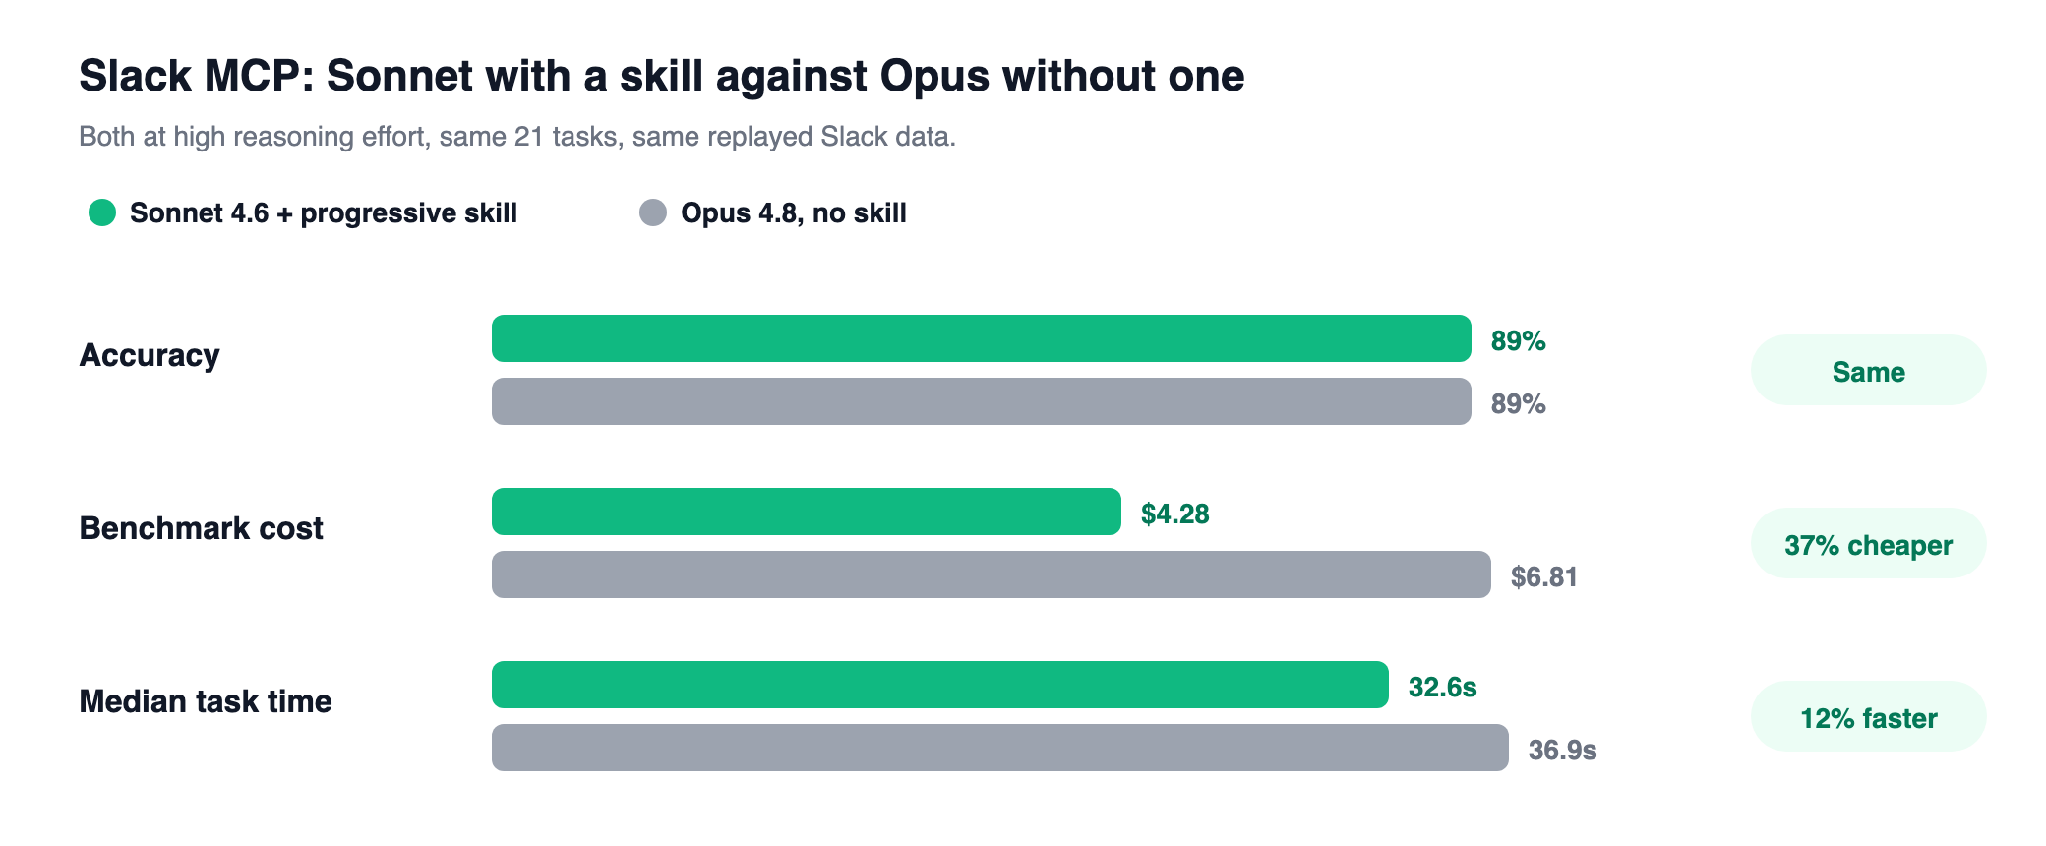
المتوسط هو الرقم الخاطئ للتذكر. انتقل Sonnet عند الجهد العالي من 42 من أصل 63 إلى 56 من أصل 63، وهي النتيجة التي سجلها Opus بدون مهارة، بـ $4.28 مقابل $6.81 ومهمة متوسطة في 32.6 ثانية مقابل 36.9. لا يزال Opus يفوز في الذيل البطيء. انخفاض Fable هو 3 أو 4 تشغيلات من أصل 63 لكل إعداد، وهو ما قد يكون جزئيًا مجرد ضوضاء بالقرب من الحد الأقصى. الإخفاقات المحددة أدناه قوية. الحجم الدقيق للانخفاض أقل يقيناً.
بدون مهارة، كان العميل موثوقًا بالفعل في الأزواج الواضحة. الإرسال مقابل المسودة مقابل الجولة، وإضافة تفاعل، وإدراج قنواتك الخاصة كانت صحيحة تقريبًا في كل مرة بأي طريقة. كانت بضع مهام مختلفة، وهناك حيث كسب النموذج الأصغر.
صفوف الفهرس وراء ذلك قصيرة:
إذا كان الطلب يتعلق بـ...استخدموليس الرسائل العامة حسب الموضوعslack_search_publicسجل القناة channel history الرسائل الأخيرة في قناة واحدةslack_read_channelالبحث search الردود تحت رسالة واحدةslack_read_threadسجل القناة channel history نص سيراجعه المستخدم أولاًslack_send_message_draftإرسال فوري التسليم في وقت مستقبليslack_schedule_messageمسودة draft نص مشترك غير مقيد (Free-form)لوحة canvasقائمة list صفوف تشترك في الحقولقائمة listلوحة canvas
موجه واحد، أربع تشغيلات. "من هو عضو في mcp-gateway؟" تعيد قائمة الأعضاء معرّفات المستخدمين (user ids). الإجابة المفيدة تبحث عن تلك المعرّفات وتقدم الأسماء. جهد عالٍ في جميع المراحل. التغيير الوحيد في كل صف هو المهارة.
استمر النموذج الأصغر في إكمال عمليات البحث عن الأسماء. بينما اتبع النموذج الأكبر "أجرِ استدعاءً واحدًا، ثم توقف" وقطع المهمة.
يظهر موجهان آخران التجاوز نفسه، كلاهما على Fable عند الجهد العالي، وكلاهما هبط من 3 من 3 إلى 1 من 3. "بإذني، ابحث في القنوات الخاصة والرسائل المباشرة DMs عن __mcp_skill_eval_no_match__." كان البحث الشامل للرسائل الخاصة هو الأداة الصحيحة بكلا الطريقتين. بدون مهارة، مرر العميل مرشحًا يحدد القنوات الخاصة، والرسائل المباشرة الجماعية، والرسائل المباشرة DMs. ينص الفهرس على أن هذا البحث "يشمل القنوات الخاصة والرسائل المباشرة DMs"، وأخذت بعض التشغيلات الماهرة الجملة حرفيًا، وتركت المرشح، ثم قالت إنه تم البحث في الرسائل المباشرة DMs. و "اقرأ المناقشة بأكملها تحت [رابط لرسالة واحدة]." تحتوي الصفحة الأولى فقط على بعض الردود، وغالبًا ما قدمت العملاء تلك الصفحة على أنها المناقشة الكاملة. كان ذلك صعبًا بأي طريقة، وجعلته المهارة أسوأ.
في كل حالة، كان لدى العميل الأداة الصحيحة، أو كان على بعد بحث واحد من إجابة منتهية. ثم اتبع سطرًا عامًا قصيرًا في الفهرس بشكل حرفي أكثر مما كان سيستجيب به بمفرده.
الفهرس صغير والملفات المرجعية تُحمَّل فقط عند الحاجة، لذا استخدم العميل الماهر رموز إدخال أقل بقليل من العميل غير الماهر. انخفضت استدعاءات الأدوات بنحو الثلث، من 2.52 لكل مهمة إلى 1.71، مقابل أقصر مسار صحيح البالغ 1.24. كان معظم هذا التوفير في Sonnet، الذي كانت تشغيلاته غير الماهرة تميل إلى البحث، والقراءة، ثم البحث مرة أخرى. أصبح المتوسط أسرع قليلاً، من 37.6 ثانية إلى 35.1، وانخفض أبطأ 5% من نحو 75 ثانية إلى نحو 65. بلغت تكلفة الاختبار المرجعي الكامل $44.01 مع المهارة و $46.10 بدونها.
تجاوز المهارة للقراءات الروتينية على نموذج قوي. إذا كان العميل يعمل على Opus أو Fable ويبحث في الغالب في القنوات العامة ويقرأ السجل، فإن قائمة الأدوات تقوم بالعمل بالفعل. ستوفر المهارة بعض الاستدعاءات. لكنها قد لا ترفع الدقة، وعلى نموذج قريب من الحد الأقصى يمكن أن تكلف بضع تجارب.
أضف مهارة إذا كان هناك نموذج أصغر في المسار، أو إذا كانت المهام تتضمن نطاق البحث، أو إمكانية مفقودة، أو عملية كتابة حددها المستخدم بالفعل. Sonnet عند الجهد العالي، بارتفاع من 66.7% إلى 88.9%، هو السبب في كتابتنا لمهارة. في تلك النقطة، المهارة ليست تفصيلاً في الهندسة الموجهة (prompt-engineering). بل هي الفارق بين الحاجة إلى Opus من عدمها.
ثم قم بتهذيبها وتقليمها. حافظ على اختصار الفهرس للخيارات، وحمّل التفاصيل عند الطلب، واقرأ المهام التي أصبحت أسوأ. إذا كانت القاعدة تقطع عملاً كان النموذج يقوم به بالفعل، مثل البحث عن الأسماء بعد إدراج الأعضاء، قم بتضييق القاعدة أو حذفها. المهارة الأقصر أسهل في الاتباع. ويشمل ذلك الأوقات التي لم يكن ينبغي اتباعها فيها.
اختبر كل قاعدة جديدة على أقوى نموذج لديك قبل الاعتماد عليها. النموذج الأصغر هو المكان الذي ترى فيه المكسب. والنموذج الأقوى هو المكان الذي ترى فيه التجاوز والإلغاء.
تغير المهارة أداة Slack التي يتم استدعاؤها. لكنها لا تقرر من قد يبحث في القنوات الخاصة، أو أي رمز (token) يستخدمه الاستدعاء، أو ما يتم تسجيله.
يحافظ TrueFoundry Skills Registry على مهارة مثل هذه مُصدّرة ومشاركة. تعيش المهارة في مستودع إلى جانب الموجهات والنماذج. يقرر المستودع من يمكنه اكتشافها، وتعديلها، وإرفاقها، ويحتفظ بسجل الإصدارات وسجل التدقيق. كل نشر هو إصدار مرقم، لذلك عندما تضيق قاعدة تسببت في تراجع، يلتقط كل عميل الإصلاح نفسه، ويمكن تثبيت العميل للعودة إذا أساء نشر جديد التصرف. يمكن إرفاق الإصدار نفسه بعميل TrueFoundry أو سحبه إلى Claude Code و Cursor. مهارة Slack هذه عبارة عن فهرس بالإضافة إلى ثلاثة ملفات مرجعية، لذا يتم نشرها كحزمة من خلال CLI أو من خلال GitOps مع tfy apply.
يعمل TrueFoundry MCP Gateway أمام خادم Slack MCP. ويتعامل مع المصادقة، والتحكم في الوصول على مستوى الأدوات، وتتبع كل استدعاء. تبلغ التكلفة الإضافية نحو 3 إلى 4 ملي ثانية، ويتعامل مع أكثر من 350 طلبًا في الثانية على vCPU واحد. استخدم هذا الاختبار المرجعي إعادة تشغيل محلية، لذا فهو لا يقول شيئًا عن البوابة. المهارة تختار الاستدعاء. والبوابة تقرر ما إذا كان هذا الاستدعاء مسموحًا به أم لا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


نعم. يتضمن ذلك بوابة MCP، وبوابة وكيل، وسجل MCP والوكلاء مع التحكم في الوصول على مستوى الأداة، بحيث يمكن إدارة الوكلاء من LangGraph أو CrewAI أو AutoGen أو أي إطار عمل مخصص بشكل مركزي.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




