October 7, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
Aplicações que utilizam grandes modelos de linguagem dependem de provedores de modelos de IA para cada solicitação de inferência. OpenAI, Anthropic e Google oferecem serviços, mas nenhum provedor de LLM elimina limites de taxa, interrupções ou picos de latência. Portanto, um problema no provedor pode interromper aplicações e fluxos de trabalho de LLM.
Sem um caminho de fallback, uma solicitação pode falhar, exceder os objetivos de resposta ou criar uma experiência de usuário inconsistente. Esse padrão encaminha as solicitações afetadas por meio de outro modelo ou provedor quando a rota inicial não atende aos requisitos definidos. Isso preserva a continuidade do serviço sem expor falhas de infraestrutura aos usuários da aplicação.
A implementação confiável é essencial sempre que sistemas de produção utilizam múltiplos modelos, regiões ou provedores. Um Gateway de LLM pode centralizar o roteamento, a resiliência e a aplicação de políticas por trás de uma única interface. Essa arquitetura ajuda as equipes de produção a evitar a incorporação de lógica de recuperação específica de cada provedor em todos os aplicativos.
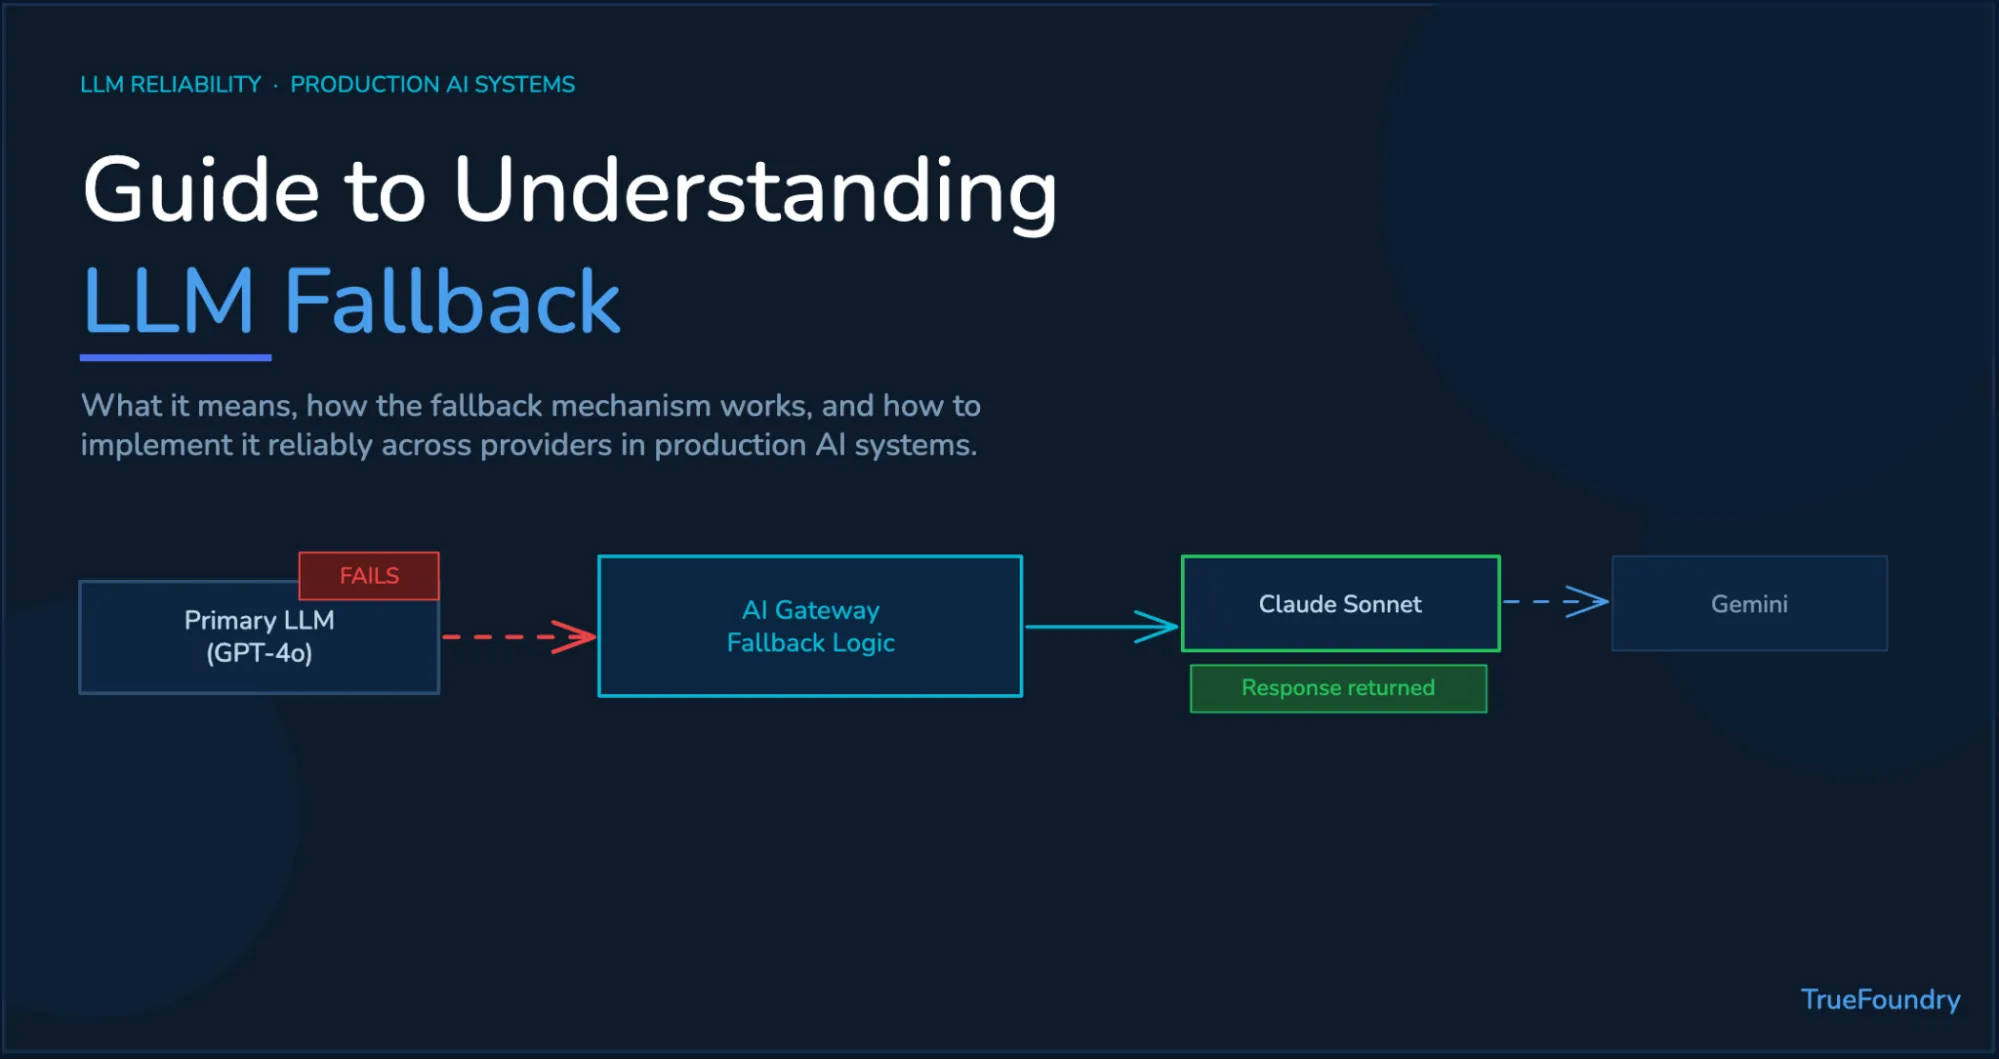
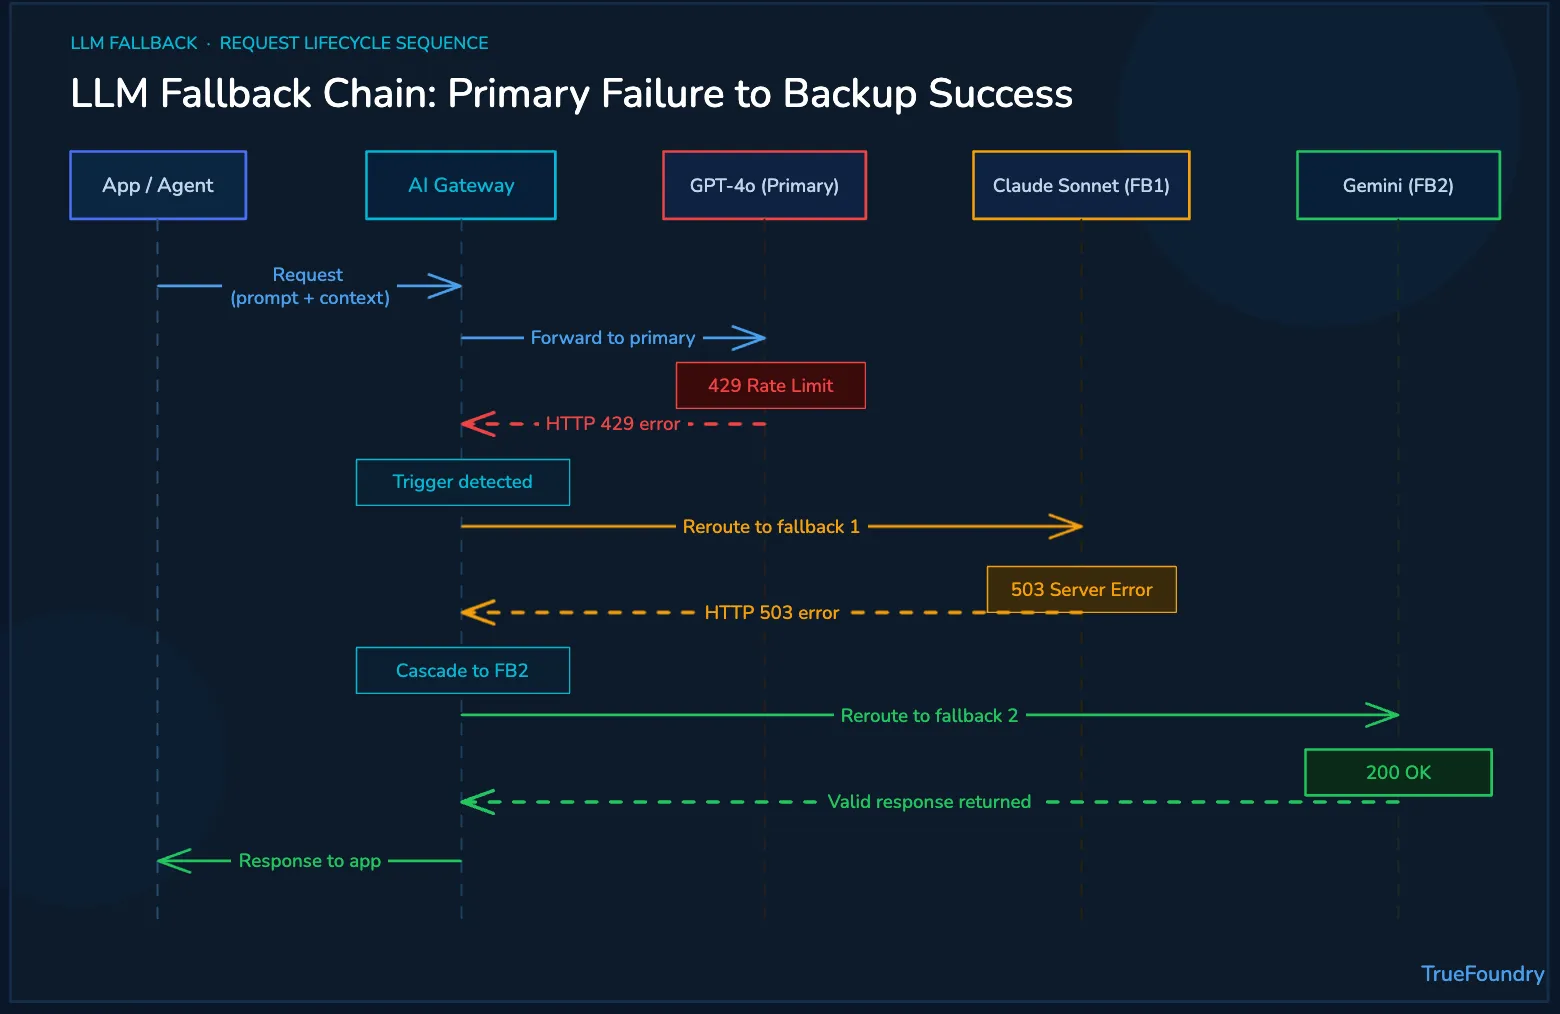
Este padrão de confiabilidade encaminha automaticamente uma solicitação quando o modelo principal não atende aos requisitos definidos de disponibilidade, latência ou qualidade. Os gatilhos podem incluir uma resposta HTTP 429, um erro de servidor, um erro de rede ou um tempo limite configurado. A solicitação é então direcionada para um modelo de fallback adequado por meio de uma rota alternativa.
O significado de LLM fallback vai além da recuperação isolada de erros. Ele representa uma camada de resiliência dentro da arquitetura de acesso ao modelo. Essa abordagem reduz a dependência de um único provedor de LLM, ajudando as aplicações a permanecerem disponíveis durante a instabilidade do provedor.
Os fallbacks podem operar entre provedores, modelos, regiões ou limites de qualidade. Um único modelo também pode recorrer a outra implantação dentro do mesmo provedor. O design selecionado deve preservar a compatibilidade entre prompts, tokens, janelas de contexto, suporte a ferramentas e formatos de resposta.
O mecanismo de LLM fallback segue uma sequência controlada após a falha de uma solicitação. Seu roteador avalia o gatilho, lê a cadeia de fallback configurada e seleciona o próximo destino elegível. O prompt original, o contexto e as configurações de geração seguem então pela rota de fallback escolhida.
As tentativas devem lidar com falhas transitórias antes de trocar de provedor. Políticas limitadas usam espera exponencial, jitter e orientações de resposta antes de redirecionar. A OpenAI recomenda espera aleatória, enquanto a Anthropic documenta limites de taxa, tempos limite e respostas de sobrecarga.
Fallback, failover e tentativas resolvem problemas relacionados em diferentes escopos operacionais. O fallback lida com falhas de solicitações individuais, enquanto o failover redireciona um tráfego mais amplo durante uma degradação sustentada. As tentativas repetem uma solicitação no mesmo endpoint antes que outro destino a receba.
Esses padrões comuns geralmente funcionam juntos em arquiteturas resilientes. Tentativas limitadas podem resolver erros de curta duração sem trocar de provedor. O balanceamento de carga de LLM distribui o tráfego normal, enquanto o failover protege a continuidade durante interrupções prolongadas. O fallback lida com as falhas restantes no nível da solicitação.
Diferentes estratégias de fallback suportam disponibilidade, qualidade, custo e independência de provedor. Cada estratégia requer condições de disparo claras e capacidades de modelo compatíveis. As equipes devem comparar a latência esperada, a qualidade da saída, os limites de contexto e o suporte a ferramentas antes de definir as prioridades de rota.
O limite de taxa eficaz deve coordenar-se com cada estratégia, em vez de acionar um redirecionamento descontrolado. Central controles de limite de taxa podem aplicar cotas entre usuários, modelos, aplicações e ambientes. O Google documenta respostas HTTP 429 quando as cargas de trabalho do Gemini excedem as cotas aplicáveis.
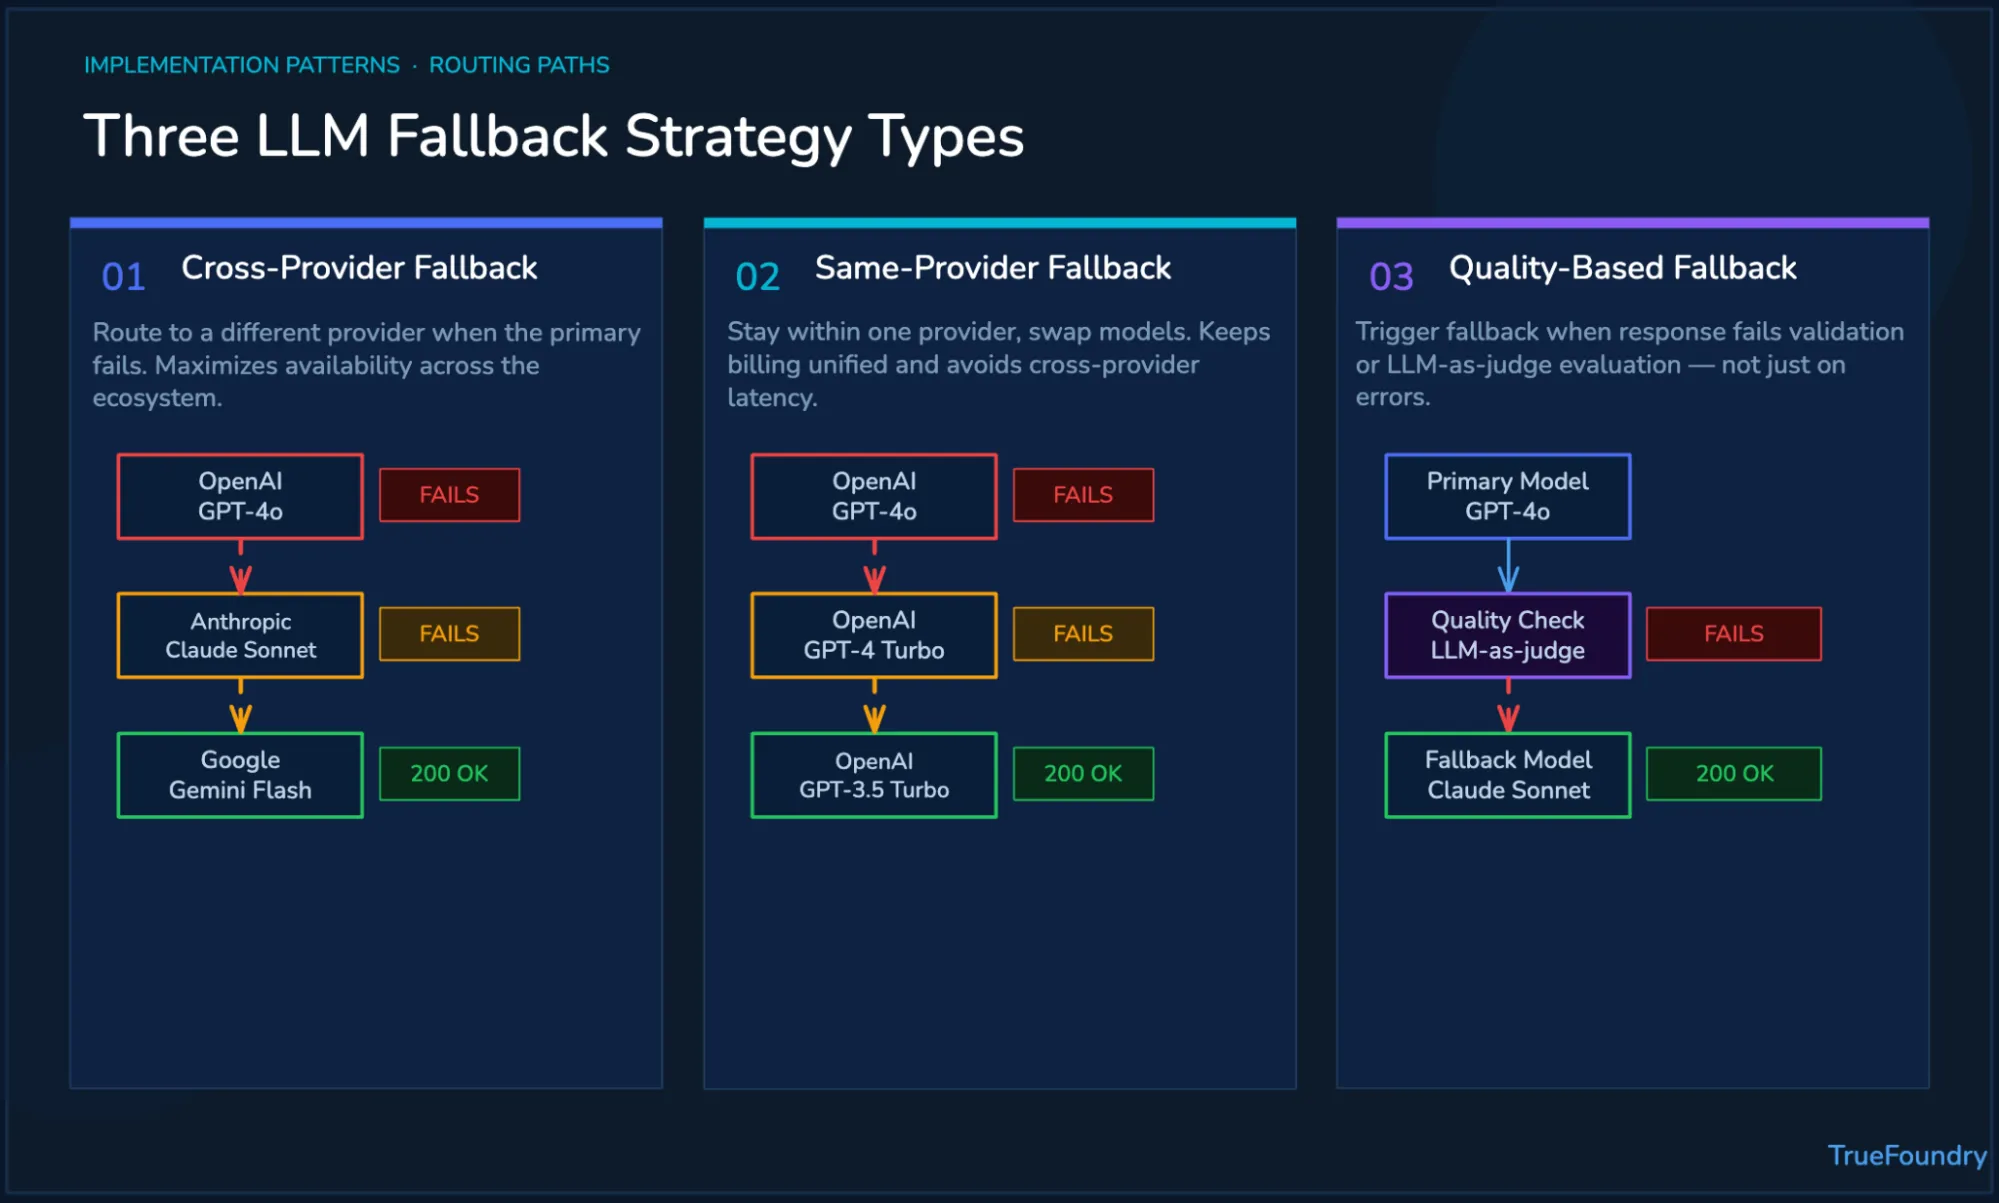
Criar lógica de fallback dentro do código da aplicação parece gerenciável durante o desenvolvimento inicial. A complexidade aumenta quando a configuração abrange vários provedores, versões de modelo e ambientes. Cada SDK expõe erros, padrões, estruturas de resposta e comportamentos de nova tentativa diferentes.
As equipes podem avaliar o Portkey, Bifrost ou Vercel ao comparar opções de gateway. Independentemente da plataforma escolhida, as melhores práticas exigem novas tentativas limitadas, roteamento com reconhecimento de integridade, credenciais seguras e recuperação mensurável. Uma forte observabilidade de LLM deve mostrar latência, erros, frequência de fallback e a taxa de sucesso final.
OTrueFoundry AI Gateway centraliza o acesso ao modelo, roteamento, controles de confiabilidade e observabilidade. Sua configuração de roteamento global suporta balanceamento de carga, fallback e regras de nova tentativa a partir de uma única camada de governança. As aplicações podem usar uma única API sem precisar reconstruir a lógica de recuperação para cada provedor.
A plataforma suporta cadeias entre um provedor primário e destinos alternativos. Novas tentativas automáticas lidam com erros temporários do provedor antes do redirecionamento. O monitoramento contínuo da integridade reduz a recuperação atrasada durante interrupções.
Para agentes de IA, o Agent Gateway governa a execução de várias etapas. O MCP Gateway controla o acesso entre ferramentas corporativas conectadas. Juntos, eles protegem todo o sistema quando uma rota de modelo fica indisponível.
Crie aplicações de IA resilientes com o AI Gateway da TrueFoundry. Centralize roteamento, novas tentativas, observabilidade e fallback de LLM entre provedores. Agende uma demonstração gratuitahoje mesmo para começar.
O fallback de LLM é um requisito arquitetural para aplicações confiáveis que utilizam modelos externos. Provedores podem impor restrições ou sofrer falhas temporárias durante as operações. As aplicações devem absorver essas condições sem repassar cada interrupção aos usuários.
A implementação em nível de aplicação é possível, mas a complexidade aumenta em ambientes com múltiplos modelos. Um gateway pode centralizar regras de novas tentativas, ordem de fallback, verificações de integridade, credenciais e monitoramento. Essa abordagem melhora a resiliência enquanto mantém o código da aplicação independente do comportamento específico de cada provedor.
As equipes devem definir gatilhos, validar a compatibilidade dos modelos e monitorar cada rota após a implantação. Elas também devem testar cadeias esgotadas e o comportamento de recuperação antes que o tráfego de produção aumente. TrueFoundry fornece um plano de controle único para governar as decisões de acesso aos modelos.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada