



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O OWASP Top 10 para Aplicações de Modelos de Linguagem Grandes é uma lista de consenso dos riscos de segurança mais críticos em softwares baseados em LLM, mantida pelo projeto OWASP GenAI Security. A versão atual é a lista de 2025 em genai.owasp.org/llm-top-10. A lista v1.1 de 2023/24 ainda está arquivada lá e ainda é amplamente citada — portanto, se uma publicação mencionar Roubo de Modelo (Model Theft) ou Excesso de Confiança (Overreliance), ela está descrevendo a versão descontinuada.
A lista de 2025 conforme publicada pela OWASP:
As mudanças mostram para onde a atenção se voltou. Vazamento de Prompt do Sistema e Fraquezas em Vetores e Embeddings são novos. Negação de Serviço do Modelo tornou-se o mais amplo Consumo Ilimitado. Design Inseguro de Plugins foi incorporado à cadeia de suprimentos e à agência excessiva à medida que as ferramentas se consolidaram em torno de protocolos como o MCP. Roubo de Modelo foi removido completamente.
Esta é a parte que a maioria dos artigos pula. O Top 10 lista riscos, e um risco não é um recurso de produto. Quatro pertencem ao caminho da inferência, onde o gateway se posiciona. Três pertencem ao código da aplicação. Três pertencem a pipelines que o gateway nunca enxerga.
Quatro diretamente no escopo, três parciais, três que necessitam de um responsável em outro lugar. Se a sua estrutura de segurança de IA tem uma linha de gateway para LLM04 e LLM08, essa linha é meramente decorativa.
Um gateway cobre o LLM01, LLM02, LLM06 e LLM10 com eficácia porque todos os quatro são problemas de caminho da requisição (request-path): eles acontecem no momento em que um prompt é enviado ou uma ferramenta é acionada, que é o único momento que o gateway enxerga. O restante foi decidido semanas antes, em uma execução de treinamento ou em uma tarefa de indexação.
Tratar a lista como um checklist de conformidade. O OWASP publica uma taxonomia de riscos com orientações de mitigação, não uma certificação. Não existe uma auditoria do OWASP LLM Top 10 nem um órgão que emita uma aprovação. Uma matriz alegando que todos os dez itens estão "cobertos" por uma única ferramenta é escrita para sobreviver a uma reunião, não a um ataque.
Colocar a validação de saída no lugar errado. O LLM05 trata do que sua aplicação faz com a saída do modelo. Um gateway pode sinalizar que uma resposta contém os.system ou uma tag de script sem escape. Ele não pode impedir que seu serviço envie essa string para um shell. O controle pertence ao local onde a saída é consumida; a verificação no gateway é defesa em profundidade.
Assumir que a detecção de injection é prevenção. A detecção é um classificador, classificadores têm falsos negativos e os atacantes iteram contra eles. A mitigação duradoura para o LLM01 é presumir que a injection ocasionalmente terá sucesso e tornar isso suportável — o que é, na verdade, um problema de LLM06. Reduza a superfície de ferramentas disponíveis e uma injection bem-sucedida alcançará um modelo sem nada perigoso para chamar.
Ignorar o LLM10 como uma preocupação apenas de faturamento. Um agente preso em um loop é uma negação de serviço contra seu próprio orçamento, e consultas em alto volume são como a extração de modelos funciona. É a entrada mais fácil de fechar e a que mais comumente é deixada aberta.
O AI Gateway da TrueFoundry implementa esses controles como guardrails em hooks no caminho da requisição. Existem quatro, e quais riscos você pode abordar depende de qual hook você está usando.
Para requisições de LLM: input, antes de o prompt atingir o modelo, e output, após a resposta.

Para chamadas de ferramentas MCP: mcp_pre_tool, antes de a ferramenta ser executada, e mcp_post_tool, após o seu retorno.
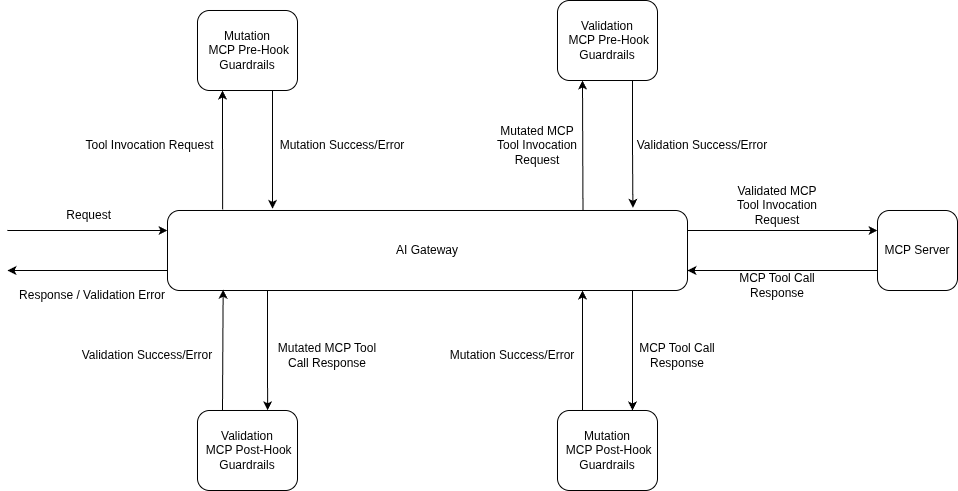
Esses hooks MCP tornam a questão da segurança em MCP no OWASP tratável. Os guardrails são executados em cada chamada de ferramenta separadamente — cinco ferramentas seguidas significam cinco conjuntos de verificações. Uma falha no pre-tool significa que a ferramenta nunca é executada; uma falha no post-tool retém o resultado.
Cada guardrail possui um modo de operação — validate inspeciona e pode bloquear, mutate também reescreve — e uma estratégia de execução (enforcement strategy) cobrindo violações e erros de guardrail:
O guardrail nativo de Prompt Injection é alimentado pelo Azure Prompt Shield e gerenciado pela TrueFoundry, sem necessidade de chaves de terceiros. Ele analisa o prompt do usuário e qualquer conteúdo de documento ou contexto separadamente, para que injections indiretas ocultas em um documento recuperado sejam capturadas juntamente com um "ignore todas as instruções anteriores" direto. Operation mode apenas validate. Adicione-o na seção de Guardrails:
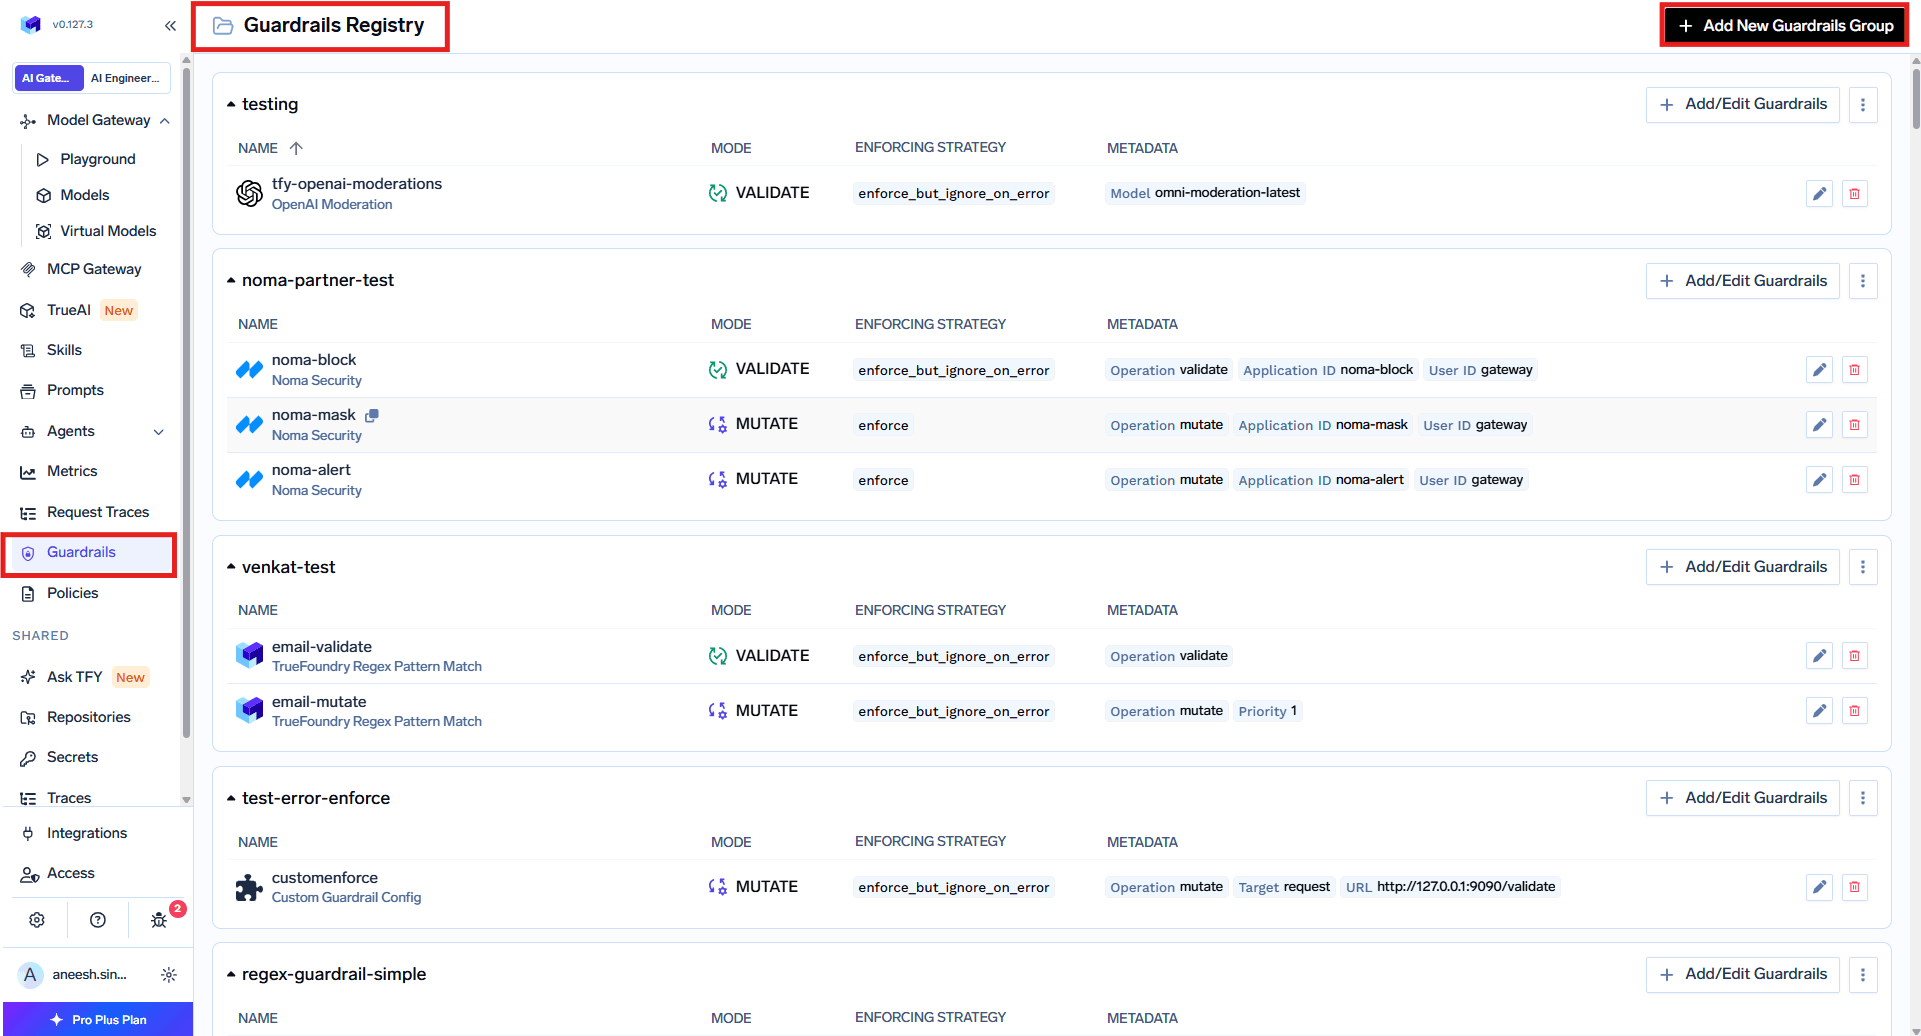
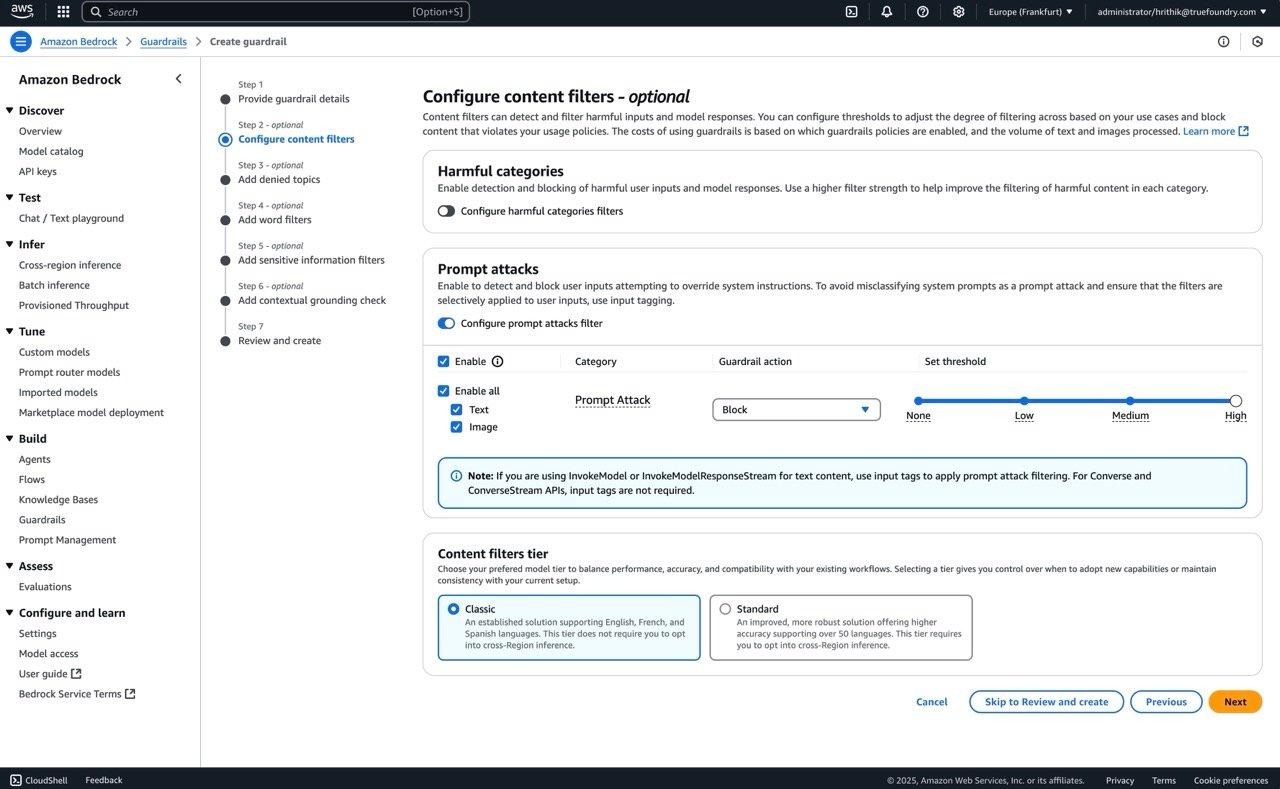
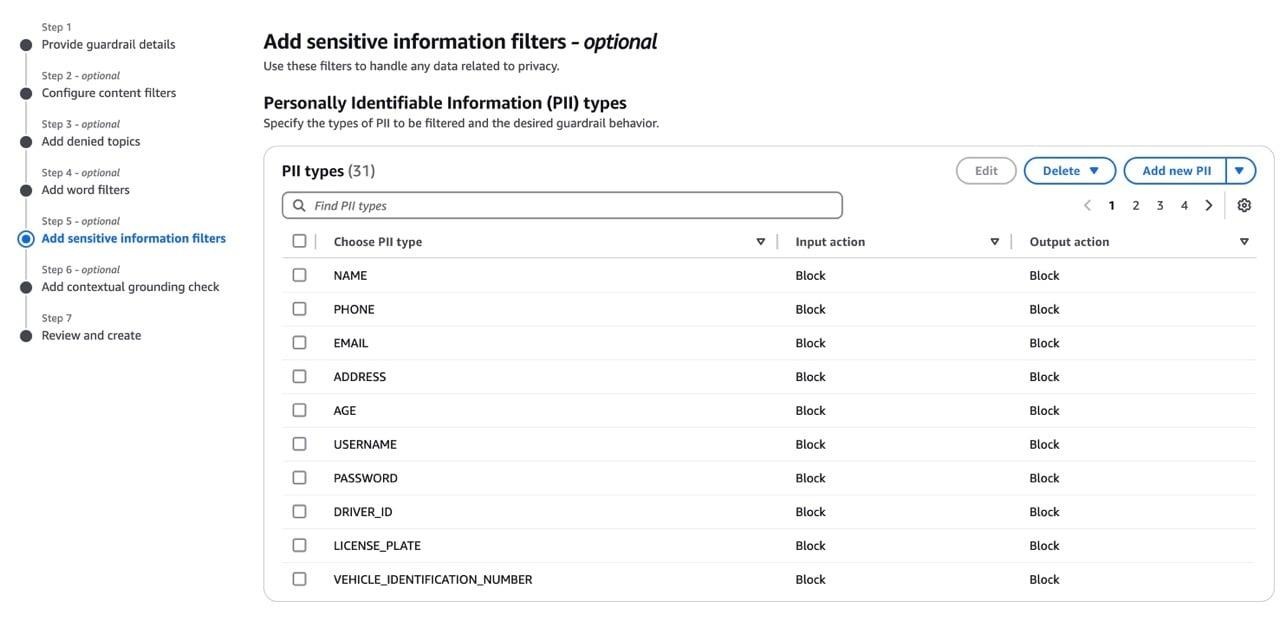
Ele roda em LLM Input e MCP Pre Tool, onde procura por injections dentro dos parâmetros de ferramentas. Caso prefira usar suas próprias credenciais de provedor, o AWS Bedrock Guardrails realiza o mesmo trabalho — ative o Prompt Attack, defina a ação para Block e registre-o:
Dois guardrails nativos cobrem a maior parte deste ponto. PII / PHI Detection encontra nomes, endereços, números de identificação (como CPF/SSN) e registros médicos com categorias de entidades configuráveis. Secrets Detection captura chaves AWS, chaves de API da OpenAI e Anthropic, tokens do GitHub e GitLab, JWTs, chaves privadas, strings de conexão de banco de dados e strings de alta entropia próximas a palavras-chave como api_key.
Secrets Detection é o principal para compreender: é o único guardrail nativo que roda em todos os quatro hooks, e cada um captura uma falha diferente.
Ele roda dentro do gateway sem chamadas de API externas e, no modo mutate, substitui as ocorrências encontradas por um texto configurável, sendo ***REDACTED*** o padrão. Para PII em implantações auto-hospedadas (self-hosted), o Azure PII com sua própria chave, o Presidio via um guardrail personalizado ou os filtros do Bedrock são soluções funcionais.
É aqui que os hooks MCP mostram seu valor. SQL Sanitizer captura DROP, TRUNCATE, DELETE ou UPDATE sem a cláusula WHERE, além de interpolação de strings. Code Safety Linter sinaliza eval, exec, os.system, chamadas de subprocess e comandos de shell perigosos. Cedar e OPA aplicam políticas granulares de negação por padrão (default-deny) para chamadas de ferramentas MCP.
Por baixo disso reside o modelo de acesso, a parte mais ampla do LLM06: ferramentas podem ser desativadas para que nunca apareçam no tools/list, chamadas sensíveis podem exigir aprovação (MCP Server Approver), e o OAuth por usuário significa que o sistema upstream avalia as permissões reais do usuário ativo em vez de usar um token compartilhado. Nosso artigo sobre Controle de acesso em MCP aborda essa camada em detalhes.
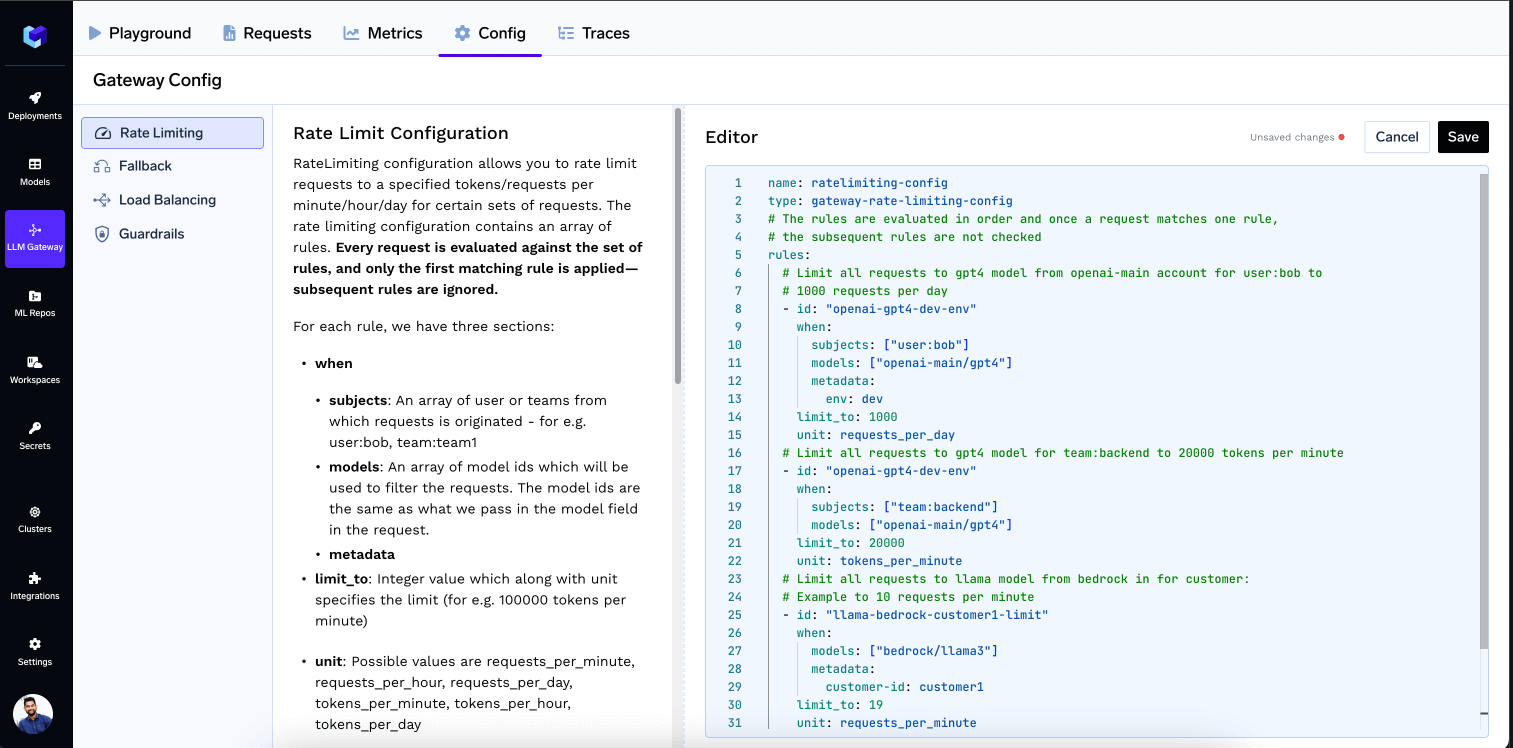
Não se trata de um guardrail — é a configuração de limites de taxa (rate limit) e orçamentos, oferecendo a cobertura mais completa da lista. As regras correspondem a sujeito, modelo ou metadados e limitam requisições ou tokens por minuto, hora ou dia:
O campo rate_limit_applies_per aceita user, virtualaccount, model ou metadata.*, até dois por regra, garantindo que cada entidade tenha seu próprio contador em vez de competir por um compartilhado. O enforcement usa uma janela deslizante; um limite excedido retorna HTTP 429 com um cabeçalho x-tfy-applied-rules identificando a regra:
LLM09 Desinformação é parcialmente tratável por meio de provedores externos — Patronus AI e Fiddler oferecem avaliadores de alucinação e fidelidade de resposta no hook de saída. Trate-os como um sinal de alerta, não como uma solução definitiva.
LLM05 Manipulação Inadequada de Saídas conta com Code Safety Linter e Secrets Detection no hook de saída. Nenhum deles substitui a validação no próprio código da sua aplicação.
LLM03, LLM04 e LLM08 é onde encerramos o escopo. A cadeia de suprimentos é um problema de aquisição e de pipeline de build; a única contribuição do gateway é controlar quais modelos e servidores MCP existem no seu registry. O envenenamento ocorre durante o treinamento. As fraquezas em vetores residem em um pipeline de RAG no qual o gateway não se posiciona. Se um fornecedor afirmar o contrário, pergunte em qual hook o controle é executado.
Considere um agente de suporte que lê chamados de clientes e faz consultas a um banco de dados de produção via MCP. Quatro dos dez riscos estão ativos, exigindo quatro controles diferentes.
Passo um — registrar os guardrails. Crie um grupo de guardrails e adicione Prompt Injection, PII Detection e Secrets Detection. Se nenhum guardrail nativo se adequar, use um Custom Guardrail apontando para seu próprio endpoint HTTPS:
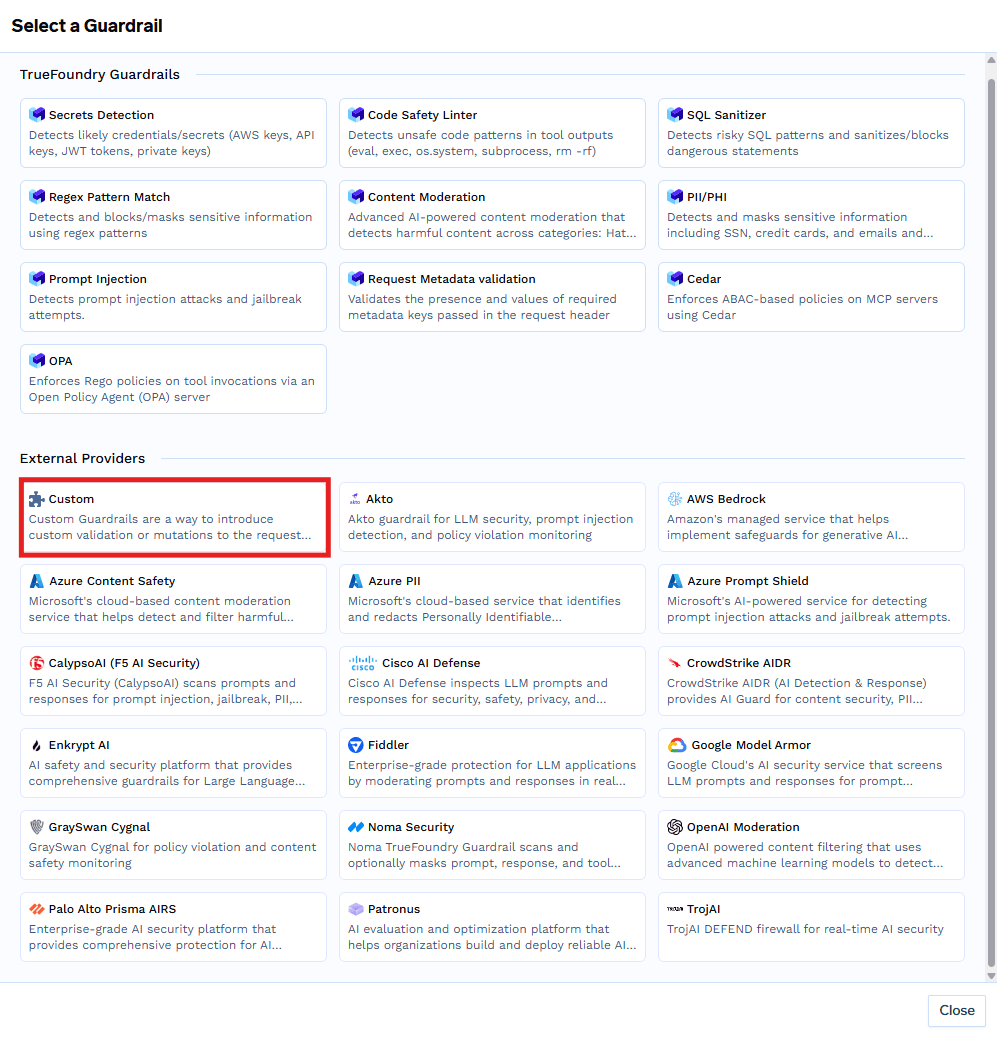
Um guardrail personalizado recebe o requestBody no formato da OpenAI, um objeto config definido no formulário e um contexto contendo o sujeito chamador. Para guardrails de ferramentas MCP, o context.metadata também carrega um objeto claims com declarações verificadas do JWT do chamador, permitindo autorizar por aplicação ou escopo:
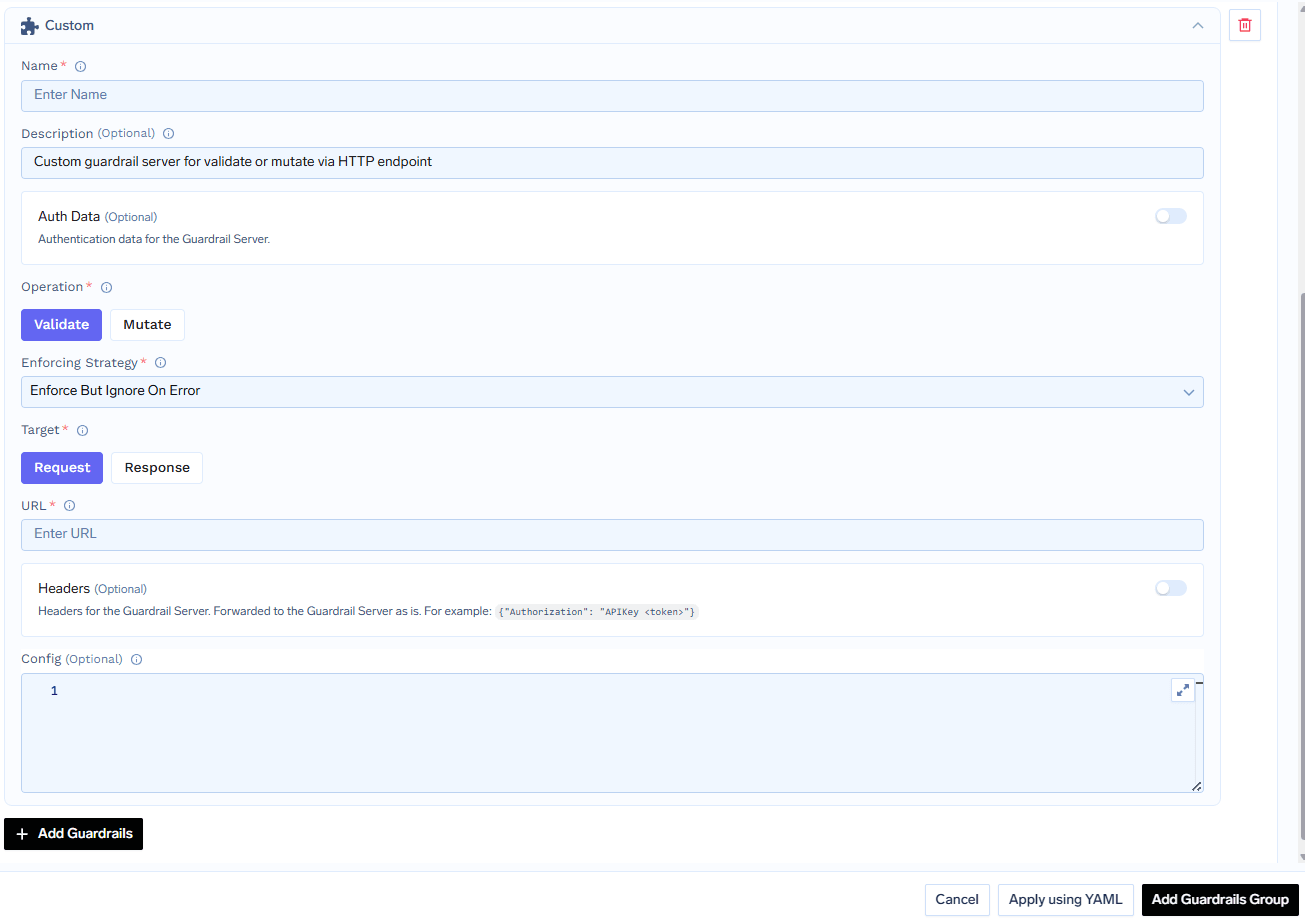
Um detalhe do contrato costuma surpreender: retorne HTTP 2xx com verdict: false para negar a requisição. Um erro 400 é interpretado como um erro de execução (runtime error) e, sob a estratégia enforce_but_ignore_on_error, a requisição será permitida.
Passo dois — escrever a política. Registrar um guardrail não o aplica a nada automaticamente. Em Policies → Guardrails, crie uma regra definindo quais guardrails rodam em quais hooks, para quais modelos, servidores MCP, sujeitos e metadados.
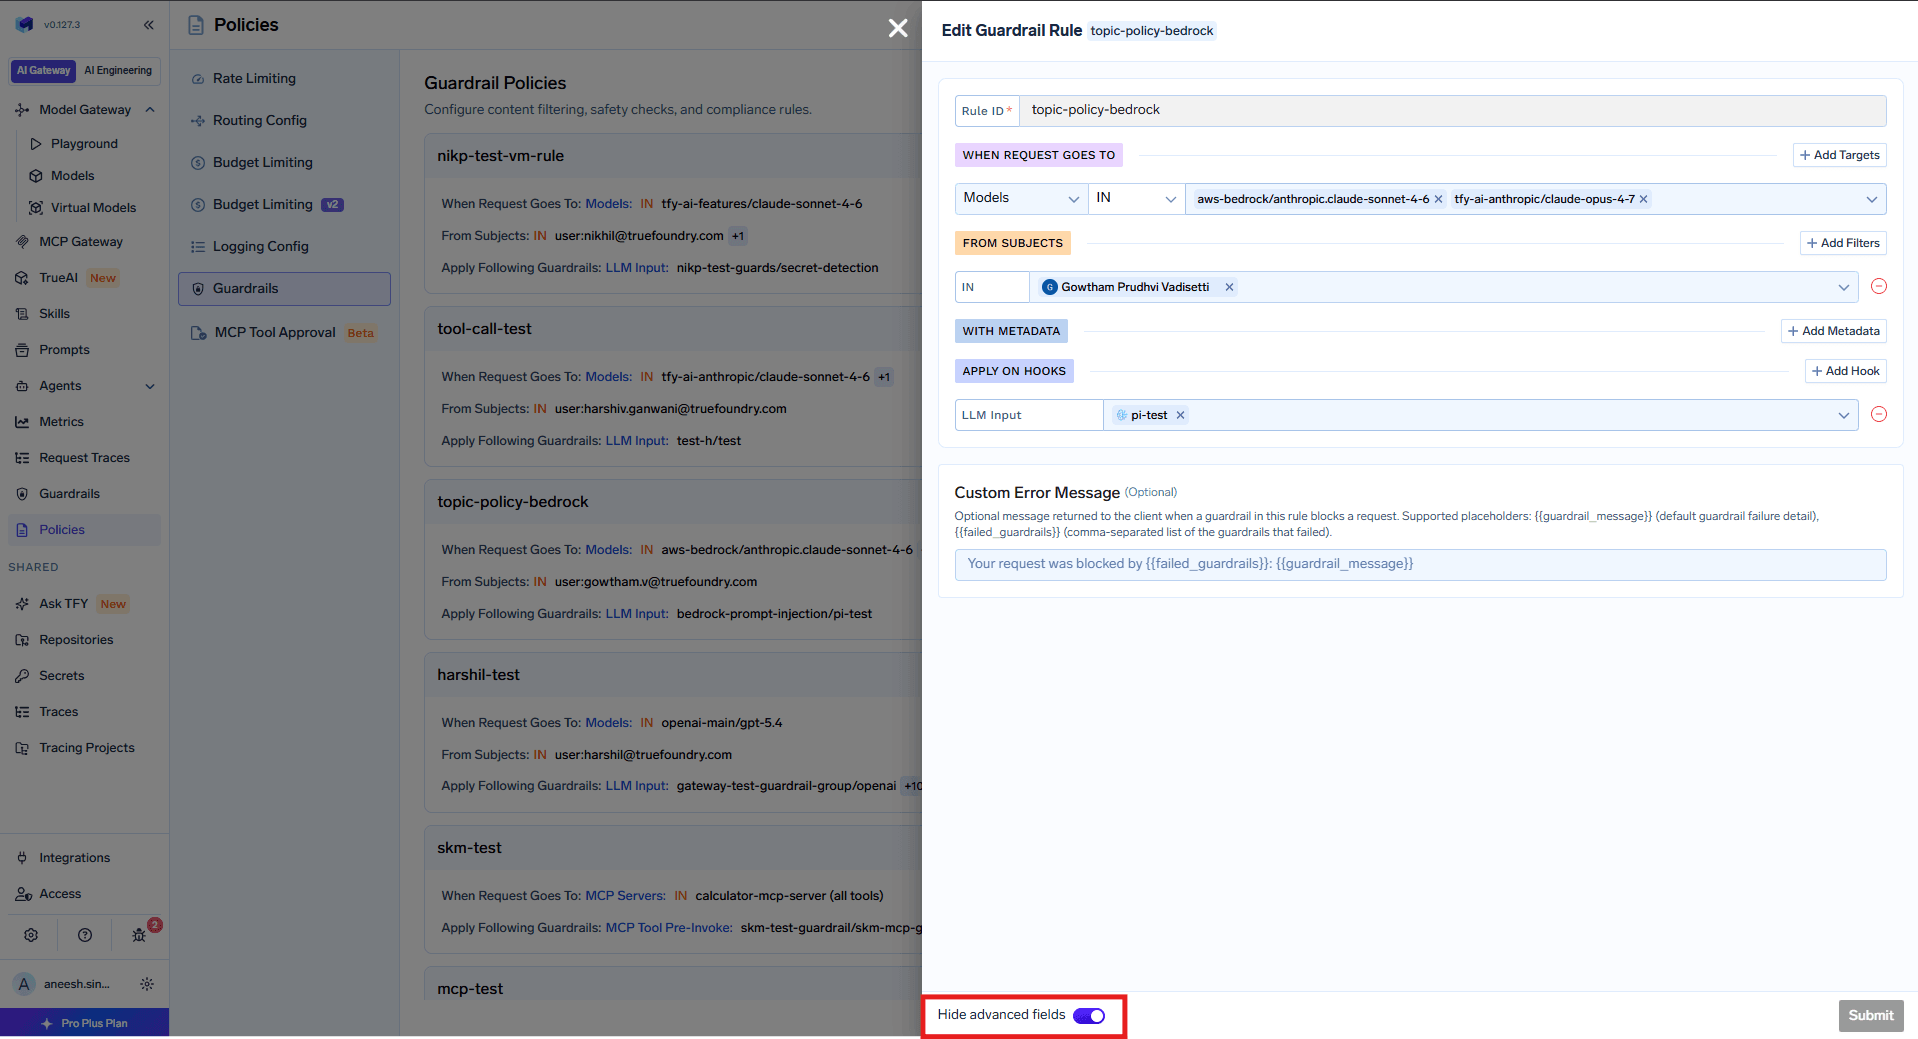
Para este agente: Prompt Injection em LLM Input (LLM01); PII Detection na entrada e Secrets Detection na saída (LLM02); SQL Sanitizer em MCP Pre-Invoke e Secrets Detection em Post-Invoke (LLM06). Uma regra de limite de taxa com rate_limit_applies_per: ['user'] encerra o LLM10.
Todas as regras são avaliadas por requisição e as correspondentes se combinam por hook, portanto, uma regra de linha de base e uma regra de produção mais estrita se aplicam juntas. Uma mensagem personalizada usando {{failed_guardrails}} em Custom Error Message é preferível a expor a saída bruta do provedor.
Passo três — monitore antes de confiar. Inicie todos os guardrails no modo Audit. Cada um aparecerá como seu próprio span em Monitor → Request Traces, com latência, resultado, escopo e descobertas:
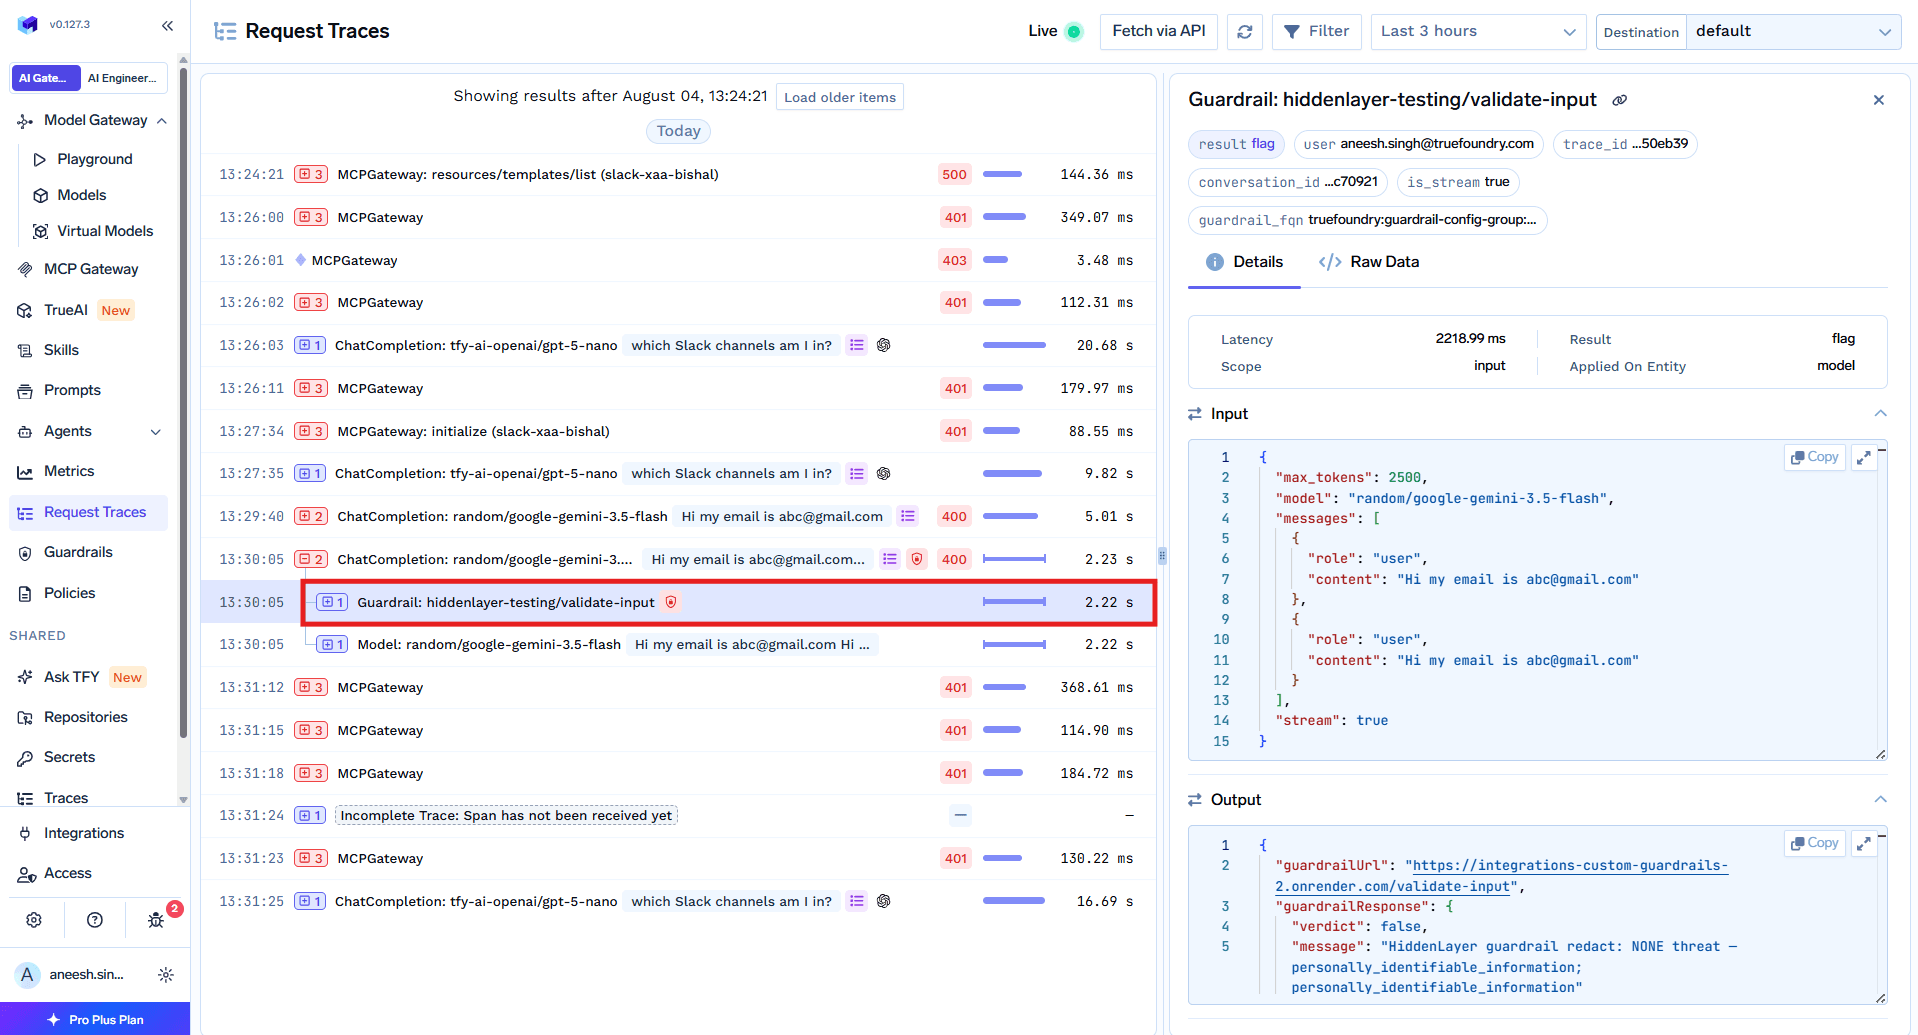
Em seguida, mude para Enforce But Ignore On Error, que bloqueia violações sem permitir que uma queda no provedor derrube sua aplicação. Use o modo Enforce completo apenas onde a conformidade assim o exigir.
Guardrails de saída não são executados em respostas via streaming. Quando stream: true, eles são ignorados completamente — avaliar uma resposta exige o texto completo, e o streaming entrega os tokens à medida que são gerados. Isso afeta a cobertura do LLM02 e do LLM05, pois as interfaces de chat comumente implantadas usam streaming por padrão. Nesses casos, defina stream: false onde as verificações de saída forem críticas, valide no lado do cliente ou aceite que seus controles de hook de saída estarão inativos nesse cenário. Os guardrails de entrada não são afetados.
Prompts do sistema são excluídos dos guardrails por padrão. O gateway os remove antes de enviar o conteúdo para qualquer guardrail, portanto eles nunca são inspecionados, bloqueados ou redigidos. O CrowdStrike AIDR é a única exceção — ele visualiza o prompt do sistema, mas nunca o modifica. É importante saber disso para o LLM07: o gateway monitora a tentativa de exfiltração na entrada e segredos na saída, mas não o prompt do sistema em si.
Onde as falhas de validação geram custos. A validação de entrada é executada em paralelo com a requisição ao modelo; se ela falhar, o gateway cancela a chamada em andamento para que você não pague por ela. A validação de saída ocorre após a resposta chegar — o bloqueio protege seu usuário, mas os tokens já foram consumidos.
Três recursos nativos são exclusivos para SaaS. Content Moderation, PII / PHI Detection e Prompt Injection não estão disponíveis em implantações auto-hospedadas. Existem alternativas — Azure Prompt Shield ou Palo Alto Prisma AIRS para injection, Azure PII ou CrowdStrike para PII, OpenAI Moderations ou Bedrock Guardrails para moderação — mas eles exigem suas próprias credenciais.
O OWASP LLM Top 10 é uma excelente lista frequentemente mal utilizada. Como taxonomia, ela informa o que pode dar errado e aproximadamente em qual ordem você deve se preocupar. Como um checklist para marcar com uma única compra, ela produz uma matriz de controle que aparenta estar completa, mas não defende nada.
A pergunta útil não é "este produto cobre o Top 10", mas sim "quais destes dez ocorrem no caminho da requisição e há algo monitorando ali?". Quatro ocorrem. Um gateway é o lugar correto para esses quatro e o único local onde você pode aplicá-los de forma unificada em todos os modelos, equipes e agentes, em vez de exigir que dez equipes de aplicação façam isso individualmente.
Para os outros seis, identifique o responsável. A cadeia de suprimentos pertence a quem aprova os modelos. O envenenamento pertence a quem executa o treinamento. As fraquezas em vetores pertencem a quem construiu o índice. Anote os nomes ao lado dos riscos. Esse documento tem mais valor do que qualquer promessa de cobertura de fornecedores, incluindo a nossa.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Uma lista de consenso dos dez riscos de segurança mais críticos em aplicações de LLM, do OWASP GenAI Security Project. A versão atual é a lista de 2025: injeção de prompt, divulgação de informações sensíveis, cadeia de suprimentos, envenenamento de dados e de modelos, tratamento inadequado de saídas, agência excessiva, vazamento do prompt de sistema, fraquezas de vetores e embeddings, desinformação e consumo ilimitado. É uma orientação, não uma certificação — não há auditoria para passar.
Não. Um gateway fica no caminho da requisição, então trata bem os riscos desse caminho: injeção de prompt, divulgação de informações sensíveis, agência excessiva e consumo ilimitado. Ele ajuda em parte com o tratamento inadequado de saídas, a desinformação e a cadeia de suprimentos. O envenenamento e as fraquezas de vetores ocorrem em pipelines de treinamento e de recuperação que um gateway nunca toca.
Principalmente por meio de LLM06 Excessive Agency e LLM01 Prompt Injection. Uma chamada de ferramenta MCP é o ponto em que um prompt comprometido se transforma em uma ação real, então os controles que importam ficam no caminho da ferramenta: um hook mcp_pre_tool que valida os argumentos antes da execução, um hook mcp_post_tool que limpa os resultados antes que o modelo os veja, lista de permissões em nível de ferramenta e aprovação em chamadas destrutivas. O TrueFoundry executa os guardrails em cada chamada de ferramenta separadamente, e não uma vez por conversa.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.
Sim. Ele inclui um MCP Gateway, um Agent Gateway e um MCP & Agents Registry com controle de acesso em nível de ferramenta. Agentes criados com LangGraph, CrewAI, AutoGen ou um framework próprio podem ser governados de forma centralizada.
Sim. O gateway é compatível com OpenTelemetry e se integra com Grafana, Datadog, Prometheus ou a sua stack preferida. Ele rastreia cada requisição, do prompt à execução da ferramenta e do modelo, para que você obtenha logs unificados sem precisar remover o que você já usa.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















