August 31, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
À medida que os grandes modelos de linguagem (LLMs) passam da experimentação para a produção, as equipes estão repensando como o tráfego de IA deve ser gerenciado, protegido e observado. O que antes parecia uma simples integração de API agora envolve prompts, tokens, roteamento de modelos, novas tentativas, rastreamento de custos e preocupações com a confiabilidade que a infraestrutura de aplicativos tradicional nunca foi projetada para lidar.
Muitas equipes de engenharia iniciam essa jornada estendendo gateways de API familiares, como Kong, aproveitando padrões existentes de roteamento, autenticação e limitação de taxa. À medida que o uso de LLMs cresce, gateways nativos de IA, como Portkey entram em cena, oferecendo abstrações adaptadas a prompts, modelos e observabilidade em nível de token.
Ambas as abordagens visam resolver problemas reais, mas partem de pontos de partida fundamentalmente diferentes. Kong está enraizado na gestão de APIs HTTP e microsserviços, enquanto Portkey é projetado especificamente para fluxos de trabalho de aplicativos LLM. As diferenças entre essas filosofias tornam-se cada vez mais importantes à medida que os sistemas de IA escalam entre equipes, ambientes e casos de uso em produção.
Neste artigo, comparamos Kong e Portkey em termos de arquitetura, observabilidade, governança e prontidão empresarial. Analisaremos onde cada ferramenta se encaixa melhor, onde as limitações começam a surgir e o que as equipes de plataforma devem considerar à medida que a IA se torna uma parte central de sua pilha de infraestrutura.
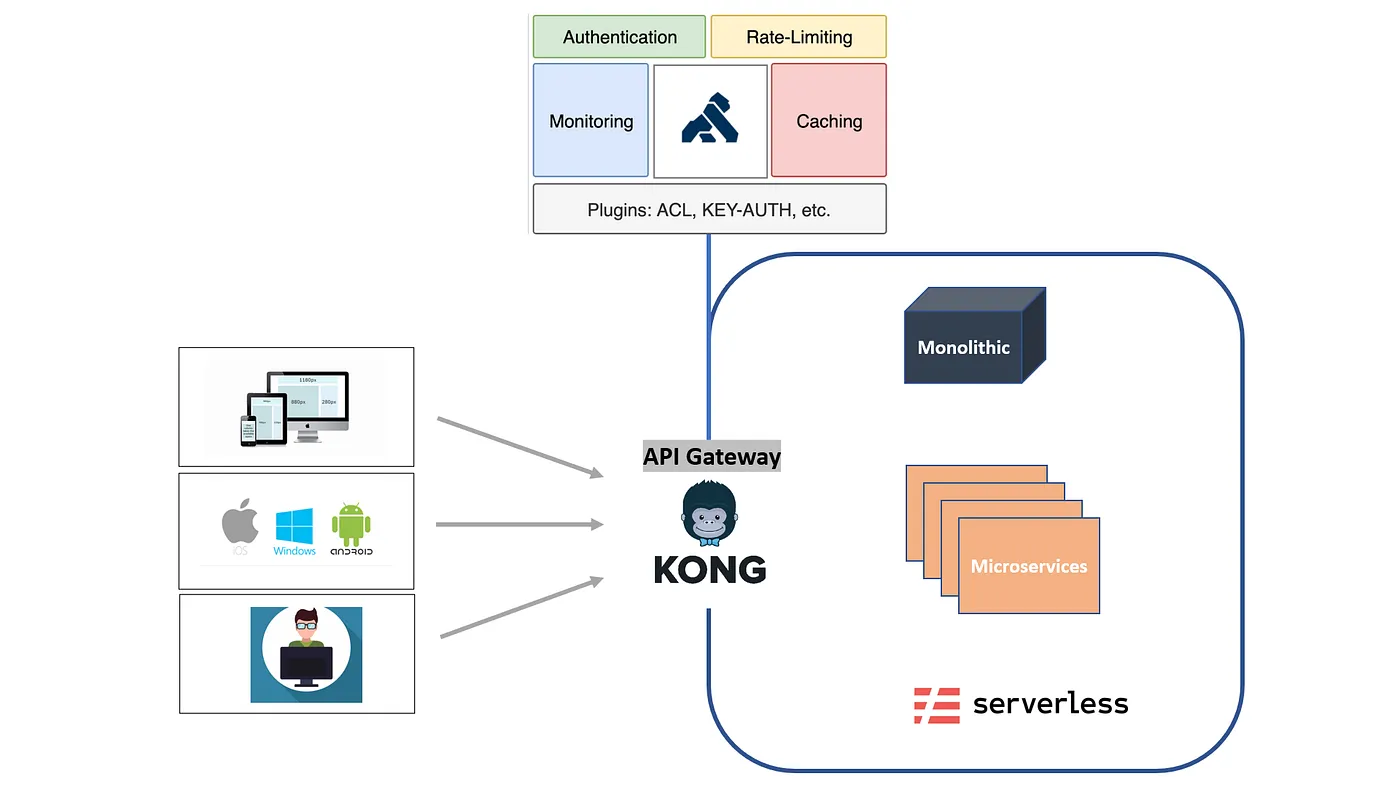
Kong é um gateway de API amplamente adotado, construído para gerenciar, proteger e rotear o tráfego HTTP entre microsserviços. É comumente usado como uma camada de entrada em arquiteturas baseadas em Kubernetes e é conhecido por lidar com questões como autenticação, limitação de taxa, roteamento de tráfego e observabilidade em nível de solicitação.
Do ponto de vista arquitetônico, Kong é otimizado para sistemas API-first. Suas abstrações centrais giram em torno de endpoints, serviços, rotas e plugins — tornando-o uma ótima opção para ambientes tradicionais de backend e microsserviços onde as solicitações são sem estado, previsíveis e uniformes.
À medida que as equipes introduzem LLMs, o Kong é frequentemente a primeira ferramenta reaproveitada para gerenciar o tráfego de IA – tratando as chamadas de LLM como apenas mais um endpoint de API. Isso funciona inicialmente para:
No entanto, o tráfego de LLM introduz propriedades que não se mapeiam de forma limpa para APIs tradicionais.
À medida que o uso de IA cresce além da experimentação simples, essas lacunas tornam-se cada vez mais visíveis, especialmente em ambientes multi-equipe ou sensíveis a custos.
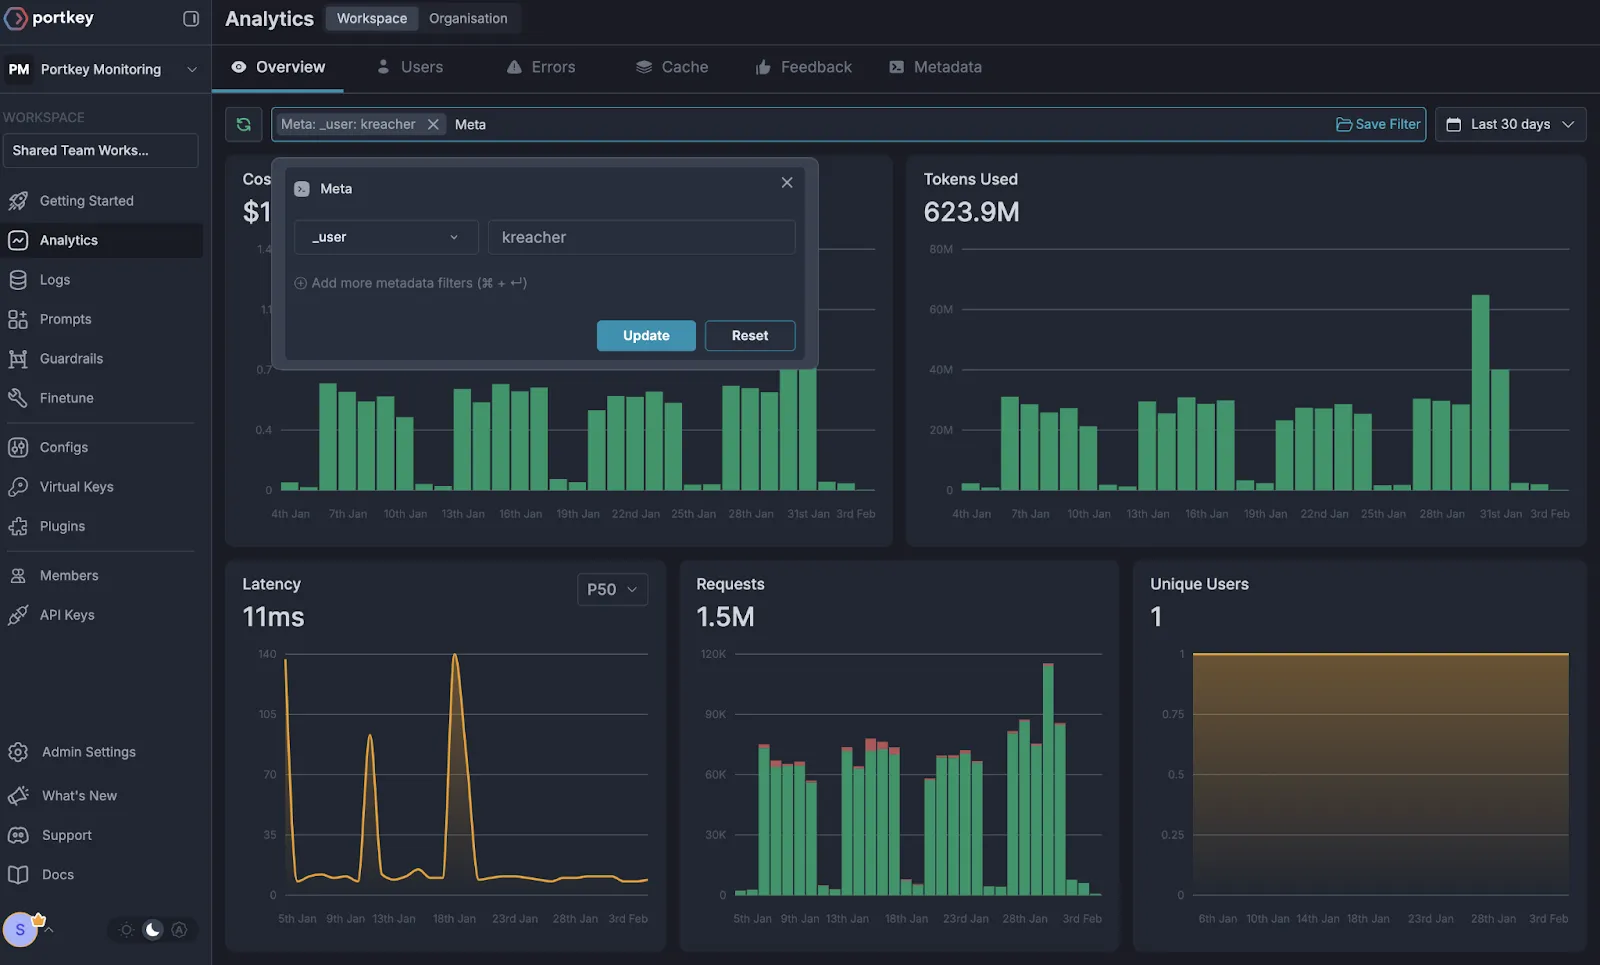
Portkey é um gateway nativo de IA projetado especificamente para aplicações construídas sobre grandes modelos de linguagem. Em vez de tratar as chamadas de LLM como requisições de API genéricas, o Portkey introduz abstrações que estão alinhadas com a forma como as aplicações de IA realmente funcionam - prompts, modelos, tokens e provedores.
Em sua essência, o Portkey atua como uma camada intermediária entre aplicações de IA e múltiplos provedores de LLM. Ele permite que os desenvolvedores alternem entre modelos, roteiem o tráfego e observem o uso sem acoplar fortemente o código da aplicação à API de um provedor específico.
Comparado a gateways de API como o Kong, o Portkey é sensível a LLM por design. Ele entende que:
Isso torna o Portkey uma excelente escolha para equipes que desenvolvem e iteram sobre aplicativos baseados em LLM, especialmente em ambientes de produção em estágio inicial ou intermediário.
À medida que o uso de LLMs se expande entre equipes e ambientes, algumas limitações surgem:
Essas restrições tornam-se importantes quando a IA deixa de ser um recurso de aplicativo para se tornar uma capacidade empresarial compartilhada.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
Enquanto Kong e Portkey podem atuar como front-end para cargas de trabalho de IA, mas são construídos com base em premissas arquitetônicas muito diferentes. Compreender essa diferença é fundamental para as equipes de plataforma que decidem como escalar a IA para além de uma única aplicação.
O Kong é uma boa escolha se:
Nesta configuração, o Kong funciona como uma extensão temporária da infraestrutura de API existente.
O Portkey se encaixa bem quando:
Portkey se destaca na camada de aplicação, especialmente para equipes de produto de IA ágeis.
Ambos Kong e Portkey abordam desafios reais na pilha de IA, mas o fazem em camadas diferentes e, em última análise, limitadas. Essas limitações tornam-se aparentes à medida que a IA evolui de um recurso de aplicação único para uma capacidade empresarial compartilhada abrangendo múltiplas equipes, ambientes e limites regulatórios.
Kong foi projetado para governar requisições de API, não o comportamento da IA. Prompts, tokens, seleção de modelo e execução de agente são opacos para o gateway.
Portkey introduz controles cientes de LLM, mas a governança permanece em grande parte no âmbito da aplicação.
As equipes de IA corporativa, no entanto, precisam de respostas para perguntas como:
Nem Kong nem Portkey fornecem governança de IA em toda a organização como um recurso de primeira classe.
Os custos de IA são moldados por uma combinação de:
Kong não tem visibilidade sobre esses fatores de custo específicos de IA.
Portkey expõe métricas em nível de token, mas a atribuição de custos torna-se cada vez mais difícil à medida que o uso se estende por várias equipes, aplicações e ambientes.
Sem atribuição em nível de infraestrutura, as equipes de plataforma e finanças têm dificuldade em responder a uma pergunta básica: quem está gastando o quê e por quê?
Sistemas de IA em produção exigem separação rigorosa entre:
O Kong não foi construído com o isolamento de ambiente de IA em mente.
O Portkey otimiza os fluxos de trabalho de aplicativos em vez de impor limites rígidos de ambiente.
Para empresas em setores regulados, essa falta de isolamento rapidamente se torna um impedimento para a implantação.
As implantações de IA corporativa devem satisfazer requisitos como:
Essas restrições devem ser impostas na camada de infraestrutura, não incorporadas ao código do aplicativo ou tratadas manualmente pelas equipes.
O Kong trata o tráfego de IA como requisições HTTP genéricas.
O Portkey pressupõe um uso prioritário da nuvem, em nível de aplicativo.
Nenhuma das abordagens é projetada para implantações de IA com foco em conformidade.
A IA em produção não se limita mais a chamadas síncronas de prompt-resposta. Os sistemas do mundo real incluem:
Gateways que se concentram apenas no tráfego de API ou no roteamento de prompts não conseguem governar o ciclo de vida completo das cargas de trabalho de IA.
À medida que a adoção da IA amadurece, as empresas chegam à mesma conclusão: Os gateways por si só não são suficientes. A execução de IA em produção exige uma camada de infraestrutura que unifique acesso, implantação, observabilidade, governança e conformidade. É por isso que as organizações acabam por ir além dos gateways de API e dos gateways de aplicação LLM em direção a plataformas de infraestrutura nativas de IA construídas para escala empresarial
As limitações de Kong e Portkey decorrem da mesma causa raiz: ambos foram projetados para resolver problemas de gateway, não problemas de infraestrutura de IA empresarial.
À medida que a IA se torna uma capacidade partilhada e crítica para a produção, as empresas precisam de mais do que encaminhamento de tráfego ou abstração de prompts. Elas precisam de uma plataforma que trate governança de IA, implantação, observabilidade e segurança como preocupações de infraestrutura de primeira classe. É aqui que TrueFoundry se destaca.
TrueFoundry é construído em torno da ideia de que as cargas de trabalho de IA devem ser gerenciadas como qualquer outro sistema de produção crítico, mas com primitivas nativas de IA. Em vez de operar apenas no caminho da requisição, TrueFoundry funciona como um plano de controle de IA unificado.
Em um nível elevado, TrueFoundry reúne:
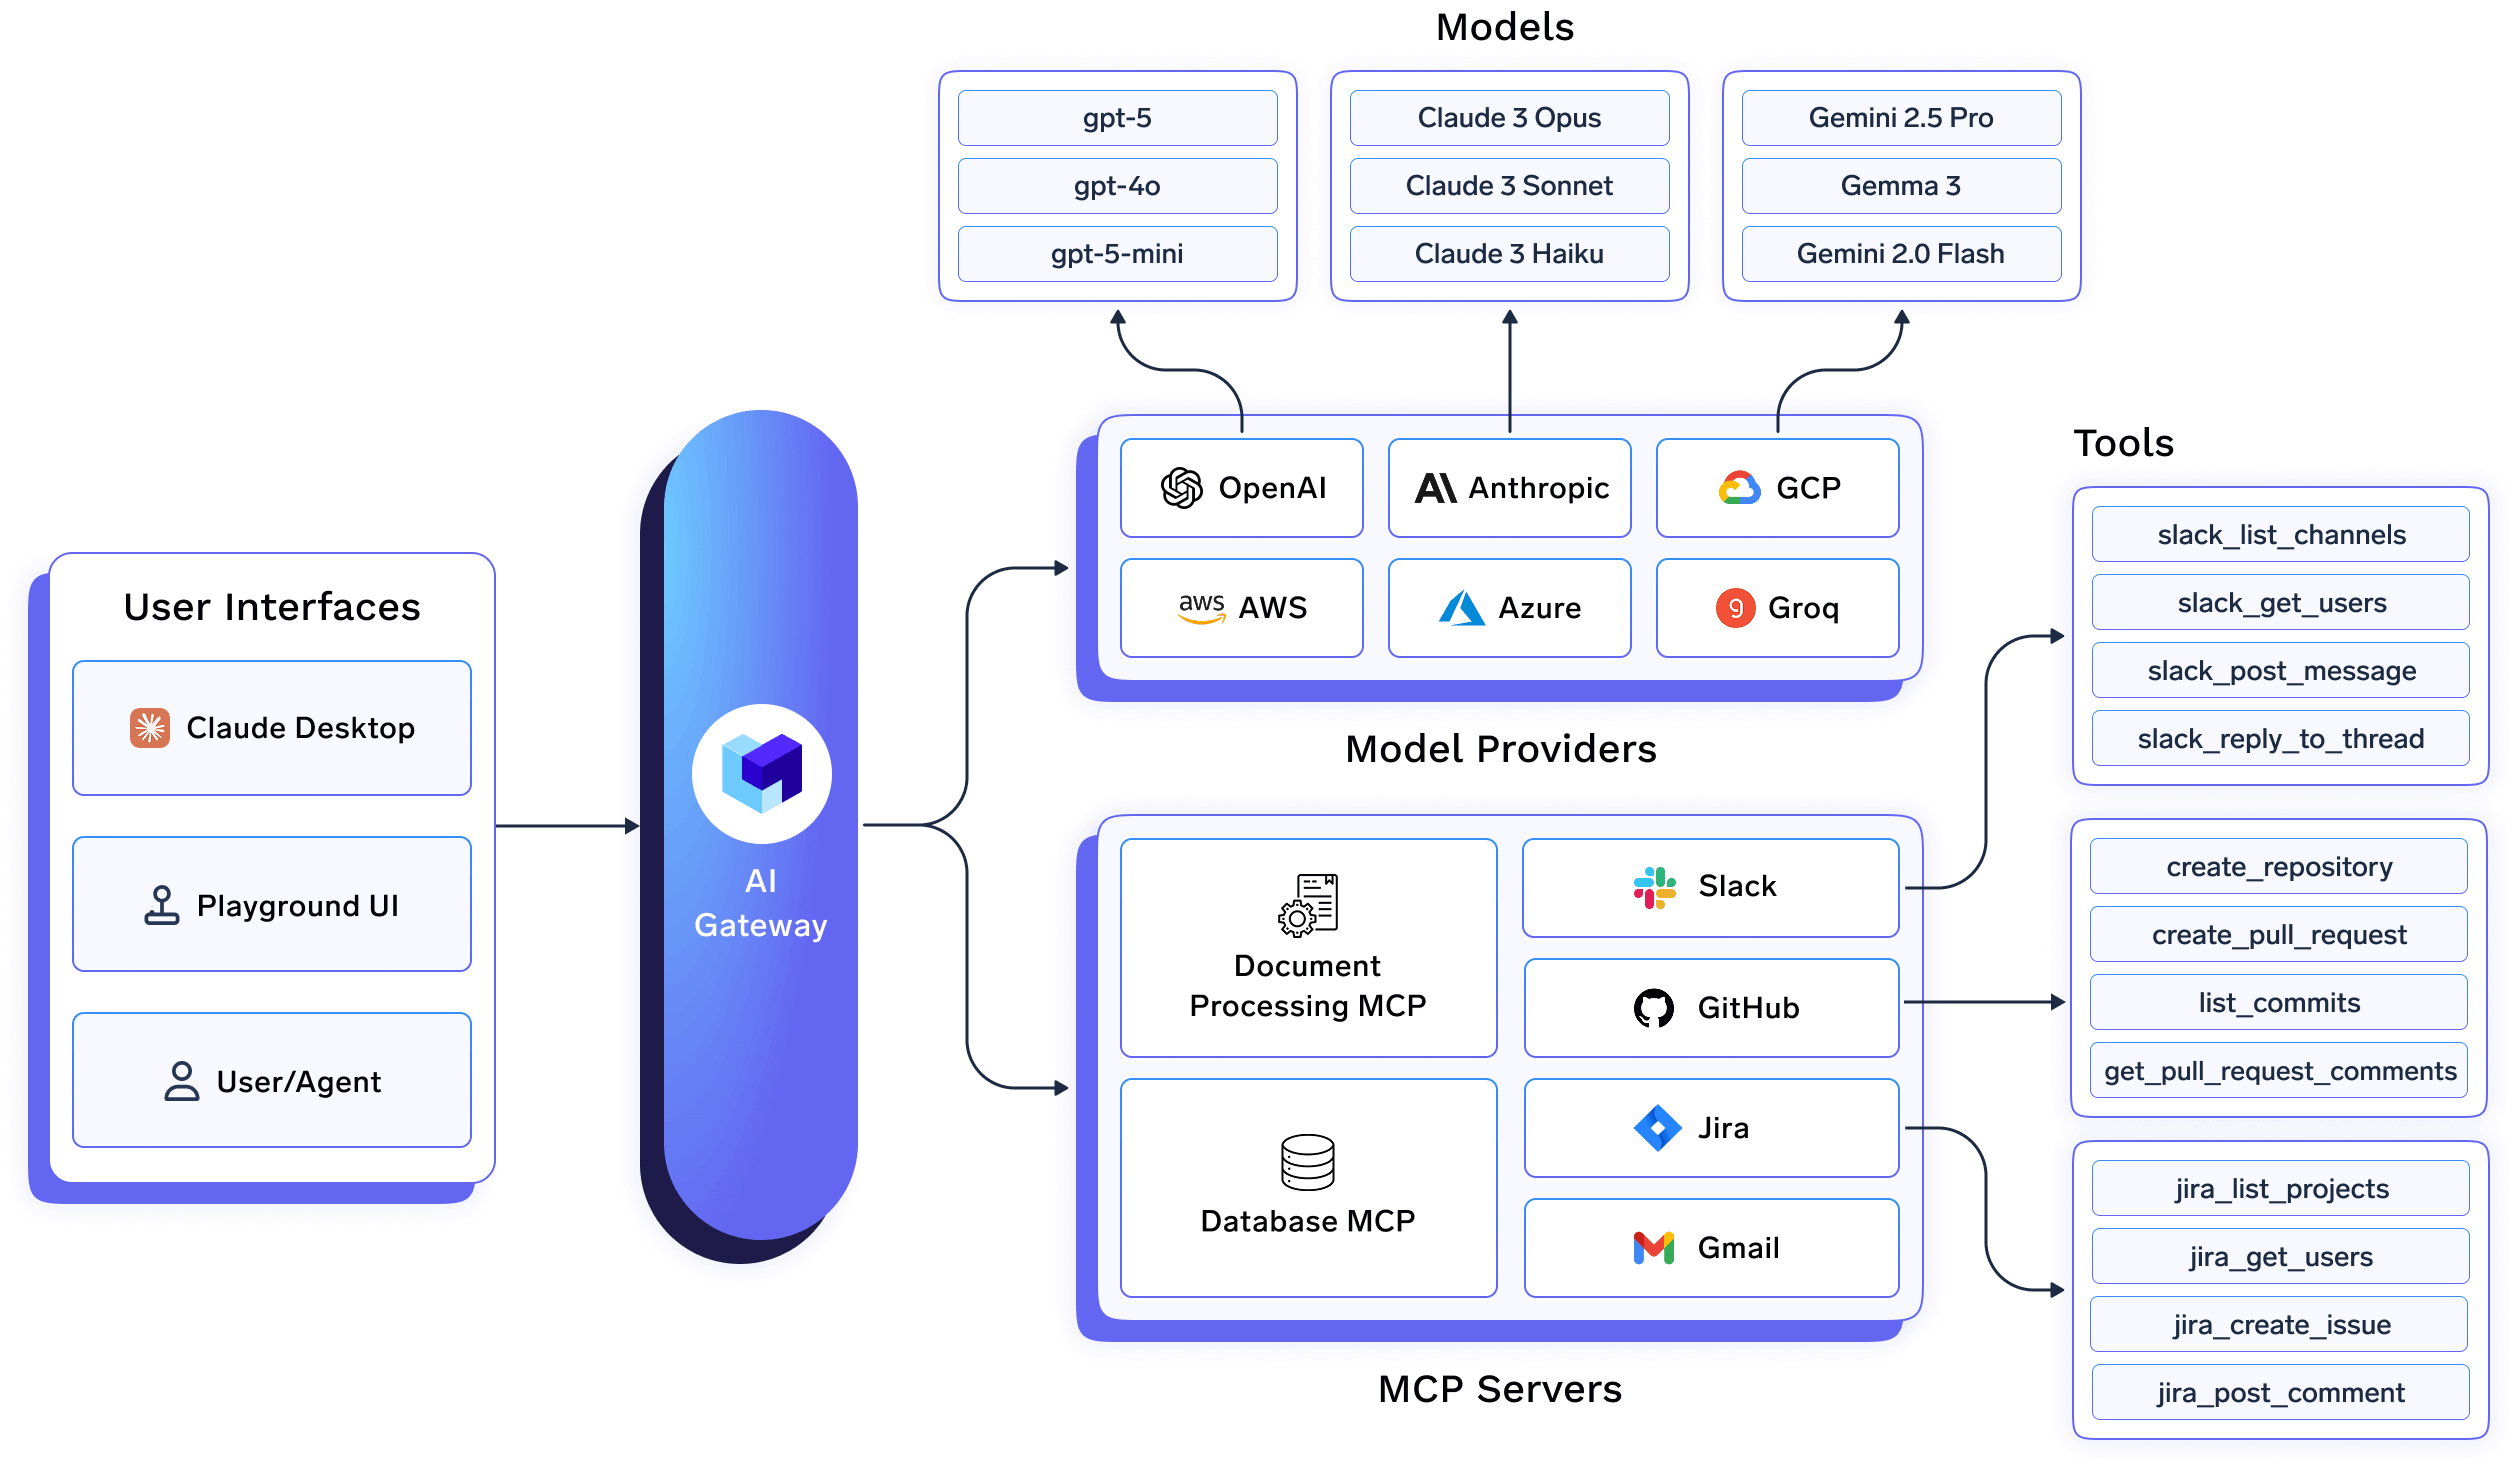
Em muitas pilhas de IA, o uso de LLMs é tratado como um problema de integração de API: as requisições são roteadas, autenticadas e registradas, mas tudo além do limite da requisição é deixado para as aplicações individuais. A TrueFoundry adota uma abordagem diferente, tratando os serviços, tarefas e agentes de cargas de trabalho de IA como objetos de infraestrutura com ciclo de vida, propriedade e limites operacionais.
Em vez de apenas decidir se uma requisição deve ser permitida, a TrueFoundry controla onde os sistemas de IA são executados, como eles são executados e sob quais restrições, desde a implantação até o tempo de execução. Essa mudança do roteamento de requisições para o controle do ciclo de vida é o que permite uma governança consistente à medida que o uso da IA escala.
Concretamente, isso se manifesta em várias dimensões críticas.
Em arquiteturas centradas em gateway, políticas de acesso são tipicamente incorporadas no código da aplicação, na configuração do SDK ou em regras de gateway por serviço. Isso rapidamente se torna frágil à medida que equipes, serviços e ambientes se multiplicam.
TrueFoundry aplica políticas de acesso e uso no nível do espaço de trabalho e do ambiente. Modelos, agentes e ferramentas são definidos para ambientes como desenvolvimento, homologação e produção, com permissões e controles aplicados consistentemente em todas as cargas de trabalho implantadas nesse ambiente.
Como as políticas estão vinculadas a ambientes em vez de aplicações individuais:
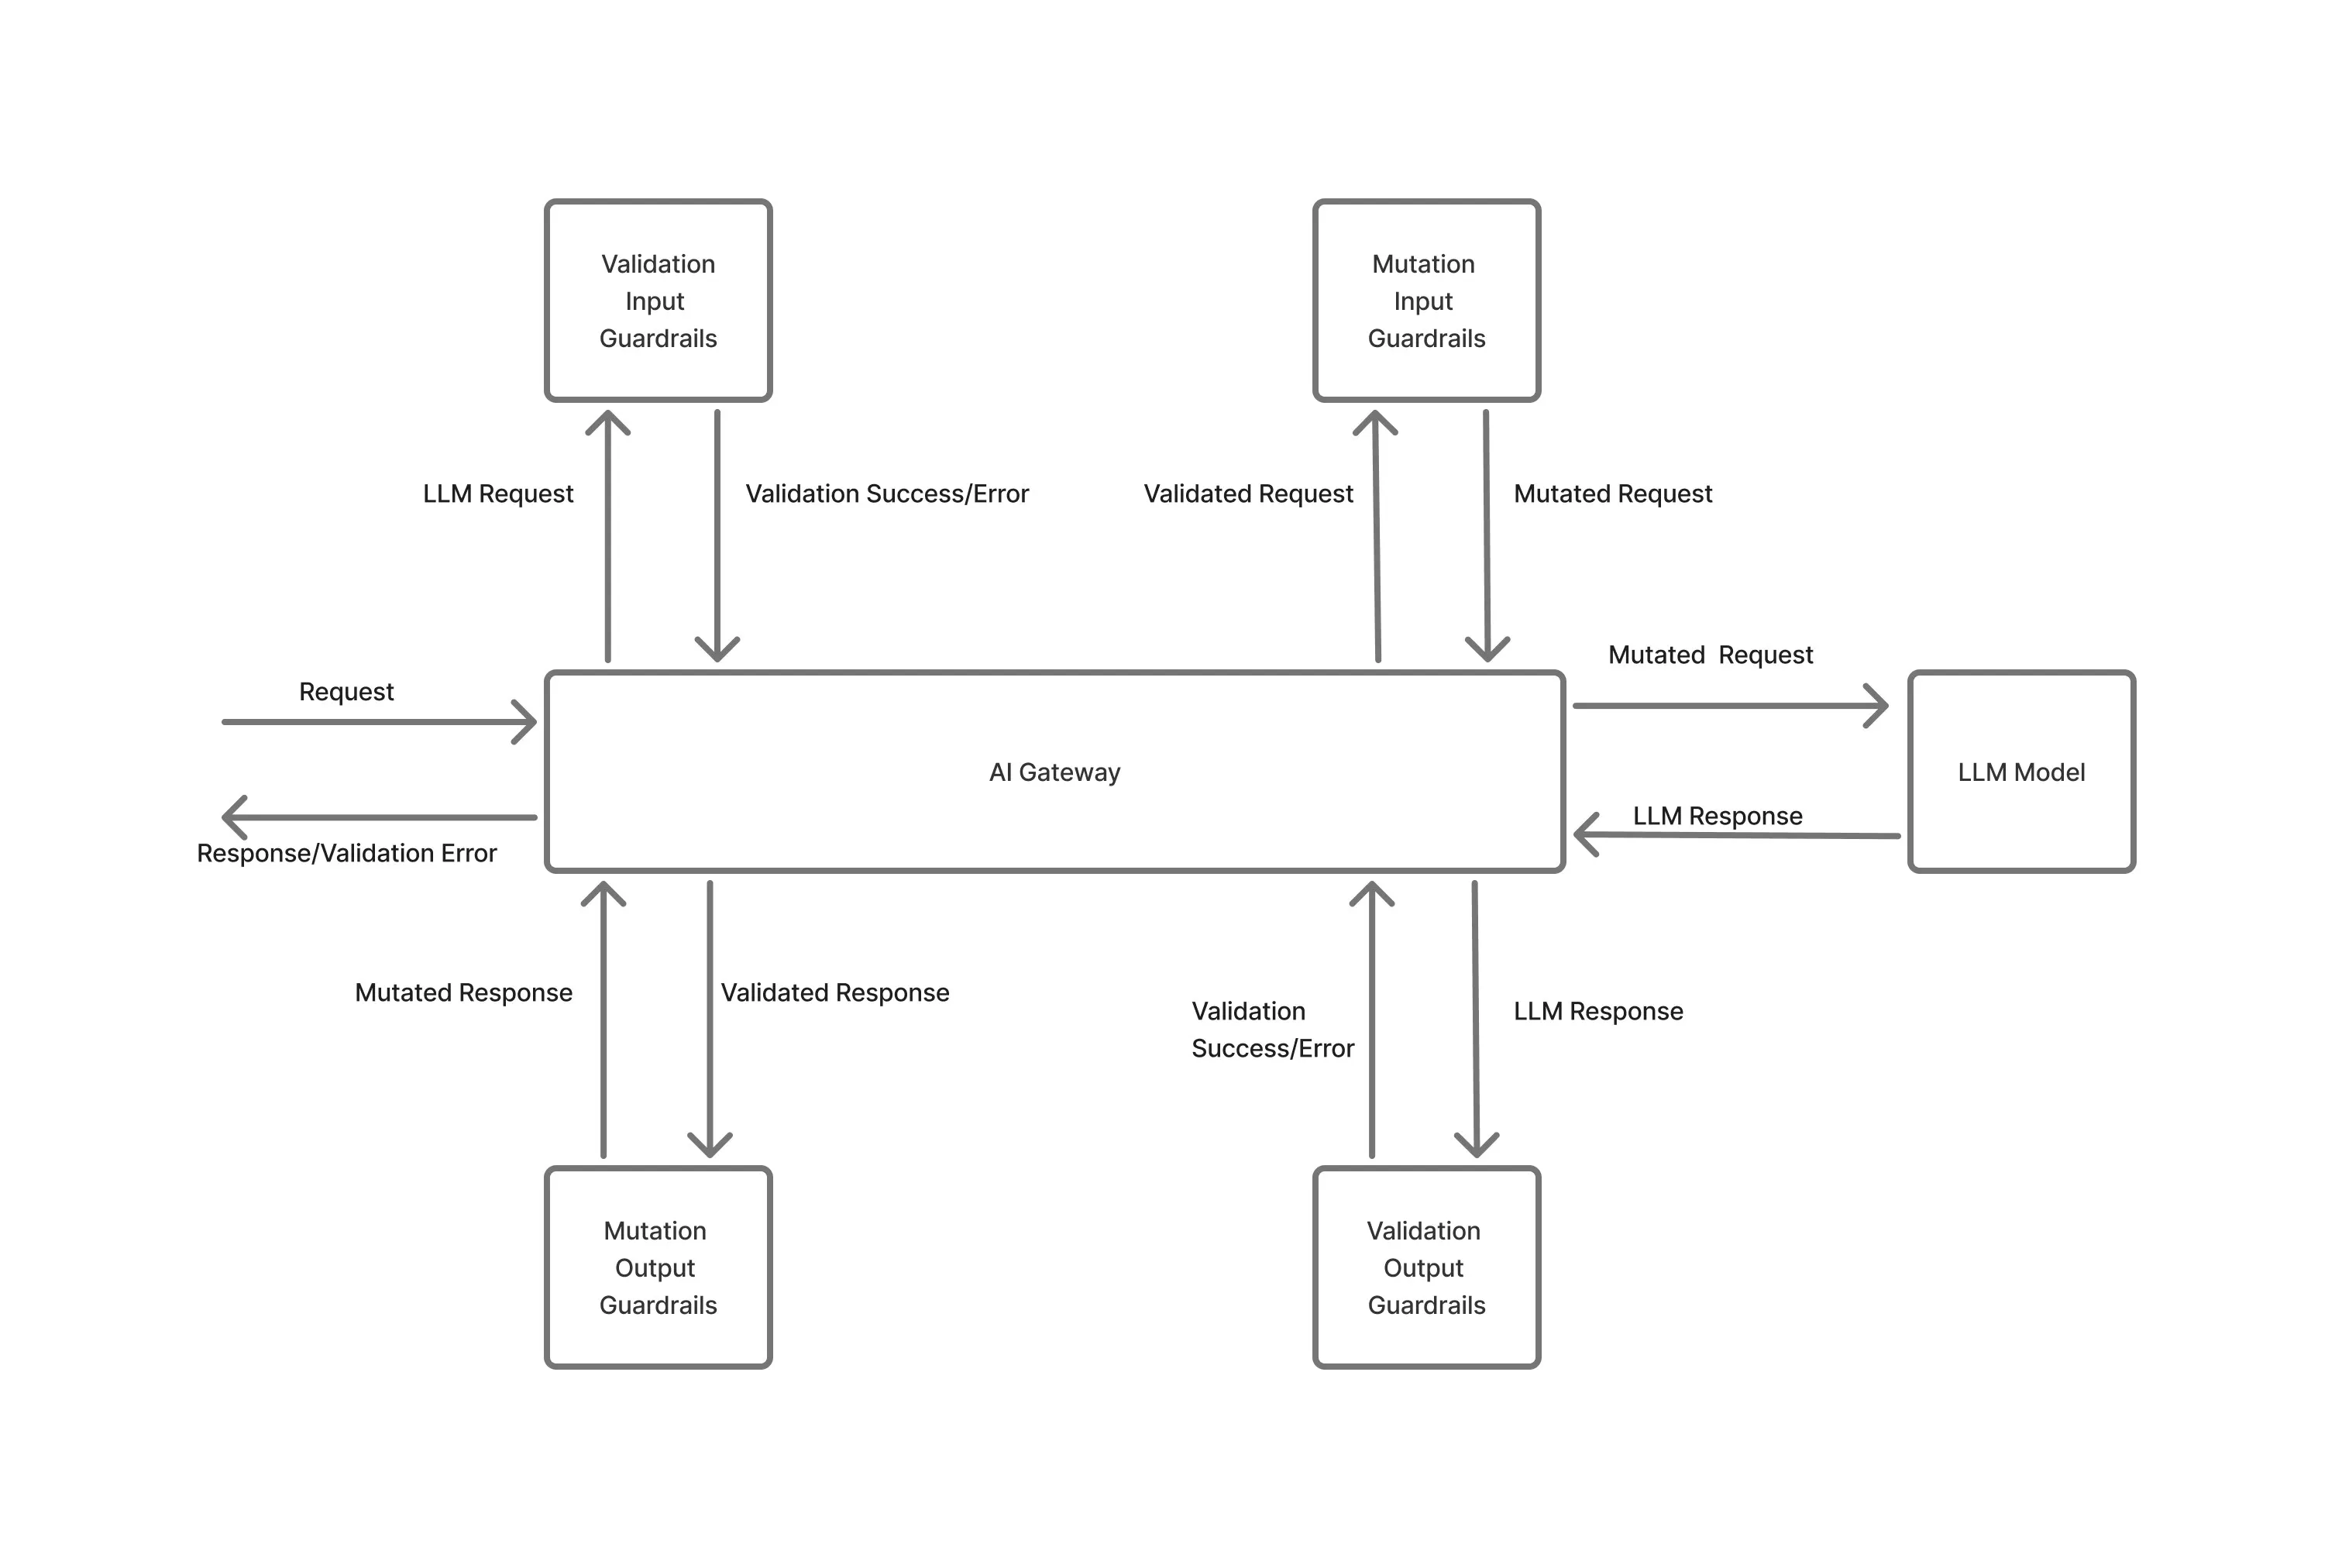
Sistemas de IA falham em produção não porque uma única solicitação é inválida, mas porque o uso se acumula de maneiras inesperadas através de picos de concorrência, tempestades de novas tentativas ou cargas de trabalho em segundo plano executadas em escala.
TrueFoundry aplica barreiras de uso em tempo de execução, com visibilidade sobre como as cargas de trabalho se comportam em tempo de execução. Limites de concorrência, restrições de throughput e limites de uso são aplicados centralmente em serviços e tarefas que compartilham modelos ou infraestrutura subjacentes.
Como esses limites são aplicados na camada da plataforma:
Isso é fundamentalmente diferente dos controles do lado do cliente ou do nível do SDK, que assumem que as aplicações se comportam corretamente e de forma independente.
A TrueFoundry impõe isolamento na camada de implantação e ambiente, não apenas na admissão de requisições. Serviços de IA, tarefas em lote e fluxos de trabalho de agentes são implantados como cargas de trabalho isoladas dentro de ambientes definidos, com acesso, políticas e recursos delimitados por ambiente.
Essas cargas de trabalho são executadas como implantações e tarefas separadas com processos de tempo de execução e domínios de falha independentes, em vez de compartilhar um único contexto de execução plano por trás de um gateway. Como resultado:
Gateways LLM em nível de aplicação, que operam principalmente no caminho da requisição, não controlam a execução em tempo de execução ou o estado da infraestrutura. Como resultado, eles não podem fornecer este nível de isolamento de implantação e ambiente — uma questão que se torna cada vez mais visível à medida que as cargas de trabalho de IA escalam entre equipes e ambientes de produção.

Métricas em nível de token são úteis, mas insuficientes quando as cargas de trabalho de IA abrangem serviços de longa duração, tarefas em segundo plano e fluxos de trabalho de agentes. Em sistemas de produção, custo e desempenho surgem da interação entre:
A TrueFoundry correlaciona esses sinais na camada da plataforma, permitindo que as equipes compreendam o comportamento da IA da mesma forma que compreendem outros sistemas de produção—por ambiente, serviço e proprietário, não por chamadas de API individuais.
Muitas implementações de IA empresariais operam sob restrições que os gateways de nível de aplicação implicitamente desconsideram, incluindo:
O plano de controle da TrueFoundry foi projetado para operar em todos esses modelos de implantação, garantindo que a governança, o isolamento e a observabilidade permaneçam consistentes independentemente de onde a inferência é executada. Como resultado, as propriedades de conformidade - como limites de dados e auditabilidade - são aplicadas como parte da própria infraestrutura, em vez de serem adicionadas posteriormente por meio de lógica de aplicação ou controles de processo.
Kong e Portkey resolvem problemas importantes em diferentes estágios da adoção de IA. Kong estende padrões familiares de gateway de API para o tráfego de IA, enquanto Portkey introduz abstrações nativas de LLM que facilitam a construção e operação de aplicações baseadas em IA.
No entanto, à medida que a IA se torna uma capacidade compartilhada e crítica para a produção, as empresas rapidamente encontram desafios que vão além do roteamento de requisições ou do gerenciamento de prompts. Governança, atribuição de custos, isolamento de ambiente e conformidade, todos exigem controles no nível da infraestrutura, e não apenas no gateway.
É por isso que muitas organizações vão além dos gateways de aplicação de API e LLM em direção a plataformas de infraestrutura nativas de IA, como TrueFoundry, que são projetadas para executar, governar e escalar sistemas de IA de forma confiável entre equipes e ambientes.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada