



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
O campo de agentes tem um problema de vocabulário. Após uma temporada na qual "harness", "scaffold", "skill" e "agent" significavam algo diferente em cada conversa, a Hugging Face publicou um glossário amplamente compartilhado que oferece ao campo um vocabulário de trabalho útil. Vale a pena ler. Mas um glossário responde a "o que significa essa palavra?" — e a pergunta seguinte, aquela com a qual as equipes de plataforma realmente convivem, é "onde essa coisa mora na minha stack?" Este post pega esse vocabulário de trabalho e mapeia cada termo para a peça de infraestrutura de produção que o implementa. As palavras vêm de um vocabulário comunitário emergente; a fiação é o que as equipes de produção precisam concretizar.
Elif, uma líder de engenharia de plataforma, observou uma reunião de comitê executivo consumir quarenta minutos em uma pergunta que não deveria ter precisado de cinco: "quantos agentes nós temos?" A engenharia contou as implantações de harness e disse nove. A equipe de dados contou prompts-com-ferramentas e disse trinta e poucos. O slide de um fornecedor contou cada fluxo de trabalho com uma chamada de LLM e disse duzentos. Ninguém estava errado por sua própria definição; ninguém compartilhava uma definição. A mesma reunião tropeçou em saber se uma "skill" era uma ferramenta, se o novo "sub-agent" era um agente para fins de inventário, e o que exatamente a equipe estava comprando quando um produto dizia "harness incluído". A conclusão da Elif não foi de que seus colegas eram desleixados. Foi de que as palavras do campo haviam se movido mais rápido do que seu entendimento compartilhado — e que até que as palavras fossem fixadas a coisas na stack, cada conversa sobre arquitetura seria secretamente uma briga de vocabulário.
A comunidade tem trabalhado para esclarecer essas definições — de forma mais visível no glossário de agentes da Hugging Face, que surgiu exatamente dessa confusão no ICLR 2026 e no qual nos apoiaremos (e daremos crédito) ao longo deste texto. O que este post adiciona é a segunda coluna que a Elif precisava: para cada termo, o componente de produção que o implementa, e a governança que se conecta a ele uma vez que se torna infraestrutura real em vez de um rótulo de diagrama. Isso não é um substituto para o glossário da Hugging Face; é a coluna de infraestrutura ao lado dele. Percorreremos a stack de dentro para fora — model, scaffold, harness, agent — e depois o vocabulário de trabalho ao seu redor: context engineering, o espectro tool/skill/sub-agent, policy, e os termos de treinamento que acabam importando na produção também. Quatro análises aprofundadas seguem este post; este é o mapa.
Comece onde o glossário começa. O model é o próprio LLM: texto entra, texto sai, sem memória entre chamadas, sem loop, sem capacidade de realmente executar nada. Ele pode expressar a intenção de chamar uma ferramenta — emitir uma requisição estruturada —, mas algo fora dele precisa executar essa ferramenta e fornecer o resultado de volta. Chamar o modelo de "o agente" é o erro de categoria original: o modelo é o motor de raciocínio, e por si só ele responde a um prompt e para.
Em termos de produção, o modelo é também a parte mais intercambiável — e é precisamente por isso que ele deve ficar atrás de uma abstração. Na TrueFoundry, os modelos são endereçados pelo nome através da API única compatível com OpenAI do AI Gateway: modelos de fronteira comerciais, modelos de pesos abertos auto-hospedados e checkpoints ajustados (fine-tuned) atrás de uma interface de gateway comum, com RBAC, orçamentos, observabilidade e guardrails aplicados centralmente onde o tráfego flui pelo gateway. A consequência arquitetônica de "o modelo é apenas um componente" é que trocá-lo deve ser uma mudança de configuração — o tema do nosso post sobre API unificada — e tudo o mais neste glossário é o que permanece no lugar quando você o troca.
Aqui está a distinção que o glossário existe para fazer, e a que mais causa confusão na prática. O scaffold é a camada definidora de comportamento a partir da qual o modelo trabalha: o prompt do sistema, as descrições das ferramentas, os formatos de saída que ele deve seguir, as regras para o que é transportado entre as etapas. Ele molda como o modelo vê o seu mundo. O harness é a camada de execução que faz o agente rodar: o loop que chama o modelo, faz o parse de suas requisições de ferramentas, realmente as executa, fornece os resultados de volta, lida com erros e decide quando parar. Scaffold é instrução; harness é maquinário. Produtos como o Claude Code frequentemente usam "harness" de forma solta para tudo o que não é o modelo, o que é aceitável como atalho — a distinção justifica seu valor quando você precisa raciocinar sobre as camadas separadamente, e na produção você faz isso constantemente: uma edição de prompt é uma mudança de scaffold que você pode implantar em minutos; uma mudança nas condições de parada ou no tratamento de erros é uma mudança de harness com raio de impacto.
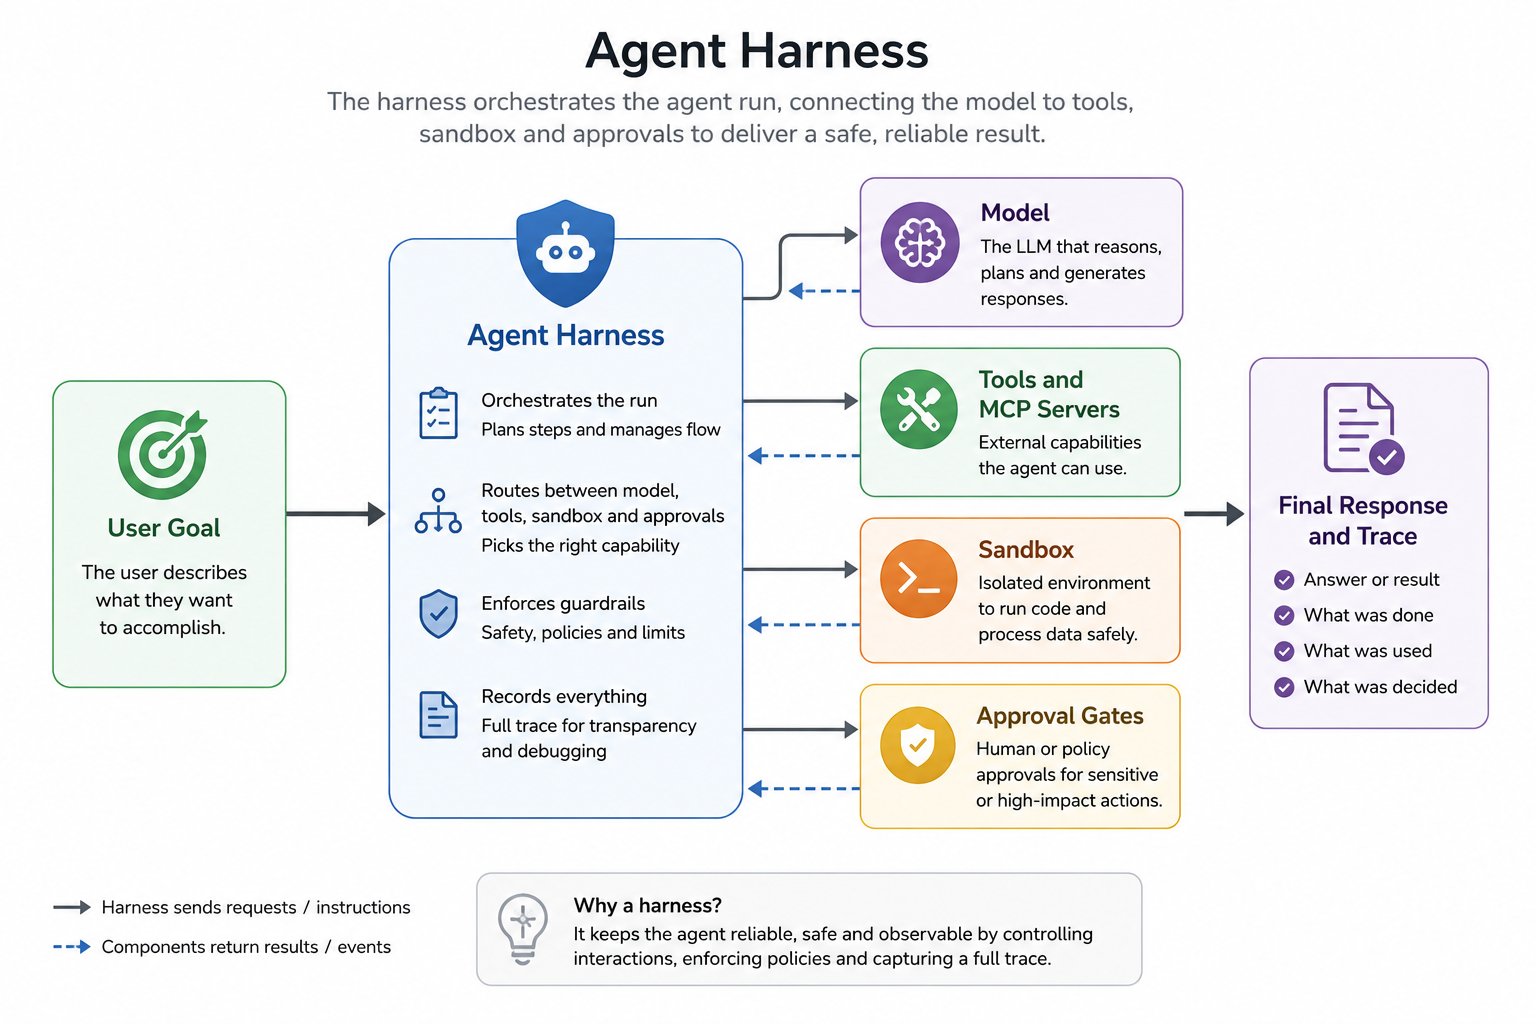
Na TrueFoundry, as duas camadas têm duas casas diferentes, o que por si só é esclarecedor. Artefatos de scaffold — instruções, versões de prompt, descrições de ferramentas, skills — são conteúdos gerenciados: versionados, revisáveis, controlados por RBAC. O harness é o runtime gerenciado: o Agent Harness da TrueFoundry executa o loop plan→act→observe, executa ferramentas através de gateways governados, gerencia o sandbox, impõe alças de aprovação (approval gates) e registra as etapas das execuções governadas do Agent Harness. Você cria o scaffold; a plataforma opera o harness. A análise aprofundada que segue este post é inteiramente sobre essa divisão e a disciplina que a comunidade agora chama de engenharia de harness (harness engineering).
Com essas duas camadas nomeadas, o agente deixa de ser místico: um agente é um model mais tudo ao seu redor que o permite agir em vez de apenas responder — a formulação que a comunidade sintetiza como agent = model + harness. A linhagem é o aprendizado por reforço (RL), onde um agente é simplesmente aquilo que toma observações e retorna ações em um loop; a versão LLM mantém esse loop e preenche a etapa de "decisão" com um modelo. Duas consequências práticas decorrem dessa equação, e ambas valem a pena ser internalizadas.
Primeiro, o que os usuários vivenciam como um "produto de agente" é frequentemente o harness e o scaffold ao redor do modelo. Quando dois produtos construídos sobre o mesmo modelo subjacente parecem completamente diferentes, a diferença é o harness e o scaffold — o design do loop, o gerenciamento de contexto, os conjuntos de ferramentas. O modelo, o harness e o produto são três coisas diferentes, e avaliar "um agente" sem dizer em qual harness ele rodou é quase sem sentido. Segundo, o inventário se torna possível. A pergunta da Elif "quantos agentes nós temos?" passa a ter uma resposta uma vez que um agente é uma coisa concreta e registrada: uma definição (model + scaffold + concessões de ferramentas) mais um runtime. Para agentes executados através do Agent Harness da TrueFoundry, o agente se torna uma definição registrada referenciando um modelo, servidores MCP e skills por nome, com credenciais mantidas no plano do gateway em vez de embutidas na definição — o que torna a porção governada do patrimônio de agentes contável e auditável em vez de um debate sobre vocabulário.
Uma definição de agente, anotada com o glossário (ilustrativo)
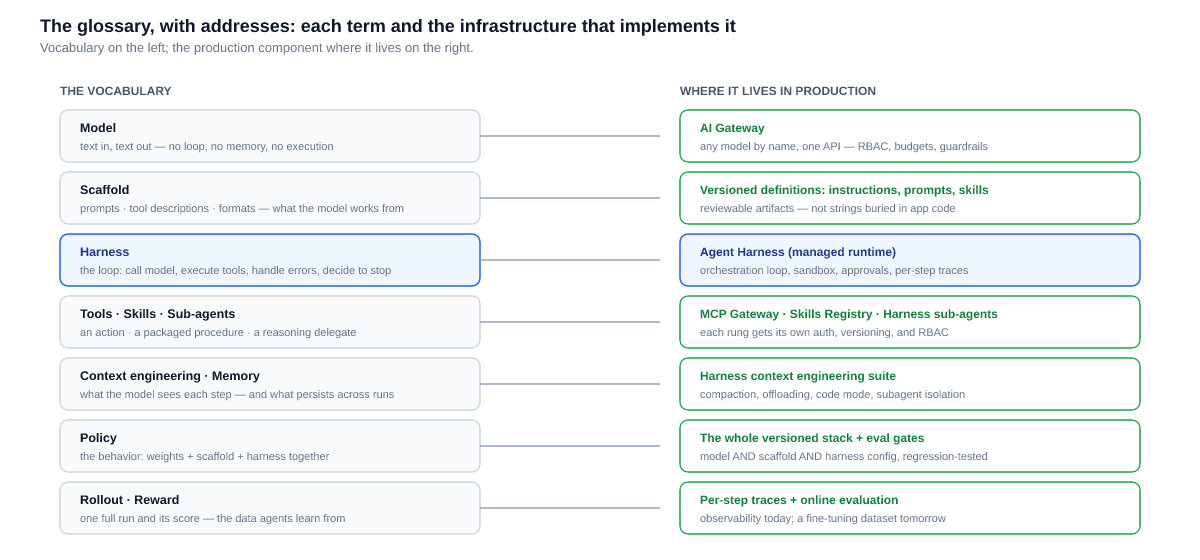
Dê um passo atrás do runtime e todo o vocabulário se alinha da mesma forma: cada termo à esquerda é um conceito, e cada um tem uma casa de produção concreta à direita.
Context engineering é a disciplina de decidir o que o modelo vê em cada etapa: quais instruções, quais descrições de ferramentas, qual fatia do histórico, quais fatos recuperados. Não é uma decisão de prompt única, porque em um agente o contexto é vivo — a saída de cada turno molda a entrada do próximo turno, e um harness que não gerencia ativamente essa acumulação assiste seu agente se degradar à medida que a janela se enche. O glossário divide o lado da memória de forma clara: memória de curto prazo é o que permanece na janela durante uma execução; memória de longo prazo persiste entre sessões externamente e é recuperada de volta quando relevante.
Na produção, essa é uma responsabilidade do harness, não do autor do prompt — nenhum humano pode curar manualmente o contexto de uma execução de 40 etapas. O Agent Harness da TrueFoundry oferece uma suíte de context-engineering que faz a curadoria automaticamente: a compactação sumariza um transcrito longo e continua; o descarregamento de grandes resultados (large-result offloading) mantém uma resposta massiva de ferramenta fora da janela e a carrega sob demanda; o modo de código (code mode) permite que o agente processe dados volumosos com código em vez de lê-los para o contexto; sub-agents (próxima seção) isolam subtarefas em janelas novas. Nós cobrimos o modo de falha que isso previne — que a comunidade chama de degradação de contexto (context rot) — em seu próprio post; aqui o mapeamento é o ponto: "context engineering" nomeia um trabalho que, em um runtime gerenciado, o harness faz por você.
O esclarecimento mais praticamente útil do glossário é a linha entre três coisas que parecem todas "o agente fazendo algo". Uma tool é uma ação: uma única chamada de função — execute este comando, consulte esta API — executada pelo harness e devolvida. Uma skill é conhecimento empacotado: um procedimento estruturado e reutilizável para uma meta de várias etapas ("investigue o bug, forme uma hipótese, escreva a correção"), carregado no contexto sob demanda em vez de executado como uma única chamada. Um sub-agent é um delegado de raciocínio: um agente invocado por outro agente, com seu próprio modelo, scaffold e contexto, que trabalha a subtarefa de forma independente e retorna um resultado. A linha se altera entre frameworks — o glossário diz isso honestamente —, mas o espectro em si é estável: ação, procedimento, delegado.
A razão pela qual a distinção importa na produção é que cada degrau precisa de uma governança diferente. Uma tool precisa de autenticação e autorização por chamada — que é o que o MCP Gateway oferece: registro, autenticação central, RBAC por ferramenta, guardrails pré/pós-chamada. Uma skill precisa de versionamento e procedência — quem escreveu este procedimento, qual versão um agente está rodando —, que é o que o Skills Registry da TrueFoundry oferece: artefatos SKILL.md versionados com RBAC, montados sob demanda. Um sub-agent precisa de identidade e contexto delimitado — seu próprio trace, suas próprias permissões, isolamento da janela do pai —, o que o Agent Harness oferece nativamente. Achate o espectro em "ferramentas" e você governará um delegado de raciocínio como uma chamada de função; a análise aprofundada sobre este espectro desmonta cada degrau.
Policy é o termo mais discreto do glossário e, para as equipes de operações, talvez o mais importante. Emprestado do RL, uma policy é o próprio comportamento — para qualquer situação, o que o sistema fará. A frase crucial é que, em agentes baseados em LLM, apenas parte da policy está nos pesos do modelo: o restante é determinado pelo scaffold e pelo harness. O mesmo checkpoint atrás de um prompt de sistema diferente, descrições de ferramentas diferentes ou um loop diferente é, comportamentalmente, uma policy diferente. Uma policy não é um agente — a policy é o comportamento; o agente é o sistema implantado cujo comportamento ela representa.
Leve isso a sério e um hábito operacional comum desmorona: rastrear "qual versão do modelo está em prod" como se isso respondesse a "o que o sistema fará". Isso responde a um terço da pergunta. A tradução de "policy" para a produção é que a stack inteira que determina o comportamento — nome do modelo, prompts, conjunto e descrições de ferramentas, skills, configuração do harness — é uma coisa única versionada, alterada deliberadamente e testada contra regressão em conjunto, porque uma edição de prompt de uma linha é uma mudança de policy exatamente como uma troca de modelo é. Esse é o argumento do quarto post desta série; a infraestrutura que torna isso tratável são definições como artefatos (a definição declarativa de agente do Agent Harness), versionamento de prompts e o loop de avaliação online que captura uma mudança de comportamento, qualquer que seja a camada que a causou.
A última seção do glossário cobre o vocabulário de treinamento em RL — environment, trainer, rollout, reward — e é tentador para uma equipe de produção ignorá-la. Não faça isso, porque dois dos termos descrevem coisas que você já possui. Um rollout é uma execução completa do agente, de ponta a ponta: o que o agente viu, o que ele fez, o que retornou, etapa por etapa. As equipes de produção chamam isso de trace. Um reward é a pontuação que diz se uma execução foi boa — verificável (testes passam, resposta coincide) ou aprendida (preferências, LLM-como-juiz). As equipes de produção chamam isso de sinal de eval. O pipeline de treinamento e o loop de produção têm o mesmo formato; um atualiza pesos e o outro atualiza painéis (dashboards).
A consequência vale a pena ser refletida: se o seu harness registra traces completos por etapa e sua camada de avaliação os pontua, você já está coletando a matéria-prima para datasets de rollout/reward — traces mais sinais de qualidade que podem ser curados para ajuste fino (fine-tuning) ou melhoria no estilo RL. Equipes que auto-hospedam modelos de pesos abertos (nosso post sobre auto-hospedagem) podem fechar esse loop deliberadamente: traces do Agent Harness, pontuações da camada de eval, fine-tuning na TrueFoundry, o checkpoint aprimorado implantado atrás do mesmo nome de gateway. O post final desta série aborda esse loop na íntegra. A lição de vocabulário é mais simples: "rollout" e "reward" não são jargões de treinamento de outras pessoas — são a sua observabilidade, vista a partir do futuro.
A reunião de quarenta minutos da Elif não foi desperdiçada por ignorância; foi desperdiçada por ambiguidade, e a ambiguidade no vocabulário se torna ambiguidade nos sistemas. Quando "agent" não tem um referente fixo, o inventário de agentes não pode existir. Quando "harness" pode significar um produto, um loop ou tudo-exceto-o-modelo, uma conversa de comprar versus construir sobre harnesses são três conversas usando o mesmo disfarce. Quando "skill" e "tool" se confundem, o modelo de governança se confunde com eles — e a capacidade desprotegida é exatamente como os problemas de descontrole e agentes paralelos (shadow-agents) começam. Fixar as palavras é o primeiro passo barato para fixar a arquitetura.
O mapeamento que este post adiciona é o segundo passo: cada termo deve ter um endereço. Na TrueFoundry, ele tem — models atrás do AI Gateway, ferramentas atrás do MCP Gateway, skills no Skills Registry, o loop e sub-agents no Agent Harness, context engineering como maquinário do harness, policy como o todo versionado, rollouts como traces alimentando a avaliação. Nada disso exige a TrueFoundry especificamente; exige alguma resposta concreta para "onde esta palavra mora, e quem a governa lá". Os quatro posts que seguem abordam os termos mais ricos um de cada vez: harness versus scaffold, o espectro tool/skill/sub-agent, policy como a coisa que você realmente versiona, e o loop de rollout para reward na produção.
"agent = model + harness" é a definição oficial? Não existe um órgão oficial, e o próprio glossário é cuidadoso ao dizer que muitos termos carecem de definições universalmente aceitas — diferentes frameworks realmente usam as mesmas palavras de forma diferente. É melhor lido como um modelo de trabalho útil e utilizável: ele separa de forma clara o motor de raciocínio do maquinário que o faz agir, que é a separação de que a arquitetura de produção precisa. Trate isso como um modelo de trabalho, dê crédito à fonte e espere refinamentos.
Onde termina o scaffold e começa o harness? A linha mais clara: scaffold é a partir de onde o modelo trabalha (prompts, descrições de ferramentas, formatos — conteúdo); harness é o que faz o agente rodar (o loop, execução, tratamento de erros, parada — maquinário). Produtos frequentemente dizem "harness" para ambos, o que é aceitável até que você precise mudar um sem o outro. Na prática, a linha também é uma linha de propriedade: autores são donos do scaffold; a plataforma é dona do harness.
Um sub-agent é apenas uma ferramenta da perspectiva de quem chama? Mecanicamente, ele é frequentemente invocado como uma, e é por isso que os termos se confundem. A diferença é o que está do outro lado: uma ferramenta executa uma função; um sub-agent raciocina — ele tem seu próprio modelo, scaffold, contexto e possivelmente suas próprias ferramentas. Essa diferença é invisível para o código que chama e enorme para a governança: um sub-agent precisa de identidade, permissões e rastreamento próprios, não apenas de uma entrada na lista de ferramentas do pai.
As equipes de produção realmente precisam dos termos de RL? Dois deles, sim. Em termos de produção, um rollout se parece com um trace e um reward se parece com uma pontuação de eval — vocabulário para coisas que você já produz. Conhecer a estrutura de treinamento importa no dia em que você quiser que seus agentes melhorem a partir do seu próprio histórico: traces completos mais pontuações de qualidade são a matéria-prima, e equipes que os capturaram bem têm um dataset onde outras têm apenas logs.
Padronizar o vocabulário realmente muda algo técnico? Indiretamente, mas de forma material. Termos compartilhados tornam o inventário contável ("agent" = definição registrada + runtime), tornam a aquisição comparável (cada alegação de "harness incluído" se decompõe em loop, sandbox, aprovações, traces) e tornam a governança atribuível (o endereço de cada termo tem um proprietário). O problema da reunião da Elif era um problema de sistemas que parecia um problema de semântica — eles geralmente são.
Um glossário é uma legenda de mapa; este post tentou desenhar o mapa. O vocabulário da comunidade — model, scaffold, harness, agent, skill, sub-agent, policy, rollout, reward — revela descrever uma arquitetura de produção notavelmente bem, termo por termo, desde que cada termo ganhe um endereço. Dê-lhe um, e as palavras deixam de ser a discussão e passam a ser o design.
Elif é uma figura ilustrativa fictícia, não uma pessoa, organização ou incidente específico. As definições neste post foram parafraseadas de, e creditadas a, o glossário de agentes da Hugging Face (Maio de 2026) somado à discussão mais ampla da comunidade que ele cita; o próprio glossário nota que muitos termos carecem de definições universalmente aceitas e o uso varia entre frameworks. As capacidades da TrueFoundry mencionadas refletem a documentação pública do produto no momento da redação; verifique os detalhes específicos na documentação atual.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















