



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
O modelo raramente é a parte mais difícil hoje em dia. Os modelos de ponta (frontier models) são capazes o suficiente para que, em muitas cargas de trabalho de agentes, alternar entre eles seja tão simples quanto alterar um campo de configuração. O que separa um agente que funciona em uma demonstração de um que continua funcionando de forma confiável após três meses em produção é tudo o que está ao redor do modelo: o loop, o contexto, as ferramentas, o sandbox, as aprovações e os controles que impedem que ele faça algo irrecuperável.
Essa camada é o agent harness, e as decisões que você toma nela podem ter um impacto maior na confiabilidade e no custo do que a própria escolha do modelo. Aprendemos isso enquanto construíamos e rodávamos o TrueForge, nosso agent harness open-source. Estas são as 10 melhores práticas para agent harness que recomendamos se você estiver construindo agentes em produção hoje.
Vamos começar com um número, porque ele reestrutura tudo o que vem a seguir. Usamos o Enterprise-Bench da DevRev: 14 tarefas cruzadas entre sistemas com variados níveis de dificuldade que se assemelham ao trabalho real de operações B2B. Para responder a qualquer uma delas, um agente precisa planejar, chamar ferramentas MCP em três sistemas (um CRM no estilo Salesforce, um rastreador de projetos no estilo Jira e um repositório de documentos e transcrições de chamadas no estilo Drive), unir os resultados corretamente e apresentar a resposta no nível correto de detalhamento.
A precisão está efetivamente empatada. O modelo define o teto; o harness não torna o modelo subjacente mais inteligente.
O que o harness determina é quanto trabalho é necessário para atingir esse teto.
Neste benchmark, o TrueForge resolveu aproximadamente o mesmo número de tarefas que o Claude Managed Agents usando cerca de 62% menos tokens e custando cerca de 28% menos por execução. Em comparação com o deepagents, a diferença de tokens foi ainda maior.
Essa é a parte da infraestrutura de agentes que é fácil de ignorar. Dois agentes podem usar o mesmo modelo, ter acesso às mesmas ferramentas e tentar a mesma tarefa, e ainda assim produzir custos de execução muito diferentes.
A diferença vem do que acontece ao redor do modelo: quanto contexto ele carrega, quais ferramentas ele carrega, como ele lida com respostas grandes, quando ele compacta o estado e quão eficientemente ele executa o loop.
Leia a metodologia completa do benchmark →
Quase toda a diferença de custo neste benchmark se resume às quatro primeiras práticas.
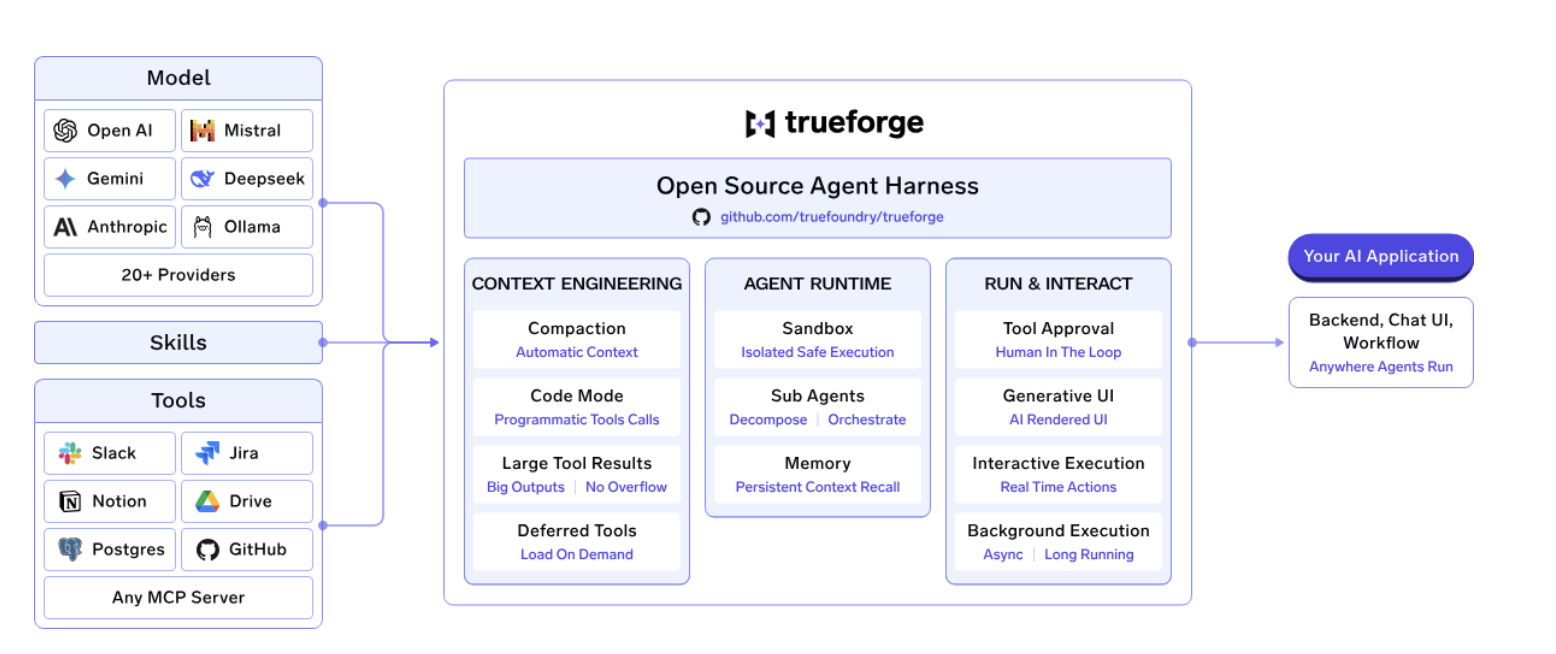
TrueForge é o agent harness open-source e neutro em relação a fornecedores da TrueFoundry para equipes que desejam mais controle sobre como seus agentes rodam em produção. Em vez de vincular o runtime a um único provedor de modelo, o TrueForge permite que você traga seus próprios modelos, servidores MCP e infraestrutura, enquanto gerencia o loop do agente, a execução de ferramentas, a gestão de contexto, aprovações e o sandboxing.
Onde um agente auto-hospedado como o Hermes deixa grande parte da infraestrutura de produção para o desenvolvedor, o TrueForge fornece o plano de controle ao redor necessário para operar agentes entre equipes e ambientes. Isso inclui acesso centralizado ao MCP e credenciais, aprovações com human-in-the-loop, execução em sandbox, observabilidade e governança.
Você pode executá-lo localmente com npx @truefoundry/trueforge ou implantá-lo para uma equipe com Docker Compose ou Helm.
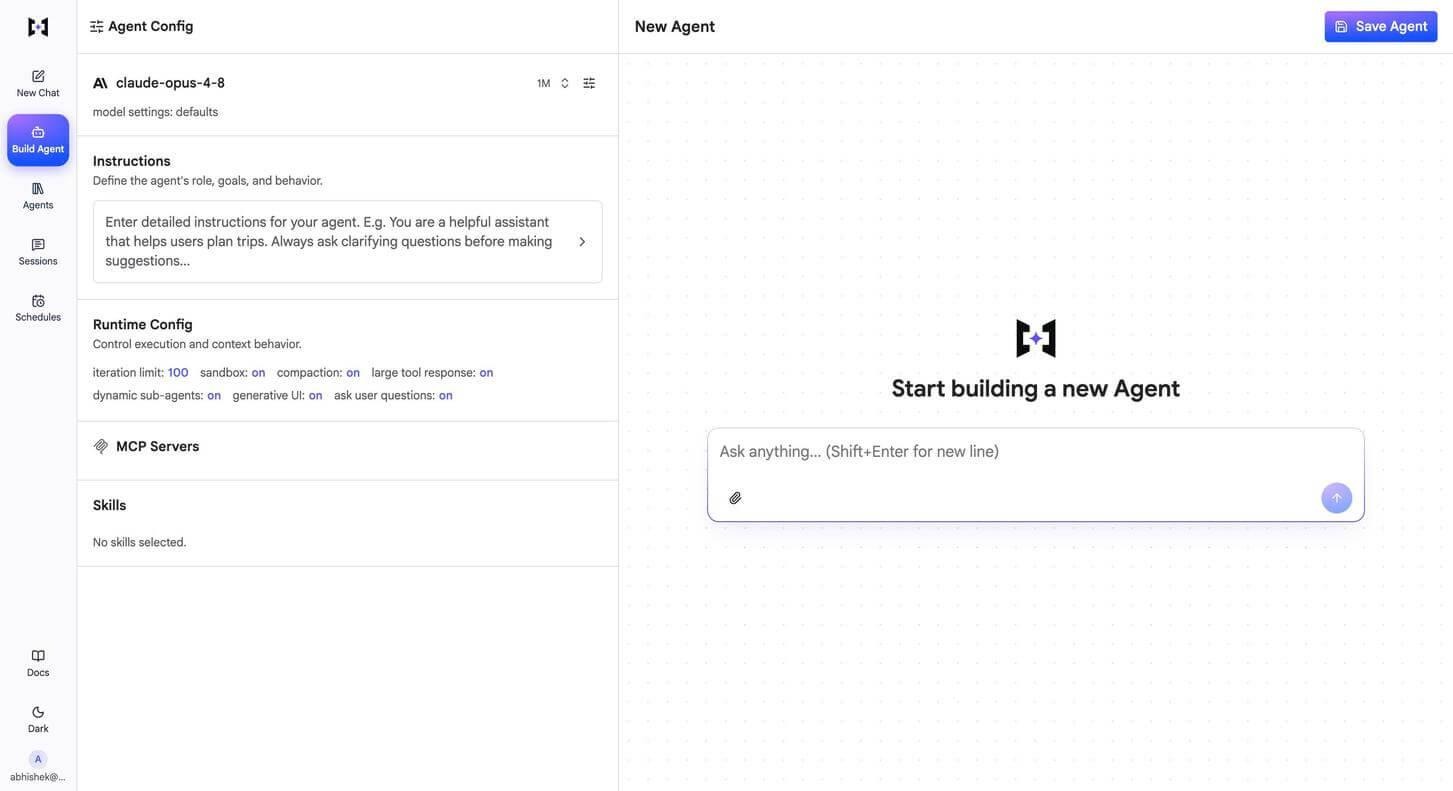
O TrueForge também separa o runtime do agente da camada do modelo. Isso significa que as equipes podem trocar de modelo ou rotear cargas de trabalho para diferentes provedores sem reconstruir o próprio agente. Combinado com o AI Gateway da TrueFoundry, as equipes também podem aplicar roteamento de modelos e controles de custo para evitar o uso de modelos de ponta caros para tarefas que não os exigem. O resultado é um meio-termo entre um runtime totalmente gerenciado e construir toda a infraestrutura de agentes do zero: um agent harness open-source com os controles operacionais necessários para rodar agentes em produção em escala.
A TrueFoundry também fornece uma segunda alavanca para reduzir os custos com modelos por meio do Auto Routing do AI Gateway. Em vez de enviar todas as requisições para um modelo de ponta, o Auto Routing classifica as requisições por complexidade e as roteia para diferentes níveis de modelos. No benchmark da TrueFoundry em 550 prompts, o roteamento entre Haiku, Sonnet e Opus reduziu o custo em 69% mantendo 98% da qualidade base, e a latência média caiu de 7,6 segundos para 4,0 segundos. Em tráfego no formato de produção, a redução geral de custo atingiu 80%.
Essas duas camadas abordam diferentes partes da equação de custo. O TrueForge reduz o overhead de executar o próprio agente, enquanto o roteamento de modelos permite evitar o uso de um modelo caro quando a tarefa não o exige. Para equipes que executam agentes em escala, ter ambos os controles pode importar mais do que apenas o preço do modelo.
O TrueForge é open-source e possui licença MIT, enquanto o AI Gateway da TrueFoundry adiciona a camada operacional de que as equipes precisam ao passar de agentes individuais para a produção: acesso centralizado a modelos, orçamentos, guardrails, gerenciamento de credenciais e traces unificados.
Se você estiver comparando o Claude Managed Agents com uma arquitetura mais configurável, vale a pena considerar a TrueFoundry quando flexibilidade de modelos, controle de infraestrutura e otimização de custo de agentes importam junto com o próprio runtime do agente.
É aqui que está o dinheiro. A engenharia de contexto é a disciplina de decidir o que o modelo vê em cada turno (turn) e, em um agente de longa execução, isso se acumula turno após turno.
O que dá errado: você conecta cinco servidores MCP, o schema de cada ferramenta é carregado na inicialização e o agente queima dezenas de milhares de tokens em definições de ferramentas que ele nunca chamará. Cada turno subsequente as carrega.
O que fazer: carregue os schemas das ferramentas sob demanda, e não antecipadamente. O bom gerenciamento de contexto do agente começa antes da primeira chamada ao modelo, não depois que a janela enche.
No TrueForge: o carregamento diferido de ferramentas dá ao agente um índice leve e busca o schema completo somente quando ele alcança essa ferramenta.
O que dá errado: a janela enche, o harness descarta o conteúdo mais antigo e o agente silenciosamente esquece a restrição que você deu a ele no terceiro turno. Não gera erro. Apenas piora, e a falha é difícil de identificar porque a saída ainda parece plausível.
O que fazer: resuma o histórico antigo em um registro estruturado e mantenha o resumo. Defina o limite abaixo do limite máximo para que a compactação ocorra sob seus termos, e não sob pressão.
No TrueForge: a compactação é acionada a 80% do tamanho do contexto do modelo e substitui o histórico antigo por um resumo estruturado. O truncamento é aceitável para um agente de suporte curto e ativamente prejudicial em uma tarefa de várias horas.
Uma ressalva importante: a compactação traz seu próprio risco se a política e as restrições existirem apenas na conversa. Escrevemos sobre como a compactação desgasta a governança e por que a aplicação de regras pertence a um ambiente fora da janela de contexto.
O que dá errado: uma ferramenta retorna um payload JSON de 200 KB, tudo vai parar na janela de contexto e o agente só precisava de três campos dali.
O que fazer: grave o payload em algum lugar acessível ao agente e entregue uma referência em vez do conteúdo.
No TrueForge: o descarregamento de respostas grandes de ferramentas grava a resposta em um arquivo de sandbox e a substitui por um caminho e uma prévia. O Code Mode vai além, permitindo que o agente encadeie várias chamadas de ferramentas dentro de um script no sandbox, de modo que apenas o resultado impresso entra no contexto. Cinco viagens de ida e volta se tornam um resumo.
O que dá errado: um subagente herda a thread pai completa, faz seu trabalho e retorna todo o seu histórico de raciocínio para o contexto pai. Agora você pagou pelo mesmo histórico duas vezes e poluiu a thread principal.
O que fazer: a delegação deve diminuir o contexto do pai, não aumentá-lo.
No TrueForge: os subagentes rodam com seu próprio contexto limpo e devolvem apenas o resultado.
Experimente: o comando npx @truefoundry/trueforge roda um harness com todos esses quatro recursos ativados por padrão, localmente, em cerca de um minuto. Dê uma estrela no GitHub.
O que dá errado: o harness envolve cada sessão em um contêiner, independentemente de o agente rodar código algum dia. Você paga pelo tempo do contêiner para conversas que eram apenas texto, e um servidor suporta muito menos agentes concorrentes.
O que fazer: provisione o sandbox quando o agente realmente precisar executar algo. O sandboxing de agentes é sobre o raio de alcance de danos (blast radius), e você obtém o mesmo isolamento sem pagar por ele em cada turno.
No TrueForge: o sandbox é uma ferramenta, iniciada apenas quando o agente precisa rodar código, para que um servidor lide com muitos agentes e os turnos que nunca tocam em código permaneçam baratos. Os provedores de sandbox são do tipo "traga o seu próprio".
O argumento mais profundo para permitir que os modelos executem sem deixá-los vagar livres vale a leitura se você estiver projetando isso do zero.
O que dá errado: as equipes abordam as aprovações em um de dois extremos. Ou nada passa por gates e um agente eventualmente deleta algo, ou tudo passa por gates e um humano clica em aprovar quarenta vezes por hora até parar de ler.
O que fazer: estabeleça gates com base na irreversibilidade. Enviar um e-mail, escrever na produção, gastar dinheiro, deletar qualquer coisa. Leituras e rascunhos rodam livres. E não implemente um requisito de conformidade descrevendo-o no prompt do sistema e torcendo, porque um prompt é uma sugestão, enquanto guardrails que inspecionam cada chamada de ferramenta são um controle.
No TrueForge: o servidor principal pausa a execução e aguarda a aprovação de ações sensíveis antes que a chamada seja enviada, em vez de depois.
Onde esse gate reside importa tanto quanto a sua existência, assunto que cobrimos ao projetar aprovações de ferramentas MCP no limite do gateway.
O que dá errado: um laptop entra em repouso, um balanceador de carga reinicia uma conexão e quarenta minutos de trabalho do agente são perdidos. Em tarefas que rodam por uma hora, isso deixa de ser um caso isolado.
O que fazer: persista o estado da sessão para que uma conexão interrompida seja retomada em vez de reiniciada.
No TrueForge: as sessões persistem entre reconexões e reinicializações. A recuperabilidade (resumability) é uma daquelas propriedades que ninguém pede na revisão de arquitetura e que todo mundo precisa na segunda semana.
O que dá errado: você tem contagens de tokens e latência por chamada de modelo, mas nenhuma ideia de qual etapa de uma execução de 60 passos deu errado. A depuração se torna uma arqueologia.
O que fazer: emita eventos estruturados para cada etapa, para que uma execução possa ser lida como uma linha do tempo em vez de um bloco de logs. Verifique se o próprio loop é observável antes de ter que depurá-lo em um momento crítico.
No TrueForge: cada etapa é transmitida via streaming à medida que acontece, e o contrato do runtime de eventos do agente é publicado para que suas próprias ferramentas possam consumi-lo.
A abordagem na engenharia de loops é útil aqui: o loop é o middleware, portanto, trate-o como infraestrutura.
O que dá errado: o agente é escrito focado no SDK e nas particularidades de um único provedor. Um modelo mais barato ou melhor é lançado e a troca significa reescrever tudo, então você não troca.
O que fazer: comunique-se com os modelos por meio de interfaces compatíveis com a OpenAI e mantenha as especificidades dos provedores fora da lógica do seu agente.
No TrueForge: modelos, servidores MCP e provedores de sandbox são todos no formato "traga o seu próprio" por meio de interfaces abertas. Isso não é um valor hipotético. No mesmo benchmark, rodar o TrueForge no GLM-5.2 em vez do Opus 4.8 resolveu os mesmos ~11 de 14 tarefas a $2,90 por execução contra $8,50. Essa economia só está disponível se a troca for uma simples mudança de configuração.
O que dá errado: cada equipe mantém suas próprias chaves de modelo e credenciais MCP. Ninguém consegue limitar os gastos, o mascaramento de PII é inconsistente e responder a uma auditoria significa juntar logs de nove serviços.
O que fazer: coloque um gateway entre seus agentes e tudo o que eles chamam.
No TrueForge: isso deliberadamente não é papel do harness. Sendo auto-hospedado, você traz suas próprias chaves e as gerencia sozinho, o que funciona até que você esteja rodando muitos agentes. Nesse ponto, direcione-o para o AI Gateway da TrueFoundry, que coloca mais de 1.000 LLMs atrás de uma única API compatível com a OpenAI com cerca de 3 a 4 ms de latência adicionada e mais de 350 RPS em um único vCPU, com RBAC, orçamentos, guardrails, rotação de credenciais e traces OpenTelemetry no Grafana, Datadog ou Prometheus.
Está rodando mais do que alguns agentes? Veja como o AI Gateway os governa centralmente, ou agende uma demonstração se quiser mapeá-lo para a sua estrutura.
Nove das dez estão no harness. A décima não está deliberadamente, porque um harness que também tenta ser o seu plano de controle tende a ser ruim em ambos.
Reconstruir um loop que já existe. Se você está escrevendo a lógica de planejar-agir-observar do zero, verifique se um harness já não a possui. O design de um agent harness só vale o seu tempo se o seu problema for genuinamente fora do comum.
Tentar aplicar controles via prompts. Etapas de conformidade, limites de gastos e gates de aprovação pertencem ao código ou a um gateway. Um modelo ao qual se pode pedir educadamente pode ser convencido do contrário.
Colocar tudo em sandbox. O isolamento em cada turno custa dinheiro real e não traz nenhum benefício em turnos que nunca executam código.
Medir o modelo em vez da execução. As contagens de tokens por chamada parecem ótimas enquanto o custo total por tarefa concluída triplica silenciosamente. Meça a execução.
P: Quais são as melhores práticas para agent harness?
R: As que mais importam são as práticas de contexto: carregar schemas de ferramentas sob demanda, compactar o histórico em vez de truncá-lo, descarregar respostas grandes de ferramentas para arquivos e manter o contexto do subagente separado do pai. Depois disso, provisionar sandboxes apenas quando o código for executado, colocar gates em ações irreversíveis, persistir sessões entre reconexões e emitir eventos estruturados para cada etapa. Em nosso benchmark, essas decisões representaram uma diferença de mais de 4x nos tokens por execução para tarefas idênticas.
P: Como evitar que um agente fique sem contexto em uma tarefa longa?
R: Compactação, não truncamento. Resuma o histórico antigo em um registro estruturado ao atingir um limite, em torno de 80% do tamanho do contexto do modelo, para que o agente mantenha o fio da meada em vez de perdê-lo silenciosamente. Combine isso com o carregamento diferido de ferramentas e o descarregamento de respostas para que a janela encha mais devagar em primeiro lugar.
P: Devo colocar todas as sessões de agentes em um sandbox?
R: Não. Coloque a execução de código em sandbox, não a sessão. Manter um contêiner aberto por toda a conversa custa dinheiro em cada turno que nunca roda código e limita quantos agentes um servidor pode gerenciar. O provisionamento sob demanda oferece o mesmo isolamento por uma fração do custo.
P: Posso rodar um agent harness na minha própria VPC ou on-premise?
R: Sim, com qualquer opção auto-hospedada. O TrueForge roda a partir de um único comando npx localmente, ou via Docker Compose e Helm para implantação em equipe com Postgres, Redis, réplicas e login via OIDC. A plataforma gerenciada da TrueFoundry também roda de forma auto-hospedada, on-premise, air-gapped ou híbrida, garantindo que nenhum dado saia do seu domínio.
P: A TrueFoundry suporta MCP e agentes de outros frameworks?
R: Sim. A plataforma inclui um MCP Gateway, Agent Gateway e um registro com controle de acesso em nível de ferramenta. Agentes construídos em LangGraph, CrewAI, AutoGen ou em um framework personalizado podem ser governados pela mesma camada, de modo que essas práticas não exigem que você adote uma única stack.
As melhores práticas para agent harness se resumem a um hábito: decidir deliberadamente o que o modelo vê e o que ele tem permissão para fazer, e então medir toda a execução em vez da chamada individual. As equipes que fazem isso obtêm agentes que custam um quarto do valor e falham de maneiras que podem ser diagnosticadas.
Você não precisa apenas acreditar em nossos números. O TrueForge possui licença MIT e a metodologia do benchmark é pública, para que você possa rodá-lo em suas próprias tarefas.
Use o comando npx @truefoundry/trueforge para testar em cerca de um minuto, leia a documentação ou agende uma demonstração se preferir vê-lo aplicado à sua estrutura.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















