



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!

In dit voorbeeld trainen we een model dat een bloem van het geslacht iris kan classificeren in een van de drie soorten op basis van de afmetingen van het kroonblad en het kelkblad.
U kunt dit voorbeeld ook volgen in een Google Colaboratory notebook.
De Iris dataset bevat drie verschillende soorten:
We moeten een classifier bouwen die de soort van de bloem kan identificeren op basis van de volgende parameters:
TrueFoundry biedt twee libraries om uw ML-workflows te vereenvoudigen:
De mlfoundry library wordt gebruikt om ML-trainingsexperimenten te tracken.
Waarom hebt u experiment tracking nodig? Als u meerdere ML-modellen traint om een probleem op te lossen, zult u waarschijnlijk meerdere modellen trainen met verschillende frameworks, hyper-parameters en meerdere datasets. Het tracken van uw experiment met een library zoals mlfoundry helpt u uw ML-experimenten te organiseren.
U kunt MLFoundry gebruiken om hyper-parameters, metrics, datasets en modellen te loggen. U kunt vervolgens verschillende experimenten vergelijken op het TrueFoundry dashboard en een model kiezen om in productie te deployen of besluiten om het model opnieuw te trainen.
We gebruiken in dit voorbeeld 5 verschillende API's van MLFoundry. Dit zijn:
Met de servicefoundry library kunt u een model eenvoudig verpakken, containerizen en deployen naar een Kubernetes-cluster.
Open een IPython notebook - u kunt lokaal op uw machine Jupyter gebruiken of een Google Colab notebook dat in de cloud draait.
Installeer de vereiste libraries.
Log in bij TrueFoundry. Maak en kopieer een API key vanaf de instellingenpagina. Gebruik deze API key om de MLFoundry client te initialiseren en een run aan te maken. Een run is een entiteit die een enkel experiment vertegenwoordigt.
Haal de Iris dataset op met behulp van de sklearn.datasets module. Vervolgens splitsen we deze in test- en train-datasets.
Laten we kijken naar de target-namen. We gebruiken dit om de integer-output van het model te koppelen aan de daadwerkelijke namen van de soorten.
Initialiseer een model. Gebruik vervolgens MLFoundry om de parameters van het model te loggen en enkele tags aan te maken voor deze huidige experimentele run.
Vervolgens trainen we het model op onze train-dataset. Zodra de training is voltooid, berekenen we de verschillende metrics en loggen deze in MLFoundry via log_metrics.
Als we tevreden zijn met de accuracy scores en andere metrics, kunnen we ervoor kiezen om het huidige model te deployen. Daarvoor moeten we het model opslaan en de huidige run id kopiëren.
U kunt al uw runs bekijken en metrics vergelijken via het TrueFoundry experiment tracking dashboard.

Om het model te deployen met ServiceFoundry, moeten we een Python-bestand maken met de functie die we als endpoint willen blootstellen.
In dat Python-bestand halen we het model op dat we zojuist hebben getraind en opgeslagen met behulp van de run id, via mlfoundry. Merk op dat de API key die vereist is door mlfoundry beschikbaar zal zijn als de omgevingsvariabele TFY_API_KEY.
Maak in uw IPython notebook een blok aan met de volgende inhoud en voer dit uit om een Python-bestand genaamd predict.py te maken. We gebruiken het Jupyter magic command %%writefile om het bestand in de notebook-omgeving aan te maken.
In de species-functie laden we de features in een pandas DataFrame en maken we de voorspelling met het model. We vertalen de integer class naar soortnamen met de target_names die we tijdens de training hebben geprint.
Dat is vrijwel al het werk dat u moet doen. Laten we dit model nu deployen als een API-service. Installeer en importeer eerst servicefoundry in uw notebook. Log in bij servicefoundry.
Ga naar het TrueFoundry dashboard en maak een workspace aan om de service te deployen. Workspaces zijn een manier om gerelateerde projecten binnen TrueFoundry te groeperen. Zodra de workspace is aangemaakt, kopieert u de FQN zodat we servicefoundry kunnen vertellen waar het model gedeployed moet worden.

Met de servicefoundry library kunt u alle afhankelijkheden van het bestand dat u zojuist hebt gemaakt verzamelen met de gather_requirements functie.
Maak nu een sfy.Service object aan, geef de workspace FQN op en deploy het door .deploy() aan te roepen.
U kunt de voortgang van deze deployment volgen op het dashboard. Zodra de deployment is voltooid, kunt u vanuit daar toegang krijgen tot de gedeployde service en deze uitproberen.
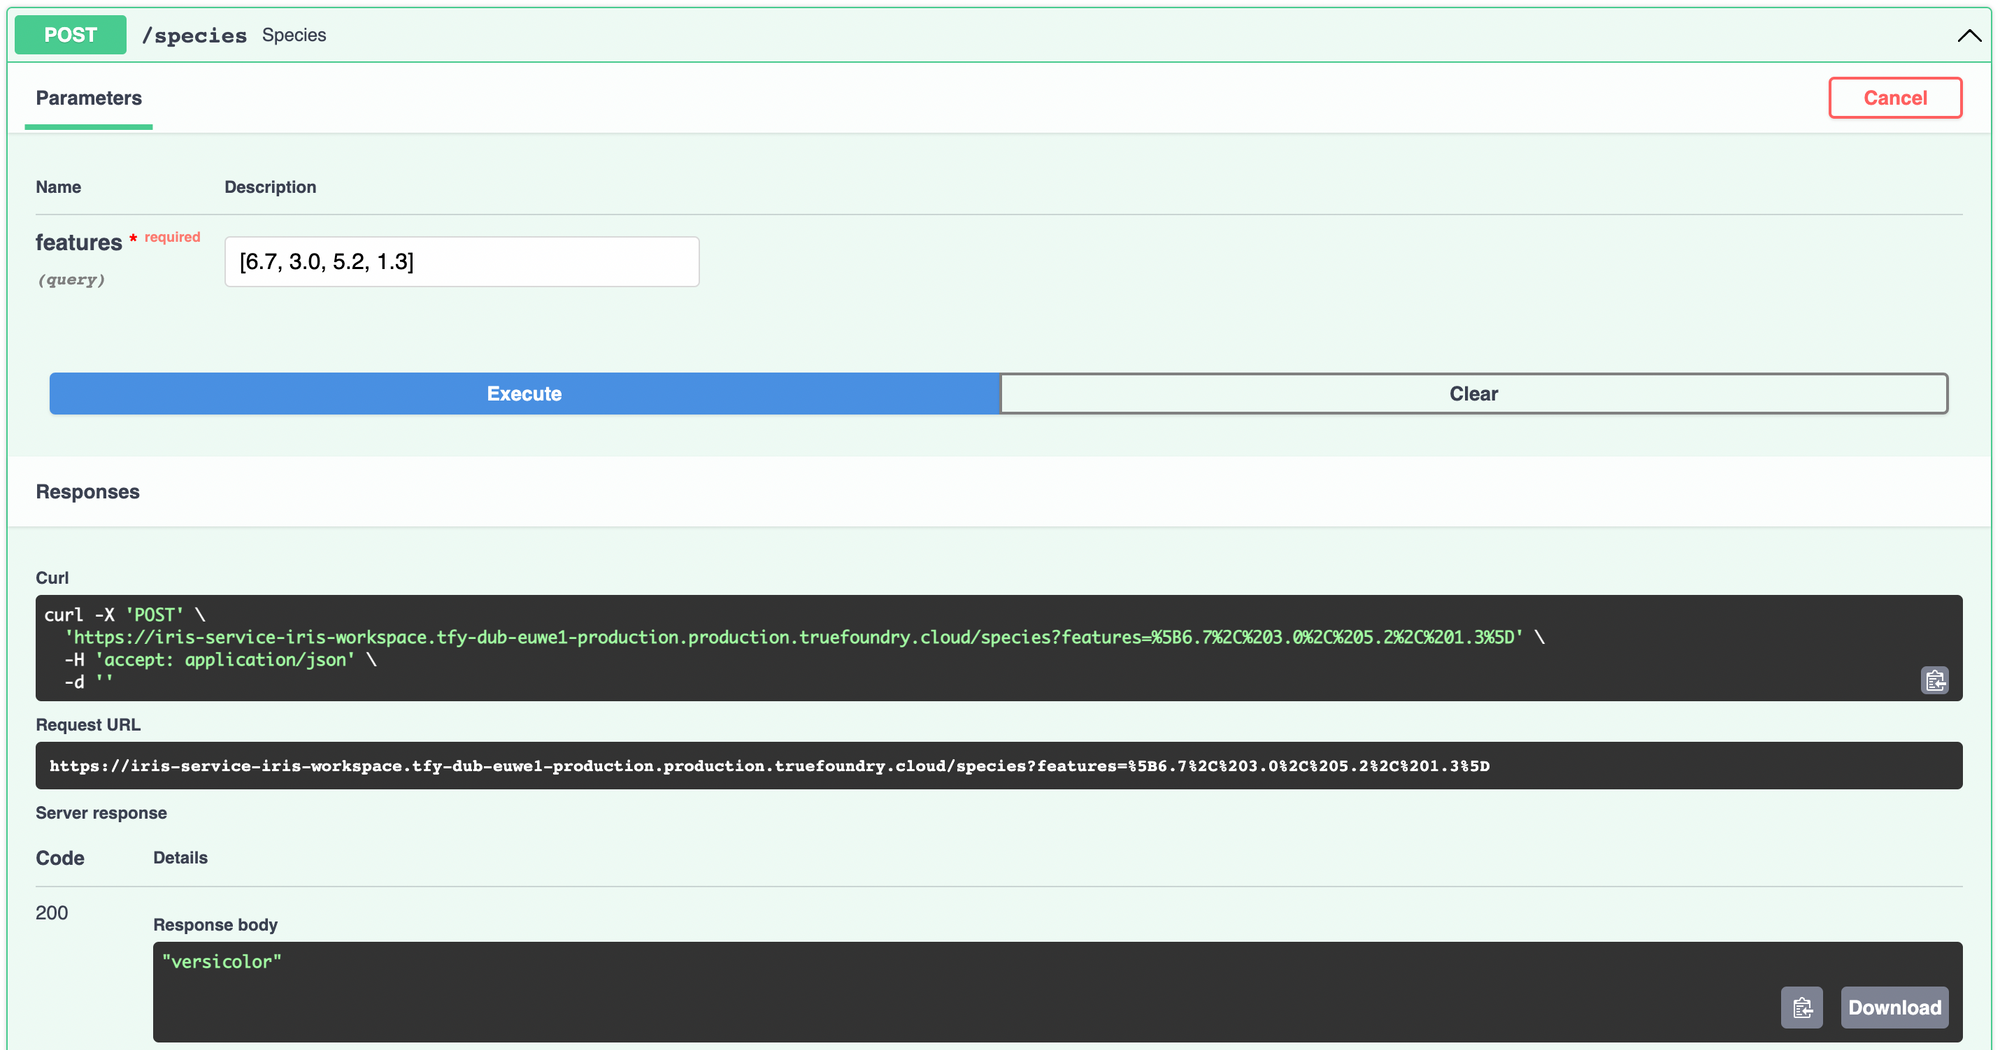
Het TrueFoundry dashboard linkt ook naar metrics en logs die standaard worden geleverd bij TrueFoundry-deployments in de vorm van Grafana-dashboards. U kunt hier meer over lezen hier.

U kunt ook eenvoudig interactieve UI-applicaties en Gradio-applicaties deployen vanuit een IPython notebook met behulp van servicefoundry. Lees deze gids om te zien hoe.
We werken aan een nog strakkere integratie tussen experiment tracking en deployment om de ervaring nog aangenamer te maken. U kunt meer lezen over wat u met TrueFoundry kunt doen in onze documentatie. Als u machine learning-modellen traint om een probleem op te lossen, helpt TrueFoundry u verschillende experimenten te tracken en maakt het het eenvoudig en intuïtief om modellen volgens best practices te deployen en binnen enkele minuten beschikbaar te maken voor openbaar gebruik.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























