



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In de meeste AI-programma's van bedrijven komt er een moment dat er een workload verschijnt die zijn data niet naar een API van derden kan sturen — een gereguleerde dataset, een eis qua datasoevereiniteit of een kostencurve die op schaal schrikbarend is geworden. Het antwoord is een open-weight model dat je zelf draait. De reden dat teams hier tegenop zien is niet het model; het is dat self-hosting meestal betekent dat er een tweede, ander systeem — een niet-OpenAI API, een serving-laag, GPU-operations — wordt vastgeschroefd op een platform dat is gebouwd rond commerciële API's. Dit artikel legt uit hoe een gateway dat probleem oplost, waardoor een zelfgehoste Llama of Mistral een direct vervangbare optie wordt naast de commerciële modellen die je al aanroept.
Ravi, een ML platform engineer, kreeg het verzoek dat hij al had verwacht: een nieuwe workload zou gegevens verwerken die volgens het beleid de cloud van het bedrijf niet mochten verlaten. Geen enkele commerciële API was een optie. Een open-weight model dat in hun eigen VPC draaide was het logische antwoord — en Ravi's moed zakte hem een beetje in de schoenen, omdat de applicatie die het nodig had geschreven was voor de OpenAI API, het team geen serving-stack had, en hij zich het parallelle universum van een tweede SDK, een tweede set dashboards en een GPU-autoscalingprobleem dat niemand had opgelost al levendig kon voorstellen. Het model was de eenvoudige beslissing. De stack eromheen was de boosdoener.
Wat Ravi's week veranderde, was het inzicht dat het zelfgehoste model helemaal geen andere stack hoefde te zijn. Als het achter dezelfde gateway zou zitten als de commerciële modellen en dezelfde OpenAI-compatibele API zou spreken, dan was het voor de applicatie gewoon een andere modelnaam — en voor het platform nog een endpoint dat door dezelfde regels werd beheerd. Aan de eis voor soevereiniteit werd voldaan zonder de architectuur te splitsen. Dit artikel legt uit hoe dat werkt en waar de echte engineering nog steeds zit.
Het zelf hosten van een open-weight model gaat zelden over kwaliteit — frontier-API's zijn uitstekend en worden steeds beter. Het gaat om vier andere zaken. Soevereiniteit: sommige gegevens mogen wettelijk of contractueel je omgeving niet verlaten, waar een model dat in je VPC of on-premise draait per definitie aan voldoet. Kosten op schaal: voorbij een bepaald stabiel volume kunnen afgeschreven GPU's goedkoper zijn dan prijzen per token, vooral voor voorspelbare workloads met een hoge doorvoer. Controle: je kiest de modelversie, kunt fine-tunen op eigen data, en bent niet overgeleverd aan een provider die een model onder je voeten aanpast of uitfaseert. Beschikbaarheid: je inference-pad is niet langer direct afhankelijk van de uptime van een API-provider van een model — al hangt het nu af van je eigen infrastructuur en deployment-supplychain.
Het eerlijke tegengewicht is dat je nu eigenaar bent van inference operations: GPU-capaciteit, de serving-stack, schalen en betrouwbaarheid — werk dat een commerciële API volledig verbergt. Self-hosting is de moeite waard wanneer een van die vier drijfveren reëel is en de operationele kosten beheersbaar zijn. De meeste bedrijven eindigen hybride: commerciële API's voor algemeen verkeer, zelfgehoste modellen voor de soevereine of hoogvolumeverzoeken. Het doel is niet om het een door het ander te vervangen; het is om beide te draaien zonder van alles twee te hoeven beheren.
Aanpassing verdient het om uit dat lijstje te worden gehaald, omdat het vaak de specifieke drijfveer is die een team richting open weights duwt. Een commerciële API geeft je een model dat iemand anders voor iedereen heeft getraind; een open-weight model kun je aanpassen aan jouw domein, jouw formaten, jouw toon en jouw uitzonderingsgevallen door te fine-tunen op data die je nergens anders heen kunt of wilt sturen. Voor specifieke, herhaaldelijke taken kan een kleiner, ge-fine-tuned open model een veel groter algemeen model evenaren of verslaan tegen een fractie van de serving-kosten — wat de aanpassingsdrijfveer weer terugbrengt naar die van de kosten. De adder onder het gras is dat fine-tuning een eigen pipeline is: datapreparatie, trainingsruns, evaluatie, versiebeheer en vervolgens het resultaat serveren zoals elk ander model. TrueFoundry ondersteunt zowel no-code als full-code fine-tuning naast de eigen serving-stack, zodat een afgestemd model achter hetzelfde gateway-endpoint belandt als al het andere, in plaats van een los artefact te worden dat je handmatig operationeel moet maken. Het punt is niet dat fine-tuning altijd de moeite waard is — dat is het vaak niet, en een goed basismodel met sterke prompting wint het vaak — maar wanneer het dat wel is, maakt het bezitten van de weights dit überhaupt mogelijk.
Eén kanttekening hoort thuis bij deze beslissing, niet er na: open-weight betekent niet vrij van verplichtingen. Voordat je zelf gaat hosten of fine-tunen, moet je de licentie van het model, het beleid voor acceptabel gebruik, de voorwaarden voor herdistributie, de naamsvermeldingsvereisten en eventuele beperkingen op gereguleerd of commercieel gebruik controleren — sommige populaire open-weight modellen hanteren drempels voor gebruik of beperkingen per toepassingsgebied die er op ondernemingsschaal toe doen. Behandel de licentiebeoordeling als onderdeel van de deployment-checklist, niet als een voetnoot die pas wordt ontdekt als het model al in productie is.
Ravi's vrees was terecht, want de naïeve manier van zelf hosten levert precies die tweede stack op. Het open-weight model heeft zijn eigen API-structuur, dus de applicatie heeft daar een eigen codepad voor nodig. Het heeft een serving-engine nodig, wat een eigen operationeel vlak is. Het heeft GPU-autoscaling nodig, wat in niets lijkt op het schalen van een stateless webservice. En het heeft zijn eigen observability nodig, omdat de dashboards van de commerciële API het niet zien. Vermenigvuldig dat met een paar modellen en je hebt een parallel platform waarvan de enige taak is om anders te zijn dan het platform dat je al draait.
Het inzicht dat dit ontmantelt, is dat vrijwel niets van dat verschil de applicatie of het beheervlak van het platform hoeft te bereiken. De serving-engine en GPU-scaling zijn reëel en onvermijdelijk — dat is het echte werk van self-hosting. Maar de API-structuur, de routing, het beheer en de observability kunnen identiek worden gemaakt aan het commerciële pad door er dezelfde gateway voor te zetten. De rest van dit artikel scheidt het essentiële verschil (serving, GPU's) van het incidentele verschil (alles wat de gateway kan opvangen).
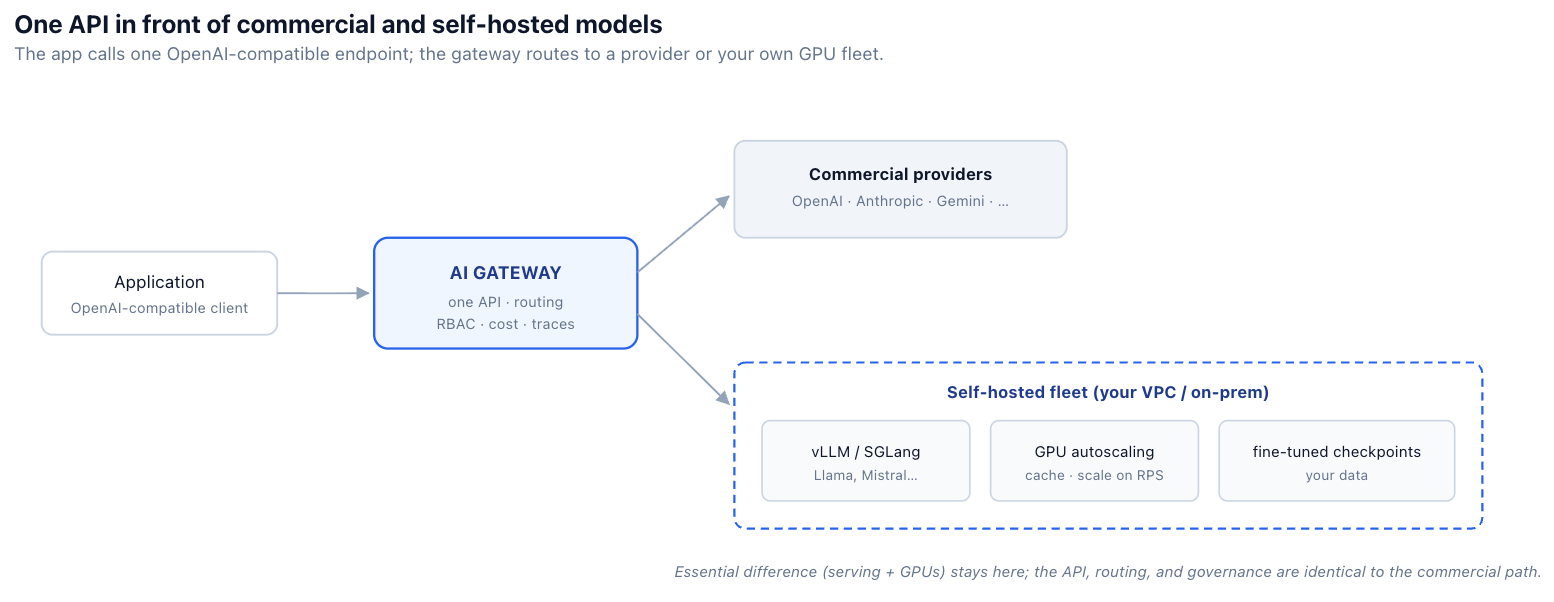
De stap die self-hosting zorgeloos maakt, is het ontsluiten van het zelfgehoste model via dezelfde OpenAI-compatibele API die de applicatie al spreekt. Wanneer een zelfgehoste Llama op dezelfde verzoekstructuur reageert als een commercieel model, is het wisselen daartussen een configuratiewijziging in plaats van een codewijziging — en routing, fallback, RBAC, budgetten en tracing zijn allemaal uniform van toepassing omdat het vanuit het perspectief van de gateway gewoon weer een model achter dezelfde interface is.
Dezelfde client, dezelfde aanroep — alleen de modelnaam verandert (illustratief)
Dit is dezelfde unificatie die ons artikel over routing behandelt, toegepast op de zelfgehoste situatie: de applicatie is losgekoppeld van de fysieke locatie waar een model draait. Ravi's gereguleerde workload verwijst naar een zelfgehoste modelnaam; al het andere in zijn platform blijft ongewijzigd werken. TrueFoundry's AI Gateway is gebouwd om precies deze centrale interface te zijn voor zowel zelfgehoste modellen als modellen van derden.
Dit is het verschil dat echt aan jou is om te beheren. Een open-weight model serveert zichzelf niet; het draait binnen een inference-engine, en de engine die je kiest heeft een aanzienlijke invloed op doorvoer, latency en geheugenefficiëntie. vLLM maakte continuous batching en paged attention populair voor een hoge doorvoer; SGLang is sterk in gestructureerde workloads en workloads met een hoge mate van gelijktijdigheid; TGI is een volwassen, breed ingezette server; en TRT-LLM (Triton) perst hardwarespecifieke prestaties uit NVIDIA GPU's. Geen enkele is universeel de beste.
De discipline die telt is benchmarking: draai je daadwerkelijke model, op je daadwerkelijke sequence lengths en gelijktijdigheid, op de beoogde engines en GPU's, en kies op basis van cijfers in plaats van reputatie. TrueFoundry's documentatie over LLM-deployment vermeldt vLLM, SGLang en TRT-LLM als ondersteunde model-servers (TGI en Triton verschijnen tussen de zelfgehoste backends van de gateway), en het platform heeft als doel om automatisch een verstandige GPU-configuratie voor een gegeven model te kiezen — wat van "welke engine en hoeveel GPU's" een keuze maakt die je valideert aan de hand van je eigen benchmarks in plaats van een onderzoeksproject. De engine is essentiële complexiteit; het doel is om het selecteren en bedienen ervan routinewerk te maken.
Het automatisch schalen van een zelfgehost LLM is om één hardnekkige reden niet vergelijkbaar met het schalen van een webservice: de weights zijn gigantisch — variërend van enkele gigabytes tot ruim boven de honderd. Een naïeve autoscaler die elke keer dat er een replica wordt toegevoegd een model van 100 GB downloadt, is minuten en aanzienlijke netwerkkosten kwijt voordat de nieuwe pod een enkele token serveert. Dat maakt opschalen tijdens een piek in het verkeer vrijwel nutteloos. Een koude start is het bepalende operationele probleem van zelfgehoste inference.
De oplossingen zijn onspectaculair en doorslaggevend. Model-caching downloadt de weights één keer en koppelt ze aan elke pod, zodat een nieuwe replica start vanuit een lokale kopie in plaats van een verse download. Image-streaming haalt de serving-image veel sneller binnen dan een koude pull. Gedeelde model-volumes houden de weights volledig buiten elke image. Samen kunnen deze voorzieningen een koude start veranderen van "alles vanaf nul downloaden" naar een opschaalpad dat snel genoeg is om met op RPS gebaseerde autoscaling de vraag bij te houden — al hangt de daadwerkelijke opstarttijd nog steeds af van modelgrootte, opslagklasse, registry-locatie, node-warmte en GPU-scheduling. TrueFoundry's documentatie beschrijft model-caching (weights worden eenmalig gedownload en aan elke pod gekoppeld), image-streaming voor aanzienlijk snellere vLLM- en SGLang-image pulls, en gedeelde volumes om precies deze reden; het is het verschil tussen autoscaling die werkt en autoscaling die theoretisch blijft.
Self-hosting verplaatst ook de verantwoordelijkheid voor de supplychain dichter naar jou toe. De weights, de serving-image en de bijbehorende afhankelijkheden zijn nu artefacten die je zelf bezit en oplevert. Zet model- en image-versies vast in plaats van een bewegende tag te volgen, controleer checksums of handtekeningen waar de bron deze levert, beheer wie model-checkpoints en serving-images naar je registry mag publiceren, scan die images zoals elke andere productiecontainer, en zorg voor een rollback-pad voor zowel de engine als de weights. De gateway bepaalt wie het model mag aanroepen; dit is de discipline die bepaalt wat je er daadwerkelijk achter draait.
Een zelfgehost model als een beheerde deployment (illustratieve configuratie)
Self-hosting ontgrendelt een optimalisatie die commerciële API's grotendeels voor je verbergen: controle over hoe verzoeken op GPU's worden geprojecteerd. Wanneer een model een sequence verwerkt, bouwt het een key-value-cache op van zijn attention-berekeningen. Als het volgende verzoek dezelfde prefix deelt — dezelfde systeemprompt, hetzelfde gesprek tot nu toe — zorgt het routeren naar dezelfde GPU-instantie ervoor dat de engine die gecachte berekening kan hergebruiken in plaats van deze opnieuw uit te voeren. Dit verlaagt de latency aanzienlijk bij verkeer met veel overlappende prefixen.
Om dat voordeel te benutten is prefix-aware sticky routing nodig: de gateway routeert verzoeken met een gedeelde prefix naar dezelfde instantie in plaats van ze via round-robin te verdelen. TrueFoundry's documentatie beschrijft precies dit — sticky routing die verzoeken met dezelfde prefix naar dezelfde GPU-machine stuurt om optimaal gebruik te maken van de KV-cache. Dit is het zelfgehoste broertje op GPU-niveau van de semantische caching op gateway-niveau uit ons artikel over caching. De een hergebruikt berekeningen binnen de serving-engine; de ander hergebruikt volledige antwoorden bij de gateway. Bij conversational workloads of workloads met een gedeelde systeemprompt versterken de twee elkaar.
Zodra zelfgehoste en commerciële modellen achter één API zitten, is het routing- en betrouwbaarheidsmechanisme uit eerdere artikelen in de reeks van toepassing op de gehele vloot tegelijk. Je kunt een soevereine workload via beleid naar het zelfgehoste model sturen, algemeen verkeer naar een commerciële API leiden, en — cruciaal — over de grens heen terugvallen: als de zelfgehoste vloot tijdens een piek verzadigd raakt, kun je uitwijken naar een commercieel model in plaats van verzoeken in de wachtrij te zetten. En als een provider een storing heeft, kan er worden overgeschakeld naar het zelfgehoste model.
Routing die zelfgehost en commercieel behandelt als één vloot (illustratief)
Dit zijn de routing en failover uit artikelen 11 en 12, die nu de grens tussen commercieel en zelfgehost overbruggen — met één belangrijke beperking die expliciet in het beleid is vastgelegd: een gereguleerde route mag niet terugvallen op een commerciële provider, omdat beschikbaarheid nooit boven soevereiniteit gaat. Het vastleggen daarvan als regel, in plaats van erop te vertrouwen dat iedereen het onthoudt, is het soort waarborg waar de gateway voor bestaat.
De rode draad is dat self-hosting zich helder opsplitst in twee soorten werk. Het essentiële deel — de serving-engine en de GPU's — is reëel, en het volgende artikel in dit tweeluik gaat over de financiële aspecten daarvan. Het incidentele deel — een afwijkende API, gescheiden routing, gescheiden beheer, gescheiden observability — is wat de gateway opvangt door de centrale schakel te zijn tussen je applicaties en elk model, waar het ook draait.
Plaats de gateway op die positie en een zelfgehost model is geen parallel platform meer, maar gewoon nog een beheerd endpoint: dezelfde OpenAI-compatibele API, dezelfde routing- en failover-regels, dezelfde RBAC en budgetten, dezelfde traces. TrueFoundry is gebouwd rondom precies deze verdeling — hoogwaardige serving op vLLM, SGLang, TGI en TRT-LLM met de GPU- en caching-mechanismen om het operationeel te maken, met daarvoor een AI Gateway die het resultaat voor alles wat stroomopwaarts zit ononderscheidbaar maakt van een commercieel model. Voor Ravi is dat het verschil tussen voldoen aan een soevereiniteitseis en het herbouwen van zijn platform om dat voor elkaar te krijgen.
Is zelf hosten goedkoper dan een commerciële API?
Soms, voorbij een bepaalde drempel. Voor stabiel, hoogvolume en voorspelbaar verkeer kunnen afgeschreven GPU's (vooral met fractionele deling en spot-capaciteit) goedkoper zijn dan tarieven per token; voor wisselvallig verkeer of lage volumes is een commerciële API meestal goedkoper omdat je niet betaalt voor ongebruikte GPU's. Het eerlijke antwoord is om je eigen volume door te rekenen — wat het onderwerp is van het artikel over GPU-kosten dat bij dit artikel hoort. Kosten zijn een van de vier redenen om zelf te hosten, niet de enige.
Moet ik mijn applicatie herschrijven om een zelfgehost model te gebruiken?
Niet als het model zich achter een OpenAI-compatibele gateway bevindt. De applicatie blijft dezelfde API aanroepen en alleen de modelnaam verandert; de gateway koppelt die naam aan je GPU-vloot en past dezelfde routing, RBAC en tracing toe als bij commerciële modellen. Het hele punt is dat de applicatie niet weet of geeft om de locatie waar het model draait.
Welke serving-engine moet ik gebruiken?
Gebruik benchmarks om te beslissen — er is geen universele winnaar. De gedocumenteerde backends — vLLM, SGLang, TRT-LLM, plus KServe en Triton — verschillen in doorvoer, latency, geheugenefficiëntie en functionaliteit. De juiste keuze hangt af van je model, sequence lengths en gelijktijdigheid. Draai je daadwerkelijke workload op de opties en kies op basis van gemeten resultaten. Een platform dat ze allemaal ondersteunt, stelt je in staat om te wisselen zonder de architectuur te veranderen.
Wat is het lastigste operationele onderdeel?
Koude starts. LLM-weights zijn groot, dus een autoscaler die het model opnieuw downloadt per replica is te traag om de vraag bij te houden. Model-caching, image-streaming en gedeelde volumes maken schalen praktisch — ze veranderen een koude start van meerdere minuten in iets wat snel genoeg is om op RPS gebaseerde autoscaling en 'scale-to-zero'-beleid bij inactiviteit daadwerkelijk te laten werken.
Kan ik zelfgehoste en commerciële modellen combineren?
Dat is de gebruikelijke eindsituatie, en dat is de kracht van het plaatsen van één gateway voor beide. Routeer soeverein verkeer of verkeer met een hoog volume naar zelfgehoste modellen, algemeen verkeer naar commerciële API's, en wijk uit over de grens heen bij hoge belasting of storingen — met de expliciete uitzondering dat gereguleerde routes niet mogen terugvallen op een commerciële provider. Één vloot, één set regels, twee soorten backends.
Ravi's soevereiniteitsprobleem vereiste nooit een tweede platform; het vereiste dat één model op een specifieke plek draaide en dat al het andere hetzelfde bleef. Dat is wat een gateway oplevert: de vrijheid om een model te plaatsen waar soevereiniteit, kosten, controle of beschikbaarheid dat vereisen, terwijl de applicatie en het platform één consistent oppervlak zien. Beheer de serving en de GPU's — dat is het echte werk — en laat de gateway de rest opvangen.
Ravi is ter illustratie. De serving- en gateway-functionaliteiten van TrueFoundry — ondersteunde inference-engines, model-caching, image-streaming, prefix-aware sticky routing en autoscaling — zijn samengesteld uit openbare productdocumentatie van midden 2026 en ontwikkelen zich verder; controleer specifieke details in de actuele documentatie. Kostenvergelijkingen tussen zelfgehoste en commerciële modellen hangen volledig af van je eigen volume en hardware en moeten direct worden doorgerekend. Code- en configuratievoorbeelden dienen ter illustratie van de gedocumenteerde patronen en zijn niet overgenomen uit een referentie-implementatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















