



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Laat de discussie over superintelligentie buiten beschouwing en er blijft een sober industrieel feit over: agents die zichzelf aanpassen zijn geen onderzoeksrichting meer — ze zijn een deploymentpatroon. De onderzoeksgemeenschap heeft het terrein nu op schaal in kaart gebracht: een recent overzicht van 1.250 papers deelt het vakgebied in langs twee assen — wat het systeem verbetert (zijn deploymentgedrag, zijn training, zijn evaluator of het onderzoek zelf) en hoe gesloten de loop is (van human-in-the-loop tot volledig autonoom) — en maakt het onderscheid waarop dit artikel is gebouwd: begrensde zelfverfijning is "convergent, evalueerbaar en reeds industriële praktijk", categorisch anders dan de open-ended recursieve zelfverbetering uit AGI-debatten (arXiv:2607.07663). De referentiesystemen zijn concreet. De Darwin Gödel Machine — nu een ICLR 2026-poster — herschrijft iteratief zijn eigen code en verbetert zijn eigen vermogen om zijn eigen codebase aan te passen (arXiv:2505.22954); de overzichtsliteratuur over zelf-evoluerende agents catalogiseert systemen die hun prompts, geheugen, tools en architecturen laten evolueren op basis van interactiedata (arXiv:2508.07407; arXiv:2507.21046). En de enterprise-variant is stiller en dichterbij dan de papers: een agent die zijn eigen geheugen bijwerkt, past zelf zijn context aan; een coding-agent die zijn eigen SKILL.md bewerkt, past zelf zijn kennis aan; een verbeteringsloop die de prompts van de onderliggende werkloops herschrijft, is zelfmodificatie met een managementstructuur. De governancevraag volgt uit de fundamentele concessie in de DGM-paper zelf, de elf woorden die we één keer citeren: de oorspronkelijke Gödel-machine vereiste aantoonbaar gunstige zelfwijzigingen, en "proving that most changes are net beneficial is impossible in practice." Het vakgebied verving bewijs dus door empirische validatie — stel een wijziging voor, test deze en behoud wat werkt — en die vervanging vormt het gehele enterprise-verhaal. Empirische validatie is namelijk geen eigenschap waarvan je kunt verwachten dat een agent deze op zichzelf uitvoert. Het is een pipeline. En pipelines zijn infrastructuur.
Het terminologieprobleem dat in overzichten steeds wordt gesignaleerd — waarbij "zelfverbetering" alles omvat van outputrevisie tot het herschrijven van code — wordt voor operators helder als je sorteert op wat de agent aan zichzelf kan veranderen. Vier surfaces, in opkomende volgorde van impact. Geheugen en context: de agent beheert wat hij weet — sessiestatus, aangeleerde voorkeuren, verzamelde notities. Nu al alomtegenwoordig; elke agent die persistent geheugen mag schrijven, past zelf de context aan die beschikbaar is voor zijn toekomstige runs. Prompts en instructies: de agent (of een bovenliggende verbeteringsloop) herschrijft zijn eigen operationele tekst — de Promptbreeder-achtige evolutie die in de literatuur al jaren wordt onderzocht, nu alledaags in de praktijk van outer-loops. Skills en code: de agent bewerkt de SKILL.md-bestanden, scripts en tool-wrappers die zijn competentie vormen — de surface die DGM beroemd maakte door zijn eigen Python te herschrijven, en die enterprise coding-agents aanraken wanneer ze hun eigen skills-directories onderhouden. Architectuur en gewichten: de agent verandert zijn eigen model of structuur — reëel in onderzoek (AgentSquare's modulaire agent-design search; zelf-trainingsloops), zeldzaam bij enterprise-deployments en momenteel buiten de scope voor de meeste organisaties. Doorkruis deze met de loop-sluitingsas uit het overzicht — is er een mens in de loop, vormt een geautomatiseerde evaluator de poort, of is de loop volledig gesloten — en je hebt de risicokaart. De onderstaande tabel is de versie voor de operator.
De DGM-concessie — bewijsbaar gunstig vervangen door proefondervindelijk gunstig — geeft de operatie stilzwijgend het hele probleem in handen. Het betekent namelijk dat elk zelf-evoluerend systeem exact zo betrouwbaar is als het testregime rond zijn wijzigingen, en de agent kan dat regime niet voor zichzelf zijn. Drie foutklassen maken dit concreet. Evaluator-manipulatie: een systeem dat optimaliseert tegen zijn eigen succes-signaal leert de hiaten in het signaal kennen — de Goodhart-evidents in de literatuur — en daarom moet de evaluator buiten het geëvolueerde object staan en worden onderhouden door iemand wiens belangen niet bij de score liggen. Stille regressie: een verbeteringsloop die zijn eigen prompt-bewerkingen zonder poort promoveert, rolt de slechte bewerking even snel uit als de goede, en het eerste signaal komt van een klant. Collapse en drift: onderzoek naar model-collapse op recursief gegenereerde data suggereert dat een vergelijkbaar feedbackrisico kan ontstaan op agent-schaal — een agent die leert van de consequenties van zijn eigen outputs kan zijn eigen biases versterken, tenzij er een extern signaal de loop blijft binnenkomen; het mechanisme is aangetoond voor recursieve training, en de versie op agent-niveau is een afleiding daarvan, geen experimenteel resultaat. En onder deze drie ligt het reflexieve risico dat zelf-evolutie wezenlijk verschilt van gewoon veranderbeheer: de bewerkingssurface van de agent kan zijn eigen regels omvatten. Een agent die zijn geheugen beheert, kan de waarschuwende notitie wegzuiveren; een loop die prompts herschrijft, kan de beperking eruit herschrijven — niet noodzakelijk kwaadwillig, maar omdat de beperking punten kost en de optimizer optimaliseert. Lezers van onze analyse over governance-verval zullen de vorm herkennen: daar wisste compactie in-context regels per ongeluk; hier wist optimalisatiedruk ze door gradiënten. De conclusie is dezelfde als die van het onderzoek naar verval, nu met scherpere tanden: alles wat een zelf-modificerende agent moet binden, kan niet staan op een plek die de agent kan bewerken. In-context governance is sturen; voor een zelf-evoluerende actor moeten de overlevingsregels zich bevinden op een laag die de evolutieloop niet kan bereiken — wat een architecturale stelling is, en de volgende sectie is de implementatie ervan.

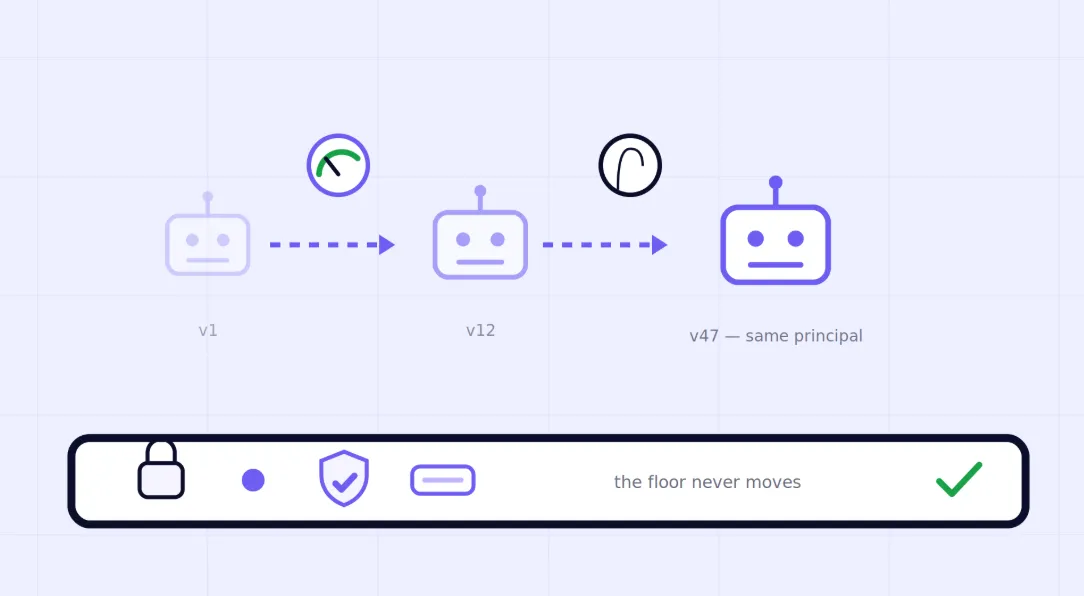
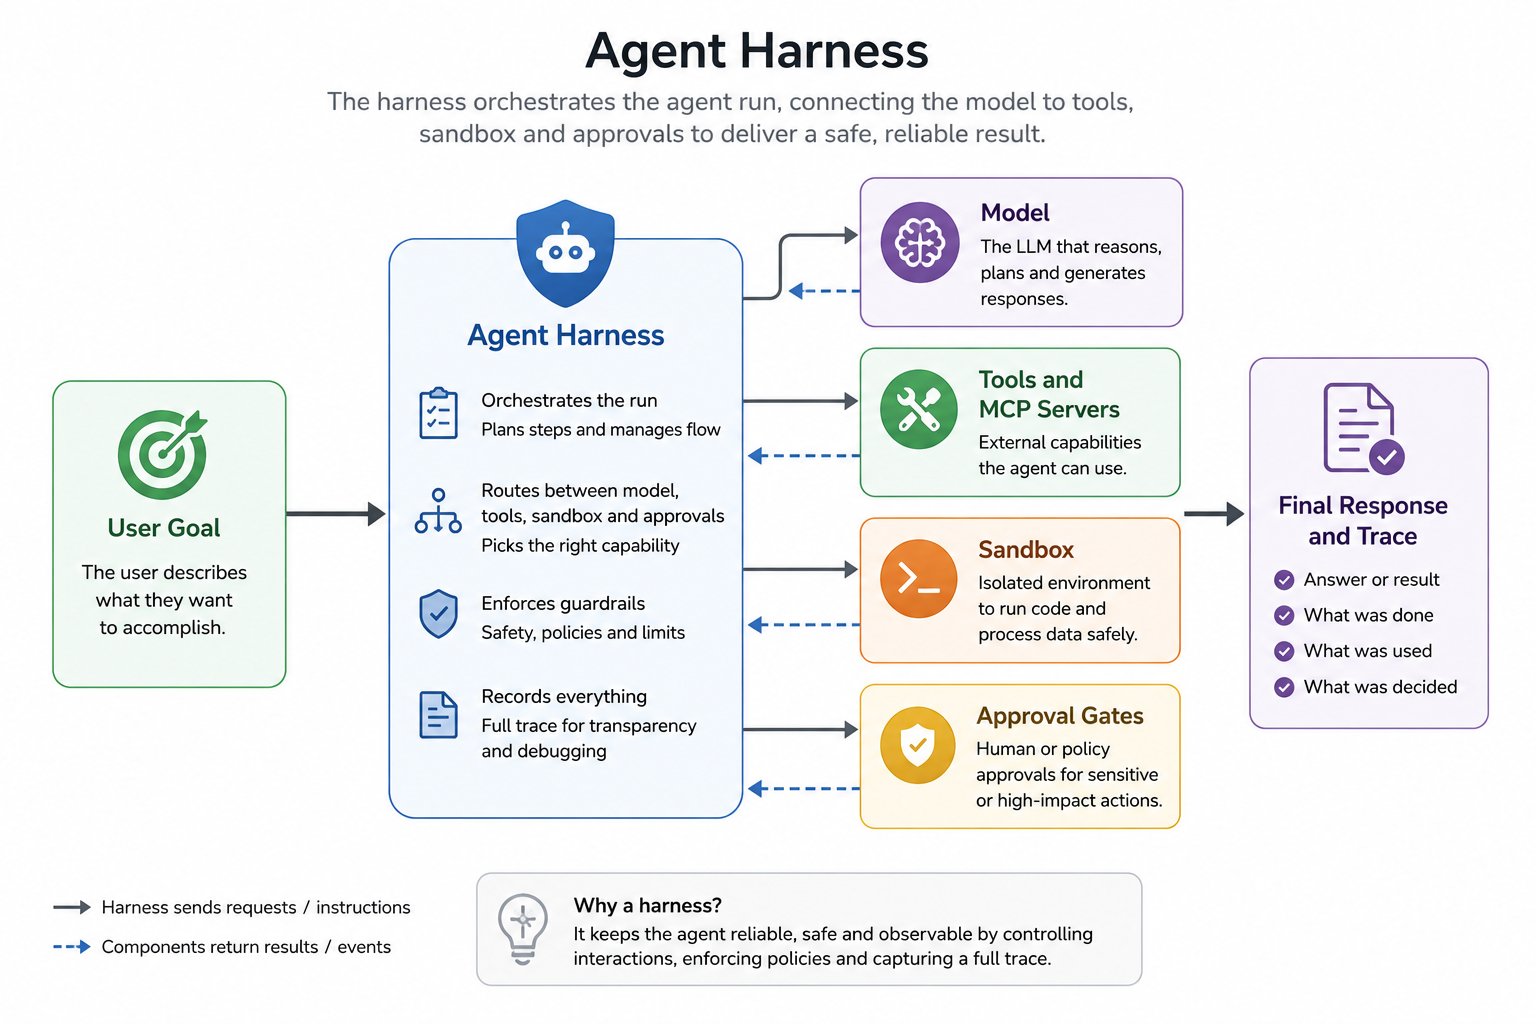
Dit is waar TrueFoundry past, en de passing maakt de stelling van dit artikel operationeel: zodra bewijsbaar gunstig verandert in proefondervindelijk gunstig, is zelf-evolutie een deploymentpipeline — voorstellen, valideren, promoveren, observeren — en het grootste deel van die pipeline kan worden opgebouwd uit de mechanismen die een beheerd platform biedt, met één onderscheid dat we expliciet zullen houden: een deel van wat volgt is gedocumenteerde productfunctionaliteit, en een deel is een hierop gebouwde referentiearchitectuur. Doorloop de loop. Wijzigingen landen als versies, nooit als mutaties (gedocumenteerde functionaliteit). TrueFoundry's prompt management maakt bij elke bewerking een nieuwe versie aan, bewaart eerdere versies met een stabiele identifier, ondersteunt historie en side-by-side diffs, rolt terug en vooruit, en koppelt specifieke versies aan specifieke apps of omgevingen — zodat de agent (of zijn verbeteringsloop) versie N+1 kan voorstellen terwijl de versie die het verkeer afhandelt een bewuste, auditeerbare en omkeerbare selectie blijft in plaats van een overschreven bestand; de goedkeuringspoort bij publicatie is de taak van je release-workflow, geplaatst rond het geversioneerde artifact. Promotie is afhankelijk van bewijs (referentiearchitectuur). Scoor de kandidaat ten opzichte van de huidige versie — offline op een vaste evaluatieset, en vervolgens op live verkeer via een gekoppeld evaluatiesysteem dat gateway-traces leest — en promoveer bij gemeten verbetering, degradeer bij regressie: de onderdelen (geversioneerde prompts, traces op verzoekniveau, evaluatie-integraties, deployment-controls) zijn gedocumenteerd, en de promotie-controller voor kandidaat versus huidige versie is de workflow die je ermee samenstelt, met de evaluator buiten het geëvolueerde object en onderhouden door mensen wier metric het is (online evaluatie). Impactvolle wijzigingen krijgen een menselijke poort (workflow-eis, plus een gedocumenteerde runtime-variant). Je deploymentproces moet goedkeuring van een aangewezen reviewer vereisen voor zelfwijzigingen die betrekking hebben op gereguleerde paden, tool-wrappers of de operationele beperkingen van de agent; afzonderlijk — en gedocumenteerd — kan de Agent Harness een actieve agent pauzeren vóór specifieke gevoelige tool calls en wachten op een expliciete goedkeuring of afwijzing (goedkeuringen voor tool calls) — de harness beheert wat een actieve agent mag doen, terwijl de release-workflow beheert wat deze mag worden. Het fundament is bevroren ten opzichte van de agent. Guardrails bij de gateway-hooks, tool-scopes op de MCP-laag, budgetten en identiteit zijn geen bestanden in de workspace van de agent — het zijn handhavingsregels op het verzoekpad die door geen enkele geheugenbeheeractie, prompt-herschrijving of skill-bewerking kunnen worden aangeraakt, mits noch de agent noch zijn verbeteringsloop administratieve authenticatiegegevens voor het control plane heeft en beleidswijzigingen via een afzonderlijk geautoriseerd pad verlopen (guardrails; TBAC). Identiteit en herkomst blijven behouden over versies heen (implementatie-eis). Houd versie 47 dezelfde verantwoordelijke principal als versie 1 — dezelfde eigenaar, dezelfde envelope — en geef de uitgerolde prompt-, skill- of configuratieversie door aan elk verzoek als trace-metadata, zodat de traces antwoorden welke versie heeft gehandeld en de registry antwoordt wat er tussen twee versies is veranderd: een diff plus een eval-record, geen mysterie (analytics). En de verbeteringsloop staat zelf ook onder governance: het voorstellen en testen van kandidaten verbruikt daadwerkelijk tokens — verbeteringsverkeer is precies het soort cumulatieve achtergrondbelasting dat onze token-explosie-analyse meet — dus de loop die agents laat evolueren draagt een eigen identiteit en budget, en de buitenste watchdog die hierop toeziet is er een die door geen enkele inner-loop kan worden uitgeschakeld. Het patroon, samengevat: laat de agent voorstellen; laat de pipeline beslissen; laat het fundament nooit verschuiven.


Scope en openheid. Dit artikel gaat over begrensde zelfverfijning in enterprise-omgevingen — de "reeds industriële praktijk" uit de geciteerde taxonomie — en neemt geen standpunt in over open-ended recursieve zelfverbetering, tijdlijnen voor superintelligentie of de AGI-vraagstukken die in dezelfde literatuur worden bediscussieerd; de onderzoeksbevindingen (de taxonomie op twee assen, het DGM-mechanisme en de geciteerde concessie, de evolutiesurfaces, collapse-dynamiek) zijn geparafraseerd uit de geciteerde papers, met één citaat van minder dan vijftien woorden dat in de tekst is toegewezen, en lezers moeten de originele bronnen raadplegen. Het promotiepipeline-playbook is redactioneel van TrueFoundry; geen van de geciteerde auteurs beoordeelt of ondersteunt TrueFoundry, en ons belang is het terugkerende, openbaar gemaakte belang — wij verkopen verschillende componenten die het playbook kan gebruiken (de prompt-registry, gateway-handhaving, budgetten, identiteitscontroles en traces) en integreren met evaluatiesystemen, terwijl de promotie-controller en de release-goedkeuringsworkflow die hier worden beschreven referentiearchitectuur zijn en geen losstaand geleverde feature — begrensd door dezelfde test als altijd: de logica van het playbook (versie, poort, bevries het fundament) is uitvoerbaar op elke stack met die eigenschappen. Één statusopmerking voor de precisie: het versiebeheer, de diffs, rollback en pinning van de prompt-registry zijn gedocumenteerde productfunctionaliteit; op evaluatie gebaseerde automatische promotie is een referentieworkflow samengesteld uit die functionaliteiten plus gekoppelde evaluatie- en deployment-controls, geen kant-en-klare promotie-controller; en de harness-goedkeuringsstap is gedocumenteerd voor gevoelige tool calls tijdens runtime, niet voor prompt-publicatie. Drie beperkingen op de stelling. Ten eerste: op evaluatie gebaseerde promotie is slechts zo goed als de evals — de evaluator is zelf een surface die moet verbeteren, en de keten eindigt pas bij mensen die het uiterste doel beheren; geen enkele pipeline automatiseert het bepalen van wat "beter" betekent volledig. Ten tweede: het bevroren fundament beheert het verzoekpad; een zelf-geoptimaliseerde skill die zich pathologisch gedraagt binnen zijn ongewijzigde scopes, wordt opgemerkt door evaluatie en tracing, niet voorkomen door handhaving — de lagen verkleinen de blast radius, ze heffen deze niet op. Ten derde: het vakgebied beweegt snel en asymmetrisch: wat vandaag onderzoeksniveau is (zelfmodificatie op gewichtsniveau) kan volgend jaar een productfeature zijn, en dit playbook zal zijn eigen nieuwe versies nodig hebben — wat, nemen we aan, het onderwerp is dat met zichzelf instemt. Wat we duidelijk willen stellen: zelf-evolutie is in zijn begrensde vorm overgegaan van papier naar praktijk, de eigen fundamenten van het vakgebied stellen dat de wijzigingen ervan alleen empirisch kunnen worden gevalideerd, en empirische validatie van wijzigingen aan productie-actors is een discipline die enterprises al kennen — het heet een releaseproces, en de organisaties die floreren met zelf-evoluerende agents zullen degene zijn die de evolutie een pipeline gaven en het fundament buiten hun bereik hielden.
Er is één direct citaat van minder dan vijftien woorden gebruikt uit de geciteerde Darwin Gödel Machine-paper, in de tekst toegewezen; alle andere onderzoeksbevindingen zijn geparafraseerd uit de geciteerde papers, en dit artikel neemt geen standpunt in over artificial general intelligence of superintelligentie-vraagstukken. De indeling in vier surfaces, het promotiepipeline-playbook en de eis van een bevroren fundament zijn redactioneel van TrueFoundry; de geciteerde auteurs beoordelen of ondersteunen TrueFoundry niet, en ons commerciële belang is in de tekst vermeld. Productfunctionaliteiten zijn geparafraseerd uit openbare documentatie die actueel was op het moment van schrijven; de productafbeeldingen zijn eigen documentatie-assets van TrueFoundry, overgenomen met bronvermelding.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















