



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Requesty biedt een universele LLM gateway om toegang te krijgen tot honderden modellen via één enkele API. De openbare prijzen zijn eenvoudig. Pay-as-you-go klanten betalen een toeslag van 5% op de kosten van het bovenliggende model. Er zijn geen standaard kosten per gebruiker of minimale afnameverplichtingen. Enterprise-plannen maken gebruik van aangepaste prijzen.
Dit model is geschikt voor teams die een beheerde AI Gateway willen met brede modeltoegang en minimale infrastructuurwerkzaamheden. Requesty omvat routing, caching, failover, uitgavenbeheer en observabiliteit over meer dan 600 modellen. Teams kunnen ook hun eigen provider-sleutels meenemen, waar Requesty momenteel vermeldt dat de toeslag 0% wordt.
Enterprise-kopers moeten daarom verder kijken dan het getoonde percentage. De werkelijke Requesty AI kosten hangen af van modelselectie, verkeer, provider-contracten, outputgrootte en agent-pogingen. Beveiligingseisen en behoeften aan private implementatie kunnen de uiteindelijke platformbeslissing eveneens veranderen.
Requesty biedt drie openbare prijsmodellen. De gratis tier biedt toegang tot modellen met 200 dagelijkse verzoeken en vereist geen creditcard. Pay-as-you-go toegang voegt 5% toe aan de prijzen van het bovenliggende model. Enterprise-prijzen hangen af van organisatorische controles, ondersteuningsvereisten en onderhandelde voorwaarden.
Een API-sleutel geeft toepassingen toegang via het universele eindpunt. BYOK is belangrijk voor bedrijven die onderhandelde provider-tarieven hebben met OpenAI, Anthropic of andere leveranciers. Het stelt teams in staat die contracten te behouden terwijl ze de routing- en monitoringslaag van Requesty gebruiken.
De volgende voorbeelden gaan uit van een model dat $10 per miljoen tokens kost. Ze gaan er ook van uit dat Requesty de modeltoegang biedt onder de 5% pay-as-you-go structuur. BYOK-workloads zouden een andere gateway-kostenstructuur volgen omdat Requesty daar momenteel 0% toeslag vermeldt.
Deze cijfers illustreren de prijsstructuur in plaats van de verwachte klantuitgaven. Werkelijke modelkosten variëren sterk per provider en model. GPT, Gemini, Claude en Mistral kunnen ook verschillende prijzen hebben voor input, output en gecachete tokens.

Dit maakt Requesty gemakkelijk te begrijpen voor beginnende teams die voorspelbare pay-as-you-go toegang willen. Eenvoudig om te starten. Eenvoudig uit te leggen aan finance. De gehele prijzenpagina is één enkel scherm.
Requesty positioneert zichzelf als een beheerde gateway voor grote taalmodellen. Het platform omvat modeltoegang, betrouwbaarheid, kostenbeheersing, caching en monitoring. Het ondersteunt OpenAI, Anthropic, Google, AWS Bedrock, Gemini, Mistral en andere providers via één compatibele interface.
De gateway-laag omvat diverse mogelijkheden buiten modeltoegang:
Requesty publiceert ook operationele gegevens op provider-niveau over succespercentages, streaming-adoptie en cache-hit-gedrag. Deze verschillen tonen aan waarom modelkeuze alleen de productieprestaties niet bepaalt. Betrouwbaarheid van de provider kan routing-beslissingen materieel beïnvloeden.
Requesty stuurt verkeer via een OpenAI-compatibele interface. Bestaande OpenAI SDK-integraties kunnen overstappen door de basis-URL en de Requesty-authenticatie aan te passen. Hetzelfde patroon werkt bij verschillende veelvoorkomende ontwikkelingstools en frameworks.
Als u al gebruikmaakt van de OpenAI SDK, richt u deze op het router-eindpunt op router.requesty.ai en wijzigt u de model-string:
Modellen volgen een provider/model-naam syntaxis, en u kunt ook verwijzen naar routing-beleid met policy/policy-naam zodat de gateway het model voor u kiest.

Het percentage zelf is eenvoudig, maar productieverkeer is dat zelden. Finance-teams moeten het verzoekvolume, de contextgrootte, de outputs, het aantal pogingen, de routing en de providerselectie schatten. Caching verandert ook de effectieve uitgaven wanneer herhaalde inhoud in aanmerking komt voor een cache-korting.
Agent-workloads maken voorspellen moeilijker omdat een enkele gebruikersactie meerdere modelaanroepen kan activeren. Een router kan ook van model wisselen na fouten of capaciteitsproblemen. Verschillende fallback-policys kunnen daarom zowel de betrouwbaarheid als de totale uitgaven veranderen.
Voor een eenvoudige illustratie: overweeg 2,5 miljard maandelijkse tokens op een model van $10 per miljoen. Provider-uitgaven worden $25.000. Een 5% Requesty pay-as-you-go vergoeding voegt $1.250 toe. Die berekening verandert bij BYOK omdat Requesty momenteel vermeldt dat uw eigen provider-sleutels geen toeslag dragen.
De bredere les is dat prijsstelling op basis van percentages de provider-uitgaven volgt. Teams moeten gebruikspatronen modelleren voor hun facturen in plaats van te vertrouwen op gemiddelde tokenprijzen. TrueFoundry’s LLM kostenoptimalisatiegids legt uit hoe routing, caching, budgetten en attributie de productie-AI-uitgaven beïnvloeden.
Bij het budgetteren moet ook rekening worden gehouden met waarschuwingen, uitgavenlimieten en handhavingsgedrag. Requesty ondersteunt budgetlimieten en automatische stopzetting. Dit onderscheid is van belang omdat het monitoren van uitgaven en het stopzetten van uitgaven verschillende operationele behoeften oplossen.
Requesty en TrueFoundry gebruiken verschillende prijsmodellen. Requesty rekent een toeslag van 5% op de kosten van het bovenliggende model voor standaard pay-as-you-go verkeer. TrueFoundry maakt gebruik van prijsplannen, beginnend met een gratis Developer tier. De prijsplannen schalen vervolgens op basis van het verzoekvolume en de platformvereisten.
Het verschil wordt belangrijker naarmate het gebruik groeit. Requesty-kosten stijgen met de provider-uitgaven, dus dwat duurder modellen of langere outputs de gateway-kosten verhogen. TrueFoundry’s prijzen volgen in plaats daarvan de verzoeklimieten. Dit kan het voorspellen van governance-kosten eenvoudiger maken wanneer de modeluitgaven sneller stijgen dan het aantal verzoeken.
Implementatie creëert een tweede verschil. Requesty blijft een beheerde cloudservice, terwijl TrueFoundry’s AI Gateway ook binnen de enterprise-infrastructuur kan draaien. Dit is van belang wanneer prompts, logs of governance-controles binnen goedgekeurde beveiligingsgrenzen moeten blijven.
Geen van beide prijsmodellen is automatisch goedkoper. Prijzen op basis van een percentage kunnen goed werken voor kleinere of variabele workloads. Plannen op basis van verzoeken kunnen voorspelbaarder worden naarmate het productiegebruik toeneemt.
Teams die andere gehoste gateways vergelijken, kunnen ook TrueFoundry’s OpenRouter prijsanalyse bekijken voor een ander op gebruik gebaseerd model. De LiteLLM prijsgids biedt een nuttige vergelijking voor teams die open-source gateway-infrastructuur overwegen.
De uiteindelijke beslissing moet rekening houden met Requesty AI prijzen, modelgebruik, implementatiebehoeften en het niveau van governance dat vereist is in productie.
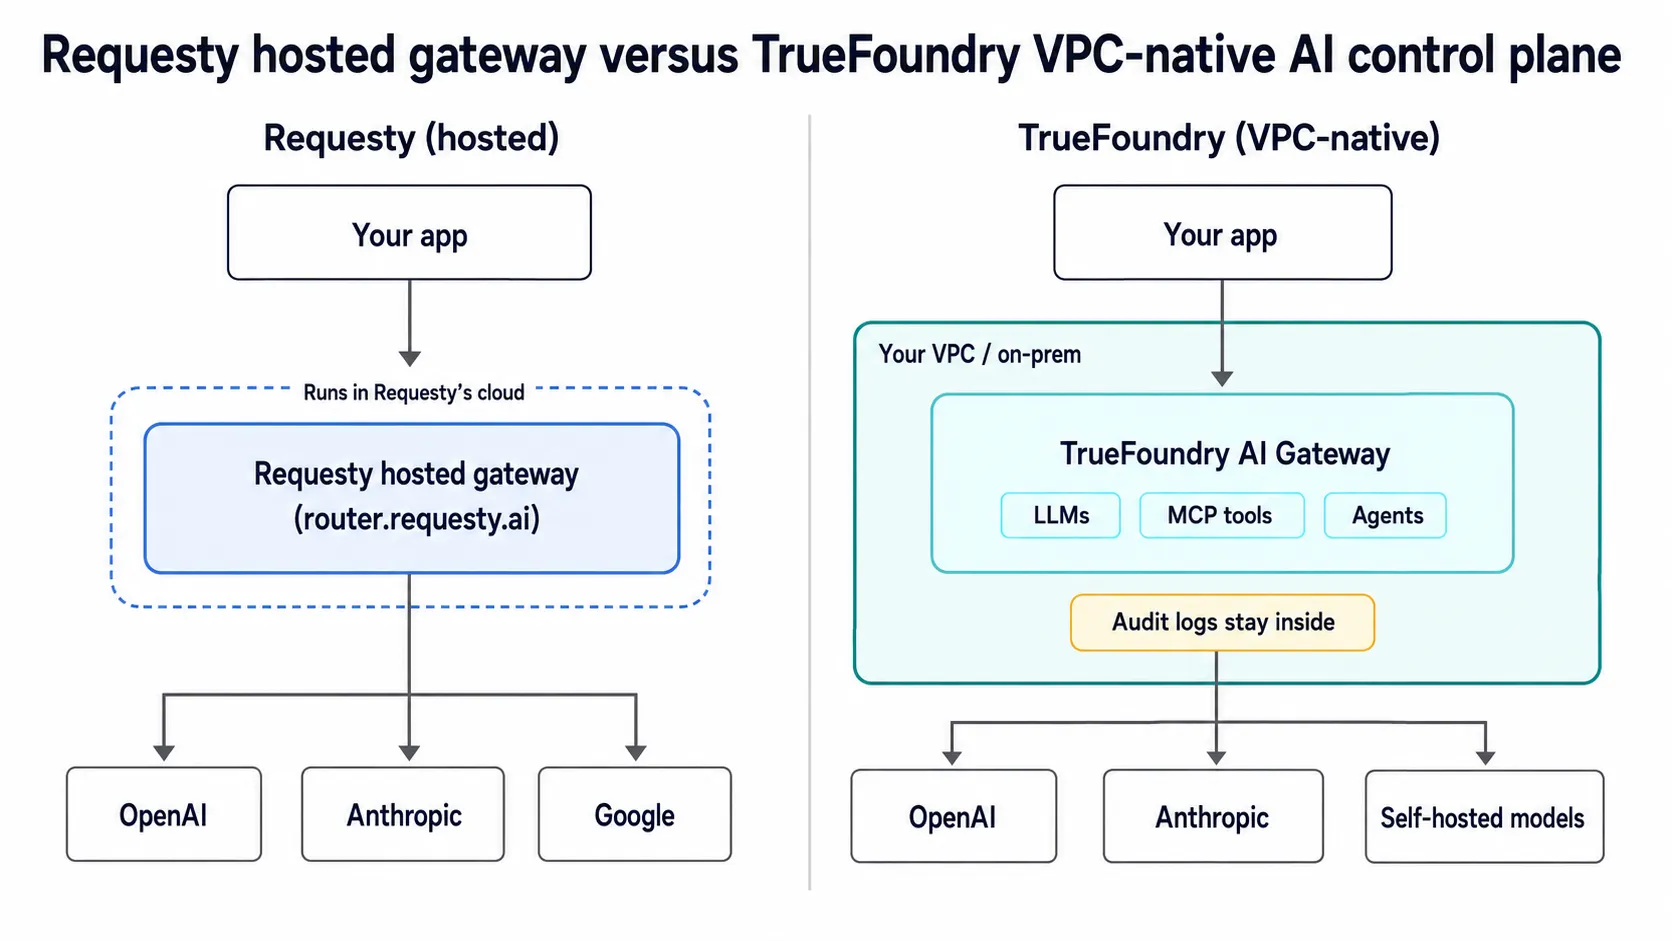
Requesty werkt goed wanneer teams modelkeuze nodig hebben zonder gateway-infrastructuur te hoeven beheren. De beheerde service vermindert de insteltijd terwijl het slimme routing, failover, monitoring en budgetcontroles biedt. Dat kan het voor sommige beginnende workloads het beste alternatief maken voor directe provider-integratie.
Requesty is een goede keuze wanneer:
Neem een productteam dat $500 per maand uitgeeft aan providers via de universele sleutel van Requesty. De gateway-vergoeding zou ongeveer $25 toevoegen onder de huidige 5% structuur. Het intern bouwen van gelijkwaardige routing en monitoring zou op die schaal zelden logisch zijn.
Het beeld verandert naarmate het verkeer verdeeld raakt over meerdere teams en agent-workflows. Grotere omgevingen vereisen mogelijk sterkere configuratiecontroles, gedetailleerde metadata, private netwerken en een geconsolideerd identiteitsbeleid. Die vereisten zijn vaak belangrijker dan de percentagevergoeding zelf.
Requesty AI's prijzen kunnen aantrekkelijk blijven, zelfs als de architectonische vereisten de mogelijkheden van het implementatiemodel overstijgen. Requesty is volledig beheerd en biedt momenteel geen self-hosting. Enterprise-teams kunnen gebruikmaken van EU-residency via Frankfurt en selecte regionale model-eindpunten waar beschikbaar.
De positie met betrekking tot dataretentie vereist ook zorgvuldige lezing. Zelfservice-logging is standaard ingeschakeld en kan prompt-inhoud tot 30 dagen bewaren. Teams kunnen inhoud-logging per sleutel uitschakelen. Geen retentie voor de gehele organisatie is beschikbaar op schriftelijk verzoek.
Requesty vermeldt momenteel dat het SOC 2 Type II-programma nog in behandeling is. De beveiligingspagina vermeldt de verwachte voltooiing in Q3 2026. Enterprise procurement teams moeten de huidige certificeringsstatus rechtstreeks verifiëren voordat ze hier op vertrouwen voor compliance.
Enterprise-teams moeten zich afvragen:
Zelfde vragen zijn van toepassing wanneer een chat-toepassing verandert in een autonome workflow. Agents kunnen herhaaldelijk modellen aanroepen en interne systemen aanspreken. De controle-eisen verschuiven dan van modelselectie naar identiteit, tools, kosten en uitvoeringsbeleid.
Voor ondernemingen die het beste alternatief zoeken buiten beheerde model-routing, pakt TrueFoundry een breder scala aan infrastructuurbehoeften aan. De AI Gateway centraliseert modeltoegang, routing, guardrails, kostenbeheersing en observabiliteit. Hetzelfde platform kan draaien als SaaS of binnen private enterprise-omgevingen.
TrueFoundry ondersteunt ook providers zoals OpenAI, Anthropic, Google en self-hosted modellen via één enkele interface. Teams kunnen latentie, kosten, fouten en verzoekniveau-analytics volgen over gedeeld productieverkeer. Beleid kan aangepaste metadata gebruiken voor attributie aan teams, klanten, projecten of omgevingen.
Drie controles worden belangrijk naarmate workloads uitbreiden:
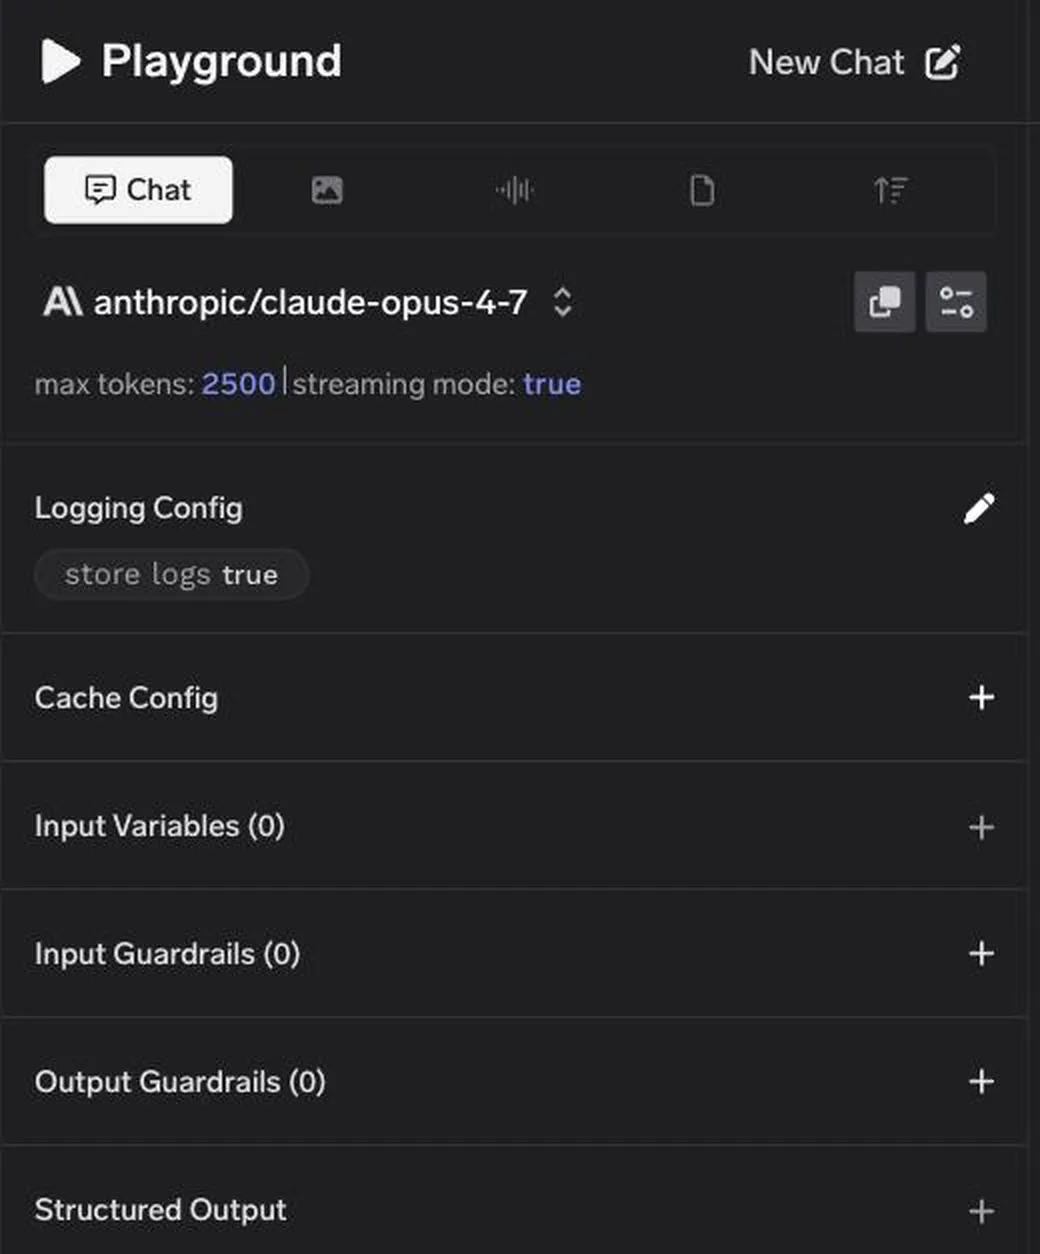
TrueFoundry maakt ook gebruik van een OpenAI-compatibele interface, dus de adoptie vereist geen nieuwe SDK. Bestaande toepassingen kunnen hun URL's naar de gateway richten met behulp van vertrouwde verzoek-formats. Het geselecteerde eindpunt kan TrueFoundry SaaS of een private enterprise-omgeving vertegenwoordigen.
Kostenbeheersing werkt binnen het verzoekpad. Teams kunnen op kosten of tokens gebaseerde quota instellen per gebruiker, service, model of workflow. De gateway kan de activiteit vervolgens vertragen, downgraden of blokkeren volgens het beleid.
Deze structuur is nuttig wanneer de toepassingscode onafhankelijk moet blijven van provider-logica. Het maakt ook automatische failover, routing en budgetten consistent over workloads heen, in plaats van elke regel afzonderlijk te implementeren.
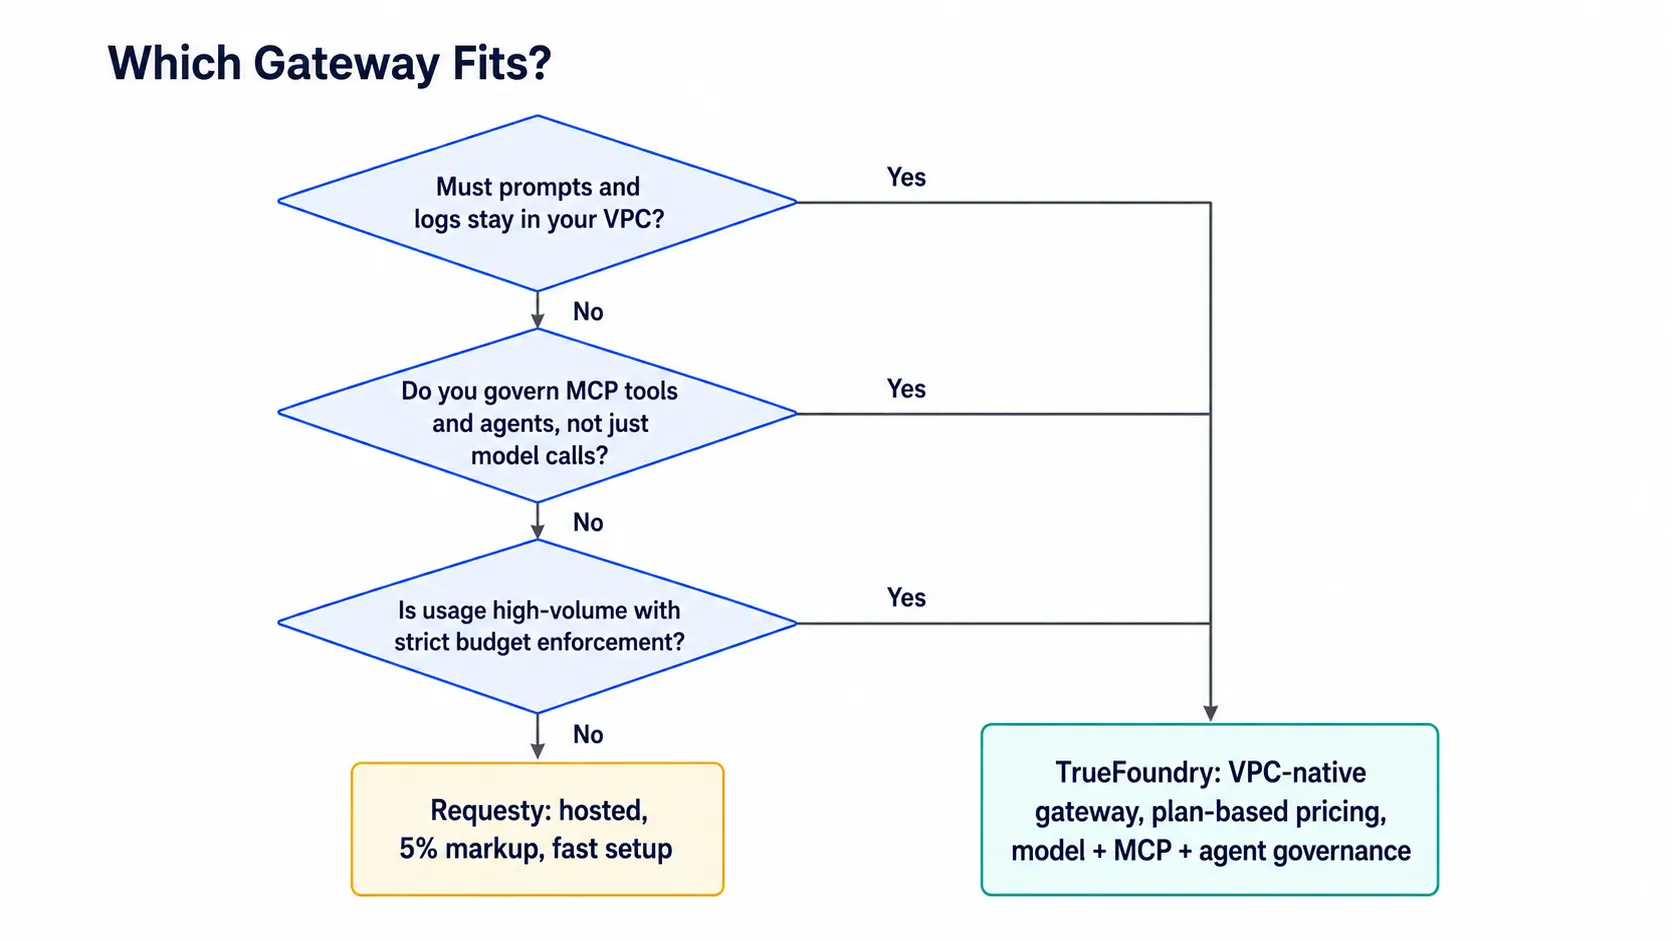
Requesty lost beheerde toegang tot meerdere providers goed op. TrueFoundry bedient ondernemingen die een gateway, modelverkeer, MCP-tools en agents nodig hebben onder één beheerde infrastructuurlaag.
Voor ondernemingen die de totale Requesty AI prijzen vergelijken met governance-vereisten, kunnen implementatiegrenzen uiteindelijk meer doorslaggevend zijn dan de kale modelkosten.
Boek een Demo met TrueFoundry om uw eisen op het gebied van modelrouting, agent-governance, implementatie en kostenbeheersing te evalueren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Requesty rekent een opslag van 5% op de upstream-modelkosten voor standaard pay-as-you-go-toegang. Er zijn geen vermelde seat-kosten of minimumuitgaven. Het gratis abonnement omvat 200 dagelijkse verzoeken. Requesty geeft momenteel aan dat BYOK-verkeer 0% opslag draagt, terwijl Enterprise-abonnementen aangepaste prijsstelling gebruiken voor geavanceerde controles en support.
Directe providertoegang vermijdt de 5% pay-as-you-go-opslag van Requesty. De vergoeding dekt managed routering, fallbacks, caching, monitoring, budgetten, en uniforme modeltoegang. BYOK verandert de vergelijking, omdat Requesty momenteel 0% opslag documenteert wanneer klanten hun eigen providersleutels aanleveren. Engineeringinspanning en operationele vereisten moeten daarom worden meegenomen naast ruwe tokenprijzen.
Modelkeuze veroorzaakt meestal de grootste variatie, omdat input- en outputprijzen aanzienlijk verschillen. Outputlengte, retries, routeselectie, en cacheprestaties beinvloeden ook de totale uitgaven. Enterprise-vereisten kunnen aangepaste prijsstelling toevoegen voor SSO, RBAC, auditlogs, guardrails, en support. BYOK kan de economie verder veranderen voor bedrijven die al onderhandelde providerovereenkomsten hebben.
Requesty biedt Enterprise SSO, RBAC, auditlogs, modelbeleid, uitgavencontroles, guardrails, en EU-dataresidentie. Het platform blijft volledig managed en ondersteunt momenteel geen self-hosting. Het SOC 2 Type II-programma staat ook vermeld als in uitvoering. Ondernemingen moeten daarom de controles ervan vergelijken met hun interne implementatie-, dataresidentie-, en compliance-vereisten.
TrueFoundry is a strong alternative when enterprises require SaaS alongside VPC, on-premises, or air-gapped deployment options. Its AI Gateway governs model access, routing, budgets, and guardrails. MCP and Agent Gateways extend those controls across enterprise tools and autonomous workflows. This broader scope suits teams whose infrastructure requirements extend beyond hosted model routing alone.



Het laatste nieuws, artikelen en bronnen in je inbox

















