Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
Verlaag uw infrastructuurkosten voor ML / LLM-modellen
Workloads voor machine learning (ML) en large language models (LLM) staan erom bekend erg duur te zijn om in de cloud uit te voeren. Dit komt doordat ze aanzienlijke hoeveelheden rekenkracht, geheugen en opslag vereisen. Er zijn echter manieren om uw cloudkosten voor ML/LLM-workloads te verlagen zonder in te boeten op schaalbaarheid of betrouwbaarheid.
Belangrijkste principes voor het verlagen van kosten
Beter inzicht voor DevOps-engineers en ontwikkelaars: Inzicht krijgen in cloudkosten is lastig, vooral wanneer u meerdere componenten hebt geïmplementeerd over meerdere clouds. TrueFoundry biedt inzicht in cloudkosten op cluster-, workspace- en deploymentniveau, waardoor DevOps-teams en ontwikkelaars de mogelijkheid krijgen om gedurende de gehele ML/LLM-levenscyclus besparingsmogelijkheden te identificeren en te optimaliseren.
Eenvoud van middelenbesteding aanpassen: TrueFoundry stelt DevOps-teams en ontwikkelaars in staat om direct te handelen op basis van het verkregen kosteninzicht.
DevOps-teams kunnen limieten voor resources instellen op projectniveau, zodat de workloads van elk team toegang hebben tot de benodigde resources zonder het budget te overschrijden.
Ontwikkelaars kunnen resources ook eenvoudig onderweg aanpassen op basis van de inzichten die ze krijgen. Bovendien maakt TrueFoundry het eenvoudig om applicaties en IDE's naar nul te schalen in niet-productieomgevingen, wat de kosten van ongebruikte resources elimineert en iteratiecycli voor kostenverlaging efficiënter maakt.
Infrastructuuroptimalisatie voor kosten: De op Kubernetes gebaseerde architectuur en infrastructuuroptimalisaties van TrueFoundry zijn ontworpen om cloudkosten te verlagen.
Over het geheel genomen bieden de kostenbesparende functies van TrueFoundry DevOps-teams en ontwikkelaars het inzicht, de controle en de optimalisatiemogelijkheden die ze nodig hebben om cloudkosten gedurende de gehele ML/LLM-levenscyclus te verlagen.
Overstap van AMI naar Docker: Ons platform heeft veel bedrijven geholpen bij de migratie van AMI naar Docker, waarbij bedrijven al kostenbesparingen van 30 tot 40 procent hebben ervaren.
TrueFoundry: Uw Cost-First platform
Truefoundry is een "cost-first" platform, gebouwd rond Kubernetes, ontworpen met een architectuur die prioriteit geeft aan efficiëntie, cloud scalability en kostenverlagingen.
Laten we verkennen hoe de unieke architectuur van TrueFoundry u in staat stelt te besparen op kosten terwijl u optimaliseert voor betrouwbaarheid en schaalbaarheid. Dit is de hiërarchische structuur van het platform:
Clusters: Verbind al uw clusters, of het nu gaat om AWS EKS, Azure AKS, GCP GKE of een on-premise cluster, met het platform. Hiermee kunt u al uw clusters naadloos op één plek integreren. Deze clusters vormen de basis voor het implementeren van een breed scala aan services, modellen en jobs.
Workspaces: Binnen clusters introduceren we workspaces, wat een gestroomlijnde aanpak biedt voor toegangsbeheer en isolatie. Dit zorgt ervoor dat elk project of elke omgeving de eigen toegewezen resources heeft en beschermd is tegen onbevoegde toegang. Zie ze als groepen van deployments.
Deployments: Binnen deze workspaces hebben we deployments en we ondersteunen u bij het implementeren van verschillende soorten toepassingen. Met TrueFoundry kunt u moeiteloos elk aspect van uw ML-ontwikkelingslevenscyclus afdekken.
Interactive Development Environments: Implementeer Jupyter Notebook en VS Code voor collaboratieve experimenten.
Training en Fine-tuning Jobs: Train ML-modellen of fine-tune LLM-modellen efficiënt door ze als job te implementeren.
Pre-trained LLMs: Implementeer snel vooraf getrainde Large Language Models voor specifieke use-cases via onze Model Catalogue.
Services en Apps: Implementeer een verscheidenheid aan services en applicaties, waaronder modellen, web-apps enz.
Application Catalog: Implementeer populaire software zoals Label Studio, Redis, Qdrant enz. met gemak.
Kostenbesparingen op Clusterniveau
Op Kubernetes gebaseerde infrastructuur
Kubernetes draagt bij aan kostenverlaging door gebruik te maken van bin-packing om de resourcebenutting te optimaliseren, containers efficiënt te plaatsen en uiteindelijk de infrastructuurkosten te verlagen.
Lees hier meer over hoe TrueFoundry Kubernetes benut.
💡
EC2 naar Kubernetes migratie: Veel bedrijven zijn na de overstap naar ons platform succesvol overgestapt van EC2-machines naar Kubernetes, wat heeft geleid tot kostenbesparingen door een betere toewijzing van resources.
Multi-cloud ondersteuning
De multi-cloud architectuur van TrueFoundry maakt het eenvoudig om verbinding te maken met verschillende cloudproviders.
Flexibiliteit om te wisselen tussen clouds: Door eenvoudig te kunnen wisselen tussen verschillende cloudproviders, kunt u profiteren van de beste prijzen en functies van diverse aanbieders.
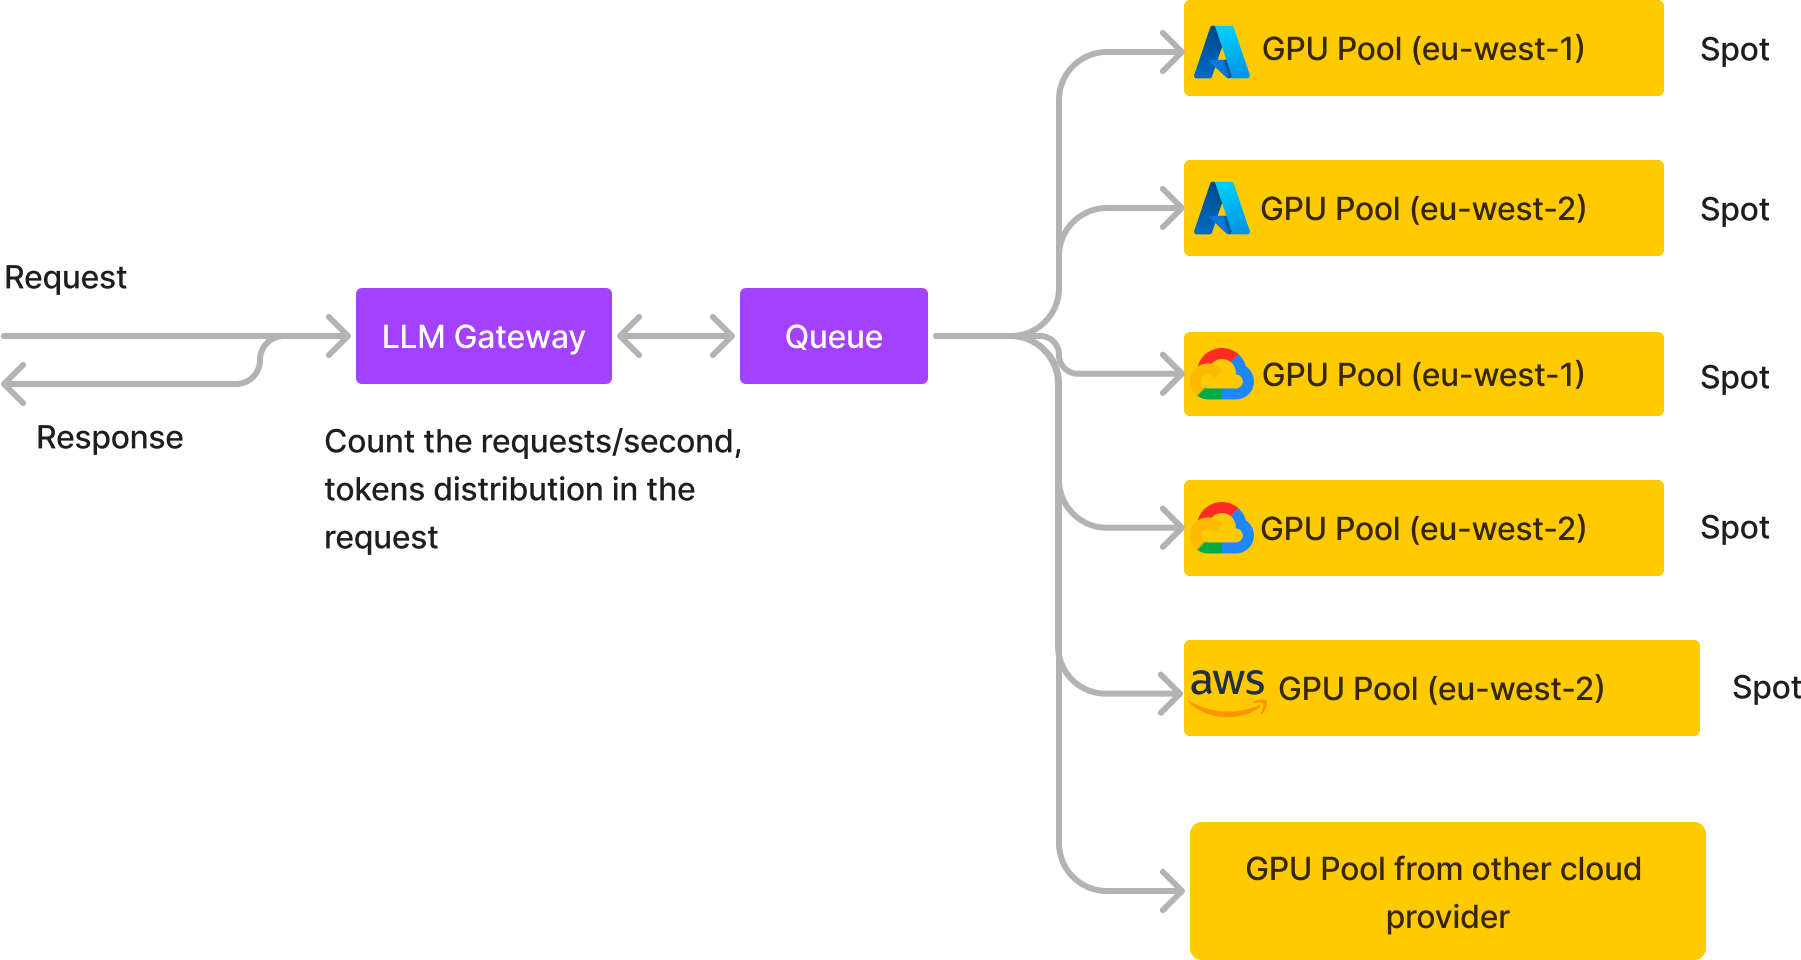
Verdeel workloads over clouds en regio's: Door uw workloads te verspreiden over meerdere cloudproviders en regio's. Dit kan helpen de kosten te verlagen door uw workloads te verdelen over verschillende prijscategorieën en regio's. Het helpt ook om de prestaties en betrouwbaarheid te verbeteren door de afhankelijkheid van één enkele cloudprovider te verminderen.
Hoge beschikbaarheid van instance-quota: Door meerdere cloudproviders te gebruiken, krijgt u toegang tot meer resources. Dit kan u helpen geld te besparen en beperkingen op de benodigde resources te voorkomen.
LLM's schalen over meerdere clouds en regio's
💡
Een middelgrote aanbieder van conversationele AI-chatbots met hoog gebruikersverkeer (20+ RPS en meer dan 2 miljoen requests per dag) draait volledig op gedistribueerde spot GPU-instances over vijf clusters in verschillende clouds en regio's via onze asynchrone service. Dit verlaagt hun infrastructuurkosten met 60% terwijl de betrouwbaarheid en doorvoer verbeteren.
Verbeterd inzicht
Voor elk cluster kunt u het aantal actieve nodes in het cluster bekijken. U kunt ook inzicht krijgen in node-specifieke details zoals:
Besparingsanalyse: Zie het percentage van de kosten dat voor elke node wordt bespaard.
Inzichten in resourcetoewijzing: Bekijk het huidige gebruik, de resource-requests en -limits om onderbouwde beslissingen te nemen.
Inzichten in capaciteitstype: Zie welk type nodes er in uw cluster draait, of het nu spot- of on-demand-nodes zijn.
Kostenbesparingen op Workspaceniveau
Resource-limieten
TrueFoundry stelt u in staat om meerdere workspaces te maken binnen een cluster. Deze segmentatie helpt u bij het organiseren van uw deployments voor verschillende teams of omgevingen.
Resource-beperkingen: Pas resource-beperkingen aan voor elke workspace, inclusief CPU, geheugen, opslag en zelfs instance-families. Hiermee kunt u de resources toewijzen die voldoen aan de specifieke vereisten van uw project of omgeving.
Ondersteunde instance-families: Stem uw workspace af op specifieke prestatie-eisen en budget door de instance-families te selecteren die deze ondersteunt.
Als een project bijvoorbeeld geen high-performance computing vereist, kunt u grotere instances in die workspace uitschakelen. Dit helpt te voorkomen dat ontwikkelaars te veel resources toewijzen, wat geld bespaart.
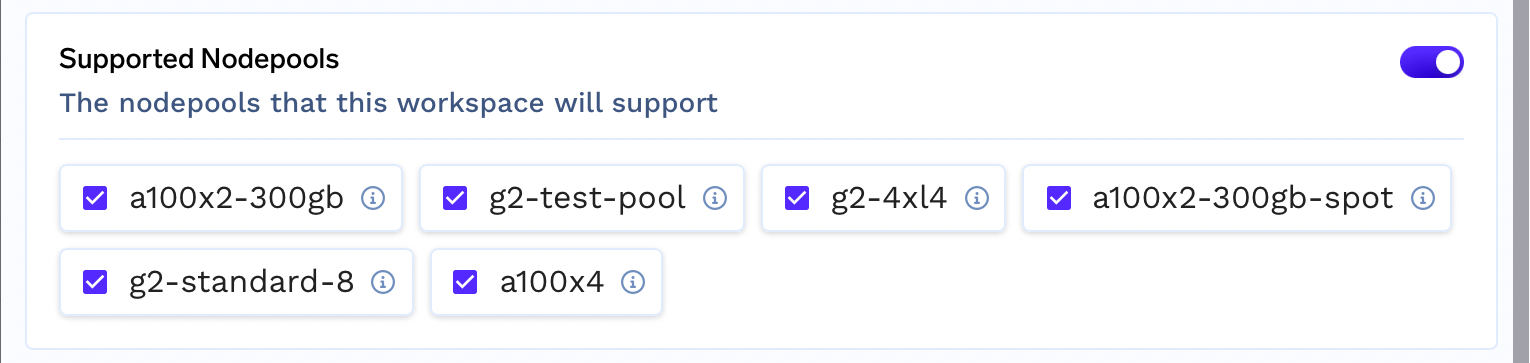
Ondersteunde node pools: Nodepools zijn groepen nodes die de rekenkracht leveren voor uw workloads. U kunt de node pools kiezen die het beste passen bij uw workloads en budget.
U kunt bijvoorbeeld een node pool maken met A100 GPU's. Vervolgens kunt u die specifieke node pool alleen inschakelen voor projectworkspaces die toegang tot dat type GPU nodig hebben.
Kosten op workspaceniveau bijhouden
We bieden u ook inzicht om uw kosten op workspaceniveau bij te houden op basis van historisch gebruik. Hiermee kunt u identificeren welke projecten of omgevingen de meeste resources gebruiken en waar u kunt besparen.
Kostenbesparingen op Deploymentniveau
We bieden geavanceerde functies op applicatieniveau om u te helpen aanzienlijke kostenbesparingen te realiseren:
Spot Instances met fallback naar On-Demand: Normaal gesproken hebben applicaties moeite om kosten en betrouwbaarheid in balans te houden. Met TrueFoundry kunt u het capaciteitstype voor uw nodes selecteren, inclusief spot-instances met fallback naar on-demand resources. Dit zorgt ervoor dat uw applicaties beschikbaar blijven, zelfs als een spot-instance wordt ingetrokken, wat de optimale balans biedt tussen kosten en beschikbaarheid.
Services pauzeren: Pauzeer services wanneer ze niet in gebruik zijn om kosten te besparen. Pauzeer of hervat services eenvoudig vanaf de pagina met deployments.
Resource-optimalisatie: Zorg ervoor dat uw resources optimaal worden toegewezen en dat uw services op de juiste capaciteit draaien.
Resource-monitoring: Volg het resourceverbruik van uw service in real-time, inclusief CPU- en GPU-toewijzing. Ontvang meldingen over over-provisioning, under-provisioning en ontvang resource-aanbevelingen.
Dynamische resource-aanpassing: Pas resourceniveaus direct aan om te schalen naar een lagere CPU-resource en uw service dienovereenkomstig opnieuw te implementeren.
Tijdsgebonden autoscaling: Plan resource-aanpassingen op basis van tijd om de kosten in niet-productieomgevingen te verlagen tijdens perioden van laag gebruik.
💡
Veel van onze klanten besparen meer dan 60% op hun cloudkosten voor ontwikkelomgevingen door automatische uitschakeling in te plannen buiten werktijden, wat het rekengebruik met 128 uur per week vermindert.
Kostenbesparingen op de niveaus van Code Editors
We bieden specifieke functies voor Code Editors, waarmee u aanzienlijke kostenbesparingen kunt behalen op het niveau van Notebooks en VSCode:
Gedeelde volumes: Gebruik volumes op basis van behoeften om grote hoeveelheden data te delen tussen Notebooks en VSCode-instances en samenwerking te vergemakkelijken. Gedeelde volumes verminderen redundantie en verhogen de efficiëntie, vooral wanneer meerdere gebruikers toegang nodig hebben tot omvangrijke data in Notebooks en VSCode-instances.
Adaptief resourcegebruik: Schakel eenvoudig tussen CPU en GPU op dezelfde machine om de resourcetoewijzing te optimaliseren. U hoeft niet continu een GPU-resource aan te houden, alleen wanneer dat nodig is.
💡
Een Generatieve AI-onderneming in het videogeneratiesegment, die honderden Jupyter Notebooks op spot-instances draait voor niet-productieworkloads, bespaarde ongeveer 50-60% op cloudkosten door GPU's alleen in te schakelen wanneer dat nodig was.
Handmatig pauzeren: Pauzeer Notebooks/VSCode-instances eenvoudig wanneer ze niet in gebruik zijn. De code en data blijven behouden, wat zorgt voor een naadloze herstart wanneer dat nodig is.
Automatisch pauzeren: Configureer uw Notebooks/VSCode-instances om automatisch te pauzeren na een bepaalde periode van inactiviteit om waardevolle resources te besparen.
💡
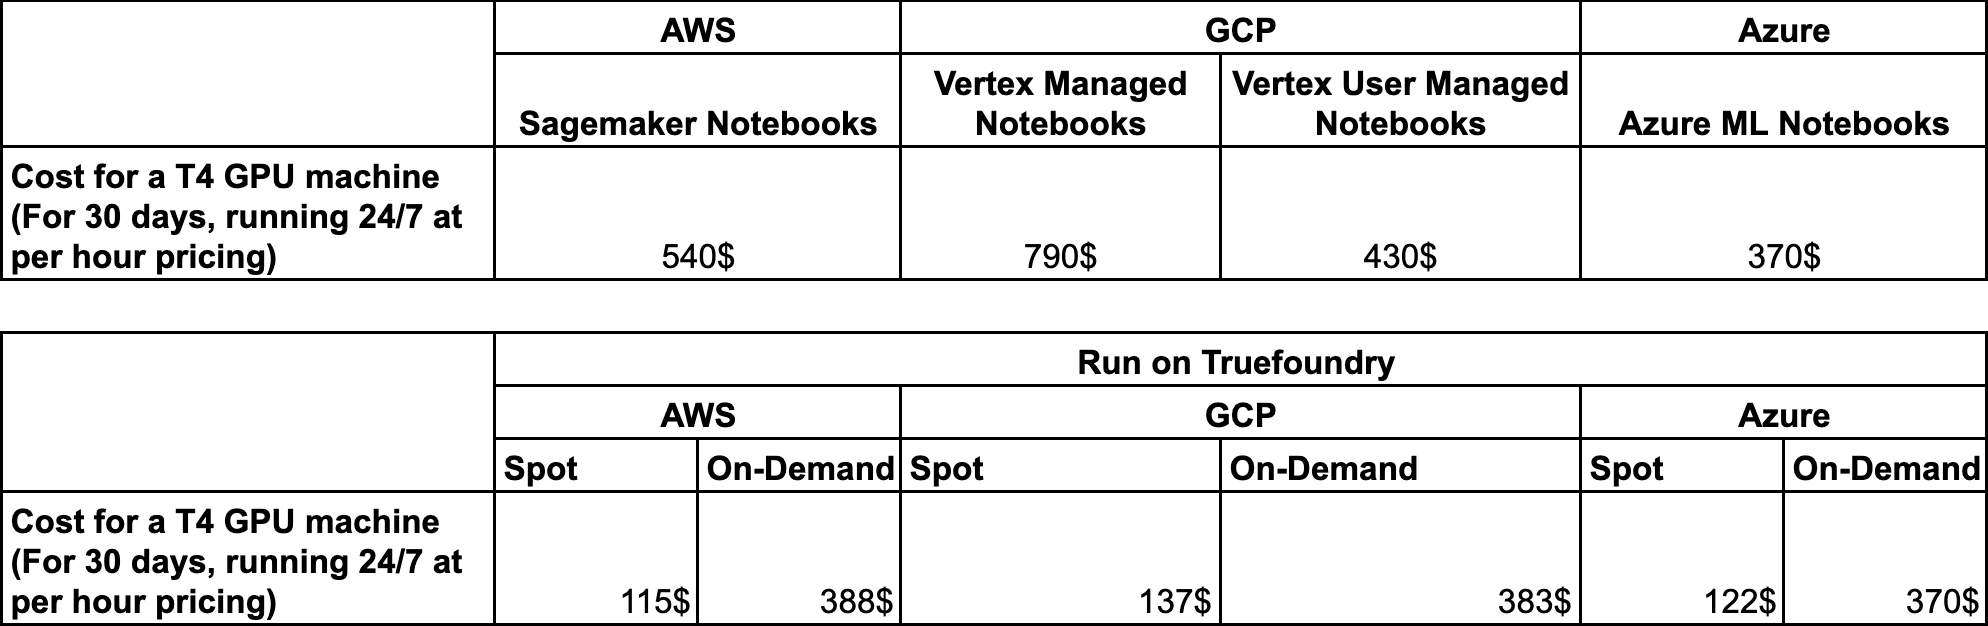
Kosten-benchmarking We hebben benchmarking uitgevoerd op AWS, GCP en Azure om de kostenbesparingen te vergelijken van het uitvoeren van Notebooks en VSCode on-demand of via de betreffende cloud.
Kostenbesparingen bij het implementeren en fine-tunen van Large Language Models (LLM's):
Onze Model Catalogue biedt een handige centrale plek voor het implementeren en fine-tunen van bekende pre-trained LLM's. We hebben de volgende stappen ondernomen om ervoor te zorgen dat deployment en fine-tuning van deze LLM's zo kostenefficiënt mogelijk zijn:
Geoptimaliseerde configuratie voor model serving: Op basis van benchmarking voor verschillende model-servers en resourcetoewijzingen bieden we u vooraf ingevulde configuraties die de beste latentie en doorvoer bieden. Dit vereenvoudigt het proces van het implementeren van LLM's en helpt u uw deployments resource-efficiënt en kosteneffectief te maken.
Efficiënte fine-tuning configuratie: We bieden efficiënte methoden voor fine-tuning, zoals LoRA en Q-LoRA, die helpen het resourcegebruik te verminderen en u in staat stellen uw doelen tegen lagere kosten te bereiken.
Schaalbare deployments met asynchrone ondersteuning: Implementeer LLM's op schaal met asynchrone ondersteuning om uw GPU-quota in alle drie de clouds optimaal te benutten en betrouwbaar de GPU's te krijgen die u nodig heeft voor fine-tuning en deployment. Deze extra betrouwbaarheid stelt u in staat om spot-instances te gebruiken, wat geld bespaart.
Benchmarking We hebben een kosten-benchmarking uitgevoerd om de uitgaven van het implementeren van LLM's op AWS EKS te vergelijken met SageMaker. U kunt er meer over lezen in de onderstaande blog.
Verschillende Fortune 100-bedrijven en middelgrote ondernemingen hebben aanzienlijk bespaard door ons platform te gebruiken. Sommigen hebben zelfs hun interne SageMaker- of cloudplatforms vervangen door ons systeem, wat 30-40% bespaart.
We hebben ook de prestaties van veel gangbare open-source LLM's gebenchmarkt in deze reeks artikelen vanuit het perspectief van latentie, kosten en requests per seconde. U kunt ze bekijken op TrueFoundry Blogs
U kunt ook deze video bekijken voor een live demo van alle functies die we in deze blog hebben behandeld:
TrueFoundry is een ML Deployment PaaS over Kubernetes om workflows van ontwikkelaars te versnellen, terwijl ze volledige flexibiliteit behouden bij het testen en implementeren van modellen, en volledige beveiliging en controle voor het infrastructuurteam wordt gewaarborgd. Via ons platform stellen we Machine Learning-teams in staat om binnen 15 minuten modellen te implementeren en te monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om in seconden terug te draaien. Hierdoor kunnen ze kosten besparen en modellen sneller naar productie brengen, wat leidt tot echte zakelijke waarde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting