



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Als u tegen OpenRouter rate limits bent aangelopen, is de reden meestal niet het verkeer. OpenRouter beperkt requests per key en per account, en de headroom die u krijgt is geïndexeerd aan de hoeveelheid credit die u heeft gekocht, dus een laag saldo betekent een lage rate limit. Dat is een factureringseigenschap die de taak van een beschikbaarheidscontrole overneemt, en het is de eerste aanwijzing dat het kostenmodel van OpenRouter en het kostenmodel van een platformteam voor verschillende mensen zijn gebouwd.
Dit artikel behandelt het onderdeel kostenbeheersing en -optimalisatie uit onze TrueFoundry vs OpenRouter-serie: rate limits, budgetten en of ze waarschuwen of blokkeren, quota en reset-vensters, kostenefficiënte routing en hoe de prijstabel wordt onderhouden, caching, en toewijzing voor chargeback. Het is geschreven voor de engineer die wordt gevraagd de LLM API-kosten te verlagen en de platform lead die erover moet rapporteren, en elke claim is ontleend aan de openbare documentatie van de twee leveranciers. Voor de positie die een LLM gateway in dat plaatje inneemt, kunt u beginnen met onze introductie.
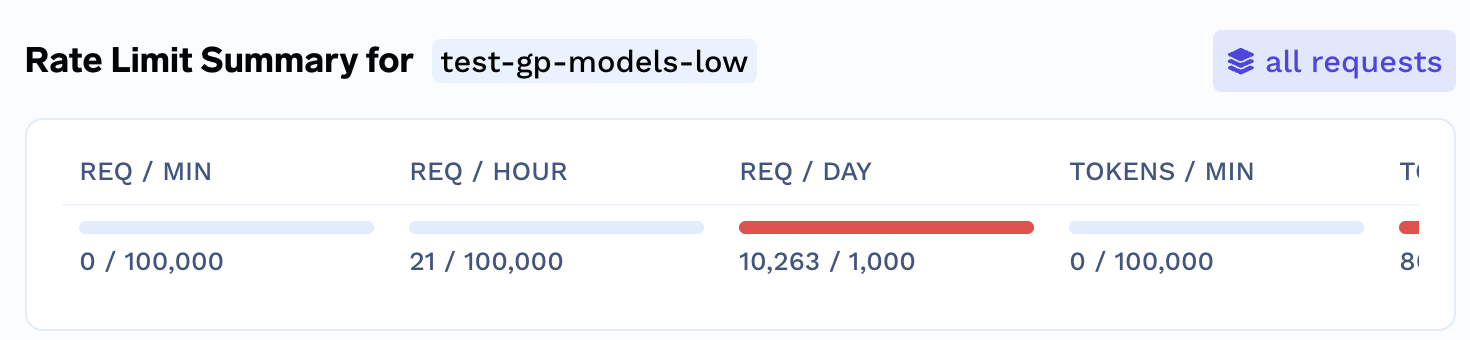
OpenRouter past rate limits toe op basis van requests, en de limieten zijn gekoppeld aan uw saldo. Gratis modelvarianten zijn beperkt tot 20 requests per minuut; accounts met minder dan $10 aan opgebouwde credit-aankopen krijgen 50 gratis model-requests per dag, wat permanent stijgt naar 1.000 per dag zodra er $10 is uitgegeven, en mislukte requests kunnen nog steeds meetellen voor het maximum. Buiten de gratis tier hangen de rate limits voor gratis modellen af van gekochte credits, waardoor de doorvoercapaciteit een functie is van het accountsaldo in plaats van een gepubliceerde quota per tenant. Token-gebaseerde limieten en concurrency-limieten zijn niet gedocumenteerd. Rate limits worden onmiddellijk afgewezen zonder queuing.
Hieruit volgen twee首页-consequenties. Ten eerste is een OpenRouter creditlimiet zowel een uitgavencontrole als een beschikbaarheidscontrole: laat het saldo laag worden en de rate limit wordt ermee verstrakt; laat het op nul komen en het verkeer stopt. Ten tweede, omdat credits zich op accountniveau bevinden terwijl workspaces eronder vallen, verbruikt het verkeer van één workspace waarschijnlijk de headroom die wordt gedeeld met elke andere workspace in de organisatie, en niets in het product beschermt dat af.
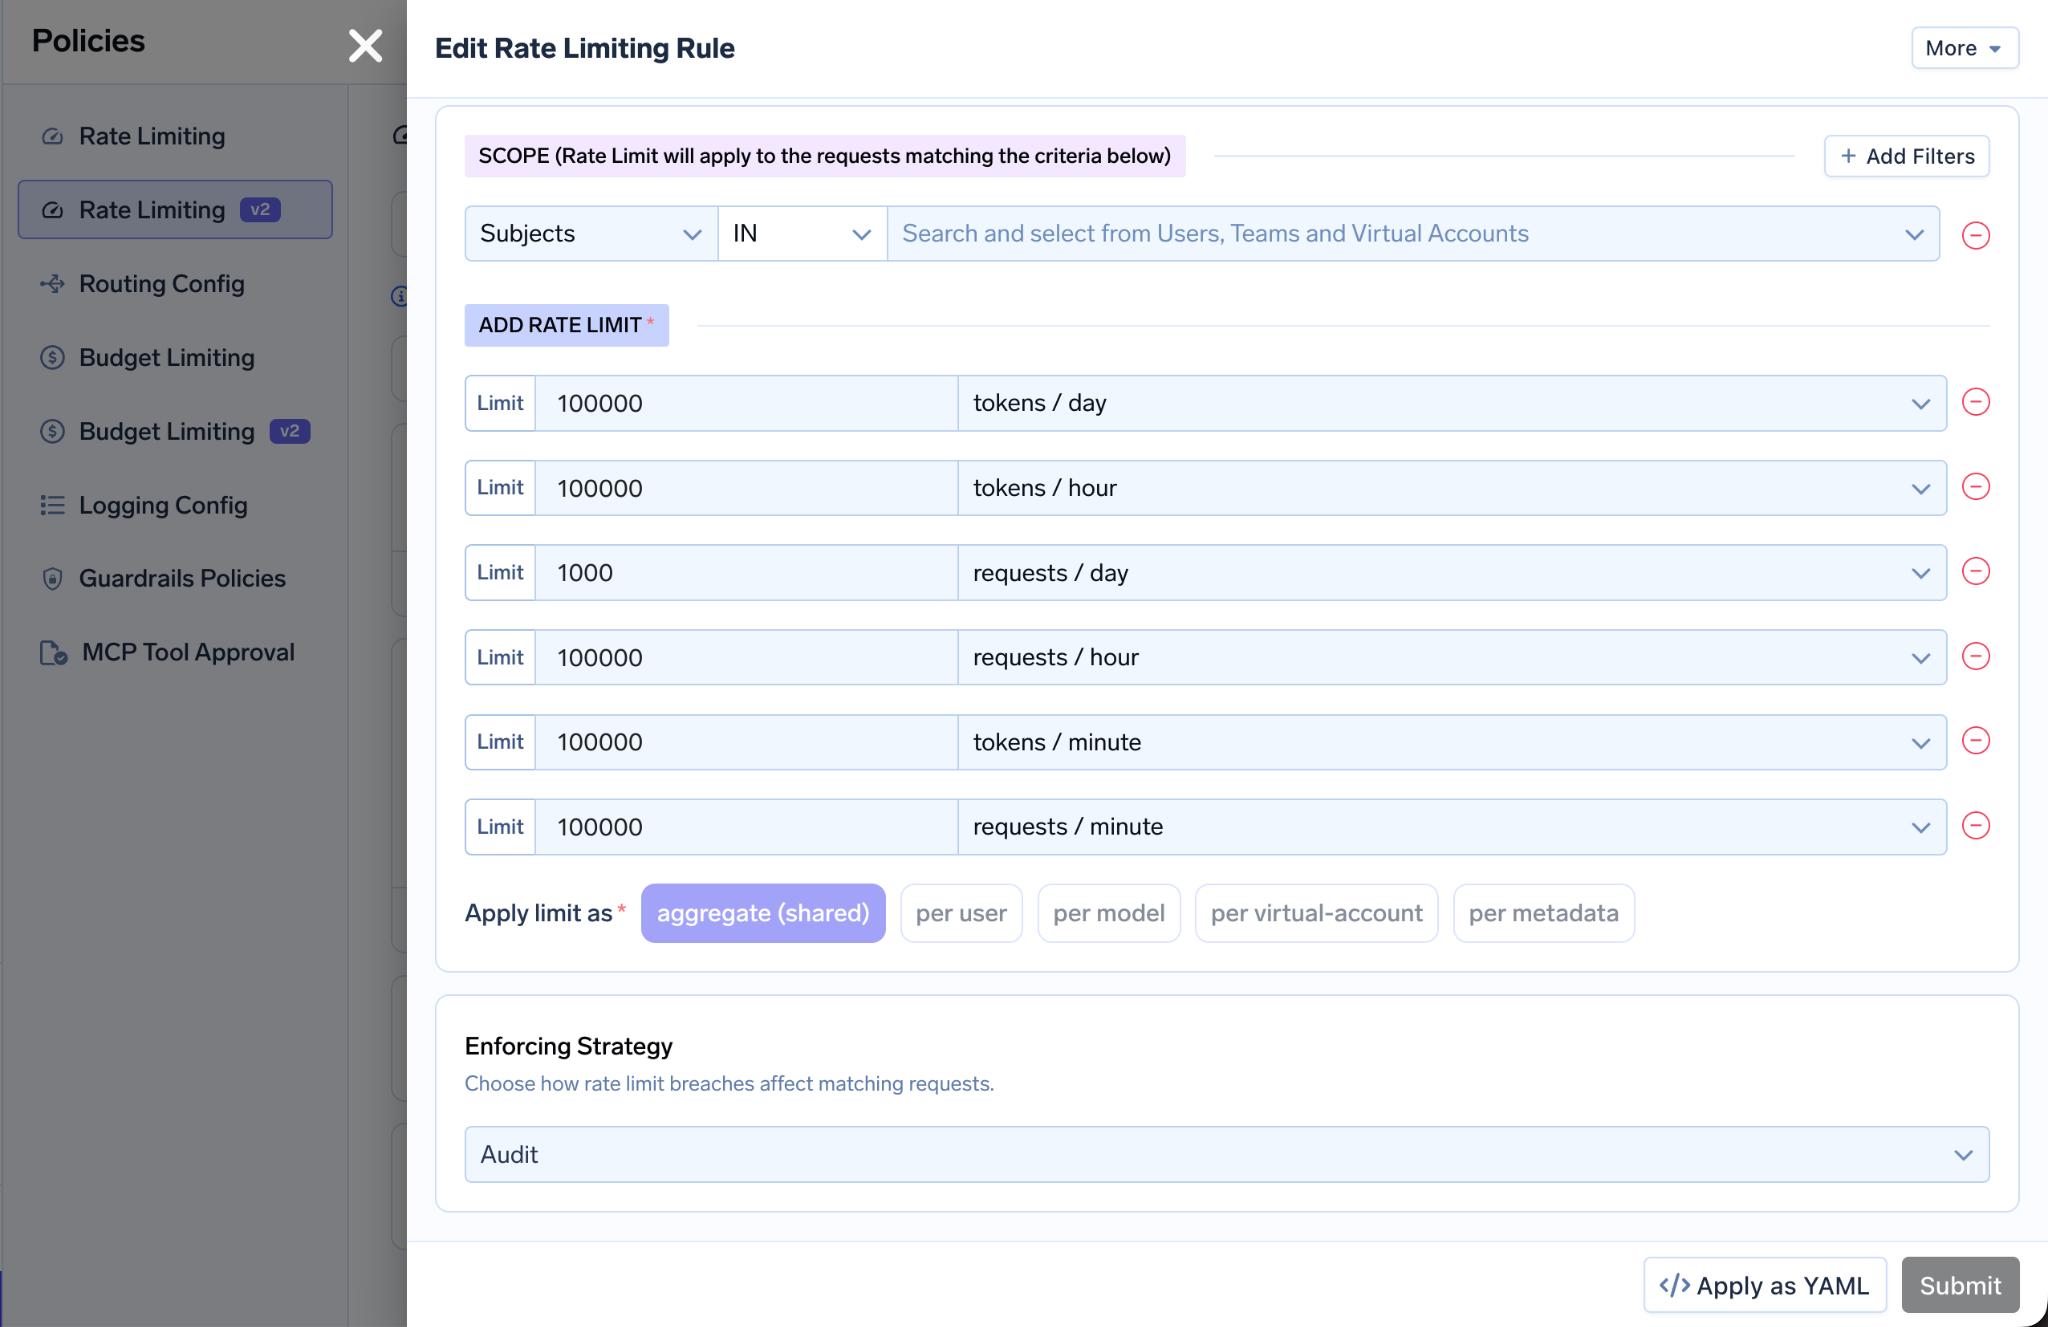
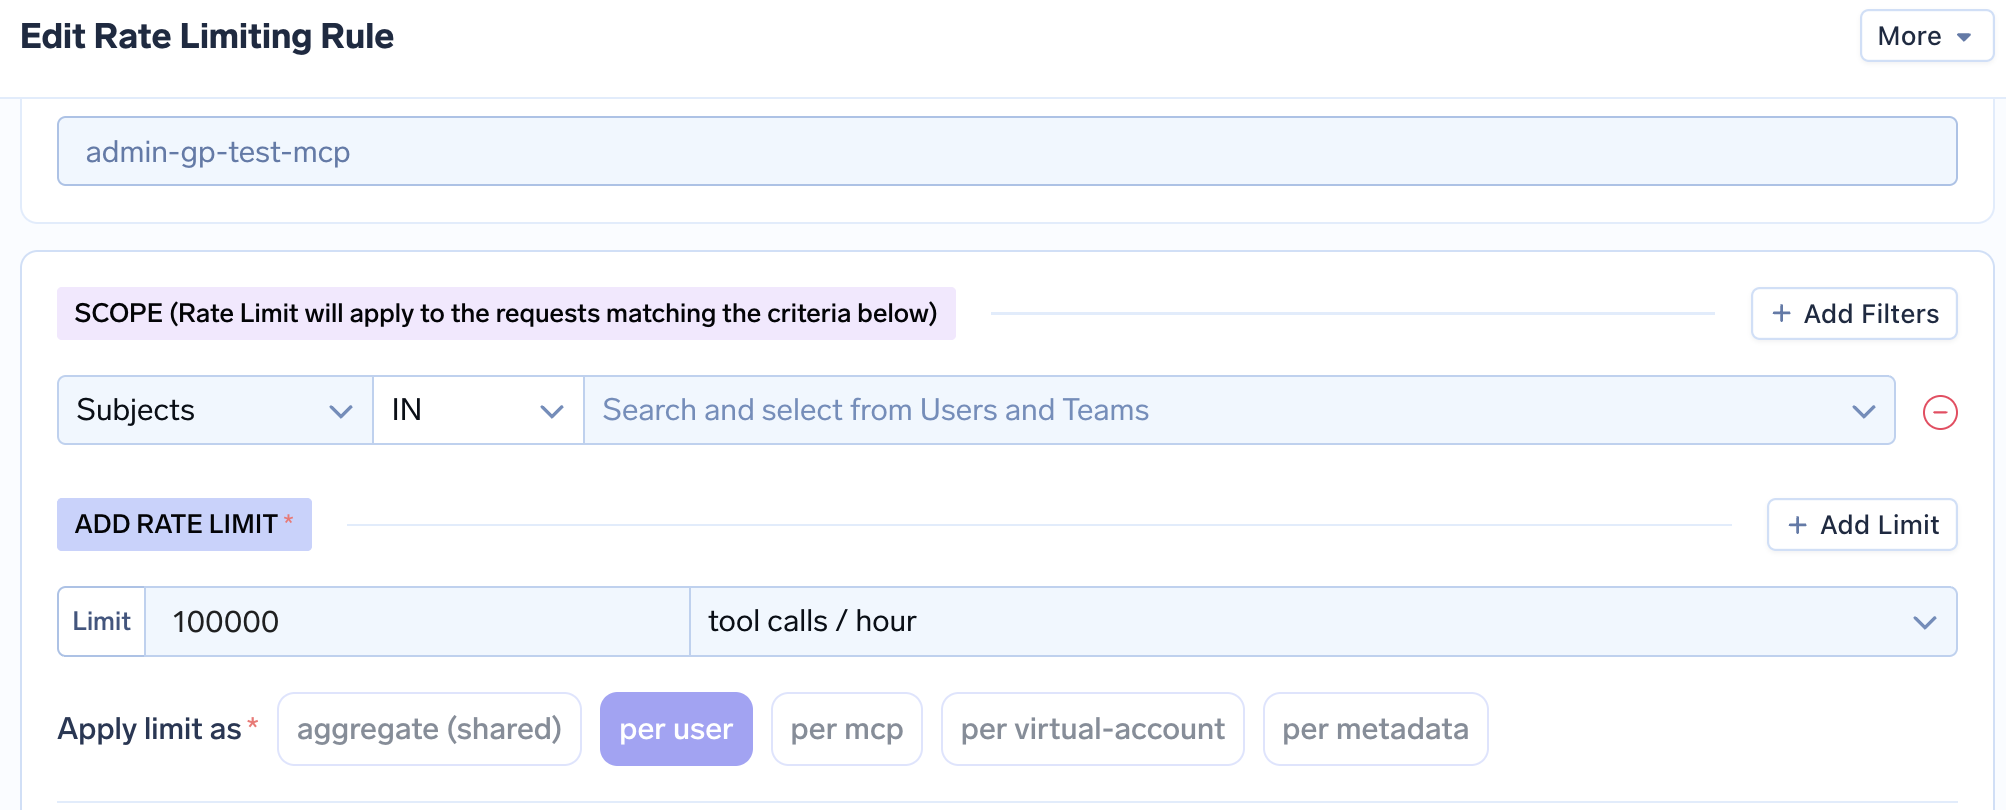
TrueFoundry past rate limits toe op basis van requests en tokens, per minuut, uur of dag, met regels die worden toegepast per gebruiker, team, virtueel account, model of request-metadata en 'first-matching-rule-wins'-semantiek (rate limiting). Limieten staan los van wat u ons hebt betaald en van het verkeer van andere teams, omdat de gateway de regels in het geheugen houdt en nooit een saldo raadpleegt om een request te verwerken. Concurrency-limieten zijn aan onze kant eveneens niet gedocumenteerd; dat is de enige rij waar beide producten moeten worden getest in plaats van alleen erover te lezen. Onze gids voor rate limiting in een LLM gateway behandelt hoe u de regels dimensioneert.
Een OpenRouter-budget bestaat op drie niveaus. Per key: een creditlimiet met een optionele dagelijkse, wekelijkse of maandelijkse reset om middernacht UTC en automatische uitschakeling wanneer de key deze overschrijdt. Per lid en per workspace: guardrails die budgetten handhaven en kunnen worden toegewezen aan keys of leden, waarbij het beleid op accountniveau dient als een plafond dat een workspace alleen kan versmallen. Workspace Budgets is een volwaardige functionaliteit met een eigen API, met intervallen die in elkaar grijpen (lifetime, maandelijks, wekelijks, dagelijks), limieten die strikt moeten afnemen naarmate het interval korter wordt, en een include_byok_in_budgets schakelaar die bepaalt of 'bring-your-own-key' inference meetelt.
Drie ontwerpkeuzes zijn hierbij van belang. Budgetten worden nooit samengevoegd: dezelfde dagelijkse budget-guardrail toegepast op drie leden geeft elk van hen dat budget afzonderlijk, en een request telt mee voor zowel het budget van de key als dat van het bezittende lid. Per model en per applicatie hebben geen direct mechanisme; een app-budget werkt alleen wanneer de app de key is. En budgetten zijn hard-stop, niet waarschuwend: een modus voor alleen waarschuwen is niet gedocumenteerd, en een request boven de limiet retourneert HTTP 403, wat de manier is waarop een team meestal ontdekt dat zijn budget op is.
TrueFoundry Budget Limiting V2 definieert regels op tenant- of teamniveau, gefilterd op gebruikers, teams, virtuele accounts, modellen (concreet of virtueel), provider-accounts en request-metadata via de X-TFY-METADATA header, zodat een budget per app slechts een virtueel account of een metadata-tag van u verwijderd is (budget limiting v2). Regels draaien in enforce-modus (request geblokkeerd) of waarschuwingsmodus; meerdere regels worden gecombineerd met AND-logica; limieten gelden geaggregeerd of per gebruiker, per virtueel account, per model of per metadata-waarde; en periodes zijn dagelijks, wekelijks, maandelijks, kwartaalbaar of lifetime, stapelbaar binnen één regel ($0,50 per dag en $2 per kwartaal, elke overschrijding geblokkeerd). Mijlpaalmeldingen worden verzonden bij 75, 90, 95 en 100 procent naar e-mail, Slack-webhook of Slack-bot. Eén valkuil die we duidelijk vermelden: tracking begint wanneer de regel wordt aangemaakt, niet aan het begin van de periode, dus eerdere uitgaven worden niet met terugwerkende kracht meegeteld.
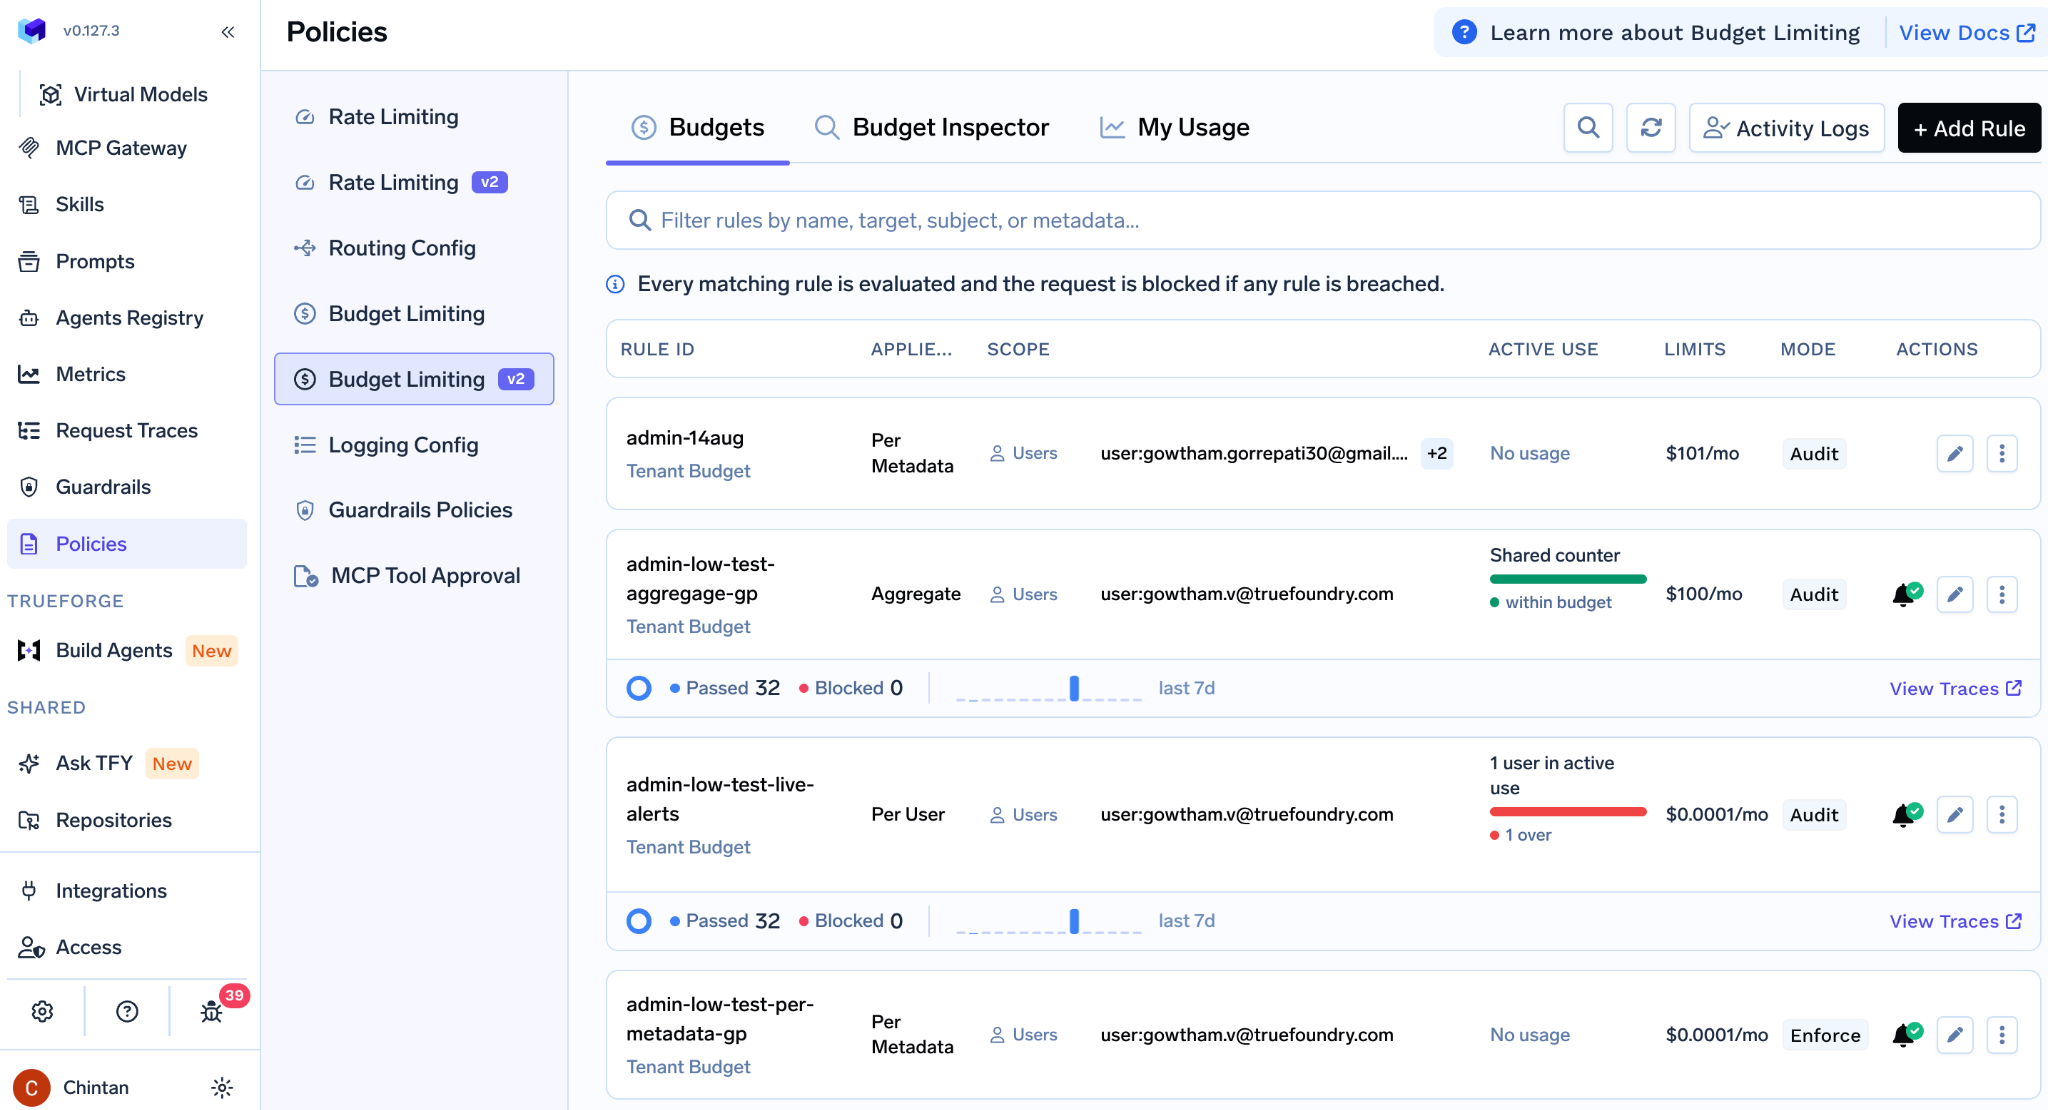
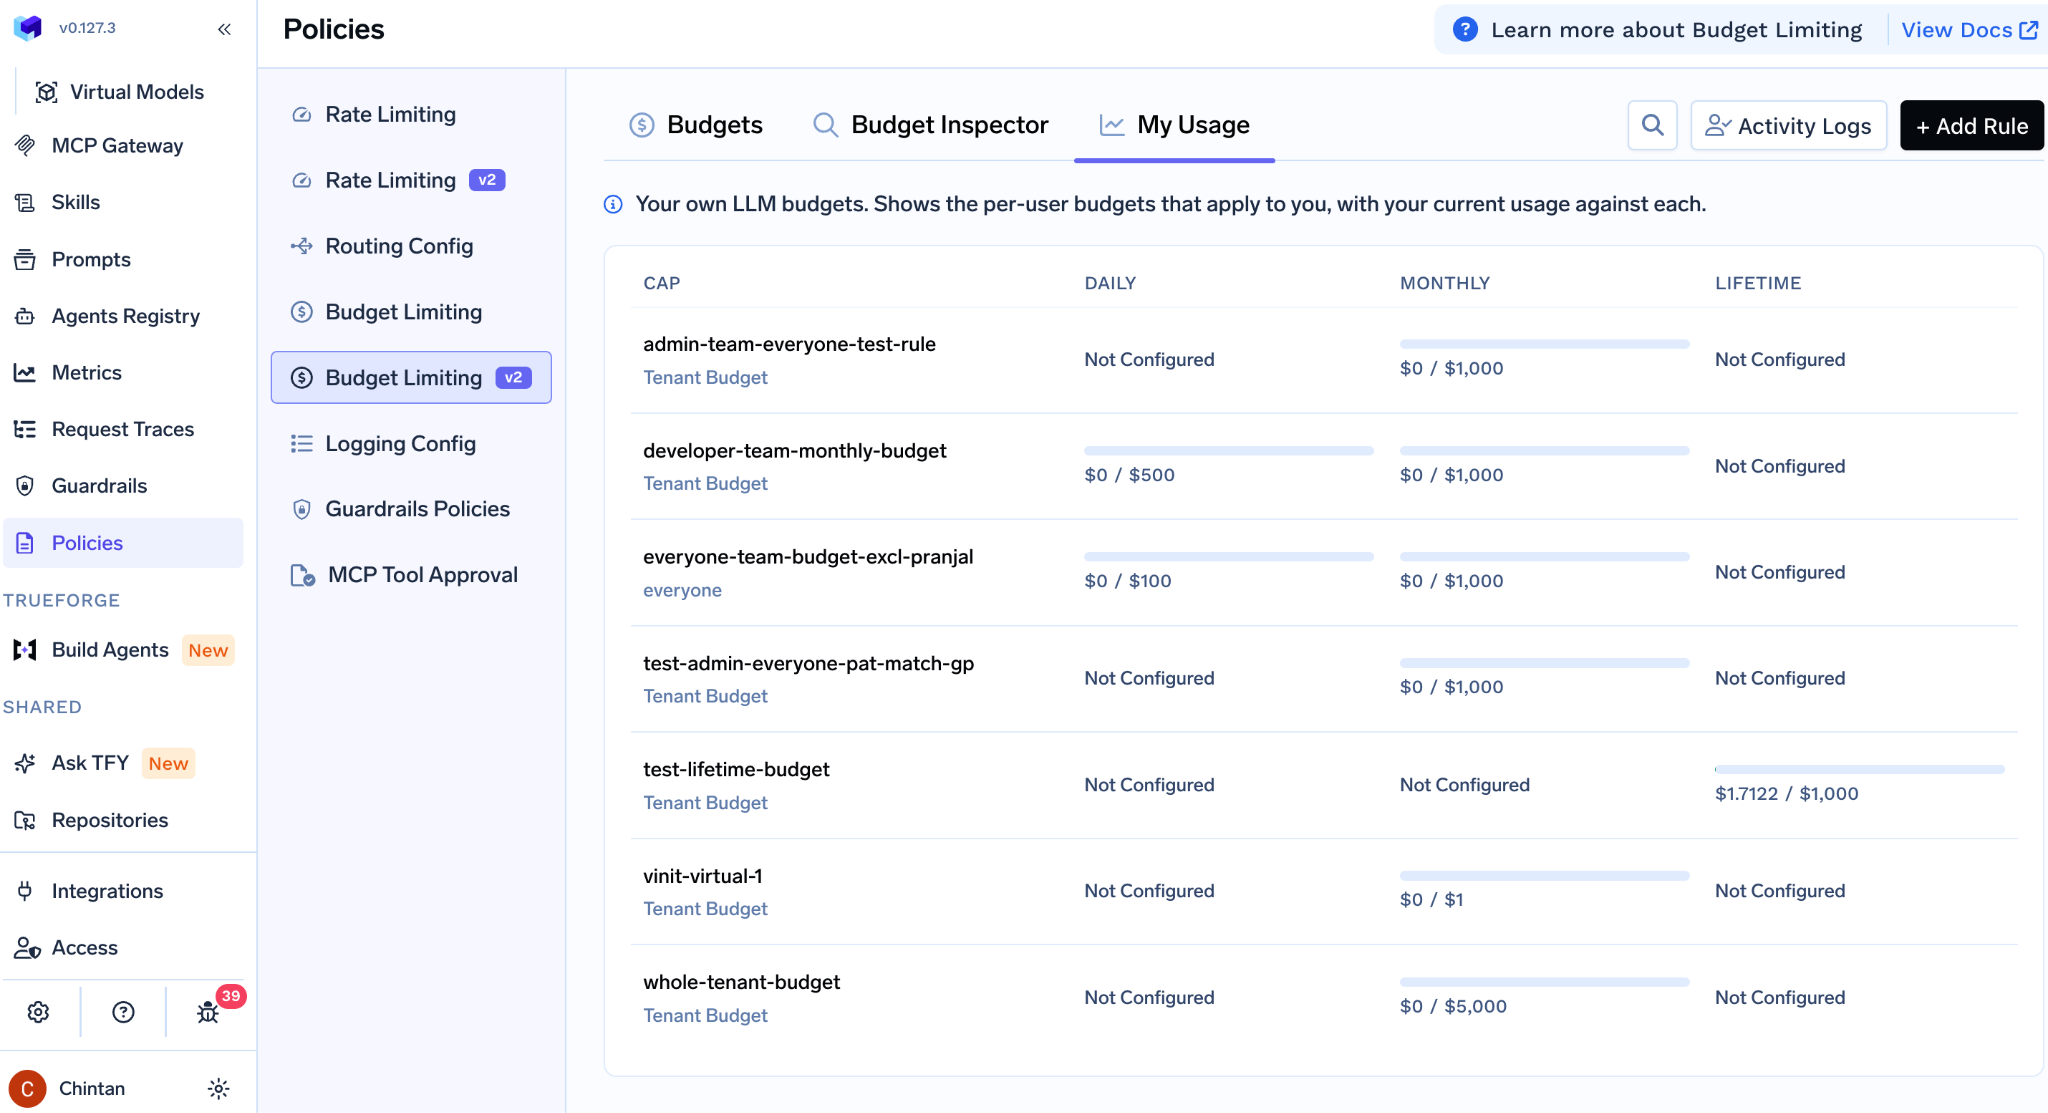
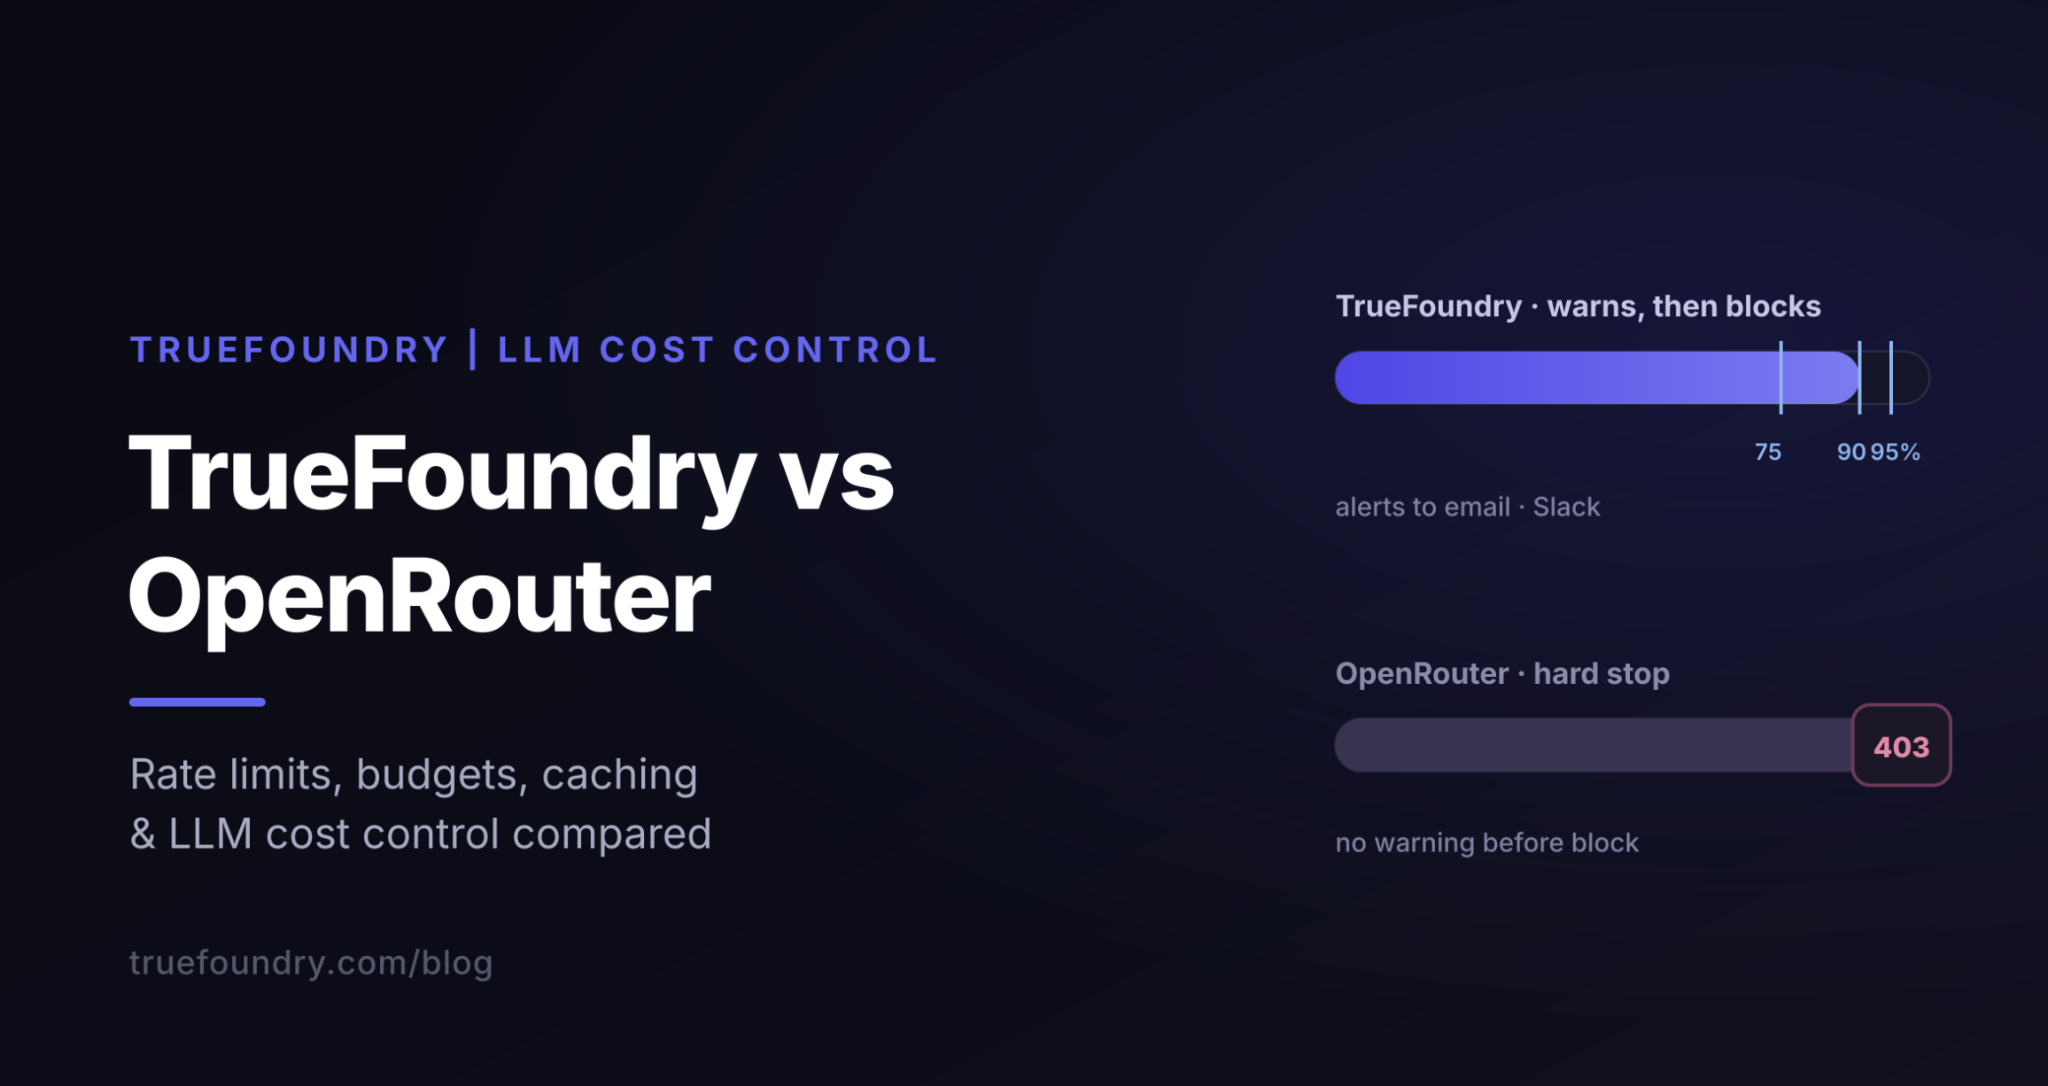
Het praktische verschil: bij TrueFoundry wordt een team gewaarschuwd bij 75 procent en kan het blijven werken voorbij 100 procent als de regel alleen waarschuwt; bij OpenRouter komt het team erachter wanneer requests HTTP 403 beginnen te retourneren.
Twee verschillende dingen worden hier caching genoemd, en het verwarren daarvan is de meest voorkomende fout die we zien bij kostenbeoordelingen.
Provider prompt caching houdt in dat de modelprovider minder in rekening brengt voor gecachte input-tokens. OpenRouter geeft dit door en stourt eromheen: een cache-read kost ongeveer 0,1x tot 0,5x van de normale inputprijs, afhankelijk van de provider, en session_id houdt een sessie sticky met de provider die de warme cache vasthoudt. TrueFoundry geeft provider prompt caching eveneens door, en onze documentatie beschrijft expliciet het combineren ervan met gateway-caching (caching). Geen van beide leveranciers heeft het uitgevonden; beide laten u het behouden.
Gateway response caching betekent dat de gateway het request zelf beantwoordt, zonder provider-call. OpenRouter Response Caching, momenteel in beta, is exact-match: twee requests zijn pas identiek wanneer ze dezelfde API key, model, endpoint-type, streaming-modus en volledige request-body delen. Het is opt-in per request via de X-OpenRouter-Cache: true header, model-agnostisch, ondersteunt chat completions, Responses, Messages en embeddings, maar geen legacy completions, TTS, STT, rerank of video, en retourneert bij een hit de response zonder facturering en zonder tokenverbruik. Twee eigenschappen verdienen verdienste: cache-hits tellen niet mee voor provider rate limits, en hits zijn zichtbaar in het Activity log. Eén eigenschap beperkt het: de OpenRouter-cache is beperkt tot één enkele API key, dus verschillende keys onder hetzelfde account delen deze niet, en een vloot aan services die elk hun eigen key vasthouden heeft niets aan elkaars verkeer. Semantische caching wordt niet aangeboden. In onze eigen tests maten we een hit-rate van 100 procent op identieke herhaalde requests, 58,5 ms bij een hit vergeleken met 2.866,8 ms bij een miss, en een time-to-live tussen twee en vijf minuten.
TrueFoundry biedt zowel exact-match als semantische caching aan bij de gateway, ondersteund door Redis. Een hit retourneert de volledige response met nul provider-aanroepen en nul providerkosten, over alle providers heen, en de cache wordt gedeeld over elke caller in plaats van afgeschermd per key, zodat het tweede team dat een vraag stelt profiteert van de eerste. Een LLM-strategie met semantische caching is van belang voor workloads waar exact-matching nooit een hit oplevert: klantenservice-assistenten, interne zoekopdrachten en elke prompt-template met een variabele variabele. We publiceren geen gemeten hit-rates, omdat deze volledig afhangen van uw verkeer; de juiste test is een week lang uw eigen prompts gebruiken.
Zonder ingestelde routing-instructies optimaliseert OpenRouter al voor de prijs in drie stappen: geef lagere prioriteit aan providers die in de afgelopen 30 seconden aanzienlijke storingen hebben gehad, kies uit de stabiele providers de goedkoopste kandidaten gewogen op de omgekeerde kwadratische waarde van de prijs, en houd de rest achter de hand als fallbacks. Expliciete instellingen kunnen hier bovenop worden gestapeld: provider.sort: "price" of de :floor model-slug snelkoppeling routeert 'goedkoopste-eerst', :nitro routeert voor doorvoer, provider.max_price stelt een hard plafond in dollars per miljoen tokens in dat combineert met een sortering, en provider.only, ignore en quantisatie-voorkeuren verkleinen de groep kandidaten. De prijstabel kan niet verouderen omdat OpenRouter de verkoper is: hun prijslijst is de prijs. Twee eerlijke beperkingen: dit is provider-arbitrage voor een gegeven model, geen modelsubstitutie, en op prijs gesorteerde routing levert kwaliteitsconsistentie in, aangezien goedkopere providers verschillende quantisaties van hetzelfde model kunnen serveren.
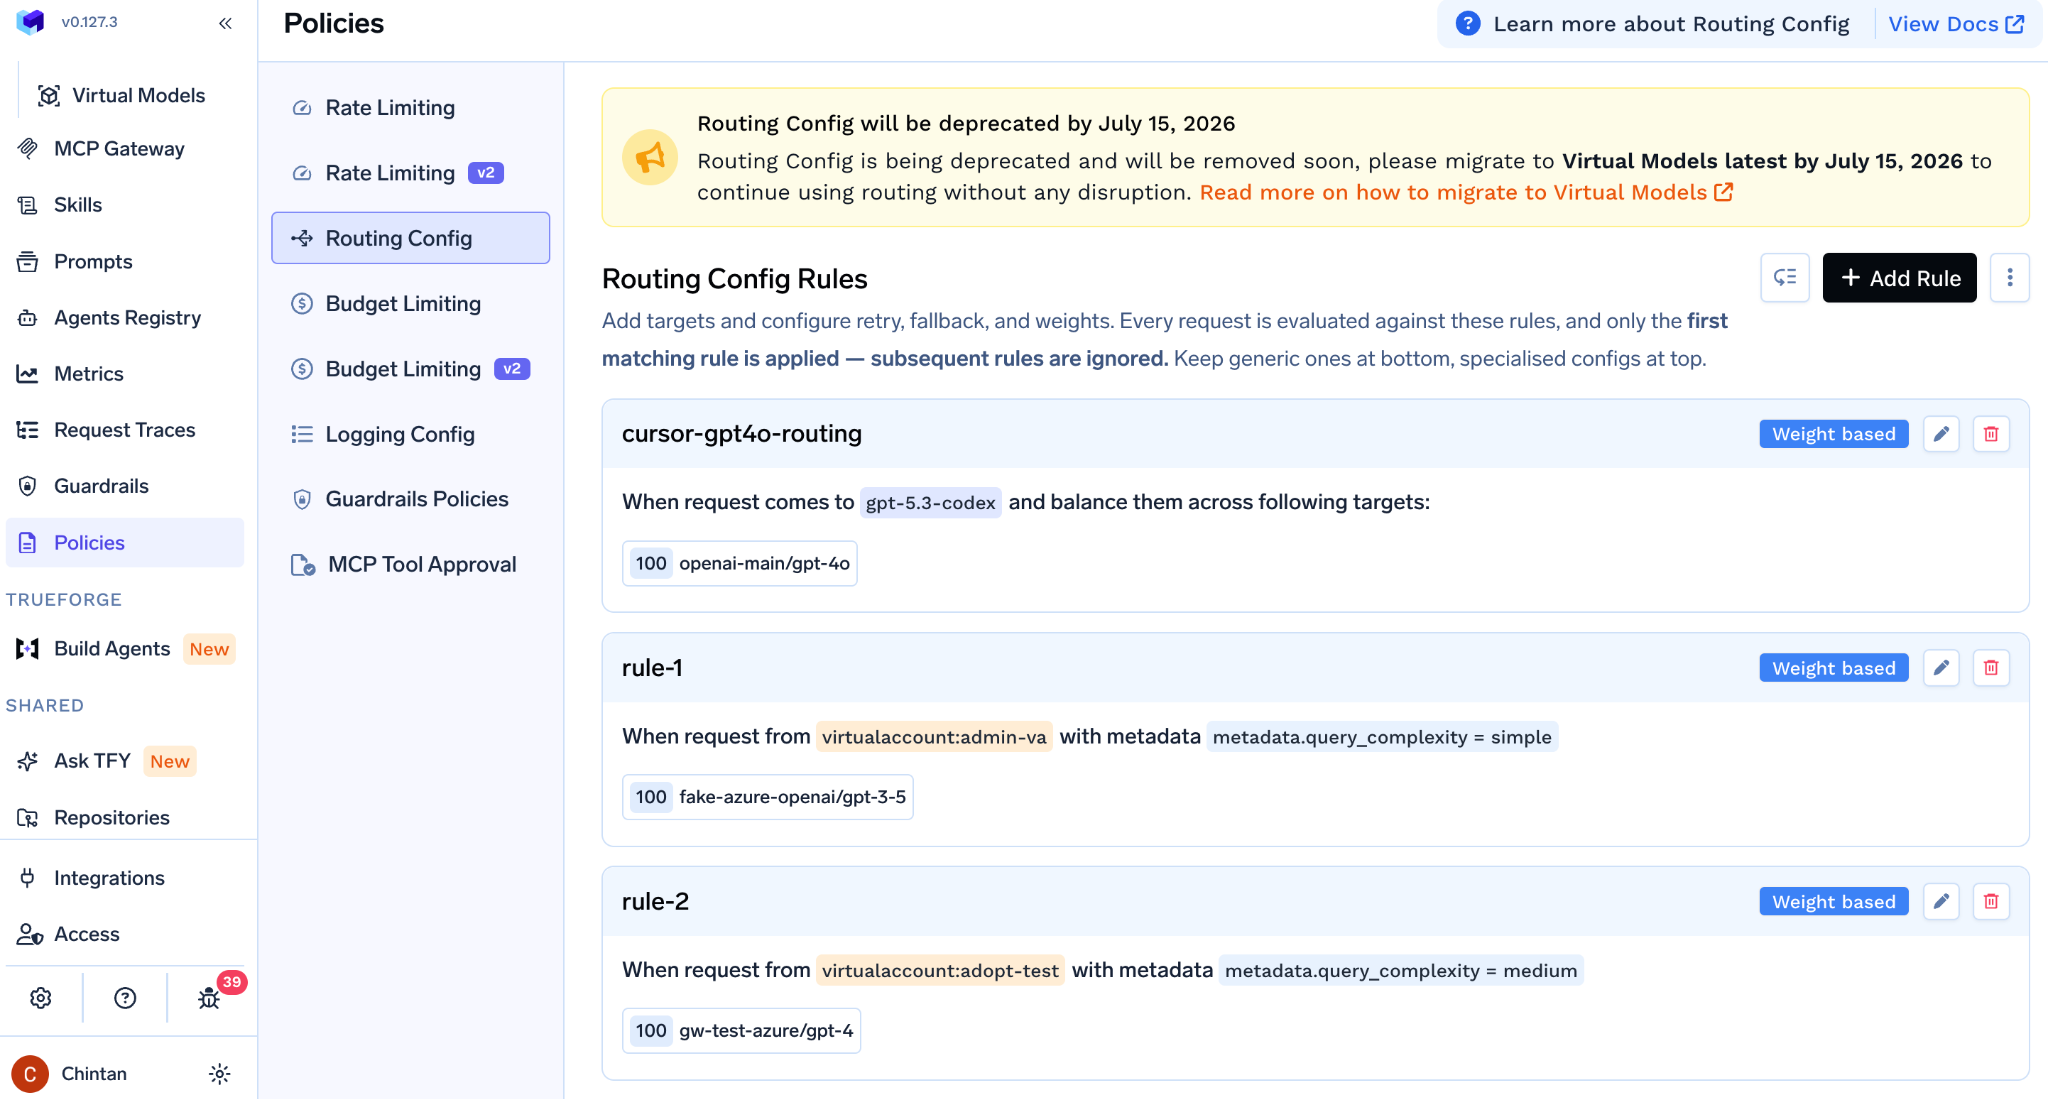
TrueFoundry doet niet aan provider-arbitrage op basis van een prijstabel. Wat wij wel doen is op complexiteit gebaseerde routing: de gateway categoriseert elk request als eenvoudig, gemiddeld of complex en routeert het naar het model dat u voor die tier hebt geconfigureerd, met sticky sessies, zodat u het goedkope model per tier kiest en de gateway de tier kiest (auto routing). Daarrond omheen zit weight-, latency- en priority-gebaseerde load balancing over targets, en een virtuele model-fallback-keten die elk target oversluit waarvan het budget is overschreden, wat werkt als een kosten-onderbreker (circuit breaker). Prijsgegevens zijn afkomstig uit een open-source catalogus plus privé-tarieven voor onderhandelde contracten en fine-tuned modellen (cost tracking). De eerlijke conclusie geldt dus in twee richtingen: goedkoopste acceptabele model, ja; goedkoopste provider voor dit model, nee. Hoe de twee benaderingen in een routing-ontwerp passen, wordt behandeld in onze uitleg over de LLM router.
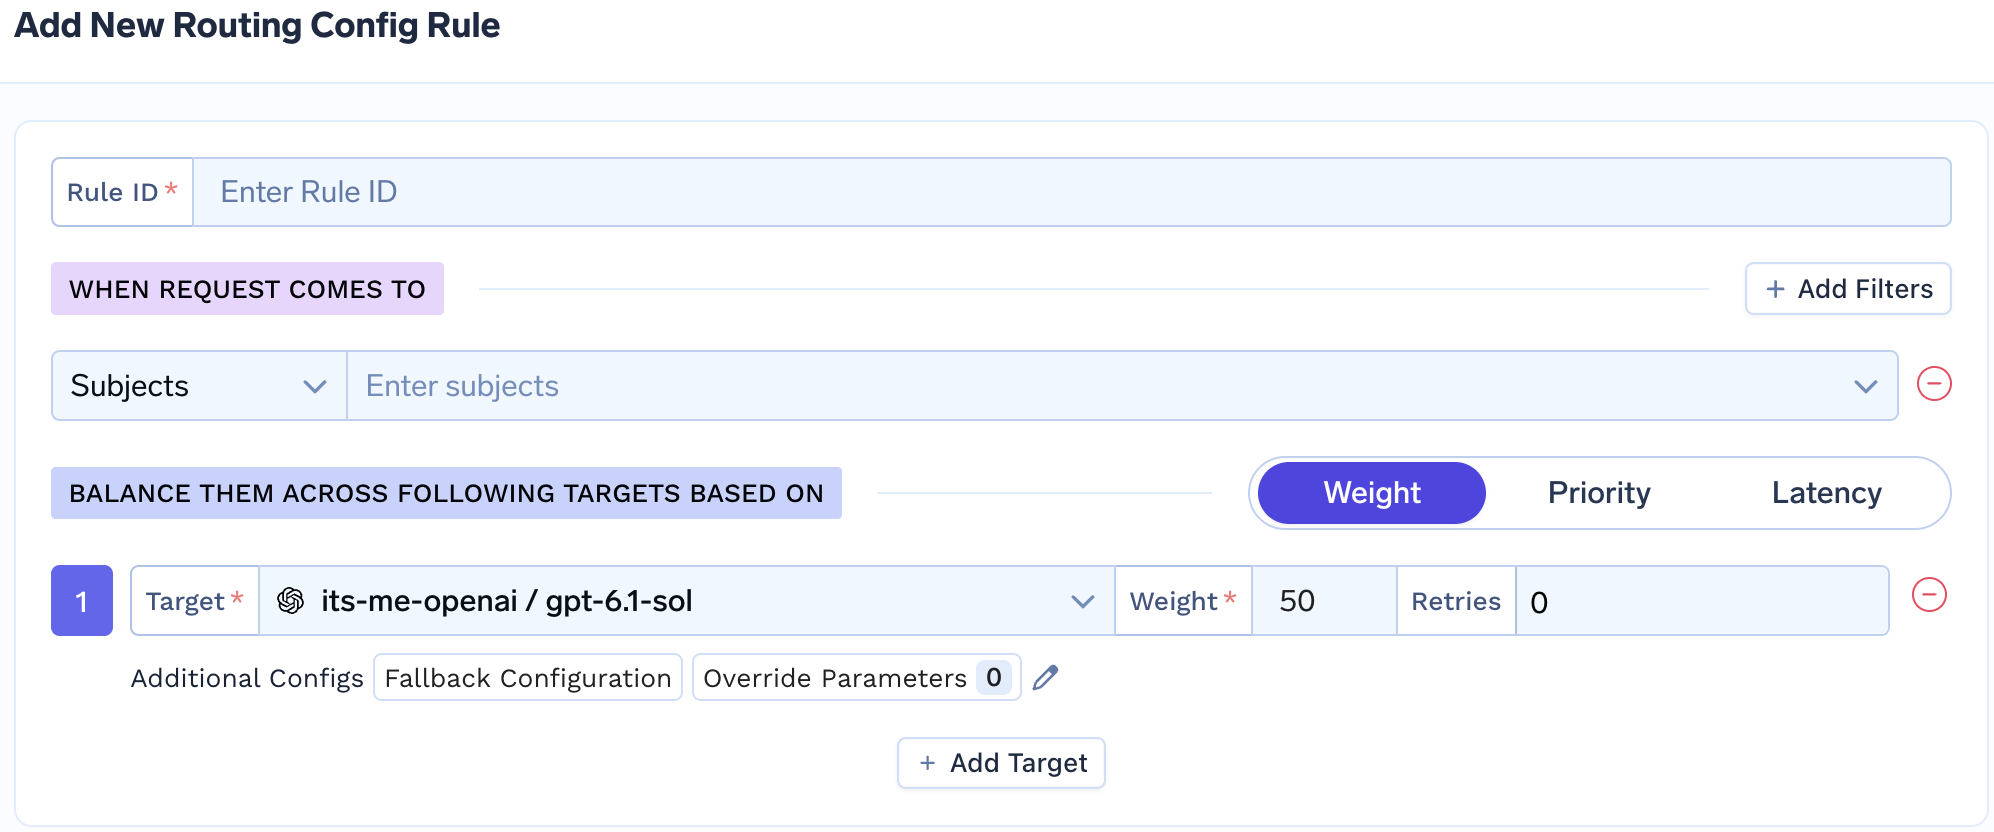
Het beheren van uitgaven begint met weten wie het heeft uitgegeven. TrueFoundry wijst kosten en tokens toe per gebruiker, team, virtueel account, model, provider-account en willekeurige metadata-keys; de X-TFY-METADATA header is de haak voor chargeback, dus een request dat is getagd met een kostenplaats- of applicatie-ID wordt daaronder gerapporteerd, dashboards splitsen uitgaven uit op al die dimensies, en de budget-API's tonen het verbruik en een ranglijst van de hoogste uitgevers (cost tracking, budgets API). Hetzelfde gateway-vlak dat deze regels in het geheugen handhaaft, houdt de overhead op ongeveer 3–4 ms en 350+ requests per seconde per vCPU over 1.000+ LLM's, dus toewijzing is niet iets waarvoor u betaalt in latency. Voor de finance-zijde hiervan, zie onze gids voor een LLM cost tracking solution.
OpenRouter wijst toe per key (met beschrijvende labels), workspace, model en provider; Activity en Logs bieden een weergave op accountniveau met optionele workspace-filtering, usage: {include: true} retourneert het verbruik per request in de response-body, Activity Export genereert CSV of PDF gegroepeerd op model, key of lid, en een User Tracking-functionaliteit plus Custom Classifiers voegen dimensies per gebruiker en per categorie toe. Facturering is één factuur voor alle workspaces. Toewijzing per applicatie of per kostenplaats is haalbaar, native via aangepaste gebruikers-ID's en classifiers of stroomafwaarts via Broadcast-metadata naar uw observability-platform.
Dat is de vorm van LLM-kostenoptimalisatie aan beide kanten. Als het doel is om LLM API-kosten voor één applicatie te verlagen, doet de routing van OpenRouter het zware werk automatisch. Als het doel is om ze voor een organisatie te verlagen, moet u weten welk team uitgeeft, hen waarschuwen voordat ze worden afgesloten, en de eenvoudige requests naar het goedkope model routen, wat de TrueFoundry-vorm is.
De functionaliteiten van TrueFoundry zijn afkomstig uit onze documentatie; de functionaliteiten van OpenRouter weerspiegelen de openbaar gedocumenteerde functionaliteit op het moment van schrijven.
Geen van beide leveranciers documenteert het voorspellen van uitgaven of anomaliedetectie; TrueFoundry vermeldt anomalie-waarschuwingen als "binnenkort beschikbaar" op de roadmap voor agent-governance en OpenRouter heeft een Notifications-functionaliteit waarvan de waarschuwingstypes niet zijn gedocumenteerd. Houd rekening met een budget voor een FinOps-tool aan beide kanten, en bekijk onze gids voor OpenRouter alternatives voor het bredere speelveld.
OpenRouter rate limits, budgetten en caching zijn gebouwd voor een ontwikkelaar die naar één key kijkt: limieten die het saldo volgen, budgetten die stoppen in plaats van waarschuwen, een cache die bij de key hoort, en in ruil daarvoor de beste automatische provider-arbitrage in de markt. De kostenbeheersingsfuncties van TrueFoundry zijn gebouwd voor een platformteam dat verantwoording aflegt aan finance: limieten op basis van requests en tokens, budgetten die waarschuwen voordat ze blokkeren en die zich richten op teams, modellen en applicaties, een semantische cache die wordt gedeeld over elke caller, en directe chargeback per kostenplaats. Geen van beide voorspelt of detecteert anomalieën, dus houd daar aan beide kanten rekening mee. De praktische scheidingslijn is of de persoon die het budgetrapport leest een ontwikkelaar is of een finance-partner.
Om te zien hoe budgetten, limieten en caching zijn geconfigureerd voor een uitrol over meerdere teams, kunt u de TrueFoundry AI Gateway verkennen, of book a demo als u nu de kostenbeheersing voor productie dimensioneert.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



OpenRouter limits by requests, not tokens, and the limits scale with your purchased credit balance. Free-model variants are capped at 20 requests per minute and 50 requests per day (1,000 per day once you have bought $10 of credits); paid headroom grows with your balance. Requests over the limit are rejected immediately with no queuing, and concurrency limits are not documented.
Nee. De Response Caching van OpenRouter is alleen exact-match, opt-in per verzoek, gebonden aan één API-sleutel en momenteel in beta; het geeft ook prompt caching van providers door. TrueFoundry biedt exact-match en semantisch cachen op gatewayniveau, gedeeld over alle aanroepers, met nul providerkosten bij een treffer.
Per team only insofar as a workspace is a team: budgets attach to keys, members and workspaces, and they never pool. There is no per-model or per-application budget, and no warn-only mode; a breached budget returns HTTP 403. TrueFoundry budgets scope by user, team, virtual account, model, provider account or metadata tag, in enforce or warn mode.
1,000+ LLMs through a single OpenAI-compatible API, with roughly 3–4 ms of added latency and 350+ requests per second on one vCPU. You switch models by changing the model name in the request, keeping the same URL and credentials.
Roughly 3–4 ms of overhead. Rate limits, budgets and attribution are checked in memory on a stateless gateway plane with no database call in the request path, so cost controls do not become the bottleneck at production throughput.
Yes. TrueFoundry runs as managed SaaS, in hybrid mode with the gateway plane in your VPC, or fully self-hosted including air-gapped environments, on one control plane, and the budgets, limits and caching described here work the same way in every mode.



Het laatste nieuws, artikelen en bronnen in je inbox



















