



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large Language Models (LLM's) veranderen de manier waarop bedrijven taken automatiseren, content genereren en met data werken. De meeste LLM-diensten zijn tegenwoordig echter cloudgericht, wat vragen oproept over databeveiliging, compliance en controle.
Voor organisaties die werken met gevoelige of gereguleerde informatie is het vertrouwen op externe API's of publieke cloudmodellen vaak geen optie. Dit heeft geleid tot een toenemende verschuiving naar on-premise LLM-implementaties, waarbij bedrijven modellen veilig laten draaien binnen hun eigen infrastructuur.
In dit artikel onderzoeken we wat on-premise LLM's zijn, waarom ze belangrijk zijn, hoe ze werken en hoe platforms zoals TrueFoundry schaalbare, veilige implementaties in enterprise-omgevingen mogelijk maken.
On-premise LLM's verwijzen naar large language models die worden geïmplementeerd en beheerd binnen de eigen infrastructuur van een organisatie, in plaats van via externe clouddiensten of API's van derden. Deze modellen kunnen open-source of gepatenteerd zijn en draaien doorgaans op eigen GPU-servers, private datacenters of geïsoleerde cloudomgevingen die zijn geconfigureerd om te voldoen aan interne veiligheids- en compliancenormen.
In tegenstelling tot in de cloud gehoste LLM's die afhankelijk zijn van publieke endpoints en door leveranciers beheerde infrastructuur, heeft de organisatie de volledige controle over on-premise LLM's. Dit maakt een grotere mate van maatwerk, fine-tuning en integratie met interne systemen en workflows mogelijk. Bedrijven kunnen kiezen welke modellen ze gebruiken, zoals LLaMA 2, Mistral of Mixtral, en deze optimaliseren op basis van specifieke zakelijke of domeinbehoeften.
On-premise implementatie stelt teams in staat om modelgedrag op maat te maken, dataresidentiebeleid af te dwingen en ervoor te zorgen dat gevoelige informatie het vertrouwde netwerk nooit verlaat. Het biedt ook kansen voor een nauwkeurigere afstemming van de prestaties en kostenbeheersing, vooral voor toepassingen met een hoog volume of toepassingen die gevoelig zijn voor latency. Voor organisaties die prioriteit geven aan autonomie, beveiliging en naleving van regelgeving bieden on-premise LLM's een praktisch en schaalbaar alternatief voor commerciële AI-API's.
On-premise LLM-implementatie geeft u volledige controle over de infrastructuur, data en het modelgedrag. Het vereist echter ook zorgvuldige planning, investeringen en doorlopend beheer. Hieronder staan de belangrijkste aspecten die u in overweging moet nemen:
U hebt hoogwaardige hardware nodig om grote taalmodellen efficiënt uit te voeren. Dit omvat krachtige GPU's zoals NVIDIA A100 of H100, voldoende RAM, een snelle netwerkverbinding en snelle SSD-opslag om grote modelgewichten en datasets te verwerken.
U behoudt het volledige eigendom van uw data, wat air-gapped setups, een strikt firewallbeleid en naleving van regelgeving voor dataresidentie zoals AVG (GDPR) en HIPAA mogelijk maakt. Dit maakt on-premise implementatie ideaal voor sectoren die gevoelige of gereguleerde informatie verwerken.
U moet ML-pipelines opzetten voor versieregeling, containerisatie, implementatie en monitoring. Het continu volgen van prestaties helpt om de nauwkeurigheid, betrouwbaarheid en operationele stabiliteit van het model op de lange termijn te garanderen.
Hoewel u terugkerende, op tokens gebaseerde API-kosten vermijdt, vereist on-premise LLM-implementatie aanzienlijke voorafgaande kapitaalinvesteringen in hardware. U moet ook rekening houden met doorlopende operationele kosten zoals stroom, koeling, onderhoud en geschoold personeel.
U krijgt volledige toegang tot de modelgewichten, wat geavanceerde fine-tuning met uw eigen data mogelijk maakt. Dit zorgt voor zeer specifieke prestaties die zijn afgestemd op de workflows van uw organisatie, in tegenstelling tot generieke, in de cloud gehoste modellen.
Uw schaalbaarheid hangt af van de beschikbare hardwarecapaciteit. In tegenstelling tot automatische schaalvergroting in de cloud moet u plannen voor piekbelastingen, load balancing implementeren en systemen optimaliseren om een lage latency en een hoge doorvoer te behouden.
Uw interne IT- of DevOps-team is verantwoordelijk voor beveiligingspatches, onderhoud van de infrastructuur en modelupdates. Regelmatig onderhoud zorgt voor systeembetrouwbaarheid, beveiliging en compatibiliteit met veranderende AI-vereisten.
Cloudgebaseerde AI-diensten hebben het voor teams eenvoudig gemaakt om op schaal te experimenteren, prototypes te bouwen en machine learning-modellen te implementeren. Wanneer het echter gaat om productieprocessen in enterprise-omgevingen, brengt het uitsluitend vertrouwen op cloudgerichte LLM's verschillende beperkingen met zich mee die niet kunnen worden genegeerd.
Dataprivacy en controle zijn de belangrijkste zorgen. Bij het gebruik van publieke cloud-API's moet gevoelige invoerdata via het internet worden verzonden en op externe infrastructuur worden verwerkt. Dit brengt risico's met zich mee rond datalekken, ongeautoriseerde toegang en schendingen van de compliance—vooral in sectoren zoals de gezondheidszorg, financiële dienstverlening, defensie en juridische diensten, waar strikte wettelijke normen gelden.
Vendor lock-in is een ander belangrijk nadeel. Cloud AI-platforms bundelen inference-API's, opslag en fine-tuning vaak in propriëtaire ecosystemen. Zodra een workflow rond een specifieke provider is gebouwd, wordt het migreren naar een andere dienst of het in-house halen van werklasten tijdrovend en kostbaar. Deze afhankelijkheid beperkt de flexibiliteit op de lange termijn en de controle over modelupdates of gebruiksvoorwaarden.
Onvoorspelbare kostenschalering wordt ook een uitdaging naarmate het gebruik groeit. LLM's zijn rekenintensief en prijsmodellen in de cloud die zijn gebaseerd op het aantal tokens of requestvolumes kunnen leiden tot snel stijgende operationele kosten—vooral voor applicaties met een hoge doorvoer of continue interactie.
Daarnaast bieden cloudomgevingen beperkte opties voor low-latency en edge-implementaties. Applicaties die vrijwel onmiddellijke reacties of offline functionaliteit vereisen, kunnen moeite hebben om prestatiedoelen te halen wanneer ze afhankelijk zijn van externe API's.
Tot slot abstraheren cloudproviders een groot deel van de infrastructuur, waardoor teams minimaal zicht hebben op knelpunten in de prestaties, optimalisatiekansen of tuning-parameters.
Voor bedrijven die controle, transparantie en duurzaamheid op de lange termijn eisen, vormen deze beperkingen een sterk argument voor het toepassen van on-premise LLM-oplossingen.
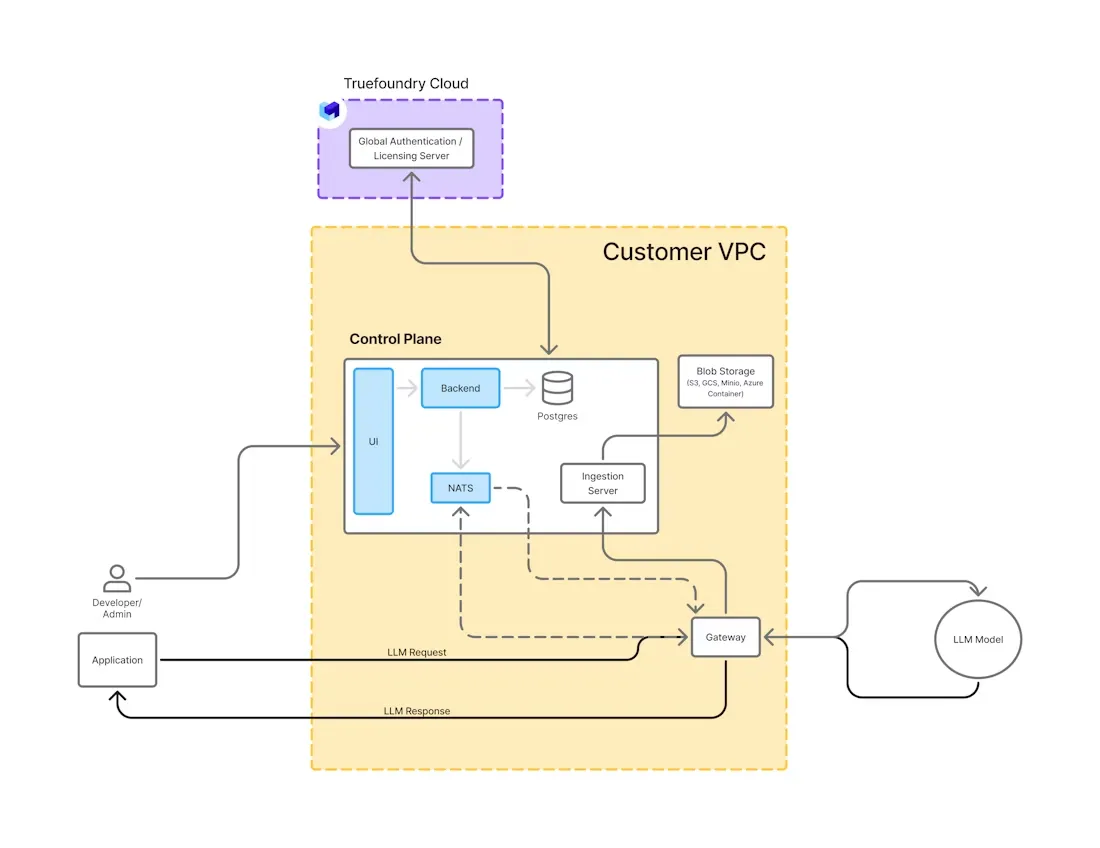
Het implementeren van LLM's on-premise vereist een zorgvuldig gestructureerde architectuur die prestaties, beveiliging en onderhoudbaarheid in evenwicht brengt. Hieronder staan de belangrijkste componenten die u doorgaans aantreft in een productie-omgeving.
Compute-infrastructuur: Krachtige GPU's vormen het fundament van on-premise LLM's. Bedrijven gebruiken vaak NVIDIA A100, H100 of L40 GPU's, afhankelijk van de modelgrootte en de vereiste doorvoer. Deze worden gehost in lokale datacenters of private cloud-clusters met geschikte koeling, netwerken en opslag.
Inference Engine: Inference-frameworks zoals vLLM, TGI of DeepSpeed-Inference verwerken de daadwerkelijke uitvoering van het model. Ze optimaliseren het geheugengebruik, ondersteunen token-streaming en maken het batchen van meerdere requests mogelijk om de doorvoer te maximaliseren.
Modelbeheer en opslag: Modellen worden lokaal opgeslagen in veilige artifact repositories of volume mounts. Versieregeling, rollbacks en toegangsbeheermechanismen zijn essentieel om modellevenscycli te beheren en wijzigingen te controleren.
Containerisatie en orchestratie: Tools zoals Docker en Kubernetes worden gebruikt om LLM-werklasten te implementeren, te schalen en te beheren. Kubernetes verzorgt automatische schaalvergroting, GPU-scheduling, load balancing en herstel bij fouten, wat zorgt voor consistente prestaties over alle diensten heen.
API-laag en routing: Een REST- of OpenAI-compatibele API-laag stelt de LLM-functionaliteit beschikbaar aan interne applicaties. Dit kan multi-model routing, gebruikersauthenticatie en promptfiltering omvatten voor veiligheid en controle.
Waarneembaarheid en monitoring: Metrieken zoals latency, GPU-gebruik, requestdoorvoer en het genereren van tokens worden gevolgd met behulp van tools zoals Prometheus, Grafana en OpenTelemetry. Logging en alerting zijn cruciaal voor het behoud van uptime en het oplossen van problemen.
Dankzij deze modulaire architectuur kunnen bedrijven schaalbare en veilige LLM-systemen bouwen die zijn afgestemd op hun interne beleid, prestatiedoelen en compliance-vereisten.
On-premise LLM's worden steeds vaker toegepast in sectoren die datasouvereiniteit, lage latency en volledige controle over AI-pipelines eisen. Hier zijn enkele veelvoorkomende en impactvolle use cases.
Ziekenhuizen en onderzoekslaboratoria gebruiken LLM's om aantekeningen over patiënten samen te vatten, ontslagrapporten te genereren en te helpen bij klinische documentatie. On-premise implementaties zorgen ervoor dat gezondheidsinformatie van patiënten binnen de veilige infrastructuur van het ziekenhuis blijft, wat HIPAA-compliance en institutioneel databeleid ondersteunt.
Financiële instellingen gebruiken LLM's voor taken zoals het samenvatten van winstuitkeringen, het automatiseren van compliancerapporten en het analyseren van financiële overzichten. On-premise setups voorkomen dat gevoelige financiële data wordt blootgesteld aan API's van derden, terwijl ze blijven voldoen aan interne risicokaders en regelgevende audits.
Instanties gebruiken LLM's voor het beantwoorden van vragen, het samenvatten van geclassificeerde rapporten en het ophalen van interne kennis. Omdat nationale veiligheidsdata strikt afgeschermd moet blijven, maken on-premise LLM's generatieve AI-toepassingen mogelijk zonder de dataclassificatieprotocollen te schenden.
Advocatenkantoren en juridische afdelingen gebruiken LLM's om contracten te analyseren, samenvattingen te maken en te helpen bij juridisch onderzoek. On-premise implementatie garandeert dat informatie die valt onder het beroepsgeheim van de advocaat de interne servers nooit verlaat, waardoor de vertrouwelijkheid behouden blijft en wordt voldaan aan de vereisten van de Orde van Advocaten.
Bedrijven in de productiesector gebruiken LLM's om handleidingen voor probleemoplossing te genereren, sensorlogs te interpreteren en veldtechnici te ondersteunen. Het implementeren van LLM's op lokale servers helpt te voorkomen dat gepatenteerde machinedata naar externe diensten wordt gestuurd en vermindert de latency voor afgelegen of offline omgevingen.
Telecombedrijven gebruiken LLM's om chatbots aan te sturen, tickets te triëren en geautomatiseerde serviceaanbevelingen te doen. On-premise implementatie maakt realtime prestaties mogelijk, terwijl klantgegevens binnen de interne infrastructuur blijven om te voldoen aan regionale privacywetten.
Deze use cases laten zien hoe on-premise LLM's krachtige automatisering en intelligentie bieden zonder dat dit ten koste gaat van de beveiliging, compliance of controle.
Het implementeren van LLM's on-premise omvat een reeks gecentraliseerde en gecoördineerde stappen, van modelselectie tot productiemonitoring. Een goed gedefinieerde workflow zorgt ervoor dat het systeem schaalbaar, veilig en geoptimaliseerd is voor de behoeften van uw organisatie.
Het proces begint met het kiezen van een geschikt model op basis van uw use case. Populaire open-source modellen zoals LLaMA 2, Mistral of Mixtral hebben vaak de voorkeur voor on-premise implementaties. Eenmaal geselecteerd wordt het model gedownload, indien nodig gekwantiseerd en gevalideerd op compatibiliteit met uw infrastructuur.
Vervolgens worden GPU-servers of private cloud-bronnen voorbereid. Dit omvat het opzetten van container runtimes (bijv. Docker), orchestrators (bijv. Kubernetes) en opslaglagen om modelgewichten en logs te hosten. Toegangscontroles en beveiligingsbeleid worden geconfigureerd om aan de compliance-vereisten te voldoen.
Het model wordt geladen in een inference engine zoals vLLM of TGI. Deze engines bieden de runtime-omgeving voor realtime tekstgeneratie, batching, streaming en geheugenoptimalisatie. Configuratiebestanden bepalen de batchgrootte, de maximale tokens en de limieten voor gelijktijdigheid (concurrency).
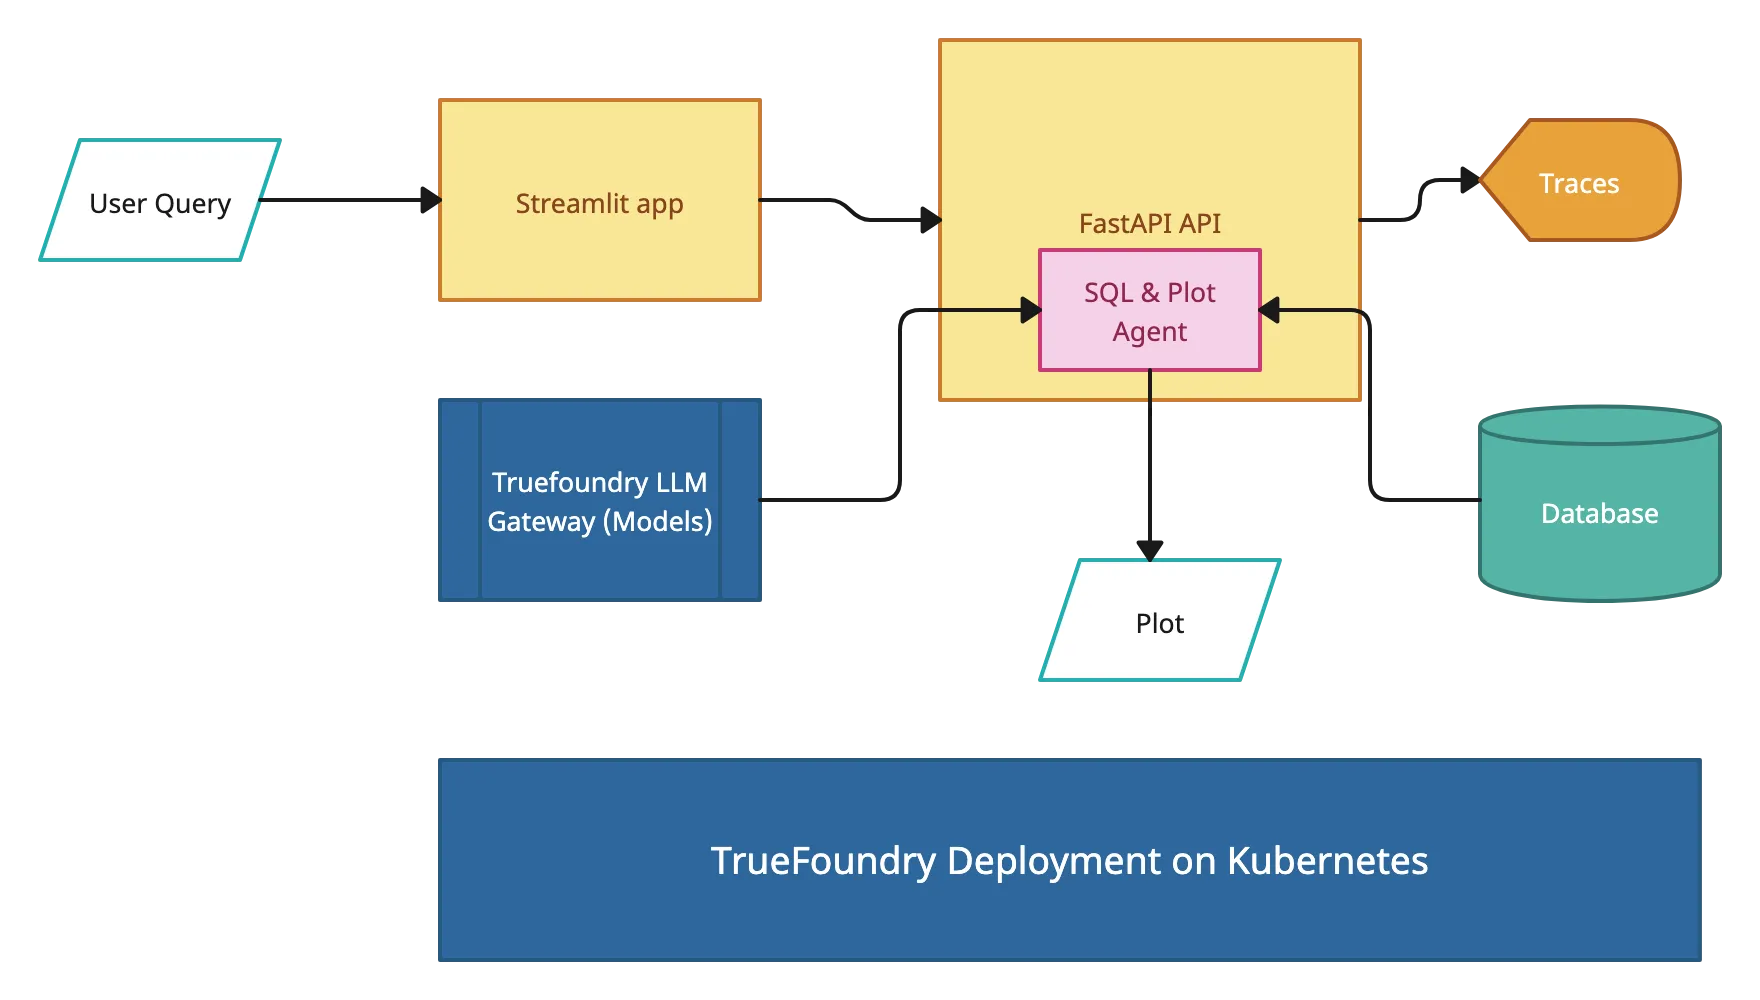
Zodra de engine operationeel is, wordt deze ontsloten via een REST- of OpenAI-compatibele API. Hiermee kunnen interne apps, tools of gebruikersinterfaces het model aanroepen. Multi-model routing, authenticatie en rate-limiting kunnen op deze laag worden toegevoegd voor een betere controle.
Er worden observability-tools gekoppeld om het GPU-gebruik, de latency, de tokendoorvoer en request-fouten bij te houden. Op basis van verkeerspatronen worden regels voor automatische schaalvergroting of handmatige schaalprocedures geconfigureerd om aan de vraag te voldoen zonder downtime.
Het volgen van deze workflow helpt organisaties om LLM's efficiënt binnen hun infrastructuur te lanceren en te beheren, zonder afhankelijk te zijn van externe platforms of gevoelige data bloot te stellen.
Deze tools en technieken helpen u bij het implementeren van on-prem LLM's met sterke prestaties, beveiliging en volledige datacontrole, met behoud van betrouwbaarheid op enterprise-niveau.
Het implementeren van LLM's on-premise geeft organisaties de volledige controle over hun AI-infrastructuur, maar brengt ook compromissen met zich mee. Het begrijpen van zowel de voordelen als de uitdagingen is essentieel voor een succesvolle uitrol.
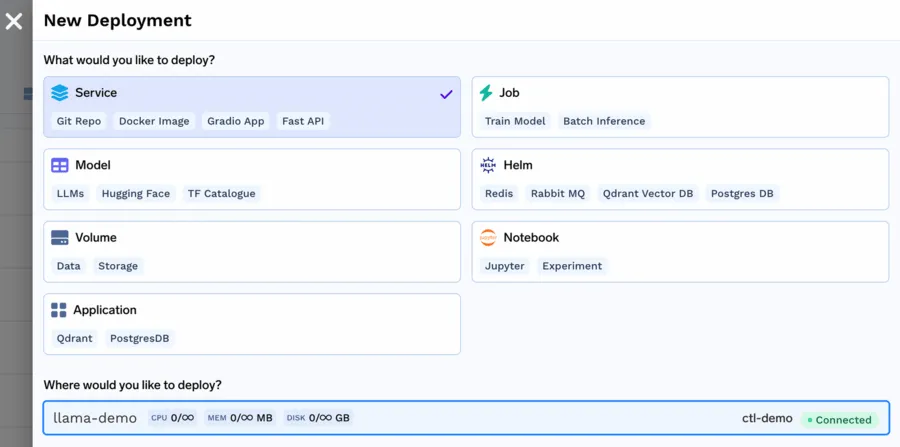
TrueFoundry vereenvoudigt de implementatie en het beheer van large language models binnen een private infrastructuur, waardoor on-premise GenAI toegankelijk wordt voor bedrijven zonder dat diepgaande DevOps- of MLOps-expertise vereist is. Gebouwd op Kubernetes maakt TrueFoundry een snelle, veilige en schaalbare LLM-bediening mogelijk via vooraf geïntegreerde ondersteuning voor hoogwaardige inference engines zoals vLLM en TGI.
Het platform abstraheert de complexiteit van het beheren van containers, GPU's en schaalregels, waardoor teams zich kunnen richten op het bouwen van applicaties in plaats van het onderhouden van infrastructuur. Met TrueFoundry’s AI Gateway kunnen organisaties LLM's ontsluiten via OpenAI-compatibele API's, terwijl ze rate-limiting, facturering op basis van tokens en multi-model routing toepassen, allemaal binnen hun eigen veilige omgeving.
TrueFoundry biedt ook ingebouwde waarneembaarheid, waaronder realtime monitoring van tokengebruik, latency en modelprestaties. Dit helpt teams de doorvoer te optimaliseren, problemen op te lossen en de governance te handhaven.
Of het nu gaat om het implementeren van LLaMA 2, Mistral of gefine-tunede interne modellen, TrueFoundry biedt bedrijven een kant-en-klare oplossing voor on-premise GenAI die volledig aanpasbaar, compliant en gebouwd is om te schalen.
Nu bedrijven op steeds grotere schaal large language models omarmen, biedt een on-premise implementatie een veilige en flexibele manier om de kracht van GenAI te benutten zonder dat dit ten koste gaat van dataprivacy, compliance of de controle over de infrastructuur. Hoewel cloudgebaseerde oplossingen gemak bieden, schieten ze vaak tekort in gereguleerde of gevoelige omgevingen. On-premise LLM's geven organisaties het volledige eigendom over de gehele stack, meer maatwerk en voorspelbare kosten, waardoor ze ideaal zijn voor AI-strategieën op de lange termijn. Met platforms zoals TrueFoundry wordt het intern implementeren en schalen van LLM's sneller, efficiënter en eenvoudiger te beheren. Voor organisaties die gericht zijn op controle, transparantie en innovatie is on-premise GenAI niet zomaar een alternatief, het is een strategisch voordeel.
U implementeert LLM's on-prem door modellen te containeriseren met Docker, ze te orchestreren via Kubernetes en ze ter beschikking te stellen via geoptimaliseerde inference engines zoals vLLM of TGI. U configureert GPU's, netwerken en opslag, integreert monitoring-tools en implementeert MLOps-pipelines om versieregeling, schaalvergroting, beveiliging en prestaties binnen uw private infrastructuur te beheren.
Implementatie in de cloud biedt schaalbaarheid op verzoek, beheerde infrastructuur en een 'pay-as-you-go'-prijsmodel, terwijl on-premise implementatie volledige datacontrole, maatwerk en compliance biedt. U ruilt de flexibiliteit van de cloud in voor meer beveiliging en souvereiniteit op locatie, maar u moet hardwarekosten, onderhoud, schaallimieten en operationele complexiteit intern afhandelen.
U kunt gebruikmaken van publieke cloud LLM-diensten, private cloudomgevingen, hybride implementaties of beheerde AI-platforms. Op API's gebaseerde modellen zoals OpenAI of gehoste Hugging Face endpoints verminderen de overhead voor infrastructuur. Met hybride opstellingen kunt u gevoelige data on-premise houden, terwijl u profiteert van de schaalbaarheid van de cloud voor piekbelastingen en experimenten.
On-premise LLM's vereisen hoge initiële hardwarekosten, doorlopend onderhoud, geschoold personeel en capaciteitsplanning. U krijgt te maken met schaalbeperkingen, kosten voor stroom en koeling en tragere upgrades. Het beheren van beveiligingspatches, modelupdates en de betrouwbaarheid van de infrastructuur voegt operationele complexiteit toe in vergelijking met volledig beheerde, cloudgebaseerde AI-diensten.
TrueFoundry vereenvoudigt on-prem LLM deployment door Kubernetes-orchestratie, GPU scheduling, model serving, monitoring en beveiligingscontroles te integreren. U krijgt gecentraliseerd beheer, RBAC, observabiliteit en naadloze schaalbaarheid over verschillende omgevingen. De vooraf geïntegreerde inference engines en compliance-ready functies helpen u om AI van productieniveau veilig en efficiënt te deployen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















