



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Gateways worden het operationele controlecentrum van GenAI-systemen. Ze centraliseren verkeer voor externe API's (OpenAI, Anthropic, Mistral, Bedrock) en zelf-gehoste modellen, handhaven beleid en bieden één centraal overzicht voor latency, fouten, tokenverbruik en uitgaven. Datzelfde centrale punt is de ideale plek om traces vast te leggen, analyses op model- en gebruikersniveau te berekenen en guardrails en waarschuwingen te activeren — zonder latency toe te voegen aan het verzoektraject.
Organisaties hebben dit in de praktijk door schade en schande geleerd. Denk aan een support copilot die duizenden agents bedient. Op een middag verhoogt een onschuldige prompt-update de outputlengte met ~40%. De tevredenheid van agents daalt doordat antwoorden vertraging oplopen; de financiële afdeling merkt de stijgende rekening op. Met gateway-observabiliteit zou u de p95-latency en het aantal output-tokens zien stijgen voor de betreffende route, dit correleren met de deployment- of prompt-versie en een rollback uitvoeren — idealiter met een geautomatiseerde waarschuwing die is ingesteld om het de volgende keer direct op te vangen.
In dit artikel vatten we samen wat een AI Gateway is, waarom observabiliteit essentieel is, en welke concrete metrieken, dashboards en workflows teams moeten opzetten. We laten ook zien hoe de AI Gateway van TrueFoundry de observabiliteitsstack kant-en-klaar meelevert: gecentraliseerde analytics (latency, TTFT/ITL, fouten), gedetailleerde kostenbewaking, uitsplitsingen op klant-/gebruikersniveau, inzicht in gezonde en mislukte routing, en een schaalbare, low-overhead verzameling die in de architectuur is ingebouwd.
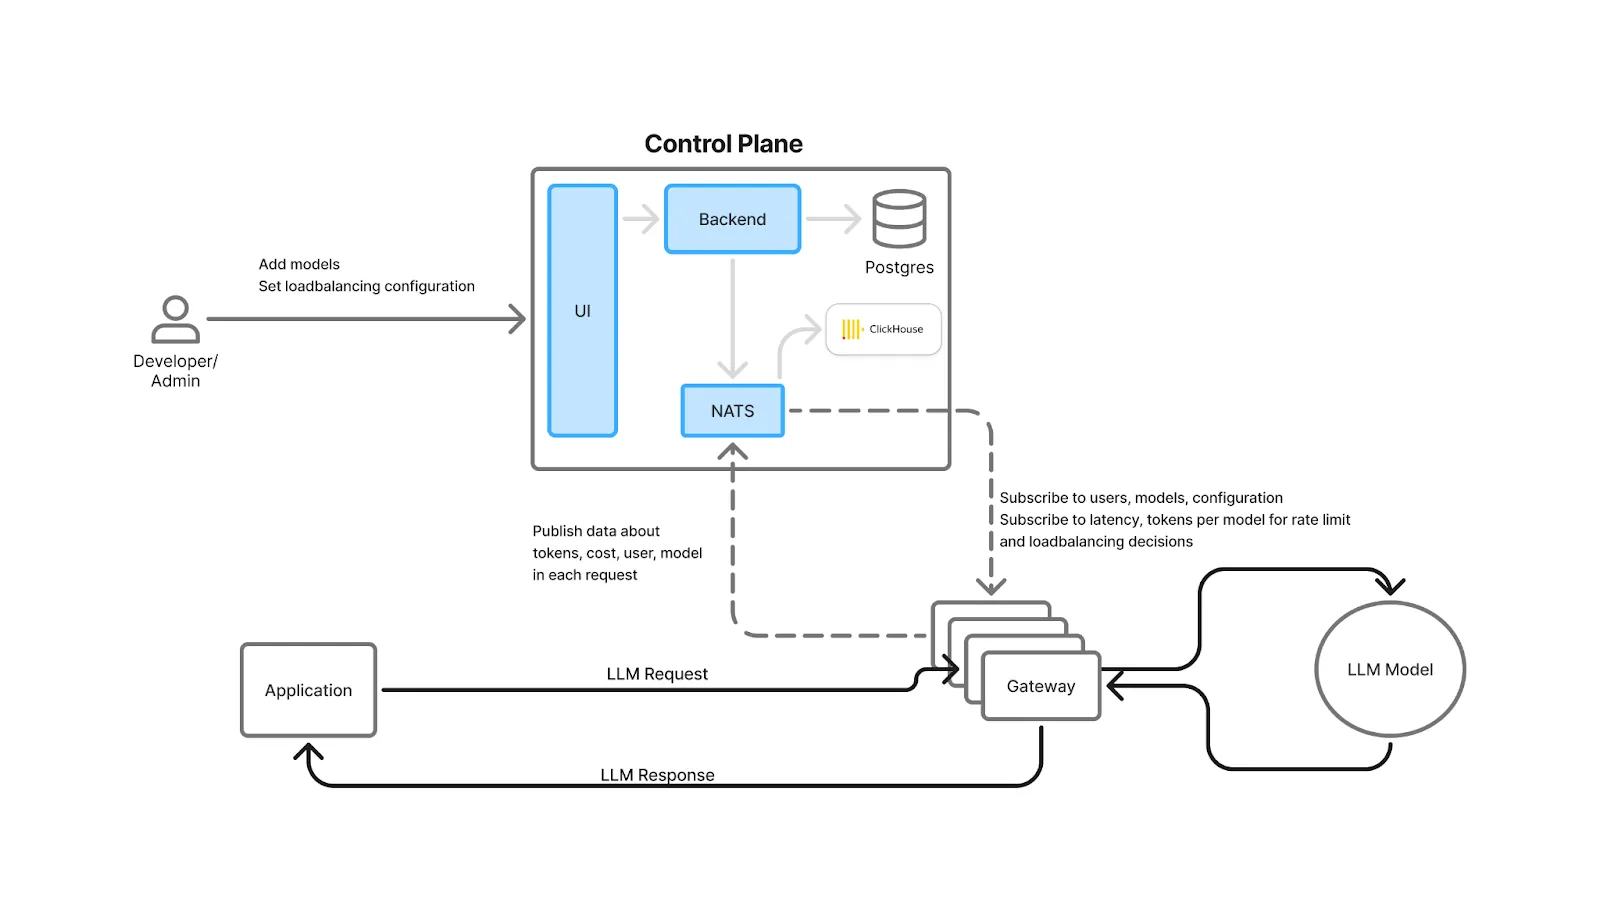
Een AI Gateway is een dunne, hoogwaardige laag die applicatieverzoeken doorstuurt naar een of meer LLM-providers of zelf-gehoste modellen. Het centraliseert API's, centraliseert authenticatie en RBAC (Role Based Access Control), past rate limits en guardrails toe, voert load balancing en failover uit, en legt observabiliteits- en kostengegevens vast voor elk verzoek. Zie het als de "ingress + policy + telemetry"-laag voor GenAI.
Op operationeel niveau ondersteunen moderne gateways gewogen en op latency gebaseerde routing, statuscontroles en automatische fallbacks wanneer een model of regio niet beschikbaar is — zodat verzoeken gewoon doorgaan, zelfs tijdens storingen bij de provider. Omdat elk verzoek via de gateway loopt, kunnen teams providers vergelijken op latency en kosten, wat OpenRouter vs AI gateway een praktische evaluatie maakt bij de beslissing hoe routing, observabiliteit en controle op schaal moeten worden beheerd.
De architectuur van TrueFoundry is zo ontworpen dat deze controles en metrieken minimale overhead toevoegen: controles voor authenticatie, rate limiting en load balancing worden in-memory uitgevoerd; logs/metrieken worden asynchroon naar een wachtrij geschreven; en het verzoektraject vermijdt externe calls (tenzij u kiest voor caching). De gateway is horizontaal schaalbaar en CPU-gebonden, waardoor de end-to-end latency-overhead beperkt blijft tot enkele milliseconden.
LLM-latency is multimodaal: er is time to first token (TTFT), inter-token latency (ITL) voor streaming, en de totale verzoek-latency. Elk heeft een andere invloed op de ervaren gebruikerservaring. Gateways die alle drie bijhouden, helpen u te diagnosticeren of vertragingen worden veroorzaakt door providerwachtrijen, modelverwerking, het netwerk of de promptlengte — en om de beste routingstrategie te kiezen.
Tokens zijn de nieuwe CPU-cyclus. Een enkele prompt kan vertakken naar meerdere tools of retrieval-stappen, en kosten stapelen zich op over verschillende providers. Observabiliteit moet uitgaven toewijzen per model, provider, omgeving, applicatie, tenant en gebruiker, en actueel blijven met de openbare prijzen van providers om handmatige spreadsheets te voorkomen.
Productie-applicaties hebben guardrails nodig tegen providerstoringen, throttling en achteruitgang van modelprestaties. Observabiliteit die gekoppeld is aan statuscontroles, uitsplitsingen van 4xx/5xx-codes, retry/fallback-percentages en rate-limit-gebruik stelt u in staat om SLO's te handhaven en automatisch over te schakelen bij afnemende prestaties.
Enterprises hebben volledige verzoek/antwoord-tracering nodig met toegangscontroles en PII-/contentmoderatiebeleid. Een gateway centraliseert deze handhaving en protocollen, zodat teams kunnen aantonen wie welk model heeft aangeroepen, met welke gegevens en wat de uitkomst was — zonder provider-API-sleutels breed te delen.
Modelkwaliteit, prijzen en quota veranderen regelmatig. Organisaties die gateways van instrumentatie voorzien, kunnen providers direct met elkaar vergelijken en verkeer verplaatsen op basis van actuele data over latency, kosten en fouten — waardoor prestaties en marges behouden blijven terwijl de markt zich ontwikkelt.
Externe richtlijnen bevestigen deze behoeften: marktleiders benadrukken AI-observabiliteit voor snelle reacties op drift, storingen en kostenspieken; OpenAI en Azure raden gestructureerde logging en exponentiële backoff voor rate limits aan, wat een gateway kan standaardiseren over applicaties heen.
Hieronder staan de functionaliteiten die u mag verwachten van een enterprise-grade AI Gateway — en die TrueFoundry native biedt.
Belangrijke metrieken voor het evalueren van een Gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Data Residency | Bewaart logs binnen uw regio (EU/US)? | Afhankelijk van use case | ✅ Ondersteund |
| Latency-Based Routing | Stuurt automatisch om op basis van realtime latency/storingen? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

Zo integreert TrueFoundry observabiliteit in de kern van het verzoektraject en levert het een volledige analytics-stack kant-en-klaar mee — zonder het productieverkeer te vertragen.

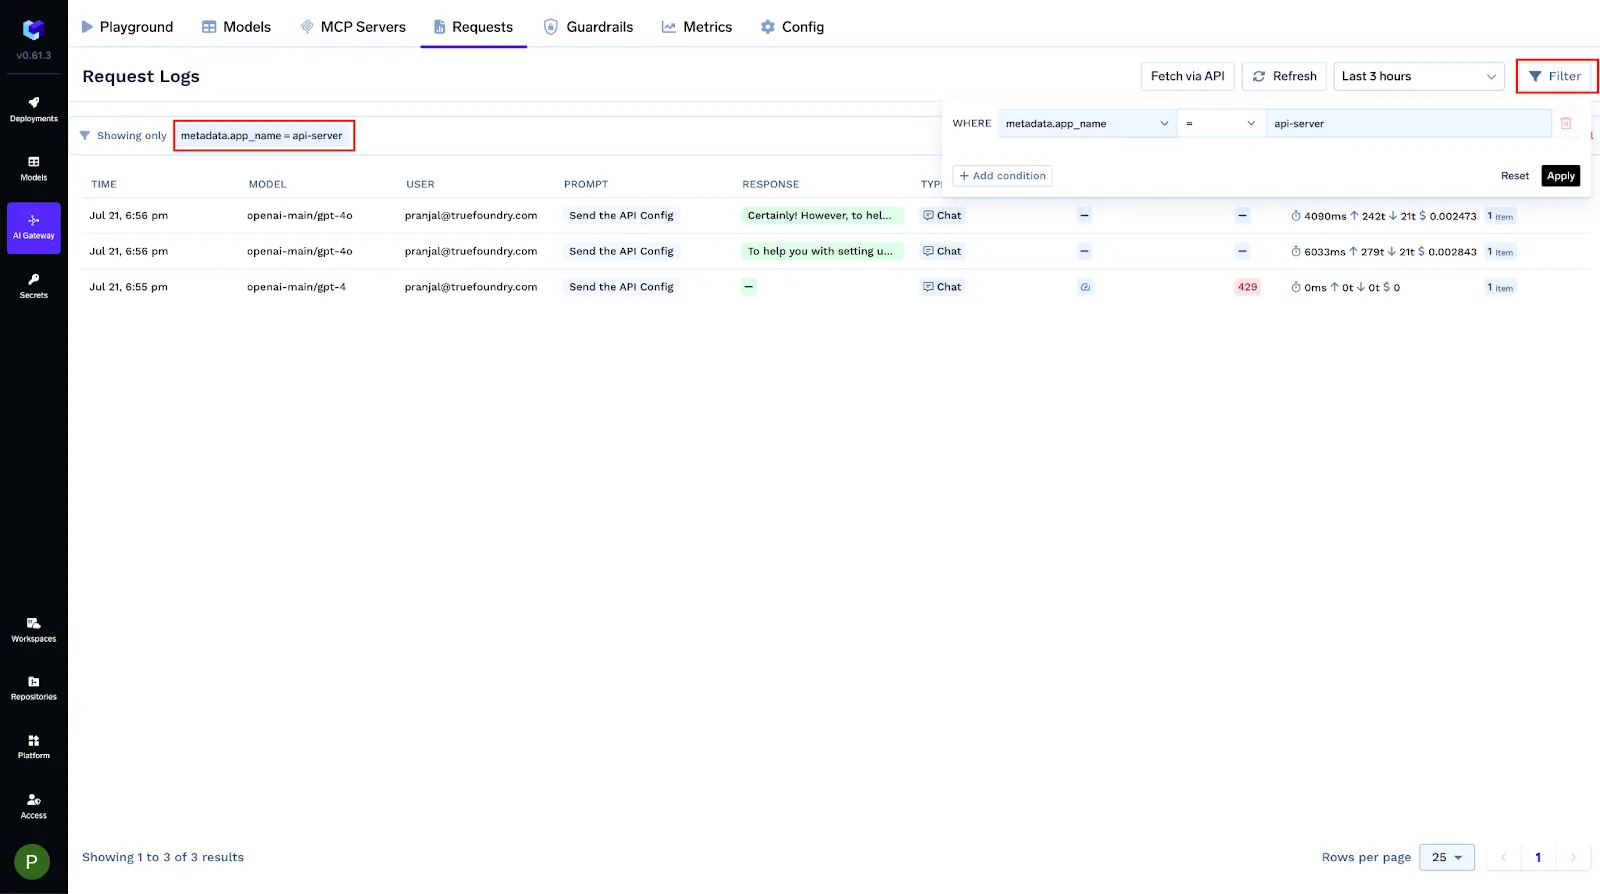
Het Analytics-dashboard biedt inzicht in: Request Latency (p50/p95/p99), Time to First Token (TTFT/TTFS), Inter-Token Latency (ITL), kosten per model/provider, input/output-tokens, foutcodes en beleidsactiviteit (rate-limit, load-balancing, fallbacks, guardrails, budgetten). Weergaven kunnen worden gefilterd op model, gebruiker, team, ruleId en aangepaste metadata; u kunt ook ruwe CSV-bestanden downloaden.
Schakel Public Cost in om automatisch prijzen per token op te halen uit de gepubliceerde tarieven van providers (OpenAI, Anthropic, Bedrock, etc.). Voor onderhandelde of fine-tuned modellen stelt u Private Cost in met aangepaste prijzen voor input/output-tokens. Beide stromen mee in de kosten-analytics per verzoek en op geaggregeerd niveau.
Voeg zakelijke context toe (klant, functie, omgeving) en splits tokens, latency en uitgaven uit op elke dimensie — ideaal voor doorbelastingen (chargebacks), het opsporen van 'noisy neighbors' en het prioriteren van optimalisaties.

Definieer quota op basis van tokens of verzoeken per minuut/uur/dag, afgestemd op gebruikers, modellen of segmenten die zijn geïdentificeerd via metadata. Dashboards tonen het gebruik en de throttles, zodat u limieten juist kunt afstemmen en gedeelde capaciteit kunt beschermen.
Gebruik op gewicht gebaseerde verdelingen voor experimenten of op latency gebaseerde routing voor stabiele situaties. Statuscontroles markeren backends als ongezond bij het bereiken van drempelwaarden voor fouten/latency en sluiten deze automatisch uit. Fallback-ketens proberen het opnieuw bij fouten, met spans en metrieken die laten zien welk pad is gekozen en wat de impact op latency en kosten was.
Centraliseer provider keys, verstrek scoped access tokens, dwing RBAC af en bewaar onveranderlijke request/response-logs voor compliance—over LLMs en MCP servers heen
U kunt elke request taggen met gestructureerde metadata via de X-TFY-METADATA header. Gelogde keys worden querybare filters, Grafana-labels en voorwaarden in gateway-configuraties (rate limits, load balancing, fallbacks, guardrails). Waarden zijn strings (≤128 tekens).
Hetzelfde metadata-patroon is van toepassing op load balancing en fallback-regels
De gateway voldoet aan de OpenTelemetry-standaard. Schakel OTLP-export in en verstuur traces naar elke gewenste backend (Tempo, Jaeger, Datadog/New Relic via Collector, TrueFoundry Tracing). Spans bevatten genai-attributen—model, tokens, TTFT, ITL, parameters, tool calls, errors—en gedetailleerde spans voor rate limiting, load balancing, fallbacks en MCP server/tool calls, waarmee u providergedrag kunt correleren met spans op applicatieniveau.
Tracing inschakelen
Representatieve spans

Metadata-keys vermeld in LLM_GATEWAY_METADATA_LOGGING_KEYS worden Prometheus labels llm_gateway_metadata_<key>, wat kosten- en latencydiagrammen per klant/per feature mogelijk maakt. (Truefoundry Docs)
Belangrijkste metriekfamilies (subset)
Een voorgebouwd Grafana dashboard JSON is gepubliceerd door TrueFoundry, georganiseerd in Model-, User-, Config- en MCP Invocation-weergaven. Voeg variabelen toe voor uw aangepaste metadata, bijv.:

Anthropic's Model Context Protocol (MCP)—aangekondigd op 25 november 2024—gestandaardiseerd hoe assistenten verbinding maken met tools, prompts en bronnen. Het ecosysteem is doorgegroeid in 2025 met veel vooraf gebouwde servers (GitHub, Slack, Google Maps, Puppeteer, enz.).
TrueFoundry integreert MCP op native wijze:
Dit maakt de gateway het operationele controle-element voor agentic workloads—waarbij beleid, auth, routing en end-to-end zichtbaarheid worden verenigd over zowel LLM-calls als tool-uitvoeringen.
Hieronder vindt u een praktische checklist. Elke metriek bevat wat het u vertelt, hoe u het gebruikt en hoe TrueFoundry het weergeeft.
Een prompt-wijziging verhoogt de lengte van de output voor enterprise-klanten. Symptomen: stijgende output-tokens, hogere p95-latency en hogere dagelijkse uitgaven. Actie met TrueFoundry: Analytics toont een sprong in output-tokens voor de "support-prod"-omgeving en een kostensprong voor het primaire model. U vergelijkt een alternatieve provider die een lagere TTFT en goedkopere output-tokens laat zien; u leidt 30% van het verkeer om via gewichtsgebaseerde routing en stelt een waarschuwing in op "kosten per gesprek".
Om 10:00 IST stegen de foutpercentages naar 429s. Actie met TrueFoundry: Rate-limit dashboards bevestigen throttling vanuit de upstream. Fallback-ketens treden in werking en de routing verschuift naar een gezondere backend. U houdt de gebruikerservaring stabiel en past later token-quota's en backoff-parameters aan.
Gebruikers melden dat "het antwoord snel begint, maar daarna kruipt". Actie met TrueFoundry: TTFT is in orde, maar ITL is verhoogd op het primaire model. Latency-gebaseerde routing geeft automatisch de voorkeur aan een provider met een betere streaming-throughput; u stelt ook een waarschuwing in op ITL p95.
De batch-job van één klant verbruikt te veel tokens en vertraagt de rest. Actie met TrueFoundry: Token-gebaseerde rate-limits per klant dwingen een eerlijke verdeling af en beschermen SLO's; analytics verifiëren het gebruik en geweigerde aantallen, zodat u hogere quota's kunt verkopen.
LLM-applicaties zijn dynamische systemen. Modellen evolueren, providers wijzigen hun quota en prijzen, prompts veranderen en gebruikersgedrag verrast je. De beste AI gateway is de plek waar je dit alles kunt observeren, beheren en optimaliseren—als je de juiste signalen verzamelt en omzet in acties.
TrueFoundry’s AI Gateway biedt je dat operationele commandocentrum. Het legt latency (TTFT/ITL), tokens, kosten en fouten vast met een lage overhead; dwingt token-aware rate limits, RBAC en guardrails af; en biedt inzicht in routing, health en fallbacks, zodat je ervaringen snel, betrouwbaar en kostenefficiënt kunt houden. Met gedetailleerde klant-/gebruikersanalyses en geautomatiseerde, actuele kostentoewijzing kunnen teams overstappen van reactief problemen oplossen naar proactieve optimalisatie.
Als je je GenAI-stack centraliseert—of een wirwar van eenmalige integraties ontwart—begin dan met het routen van verkeer via de gateway, schakel de bovenstaande dashboards in en stel een aantal SLO-aligned alerts in. Je krijgt de zichtbaarheid die nodig is om sneller te deployen, kosten te beheersen en je agents en gebruikers tevreden te houden.
Observabiliteit in een AI gateway helpt bij het traceren van complexe meerstaps-redeneringen en tool-aanroepen die anders ondoorzichtig blijven. Het monitoren van agent-uitvoeringspaden helpt bij het in real-time detecteren van oneindige loops, hallucinaties en inefficiënt toolgebruik. Deze zichtbaarheid zorgt ervoor dat autonome agents betrouwbaar, voorspelbaar en binnen het budget blijven terwijl ze interageren met diverse externe systemen en API's.
AI gateway-observabiliteit optimaliseert LLM-prestaties door real-time tracking te bieden van latency, throughput en error rates bij verschillende modelproviders. Door gedetailleerde metrieken zoals Time to First Token (TTFT) en Inter-Token Latency (ITL) vast te leggen, kunnen teams specifieke knelpunten in de inference-keten opsporen. Deze inzichten stellen ontwikkelaars in staat om modelsnelheden objectief te vergelijken en slimme routing te implementeren om hoge prestaties voor eindgebruikers te garanderen.
AI gateway-observabiliteit verlaagt de kosten door gedetailleerd inzicht te bieden in het tokenverbruik over modellen, teams en gebruikers heen. Het bijhouden van uitgaven per request en workspace stelt teams in staat om ontspoorde prompts of inefficiënte workflows onmiddellijk te identificeren. Deze data ondersteunt geautomatiseerde kostenbesparende strategieën zoals semantic caching, token-aware rate limiting en het routen van queries naar goedkopere modellen zonder handmatige tussenkomst.
AI gateway-observabiliteit ondersteunt compliance-auditing door een gecentraliseerd, onveranderlijk logboek bij te houden van elk request en response. Moderne systemen leggen gedetailleerde audit trails vast, waaronder gebruiker-ID's, timestamps en PII-maskeringsevents om gevoelige gegevens te beschermen. Deze logs zorgen ervoor dat ondernemingen voldoen aan regelgevingsnormen zoals GDPR en SOC 2 door volledige transparantie te bieden in modelinteracties, vaak terwijl alle telemetrie binnen de beveiligde cloudomgeving van de organisatie blijft.
TrueFoundry vereenvoudigt het beheer van AI-infrastructuur door meerdere modelproviders te verenigen in één control plane via observabiliteit in AI gateways. TrueFoundry relateert telemetrie op request-niveau met GPU- en CPU-benutting om de toewijzing van resources te optimaliseren en verspilling te verminderen. Deze geïntegreerde aanpak stelt platformteams in staat om deployments, schaling en beveiligingsbeleid via diverse omgevingen native te beheren binnen hun AWS-, GCP- of Azure-accounts.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















