August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Naarmate organisaties hun AI-toepassingen schalen, is het begrijpen van wat uw modellen in productie doen even belangrijk als ze in de eerste plaats draaiende krijgen. Engineers hebben inzicht nodig in elk inferentieverzoek latentie, tokengebruik, modelgedrag, finish reason maar het verbinden van observability-tools met elk model en elke provider betekent complex, repetitief instrumentatiewerk voor elke integratie.
De grote vraag: hoe krijgt u full-stack inzicht in alle modellen die uw teams gebruiken zonder voor elk model maatwerkontwikkeling uit te voeren?
Bij Middleware is het doel om observability even eenvoudig als krachtig te maken. Daarom zijn we erg enthousiast om de integratie van Middleware met de TrueFoundry AI Gateway aan te kondigen. Deze integratie geeft uw organisatie volledig inzicht in elk AI-inferentieverzoek gecorreleerd met infrastructuurmetrieken, applicatietraces en logs allemaal vanuit één gecentraliseerd platform, wat helpt om te garanderen dat uw AI-operaties transparant en onder controle blijven.
De TrueFoundry AI Gateway is een krachtige manier voor ontwikkelaars en platformteams om hun AI-toepassingen te beheren, te monitoren en te schalen. Het brengt geünificeerde toegang tot honderden large language models, slimme routing en gecentraliseerde policy-handhaving samen allemaal op één plek. Eén enkele gateway-pod verwerkt meer dan 250 verzoeken per seconde terwijl het slechts ongeveer 3 ms aan latentie toevoegt, waardoor het vanaf dag één klaar is voor productie.
Nu de adoptie van AI versnelt, is de echte uitdaging niet de toegang tot modellen het is het beheren van de complexiteit die volgt. Meerdere providers, veranderende API's en strenge compliance-eisen kunnen teams snel vertragen. De TrueFoundry AI Gateway brengt orde in deze complexiteit en dient als de control plane voor enterprise AI. Het centraliseert toegang, handhaaft beleid en levert OpenTelemetry-compliant observability over elk model en elke omgeving zonder dat er wijzigingen nodig zijn in de toepassingen die de gateway aanroepen.
Middleware is een full-stack observability-platform dat is gebouwd op OpenTelemetry als de kernstandaard voor instrumentatie. Het accepteert traces, logs, infrastructuurmetrieken en real user monitoring data via de OTEL Collector, en slaat deze op in één gecorreleerde datalaag die engineeringteams op één plek een compleet beeld geeft van hun systemen.
Wat Middleware onderscheidt, is wat het doet nadat een trace binnenkomt. In plaats van spans geïsoleerd op te slaan, correleert Middleware ze met infrastructuursignalen van de host of het cluster waar de service draait. Een engineer die een latentiepiek in een gateway-span onderzoekt, kan rechtstreeks vanuit de trace-weergave navigeren naar CPU- en geheugenmetrieken voor die pod zonder van dashboard te wisselen. Middleware bouwt ook een live servicetopologiemap van inkomende span-data, waardoor elke geïstrumenteerde service zichtbaar wordt als een node in de servicemap, waarbij de latentie en het foutpercentage automatisch worden berekend op basis van de spans.
De integratie van Middleware en de TrueFoundry AI Gateway vereenvoudigt en versterkt uw AI-observability. Deze combinatie maakt het eenvoudig om observability van productiekwaliteit direct in uw AI-workflow te verankeren, zodat uw systemen vanaf het moment van deployment observeerbaar zijn.
Met deze geïntegreerde oplossing genereert elk inferentieverzoek dat door de TrueFoundry AI Gateway gaat automatisch een gestructureerde set OpenTelemetry-spans. Die spans bevatten prompt-inhoud, completion-inhoud, aantallen tokens, modelnaam, latentie en finish reason als opvraagbare attributen en stromen vervolgens asynchroon naar Middleware via OTLP/HTTP. Middleware verwerkt ze samen met de rest van uw infrastructuurtelemetrie, waardoor gateway-verkeer onmiddellijk zichtbaar wordt als een first-class service in de topologiemap en APM-weergaven, naast de applicatieservices die deze aanroepen.
Voor volledige controle over gevoelige gegevens verwijdert de Exclude Request Data-schakelaar van de TrueFoundry-gateway prompt- en completion-inhoud uit span-attributen vóór de export. Tokenaantallen, latentie en modelmetadata blijven in elk geval behouden, zodat u volledig operationeel inzicht behoudt zonder gebruikersinvoer bloot te stellen aan externe systemen. Voor organisaties met strenge netwerk-egress-eisen kan de gateway-exporter ook worden gericht op een zelfbeheerde OpenTelemetry Collector die doorstuurt naar Middleware waarvoor geen andere wijzigingen nodig zijn dan de endpoint-URL.
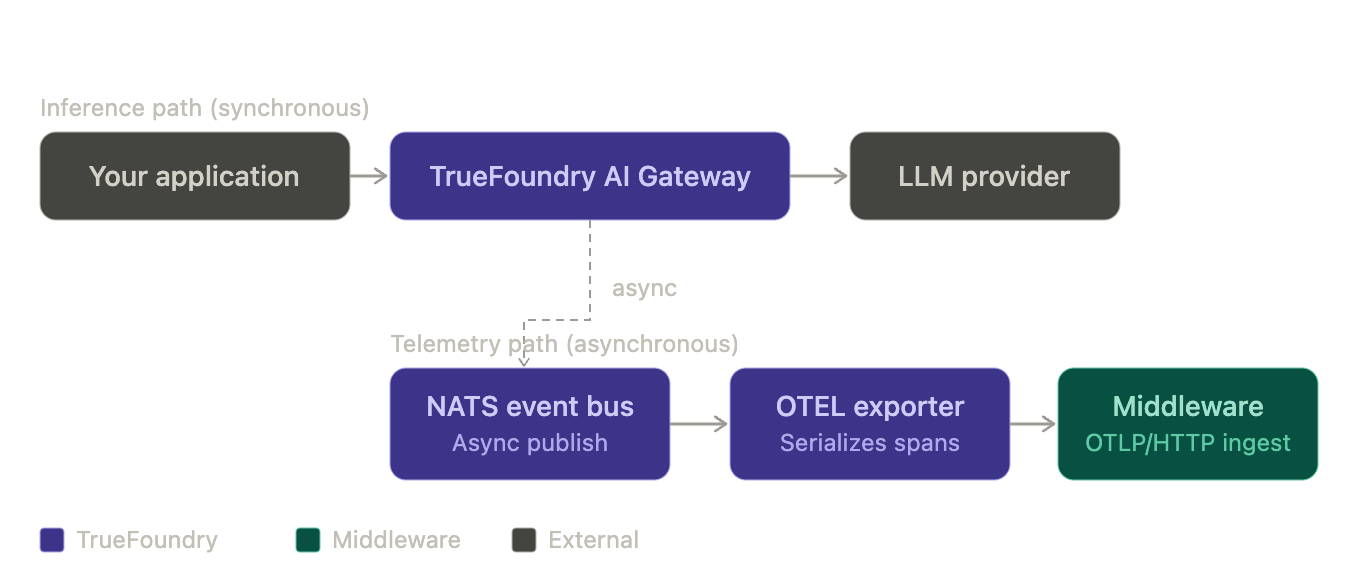
Integratie van Middleware en TrueFoundry AI Gateway
Middleware en de TrueFoundry AI Gateway werken samen om observability te leveren zonder complexiteit toe te voegen aan uw inferentiepad.
De configuratie is net zo eenvoudig. Navigeer naar AI Engineering → Settings → OTEL Config in het TrueFoundry-dashboard, voer uw Middleware-tenant-endpoint en API-key in, stel het protocol in op HTTP met protobuf-codering en u bent klaar om te starten.
AI-observability hoeft geen complex instrumentatiewerk te betekenen. Met Middleware geïntegreerd in de TrueFoundry AI Gateway wordt uw gehele inferentieverkeer zichtbaar gecorreleerd met infrastructuursignalen, filterbaar op modelnaam of aantallen tokens en in kaart gebracht in een live servicetopologie vanaf het moment dat de configuratie is opgeslagen. Het is complete observability van productiekwaliteit die eenvoudig in te stellen is, meer alsof u een knop omzet dan een maatwerkontwikkelingsproject.
Voor meer informatie kunt u de Middleware-documentatie en de TrueFoundry-integratiereferentie bezoeken om te zien hoe eenvoudig het is om full-stack inzicht te krijgen in uw AI-toepassingen.
Klaar om te beginnen? Verbind uw TrueFoundry-gateway vandaag nog met Middleware en zet elk inferentieverzoek om in een gestructureerd, opvraagbaar observability-event.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox