



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large language models worden in snel tempo een kernlaag van enterprise software. Wat begon als cloudgebaseerde experimenten met gehoste API's, ontwikkelt zich nu tot productiewaardige systemen die verankerd zijn in interne tools, klantgerichte toepassingen en geautomatiseerde workflows.
Naarmate deze verschuiving plaatsvindt, worden veel organisaties geconfronteerd met een harde werkelijkheid: niet alle AI-workloads kunnen in de public cloud draaien.
Gevoelige enterprise data, intellectueel eigendom, gereguleerde workloads, latentiegevoelige toepassingen en compliance-verplichtingen dwingen teams om LLM's te deployen binnen on-premise of private infrastructuur. Het simpelweg zelf hosten van modellen lost het grotere operationele probleem echter niet op. Naarmate meer teams, toepassingen en modellen online komen, hebben organisaties een consistente manier nodig om de toegang te beheren, beleid af te dwingen, het gebruik te monitoren en de kosten te beheersen in hun gehele LLM-ecosysteem.
Dit is waar een LLM Gateway on-premise infrastructuur essentieel wordt.
In plaats van te toestaan dat elke toepassing rechtstreeks integreert met individuele modellen, introduceert een LLM Gateway een gecentraliseerde controlelaag die regelt hoe modellen worden benaderd en gebruikt. In on-prem-omgevingen vormt deze gateway de ruggengraat waarmee enterprises LLM-adoptie veilig, compliant en efficiënt kunnen schalen zonder in te boeten op zichtbaarheid of controle.
Een LLM Gateway is een gecentraliseerde toegangs- en governancelaag die zich bevindt tussen toepassingen en taalmodellen. In plaats van dat toepassingen modellen rechtstreeks aanroepen, verlopen alle LLM-verzoeken via de gateway, die beveiliging, routing, observabiliteit en beleidscontroles op één plek afdwingt.
In een on-premise setup draaien zowel de gateway als de modellen volledig binnen de infrastructuur van de organisatie - zoals een datacenter, private cloud (VPC) of een air-gapped omgeving. Dit zorgt ervoor dat prompts, responsen, embeddings en metadata de gecontroleerde grenzen nooit verlaten.
Op hoofdlijnen biedt een on-prem LLM Gateway:
Door modeltoegang te abstraheren achter een gestandaardiseerde API, ontkoppelt de gateway de ontwikkeling van toepassingen van de modelinfrastructuur. Teams kunnen van model wisselen, fine-tuned versies introduceren of nieuwe governanceregels afdwingen zonder de applicatiecode te wijzigen.
In on-prem-omgevingen waar de infrastructuur eindig is, de compliance-eisen strikt zijn en de operationele complexiteit hoog is, is deze gecentraliseerde gatewaylaag hetgeen wat grootschalige LLM-adoptie haalbaar maakt. Het transformeert zelfgehoste modellen van geïsoleerde deployments naar een gecontroleerd, productiewaardig AI-platform.
Belangrijkste metrieken voor het evalueren van een Gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latentie | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Data-residentie | Bewaart logs binnen uw regio (EU/US)? | Afhankelijk van use case | ✅ Ondersteund |
| Op latentie gebaseerde routing | Stuurt automatisch om op basis van realtime latentie/storingen? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

Het draaien van LLM's on-premise is zelden alleen een infrastructuurbeslissing. Het wordt meestal gedreven door cruciale enterprise-eisen rond databeheer, beveiliging en governance. Een LLM Gateway maakt deze deployments op schaal praktisch uitvoerbaar.
Enterprises verwerken vaak gevoelige invoer zoals interne documenten, klantedossiers, broncode of geclassificeerde gegevens. In gereguleerde omgevingen is zelfs het tijdelijk verlaten van gecontroleerde infrastructuur door prompt-data onacceptabel.
Een on-prem LLM Gateway zorgt ervoor dat:
Dit is bijzonder kritiek voor organisaties die vallen onder strikte eisen voor datalokalisatie of -soevereiniteit.
Directe integraties tussen toepassingen en modellen creëren gefragmenteerde beveiligingsgrenzen. Elke service eindigt met het beheren van zijn eigen authenticatiegegevens, machtigingen en toegangslogica, wat het lastig maakt om uniforme beveiligingsnormen te handhaven.
Een LLM Gateway centraliseert:
Door al het verkeer via één enkele controlelaag te leiden, verkleinen enterprises hun aanvalsoppervlak aanzienlijk en krijgen ze vertrouwen in de manier waarop modellen worden benaderd.
Regelgevende kaderovereenkomsten vereisen toenemend dat organisaties vragen kunnen beantwoorden zoals:
Een on-prem LLM Gateway biedt standaard ingebouwde audit-trails. Elk verzoek kan worden gelogd, gemeten en getraceerd zonder afhankelijk te zijn van individuele applicatieteams om compliancelogica correct te implementeren.
Dit is essentieel voor omgevingen die onderhevig zijn aan GDPR, ITAR, HIPAA of interne governancenormen.
On-prem GPU-bronnen zijn eindig en kostbaar. Zonder gecentraliseerde controles kunnen teams eenvoudig te veel inferentiecapaciteit verbruiken of inefficiënte workloads deployen.
Een LLM Gateway maakt het volgende mogelijk:
Hiermee kunnen organisaties LLM-inferentie behandelen als een beheerde bron in plaats van een onbeheerste kostenpost.
Een on-prem LLM Gateway is geen losse service, maar een gelaagde infrastructuurstack die is ontworpen om te beheren hoe modellen worden benaderd, gecontroleerd en geëxploiteerd binnen enterprise-omgevingen.
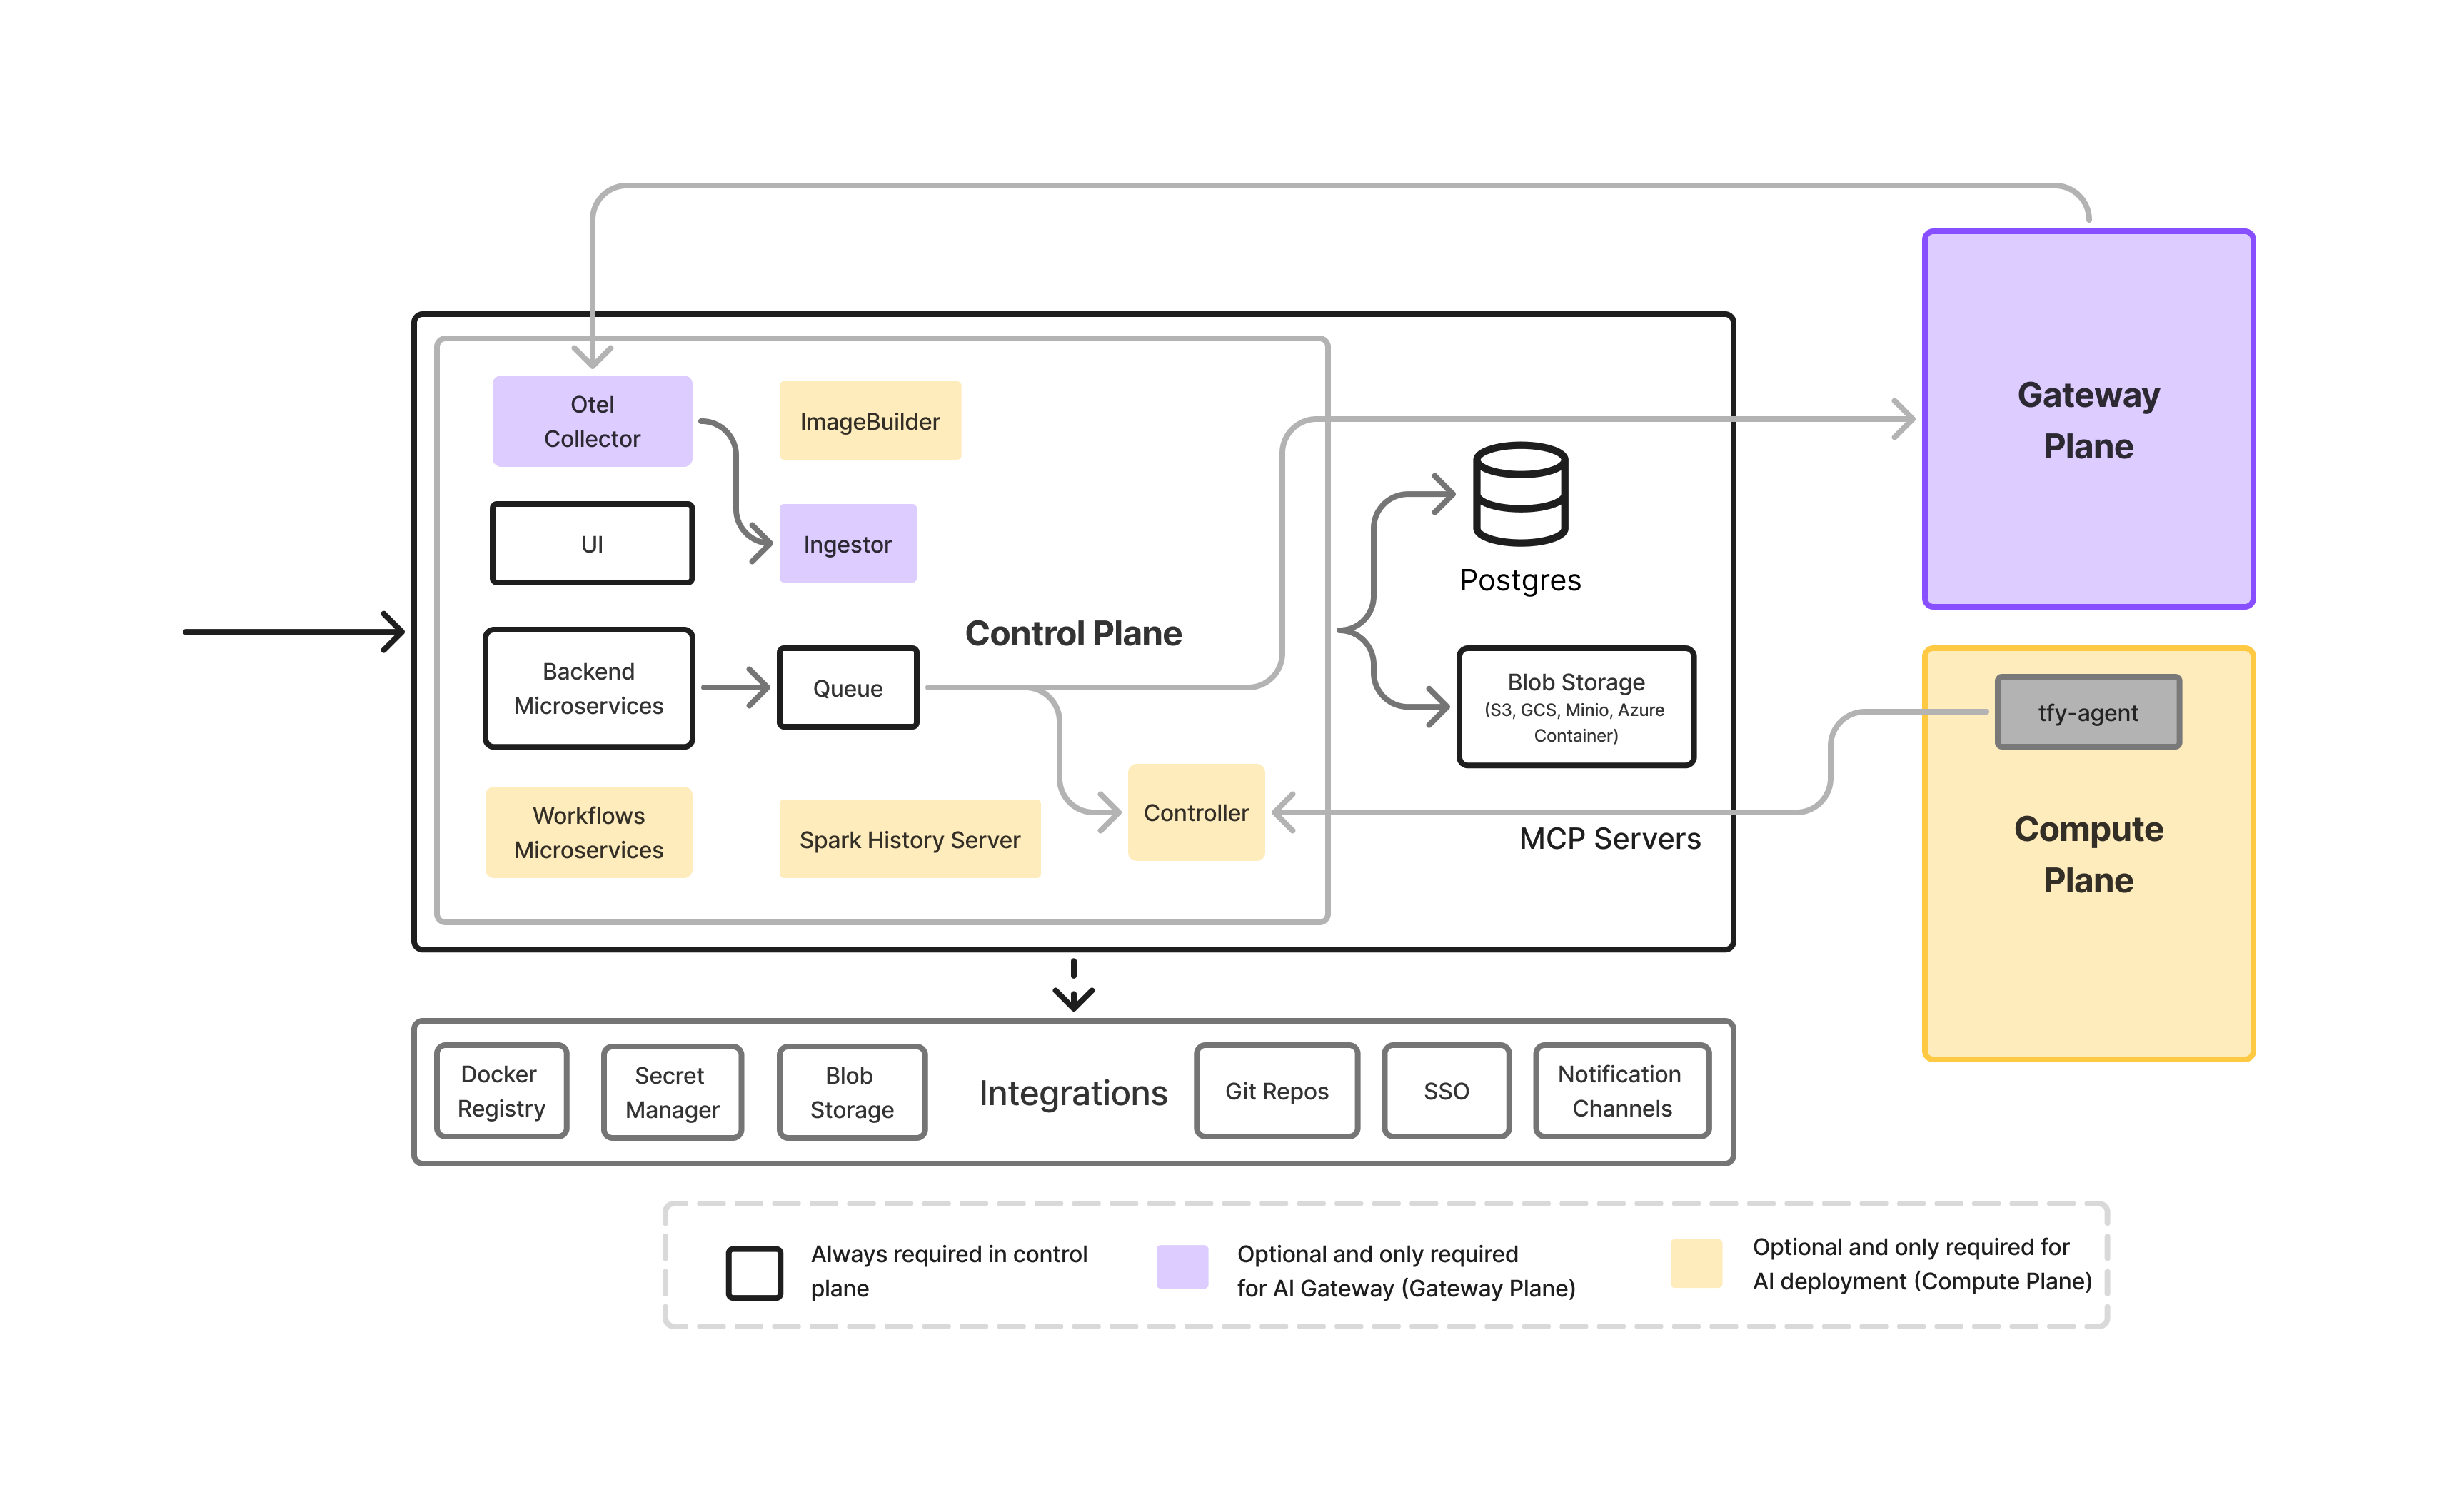
Dit is de voordeur voor al het LLM-verkeer.
Het verwerkt authenticatie, autorisatie, verzoekvalidatie en routingbeslissingen. Door beleid centraal af te dwingen, neemt het control plane de noodzaak weg voor applicatieteams om beveiligings- of governance-logica in hun code op te nemen.
Deze laag is verantwoordelijk voor model serving, het hosten van de daadwerkelijke LLM's die on-premise draaien en het beschikbaar stellen ervan voor GPU-geaccelereerde inferentie met lage latentie, waaronder:
De gateway abstraheert deze modellen achter een universele API, waardoor teams modellen kunnen wijzigen of upgraden zonder impact op toepassingen.
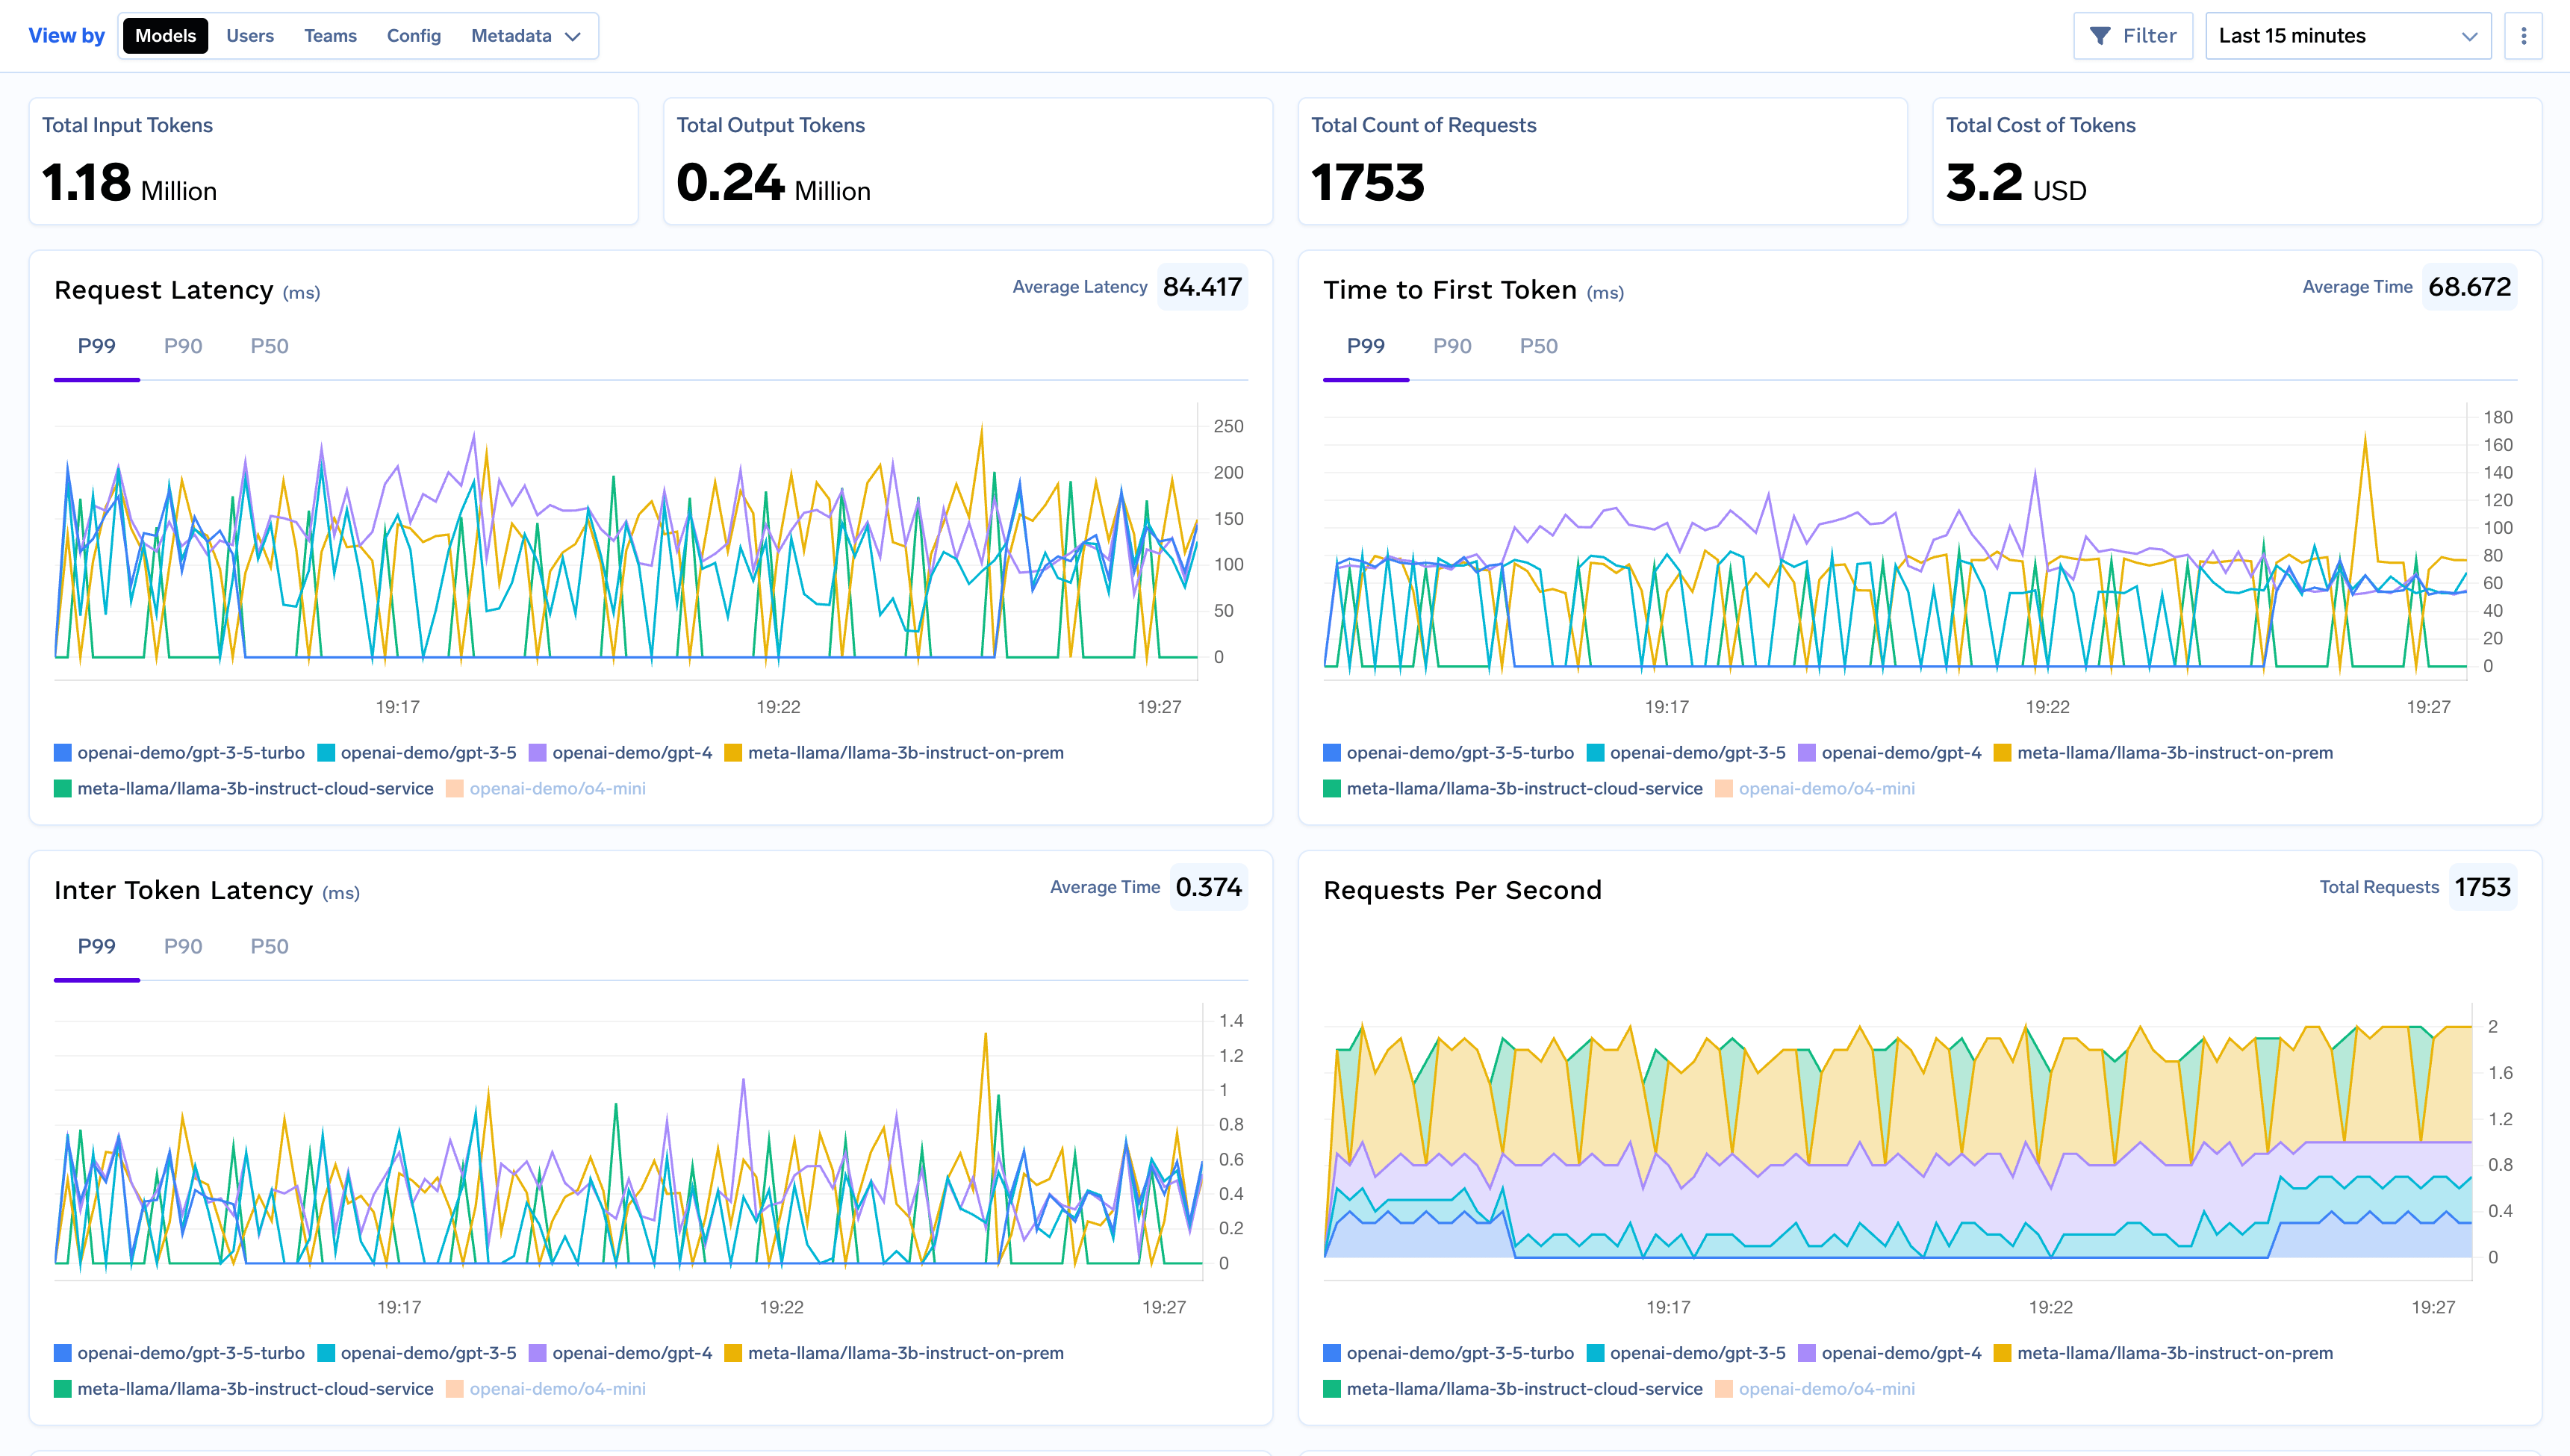
Zichtbaarheid is cruciaal in on-prem-omgevingen waar middelen beperkt zijn.
De gateway biedt:
Dit stelt teams in staat te begrijpen hoe modellen worden gebruikt en prestatie- of kostenproblemen vroegtijdig te identificeren.
Governanceregels worden één keer gedefinieerd en overal afgedwongen.
Dit omvat:
Gecentraliseerde governance voorkomt beleidsafwijkingen tussen teams en toepassingen.
De gateway en modelservices draaien doorgaans op Kubernetes-gebaseerde infrastructuur met GPU-ondersteuning. Deze laag biedt:
Het zorgt ervoor dat de gateway betrouwbaar functioneert als onderdeel van de bredere on-prem AI-stack.
In een on-premise setup fungeert de LLM Gateway als de centrale controlelaag tussen toepassingen en zelfgehoste modellen. Alle verzoeken verlopen via deze laag, wat zorgt voor consistente beveiliging, governance en observabiliteit.
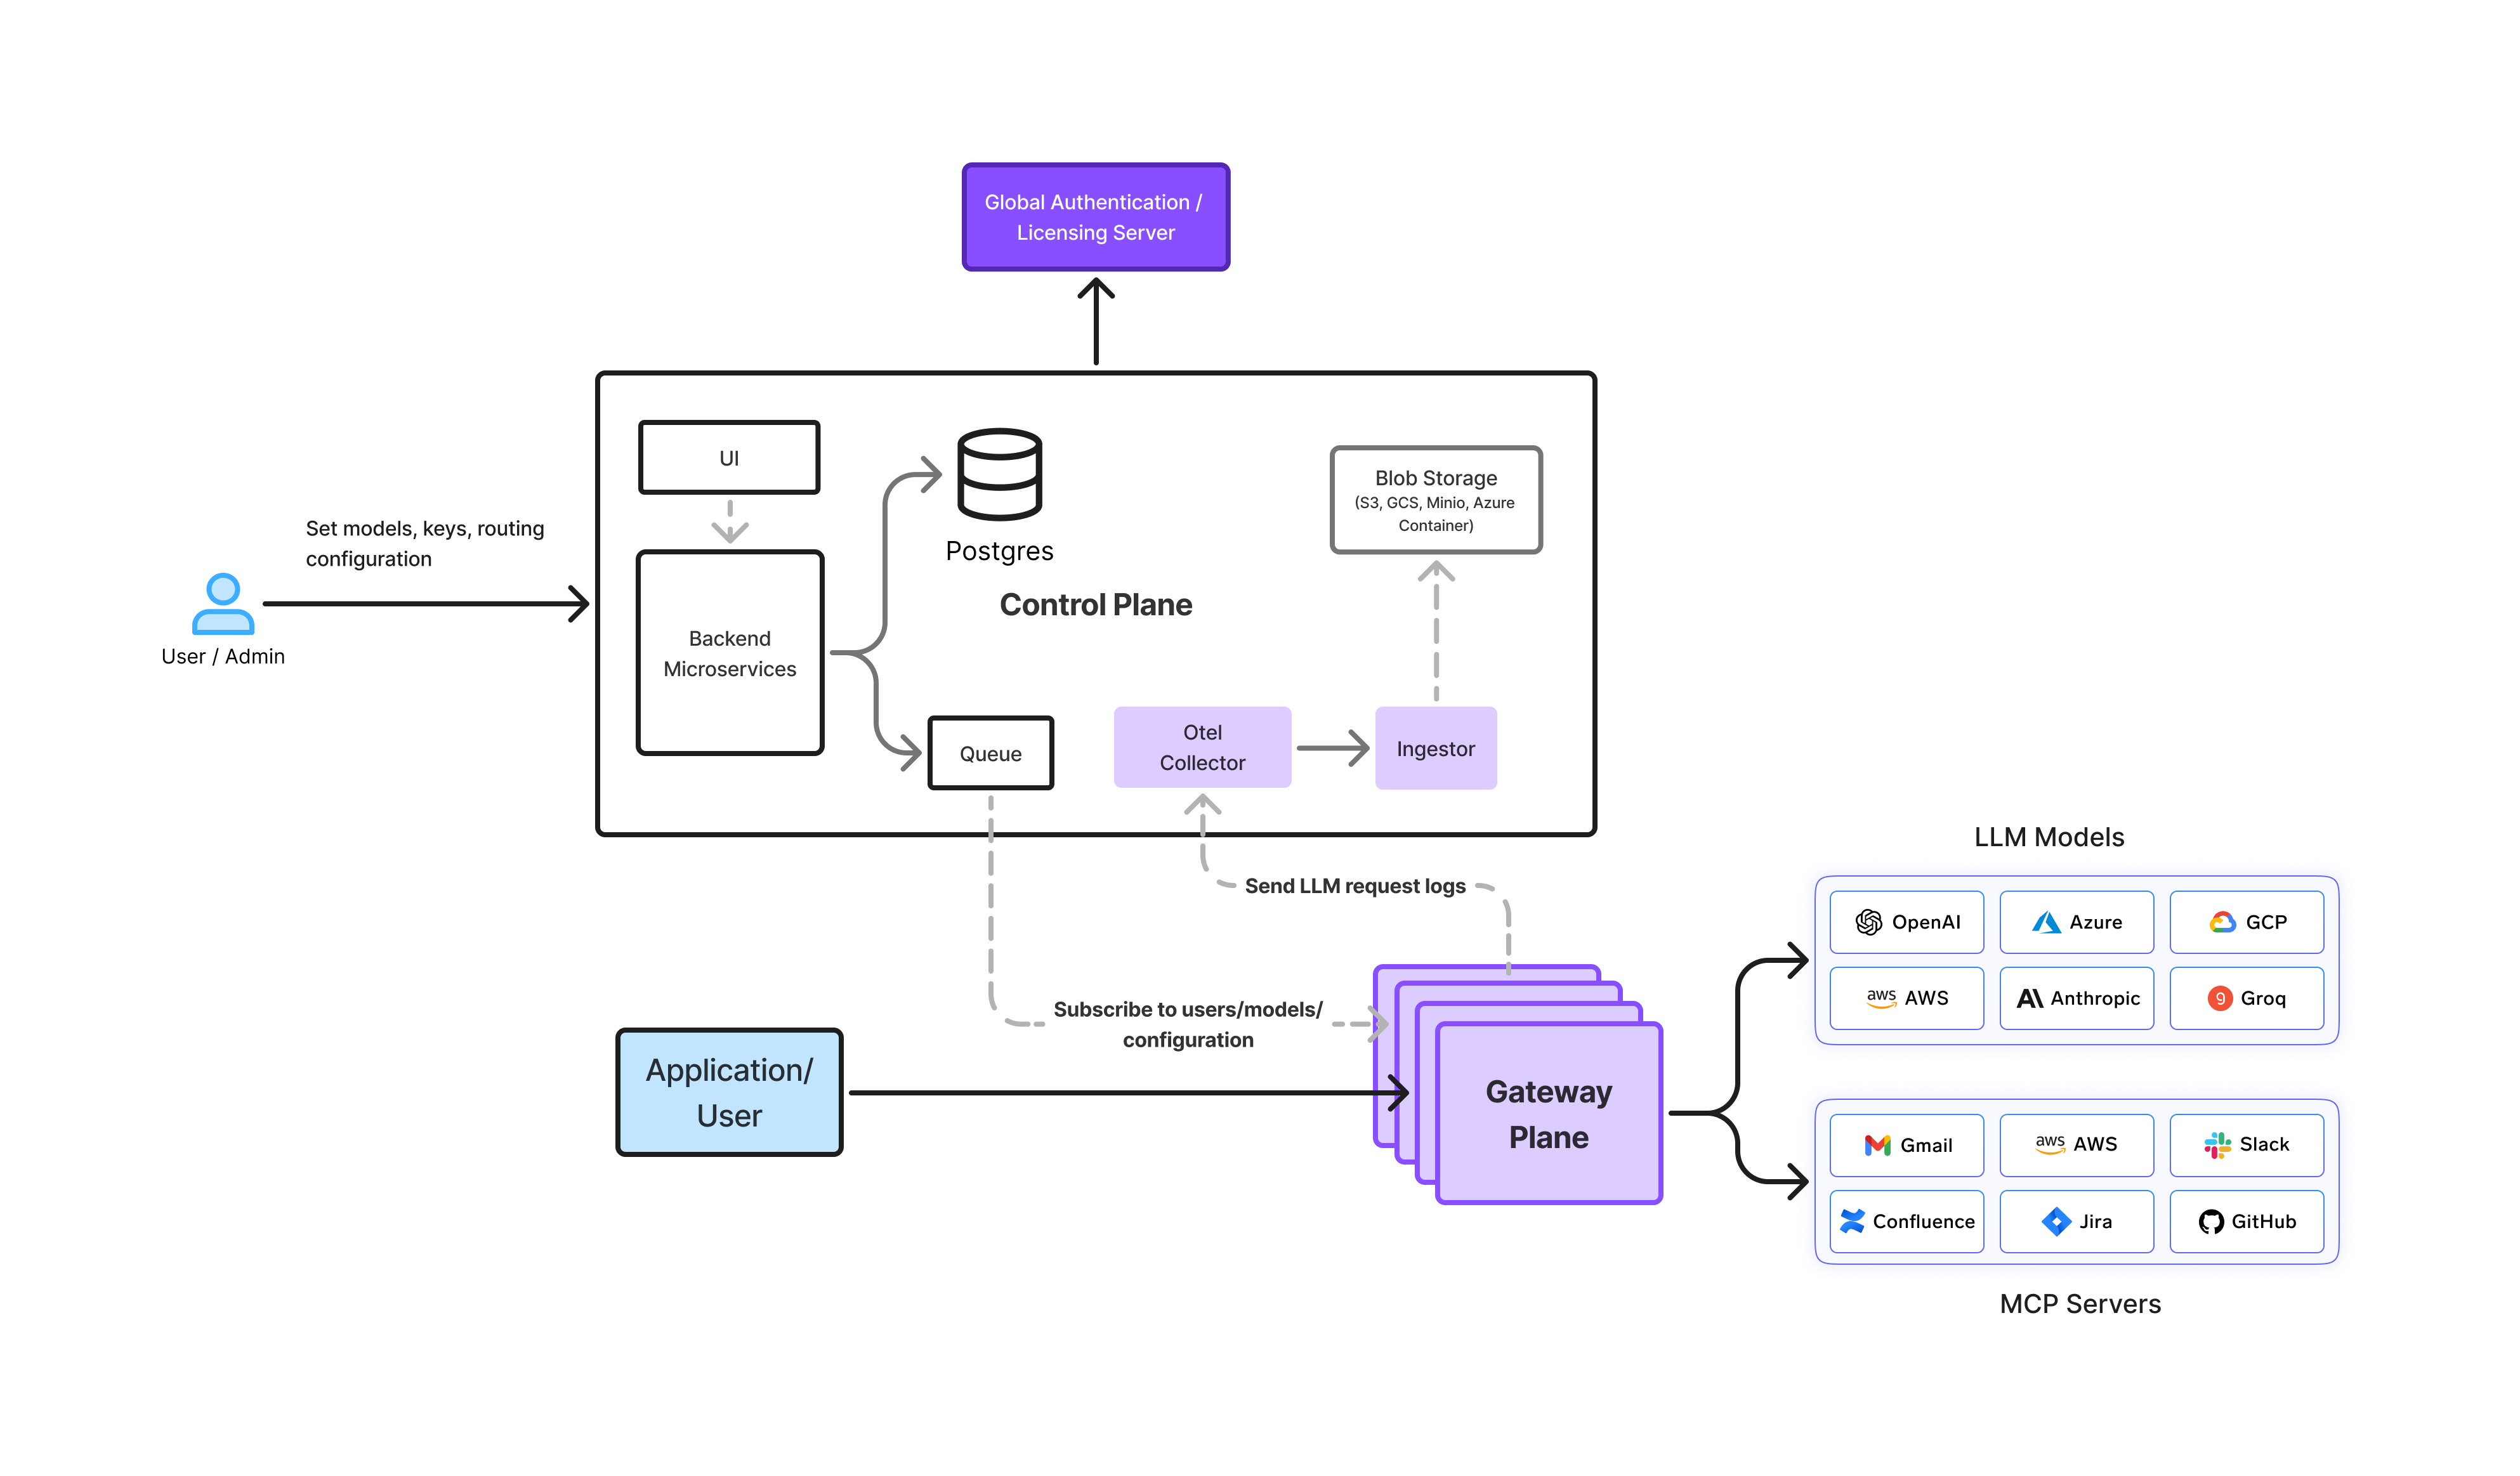
Enterprises deployen on-prem LLM Gateways op verschillende manieren, afhankelijk van beveiligings-, compliance- en connectiviteitseisen. De gateway-architectuur blijft hetzelfde, het deploymentmodel verandert.
In zeer streng gereguleerde omgevingenwerkt de infrastructuur zonder externe netwerktoegang.
In deze setups biedt de LLM Gateway volledige controle, terwijl er wordt voldaan aan strikte isolatie-eisen.
Veel enterprises deployen LLM Gateways binnen hun eigen cloudaccounts of private netwerken.
Dit model komt veel voor bij gereguleerde SaaS- en financiële dienstverleningsorganisaties.
Sommige organisaties verdelen workloads op basis van gevoeligheid.
De gateway waarborgt een consistent beleid, zelfs wanneer er meerdere uitvoeringsomgevingen bij betrokken zijn.
Hoewel on-prem LLM Gateways controle en compliance bieden, introduceren ze ook operationele uitdagingen waar enterprises rekening mee moeten houden.
Het beheren van GPU-ondersteunde inferentieworkloads on-prem vereist zorgvuldige capaciteitsplanning. Zonder automatisering kan het schalen van modellen of het verwerken van piekverkeer operationeel zwaar worden.
On-prem-omgevingen beschikken over een beperkte hoeveelheid rekenkracht. Slechte routing of een gebrek aan verzoekcontroles kan leiden tot latentieproblemen en onderbenutting van GPU's. Gecentraliseerd verkeersbeheer is essentieel om prestaties en efficiëntie in balans te houden.
Naarmate meerdere teams LLM's adopteren, kunnen governanceregels gemakkelijk uiteenlopen als ze op applicatieniveau worden afgedwongen. Het handhaven van consistente toegangscontroles en gebruiksregels over verschillende omgevingen is lastig zonder een gecentraliseerde gateway.
Enterprises moeten duidelijke overzichten van LLM-gebruik bewaren zonder de opslag te overbelasten of de prestaties te beïnvloeden. Het vinden van de juiste balans tussen observabiliteit en overhead is een veelvoorkomende uitdaging.
Enterprises die succesvol zijn met on-prem LLM-deployments behandelen de gateway als kerninfrastructuur, en niet slechts als een API-proxy.
Alle toepassingen en agents moeten modellen uitsluitend via de gateway benaderen. Dit elimineert schaduwintegraties en zorgt voor uniforme beveiliging en governance.
Toepassingen mogen nooit afhankelijk zijn van specifieke model-endpoints. Door modellen achter de gateway te abstraheren, kunnen teams modellen vervangen, upgraden of fine-tunen zonder codeaanpassingen.
Toegangscontroles, rate limits en gebruiksregels moeten zich in de gatewaylaag bevinden - niet in de applicatielogica. Dit voorkomt dat beleid tussen teams en omgevingen gaat afwijken.
Dev, staging en productie moeten op infrastructuur- en beleidsniveau geïsoleerd zijn. Dit vermindert risico's en maakt experimenteren veiliger.
Leg voldoende telemetrie vast voor auditeerbaarheid en optimalisatie, terwijl gevoelige prompt-data waar nodig wordt afgeschermd of beperkt. Observabiliteit moet controle mogelijk maken, niet nieuwe risico's introduceren.
Het volgen van deze best practices zorgt ervoor dat on-prem LLM Gateways veilig, schaalbaar en beheersbaar blijven naarmate het gebruik groeit.
Wanneer enterprises verder gaan dan experimenteren en large language models integreren in kernsystemen, wordt controle net zo belangrijk als functionaliteit. On-premise deployments voldoen aan de eisen op het gebied van data-residentie, beveiliging en compliance, maar zonder een gecentraliseerde toegangslaag worden ze snel gefragmenteerd en moeilijk te beheren.
Een LLM Gateway on-premise infrastructuur biedt de ontbrekende controlelaag. Het standaardiseert hoe toepassingen interactie hebben met modellen, dwingt consistent beleid af en levert de zichtbaarheid die nodig is om LLM's op verantwoorde wijze en op schaal te gebruiken.
Het kiezen van de beste LLM gateway voor on-prem deployments vereist een afweging tussen governance, prestaties en operationele eenvoud, in plaats van alleen te focussen op de routing van verzoeken.
In plaats van zelfgehoste modellen te behandelen als geïsoleerde services, transformeren organisaties die kiezen voor een gateway-first benadering hun LLM's tot beheerde enterprise-infrastructuur - veilig, observeerbaar en gereed voor langdurige groei.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















