November 11, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
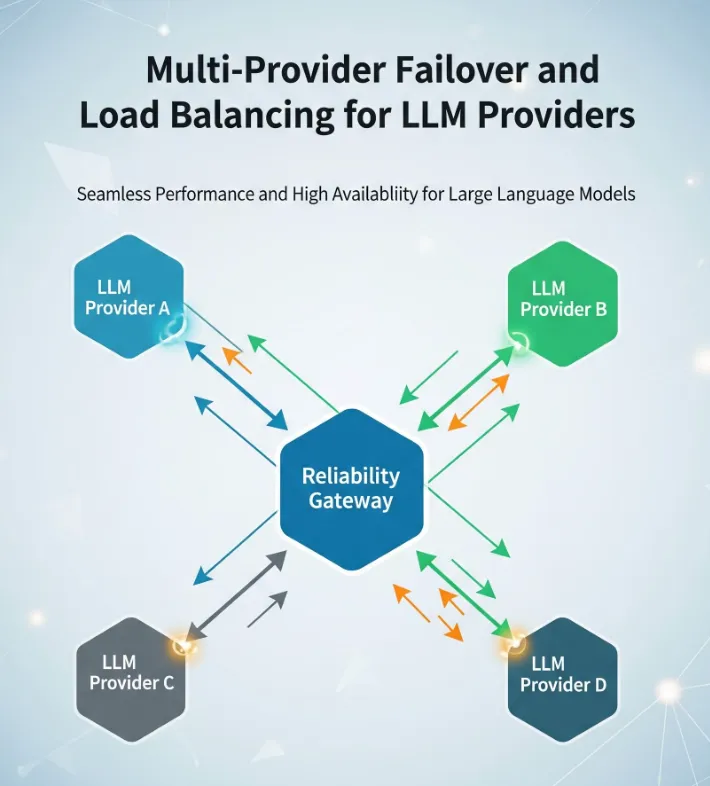
Elke modelprovider heeft slechte dagen — regionale storingen, rate-limit storms onder zware belasting, latency die verslechtert zonder echt te mislukken. Als uw applicatie één provider rechtstreeks aanroept, is de slechtste dag van die provider uw slechtste dag. Dit artikel vormt de betrouwbaarheidslaag die dit voorkomt: een taxonomie van hoe LLM-aanroepen mislukken, retries die de situatie niet verergeren, fallback chains over meerdere providers, health-aware load balancing, circuit breakers die snel mislukken (fail fast), en het echt lastige geval van failover halverwege een stream.
02:14 uur bij Northwind. Nadia, een SRE, werd wakker geschud door een melding: de klantspecifieke support-agent gaf fouten terug aan elke gebruiker. Niet aan sommige gebruikers — aan elke gebruiker. De eigen diensten van Northwind waren gezond; CPU, geheugen en wachtrijen waren allemaal nominaal. De fouten waren identiek: 503 van de modelprovider. Een regionaal incident aan de kant van de provider had het inference endpoint platgelegd, en de agent van Northwind riep dat endpoint rechtstreeks aan. Elke request raakte het dode endpoint, mislukte en stuurde een foutmelding terug naar de klant. Veertig minuten lang, totdat de provider herstelde, was er niets anders te doen dan wachten — de agent had precies één manier om een completion te krijgen, en die lag eruit.
Het actiepunt van de postmortem was niet "kies een betrouwbaardere provider." Elke provider heeft incidenten. Het was "wees nooit afhankelijk van één enkele provider voor een request die moet slagen." Dat is een gateway-probleem, en dit artikel legt uit hoe u het oplost: retries die de situatie niet verergeren, fallback chains over meerdere providers, health-aware load balancing en circuit breakers die snel mislukken in plaats van uw hele systeem mee te sleuren met de provider.
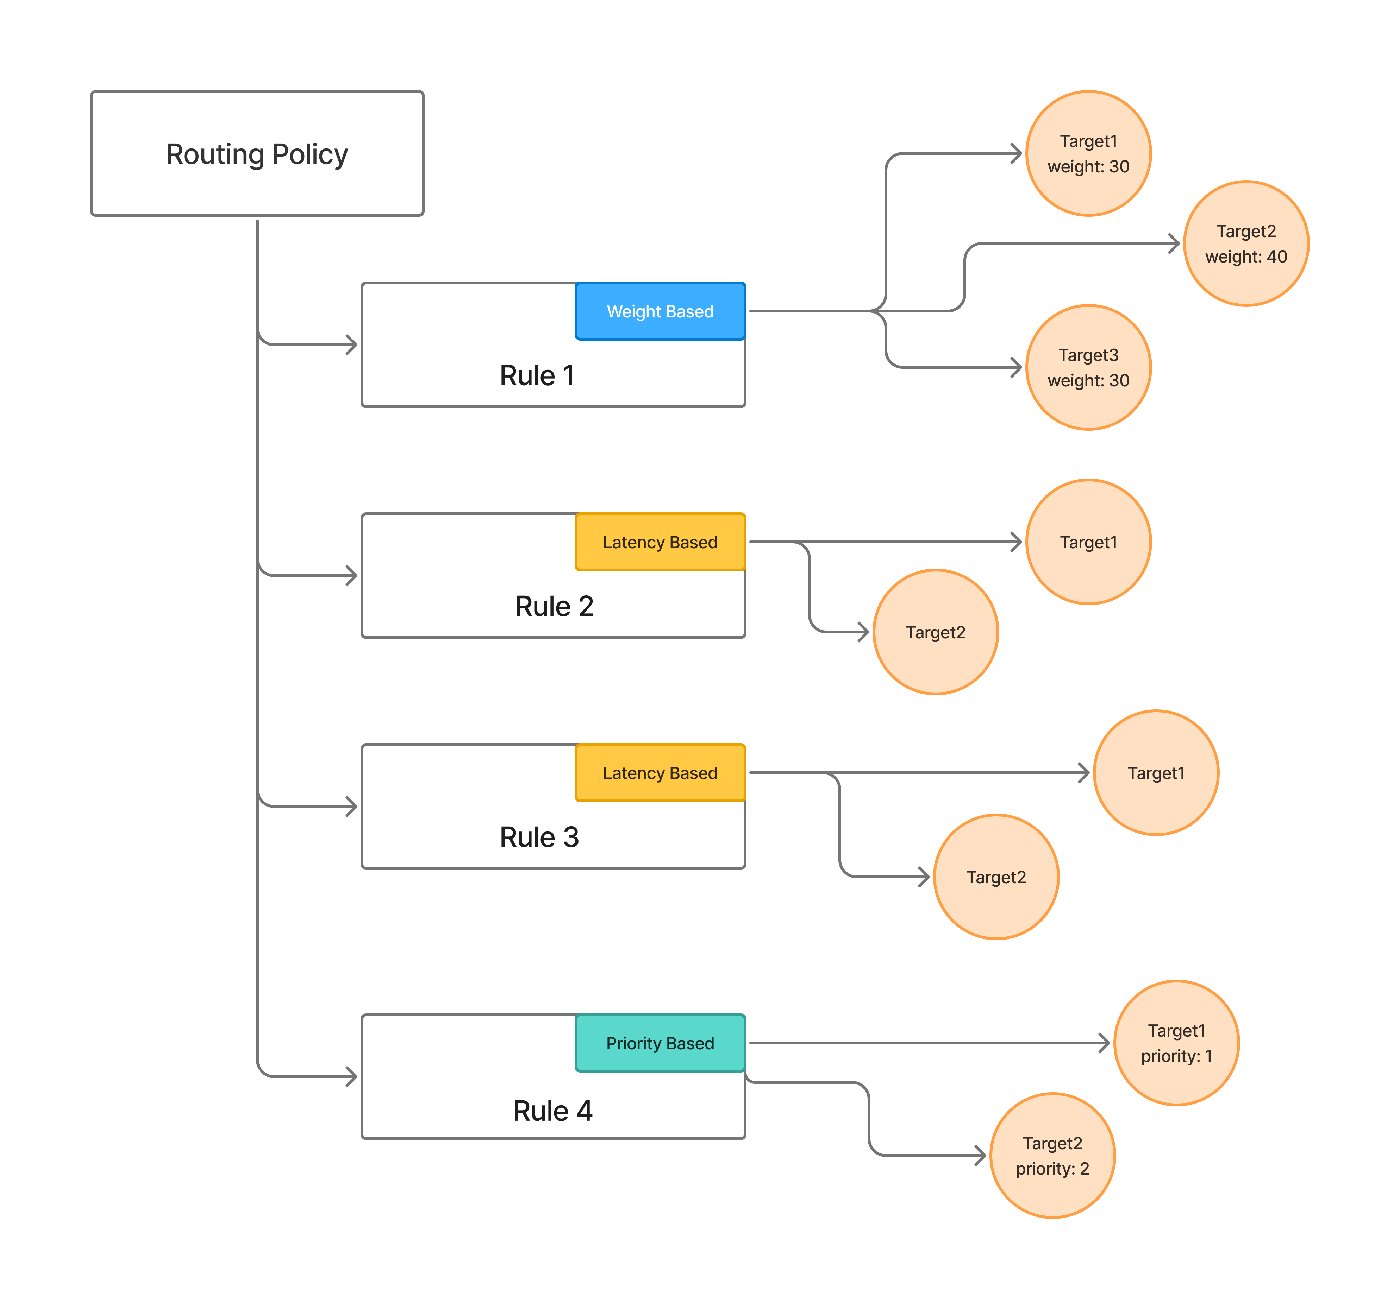
Alles in dit artikel — retries, fallback chains, health-aware load balancing — is iets wat TrueFoundry's AI Gateway uitdrukt als configuratie in plaats van code per dienst. De routingconfiguratie definieert regels voor load balancing, fallback en retries in YAML, evalueert ze op volgorde zodat de eerste overeenkomende regel wint, en past ze centraal toe op elke request in plaats van dat ze in elke app opnieuw moeten worden geïmplementeerd.
De onderdelen sluiten aan op de onderstaande foutentaxonomie. Elk doel heeft zijn eigen retry_config — pogingen, vertraging en de statuscodes die het herhalen waard zijn (standaard 429/500/502/503) — en een afzonderlijke fallback_status_codes-lijst verplaatst de request naar het volgende doel wanneer retries niet helpen. Priority-based routing biedt een geordende failover-chain; latency-based routing geeft de voorkeur aan het gezonde doel met de laagste latency; en een ongezond doel wordt gedetecteerd aan de hand van het aantal requests, tokens en fouten per minuut en aan de kant gezet voor een afkoelperiode (cooldown). De documentatie behandelt zelfs het lastige streaming-geval uit sectie 8 — providerspecifieke stream-overload afhandeling zodat een doorval kan plaatsvinden voordat er voor de gebruiker zichtbare tokens worden gegenereerd.
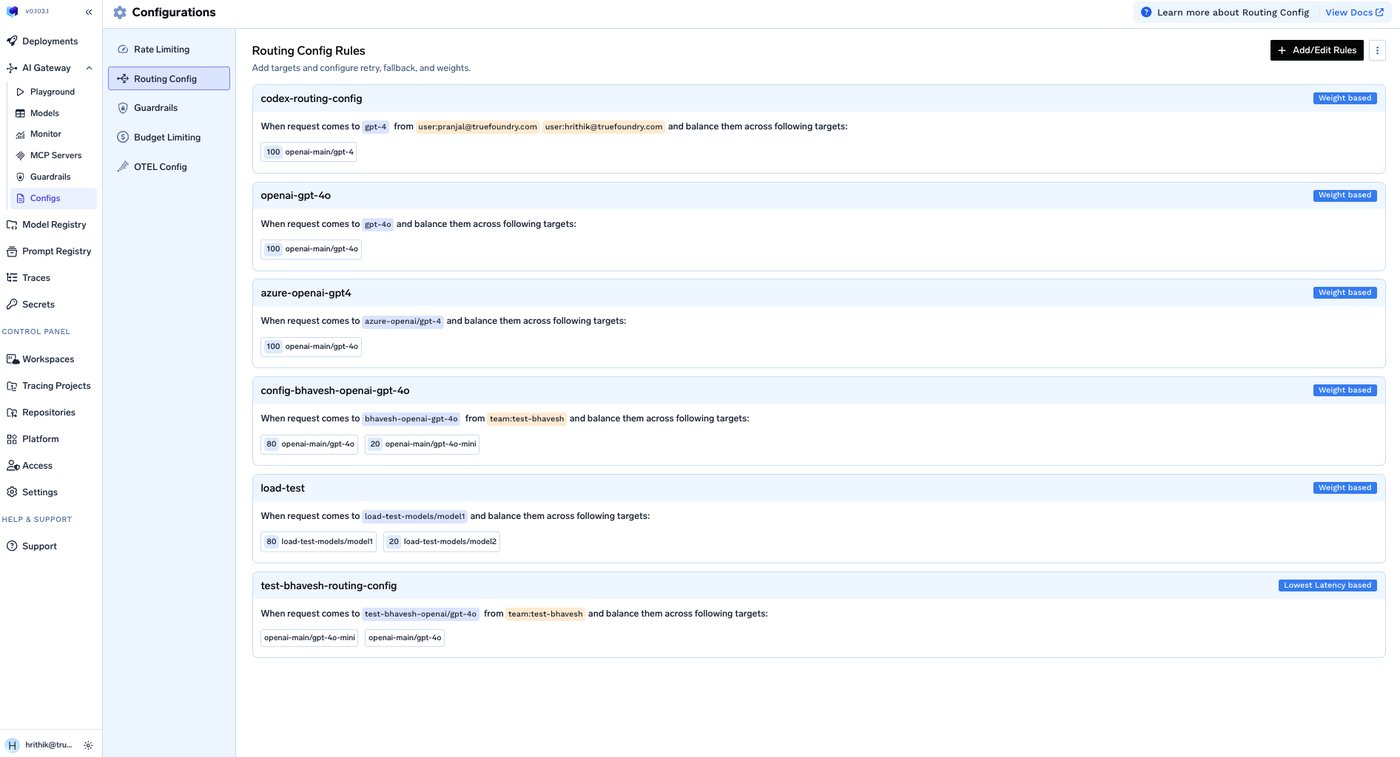
Het aanroepen van de gateway vanuit een applicatie is een aanpassing van één regel voor alles wat al de OpenAI SDK gebruikt — dezelfde client, een andere URL en sleutel — zodat het betrouwbaarheidsbeleid in de configuratie staat, niet in de code:
Productie-LLM-applicaties zijn afhankelijk van infrastructuur die ze niet beheren. Providers hebben regionale en wereldwijde storingen, ze retourneren 429-fouten wanneer u een rate limit overschrijdt (en soms simpelweg wanneer ze overbelast zijn), en hun latency verslechtert onder belasting zonder dat er überhaupt een fout wordt geretourneerd. Een directe integratie maakt de provider een single point of failure: er is geen ander pad naar een completion dan het pad dat eruit ligt.
Het werk dat dit oplost — retries, fallback, load balancing, circuit breaking — is overkoepelend. Elke dienst die een model aanroept heeft het nodig, en het per dienst implementeren betekent dat elke dienst dezelfde logica opnieuw formuleert en afwijkt van de rest. Hierdoor is het retry-beleid van het agent-team en dat van het zoek-team subtiel anders en zijn ze beide subtiel onjuist. De gateway is de enige component die elke provider ziet, elke sleutel beheert en de API normaliseert naar één enkele vorm — wat precies is wat nodig is voor failover van de ene provider naar de andere. Centralisatie van betrouwbaarheid bij TrueFoundry's AI Gateway betekent één beleid, uniform toegepast, waarbij de failover-gebeurtenissen op dezelfde request traces terechtkomen als de rest van uw telemetrie.
De meest voorkomende betrouwbaarheidsfout is het behandelen van elke storing als "fout, herhalen". Verschillende storingen vragen om verschillende reacties, en de onderstaande tabel biedt het overzicht. Dit verkeerd aanpakken is hoe een rate limit verandert in een algehele storing.
De laatste rij is de rij die teams het vaakst verkeerd begripen: een afwijzing door een content-filter is een eigenschap van de request, geen tijdelijke storing. Opnieuw proberen kost tijd en geld, en uitwijken naar een andere provider levert vaak precies dezelfde afwijzing op — dus deze moet worden geclassificeerd als niet-herhaalbaar en naar de oppervlakte worden gebracht, niet stilzwijgend in een loop worden geplaatst. Een afzonderlijk herstelpad kan de prompt herschrijven, de gebruiker om verduidelijking vragen of naar een veiliger werkproces routeren, maar dat is een beleidsstroom, geen failover. Deze tabel eenmalig coderen op de gateway — welk signaal gekoppeld is aan herhalen, terugvallen of naar de oppervlakte brengen — betekent dat elke dienst dezelfde classificatie erft in plaats van deze opnieuw uit te vinden; het uniform toepassen van die toewijzing is een van de zaken die TrueFoundry's AI Gateway centraliseert.
Retries zijn de eerste verdedigingslinie en de eenvoudigste om tegen jezelf in te zetten. Drie regels maken ze veilig: exponentiële backoff (langer wachten na elke mislukking), jitter (de wachttijd randomiseren zodat clients niet tegelijkertijd herhalen), en het respecteren van de rate-limit headers van de provider — Retry-After waar deze wordt verzonden, of remaining/reset headers zoals x-ratelimit-* waar dat het contract van de provider is (luister wanneer de server u vertelt wanneer u terug moet komen).
De storing die ze voorkomen is de thundering herd. Wanneer een provider onder belasting 429-fouten begint te retourneren en elke client onmiddellijk en synchroon opnieuw probeert, houden de retries de overbelasting juist in stand — een zelf veroorzaakte denial of service die de provider precies geblokkeerd houdt wanneer u wilt dat deze herstelt. Jitter desynchroniseert de retries, backoff vermindert de druk naarmate de tijd vordert, en Retry-After respecteert het eigen signaal van de provider over wanneer er weer capaciteit is. Even belangrijk is het niet herhalen van wat niet zal slagen: een verkeerd gevormde request of een afwijzing door een content-filter is een 4xx die bij de volgende poging identiek zal mislukken, dus herhalen voegt alleen maar latency en kosten toe.
Een consistent retry-beleid is precies het soort ding dat afwijkt wanneer elke dienst zijn eigen logica beheert. Toegepast bij TrueFoundry's AI Gateway zijn de afhandeling van backoff, jitter en Retry-After uniform voor elke dienst die erdoorheen wordt gerouteerd, en is de grens van herhalen-en-dan-terugvallen één geconfigureerd gedrag in plaats van vijf subtiel verschillende varianten.
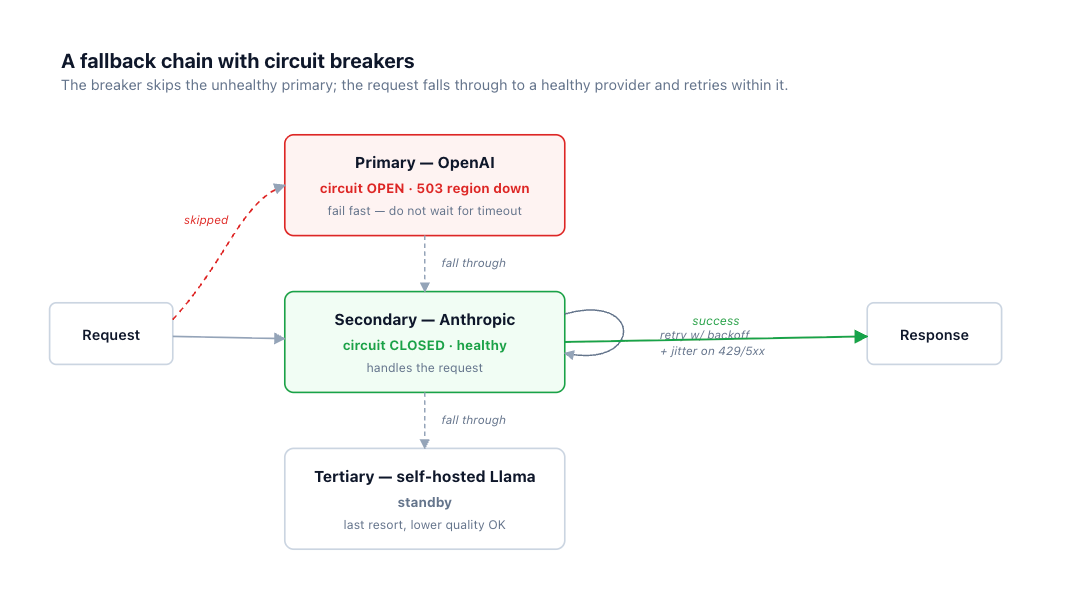
Wanneer pogingen tegen het primaire model zijn uitgeput, houdt een fallback chain de request levend: primair, dan secundair, dan tertiair. Er zijn twee assen. Over providers heen (Claude, dan GPT, dan Gemini) biedt onafhankelijke foutdomeinen — verschillende infrastructuur, verschillende incidenten, dus het is onwaarschijnlijk dat het secundaire model om dezelfde reden platligt als het primaire. Binnen een provider (een alternatieve regio of deployment) is goedkoper in te stellen, maar deelt een foutdomein, dus het beschermt tegen een gelokaliseerd probleem in plaats van een provider-brede storing.
Illustratieve fallback chain (conceptueel — exact schema is gateway-specifiek)
Dit is niet alleen een patroon — het is de manier waarop TrueFoundry's AI Gateway is geconfigureerd. Een fallback chain is een priority-based routingregel: elk doel krijgt een prioriteit, een eigen retry-beleid en de statuscodes die een doorval naar het volgende doel moeten activeren — waarbij gehoste en zelfgehoste modellen worden gecombineerd achter één OpenAI-compatibele API, zodat de fallback een andere leverancier of uw eigen model kan zijn zonder dat de applicatie daarvan op de hoogte is:
Hoe TrueFoundry dezelfde chain uitdrukt (gateway-load-balancing-config)
Retries vinden plaats binnen een doel via retry_config; fallback_status_codes bepalen wanneer op te geven en naar het volgende doel te gaan. De weergave op request-niveau van de gateway legt vast welke doelen zijn geprobeerd en waarom een doorval heeft plaatsgevonden, zodat failover kan worden geanalyseerd in plaats van afgeleid — en het volledige schema, inclusief op gewicht en latency gebaseerde strategieën, bevindt zich in de routing config docs.
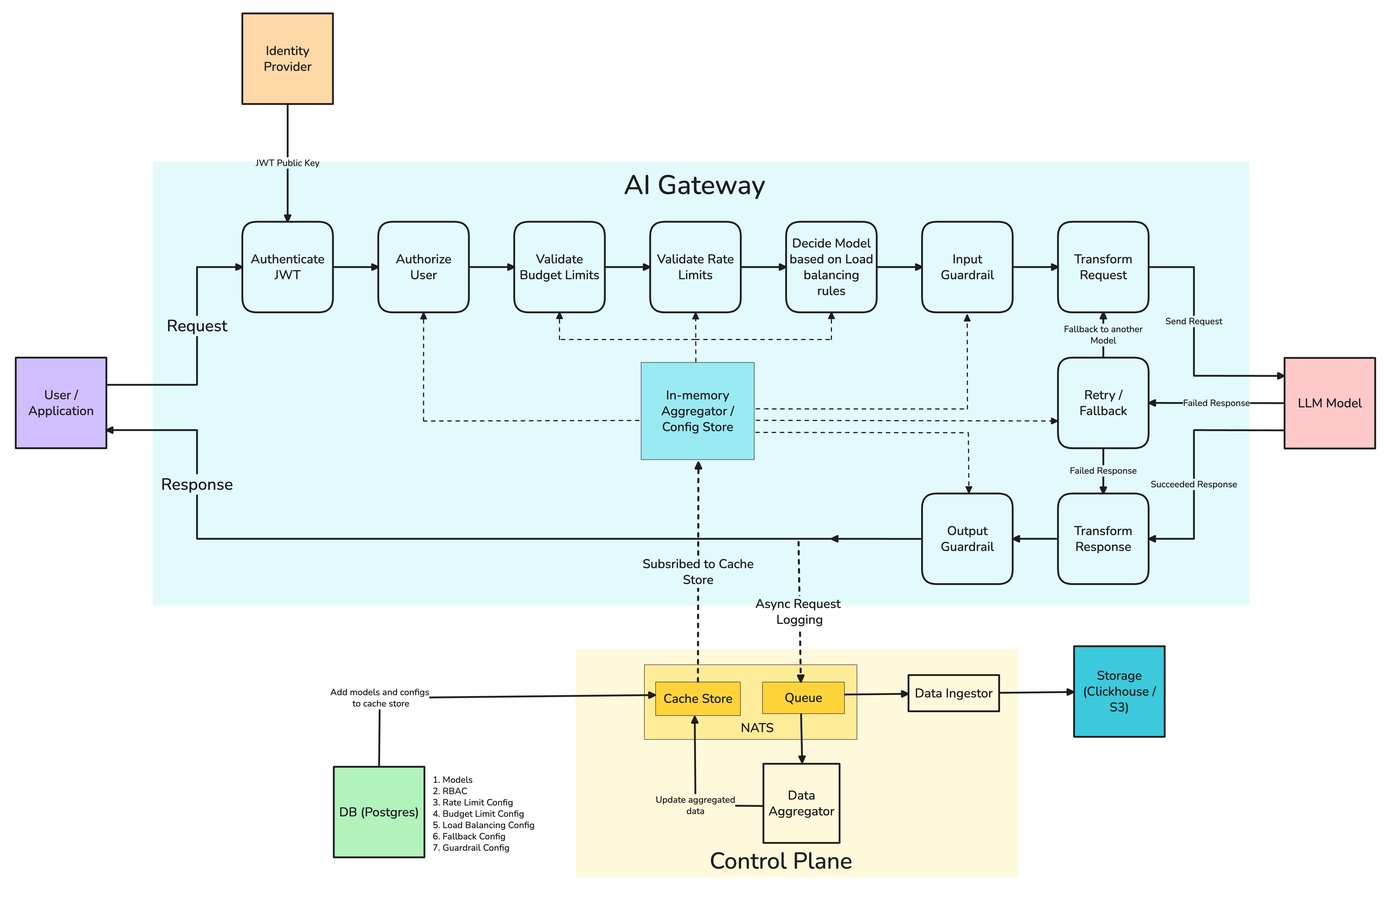
Een tweede patroon dat het bekijken waard is — een on-prem primair model met een cloud fallback, de indeling waar de meeste gereguleerde workloads op uitkomen — wordt op dezelfde manier ingezet:
On-prem primair met cloud fallback (uit de documentatie)
Onder de motorkap moet het failover-systeem betrouwbaarder zijn dan wat het beschermt — dus de gateway voert elke rate-limit-, load-balancing- en authenticatiecontrole in-memory uit, zonder externe hop op het request-pad, en verstuurt logs en metrics asynchroon via een NATS-wachtrij zodat een uitgevallen log-pipeline nooit een live request laat mislukken. De gepubliceerde benchmark is 350 RPS op 1 vCPU / 1 GB RAM met ~7 ms overhead bij 200 RPS, zelfs met tracing ingeschakeld. De gateway-plane is bovendien stateless en blijft verkeer afhandelen op basis van de laatst gesynchroniseerde configuratie als de control-plane kortstondig onbeschikbaar is — precies nuttig wanneer er een incident gaande is. TrueFoundry bundelt deze eigenschappen in truefailover™, een product voor storingsbestendigheid op de gateway dat multi-regio, multi-cloud en latency-aware routing toevoegt bovenop de bovenstaande multi-model failover.
Load balancing vervult twee taken: verkeer spreiden zodat geen enkele backend of sleutel de knelpunt wordt, en verkeer weghouden bij backends die ongezond zijn. De meest gebruikte strategieën zijn weighted round-robin (verdelen op basis van capaciteit), least-latency (voorkeur geven aan de snelste gezonde backend) en least-loaded (voorkeur geven aan degene met de minste in-flight requests).
Er is een belangrijk punt over doorvoer dat goed moet worden begrepen: speling komt voort uit onafhankelijke quotapools, niet uit extra sleutels. Afzonderlijke providers, deployments, regio's of afzonderlijk ingerichte projecten en accounts dragen elk hun eigen limieten, dus het verdelen van de belasting hierover voegt daadwerkelijk capaciteit toe. Wat niet werkt, is aannemen dat meer API-sleutels binnen dezelfde organisatie uw quota vermenigvuldigen — de meeste providers dwingen rate limits af op organisatie-, project- of modelfamilieniveau, dus sleutels onder één organisatie delen één pool. (OpenAI geeft bijvoorbeeld aan dat aanvullende sleutels onder dezelfde organisatie uw limieten niet verhogen, en sommige modelfamilies delen een pool.) De balancer moet routeren op basis van de werkelijke resterende capaciteit zoals gerapporteerd in de rate-limit headers van de provider, niet op basis van een aanname per sleutel. Health checks zijn er in twee varianten: actief (periodiek elke backend controleren) en passief (het werkelijke verkeer observeren en een backend als ongezond markeren wanneer het foutpercentage een drempelwaarde overschrijdt — wat circuit breaking is, de volgende sectie). Passief is goedkoper en weerspiegelt de omstandigheden die uw werkelijke requests ondervinden. Balancing over providers en sleutels heen is een kernfunctie van TrueFoundry's AI Gateway, wat de logische plek is om dit te doen omdat het al de sleutels beheert en de latency en foutpercentages per backend ziet die de balancer nodig heeft.
Wanneer een provider platligt, is het actief schadelijk om er verkeer naartoe te blijven sturen. Elke request wacht op een timeout voordat deze mislukt, die wachtende requests hopen zich op, uw wachtrijen lopen vol en de storing van de provider slaat door in uw eigen latency en uitputting van resources. Een circuit breaker stopt dit door snel te mislukken (fail fast).
Het is een kleine toestandsmachine. Gesloten is de normale werking. Nadat fouten een drempelwaarde overschrijden — een hoog foutpercentage binnen een tijdsbestek, of N opeenvolgende mislukkingen — slaat de breaker om naar open: requests naar die provider mislukken onmiddellijk (of slaan direct over naar de fallback) zonder te wachten op een timeout. Na een afkoelperiode schakelt deze over naar half-open en laat een enkele controle-request door; als de controle slaagt, sluit de breaker en wordt het normale verkeer hervat, en als deze mislukt, opent de breaker weer voor een nieuwe afkoelperiode. Het effect is dat een dode provider u één snelle afwijzing per request kost in plaats van één volledige timeout, wat het verschil is tussen een schone failover en een doorslaande vertraging.
Circuit breaker — stop met verzenden naar een provider die faalt
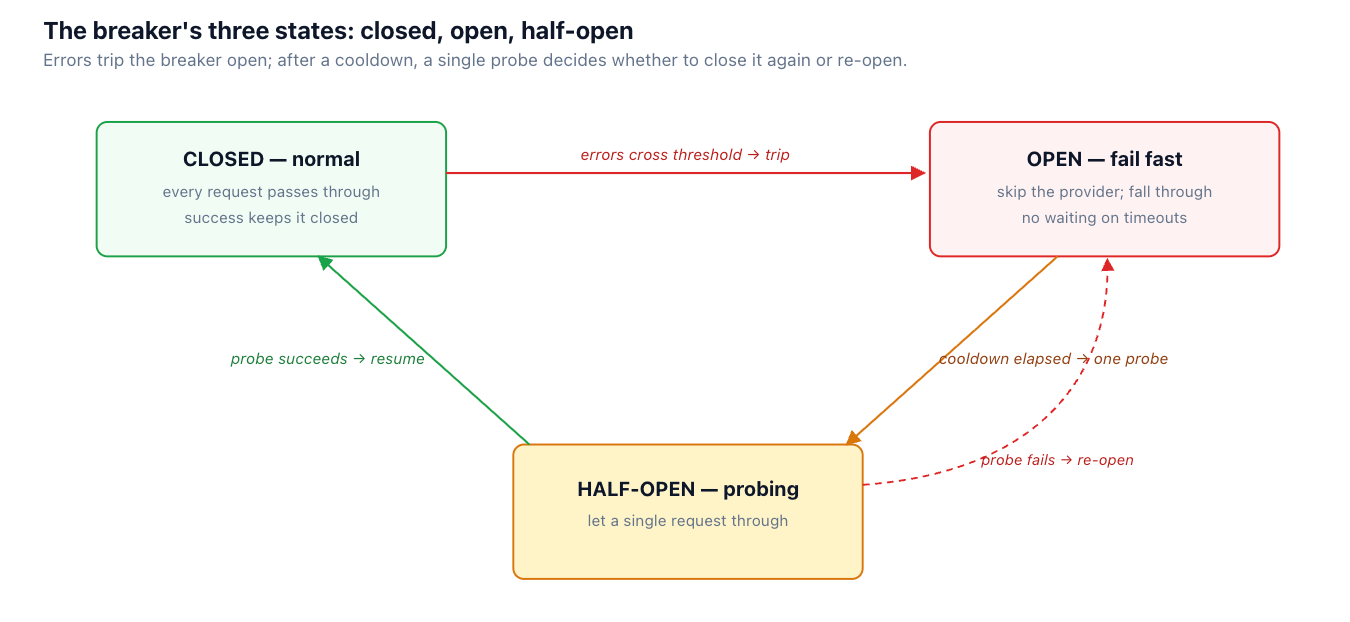
Zoals in het eerdere fallback-diagram staat de breaker van het primaire model open na een reeks 503-fouten, wat de reden is dat de request deze overslaat zonder te wachten. Health-aware routing bij TrueFoundry's AI Gateway past dit toe over providers heen, zodat een ongezonde backend bij de gateway wordt omzeild in plaats van request voor request opnieuw te worden ontdekt binnen elke dienst.
Sommige betrouwbaarheidsproblemen zijn geen storingen — het is de tail. De meeste requests zijn snel, maar p99 is traag omdat een paar ervan toevallig op een traag moment bij een provider terechtkomen. Hedging pakt de tail aan: stuur na een korte vertraging dezelfde request naar een tweede provider en gebruik de reactie die het eerst binnenkomt. De trage tail wordt afgesneden omdat u bij een specifieke aanroep niet langer overgeleverd bent aan de ppsite latency van één provider.
De kosten zijn reëel en moeten duidelijk worden vermeld: wanneer de hedge wordt geactiveerd, betaalt u voor twee aanroepen. Annuleer de verliezer zodra de winnaar retourneert, maar neem niet aan dat annulering het gratis maakt — afhankelijk van de provider en hoe ver de generatie is gevorderd, kan de geannuleerde aanroep nog steeds kosten in rekening brengen voor gedeeltelijke tokens, dus houd beide pogingen bij. De manier om dat betaalbaar te houden, is door de hedge pas te activeren na een vertraging die is afgestemd op uw latency-profiel — bijvoorbeeld rond de p95 — zodat u alleen de trage tail hedget en niet elke request. Twee kanttekeningen: hedging dupliceert eventuele bijwerkingen als de aanroep niet idempotent is (geen probleem voor zuivere completions, wel iets om over na te denken bij agents die tools aanroepen), en het voegt belasting toe aan providers, dus het is een hulpmiddel voor tail-latency, geen standaardinstelling. Hedging is van nature een gateway-aangelegenheid om dezelfde reden als load balancing — de gateway ziet al beide providers en kan de tweede aanroep starten en afhandelen — dus het hoort thuis als een beleid per route naast de fallback- en load-balancing-knoppen die TrueFoundry's AI Gateway al centraliseert, in plaats van als maatwerkcode per dienst.
Geen van deze instellingen heeft een universele waarde, maar hier zijn verdedigbare uitgangspunten om vanuit te finetunen — geen instellingen om blindelings te kopiëren:
Alles wat hierboven staat, gaat ervan uit dat u een request schoon kunt herhalen of omleiden. Streaming verbreekt die aanname. Als u al tweehonderd tokens naar de gebruiker hebt gestreamd en de stream valt weg, kunt u niet transparant van provider wisselen — de nieuwe provider begint vanaf het begin, dus u herstart ofwel de zichtbare output (storend) of u probeert de outputs van twee modellen aan elkaar te plakken (inconsistent). Er is geen schone universele oplossing.
De praktische opties zijn een reeks afwegingen. U kunt de stream aan de serverzijde bufferen en deze pas vrijgeven als deze compleet of gevalideerd is, wat failover schoon maakt, maar het voordeel in ervaren latency opoffert waarvoor u in de eerste plaats ging streamen. U kunt accepteren dat storingen halverwege de stream opnieuw starten en de UX zo ontwerpen dat dit wordt getolereerd. Of u kunt op kritieke paden controleren of de provider actief is met een niet-gestreamde eerste token voordat u zich vastlegt op een stream. Dit is dezelfde spanning die de streaming-discussie in de artikelen over context engineering en PII vanuit de andere richting naar voren bracht: streaming ruilt herstelbaarheid en controle achteraf in voor latency. Behandel streaming failover als een bewuste beslissing per pad, niet als een globale instelling — het juiste antwoord voor een interne batch-agent is anders dan dat voor een klantgerichte chat. Omdat die keuze per pad verschilt, hoort deze thuis waar de andere beleidsregels per route staan: het soort configuratie per route dat TrueFoundry's AI Gateway centraliseert, zodat een chatpad en een batchpad tegengestelde bufferkeuzes kunnen maken binnen één configuratie.
Fallback via verschillende providers of binnen dezelfde provider?
Beide, in deze volgorde. Fallback binnen dezelfde provider (alternatieve regio/deployment) is goedkoop en vangt gelokaliseerde problemen op, maar deelt hetzelfde failure domain, waardoor een providerbrede storing de gehele tier platlegt. Cross-provider biedt onafhankelijke failure domains en is wat je redt bij een storing zoals in het intro — ten koste van meer variatie in de output, aangezien je nu vanuit een ander model serveert. Een robuuste keten probeert meestal eerst een alternatieve deployment en schakelt daarna pas over naar een andere leverancier.
Verandert mijn output niet als ik overschakel op een ander model?
Ja — dat is de afweging in sectie 4. Failover koopt beschikbaarheid ten koste van getrouwheid, omdat het fallback-model anders formuleert, weigert en redeneert. Valideer fallback-outputs tegen hetzelfde schema als de primaire, vooral bij gestructureerde responsen, en houd prompts draagbaar zodat de fallback niet start met een prompt die alleen is afgestemd op het primaire model.
Hoeveel retries moet ik configureren?
Wenig — typisch twee of drie — met exponential backoff, jitter en respect voor Retry-After. Meer retries naar een provider die daadwerkelijk platligt, vertragen alleen maar de fallback die wel geslaagd zou zijn, en ze voegen belasting toe op precies het moment dat de provider het zwaar heeft. Het doel is om een korte hapering uit te zitten en daarna over te dragen, niet om een dode endpoint te blijven bestoken.
Moet ik elke request hedgen?
Nee. Alles hedgen verdubbelt je providerkosten en -belasting. Stuur de hedge pas uit na een vertraging die is afgesteld rond je p95, zodat deze zich richt op de trage tail, en alleen op paden waar tail latency er echt toe doet. Wees voorzichtig bij niet-idempotente calls — een hedge kan bijwerkingen dupliceren.
Moet dit in de app of in de gateway zitten?
De gateway. Deze ziet elke provider en sleutel, normaliseert de API zodat een fallback-target een andere leverancier kan zijn zonder app-wijzigingen, en kan één consistent beleid voor retries, fallbacks en circuit-breakers toepassen op alle services. Implementaties per service gaan afwijken en dupliceren dezelfde logica. De gateway traceert ook failover-events, waardoor "we zijn teruggevallen omdat de primaire open was" zichtbaar is in plaats van afgeleid — wat aansluit op het kosten- en observability-werk eerder in deze serie.
De storing van Nadia had geen betere provider nodig; het had een tweede provider nodig en een beleid om deze te gebruiken. Betrouwbaarheid voor LLM-verkeer is dezelfde discipline als voor elke andere afhankelijkheid — retries die de server respecteren, fallbacks over onafhankelijke failure domains, circuit-breakers die snel falen — toegepast op de laag die elke provider tegelijk ziet.
TrueFoundry's AI Gateway is een control plane op enterprise-niveau die tussen je applicaties en 1.600+ modellen staat — via OpenAI, Anthropic, Google, AWS Bedrock, Azure OpenAI en je eigen self-hosted modellen — achter één enkele OpenAI-compatibele API. Het zet de betrouwbaarheidspatronen uit dit artikel om in configuratie in plaats van code per service: fallback-ketens, gewogen en op latency gebaseerde load balancing, retries en health-aware routing, allemaal één keer gedefinieerd en toegepast op elke request.
Omdat de gateway de sleutels beheert, elke provider normaliseert en telemetrie voor kosten, latency, fouten en fallbacks per request vastlegt, is het de logische plek om failover zowel automatisch als observeerbaar te maken. Het kan worden geïmplementeerd als SaaS, in je VPC, on-prem of air-gapped, met ingebouwde RBAC, budgetten, rate limits en guardrails, en het voldoet aan SOC 2-, HIPAA- en ITAR-compliance — bovendien is het erkend in Gartner's Market Guide voor AI Gateways. Je kunt de betrouwbaarheidsfuncties verkennen in de documentatie over load-balancing en fallbacks of het AI Gateway-overzicht bekijken.
Northwind en Nadia zijn ter illustratie. De typologie van failure-modes en de patronen voor retries, fallbacks, load balancing en circuit-breakers zijn standaard reliability engineering toegepast op LLM-verkeer. Specifieke getallen — twee tot drie retries, hedgen rond p95 — zijn representatieve uitgangspunten, geen universele instellingen; stem ze af op je eigen verkeer, SLO's en providerlimieten. Rate-limit-speling komt voort uit onafhankelijke quotapools (afzonderlijke providers, projecten of accounts), niet uit extra sleutels onder één enkele organisatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox