



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
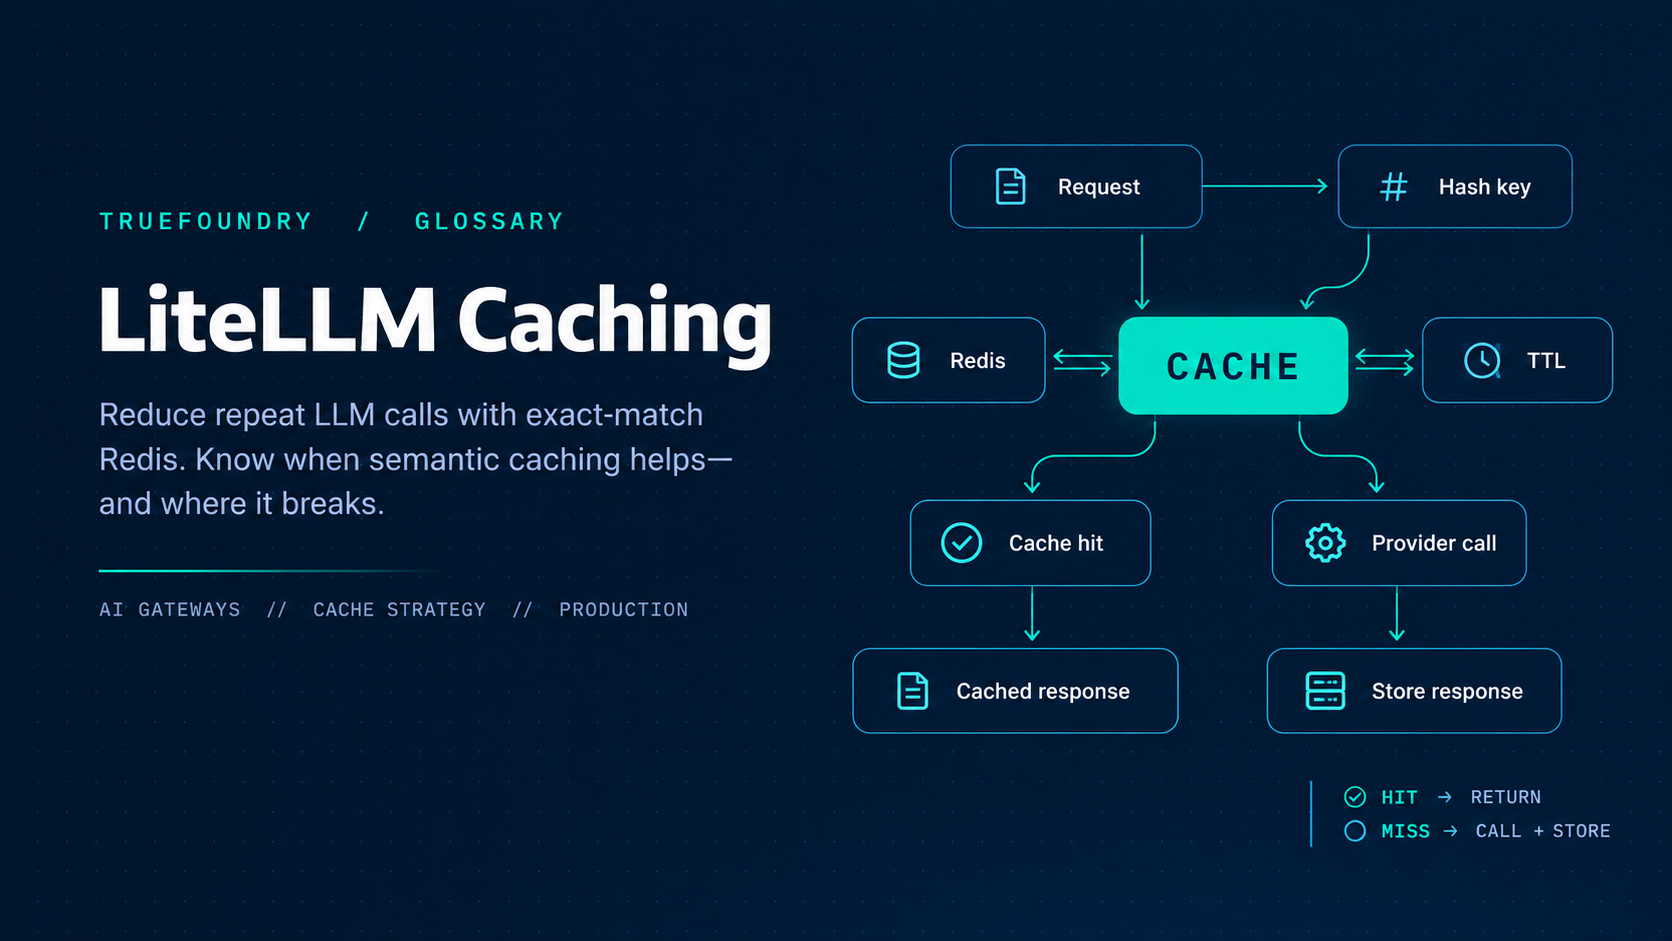
Een LiteLLM cache slaat LLM-antwoorden op, zodat een later identiek (of, in de semantische modus, vergelijkbaar) verzoek de provider-call kan overslaan. Dat verlaagt de latency en provider-kosten wanneer het verkeer repetitief is—en veroorzaakt fouten in de juistheid van gegevens wanneer dat niet zo is. Dit artikel behandelt exact-match caches (in-memory, Redis/Valkey, S3/GCS, disk), semantische caches (Redis, Valkey, Qdrant), TTL en keys, vereisten voor meerdere replica's, invalidatie en de failure modes waar platform engineers in productie tegenaan lopen. Opmerking over de reikwijdte: dit betreft de response-cache van LiteLLM op applicatieniveau, niet de prompt-caching aan de provider-zijde van OpenAI/Anthropic (een afzonderlijke functie met een eigen configuratie). Caching is een van de diverse instellingen die een LLM gateway toepast op het verzoekpad, naast authenticatie, rate limits en routing.
De officiële proxy caching documentatie vermeldt: redis (ook Valkey/ElastiCache/Memorystore via het Redis-protocol), redis-semantic, valkey-semantic, qdrant-semantic, s3, gcs, local (in-memory) en disk. Redis is de juiste standaardkeuze zodra u meer dan één worker gebruikt. Exact-match caches maken een key op basis van een hash van het gehele verzoek. Semantische caches embedden de prompt en serveren de dichtstbijzijnde overeenkomst boven een gelijkenisdrempel—geschikt voor single-shot prompts en ongeschikt voor agentic verkeer.
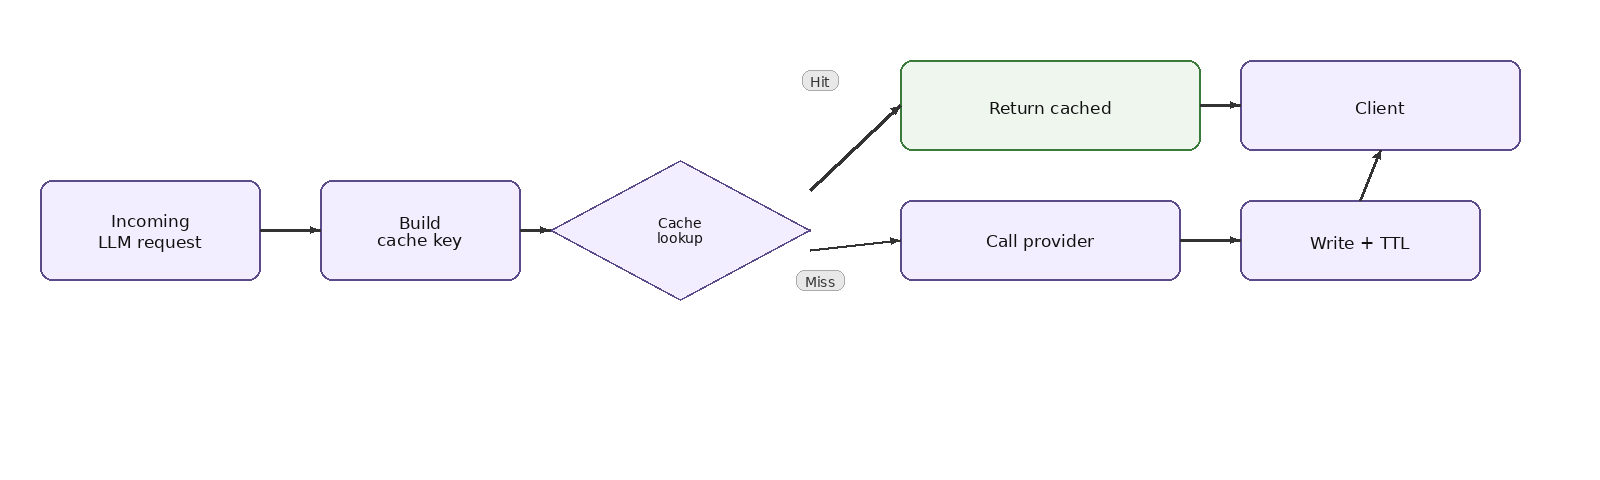
Bij een hit kunnen antwoorden een x-litellm-cache-key header bevatten, wat handig is voor debugging en voor /cache/delete. Met cache: True en geen ondersteunde supported_call_types override, is caching van toepassing op /chat/completions, /completions, /embeddings, /audio/transcriptions, /rerank, /v1/responses en /v1/messages (controleer dit in uw specifieke versie). Op /v1/responses maakt exact-match keys aan op basis van de request body—dus previous_response_id ten opzichte van een inlined conversatie levert verschillende keys op, en elke multi-turn stap is een eigen entry.
Minimale inschakeling (gebruikt standaard Redis wanneer inloggegevens aanwezig zijn):
Stel vervolgens REDIS_URL of REDIS_HOST / REDIS_PORT / REDIS_PASSWORD in, en bij voorkeur expliciet cache_params.type: redis. Debug met:
Een gezonde respons meldt cache_type, ping_response en redis client metadata. Gebruik dit in readiness checks voor multi-replica uitrol.
Laptop / single-process:
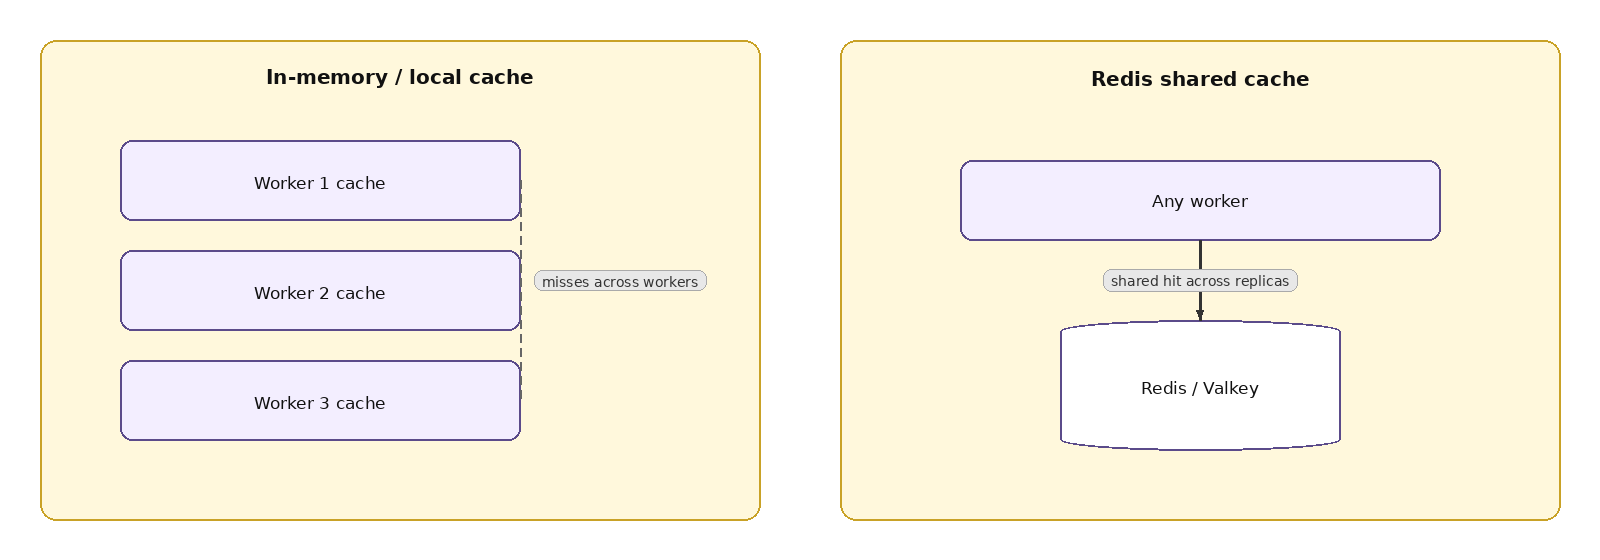
Schijf: type: disk met optionele disk_cache_dir. Geen van beide wordt gedeeld tussen workers of replica's—volgens de documentatie moet u deze gebruiken voor lokale ontwikkeling, niet voor productie.
Productie-voorbeeld voor Redis met TTL:
Vier workers zonder Redis betekent ongeveer vier onafhankelijke caches—de hit-rate daalt met ongeveer het aantal workers. Configureer ook router_settings Redis voor gedeelde RPM/TPM, cooldowns en routing-status. "What Needs Redis" behandelt rate limits, budgetcoördinatie, cache-invalidatie en pod-locks. REDIS_HOST alleen, zonder YAML-verwijzingen, zal het delen niet inschakelen.
ttl onder cache_params stelt de levensduur van de entry in seconden in. Per-verzoek cache-objectvelden: ttl, s-maxage (accepteer alleen entries jonger dan N seconden), no-cache (sla lezen over), no-store (sla schrijven over), namespace. Voeg dezelfde instellingen toe aan virtual-key metadata, zodat een bepaalde klasse verkeer zich kan afmelden zonder client-wijzigingen—een standaardpatroon voor agent-keys.
Beperk deelname met cache_params.supported_call_types (een lege lijst schakelt het uit). Standaard worden alleen standaard OpenAI-gevormde parameters opgenomen in de cache key; stel enable_caching_on_provider_specific_optional_params: True in als optionele velden in Vertex-stijl entries moeten onderscheiden. Er bestaan aangepaste get_cache_key-functies op het SDK Cache-object voor geavanceerde situaties—geef de voorkeur aan gedocumenteerde instellingen op de proxy voordat u aangepaste code gebruikt.
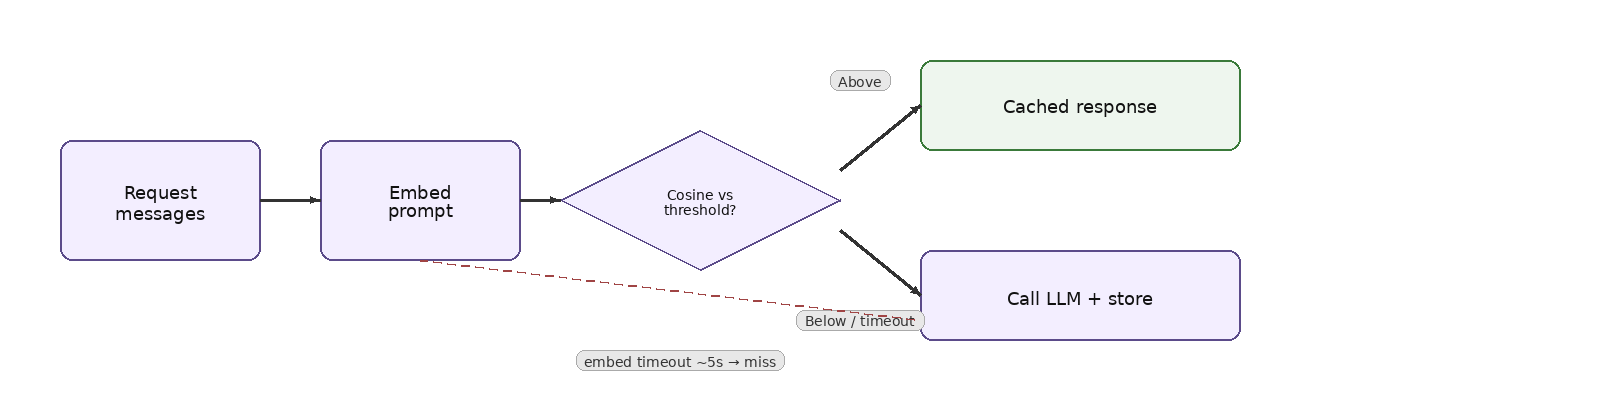
Een semantische cache embedt de prompt (inclusief berichten-tekst en systeemtekst) en serveert het dichtstbijzijnde gecachete antwoord waarvan de cosinus-similarity hoger is dan similarity_threshold. Backends: redis-semantic, valkey-semantic, qdrant-semantic. Configureer een embeddingmodel dat LiteLLM kan aanroepen—meestal een model_name uit de model_list. Hits kunnen x-litellm-semantic-similarity bevatten.
Voorbeeld van de structuur van Redis semantic:
Valkey semantic heeft de valkey-search module nodig (ElastiCache: op nodes gebaseerde Valkey 8.2+, cluster-mode-disabled wordt aanbevolen; Serverless en multi-shard cluster-mode-enabled worden vermeld als niet-ondersteund voor deze backend). Qdrant heeft een collectienaam nodig, een vectorgrootte die overeenkomt met de embedding-dimensionaliteit, en API-inloggegevens.
Embedding wordt inline uitgevoerd vóór de LLM. De standaard timeout is 5 seconden; daarna wordt de zoekopdracht afgebroken (similarity 0.0) en resulteert het verzoek in een miss. Stel semantic_cache_embedding_timeout of SEMANTIC_CACHE_EMBEDDING_TIMEOUT_SECONDS zorgvuldig in—een hogere deadline is ook de tijd die elk verzoek wacht wanneer embeddings blijven hangen.
semantic_cache_scope staat standaard op key (virtual key / team / org bucket). Stel in op end_user om te isoleren per geauthenticeerde eindgebruikers-ID (x-litellm-customer-id, geconfigureerde user_header_name, of request user). Anders kunnen vergelijkbare prompts op een gedeelde key antwoorden uitwisselen tussen eindgebruikers—inclusief tool-call payloads.
Exact-match Redis is de veilige standaardkeuze voor de meeste platform-gateways: voorspelbare keys, geen embedding-afhankelijkheid in het kritieke pad en een natuurlijke juistheid voor multi-turn verkeer omdat elke berichtwijziging leidt tot een miss. Semantic cache is een optimalisatie voor hoog-volume, geparafraseerde, single-shot workloads waarbij u een benaderend hergebruik accepteert. Schakel de semantische modus niet in "omdat het slimmer klinkt" op een gedeelde gateway die ook agents bedient—splits het verkeer met virtual-key metadata of gescheiden gateways als de functionaliteit beide vereist.
Helpt:
Schaadt of is risicovol:
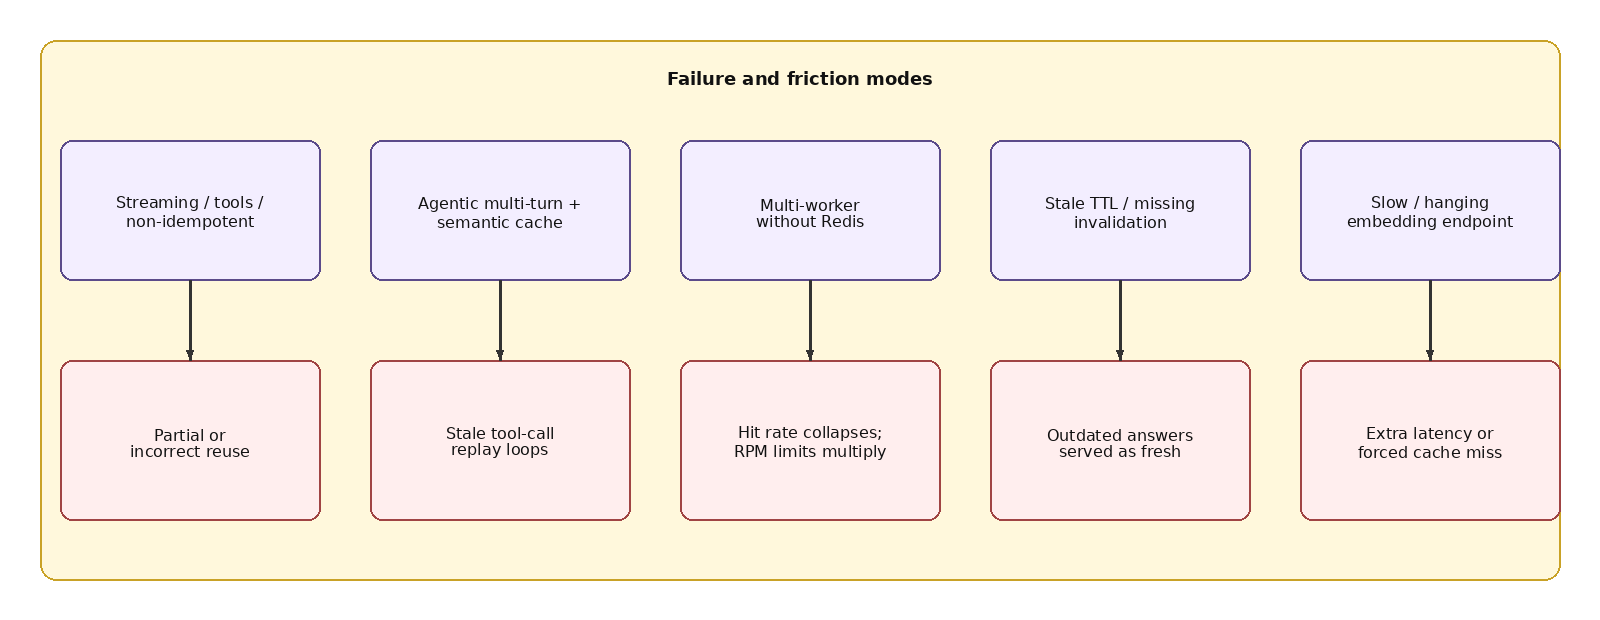
De officiële documentatie over semantic-caching is duidelijk: ontworpen voor single-shot prompts; bij multi-turn of agentic verkeer worden verouderde antwoorden opnieuw afgespeeld. Elke nieuwe beurt is de vorige tekst plus een kleine wijziging, waardoor embeddings ~0.99 vergelijkbaar blijven; bij praktische drempelwaarden komt elke beurt overeen met de vorige entry. Het verhogen van similarity_threshold lost dit niet betrouwbaar op. Assistant tool_calls maken geen deel uit van de ingebedde tekst, wat het nog moeilijker maakt om opeenvolgende agent-beurten van elkaar te onderscheiden—symptomen zijn onder meer agents die dezelfde tool-call blijven herhalen.
Oplossingen uit die documentatie: bewaar semantic caching voor single-shot verkeer; sluit agentic verkeer uit met key metadata cache.no-cache true, of mode default_off, of per-verzoek instellingen. Als agents toch caching nodig hebben, gebruik dan exact-match type: redis zodat elke conversatiewijziging netjes tot een miss leidt.
TTL is het grove middel. Namespaces scheiden omgevingen of tenants. no-store / no-cache onderdrukken schrijven/lezen. /cache/ping verifieert de backend. Bij hits kan x-litellm-cache-key gegevens leveren aan /cache/delete voor gerichte invalidatie—controleer de delete API op uw versie voordat u dit automatiseert. Success callbacks kunnen kwargs["cache_hit"] uitlezen voor metrics-pipelines. Houd de hit-rate, embedding latency (semantic), Redis-fouten (geen verbinding beschikbaar → verhoog max_connections) en de juistheid van antwoorden bij na configuratiewijzigingen.
Meer dan één worker-proces of replica ⇒ Redis (of compatibel) voor een coherente cache en voor gedeelde rate limits / router-status. Semantische backends hebben een gezonde vector store nodig op elk verzoekpad. Productie-documentatie gebruikt Redis ook voor de spend transaction buffer bij zeer hoge QPS (~1000+ RPS of 10+ instanties)—dit staat naast caching, maar heeft hetzelfde thema van gedeelde status. Optionele enable_redis_auth_cache spiegelt virtual-key authenticatie naar Redis zodat replica's auth-entries delen; combineer met general_settings.user_api_key_cache_ttl (standaard 60s) zodat intrekkingen synchroon lopen.
LiteLLM kan de coördinatie naar een andere Redis richten dan de response-cache via general_settings.coordination_redis. Als u ze scheidt, dimensioneer en monitor ze dan allebei. Als u één cluster behoudt, configureer dan nog steeds zowel router_settings als litellm_settings.cache_params—omgevingsvariabelen alleen koppelen niet elk subsysteem. Cluster/Sentinel/IAM-topologieën zijn gedocumenteerd op de Redis- en Valkey-pagina's. De cache client timeout per commando is cache_params.socket_timeout (standaard 5s), wat verschilt van REDIS_SOCKET_TIMEOUT.
Begin met exact-match Redis, een conservatieve TTL en caching die beperkt is tot bekende veilige call-types. Sluit agent virtual keys uit via metadata. Introduceer semantic cache alleen voor duidelijk single-shot workloads met een geteste similarity-drempelwaarde, embedding SLO's binnen het timeout-budget en een end_user scope als keys worden gedeeld. Load-test de hit-rate met uw werkelijke prompt-distributie—synthetische identieke grappen in demo's overschatten de besparingen. Baseer elke wijziging op /cache/ping, response headers en spend dashboards in plaats van op hoop. Combineer cache-metrics met LLM cost tracking zodat besparingen per team en model worden gemeten en niet zomaar worden aangenomen.
LiteLLM caching kan de latency en de provider-kosten aanzienlijk verlagen—wanneer het verkeer werkelijk repetitief is en de cache wordt gedeeld via Redis. Begin met exact-match Redis en een conservatieve TTL, beperk semantic caching tot single-shot workloads en houd agents buiten de deur.
Voor een gateway die caching samenbrengt met routing, rate limits en observabiliteit binnen uw eigen infrastructuur, ontdek hoe de AI Gateway van TrueFoundry dit aanpakt →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



LiteLLM cache is the response cache built into the LiteLLM proxy and SDK: it stores LLM responses so a later identical request—or a similar one in semantic mode—skips the provider call. You enable it with litellm_settings.cache: true and choose a backend in cache_params (local, disk, redis, s3, gcs, or a semantic backend). It cuts latency and provider spend on repetitive traffic, and it is separate from provider-side prompt caching.
Use the in-memory (local) or disk cache only for local development or a single process, because neither is shared between workers or replicas. Use Redis—or a Redis-protocol service such as Valkey, ElastiCache, or Memorystore—as soon as you run more than one worker or pod. Four workers with local caches behave like four separate caches, and hit rates drop roughly by the worker count.
Semantic cache is designed for single-shot prompts; on multi-turn traffic it replays stale responses. Each new turn is the previous conversation plus a small delta, so embeddings stay around 0.99 similar, and assistant tool_calls are not part of the embedded text—agents end up repeating the same tool call. Raising similarity_threshold does not reliably fix it; exclude agent keys with "cache": {"no-cache": true} metadata or use exact-match type: redis.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Elk verzoek wordt getraceerd van prompt tot modeluitvoering, zodat metrics zoals latentie, kosten en fouten naast uw bestaande dashboards terechtkomen.



Het laatste nieuws, artikelen en bronnen in je inbox



















