



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large language models hebben een belangrijke drempel overschreden. Wat begon als geïsoleerde experimenten en pilotprojecten is nu geëvolueerd tot productie-workloads die diep verankerd zijn in enterprise-systemen. Klantenservice, interne kenniszoekopdrachten, softwareontwikkeling, analytics en autonome agents vertrouwen in toenemende mate op LLMs als kernbouwstenen in plaats van optionele uitbreidingen.
Deze verschuiving heeft een nieuwe categorie infrastructuuruitdagingen blootgelegd. LLM workloads gedragen zich heel anders dan traditionele applicatiediensten. Kosten schalen met tokens in plaats van requests, de latency varieert aanzienlijk tussen providers en regio's, en failure modes - zoals timeouts, hallucinaties of gedeeltelijke antwoorden - zijn vaak ondoorzichtig. Naarmate organisaties meerdere modellen van verschillende providers omarmen, stapelen deze problemen zich snel op.
Voor de meeste ondernemingen werden vroege LLM-integraties gebouwd met directe API-calls en logica op applicatieniveau. Die aanpak houdt geen stand op schaal. Teams lopen snel tegen onvoorspelbare inference-kosten aan, beperkt zicht op het gebruik, provider lock-in en toenemende governance-zorgen. Het optimaliseren van LLM workloads wordt steeds moeilijker wanneer elke applicatie zijn eigen routing, retries, kostenbeheersing en logging implementeert.
Naarmate de adoptie van AI horizontaal groeit over teams heen en verticaal over omgevingen, verschuift LLM workload optimalisatie van een applicatieprobleem naar een infrastructuurprobleem. Ondernemingen hebben een gecentraliseerde laag nodig die consistent en op schaal kan observeren, beheren en optimaliseren hoe modellen worden gebruikt. Deze behoefte heeft geleid tot de opkomst van AI gateways als een fundamenteel onderdeel van moderne AI-infrastructuur.
Het optimaliseren van LLM workloads is fundamenteel anders dan het optimaliseren van traditionele compute of microservices. De uitdagingen zijn systeemomvattend, niet lokaal.
Ten eerste zijn kostendynamieken niet-lineair. Een kleine verandering in promptstructuur, retry-logica of contextgrootte kan het tokenverbruik en de uitgaven aanzienlijk verhogen. Zonder gecentraliseerde zichtbaarheid en een gestructureerde LLM cost tracking solution blijven deze veranderingen vaak onopgemerkt totdat de kosten omhoogschieten. Besturingselementen op applicatieniveau missen de globale context die nodig is om budgetten af te dwingen of efficiëntie te vergelijken tussen teams en use cases.
Ten tweede is prestatievariabiliteit inherent. Dit wordt nog zichtbaarder tijdens LLM inferencing, waar latency en throughput verschillen per model, provider en regio, en fluctueren op basis van belasting en beschikbaarheid. Het hardcoden van een enkele provider of model in een applicatie creëert kwetsbaarheid. Wanneer er storingen of rate limits optreden, worden teams gedwongen tot reactieve oplossingen in plaats van proactieve optimalisatie.
Ten derde brengt de adoptie van meerdere modellen operationele complexiteit met zich mee. Ondernemingen gebruiken steeds vaker een mix van premium modellen voor kritieke workflows en goedkopere modellen voor taken met een hoog volume of niet-kritieke taken. Om deze mix efficiënt te beheren, zijn routingbeslissingen nodig die kosten, kwaliteit en latency in evenwicht brengen - beslissingen die niet in de applicatiecode horen te zitten.
Ten slotte blijft de druk op governance en compliance toenemen. Organisaties moeten toegangscontroles afdwingen, het gebruik monitoren, auditlogs bijhouden en dataresidentie garanderen over verschillende regio's. Deze vereisten gelden voor elke AI-workload en kunnen niet effectief per applicatie afzonderlijk worden aangepakt.
Samen maken deze factoren duidelijk dat LLM workload optimalisatie niet versnipperd kan worden opgelost. Het vereist een gecentraliseerde controlelaag die zicht heeft op al het AI-verkeer en de bevoegdheid heeft om beleid consistent af te dwingen.
AI gateways spelen in op deze uitdaging door te fungeren als het control plane voor LLM workloads. Geplaatst tussen applicaties en modelproviders, centraliseert een AI gateway hoe LLM-requests worden gerouteerd, geobserveerd, beheerd en geoptimaliseerd.
In tegenstelling tot traditionele API gateways zijn AI gateways specifiek gebouwd voor de kenmerken van LLM workloads. Ze begrijpen modelspecifiek gedrag, op tokens gebaseerde prijzen, latency-afwegingen en de noodzaak van gedetailleerde observabiliteit. Hierdoor kunnen optimalisatiestrategieën één keer op de infrastructuurlaag worden geïmplementeerd en uniform worden toegepast op alle applicaties.
Op hoofdlijnen maken AI gateways LLM workload optimalisatie mogelijk door:
Deze architectonische aanpak ontkoppelt applicatielogica van modelbeheer. Ontwikkelaars richten zich op het bouwen van AI-gestuurde functionaliteiten, terwijl platformteams de controle behouden over prestaties, kosten en risico's.
Naarmate ondernemingen hun gebruik van LLMs opschalen, wordt deze scheiding cruciaal. Zonder dit zijn optimalisatie-inspanningen versnipperd, reactief en moeilijk vol te houden. Met deze scheiding krijgen organisaties een consistente, meetbare en herhaalbare manier om LLM-workloads efficiënt uit te voeren, ongeacht het aantal betrokken modellen, teams of applicaties.
Naarmate organisaties volwassener worden in hun gebruik van LLMs, worden optimalisatiestrategieën systematische en meer infrastructuurgedreven. Tegen 2026 worden verschillende patronen de standaardpraktijk onder ondernemingen die LLM-workloads op schaal uitvoeren.
In plaats van modelselectie te behandelen als een vaste keuze, stappen ondernemingen over op kostenbewuste orchestratie. In dit model balanceren AI-gateways dynamisch kosten, kwaliteit en latency op basis van de context van elk verzoek.
Bijvoorbeeld:
Deze aanpak stelt organisaties in staat om uitgaven te optimaliseren zonder de gebruikerservaring in gevaar te brengen. Na verloop van tijd creëert het ook een feedbackloop waarin echte gebruiksgegevens zorgen voor betere orchestratiebeslissingen.
Wettelijke vereisten en geopolitieke realiteiten veranderen de manier waarop AI-systemen worden ingezet. Ondernemingen werken steeds vaker met geogepartitioneerde AI-stacks, waarbij LLM-workloads per regio worden geïsoleerd om te voldoen aan vereisten op het gebied van dataresidentie, soevereiniteit en compliance.
In de praktijk betekent dit:
AI-gateways spelen een centrale rol bij het afdwingen van deze beperkingen, terwijl ze toch een uniform operationeel model bieden over regio's heen.
Naarmate het gebruik van LLMs schaalt, stappen organisaties af van het herhaaldelijk verzenden van grote contexten naar modellen. In plaats daarvan stappen ze over op tool-gedreven AI-systemen, waarbij modellen op verzoek informatie ophalen via gecontroleerde interfaces.
Deze verschuiving:
AI-gateways bemiddelen steeds vaker niet alleen bij model calls, maar ook bij het uitvoeren van tools en APIs, wat ervoor zorgt dat AI-systemen op een gecontroleerde, auditeerbare manier interactie hebben met bedrijfsdata.
De opkomst van autonome en semi-autonome agents brengt nieuwe optimalisatie-uitdagingen met zich mee. Agents voeren vaak meerdere model calls uit, roepen tools aan en voeren langlopende workflows uit.
Toonaangevende organisaties breiden optimalisatiestrategieën uit naar de agent-laag door:
AI-gateways ontwikkelen zich om deze verschuiving te ondersteunen en fungeren als een bemiddelingslaag voor zowel model inference als de uitvoering van agents.
Belangrijkste statistieken voor het evalueren van een Gateway
| Criteria | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must have | ✅ Ondersteund |
| Dataresidentie | Behoudt logs binnen uw regio (EU/VS)? | Afhankelijk van use case | ✅ Ondersteund |
| Latency-based routing | Herrouteert automatisch op basis van realtime latency/storingen? | Must have | ✅ Ondersteund |
| Sleutelrotatie & intrekking | Sleutels roteren of intrekken zonder downtime? | Must have | ✅ Ondersteund |
| Sleutelrotatie & intrekking | Sleutels roteren or intrekken zonder downtime? | Must have | ✅ Ondersteund |
| Sleutelrotatie & intrekking | Sleutels roteren of intrekken zonder downtime? | Must have | ✅ Ondersteund |
| Sleutelrotatie & intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

Het kiezen van een AI gateway is geen beslissing over tooling—het is een infrastructuurcommitment. Voor de meeste ondernemingen bevindt deze laag zich in het kritieke pad van elke door LLM aangedreven applicatie, waardoor de gemaakte ontwerpkeuzes later moeilijk terug te draaien zijn. Evaluatie moet daarom minder gericht zijn op functies aan de oppervlakte en meer op architecturale geschiktheid, operationele volwassenheid en flexibiliteit op de lange termijn.
Hieronder vindt u een praktisch kader dat technische leiders kunnen gebruiken om AI gateways specifiek te evalueren vanuit het perspectief van LLM workload-optimalisatie.
Een toonaangevende AI gateway moet echt multi-modelgebruik mogelijk maken zonder applicaties te dwingen te veranderen wanneer modellen of providers veranderen.
Belangrijke vragen om te stellen:
Als de modelkeuze doorsijpelt in de applicatielogica, zal optimalisatie traag en kwetsbaar zijn.
LLM-optimalisatie is onmogelijk zonder kosteninzicht. Gateways moeten inzicht en handhaving bieden op het niveau waar beslissingen worden genomen.
Let op:
Een gateway die alleen geaggregeerd gebruik rapporteert, is onvoldoende voor echte optimalisatie.
Omdat de gateway zich in het kritieke pad bevindt, zijn de prestatie-eigenschappen van groot belang.
Evalueer:
Zelfs een kleine prestatieboete kan op schaal opbouwen.
Optimalisatie hangt af van feedbacklussen. De gateway moet fungeren als het 'system of record' voor LLM-activiteit.
Beoordeel of de gateway het volgende biedt:
Als observability achteraf toegevoegd voelt, zal optimalisatie eerder reactief dan systematisch zijn.
Optimalisatie moet samengaan met de risicobeheersing van de onderneming.
Belangrijke overwegingen zijn onder meer:
Een gateway die compromissen vereist tussen optimalisatie en compliance zal niet schalen in gereguleerde omgevingen.
Evalueer ten slotte hoe de gateway past in uw bestaande infrastructuur en operationele model.
Overweeg:
Hoe strakker de gateway integreert met uw platformstack, hoe gemakkelijker het zal zijn om op lange termijn te beheren.
De architectuur van TrueFoundry is gebouwd rond een duidelijke veronderstelling: LLM workload-optimalisatie is een infrastructuurvraagstuk, geen verantwoordelijkheid van de applicatie. Als gevolg hiervan is de AI Gateway ontworpen als een eersteklas control plane die centraal staat in de enterprise AI stack.
In een TrueFoundry-implementatie communiceren applicaties en agents nooit rechtstreeks met modelproviders. In plaats daarvan stroomt al het LLM-verkeer via de AI Gateway, die fungeert als een enkele, stabiele interface voor inference, routing, observability en governance.
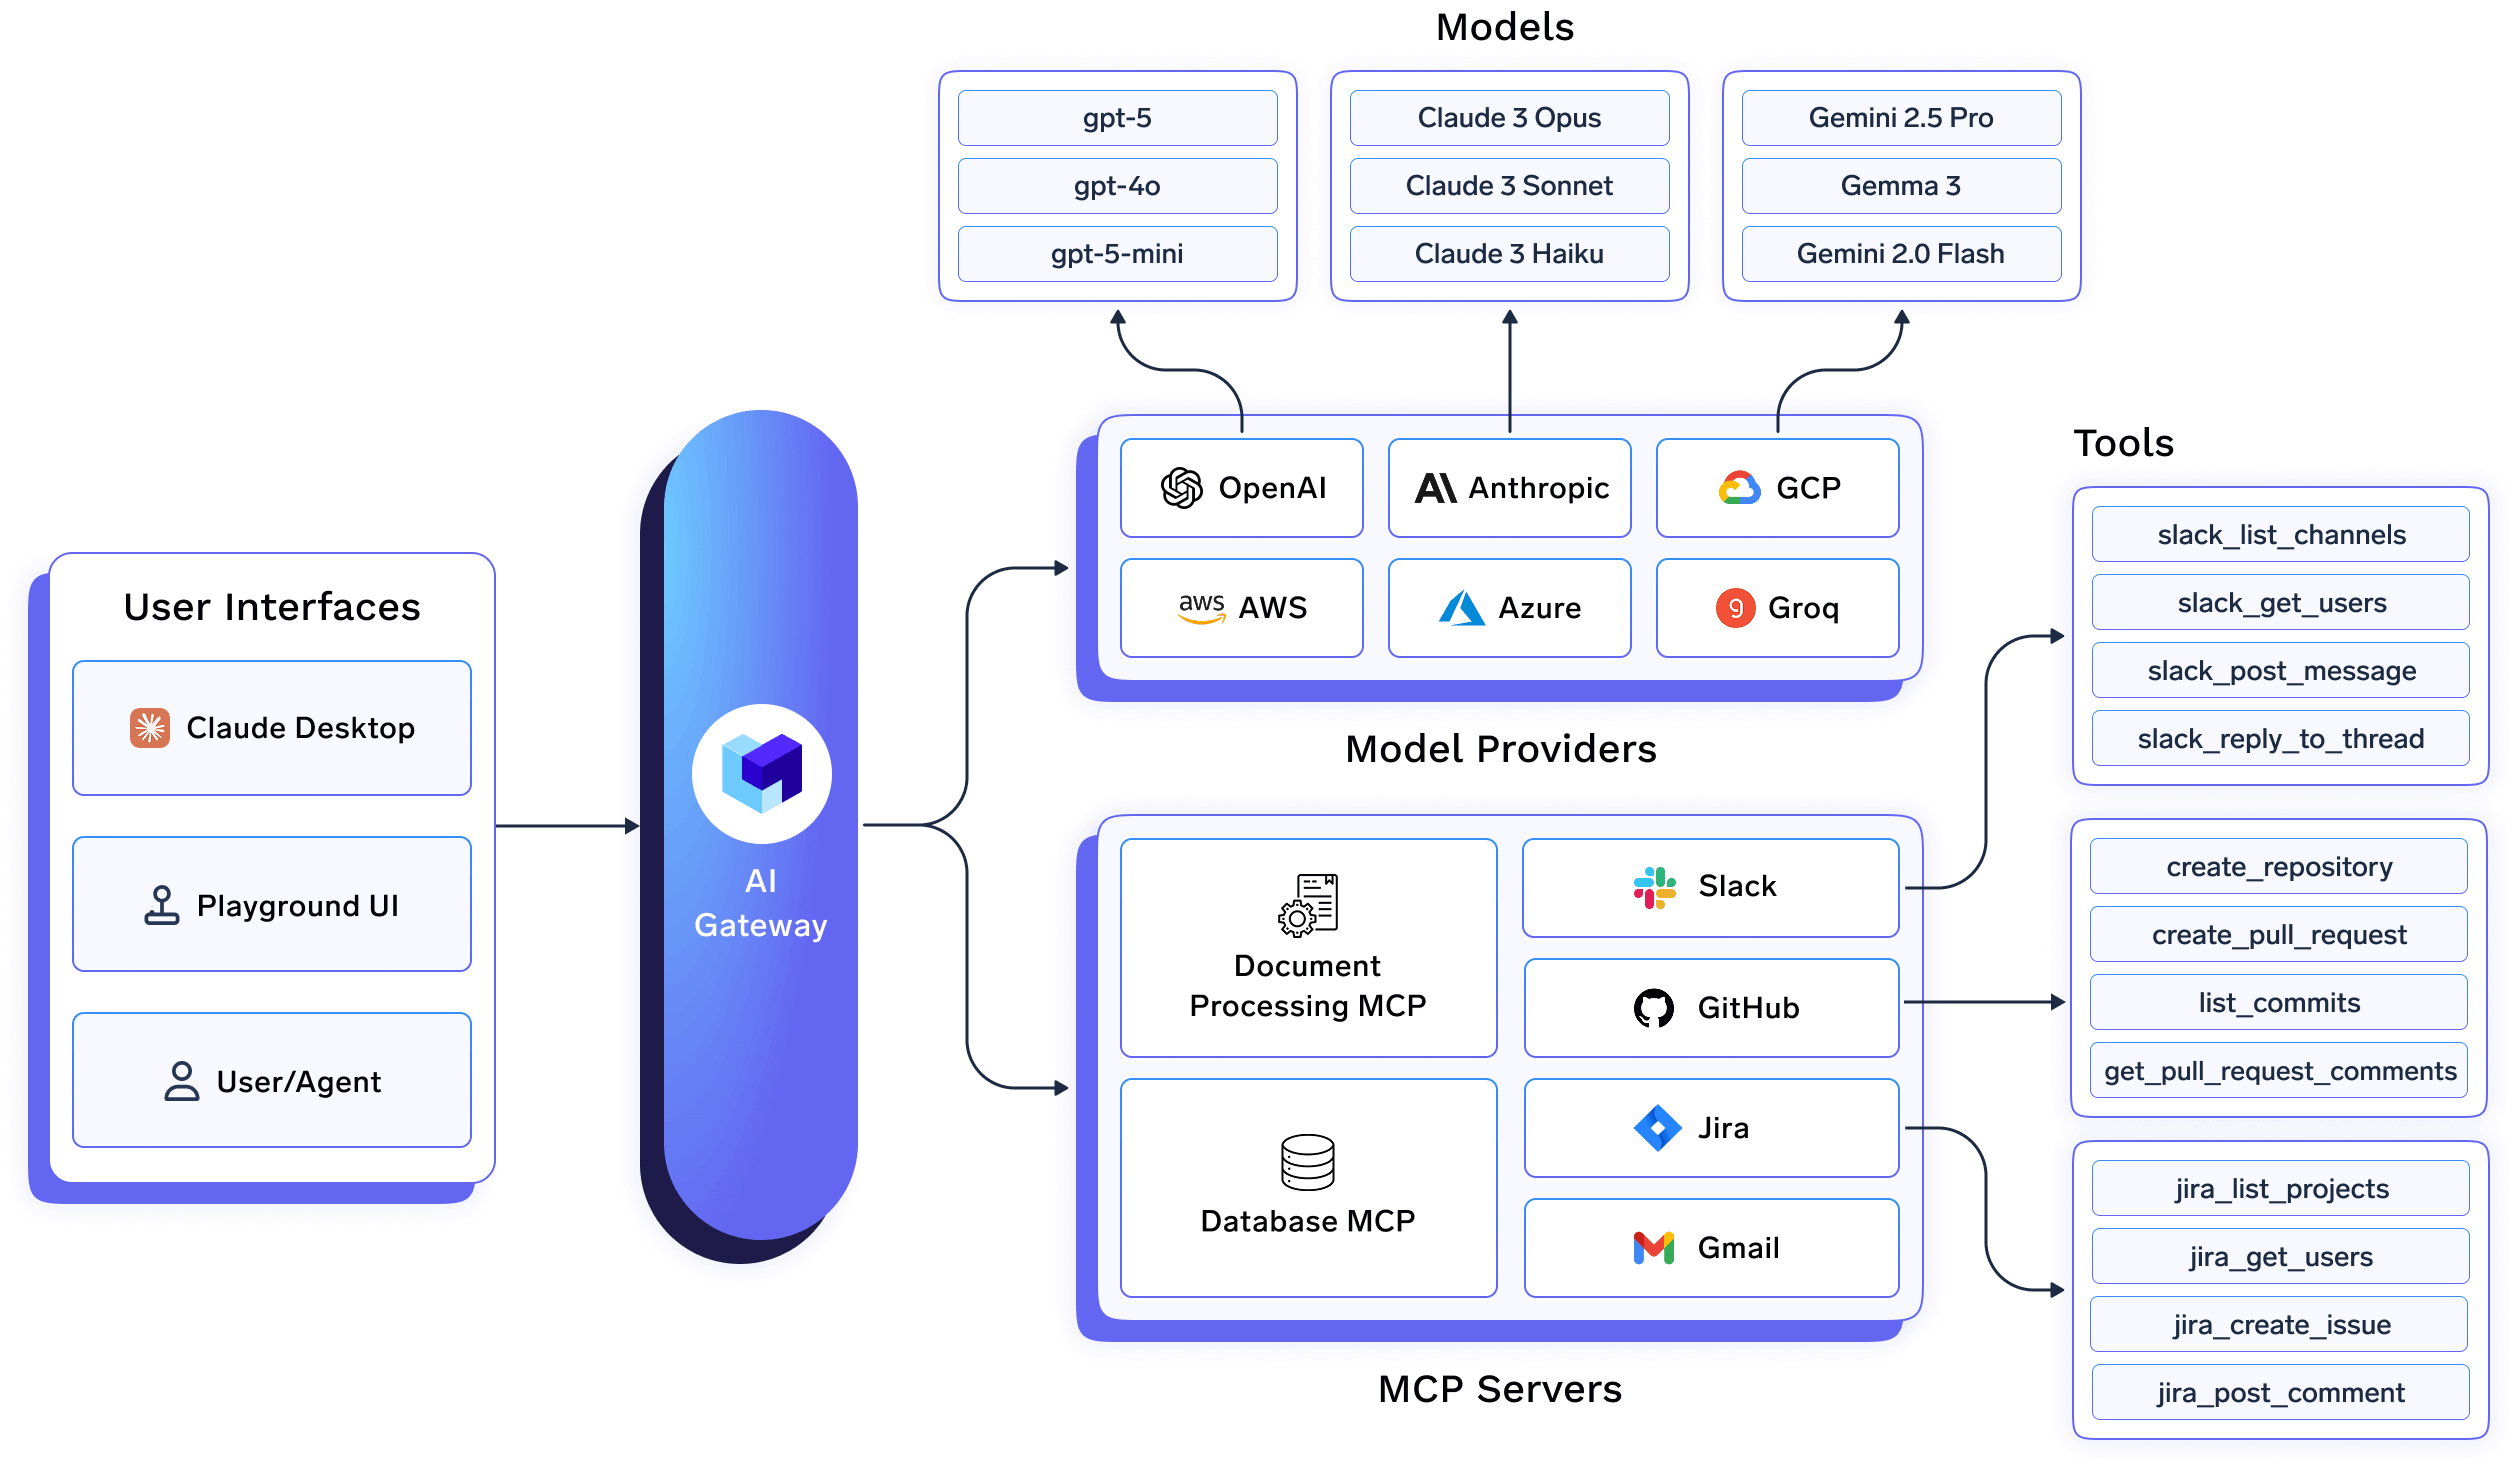
Op architectuurniveau betekent dit:
Dit ontwerp verwijdert modelspecifieke zaken uit de applicatiecode en zorgt ervoor dat optimalisatiestrategieën zich onafhankelijk kunnen ontwikkelen.
TrueFoundry’s AI Gateway maakt echt multi-modelgebruik mogelijk door provider-specifieke API's te abstraheren achter één enkel contract. Routingbeslissingen, zoals welk model te gebruiken, wanneer terug te vallen (fallback), of hoe kosten versus latency gebalanceerd moeten worden, worden gecentraliseerd op de gateway afgehandeld.
In de praktijk stelt dit platformteams in staat om:
Omdat routing op de gateway wordt afgehandeld, kunnen wijzigingen in prijzen, prestaties of beschikbaarheid van providers direct worden opgevangen, in plaats van dat hiervoor wijzigingen op applicatieniveau nodig zijn.
Een kernprincipe van de architectuur van TrueFoundry is dat de AI Gateway fungeert als het system of record voor alle LLM-activiteit. Elk verzoek dat via de gateway passeert, wordt vastgelegd met gedetailleerde metadata, waaronder modelselectie, tokengebruik, latency en verzoekcontext.
In tegenstelling tot veel platforms die deze gegevens centraliseren in door de leverancier beheerde systemen, zorgt het ontwerp van TrueFoundry ervoor dat:
Deze aanpak vermijdt het "black box"-probleem en stelt organisaties in staat om optimalisatiefeedbacklussen op de lange termijn te bouwen met hun eigen data.
TrueFoundry’s AI Gateway integreert kosten- en governancecontroles rechtstreeks in het verzoekpad. In plaats van te vertrouwen op achteraf gegenereerde facturatie-rapporten of externe tooling, vinden optimalisatie en handhaving in real-time plaats.
Belangrijke architecturale mogelijkheden zijn onder meer:
Omdat deze controles gecentraliseerd zijn, erft elke door LLM aangedreven applicatie ze automatisch. Dit maakt het mogelijk om AI-gebruik over teams heen te schalen zonder governancelogica te dupliceren.
TrueFoundry’s AI Gateway is ontworpen om te worden geïmplementeerd waar enterprise data zich al bevindt. Het kan draaien in private VPC's, on-prem omgevingen of gecontroleerde cloudregio's, waardoor organisaties kunnen voldoen aan strenge data residency- en regelgevingsvereisten.
Architecturaal ondersteunt dit:
Dit ontwerp sluit aan bij ondernemingen die in meerdere jurisdicties actief zijn, waar datastromen strikt moeten worden gecontroleerd.
TrueFoundry’s gateway-gerichte architectuur sluit ook aan bij de verschuiving naar agent-gebaseerde AI-systemen. Naarmate agents steeds vaker meerstaps-workflows orchestreren en tools of API's aanroepen, wordt de gateway het natuurlijke handhavingspunt.
Binnen dit model kan de AI Gateway:
Dit positioneert de gateway niet alleen als een inference-laag, maar als een breder uitvoeringsbeheerplatform (control plane) voor intelligente systemen.
Het bepalende kenmerk van de aanpak van TrueFoundry is dat optimalisatie, governance en observability eenmalig worden geïmplementeerd op de infrastructuurlaag en overal worden hergebruikt. Dit vermindert de operationele complexiteit, verbetert de consistentie en stelt organisaties in staat om LLM workloads te schalen zonder de controle te verliezen.
De bredere conclusie is dat TrueFoundry’s AI Gateway niet wordt gepositioneerd als een toevoeging achteraf, maar als kernelement van de AI-infrastructuur. Door de gateway te behandelen als een duurzame architecturale laag, sluit TrueFoundry aan bij de manier waarop ondernemingen al denken over kritieke systemen zoals API gateways, dataplatforms en compute-orchestratie.
Naarmate de adoptie van LLM's schaalt, is optimalisatie geen kwestie meer van prompt tuning of modelselectie—het is een infrastructuurbeslissing. Volatiliteit in kosten, prestatievariatie en governance-eisen vragen om een gecentraliseerde controlelaag die kan opereren over modellen, teams en applicaties heen.
AI gateways zijn naar voren gekomen als die laag. Door routing, observability, kostenbeheersing en beleidshandhaving te consolideren, maken ze van LLM-optimalisatie een systematische capaciteit in plaats van een voortdurende operationele last.
Platformen zoals TrueFoundry weerspiegelen deze verschuiving door de AI Gateway te behandelen als een essentieel onderdeel van de AI-infrastructuur voor bedrijven. Voor technische leiders is de boodschap helder: duurzame LLM-schaalbaarheid hangt minder af van het kiezen van het juiste model, en meer van het bouwen van het juiste fundament om ze uit te voeren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















