



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu de reeks use cases voor machine learning de afgelopen jaren sterk is uitgebreid, is de noodzaak om de operaties rond het trainen, deployen en monitoren van deze modellen te schalen ook heel belangrijk geworden. Veel van deze uitdagingen zijn vergelijkbaar met de problemen die zijn "opgelost" voor algemene software-use-cases. Kubernetes is een van die open-source softwareproducten die het cloud native ecosysteem om zich heen heeft geconsolideerd door te dienen als het onderliggende platform.
Daarom is het essentieel om te onderzoeken of het nuttig is om Kubernetes in te zetten voor een machine learning use case. Laten we eerst beginnen met Kubernetes zelf en wat er zo interessant aan is.
Bron: Kubernetes
💡 Kubernetes is een open-source container-orchestratie-engine voor het automatiseren van deployment, schalen en beheer van gecontaineriseerde applicaties.
In eenvoudigere termen biedt Kubernetes een simpele en gestandaardiseerde manier om workloads uit te voeren en te beheren die dynamisch moeten worden geschaald over meerdere machines.
Laten we een aantal van de meest populaire functies doornemen -
Dit zijn slechts enkele van de functies die standaard beschikbaar zijn. Een groot aantal use cases wordt daadwerkelijk opgelost door de tooling die is gebouwd met Kubernetes als onderliggende laag. In een volgend artikel gaan we dieper in op specifieke tools.
Met het inzicht in wat Kubernetes is en wat de belangrijkste functies zijn die het biedt in een software-ontwikkelingsscenario, gaan we nu dieper in op de specifieke problemen die het kan oplossen in de workflow van een data scientist.
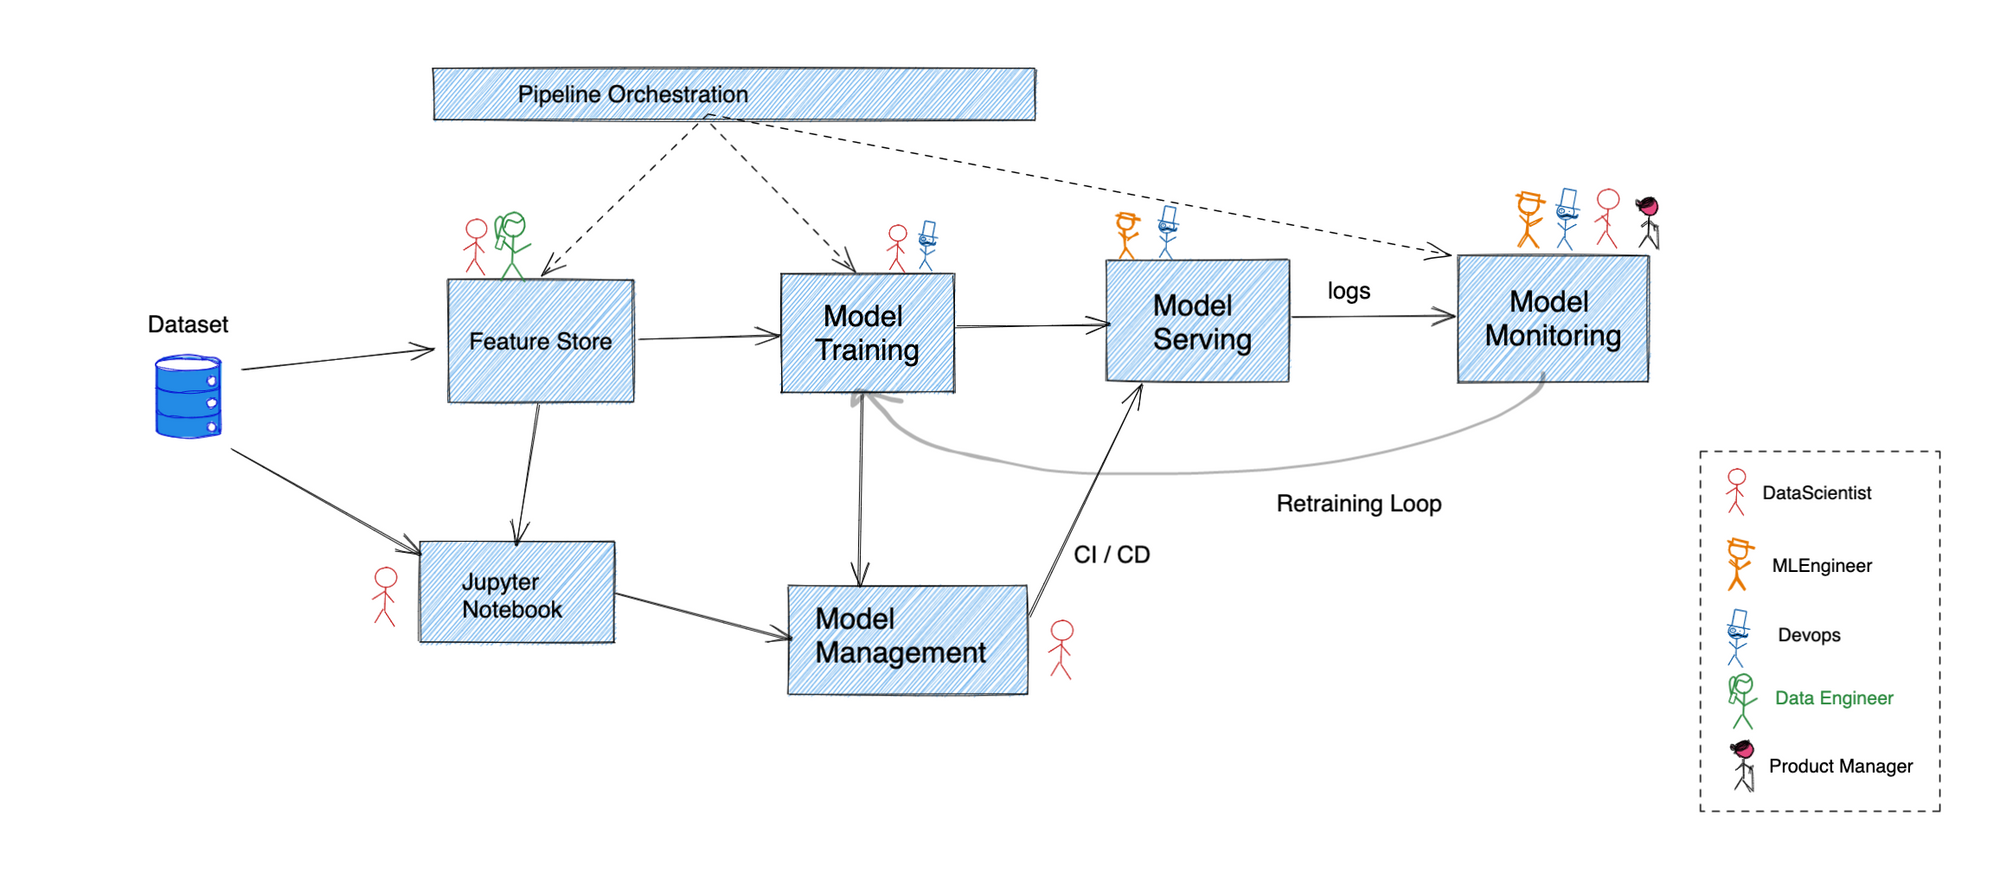
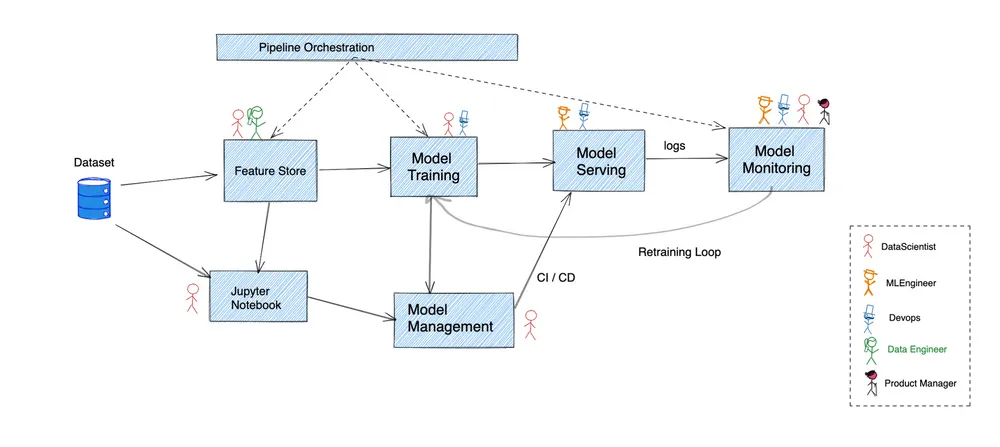
De bovenstaande afbeelding geeft een globaal overzicht van hoe een typische data science-pipeline verloopt. Veel bedrijven hebben ervoor gekozen om een grote verscheidenheid aan maatwerkoplossingen met overlappende functies te gebruiken om het allemaal aan elkaar te lijmen.
We lopen al deze stappen langs om te begrijpen waar Kubernetes precies uitkomst biedt -
Voordat ruwe data nuttig kan worden gemaakt, moet deze eerst worden getransformeerd tot opgeschoonde inputs voor de model training pipeline. Dit is waar feature stores in beeld komen door het uitvoeren van transformatie, opslag en serving van de feature-data.
Kubernetes ondersteunt de deployment van stateful workloads en integreert zeer goed met cloud providers om naadloos persistence te bieden.
De meeste model development begint met een ML Engineer die code schrijft in een Jupyter Notebook, en voor velen is dat bijna alles wat nodig is. Het biedt een REPL-interface voor het uitvoeren van Python-code. Dit begint vaak op persoonlijke laptops, maar het is beter om een gecentraliseerde pool van gehoste Jupyter Notebooks uit te voeren die door meerdere individuen kan worden gebruikt.
Het declaratieve model van Kubernetes, samen met de ondersteuning voor persistent storage systems, maakt het eenvoudig om een pool van notebooks te hosten en access control op individuele notebooks toe te passen om effectieve samenwerking af te dwingen.
Elk algoritme dat in een notebook is geschreven, moet worden gevoed met training data om een model-artefact als output te krijgen. Dit kan bij kleinere use cases in het notebook zelf worden gedaan, maar vereist een veel krachtigere pipeline voor grotere datasets. Meestal wordt de validatie tegen de test-dataset hier ook uitgevoerd voordat het artefact wordt gebruikt voor het uitvoeren van inferences in productie.
Er zijn meerdere oplossingen voor het orchestreren van een DAG-pipeline op Kubernetes. Airflow heeft native ondersteuning voor Kubernetes, terwijl Kubeflow volledig bovenop Kubernetes is gebouwd. Alle grote monitoring-oplossingen bieden first-class integratie met Kubernetes, wat essentieel is voor het draaien van production-grade pipelines.
Deze fase zorgt voor het opslaan en versioneren van de dataset en het model. Dit zorgt ervoor dat elk model-artefact reproduceerbaar blijft zolang dat nodig is. Er kan een parallel worden getrokken met hoe code management wordt uitgevoerd met behulp van Git.
Hoewel de onderliggende datastore voor dergelijke management systems op Kubernetes zelf kan worden gehost, is het in veel gevallen beter om een managed oplossing van een cloud provider te gebruiken. In dergelijke gevallen integreren de meeste cloud providers naadloos hun eigen IAM-systemen met die van Kubernetes, waardoor het veilig is om toegang te krijgen tot data van buiten het cluster zonder dat er access credentials hoeven te worden opgeslagen.
Ten slotte wordt het model-artefact geprepareerd zodat een productiesysteem er inferences op kan uitvoeren. Dit omvat meestal het wrappen van een model in een API framework en het toestaan dat andere services het model aanroepen om inferences te maken. Zaken die vergelijkbaar zijn met software engineering, zoals authn/authz, schaalbaarheid, betrouwbaarheid enz., komen hier om de hoek kijken.
Dit is waar Kubernetes schittert. De meeste functies die we in het vorige gedeelte hebben besproken, worden in deze fase kritiek.
Zoals bij elk productiesysteem is het continu monitoren van het momenteel deployed model essentieel om er zeker van te zijn dat uw systeem zich gedraagt zoals verwacht. De metrics om in de gaten te houden kunnen variëren van de werkelijke nauwkeurigheid van de voorspellingen tot de latency en throughput die het systeem kan ondersteunen.
Veel monitoring-oplossingen integreren nauw met Kubernetes. Het ontdekken van een target om daadwerkelijk metrics te scrapend, het uitvoeren van berekeningen daarbovenop en het opslaan voor later gebruik kan allemaal worden uitgevoerd zonder enige externe afhankelijkheid.
Het gehele landschap rondom Kubernetes ontploft en er is al een enorme hoeveelheid tooling beschikbaar. Er zijn echter enkele valkuilen waar elke organisatie rekening mee moet houden voordat het op grote schaal wordt omarmd. In de volgende editie gaan we hier dieper op in en bespreken we hoe deze kunnen worden beperkt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























