Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
Kostenoverwegingen bij het gebruik van een AI Gateway: Optimaliseren van enterprise AI-uitgaven
Het beheren van de kosten van het gebruik van Large Language Models (LLM's) is een missiekritiek punt geworden voor ondernemingen die AI op schaal inzetten. In tegenstelling tot traditionele software gebruiken op LLM gebaseerde diensten vaak prijsstelling op basis van tokens – providers rekenen af per input-/outputtoken – wat het budgetteren moeilijk voorspelbaar of beheersbaar maakt. Meerdere factoren dragen bij aan deze complexiteit:
Verschillende modelprijzen: Elke LLM-provider (OpenAI, Anthropic, Cohere, etc.) of modelgrootte heeft zijn eigen tarief per token, waarbij grotere modellen (bijv. GPT-4-klasse) aanzienlijk meer kosten per token dan kleinere modellen.
Onvoorspelbare gebruikspatronen: Tokenconsumptie kan enorm variëren per gebruiker, functie of workflow – de ene functie kan in stilte 10× meer tokens gebruiken dan de andere, en het gebruik kan onverwacht pieken door gebruikersgedrag.
Dynamische prompt-pipelines: Geavanceerde toepassingen zoals Retrieval-Augmented Generation (RAG), agents die tools gebruiken, of ketens met meerdere stappen kunnen onbedoeld de promptgrootte en de responslengte vergroten, waardoor de vereiste tokens (en kosten) per query vermenigvuldigen.
Het resultaat is dat teams zonder behoorlijk inzicht en controles vaak pas beseffen hoe snel de kosten oplopen wanneer de rekening arriveert. Het komt niet zelden voor dat kosten onverwacht de pan uit rijzen, wat projectbudgetten bedreigt en schaalvergroting belemmert. Een recent Gartner-rapport waarschuwt eveneens dat een gebrek aan kostentransparantie en governance snel kan leiden tot budgetoverschrijdingen bij AI-initiatieven. Kortom, naarmate organisaties LLM's in producten integreren, is het beheersen van de gebruikskosten even cruciaal als de nauwkeurigheid van het model of de uptime. Prijsstelling op basis van tokens brengt onzekerheid met zich mee die het rendement (ROI) kan laten kelderen, tenzij dit actief wordt beheerd.
Dit is waar het concept van een AI Gateway in beeld komt. Een AI Gateway ontpopt zich tot een sleutelcomponent om opnieuw controle te krijgen over het LLM-gebruik en de uitgaven. Voordat we ingaan op de kostendrijvers en oplossingen, definiëren we eerst wat een AI Gateway is en hoe deze de kosten beïnvloedt.
Wat is een AI Gateway? (En hoe beïnvloedt deze de kosten?)
Een AI Gateway is een gespecialiseerde middlewarelaag die alle interacties tussen uw applicaties en meerdere AI-modellen of -providers beheert. Zie het als een API gateway die specifiek is gebouwd voor AI-workloads — een gateway die AI-specifieke nuances begrijpt, zoals facturering op basis van tokens, inferentielatentie en dynamische routing. Het biedt één centraal eindpunt voor alle AI-verzoeken en stuurt het verkeer intelligent naar de juiste model-backend op basis van beleid voor kosten, prestaties of beschikbaarheid.
Hoewel het toevoegen van een gateway lichte overhead met zich meebrengt — zoals hostingkosten en configuratie-inspanning — wegen deze ruimschoots niet op tegen de controle en het inzicht die het oplevert. Door elk verzoek via één enkele laag te routeren, kunnen organisaties het gebruik monitoren, budgetten handhaven en realtime beslissingen nemen over welk model de beste kosten-prestatieverhouding biedt. Gartner omschrijft AI gateways als "intelligente verkeersregelaars" die ondernemingen helpen bij het evalueren en optimaliseren van modelgebruik in alle applicaties.
TrueFoundry’s AI Gateway fungeert als dit controle-oppervlak dat de toegang over modellen en providers heen centraliseert, terwijl enterprise-beleid zoals toegangsbeheer, kostengovernance, caching en observabiliteit wordt gehandhaafd. Het verandert AI-consumptie van een onvoorspelbare uitgave in een beheerd, meetbaar en optimaliseerbaar systeem.
Belangrijkste kostendrijvers bij LLM-gebruik
Bij het gebruik van Large Language Models in productie bepalen meerdere cruciale factoren de totale operationele kosten. Het begrijpen van deze drijvers is de eerste stap in het beheren en verlagen van LLM-gerelateerde kosten:
Modelkeuze en -grootte: De keuze van het model heeft een buitengewoon grote impact op de kosten. Grotere, geavanceerdere modellen (met hogere aantallen parameters of meer mogelijkheden) hebben doorgaans veel hogere kosten per token. Zo kunnen GPT-4 of andere "reasoning"-modellen een orde van grootte meer kosten per token dan kleinere modellen. Het inzetten van een topmodel voor elk afzonderlijk verzoek – inclusief triviale query's – zal de kosten onnodig opdrijven.
Tokengebruik (prompt- en responslengte): Het aantal verzonden tokens in prompts plus de gegenereerde tokens in responsen bepaalt rechtstreeks de factuur. Lange gesprekken of documenten, extreem grote contextvensters of niet-geoptimaliseerde prompts die irrelevante informatie bevatten, zorgen allemaal voor een snelle toename van het aantal tokens. Functies zoals het vragen om uitgebreide antwoorden of gedetailleerde uitleg kunnen het gebruik exponentieel verhogen. Effectieve prompt engineering om prompts beknopt en outputs gericht te houden, kan de kosten aanzienlijk verlagen. Elke token telt wanneer u miljoenen keren een fractie van een cent per token betaalt.
Verkeersvolume en -patronen: Hoe vaak en hoe breed AI-functies worden gebruikt, heeft uiteraard invloed op de kosten – maar het gaat niet alleen om het totale volume, het gaat om het patroon. Piekerig, onvoorspelbaar verkeer kan tijdens piekgebruik kosten veroorzaken die het maandbudget overschrijden. Variabiliteit tussen gebruikers of functies betekent dat een paar intensieve gebruikers of een interne tool in het geheim het merendeel van de tokens kunnen verbruiken. Plotselinge stijgingen in het gebruik (bijv. een nieuwe functie die viraal gaat) kunnen leiden tot ongeplande rekeningen als er geen throttling wordt toegepast. Het opschalen van gebruik zonder het opschalen van kostentoezicht is een recept voor overschrijdingen.
Gebruik van meerdere modellen en providerselectie: Veel teams gebruiken een mix van modellen – bijvoorbeeld een open-source model voor sommige taken en een eigen API voor andere, of verschillende providers voor verschillende talen. Elk model of elke provider kan verschillende prijseenheden hanteren (sommige rekenen per 1000 tokens, andere per verzoek, etc.), evenals eventuele aanvullende kosten. Bovendien, als een team uit voorzorg altijd terugvalt op het duurste model, lopen ze kansen mis om te besparen. Het selecteren van het juiste model voor elke taak is een belangrijke kostenhefboom: een eenvoudige query heeft geen duur model met 175 miljard parameters nodig wanneer een kleiner (en goedkoper) model volstaat. Omgekeerd kunnen sommige complexe taken de kosten van een superieur model rechtvaardigen. De strategie (of het gebrek daaraan) bij het routeren van verkeer naar modellen is een grote kostendrijver.
Infrastructuur en overhead: Er zijn ook kosten buiten de tarieven per token. Als u zelf open-source LLM's host om API-kosten te vermijden, betaalt u in infrastructuur – GPU-servers, geheugen, onderhoud en MLOps-inspanningen. Zoals één analyse het beknopt verwoordde: "Open-source LLM's zijn niet gratis — ze verplaatsen de rekening alleen van licenties naar engineering, infrastructuur, onderhoud en strategisch risico." Zelfs bij het gebruik van cloud-API's hebt u mogelijk extra infrastructuur nodig om verzoeken af te handelen (bijv. het draaien van een interne dienst of gateway, vectordatabases voor RAG, enz.), wat cloud-computekosten met zich meebrengt. Integratie-overhead en engineeringtijd zijn "verborgen" kosten die langzaam kunnen oplopen.
Licentie- of abonnementskosten: Sommige modellen en diensten brengen vaste kosten met zich mee bovenop het gebruik. Bepaalde enterprise AI-API's vereisen bijvoorbeeld een maandelijks abonnement of een afnameverplichting. Zelfs open-source modellen kunnen licentiebeperkingen hebben die ondernemingen richting betaalde opties duwen. Als u een eigen platform voor het serveren van modellen inzet, kunnen er licentiekosten zijn. Deze kosten moeten worden meegenomen in de totale eigendomskosten (TCO) voor het gebruik van een gegeven model – soms vereist een model dat "goedkoper per token" is een dure licentie, wat de besparingen tenietdoet.
Integratie- en inefficiëntiekosten: Ten slotte kan de manier waarop u AI in uw systemen integreert leiden tot kostenefficiëntieproblemen. Overtollige calls, gebrek aan caching of slecht belastingbeheer kunnen tokens verspillen. Vroege enterprise-gebruikers ontdekten dat het gebruik van een standaard API gateway of ad-hoc integratie leidde tot aanzienlijke kostenoverschrijdingen – in sommige gevallen 300% boven de initiële prognoses – omdat de tooling geen rekening hield met AI-specifieke optimalisaties zoals het cachen van vergelijkbare prompts of load-balancing over modellen heen. Er hangt een prijskaartje aan het bouwen en onderhouden van uw eigen infrastructuur voor toegang tot meerdere modellen en monitoring. Als elk team onafhankelijk AI-API's aanroept, mist u schaalvoordelen en gecentraliseerd toezicht, wat vaak leidt tot hogere totale uitgaven dan nodig (bijvoorbeeld wanneer meerdere teams hetzelfde model aanroepen met dezelfde vraag en dubbel betalen).
Het begrijpen van deze kostendrijvers benadrukt waarom het simpelweg verlenen van toegang tot een LLM-API aan teams niet voldoende is – onbeheerd gebruik over vele apps en gebruikers zal bijna onvermijdelijk tot verrassingen leiden. Hoe missiekritieker en wijdverbreider het AI-gebruik, des te groter is de noodzaak voor governance. Dit is waar AI Gateways hun waarde bewijzen: ze richten zich rechtstreeks op deze kostendrijvers en bieden mechanismen om kosten binnen de perken te houden zonder in te boeten op prestaties of betrouwbaarheid.
LLM-kosten beheren en verlagen met een AI Gateway
Een AI Gateway biedt een reeks tools en slimme strategieën om bovenstaande kostendrijvers aan te pakken. Het fungeert als een centrale kostengovernance-laag voor al het AI-gebruik. Volgens Gartner kunnen AI gateways het risico op "uit de hand lopende AI-kosten door gebrekkige governance" beperken door te fungeren als een controlepunt tussen AI-consumenten en -providers. De AI Gateway van TrueFoundry beschikt bijvoorbeeld over tal van ingebouwde functies om kosten te bewaken en te optimaliseren. Laten we dieper ingaan op hoe een AI gateway helpt bij het beheren en verlagen van LLM-kosten:
Gecentraliseerd kosteninzicht: Alle verzoeken lopen via de gateway, die gedetailleerde gebruiksmetrieken registreert voor elke call – gebruikt model, verbruikte tokens, latentie, toewijzing aan gebruiker/team, enz. Dit biedt een gedetailleerd, realtime inzicht in waar uw token-euro's naartoe gaan. Leidinggevenden kunnen eindelijk met precisie antwoord geven op de vraag "welke applicaties of toepassingen zijn verantwoordelijk voor het grootste deel van onze OpenAI-rekening?". Dit overkoepelende inzicht over alle apps heen is vrijwel onmogelijk te verkrijgen wanneer teams modellen rechtstreeks aanroepen. Met een gateway krijgt u één enkele bron van waarheid op het dashboard voor AI-gebruik en -uitgaven. Dergelijke transparantie maakt chargeback/showback-boekhouding mogelijk (het toewijzen van kosten aan afdelingen), wat op zijn beurt de verantwoordelijkheid stimuleert.
Budgethandhaving & waarborgen: Inzicht alleen is niet genoeg – de gateway handhaaft ook beleid om onbeheerst gebruik te voorkomen. U kunt ratelimieten en quota instellen (bijv. niet meer dan N tokens of € X aan uitgaven per dag voor een specifieke gebruiker of functie) en de gateway zal verzoeken die deze limiet overschrijden weigeren of vertragen. Dit zorgt ervoor dat één verkeerd geconfigureerd script of een onverwachte gebruikspiek het budget niet laat ontploffen. U kunt ook budgetwaarschuwingen of automatische uitschakelregels instellen: als het maandelijkse gebruik van een team een drempel overschrijdt, kan de gateway meldingen sturen of verdere calls tijdelijk blokkeren tot er goedkeuring is, wat verrassingsrekeningen voorkomt. Bovendien maken gateways toegangsbeheer en modelbeperkingen mogelijk – u kunt bijvoorbeeld instellen dat dure modellen zoals GPT-4 alleen mogen worden gebruikt door specifieke kritieke workflows, terwijl minder kritische toepassingen worden beperkt tot goedkopere modellen. Een andere vorm van waarborg is prompt-filtering: het blokkeren van prompts die extreem lange antwoorden of anderszins kostenefficiënte verzoeken zouden uitlokken. Door deze governance-regels centraal toe te passen, stellen organisaties harde grenzen aan hun kostenrisico.
Belangrijkste metrieken voor het evalueren van een Gateway
Criterium
Wat moet u evalueren?
Prioriteit
TrueFoundry
Latency
Voegt <10ms p95 overhead toe voor time-to-first-token?
Must Have
✅ Ondersteund
Data Residency
Bewaart logs binnen uw regio (EU/US)?
Afhankelijk van use case
✅ Ondersteund
Latency-Based Routing
Stuurt automatisch om op basis van realtime latency/storingen?
Must Have
✅ Ondersteund
Key Rotation & Revocation
Sleutels roteren of intrekken zonder downtime?
Must Have
✅ Ondersteund
Key Rotation & Revocation
Sleutels roteren of intrekken zonder downtime?
Must Have
✅ Ondersteund
Key Rotation & Revocation
Sleutels roteren of intrekken zonder downtime?
Must Have
✅ Ondersteund
Key Rotation & Revocation
Sleutels roteren of intrekken zonder downtime?
Must Have
✅ Ondersteund
Key Rotation & Revocation
Sleutels roteren of intrekken zonder downtime?
Must Have
✅ Ondersteund
Een AI Gateway evalueren?
Een praktische gids gebruikt door platform- & infra-teams
Intelligente model routing: Misschien wel de grootste kostenbespringer is het vermogen van de gateway om elk verzoek dynamisch naar het optimale model of de optimale provider te routen op basis van context. In plaats van een eenheidsworst kan de gateway factoren zoals de complexiteit van de query, vereiste nauwkeurigheid, latency en kosten evalueren en vervolgens het model kiezen (of zelfs automatisch wisselen) dat het beste aan de behoeften voldoet tegen de laagste kosten. Een eenvoudige feitelijke vraag kan bijvoorbeeld worden beantwoord door een kleiner, goedkoper model zonder merkbaar kwaliteitsverschil, terwijl een complexe taak naar een krachtiger model wordt gestuurd. Dit type realtime modelselectie verlaagt de kosten drastisch door overkill te voorkomen. De AI Gateway van TrueFoundry implementeert dit via slimme routingregels en load balancing: u kunt deze bijvoorbeeld zo configureren dat query's standaard naar een open-source model zoals Mistral gaan voor snelheid en lage kosten, maar als de prompt er complex uitziet of als de betrouwbaarheid van het kleinere model laag is, routeert de gateway dat verzoek naar een groter model zoals GPT-4. Over honderdduizenden verzoeken kan deze adaptieve routing tot enorme besparingen leiden terwijl de algehele kwaliteit behouden blijft. Het doorbreekt de valse tegenstelling tussen het kiezen voor een hoogwaardig óf een goedkoop model – u kunt beide hebben door elk model in te zetten waar het logisch is.
Response caching: Een andere kostenoptimalisatie is het cachen van herhaalde of veelvoorkomende AI-antwoorden. Als meerdere gebruikers dezelfde vraag stellen of uw systeem herhaaldelijk identieke query's uitvoert, kan een AI gateway een gecachet antwoord retourneren in plaats van het model opnieuw aan te roepen, wat die tokens volledig bespaart. Zelfs het cachen van gedeeltelijke resultaten (zoals kostbare tussenstappen) kan helpen. Dit is vooral nuttig voor backend-taken of apps waar dezelfde prompt frequent wordt gebruikt. Caching verlaagt niet alleen de kosten, maar verbetert ook de latency voor die query's. De gateway van TrueFoundry ondersteunt zowel eenvoudige caching als meer geavanceerde semantische caching – waarbij semantisch vergelijkbare prompts als cache-hits kunnen worden behandeld. (Semantische caching moet zorgvuldig worden gebruikt, omdat subtiele verschillen in prompts het antwoord kunnen veranderen, maar in de juiste scenario's kan het de cache-hitratio verhogen en de kosten verlagen.) Studies hebben aangetoond dat semantische cachingmechanismen de LLM API-kosten met wel 70% kunnen verlagen in enterprise use cases. In de praktijk biedt zelfs een eenvoudigere cache voor identieke verzoeken al een aanzienlijke kostenbuffer voor apps met een hoog volume.
Observability & anomaliedetectie: Omdat de gateway alle verzoeken monitort, kan deze ook afwijkende gebruikspatronen detecteren die op een bug of misbruik kunnen wijzen. Als dit uur bijvoorbeeld 5× zoveel tokengebruik laat zien als het vorige, of als één applicatie het model plotseling begint te spammen met grote prompts, brengt de gateway (en de geïntegreerde dashboards) die anomalie aan het licht. Vroegtijdige detectie betekent dat u kunt ingrijpen voordat het het budget uitput. De observability draagt ook bij aan de betrouwbaarheid: het houdt foutpercentages en latencies bij, wat helpt om kostengerelateerde vertragingen te onderscheiden van problemen met het model zelf. Sommige gateways, zoals die van TrueFoundry, integreren met tools zoals OpenTelemetry, zodat u LLM-gebruiksstatistieken kunt samenvoegen met uw algehele monitoringstack. Deze holistische observability zorgt ervoor dat u zowel kosten- als prestatiedoelstellingen behaalt. Het maakt ook interne chargebacks mogelijk – aangezien het gebruik centraal wordt gelogd, kunt u teams verantwoordelijk houden voor hun deel van de AI-rekening, wat hen stimuleert om efficiënt te werken.
Hoe een AI Gateway LLM-kosten beheert en verlaagt, door gecentraliseerde zichtbaarheid, budgethandhaving, intelligente model-routing, caching en observabiliteit te combineren in één controlelaag.
Al deze mogelijkheden komen samen om kostendiscipline af te dwingen zonder voortdurend handmatig toezicht. Door een AI gateway te gebruiken, wordt kostenbeheer proactief en geautomatiseerd: u heeft kostenlimieten ingesteld zodat u niet te veel kunt uitgeven, u beschikt over realtime inzicht om gebruikspatronen aan te passen, en u heeft geautomatiseerde optimalisaties (routing, caching) die efficiëntie-lekken direct verhelpen. Het verandert wat een ondoorzichtige, uit de hand gelopen kostenpost zou kunnen zijn in een beheerde utility.
De AI Gateway van TrueFoundry is een voorbeeld van deze kostenbeheersing in de praktijk. Het biedt ingebouwde dashboards voor het bijhouden van kosten, configuratie van budgetbeleid, multi-model routing-regels en caching-mechanismen, allemaal configureerbaar via een ondernemingsvriendelijke interface. Het resultaat is dat bedrijven meer AI-use cases kunnen omarmen zonder de angst voor onvoorspelbare rekeningen. Natuurlijk brengt het gebruik van een dergelijke gateway enkele overwegingen met zich mee rond prestaties en architectuur, die we hierna bespreken.
Het in evenwicht brengen van kosten, nauwkeurigheid, latency en complexiteit
Elke strategie om kosten agressief terug te dringen moet worden afgewogen tegen andere technische en zakelijke vereisten. Compromissen zijn onvermijdelijk. In de context van LLM-implementaties zijn de belangrijkste dimensies om in evenwicht te brengen kosten, nauwkeurigheid (of kwaliteit van de resultaten), latency (reactiesnelheid) en architecturale complexiteit. Een AI gateway helpt deze afwegingen te beheren, maar het begrijpen ervan is belangrijk voor het instellen van het juiste beleid:
Kosten vs. Nauwkeurigheid: Modellen van hogere kwaliteit betekenen meestal hogere kosten, maar niet elke taak vereist redeneervermogen op GPT-4-niveau. Een kleiner 7B-model kan "Wat is de hoofdstad van Frankrijk?" net zo nauwkeurig beantwoorden als een vlaggenschipmodel, maar een complexe juridische vraag niet. De sleutel is om de routing-intelligentie van de gateway te gebruiken om te beslissen wanneer hoogwaardige nauwkeurigheid de prijs waard is. Stuur alledaagse taken naar kleinere modellen en bewaar geavanceerde modellen voor complexe redeneringen. Na verloop van tijd helpen analyses om deze drempels te verfijnen, waardoor de balans wordt gevonden tussen acceptabele nauwkeurigheid en aanzienlijke kostenbesparingen.
Kosten vs. Latency: Goedkopere modellen leveren vaak ook snellere reacties, vooral als ze lokaal worden gehost. Naïeve multi-model routing kan echter latency veroorzaken als het systeem één model probeert en vervolgens terugvalt op een ander. De Gateway van TrueFoundry beperkt dit met latency-gebaseerde en belastingbewuste routing, wat ervoor zorgt dat requests naar het snelste levensvatbare model stromen zonder onnodige tussenstappen. De architectuur voegt slechts een paar milliseconden overhead toe (~3–4 ms per request) — verwaarloosbaar vergeleken met model-inferentietijden, zodat teams aan efficiëntie winnen zonder de gebruikerservaring in gevaar te brengen.
Kosten vs. Architecturale complexiteit: Het toevoegen van een AI Gateway introduceert een extra infrastructuurlaag, maar levert ook zichtbaarheid, guardrails en betrouwbaarheid die opstellingen met één model missen. Voor kleine teams of prototypes kunnen directe model-calls volstaan. Maar naarmate het gebruik schaalt, worden gecentraliseerde routing, caching en kostenbeheer essentieel.
Uiteindelijk is het in evenwicht brengen van deze factoren een continu proces. De beste werkwijze is om voortdurend de impact van uw kostenbesparende maatregelen op de kwaliteit van de model-output en de gebruikerservaring te monitoren (waarbij de observabiliteit van de gateway helpt), en de knoppen (routing-regels, cache-instellingen, enz.) dienovereenkomstig aan te passen. Het schone van de AI gateway-aanpak is dat u deze knoppen heeft om aan te draaien – u zit niet vast aan een 'one-size-fits-all' modelgebruik. U kunt de uitgaven op bepaalde gebieden verhogen of verlagen, terwijl u behoudt wat het belangrijkst is voor uw applicatie, of dat nu responstijd of nauwkeurigheid van de antwoorden is.
Best Practices voor LLM-kostenoptimalisatie met behulp van een Gateway
Om het meeste profijt te halen uit een AI gateway, moeten organisaties de technologie combineren met verstandige gebruiksstrategieën. Hier zijn enkele praktische best practices voor het optimaliseren van LLM-kosten met behulp van behoud van prestaties:
1. Optimaliseer prompts en outputs. Schrap onnodige tokens en houd prompts gericht. Te lange of omslachtige instructies verspillen tokens. Gestructureerde formaten — zoals opsommingstekens of JSON-schema's — houden antwoorden beknopt en voorspelbaar. Beoordeel en verkort veelvoorkomende context-prompts die voorafgaand aan elke call worden toegevoegd. Deze "kosteloze" optimalisatie verlaagt de uitgaven rechtstreeks.
2. Gebruik hybride model-routing. Hanteer een gelaagde modelstrategie: stuur eenvoudige of minder kritieke query's naar kleinere, goedkopere modellen, en complexe query's naar premium modellen. Veel teams volgen een 90/10-patroon — 90% van het verkeer naar snelle, goedkope modellen; 10% naar hoogwaardige modellen voor kritieke taken. De Gateway van TrueFoundry automatiseert dit via regelgebaseerde of op ML gebaseerde routing, zodat u nooit te veel betaalt voor capaciteit die u niet nodig heeft.
3. Batch en paralleliseer calls. Wanneer u per token of per call betaalt, kunt u de overhead minimaliseren door meerdere prompts te groeperen in één request. Met de batch inference API van TrueFoundry kunt u gerelateerde taken groeperen — ideaal voor periodieke taken zoals het samenvatten van grote documentensets. In sommige gevallen kunnen parallelle requests worden verzonden naar zowel goedkope als dwaze modellen, waarbij de duurdere wordt geannuleerd als de eerste een bevredigend resultaat oplevert.
4. Cache hoogfrequente queries. Hergebruik resultaten in plaats van ze opnieuw te berekenen. De Gateway ondersteunt zowel exact-match als semantische caching, waarbij vergelijkbare prompts eerdere antwoorden kunnen hergebruiken. Zelfs bescheiden cache-hitrates kunnen een aanzienlijke besparing op tokenkosten opleveren en tegelijkertijd de latency verbeteren — een grote winst voor herhaalde workflows of veelvoorkomende queries.
5. Fine-tune of specialiseer modellen. Voor repetitieve, domeinspecifieke taken kan het fine-tunen van een kleiner model of het integreren van RAG (retrieval-augmented generation) prompts verkorten en tokens verminderen. Het platform van TrueFoundry ondersteunt fine-tuning en custom deployment, waardoor teams worden geholpen om precisie en efficiëntie op schaal in balans te brengen.
6. Gebruik open-source of self-hosted modellen. Bij hoge volumes kan het goedkoper zijn om open-weight modellen te hosten op dedicated GPU's in plaats van te betalen per API-call. De Gateway maakt een naadloze hybride uitrol mogelijk — waarbij een deel van het verkeer naar self-hosted modellen wordt gestuurd, terwijl centraal beheer van logging en beleid behouden blijft. Deze hybride configuratie kan aanzienlijke kostenbesparingen opleveren met behoud van flexibiliteit.
Naast deze best practices geldt altijd:
monitoren en itereren
. Gebruik de data uit de gateway om te zien welke strategieën de meeste impact hebben (bijv. cache hit rates, tokens bespaard door routing, enz.) en stuur bij waar nodig. Kostenoptimalisatie is geen eenmalige instelling die u kunt vergeten, maar de gateway geeft u de middelen om er een continu, beheersbaar proces van te maken in plaats van een verrassing die u achteraf moet bestrijden.
TrueFoundry’s benadering van kostentracking en governance
Hoewel kostenoptimalisatie een universele uitdaging is bij LLM-implementaties, transformeert TrueFoundry’s AI Gateway dit in een gestructureerd, meetbaar en continu proces. In plaats van te vertrouwen op handmatige budgettering of verspreide kostenrapporten, verankert TrueFoundry governance rechtstreeks in de infrastructuurlaag — wat ervoor zorgt dat elke AI-interactie in real-time wordt gelogd, geprijsd en toegewezen. Deze geïntegreerde infrastructuur maakt een gestructureerde LLM cost tracking solution mogelijk, waarmee ondernemingen hun uitgaven op model-, team- en workflow-niveau met volledige transparantie kunnen monitoren.
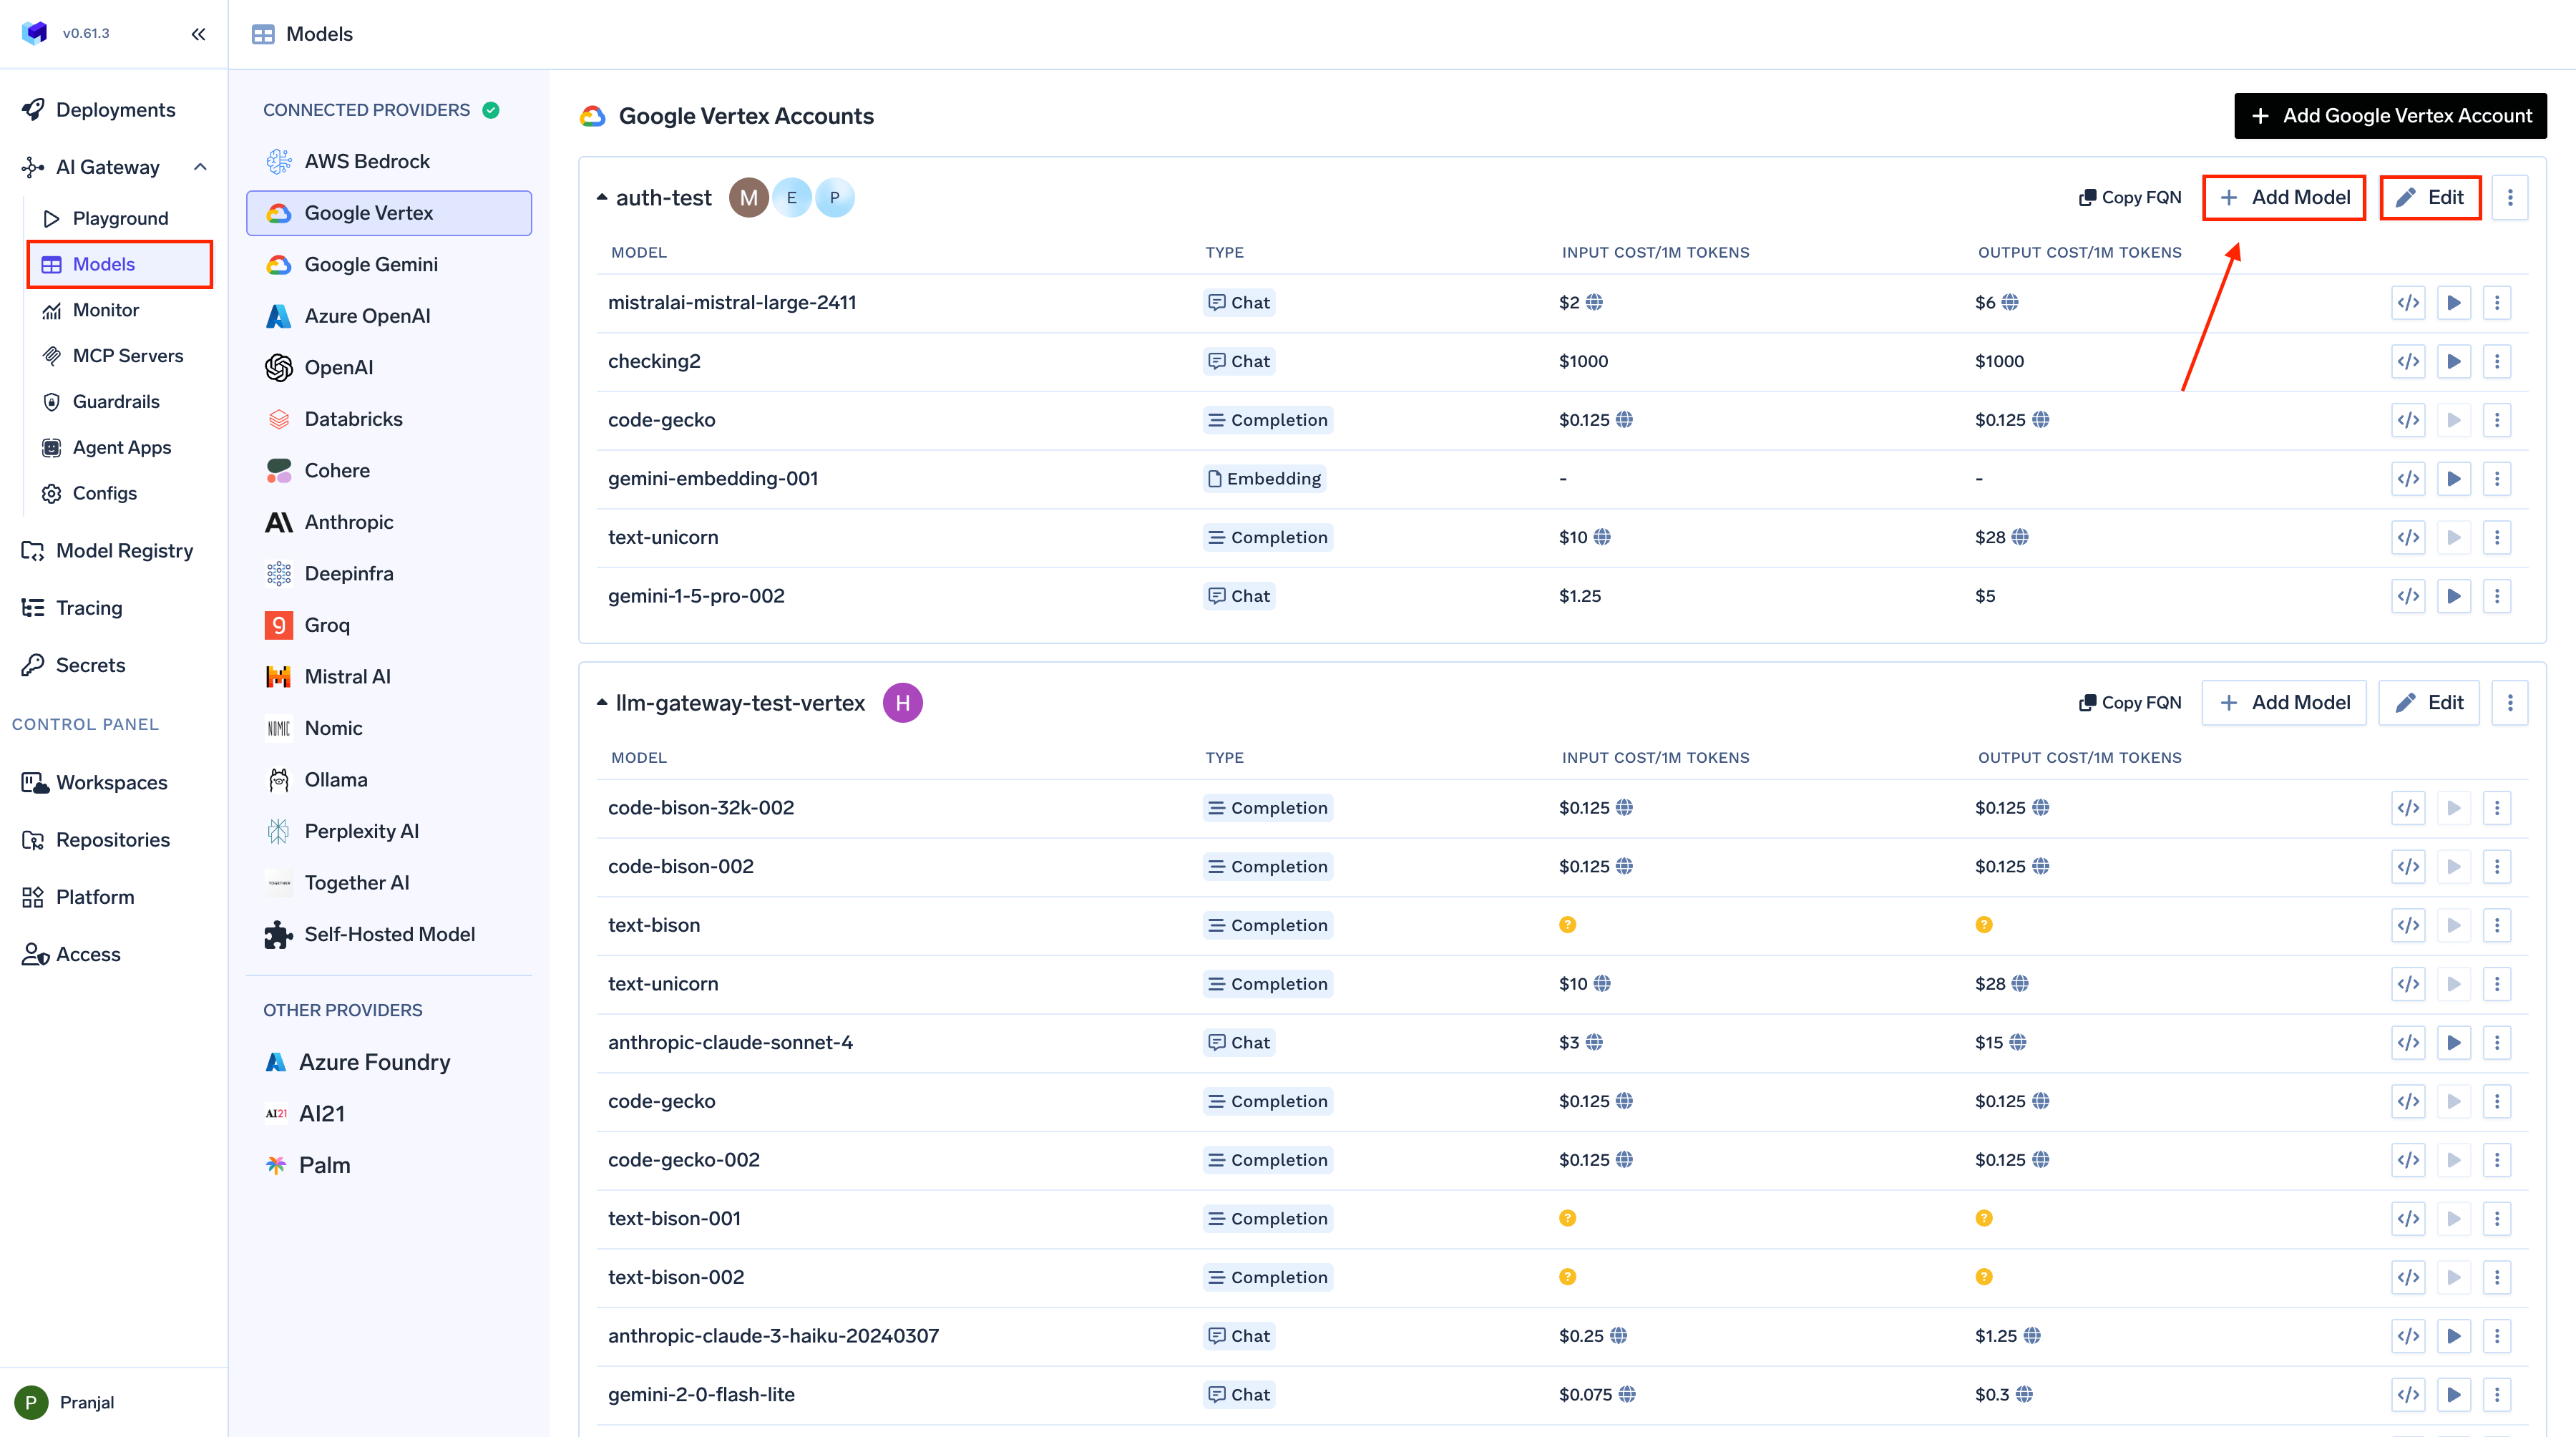
TrueFoundry's Model Cost Configuration Interface
1. Real-time kostentoewijzing
Elk verzoek dat door TrueFoundry’s Gateway gaat, wordt automatisch getagd en geprijsd. Het systeem combineert het aantal input/output-tokens met modelspecifieke prijsinformatie, afkomstig van openbare API's of op maat onderhandelde tarieven — om zo de exacte kosten per inference te berekenen. Teams kunnen deze metrieken filteren op model, team, omgeving of gebruiker, wat een nauwkeurig inzicht geeft in wie of wat de uitgaven drijft. Dit maakt het eenvoudig om kosten toe te wijzen, interne chargebacks uit te voeren of de ROI van AI-functionaliteiten te verantwoorden.
2. Configureerbare modelprijzen en budgetten
TrueFoundry stelt ondernemingen in staat om aangepaste prijzen per model te definiëren, waardoor de interne tracking wordt afgestemd op de daadwerkelijke contracten met leveranciers of de kosten van self-hosted compute. Beheerders kunnen ook budgetdrempels of quota instellen voor elke app of omgeving. Wanneer de uitgaven een gedefinieerde limiet overschrijden, kan de Gateway geautomatiseerde waarschuwingen activeren of zelfs tijdelijke throttling afdwingen, wat zorgt voor kostenbeheersing zonder handmatige tussenkomst.
3. Geïntegreerde observability
TrueFoundry meent kosten- en gebruiksgegevens te exporteren naar Prometheus en OpenTelemetry, waarmee het naadloos integreert met bestaande monitoringpipelines. Hierdoor verschijnen AI-kosten, latency- en betrouwbaarheidsmetrieken in dezelfde dashboards die worden gebruikt voor infrastructuur- en applicatiemonitoring. Het resultaat is één single pane of glass waarin engineering-, finance- en productteams een gezamenlijk overzicht hebben van prestaties en uitgaven.
4. Governance by Design
Omdat elke call metadatatagging bevat (team, project en omgeving), kunnen organisaties een gestructureerde verantwoordelijkheid over afdelingen heen implementeren. Gecombineerd met role-based access control (RBAC) en permissies op modelniveau zorgt dit ervoor dat dure of risicovolle modellen alleen toegankelijk zijn voor geautoriseerde teams. Deze waarborgen maken compliance, budgetdiscipline en transparantie automatisch — niet handmatig.
Wanneer een AI Gateway wellicht niet nodig is
AI Gateways bieden enorme waarde op schaal, maar niet elke organisatie heeft er direct een nodig. Voor kleine teams of projecten in een vroeg stadium die een enkel model en lage verzoekvolumes gebruiken, kan het implementeren van een volledige gateway onnodige overhead veroorzaken. Een prototype dat één OpenAI-model aanroept met een paar duizend tokens per dag, kan eenvoudig worden beheerd met directe API-calls en basis-monitoring.
Richtlijnen uit de sector suggereren dat wanneer het gebruik beperkt is (tientallen duizenden tokens per maand) en de behoefte aan compliance of betrouwbaarheid minimaal is, een lichte proxy of handmatige tracking kan volstaan. Het echte voordeel van de gateway komt naar voren naarmate workloads schalen of diversifiëren over meerdere modellen en providers. Als uw organisatie nog aan het experimenteren is met LLM's of een minimale infrastructuur heeft, richt u dan eerst op iteratie, maar plan vooruit. De Gateway van TrueFoundry kan bijvoorbeeld efficiënt meeschalen vanaf een klein niveau, wat al vroeg inzicht en governance biedt zonder zware installatie. Kortom, beoordeel uw AI-volwassenheid en schaal: voor toepassingen met één model en een laag volume is een gateway mogelijk te vroeg; naarmate de adoptie groeit, wordt het al snel essentieel voor kostenbeheersing, betrouwbaarheid en langetermijngovernance.
Conclusie
Het beheersen van LLM-kosten in enterprise-omgevingen is complex, maar AI Gateways zijn precies gebouwd om dat op te lossen. In plaats van kosten aan het toeval over te laten, verankert een gateway zoals die van TrueFoundry kostengovernance rechtstreeks in uw AI-architectuur. Door gecentraliseerde tracking, budgetteringswaarborgen, intelligente routing en caching verandert het kostenbeheersing in een ingebouwde functionaliteit in plaats van een achterafgedachte.
Ondernemingen die AI gateways gebruiken, melden reducties van 40–60% in inference-kosten, samen met een hogere betrouwbaarheid en beveiliging. Met name de Gateway van TrueFoundry biedt verantwoordelijkheid by design — door teams gedetailleerd inzicht, kostentoewijzing en chargebacks te geven — en risicoreductie op schaal via geautomatiseerde limieten en fail-safes. Het biedt ook volledige transparantie in gebruikspatronen, zodat geen enkel kosten- of latency-probleem onopgemerkt blijft.
Door beleid over regio's en teams heen te centraliseren, garandeert de Gateway consistente governance en compliance — cruciaal voor sectoren die gevoelige gegevens verwerken. Het resultaat: AI-projecten bewegen van experiment naar productie met voorspelbare uitgaven en operationeel vertrouwen.
Kortom, AI Gateways maken de adoptie van LLM's duurzaam. Prijzen op basis van tokens mogen dan onvoorspelbaar zijn, maar met de centrale controle-laag van TrueFoundry kunnen ondernemingen hun uitgaven optimaliseren, waarborgen afdwingen en op een verantwoorde manier opschalen. Dit is hoe innovatie en financiële discipline samengaan — waardoor AI verandert in een beheerde, efficiënte en enterprise-ready capaciteit.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting