April 16, 2024
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Arthur AI integratie met Truefoundry AI Gateway
Elk team dat een LLM-applicatie uitrolt, loopt tegen dezelfde muur op. Ontwikkelaars willen snel handelen en verbinding maken met het model dat de taak volbrengt. Beveiligings- en risicoteams willen de garantie dat er niets toxisch, gemanipuleerds of gehallucineerds naar een gebruiker doorsijpelt. Beiden hebben gelijk. Het moeilijke deel is om beide tegelijk te doen, voor elk model dat uw teams gebruiken, zonder op elke app een SDK van een derde partij te schroeven. De grote vraag: hoe valideert u elke prompt en elke respons die uw AI produceert zonder van veiligheid een complex engineeringproject te maken?
Met trots kondigen we aan dat Arthur AI nu integreert met de TrueFoundry AI Gateway. Door de Arthur Engine naar de Gateway te brengen als een custom guardrail, kunt u AI-inputs en -outputs in real-time valideren voor al uw modellen vanaf één plek, met een consistent beleid en een enkele integratie.
De kracht van de TrueFoundry AI Gateway
De TrueFoundry AI Gateway is de manier waarop ontwikkelaars en platformteams hun AI-applicaties beheren, monitoren en schalen. Het brengt geünificeerde toegang tot honderden large language models, diepe observabiliteit en slimme routing samen in één laag. Naarmate AI-adoptie groeit, is de echte uitdaging niet langer de toegang tot modellen, maar het beheren van alles wat daarna komt: meerdere providers, veranderende API's en strenge compliance-eisen die teams ongemerkt kunnen vertragen.
De Gateway brengt orde in die complexiteit. Het fungeert als het commandocentrum voor enterprise AI, dat toegang unificeert, beveiligingsbeleid afdwingt en volledige zichtbaarheid biedt in elk model en elke omgeving. Guardrails worden eenmalig op deze laag aangesloten en gelden overal, zodat een veiligheidsbeslissing die in het dashboard wordt genomen, wordt afgedwongen op elk verzoek dat erdoorheen stroomt.
Arthur AI: Real-Time Validatie
Arthur AI bevindt zich tussen uw applicatie en uw modellen als een validatielaag. De ArthurEngine inspecteert prompts en completions in real-time en geeft een duidelijk oordeel over de vraag of het veilig is om door te gaan.
Out-of-the-box controleert Arthur op de risico's die er het meest toe doen in productie. Het detecteert prompt injection, waarbij een aanvaller input formuleert die is ontworpen om het model over te nemen en van zijn instructies af te brengen. Het vlagt toxische content zowel op de heen- als de terugweg, zodat schadelijke taal nooit uw model of uw gebruikers bereikt. En het voert hallucinatiecontroles uit tegen de grounding context die u aanlevert, waarbij responsen worden opgevangen die afwijken van de feiten voordat ze als antwoorden worden vertrouwd.
Eén belangrijk detail bepaalt hoe Arthur past: het is validate-only. Het vertelt u, snel en stateless, of iets is geslaagd of mislukt. Het meldt problemen in plaats van tekst stilzwijgend te herschrijven, wat het gedrag voorspelbaar en eenvoudig te auditen houdt.
Samen beter: Één contract, elk model
De integratie verbindt Arthur met TrueFoundry via een lichtgewicht deployable wrapper en het Custom Guardrail-contract van de Gateway. U implementeert een kleine FastAPI-service, verwijst de Gateway daarnaar en registreert twee guardrail-configs in het dashboard: één voor input, één voor output. Vanaf dat moment kan elk model achter de Gateway worden gevalideerd door Arthur zonder dat er per app codeaanpassingen nodig zijn.
Dat is de echte winst. In plaats van Arthur handmatig in elke applicatie te integreren, koppelt u het eenmalig aan de Gateway. Koppel het aan een model zodat elke aanroeper is beschermd, of kies per verzoek voor een opt-in met een enkele header wanneer u het alleen bij specifieke aanroepen wilt. Hetzelfde beleid reist mee met elk team, model en elke omgeving, en elk oordeel wordt vastgelegd naast TrueFoundry's request tracking voor een schone audit trail.
Hoe de Arthur AI en TrueFoundry integratie werkt
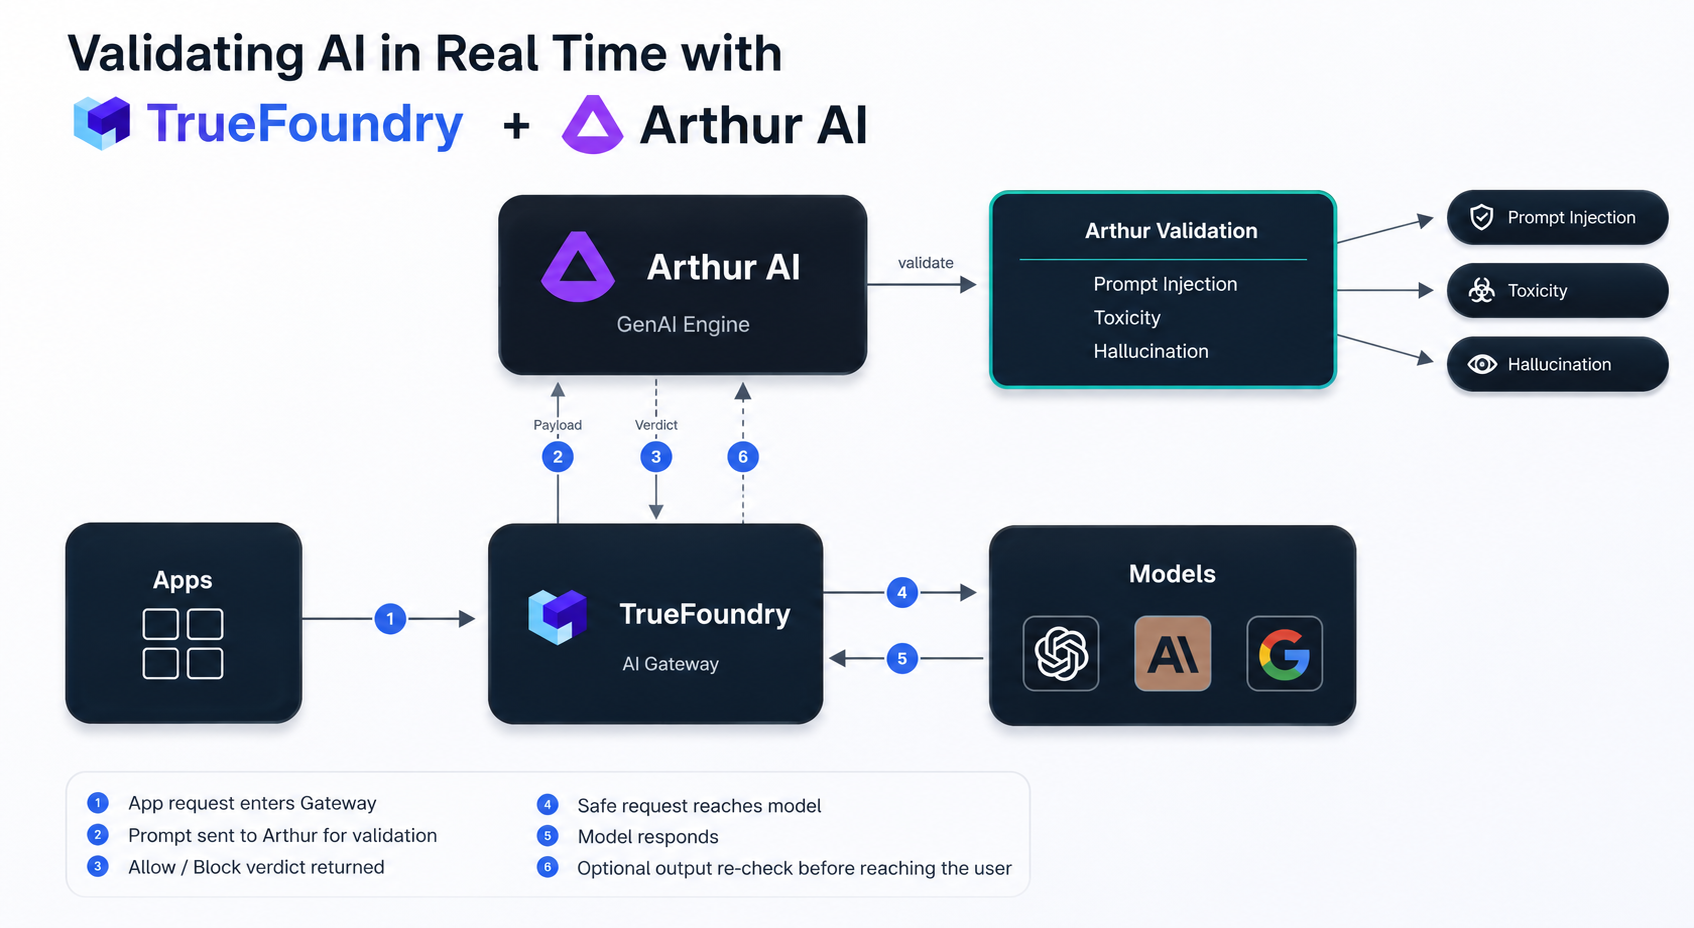
De integratie introduceert een gelaagde validatiestroom die eenvoudig te volgen is:
Een subtiele maar belangrijke ontwerpkeuze maakt dit robuust: beleidsbeslissingen worden meegegeven op een normale HTTP 200 met een oordeelveld, terwijl echte infrastructuurfouten als 5xx-fouten naar boven komen. Met de aanbevolen Enforce But Ignore On Error-strategie laat een tijdelijke storing het verkeer door, maar een echte policy block stopt het verzoek altijd. Voor veiligheidscritische regels kunt u overschakelen naar strikte handhaving en in plaats daarvan afsluiten bij fouten (fail closed).
Aan de slag
Het beveiligen van uw AI zou niet moeten voelen als een herstructurering. Met Arthur AI op de TrueFoundry AI Gateway is real-time validatie eerder het omzetten van een knop dan een complex bedradingsproject: implementeer de wrapper, voeg twee guardrail-configs toe, koppel ze aan uw modellen en u valideert prompts en responsen over uw gehele stack.
Om precies te zien hoe het werkt, gaat u naar de Arthur AI integratiegids in de TrueFoundry-documentatie, waar de volledige instelling, het responscontract en de configuratie van custom checks stap voor stap worden uitgelegd.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox