



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In 2026 kunnen ondernemingen het zich niet langer veroorloven om een LLM Gateway om te bouwen tot een behelpen AI Gateway. AI zal alleen maar dieper geïntegreerd raken in klantgerichte workflows, waardoor een toegewijde gateway-laag essentieel is voor betrouwbare AI-gestuurde applicaties. De typische enterprise AI-infrastructuur is vaak multi-model, multi-team en multi-cloud, wat leidt tot complexe vraagstukken rondom compliance en kostenverantwoordelijkheid.
Gartner definieert een AI-gateway als een technologie of platform dat fungeert als tussenpersoon tussen applicaties en diverse artificial intelligence (AI)-services of -modellen. Het doel is om de toegang tot AI-functionaliteiten te vereenvoudigen en te beheren, door een centraal punt te bieden dat beveiliging, governance en observability van AI-workloads mogelijk maakt. Lees de volledige Gartner Market Guide for AI Gateways 2025 om meer te weten te komen.
Het afgelopen jaar hebben we drie brede categorieën zien ontstaan om de uitdagingen rondom governance en veerkracht van GenAI aan te pakken:
Elke categorie is geoptimaliseerd voor een andere fase van AI-adoptie. Problemen ontstaan wanneer tools die geoptimaliseerd zijn voor de ene fase worden geforceerd om een andere fase af te handelen.
In dit blog brengen we alle concurrentieanalyses samen in één definitief overzicht van het landschap. We leggen uit waar elk platform past, waar ze vastlopen en waar ondernemingen rekening mee moeten houden bij het kiezen van een leverancier die het beste aansluit bij hun vereisten.
1. Kong AI: Traditionele API Gateway aangepast voor AI
Kong is een API-gateway die vaak wordt gebruikt in op Kubernetes gebaseerde microservice-architecturen. Kong AI bouwt voort op dit fundament door plugins en integraties toe te voegen die zijn ontworpen om verkeer naar grote taalmodellen te routen.
Waar Kong AI goed in is
Waar Kong AI vastloopt
Naarmate het AI-gebruik groeit, worden deze tekortkomingen zichtbaarder. Kostentoewijzing, modelselectiestrategieën en AI-specifieke governance moeten buiten de gateway worden geregeld, vaak binnen de applicatiecode zelf.
Kernconclusie: Kong AI is effectief als API-gateway, maar AI blijft een secundair aandachtspunt in plaats van een native abstractie.
2. Portkey: LLM Gateway op applicatieniveau
Portkey is een AI-gateway die specifiek is ontworpen voor LLM-applicaties. In plaats van AI-verzoeken te behandelen als generieke HTTP-calls, introduceert Portkey prompt- en modelbewuste routing en observability.
Waar Portkey goed in is
Waar Portkey tekortschiet
Het ontwerp van Portkey is bewust gericht op applicaties, wat beperkingen met zich meebrengt op enterprise-schaal
Wanneer AI een gedeelde interne functionaliteit wordt in plaats van een functie van een enkele applicatie, vereisen deze beperkingen vaak aanvullende infrastructuurlagen.
Het beste voor: LLM-applicaties van een enkel team die naar vroege productie gaan.
3. LiteLLM: Developer-First Open-Source Gateway
LiteLLM is een open-source LLM gateway die een uniforme, OpenAI-compatibele API biedt voor toegang tot tientallen modelproviders.
Waar LiteLLM goed in is
Waar LiteLLM tekortschiet
Het beste voor: LiteLLM is een effectief instappunt, maar vereist aanzienlijke uitbreidingen voor gereguleerde of multi-team omgevingen.
Lees ook: Portkey vs LiteLLM
4. AWS Bedrock: Serverless Model-API's
AWS Bedrock biedt beheerde, serverless toegang tot fundamentmodellen van providers zoals Anthropic en Amazon. Het abstraheert de infrastructuur volledig en factureert zuiver op basis van tokengebruik.
Waar AWS Bedrock goed in is
Verborgen valkuilen van AWS Bedrock
Deze valkuilen verrassen teams vaak zodra workloads verschuiven van experimenten naar langdurig productiegebruik.
Kernconclusie: Bedrock is geoptimaliseerd voor snelheid en eenvoud, niet voor kostenefficiëntie of controle op de lange termijn.
5. AWS SageMaker: Beheerde ML-infrastructuur
SageMaker biedt een uitgebreide suite voor het trainen, finetunen en deployen van machine learning-modellen. In tegenstelling tot Bedrock stelt het infrastructuurkeuzes rechtstreeks beschikbaar aan gebruikers.
Waar AWS SageMaker goed in is
Nadelen van AWS SageMaker
Kernconclusie: SageMaker biedt controle, maar ten koste van operationele eenvoud.
6. Databricks: Het Lakehouse ML-platform
Databricks benadert AI vanuit een data-first perspectief en integreert ML- en GenAI-functionaliteiten in zijn Lakehouse-architectuur.
Waar Databricks goed in is
Waar Databricks tekortschiet
Kernconclusie: Databricks uitblinkt in data engineering, niet in AI-serving.
De rode draad: Gateways zonder governance
Bij het vergelijken van Kong vs LiteLLM, Portkey en zelfs Bedrock komt hetzelfde probleem naar voren: ze beheren verzoeken, geen AI-systemen.
Bij alle gateways en beheerde diensten keert een terugkerend probleem terug: de meeste tools richten zich op verzoeken, niet op systemen.
Ze beantwoorden vragen zoals:
Ze hebben moeite met:
Dit zijn vraagstukken op infrastructuurniveau.
TrueFoundry bevindt zich in een andere laag van de stack. In plaats van zich uitsluitend te richten op API-routing of beheerde diensten, behandelt het AI-workloads — modellen, agents, services en jobs — als eersteklas infrastructuurobjecten. Hiermee verplaatst de verantwoordelijkheid zich van applicatiecode naar het platform zelf.
De TrueFoundry AI Gateway is gebouwd volgens de volgende kernprincipes:
Dit betekent dat de AI Gateway een onderdeel is van een groter systeem, waardoor ondernemingen hun AI-toepassingen naadloos kunnen opschalen.
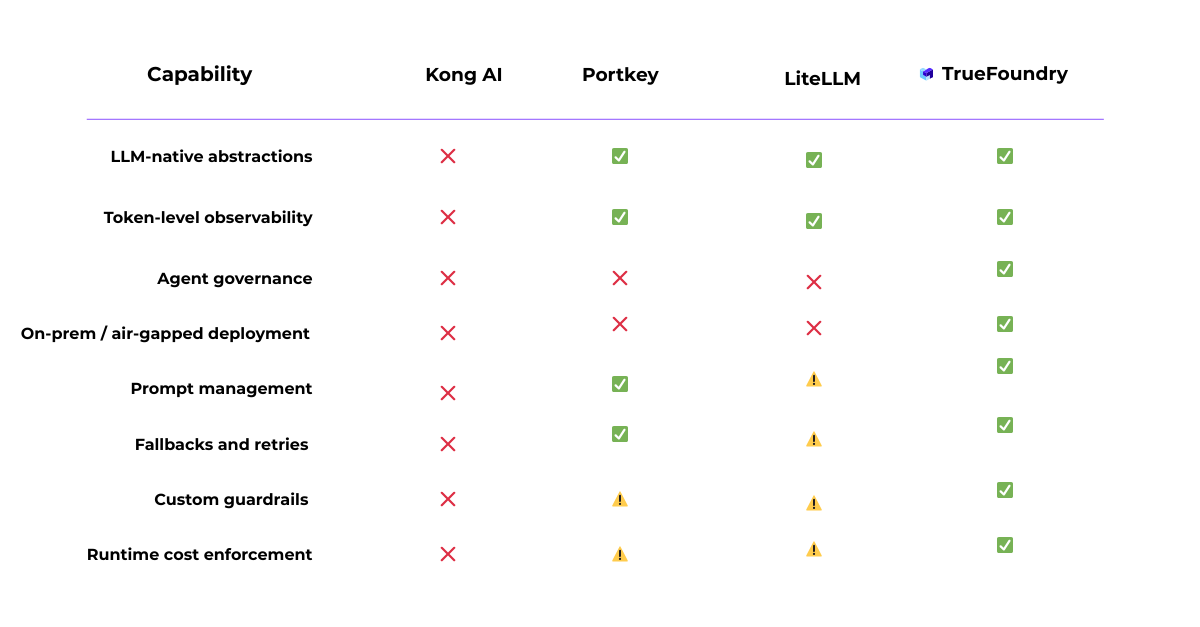
Hier is het evaluatiekader voor het voorstel-template
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Geünificeerde API & Routing | |||
| Geünificeerd OpenAI-compatibel eindpunt | Is de gateway-API compatibel met de /v1/chat/completions- en /v1/responses-formaten van OpenAI, wat consistente toegang biedt tot verschillende modellen via een gestandaardiseerde interface? | Must-have | ✅ Ondersteund: OpenAI-compatibel eindpunt voor alle providers. |
| Provider- en modeldekking | Ondersteunt het toonaangevende providers zoals OpenAI, Azure OpenAI, Amazon Bedrock, Anthropic, Gemini, Groq, plus self-hosted modellen? | Must-have | ✅ Ondersteund: 1000+ LLM's voor hosted en self-hosted providers. |
| Snelheid van model-onboarding | Hoe snel kunnen nieuwe modellen (OpenAI-compatibele en niet-standaard API's) worden toegevoegd zonder code-aanpassingen? | Must-have | ✅ Ondersteund: configuratiegestuurde onboarding binnen enkele minuten. |
| Multimodale ondersteuning | Ondersteunt de gateway tekst, vision, audio, afbeeldingsgeneratie en embeddings via een enkele interface? | Afhankelijk van use-case | ✅ Ondersteund: chat, embeddings, afbeeldingen, audio, rerank en realtime API's. |
| Routing, load balancing, fallback | Kunnen verzoeken worden gerouteerd op basis van model, provider, latency, prioriteit, gewicht, regio en foutstatus met automatische retries? | Must-have | ✅ Ondersteund: load balancing, fallbacks, gewogen en op latency gebaseerde routing. |
| Model wisselen zonder code-aanpassing | Wordt het wisselen van model ondersteund via headers of configuraties zonder de clientcode te wijzigen? | Must-have | ✅ Ondersteund: op headers en configuratie gebaseerd wisselen van model. |

De TrueFoundry AI Gateway wordt cruciaal wanneer AI-gebruik verder gaat dan geïsoleerde applicaties en een gedeelde, productie-kritische functionaliteit wordt. In dat stadium gaan de uitdagingen vaak minder over individuele model-calls en meer over operationele consistentie over teams en omgevingen heen.
Dit is hoe TrueFoundry's AI Gateway verschilt van andere oplossingen:
Veel AI-tools richten zich op zaken op verzoekniveau, zoals routing, retries en basis-observability. Dit is meestal voldoende in een vroeg stadium.
Naarmate het gebruik groeit, beginnen modellen en agents zich echter meer te gedragen als langdurige services. Teams hebben duidelijker eigenaarschap, levenscyclusbeheer en operationele grenzen nodig. TrueFoundry is ontworpen om AI-workloads — modellen, services en jobs — te beheren als infrastructuurcomponenten met gedefinieerde deployment- en runtime-eigenschappen.
In veel stacks worden toegangsbeheer en gebruiks-policies geconfigureerd op applicatie- of SDK-niveau. Naverloop van tijd kan dit leiden tot inconsistentie naarmate het aantal services groeit.
TrueFoundry past controls toe op omgevingsniveau, waarbij development, staging en productie standaard gescheiden zijn. Policies die op deze laag zijn gedefinieerd, zijn uniform van toepassing op alle workloads die binnen een omgeving zijn geïmplementeerd, wat de afhankelijkheid van configuraties per applicatie vermindert.
AI-kosten stijgen vaak door concurrency, retries of achtergrond-workloads in plaats van door individuele verzoeken. TrueFoundry pakt dit aan door tijdens de uitvoering limieten te stellen aan concurrency, doorvoer en bronnenverbruik.
Dit stelt organisaties in staat om gedeelde infrastructuur voorspelbaarder te beheren naarmate het gebruik schaalt.
Hoewel metrieken op token-niveau nuttig zijn, verklaren ze het systeemgedrag in productie niet volledig. TrueFoundry relateert signalen op verzoekniveau aan infrastructuurmetrieken zoals CPU/GPU-belasting en autoscaling-gedrag, waardoor teams inzicht krijgen in de oorzaken van prestaties en kosten binnen hun context.
Sommige organisaties werken onder beperkingen die private netwerken, on-premise deployments of strikte datalokalisatie vereisen. TrueFoundry is ontworpen om in deze omgevingen te draaien, waardoor AI-workloads kunnen worden beheerd met dezelfde infrastructuurstandaarden die elders in de organisatie worden toegepast.
Conclusie
Het huidige AI-platformlandschap weerspiegelt de snelheid waarmee generatieve AI zich heeft ontwikkeld. Veel tools lossen echte problemen op — routing, modeltoegang, observability of training — maar doen dit vanuit verschillende vertrekpunten. Als gevolg hiervan dekt geen enkele categorie van nature de volledige reeks operationele vereisten af die ontstaan zodra AI productie-kritisch wordt.
TrueFoundry biedt de meeste waarde wanneer AI-workloads met dezelfde discipline moeten worden beheerd als andere productiesystemen — over omgevingen heen, onder gedeelde policies en met voorspelbaar bronnengebruik.
Ondernemingen die leveranciers vergelijken, beginnen vaak met het zoeken naar de best LLM gateway, maar het echte verschil zit in hoe goed het platform AI-systemen op schaal beheert. Begrijpen waar elk platform past, en waar de ontwerpveronderstellingen beginnen te wankelen, is essentieel bij het evalueren van de best AI gateway voor enterprise-deployments. De juiste keuze hangt minder af van individuele functies en meer van de manier waarop een organisatie verwacht dat haar AI-gebruik zich in de loop van de tijd zal ontwikkelen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



The best AI gateway depends on the organization's specific requirements. TrueFoundry's AI Gateway stands out for enterprises needing multi-provider routing, centralized governance, cost tracking, and MCP integration in a single platform. Other strong options include LiteLLM for open-source flexibility and Kong AI Gateway for teams already invested in Kong's API management ecosystem.
Een AI Gateway is een middleware-laag die zich tussen applicaties en LLM-providers (zoals OpenAI, Anthropic, of Google) bevindt. De architectuur omvat doorgaans een routing engine die verzoeken naar het juiste model stuurt, een beleidslaag voor het afdwingen van rate limits en toegangscontroles, een observability-stack voor logging en kostentracking, en een cachinglaag om overbodige API-aanroepen te verminderen. Deze architectuur stelt organisaties in staat multi-model-implementaties vanuit één control plane te beheren.
TrueFoundry differentiates itself by combining AI gateway capabilities with a full ML infrastructure platform including model serving, fine-tuning, and MCP server management in a unified solution. Its AI Gateway offers enterprise-grade features such as per-team budget controls, audit logging, model fallback routing, and native MCP support, making it particularly well-suited for organizations looking to govern and scale Claude Code and other agentic AI deployments



Het laatste nieuws, artikelen en bronnen in je inbox



















