



November 14, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La CI/CD est discrètement devenue l'un des postes de dépenses LLM les plus importants dans les organisations d'ingénierie modernes. Un seul agent de revue de sécurité déclenché sur chaque pull request peut dépenser trois fois plus que l'ensemble de la charge de travail IA orientée client de l'équipe d'ingénierie. La facture du fournisseur vous donne le total. Elle ne vous indique pas quel pipeline, quel dépôt ou quelle étape d'agent en est la cause. Sans cette attribution, la seule réponse possible est une interdiction générale, et la perte de productivité dépasse le dépassement de coût initial.
L'AI Gateway de TrueFoundry comble ce fossé grâce à trois primitives : un marquage obligatoire des métadonnées sur chaque requête, des budgets hiérarchiques par centre de coûts avec des seuils souples, restreints et stricts, et une prévision glissante P95 qui révèle les dépassements avant qu'ils n'atteignent la facture. Les configurations de cet article sont réelles, réutilisables par copier-coller et basées sur les schémas officiels de TrueFoundry pour la limitation de budget et la limitation de débit.
Les applications LLM en production fonctionnent sur le trafic utilisateur, qui est limité par le nombre d'utilisateurs et la fréquence des requêtes. Les pipelines CI/CD fonctionnent sur du trafic machine — agents automatisés, tâches planifiées, régressions périodiques, revues de chaque PR. La structure des coûts est fondamentalement différente. Une équipe de 50 ingénieurs, ouvrant chacun 15 pull requests par semaine, génère 750 invocations LLM pilotées par PR par semaine avant même que quiconque ne touche à une fonctionnalité orientée client. Chaque invocation peut enchaîner quatre ou cinq étapes d'agent. Chaque étape peut effectuer plusieurs appels de modèles avec des contextes de plusieurs milliers de tokens. Le multiplicateur de débit entre l'IA orientée client et l'IA en CI/CD est couramment de 10x à 100x.
La première fois que la direction de l'ingénierie s'en aperçoit, c'est lorsque la finance transmet une facture dont le montant ne correspond à la représentation mentale de personne. L'histoire se répète dans chaque organisation qui déploie une CI/CD basée sur des agents sans observabilité : octobre est une petite facture, novembre est moyenne, décembre est le mois qui provoque une réunion de la direction. Le schéma est suffisamment récurrent pour que les équipes plateforme le traitent comme une prévision opérationnelle, et non comme une surprise.
La facture du fournisseur — Anthropic, OpenAI, Bedrock ou tout autre — détaille les coûts par modèle et par type de token. Elle ne peut pas les détailler par dépôt, par pipeline ou par étape d'agent, car le fournisseur ne sait pas ce que ces concepts signifient au sein de votre organisation d'ingénierie. Cette information réside dans les métadonnées de vos requêtes, que le fournisseur ne voit jamais. Du point de vue du fournisseur, les 847 millions de tokens d'entrée Sonnet du mois dernier semblent tous identiques ; de votre point de vue, 80 % d'entre eux provenaient d'un seul pipeline incontrôlé que vous auriez limité dès la première semaine si vous l'aviez su.
L'écart entre ce que la finance reçoit et ce que l'ingénierie doit déboguer est la raison structurelle pour laquelle les projets de gouvernance des coûts stagnent. La finance reçoit une facture. L'ingénierie reçoit la même facture sans aucune ventilation. Sans un registre par charge de travail, la réponse se résume à « arrêtez de dépenser dans l'IA pendant deux semaines le temps que nous comprenions », ce qui détruit le gain de productivité que l'IA générait.
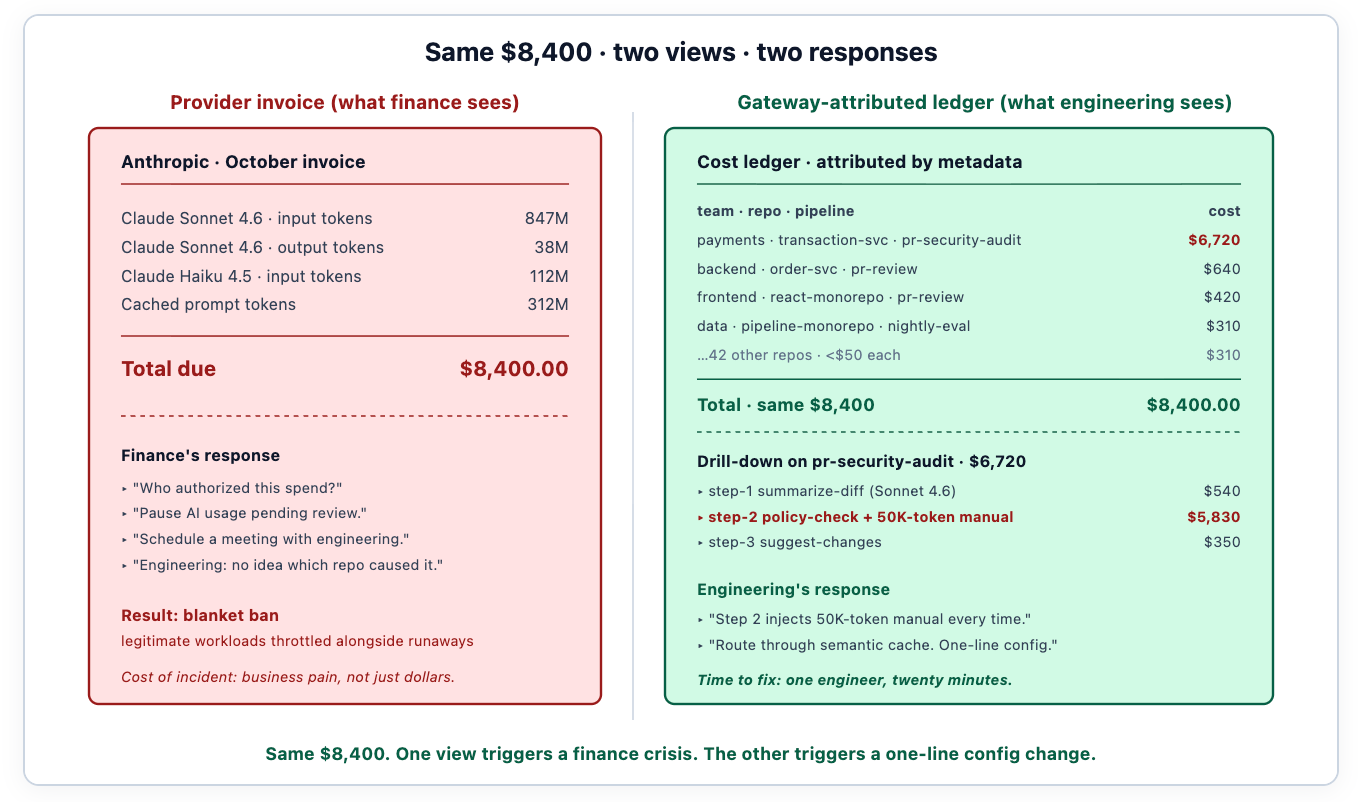
Le même montant génère des réponses opposées selon que l'équipe dispose ou non de l'attribution. Sans elle, la réponse est structurelle : interdire la dépense, faire remonter à la direction, planifier une réunion qui sera désagréable pour tout le monde. Avec elle, la réponse réside dans un ingénieur qui consulte le registre des coûts, identifie que l'étape 2 d'un pipeline spécifique injecte un manuel de règles de 50 000 tokens dans chaque prompt, et rédigera une modification de configuration d'une ligne pour router l'étape 2 via le cache sémantique. Même facture. Résultat différent.
La base de l'attribution des coûts est le marquage obligatoire au niveau de la passerelle. Les pipelines CI/CD doivent injecter une identité sur chaque requête — en identifiant l'équipe, le dépôt, le pipeline, l'étape de l'agent et le centre de coûts responsable. Selon la documentation sur les en-têtes de requête de TrueFoundry, cette identité voyage dans un en-tête unique — x-tfy-metadata — dont la valeur est un objet JSON sous forme de chaîne avec des clés et des valeurs de type chaîne, limitées à 128 caractères par valeur. Les champs contenus dans le JSON sont des conventions choisies par l'équipe plateforme ; ce ne sont pas des en-têtes HTTP à part entière.
Une requête correctement formée provenant d'un pipeline CI/CD ressemble à ceci sur le réseau :
La documentation de la passerelle énumère exactement neuf en-têtes de requête personnalisés acceptés : Authorization, x-tfy-metadata, x-tfy-provider-name, x-tfy-strict-openai, x-tfy-retry-config, x-tfy-request-timeout, x-tfy-ttft-timeout-ms, x-tfy-logging-config et x-tfy-mcp-headers. L'identité personnalisée — team, repo, pipeline, cost_center, run_id, tout autre élément défini par l'équipe plateforme — réside strictement à l'intérieur de la valeur JSON de x-tfy-metadata, et non sous forme d'en-têtes séparés. C'est le seul contrat reconnu par la passerelle. Les équipes qui inventent des en-têtes x-tfy-* supplémentaires voient ces derniers ignorés en silence — les métadonnées n'atteignent jamais les couches de suivi des coûts ou de politique, les tableaux de bord perdent l'attribution et les journaux d'audit ne conservent que le jeton porteur. Un seul en-tête contenant du JSON, telle est la règle.
La visibilité sans application des règles est un tableau de bord sur lequel personne n'agit. La passerelle rattache des budgets hiérarchiques, appliqués mathématiquement, à chaque centre de coûts produit par le marquage. L'équipe de la plateforme de paiement obtient, par exemple, 500 $ par semaine pour ses flux de travail d'agents CI/CD ; ce budget est appliqué au niveau de la passerelle, sur le chemin de la requête, avec trois seuils qui déclenchent des réponses différentes.
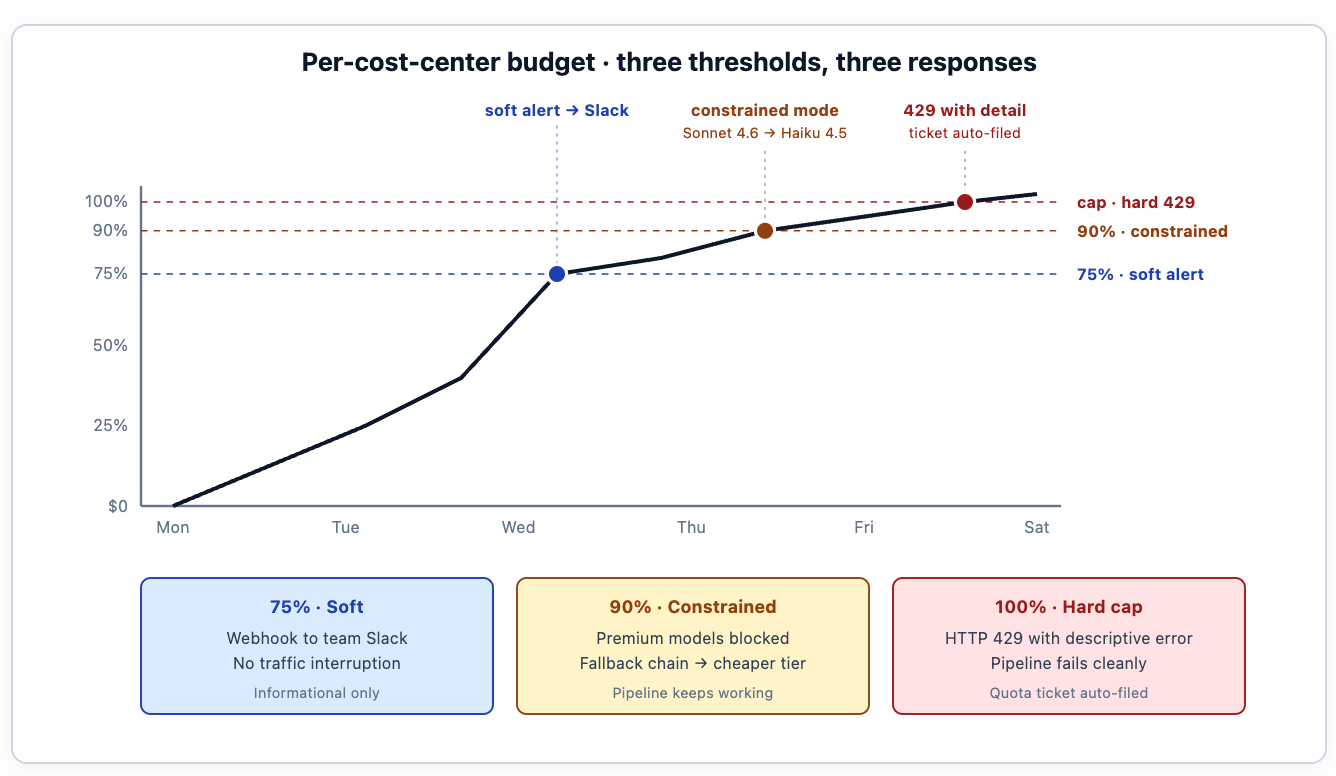
75 % du plafond — alerte souple. Un webhook publie un message sur le canal Slack de l'équipe : « Vous avez consommé les trois quarts du budget IA de cette semaine. » Aucune interruption de trafic. Le responsable de la charge de travail voit l'alerte pendant ses heures de travail normales et peut décider d'ajuster le comportement de l'agent, de demander une augmentation de quota ou de ne rien faire si la dépense est légitime.
90 % — mode restreint. Les modèles premium (Sonnet 4.6, Opus 4.7, GPT-4o) sont bloqués ; la passerelle route de façon transparente les requêtes vers des solutions de secours moins chères (Haiku 4.5, GPT-4o-mini) via la configuration de secours de modèles virtuels, de sorte que les pipelines continuent de fonctionner pendant que les coûts se stabilisent. La chaîne de secours est définie dans une configuration de routage séparée — la configuration budgétaire déclenche la contrainte, la configuration de routage exécute le remplacement. L'application voit un en-tête indiquant quel modèle a réellement servi la requête, et la qualité peut différer pour certaines charges de travail spécifiques.
100 % — plafond strict. La passerelle rejette les requêtes ultérieures avec une erreur HTTP 429. Voici la structure que les équipes plateforme conçoivent généralement pour le corps de l'erreur — la réponse par défaut de la passerelle est concise, et l'équipe l'enrichit via sa couche d'enrobage avec le contexte du centre de coûts, le lien vers le tableau de bord et le flux de demande de quota :
Le corps de l'erreur fait partie de la conception. Un pipeline qui atteint son budget doit savoir quoi faire ensuite — lire les journaux, soumettre une demande de quota — sans que le développeur n'ait à solliciter l'équipe plateforme pour obtenir du contexte. Les exécuteurs CI interprètent le code 429 comme un signal de temporisation (backoff) standard ; le build échoue proprement avec un message exploitable plutôt que de planter de manière confuse. Ce même schéma 429 s'associe aux couches de limitation de débit et de détection des dérivess, ainsi une charge de travail qui dépasse plusieurs contrôles reçoit un chemin d'échec cohérent plutôt qu'une cascade d'erreurs non liées.
Les données marquées qui alimentent Grafana permettent à l'équipe plateforme de construire des tableaux de bord qui répondent aux questions de responsabilité au lieu de générer du bruit agrégé supplémentaire. Au lieu d'observer un pic et de demander « qui a fait ça ? », le tableau de bord vous indique déjà qu'à 02:00 UTC, l'équipe frontend a déployé un nouvel agent sur react-monorepo qui a halluciné une dépendance manquante et est entré dans une boucle de résolution de 400 étapes. Les champs de métadonnées apparaissent sous forme d'étiquettes Prometheus ; les requêtes PromQL standards produisent des ventilations par équipe, par dépôt et par pipeline ; les tableaux de bord Grafana standards les visualisent.
Ce type de contexte opérationnel transforme les coûts d'un problème financier en un problème d'ingénierie. Une fois que l'équipe constate que le passage de l'étape initiale de résumé de code de Sonnet 4.6 à Haiku 4.5 réduit le coût de cette étape de 80 % sans affecter la qualité de la revue de la PR, elle effectue la modification. Le débat sur les plafonds budgétaires n'a pas besoin d'avoir lieu dans un comité de pilotage — les données constituent l'argument, et la modification est la réponse.
Un tableau de bord utile comporte trois vues : un coût agrégé par centre de coûts au fil du temps, une analyse détaillée par pipeline et par étape, et une vue d'anomalies qui fait remonter automatiquement les dérives de coûts. Les deux premières sont les vues opérationnelles ; la troisième est la vue d'avertissement précoce qui trouve les dérives avant que le disjoncteur budgétaire ne se déclenche. Les traces OpenTelemetry émises par la passerelle incluent le modèle, le nombre de tokens, les champs de métadonnées et le montant en dollars par appel — les outils existants de Grafana gèrent le reste.
L'agrégation des données de marquage rend également les prévisions réalisables. Les charges de travail basées sur des agents fonctionnent par pics — les lourdes tâches périodiques de CI dominent la facture — c'est pourquoi les simples moyennes mobiles sous-estiment systématiquement les dépenses. Une équipe qui a dépensé en moyenne 40 $/jour pendant trois semaines et 400 $ lors de l'exécution d'un train de versions un mercredi a une moyenne mobile de 51 $/jour ; ses dépenses réelles de fin de mois, si elle déploie deux autres trains de versions, dépasseront les 2 000 $.
La passerelle exécute une prévision glissante P95 sur 7 jours par dépôt et par centre de coûts. La valeur P95 capture le risque de pic qu'une moyenne lisserait, en projetant les dépenses de fin de mois avec suffisamment d'avance pour ajuster les budgets, augmenter les quotas ou arrêter un pipeline défaillant avant que la finance n'en soit surprise. « Surprise » est le mot clé : il s'agit d'une prévision conçue pour éviter d'en produire. Lorsque la prévision indique qu'une équipe est en passe de dépasser son budget mensuel de 30 %, l'équipe dispose de deux ou trois semaines de marge pour agir avant que le plafond strict ne se déclenche.
La prévision apparaît dans le même tableau de bord Grafana que les dépenses en temps réel, avec la projection tracée à côté de la courbe historique. Les équipes plateforme qui revoient la prévision chaque semaine repèrent le schéma qui produirait la crise budgétaire du trimestre suivant ; les équipes qui ne révisent pas la prévision découvrent le problème de la même manière que d'habitude — via la finance.
Ce qui suit est une synthèse illustrative tirée de schémas que cette équipe a observés sur des déploiements clients réels — les chiffres sont stylisés pour rendre les mécanismes clairs, mais le mode de défaillance et la correction sont tous deux courants.
Une organisation de 50 ingénieurs a conçu un agent de revue Claude Code en trois étapes qui s'exécutait sur chaque pull request : (1) résumer le diff, (2) réviser le diff par rapport aux règles de sécurité via un serveur de documentation MCP, (3) suggérer des modifications de code. Une architecture sensée, un flux de travail utile, pas de signal d'alarme évident. L'agent est passé en production début septembre.
À raison d'environ 15 PR par ingénieur et par semaine, en tenant compte des retentatives et du coût de la fenêtre de contexte liée à l'injection de fichiers entiers dans les prompts, l'agent consommait en moyenne environ 400 000 tokens d'entrée par PR. La facture du premier mois pour l'automatisation CI/CD s'est élevée à 8 400 $. La facture est arrivée le 5 octobre. Le message Slack de la finance est arrivé le 6 octobre. La conversation qui a produit cet article est arrivée le 7 octobre.
L'attribution a révélé la cause réelle quelques minutes après la connexion de l'équipe au tableau de bord des coûts. L'étape 2 injectait un manuel de sécurité de 50 000 tokens dans chaque prompt, sur chaque PR, que le diff touche ou non du code soumis aux règles de sécurité. Le modèle lisait l'intégralité du manuel pour évaluer s'il devait l'appliquer ; la réponse était « non, c'est une modification CSS » 80 % du temps ; le coût était payé à chaque fois. Le routage de l'étape 2 via le cache sémantique de la passerelle — basé sur l'extension de fichier du diff et la signature du contenu — a réduit le surcoût de tokens de 92 %. Même couverture. Mêmes suggestions. Une facture mensuelle inférieure à 800 $.
Sans attribution, la réponse aurait été une interdiction générale de Sonnet pour les flux de travail CI. L'ingénierie aurait subi la baisse de productivité ; la finance aurait obtenu une victoire politique ; personne n'aurait compris quel était le problème réel. Avec l'attribution, la réponse a été une modification de configuration d'une seule ligne. C'est la différence que font les données.
Deux configurations de politiques TrueFoundry prennent en charge l'ensemble de ce schéma : une configuration budgétaire qui applique des plafonds financiers avec des modes d'audit et des alertes, et une configuration de limitation de débit qui applique des quotas de tokens et de requêtes. Les deux sont de vrais schémas — copiez-les directement dans l'onglet Policies de l'AI Gateway. La référence du schéma se trouve dans la documentation officielle pour la Limitation de budget et la Limitation de débit. Deux points sémantiques sont à assimiler avant de les déployer :
D'abord, concernant l'ordre des règles et le suivi superposé : conformément à la documentation budgétaire de TrueFoundry, lorsqu'une requête correspond à plusieurs règles, le coût est suivi par rapport à chaque règle correspondante, mais seule la première règle correspondante contrôle la décision d'autorisation/blocage. L'ordre des règles dans le YAML détermine la priorité — il n'y a pas de champ de priorité séparé. Dans la configuration ci-dessous, une requête de la plateforme de paiement correspond à la fois à la règle spécifique payments-platform-weekly (première correspondance, contrôle la décision de blocage) et à la règle générale per-user-daily-default (suit également le coût, utile pour la visibilité par développeur). C'est intentionnel : le tableau de bord affiche à la fois l'utilisation au niveau du centre de coûts et au niveau de l'utilisateur pour la même requête.
Ensuite, concernant le nommage du compte fournisseur : les identifiants de modèles comme anthropic-main/claude-opus-4-7 suivent le format <provider-account-name>/<model-id>, où le nom du compte fournisseur est celui que l'administrateur de l'espace de travail a attribué au compte Anthropic dans AI Gateway → Models. La partie model-id est fixée par Anthropic. Vérifiez le nom du compte fournisseur dans votre instance TrueFoundry spécifique avant de copier-coller.
Configuration budgétaire — application de montants en dollars par centre de coûts, avec mode d'audit pour un déploiement sécurisé :
Configuration de limitation de débit — quotas de requêtes et de tokens, la deuxième ligne de défense :
Les deux configurations sont contrôlées en version, révisées dans des pull requests et appliquées via le même flux GitOps que l'équipe plateforme utilise pour le reste de la passerelle. Les schémas ci-dessus correspondent exactement à la documentation officielle — chaque champ, chaque valeur, chaque entrée rate_limit_applies_per est documenté et pris en charge. Les équipes en charge des charges de travail proposent des modifications pour leurs propres entrées de centre de coûts via des pull requests ; l'équipe plateforme approuve ; la passerelle intègre le changement lors de sa boucle de réconciliation suivante.
Le paramètre audit_mode: true sur la règle par utilisateur par défaut est la primitive de sécurité qu'il convient de souligner. Pendant le déploiement, le mode audit permet à la règle de suivre les dépenses réelles et de déclencher des alertes sans bloquer aucun trafic. Après une semaine ou deux d'observation, l'équipe passe audit_mode à false pour appliquer la règle. C'est le chemin le moins risqué vers un système d'application de budget de niveau production : observer d'abord, appliquer ensuite, et ne jamais appliquer un chiffre que vous n'avez pas encore vu le trafic réel produire.
Le cas d'une organisation unique où chaque centre de coûts appartient à une seule entreprise est le plus simple. De nombreux déploiements d'IA en production sont multi-locataires (multi-tenant) : un produit SaaS B2B propose des fonctionnalités d'IA à ses propres clients, et la facture d'IA doit être allouée par locataire avant que l'entreprise ne sache quels clients sont rentables et lesquels sont subventionnés. La couche d'attribution des coûts est ce qui permet de répondre à cette question.
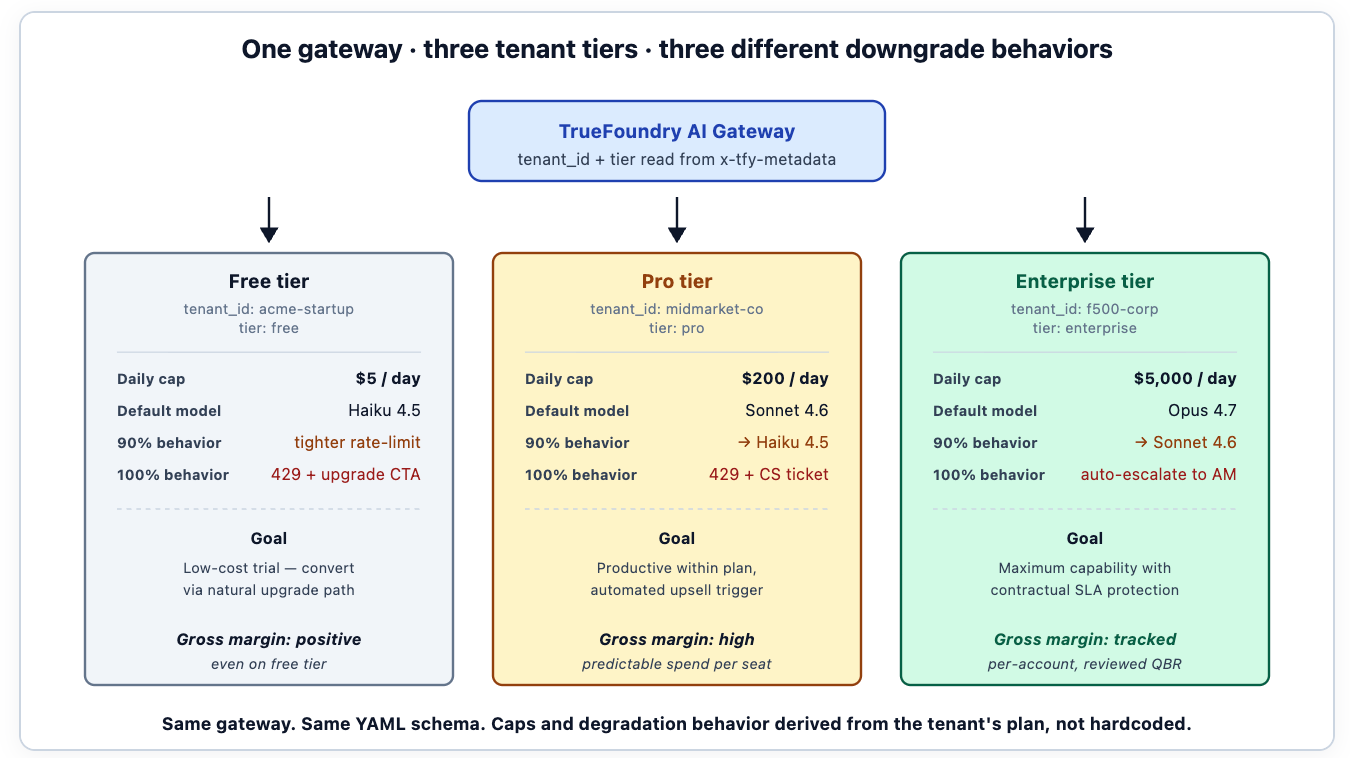
Le schéma qui fonctionne consiste à ajouter tenant_id comme un autre champ sur l'enveloppe de métadonnées. La clé d'agrégation pour la budgétisation devient la combinaison de tenant_id et de la charge de travail ; le tableau de bord prend en charge une vue par locataire aux côtés de la vue par centre de coûts ; le rapport FinOps associe les données de la passerelle au système de facturation de l'entreprise pour produire la marge brute par locataire. Un locataire dont la consommation d'IA dépasse le niveau de son forfait apparaît dans le tableau de bord avant que l'équipe Customer Success n'ait à engager la discussion.
Les plafonds budgétaires adaptés au niveau de forfait constituent le deuxième schéma. Le locataire du niveau gratuit obtient un plafond plus strict que le locataire du niveau entreprise ; les plafonds sont dérivés du forfait du locataire plutôt que codés en dur. Lorsqu'un locataire monte en gamme, le plafond se met à jour sans modification de code — le forfait est une métadonnée sur l'identité du locataire, le plafond est une fonction du forfait. Les équipes qui codent les plafonds en dur finissent par les réécrire à chaque changement de tarif ; les équipes qui les dérivent des données du locataire héritent automatiquement du bon comportement.
Le troisième schéma : des modes dégradés mais fonctionnels par niveau. Le mode restreint du locataire du niveau entreprise peut le maintenir sur un modèle de pointe avec une limitation de débit plus stricte ; le mode restreint du locataire du niveau gratuit peut le router vers un petit modèle hébergé en interne. Même passerelle, chaînes de dégradation différentes, exprimées sous forme de configuration. La structure tarifaire de l'entreprise SaaS B2B apparaît directement dans la configuration de la passerelle — ce qui est sa place légitime.
Quatre erreurs de configuration apparaissent régulièrement lors des premières tentatives d'attribution des coûts par les équipes. Chacune produit un mode de défaillance différent qu'il convient de connaître.
Marquage optionnel. L'équipe configure la passerelle pour journaliser les requêtes non marquées mais les laisse passer, dans l'intention d'appliquer la règle plus tard. « Plus tard » n'arrive jamais, et le tableau de bord accumule une catégorie « inconnu » qui croît mois après mois. Au moment où l'application est activée, la moitié du trafic se trouve dans cette catégorie inconnue et la bloquer devient politiquement coûteux. La solution consiste à imposer le rejet dès la deuxième semaine, lorsque le trafic visible est encore faible.
Invention d'en-têtes supplémentaires. Les équipes tentent parfois de répartir l'identité sur plusieurs en-têtes — des en-têtes séparés pour l'équipe, le dépôt, le centre de coûts, etc. La passerelle ne reconnaît que neuf en-têtes personnalisés, énumérés plus haut dans cet article ; le reste est ignoré en silence. Toute l'identité personnalisée doit se trouver dans la valeur JSON de x-tfy-metadata. Un seul en-tête. Du JSON à l'intérieur. Le contrat est documenté et la passerelle l'applique.
Centres de coûts couvrant plusieurs équipes. Un centre de coûts comme shared-infra ressemble à une abstraction propre mais ne produit aucune responsabilité d'ingénierie lorsqu'il y a un dépassement — il n'y a pas d'équipe à contacter. Les centres de coûts doivent correspondre au périmètre de responsabilité d'une équipe ; le travail partagé appartient à un centre de coûts « plateforme » détenu par l'équipe plateforme, et non à un périmètre partagé flou.
Plafonds stricts sans erreurs descriptives. Une erreur 429 avec un corps {"error": "rate_limited"} n'apporte aucune information exploitable au développeur. Une erreur 429 avec le centre de coûts, le plafond, le plus grand consommateur et un lien vers le flux de demande de quota lui indique exactement quoi faire. Le schéma du corps de l'erreur est l'une des parties les plus ajustées de la configuration dans tout déploiement mature.
L'attribution des coûts est l'un des déploiements les plus sûrs dans l'espace des plateformes IA car le mode de défaillance d'un « budget mal calibré » est limité (certains pipelines atteignent le mode restreint de manière inattendue) et le mode de défaillance « sans attribution » est catastrophique (la facture incontrôlée). La bonne séquence est d'observer d'abord, puis d'appliquer ensuite.

Semaine 1 — Marquage en mode audit. Mettez à jour les modèles CI pour injecter x-tfy-metadata sur chaque requête. Configurez la passerelle pour enregistrer les requêtes non marquées comme des avertissements tout en les laissant passer. Le tableau de bord à la fin de la semaine indique à l'équipe la structure naturelle de ses dépenses : quels pipelines dominent, quels centres de coûts sont les plus grands utilisateurs, quels modèles les charges de travail préfèrent réellement. Ce sont ces données qui permettent d'étalonner le budget.
Semaine 2 — Rejeter les requêtes non étiquetées. Basculez la gateway pour renvoyer un code 400 pour les requêtes non étiquetées. Les modèles CI mis à jour lors de la semaine 1 sont les seuls clients légitimes ; toute réponse 400 indique soit un modèle non mis à jour, soit un appelant hors bande qui doit être traité. À la fin de la semaine 2, chaque requête en production est étiquetée.
Semaines 3-4 — Configurer les budgets en mode audit. Déployez la configuration budgétaire avec audit_mode: true sur l'ensemble des règles. Définissez les seuils tolérants (75 %) par rapport au P95 observé des dépenses légitimes, augmenté d'une marge. Des alertes sont envoyées sur les canaux Slack des équipes ; aucune action d'application n'est encore déclenchée. L'équipe observe quels seuils sont raisonnables et lesquels nécessitent un ajustement. Certains workloads sembleront suivre une trajectoire incontrôlée ; un ou deux le seront réellement, et l'équipe pourra intervenir avant le déclenchement des mesures restrictives.
Semaine 5 — Activer l'application des règles. Faiates passer audit_mode à false sur les règles budgétaires. Activez la chaîne de rétrogradation à 90 % (configuration de fallback associée avec des virtual models) et le plafond strict à 100 %. La chaîne de rétrogradation est le changement le plus sujet à débat avec les propriétaires de workloads — certaines équipes préfèrent nettement le "fail fast" à un fonctionnement "dégradé mais opérationnel" pour leurs pipelines. Rendez la chaîne configurable par centre de coûts dès le départ, afin que chaque équipe puisse choisir le comportement qu'elle préfère.
Semaine 6+ — Prévisions et rythme de revue. Activez la prévision P95 à 7 jours. Mettez en place une revue hebdomadaire de la prévision par rapport aux budgets avec l'équipe platform. Les nouveaux centres de coûts reçoivent par défaut des plafonds de départ raisonnables basés sur l'utilisation initiale observée ; les modifications de quota s'effectuent via des pull requests sur la configuration. Le système fonctionne comme une infrastructure, et non comme un projet ponctuel.
La couche d'imputation des coûts nécessite une frontière de responsabilité claire car les données qu'elle produit touchent simultanément le périmètre de plusieurs parties prenantes. La bonne répartition est la suivante : l'équipe platform possède la couche, les équipes applicatives possèdent leurs budgets, la finance possède la vision stratégique, et la direction engineering possède la politique.
L'équipe platform gère la gateway, la discipline d'étiquetage, le moteur de budget et les prévisions. Elle examine et approuve les demandes de quota, ajuste les chaînes de rétrogradation en fonction des retours sur la qualité fournis par les propriétaires de workloads, et traite les alertes déclenchées en dehors des heures d'ouverture. Son rôle est d'assurer le bon fonctionnement du système ; elle ne décide pas du coût de chaque workload.
Les équipes applicatives possèdent leur propre entrée de centre de coûts dans la configuration. Elles proposent des modifications budgétaires via des pull requests ; elles ajustent leurs pipelines lorsqu'elles atteignent des alertes tolérantes ; elles choisissent entre un comportement dégradé mais opérationnel et le fail fast en réponse au plafond strict. L'équipe platform approuve ; l'équipe applicative exécute.
La finance et la direction engineering exploitent les vues agrégées. Les réunions de clôture mensuelle citent des centres de coûts et des pipelines spécifiques plutôt que des chiffres globaux. La planification trimestrielle utilise la prévision pour projeter les dépenses d'infrastructure AI ; les cycles budgétaires deviennent prévisibles au lieu d'être réactifs. C'est cette propriété qui fait des dépenses AI une ligne budgétisée plutôt qu'une surprise récurrente.
L'étiquetage obligatoire ne remplace pas le prompt engineering. Un workload qui injecte un manuel de 50 000 tokens dans chaque prompt verra l'étiquette lui indiquer exactement quel workload est coûteux ; cela ne lui dira pas comment y remédier. La correction — un manuel plus court, un cache, une recherche plus ciblée, un modèle mieux adapté à la tâche — constitue le travail d'engineering qui fait suite à l'imputation. Le dashboard est le diagnostic ; la correction est le traitement.
Les budgets hiérarchiques ne garantissent pas à eux seuls le contrôle des coûts. Une équipe dont le budget est augmenté chaque fois qu'elle atteint son plafond finit par considérer que "le plafond n'existe pas". La discipline réside dans le rythme de revue budgétaire, et non dans le mécanisme technique. Les équipes platform qui approuvent chaque demande de quota perdent le levier que le budget était censé fournir.
Et l'imputation des coûts au niveau de la gateway n'est pas la réponse adaptée à toutes les organisations. Les équipes dont les dépenses AI totales sont suffisamment faibles pour que l'investissement en engineering dépasse les économies réalisées devraient d'abord choisir un autre problème à résoudre ; les équipes dont les outils FinOps existants produisent déjà une imputation par workload à partir des données des fournisseurs cloud n'ont pas besoin d'un système parallèle au niveau de la gateway. Ce modèle convient aux organisations dont les dépenses AI ont grandi plus vite que leur visibilité sur celles-ci — généralement à partir de 5 000 $/mois de dépenses auprès des fournisseurs, là où le coût d'un seul incident incontrôlé dépasse le coût de construction de cette couche. En dessous de ce seuil, le calcul économique, même pour une gateway clé en main comme celle de TrueFoundry, n'est pas toujours rentable ; l'équipe a intérêt à maintenir les dépenses au sein d'une ou deux applications bien surveillées et à déployer la couche lorsque la croissance le justifiera.
Les deux, simultanément. Les dollars s'alignent sur la finance et la planification opérationnelle. Les tokens sont la métrique d'engineering qui permet à l'équipe de déboguer l'efficacité des prompts — un workload dont la consommation de tokens double alors que son coût en dollars reste stable (parce que le modèle est devenu moins cher) mérite d'être examiné du point de vue de l'engineering, même si la finance ne s'en aperçoit pas. La gateway suit les deux ; la finance possède les dashboards en dollars, l'engineering possède les dashboards en tokens, et la gateway est la source unique de vérité pour l'un comme pour l'autre.
Le pipeline reçoit une erreur 429 avec le corps d'erreur descriptif présenté ci-dessus et un lien vers le dashboard budgétaire. Les runners CI interprètent le code 429 comme un signal classique de temporisation (backoff) ; le build échoue proprement avec un message exploitable au lieu de planter de manière confuse. Les demandes d'augmentation de quota sont soumises sous forme de tickets standards à l'équipe platform via le lien fourni dans le corps de l'erreur. La dernière étape réussie du pipeline est préservée ; la reprise après l'augmentation de quota ne réexécute pas le travail déjà payé.
En pratique, non. TrueFoundry fournit des wrappers d'SDK qui injectent automatiquement l'enveloppe de métadonnées à partir des variables d'environnement déjà définies par les runners CI, de sorte que les développeurs n'ont jamais à modifier les en-têtes. Le coût unique consiste à mettre à jour les modèles de pipeline de l'équipe ; le coût récurrent est nul. Le bénéfice récurrent réside dans la précision de chaque dashboard qui en découle.
Utilisez un champ workflow_id stable à l'intérieur du JSON x-tfy-metadata — la même valeur pour chaque requête appartenant au même workflow logique. La gateway regroupe les requêtes par workflow_id pour appliquer le budget par workflow. Un workflow avec un plafond de 5 $ peut s'étendre sur des centaines de requêtes ; la gateway suit le total cumulé par rapport à l'identifiant du workflow plutôt qu'à la requête individuelle.
Elle correspond à la facture du fournisseur à environ 1 % près pour les coûts de tokens d'entrée et de sortie ; le léger écart provient des arrondis et des surcharges appliquées par le fournisseur (remises sur volume, différences régionales) que la gateway ne peut pas voir au moment de la requête. Pour la plupart des besoins de planification, les chiffres de la gateway sont suffisamment précis ; pour un rapprochement de niveau comptable, la facture du fournisseur reste la source de vérité, la gateway fournissant la ventilation par workload. La documentation sur le suivi des coûts de TrueFoundry décrit à la fois les modes de tarification publique (tarifs publiés par le fournisseur) et de tarification privée (contrats personnalisés).
Les budgets sont définis par centre de coûts ; le dérapage d'une équipe ne consomme que son propre budget. Le plafond strict stoppe le dérapage avant qu'il ne puisse affecter les autres équipes. La règle de plafonnement au niveau du modèle dans la configuration de rate limit (l'exemple opus-per-cost-center-daily) sert de garde-fou dans le cas où plusieurs équipes agiraient de manière inappropriée simultanément ou si l'imputation elle-même était erronée ; elle intervient au-dessus de la couche définie par centre de coûts.
Les travaux inter-équipes sont rares mais existent bel et bien. L'approche la plus propre consiste à définir un centre de coûts pour "initiatives partagées" détenu par l'équipe platform, avec des règles de réimputation explicites documentées dans le README de la gateway. L'étiquetage reste à valeur unique — la requête appartient à un seul centre de coûts à l'exécution —, mais l'équipe platform peut répartir les dépenses entre les équipes participantes à la fin de chaque période de facturation via les données de coûts exportées, comme décrit dans la documentation sur le suivi des coûts.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception


















