



November 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Oracle Cloud Infrastructure (OCI) adopte une approche du calcul IA différente de celle des hyperscalers centrés sur les VM. La couche différenciée est le bare-metal : les instances GPU d'OCI — comme BM.GPU.H100.8 — fonctionnent sans aucun surcoût d'hyperviseur et se connectent via des SmartNIC NVIDIA ConnectX sur un réseau de cluster personnalisé RDMA over Converged Ethernet (RoCE v2).
Ce plafond de performances s'accompagne de considérations opérationnelles lors de la gestion de l'infrastructure cloud sur du bare-metal. Le bare-metal signifie que vous êtes désormais responsable de la couche que les VM abstraient généralement : les pilotes GPU et la pile OFED, la planification en tenant compte des contraintes de topologie du réseau de cluster, la fédération d'identité via OCI IAM, et le choix entre plusieurs options de stockage pour les poids de modèles. Rien de tout cela n'est exotique, mais représente un travail Kubernetes substantiel qui n'apparaît pas sur les offres de VM gérées.
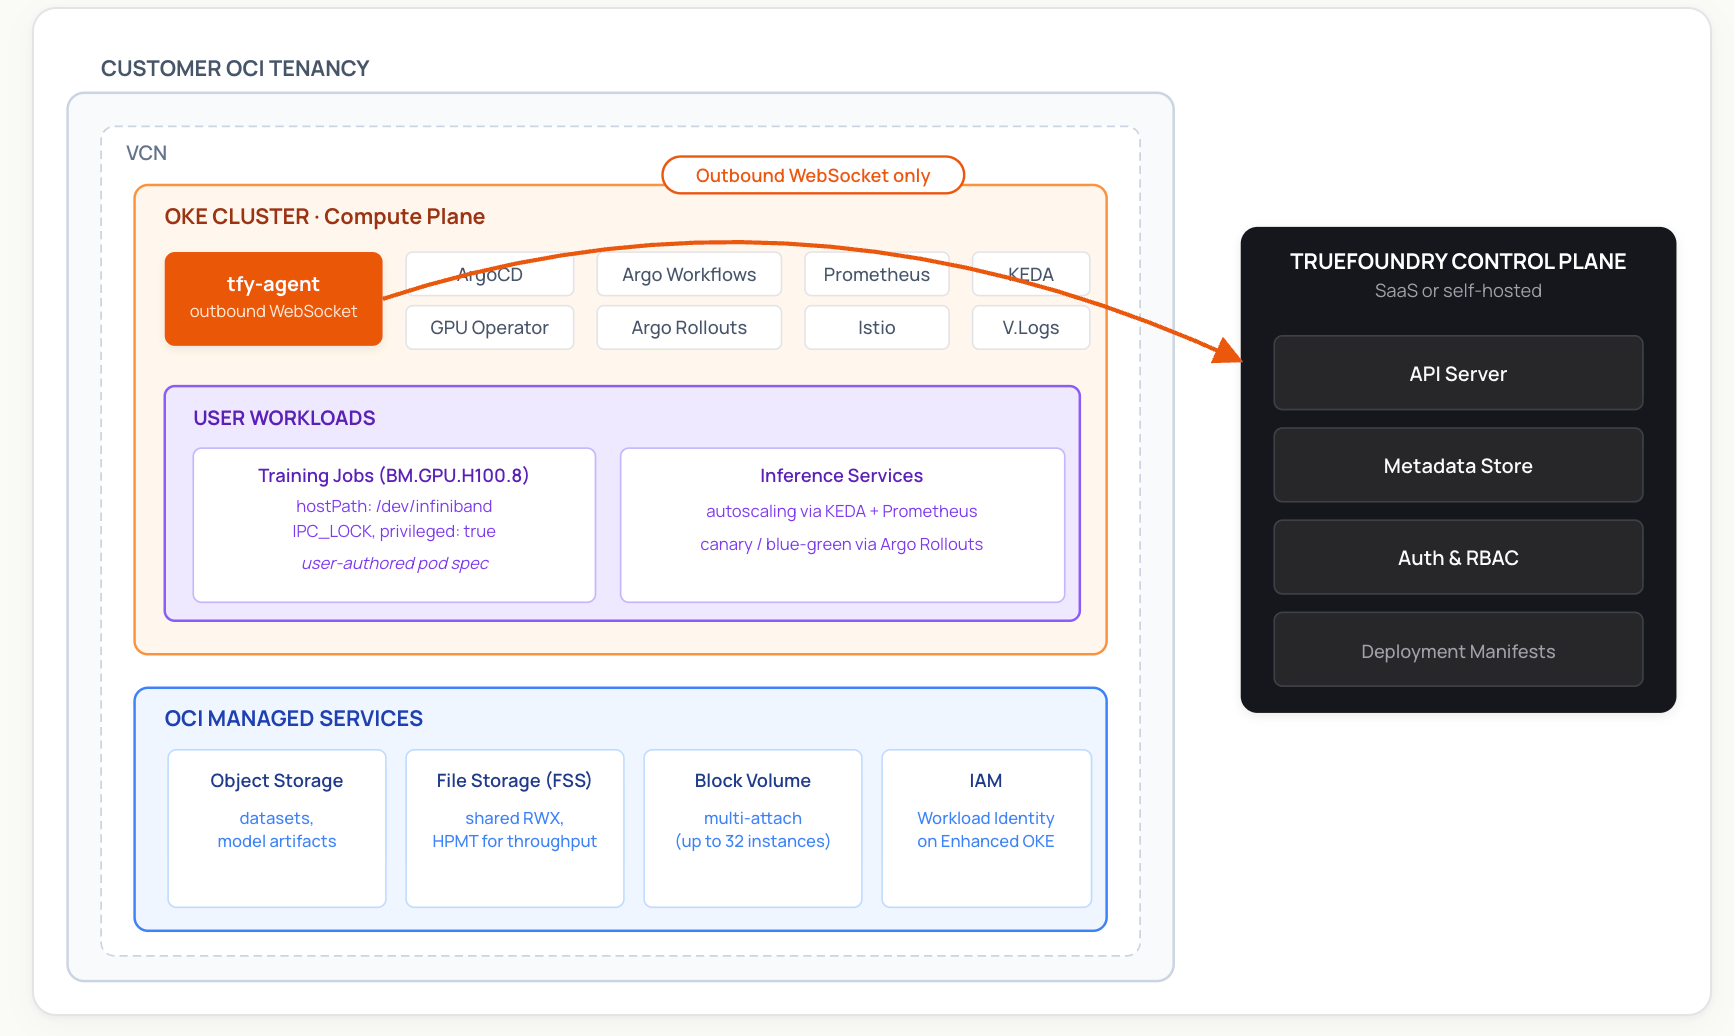
Le rôle de TrueFoundry sur cette pile est d'offrir une couche opérationnelle native à Kubernetes. Le Compute Plane est votre propre cluster Oracle Cloud Infrastructure Kubernetes Engine (OKE) fonctionnant sur le bare-metal d'OCI. La plateforme intègre un ensemble de composants open source et affiliés à la CNCF (ArgoCD, Argo Workflows, NVIDIA GPU Operator, Prometheus, KEDA, Istio, et d'autres) dans un déploiement géré, ajoute une interface utilisateur unifiée ainsi qu'un flux de travail GitOps, et fournit une observabilité sur l'ensemble des services, des jobs et de l'utilisation des GPU. Elle ne remplace pas les primitives OCI — elle s'installe au-dessus d'elles.
Cet article détaille l'architecture obtenue lorsque vous exécutez TrueFoundry sur le bare-metal d'OCI : la séparation control/compute plane, l'intégration de l'entraînement RDMA dans Kubernetes, le fonctionnement de l'identité des charges de travail, et les schémas pratiques pour charger les poids de modèles à grande échelle.
TrueFoundry utilise une architecture à deux plans (split-plane). Le Control Plane (géré par TrueFoundry ou hébergé par vos soins) conserve les métadonnées, le RBAC, le serveur d'API et le magasin de manifestes de déploiement. Le Compute Plane consiste en un ou plusieurs clusters Kubernetes dans votre propre environnement cloud — dans ce cas, un cluster OKE sur le bare-metal d'OCI. Les charges de travail, les poids de modèles et les données clients restent dans votre tenancy.
Le lien entre eux est l'tfy-agent, qui s'exécute sur le cluster du Compute Plane et ouvre un WebSocket sortant uniquement vers le Control Plane. L'agent récupère les manifestes de déploiement et renvoie les mises à jour des ressources Kubernetes. La connexion étant sortante, vous n'avez pas besoin d'ouvrir de ports entrants sur votre VCN ni d'exposer le serveur d'API du cluster à l'Internet public.
Lorsque TrueFoundry configure un Compute Plane, l'agent installe et gère un ensemble de modules complémentaires open source via ArgoCD :
Vous pouvez également utiliser vos propres instances existantes de n'importe lequel de ces composants — TrueFoundry fournit la documentation sur la configuration requise pour coexister avec une installation existante d'ArgoCD, Prometheus ou Istio.
Le réseau de cluster d'OCI est la couche réseau différenciée qui rend possible l'entraînement distribué à grande échelle. Oracle a publié des mesures internes montrant une latence de l'ordre de la microseconde unique dans cette infrastructure — aussi basse que 2 microsecondes pour les clusters à rack unique, et généralement de 2,5 à 9 microseconds sur des superclusters multi-racks — en utilisant RoCE v2 sur des SmartNIC NVIDIA ConnectX. Les chiffres réels en production dépendent de la topologie du cluster, de la taille des messages et de la contention ; l'article First Principles d'Oracle détaille la conception sous-jacente.
Pour utiliser efficacement le RDMA, deux conditions doivent être remplies :
oci.oraclecloud.com/rdma.local_block_id, network_block_id, et hpc_island_id — et le quickstart oci-hpc-oke d'Oracle montre comment les utiliser avec la planification sensible à la topologie de Kueue afin d'obtenir les meilleures performances NCCL. Pour un entraînement fortement couplé, privilégiez le colocalisation des pods au sein d'un même Local Block./dev/infiniband/ (le nom du chemin reflète l'API IB verbs sous-jacente, même si le transport est en RoCE v2 sur Ethernet).Le schéma de pod standard issu du quickstart d'Oracle ressemble à ceci :
Ces privilèges élevés — privileged: true, IPC_LOCK, host networking — sont spécifiques aux charges de travail HPC/RDMA. En production, isolez ces pods dans des namespaces GPU dédiés avec des politiques d'admission (par ex. Pod Security Admission défini sur privileged sur le namespace, restricted ailleurs ; ou une politique OPA/Kyverno basée sur une étiquette) afin que les charges de travail non liées n'héritent pas du même contexte.
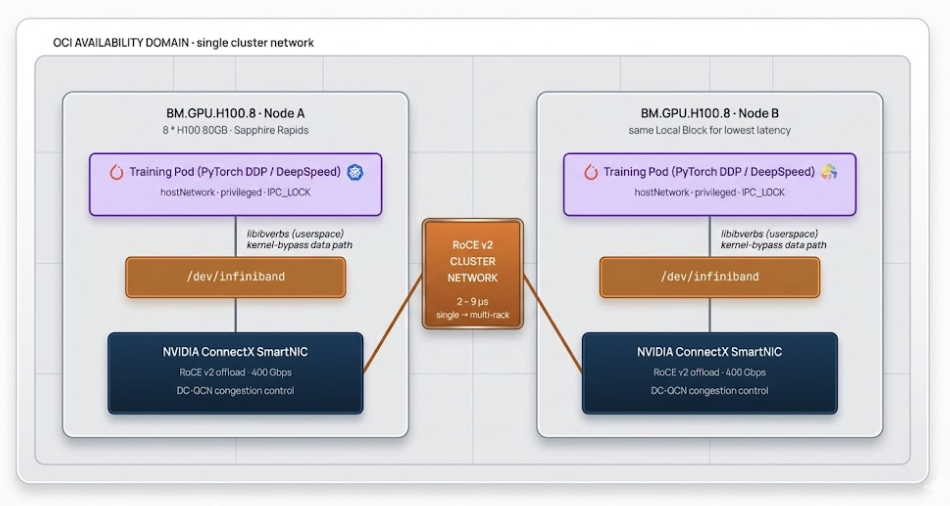
Le rôle de TrueFoundry ici est de faire de l'exécution de ces pods d'entraînement une étape normale du flux de travail de déploiement — vous rédigez la charge de travail, la plateforme la transmet via Argo Workflows, Prometheus collecte les métriques GPU à partir du DCGM Exporter fourni avec le GPU Operator, et ArgoCD versionne les manifestes. Les signaux au niveau de la charge de travail, comme les compteurs NCCL, ne sont collectés que lorsque l'application les expose. Les éléments spécifiques au RDMA (montages hostPath, IPC_LOCK, affinité de topologie) sont configurés dans la spécification de votre job selon le modèle standard ci-dessus ; la plateforme ne remplace pas ces champs, elle déploie ce que vous spécifiez.
Pour l'entraînement distribué multi-nœuds en particulier, vous installerez généralement un opérateur sur le cluster via son chart Helm — MPI Operator pour les exécutions basées sur MPIJob (PyTorch DDP, DeepSpeed, NCCL), Kubeflow Training Operator pour PyTorchJob/TFJob, ou KubeRay pour l'entraînement basé sur Ray. TrueFoundry ne les intègre pas par défaut. Une fois installés, la plateforme déploie les ressources MPIJob/PyTorchJob/RayJob comme n'importe quelle autre charge de travail Kubernetes, avec les mêmes garanties de GitOps et d'observabilité. L'entraînement distribué avec RDMA sur OCI n'est pas une fonctionnalité native de TrueFoundry aujourd'hui — c'est un modèle d'implémentation basé sur les manifestes de référence publiés par Oracle, où la plateforme gère la pile opérationnelle globale plutôt que l'orchestration spécifique au RDMA.
Pour les types de clusters pris en charge, Oracle recommande désormais OKE Workload Identity plutôt que de distribuer des clés d'API à longue durée de vie dans les pods. Le mécanisme fonctionne de manière similaire à AWS IRSA ou GKE Workload Identity : un ServiceAccount Kubernetes est associé à une politique OCI IAM, et le SDK OCI échange le jeton de ServiceAccount projeté du pod contre un jeton d'accès OCI à courte durée de vie lors de l'appel. Il n'y a pas d'identifiant statique dans le pod.
Deux contraintes importantes issues de la documentation d'Oracle :
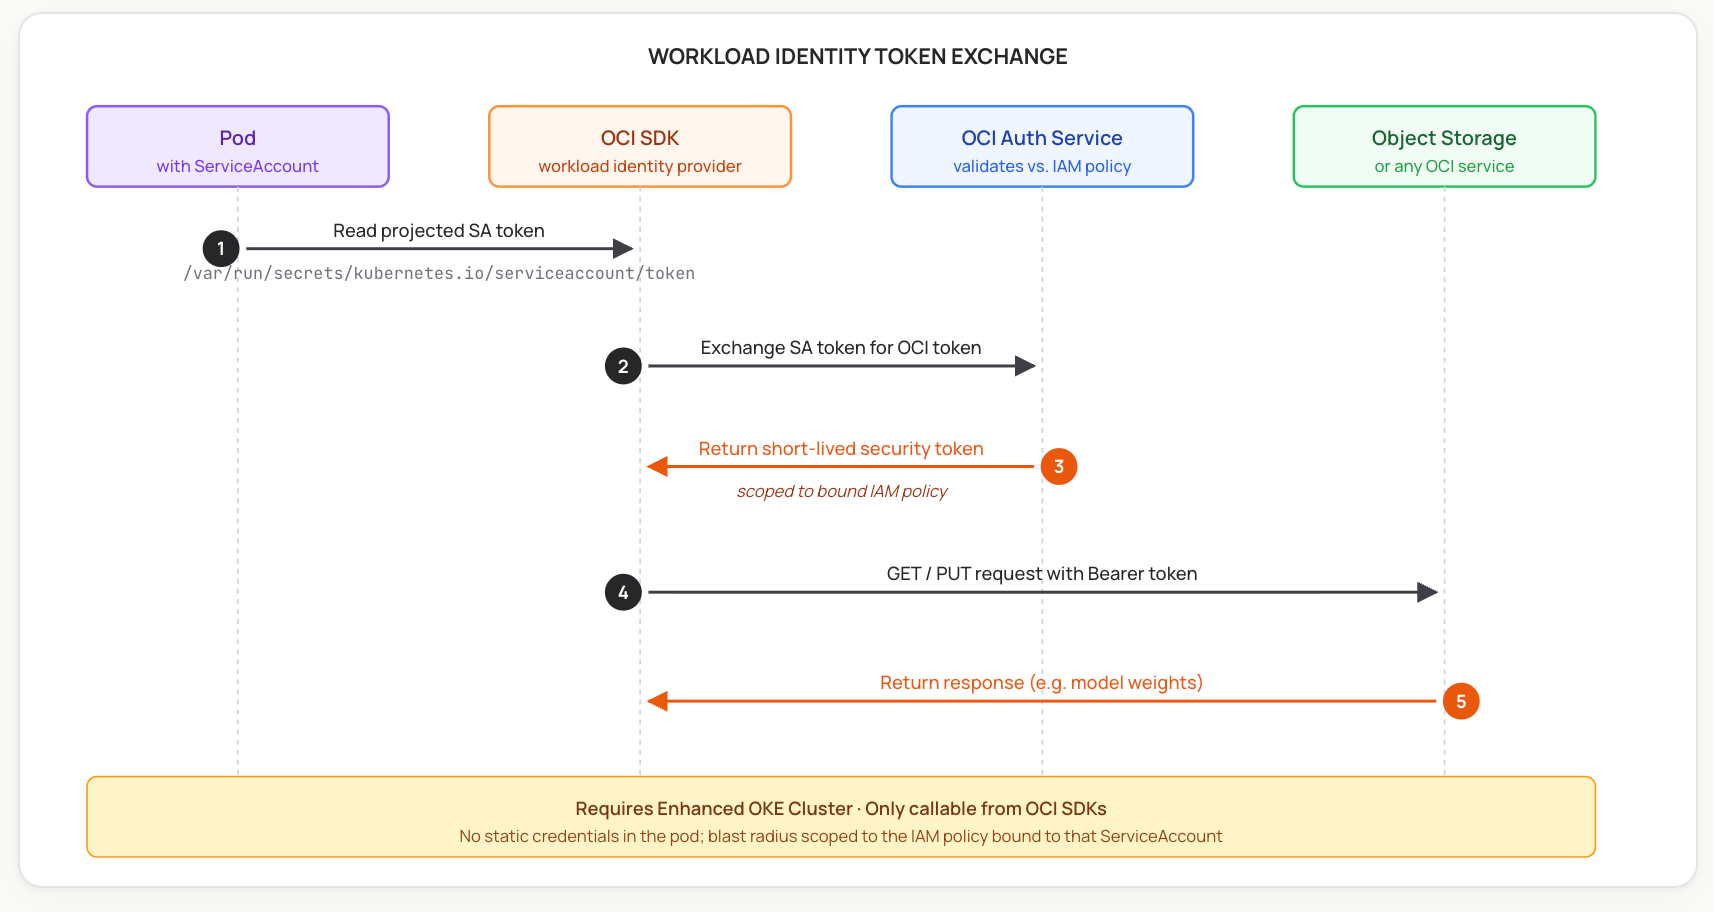
Du côté de Kubernetes, les charges de travail sont liées à des ServiceAccounts restreints à un namespace, et la plateforme peut automatiser leur création dans le cadre du flux de déploiement. Du côté OCI — la politique IAM avec la règle request.principal.type='workload' et les sélecteurs cluster/namespace/serviceaccount — la configuration est effectuée selon le processus standard d'OKE Workload Identity. Une fois les deux côtés configurés, les déploiements nécessitant un accès à OCI obtiennent de manière transparente des jetons à courte durée de vie via le SDK.
Le bare-metal d'OCI vous offre plusieurs choix de stockage pour charger les poids de modèles dans la VRAM. Chaque option présente des compromis, et les abstractions de volumes de TrueFoundry (PVC, montages de volumes, init containers) fonctionnent avec l'ensemble d'entre elles — le choix du schéma dépend de votre charge de travail :
Le bon schéma dépend de la charge de travail. Pour la plupart des exécutions d'entraînement, le NVMe local (pour les données temporaires à accès rapide) combiné à FSS (pour les checkpoints et poids partagés) constitue la configuration de production recommandée. Le multi-attachement Block Volume reste une option pour des cas spécifiques où un artefact immuable unique doit apparaître comme un disque local pour de nombreux lecteurs.
Exécuter des charges de travail GPU bare-metal directement sur des primitives OCI brutes est possible — Oracle fournit une pile HPC basée sur Terraform et le quickstart oci-hpc-oke — mais cela vous laisse la gestion d'une couche opérationnelle Kubernetes conséquente. Le tableau ci-dessous détaille la valeur ajoutée par TrueFoundry.
Le modèle est cohérent : OCI fournit les primitives de calcul bare-metal et de réseau ; TrueFoundry fournit la couche opérationnelle Kubernetes au-dessus.
TrueFoundry sur OCI est une plateforme native Kubernetes fonctionnant sur la pile bare-metal d'Oracle. Le Compute Plane est votre cluster OKE, les charges de travail utilisent le réseau de cluster RoCE v2 d'OCI et Workload Identity via des schémas Kubernetes standards, et la plateforme regroupe la couche opérationnelle open source et CNCF — GitOps, observabilité, autoscaling, opérateur GPU — dans un déploiement géré. Le résultat est une réduction des coûts d'ingénierie de plateforme pour l'exploitation de charges de travail GPU bare-metal, tout en maintenant la transparence des configurations spécifiques à OCI.
Une approche d'évaluation pratique consiste à réaliser un déploiement de référence sur un petit cluster OKE — généralement une ou deux instances BM.GPU plus un pool CPU pour les modules complémentaires de la plateforme — afin de valider l'architecture avant de passer à l'échelle sur un Supercluster complet.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















