



November 16, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Dans le monde des microservices, nous avons perfectionné l'art du CI/CD. Les tests unitaires sont déterministes : assert(2 + 2 == 4). Si les tests passent, le code peut être déployé en toute sécurité.
Dans le monde de l'IA agentique, les "tests unitaires" n'existent pas de la même manière.
Vous ne pouvez pas simplement déployer un agent parce que le code compile. Le prompt est un hyperparamètre de comportement. Une modification mineure du prompt système ("Sois plus concis") peut entraîner une régression massive des capacités de raisonnement ("L'agent a cessé de vérifier les erreurs parce qu'il voulait être concis").
Pour résoudre ce problème, l'Agent Gateway TrueFoundry intègre l'Agent DevOps, une couche spécialisée de gestion du cycle de vie qui apporte le "mode shadow", les "évaluations en ligne" et les "déploiements Canary" à la pile cognitive.
Examinons un exemple concret montrant pourquoi le CI/CD standard échoue pour les agents.
Le scénario : Vous avez un agent de support client en production. Il est poli et utile. Le responsable produit souhaite qu'il soit plus efficace. La modification : Vous mettez à jour le prompt système de "Vous êtes un assistant utile" à "Vous êtes un assistant concis et direct. N'économisez pas vos mots."
Le déploiement standard :
La catastrophe : L'agent interprète "direct" comme "impoli".
Le score de satisfaction client (CSAT) s'effondre. Vous avez dégradé l'image de votre marque parce que vous avez traité une modification cognitive comme une modification de code.
La Gateway TrueFoundry prend en charge le miroir de trafic (mode shadow). Au lieu de remplacer v1 par v2, nous déployons v2 aux côtés de v1.
La Gateway compare ensuite les sorties de manière asynchrone. Vous pouvez exécuter une "évaluation automatique" (en utilisant un modèle juge) pour noter la différence.
Le tableau de bord vous alerte : "Régression de l'empathie v2 détectée." Vous annulez le déploiement avant qu'un seul client ne voie le message impoli.

Avant même qu'un agent n'atteigne le mode shadow, il doit passer le pipeline d'évaluation. Tout comme vous exécutez pytest pour le code, vous devez exécuter deepeval ou ragas pour la cognition.
Le Registry TrueFoundry traite les "jeux de données d'évaluation" comme des citoyens de première classe.
Lorsque vous soumettez une Pull Request, le système CI démarre l'agent et exécute les 500 requêtes. Critères de réussite :
Si le "prompt concis" fait chuter le score de "Fidélité" de 10 %, le build échoue. "Fusion bloquée : l'agent génère des hallucinations."
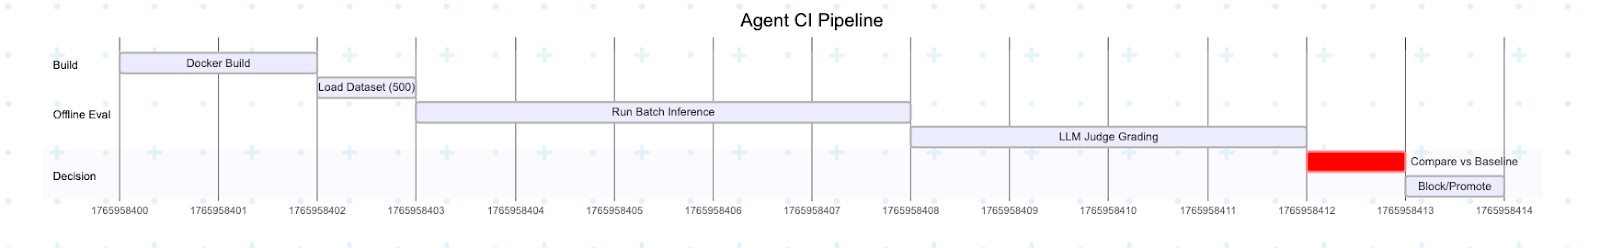
Une fois que l'agent a passé le CI et le mode shadow, vous êtes prêt pour le monde réel. Mais vous ne basculez pas à 100 % immédiatement. Vous utilisez le routage Canary.
La Gateway crée un "service virtuel" qui répartit le trafic selon des pondérations.
La Gateway automatise ce processus. Si le "taux d'erreur" augmente fortement lors de la phase à 10 %, la Gateway peut aider à revenir automatiquement à la v1 et avertir l'ingénieur de garde.
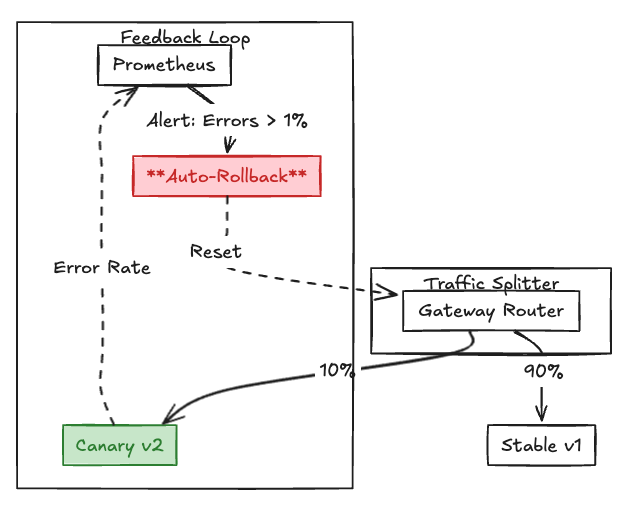
Fig 1 : Exemple de déploiement Canary
L'un des principaux défis de l'Agent DevOps réside dans le fait que le prompt et le code résident souvent dans des emplacements différents.
L'Agent Registry TrueFoundry impose des artefacts immuables. Lors du déploiement, nous regroupons : Artifact ID = Hash(Code + Prompt + Model Config + Dependencies)
Vous ne pouvez pas modifier le prompt de la v1 en production. Vous devez créer la v1.1. Ce versionnage strict garantit la reproductibilité. Si un incident survient, vous savez exactement quelle combinaison Code+Prompt en est la cause.
L'Agent DevOps est la discipline consistant à appliquer la rigueur de l'ingénierie logicielle aux logiciels probabilistes. En passant d'un "déploiement fondé sur l'intuition" (l'impression que c'est plus rapide) à un "déploiement fondé sur des métriques" (le mode shadow a confirmé une précision supérieure de 5 %), TrueFoundry permet aux entreprises d'innover rapidement sur leurs prompts sans altérer la confiance de leurs utilisateurs.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















