



October 10, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
هناك رقمان يسيطران على معظم النقاشات حول المقارنة بين Claude Sonnet 4.5 و GPT-5. تُسعّر شركة Anthropic نموذج Claude Sonnet 4.5 بمبلغ 3 دولارات لكل مليون رمز (token) للمدخلات و15 دولاراً لكل مليون رمز للمخرجات. بينما تُسعّر OpenAI نموذج GPT-5 بمبلغ 1.25 دولار و10 دولارات على التوالي. يتفوق GPT-5 بوضوح في قائمة الأسعار المعلنة.
لا تحسم قوائم الأسعار الكثير في بيئات العمل الفعلية. فعميل البرمجة الذي يعيد تشغيل مهمة فاشلة مرتين يكون قد استهلك بالفعل ما تم توفيره من تكاليف الرموز. كما أن خط معالجة التلخيص الذي يحتوي على بادئة ثابتة مكونة من 40,000 رمز يتصرف بشكل مختلف عن العميل الذي يعيد كتابة السياق في كل خطوة.
لقد تجاوز كلا الموردين هذه الإصدارات أيضاً. تصف OpenAI نموذج GPT-5 بأنه نموذج الاستنتاج السابق الخاص بها وتوجه المطورين إلى GPT-5.6. بينما تضع Anthropic الآن نماذج Claude الأحدث في مرتبة أعلى من Claude Sonnet 4.5 للعديد من احتياجات التطوير. إن الفرق التي تقوم بترميز اسم أي من النموذجين برمجياً (hard-code) تخلق ديوناً تقنية تتعلق بترحيل البيانات في وقت مبكر.
يستهدف كلا النموذجين أعباء عمل الذكاء الاصطناعي التوليدي المتقدمة، على الرغم من اختلاف مراكز التصميم لكل منهما. إن قراءة رؤية كل مورد تقدم للمشترين معلومات أكثر من مجرد لوحة صدارة واحدة. تبدأ المقارنة العملية بين Claude Sonnet 4.5 و GPT-5 بحالة الاستخدام الأساسية.
ركزت Anthropic في نموذج Claude Sonnet 4.5 على أعمال البرمجة المتطلبة، والوكلاء طويلي الأمد، واستخدام الحاسوب. تصف ملاحظة الإطلاق النموذج بأنه إصدار رئيسي للوكلاء في العالم الحقيقي، مع الحفاظ على الأسعار عند نفس مستويات 3 دولارات و15 دولاراً كما في Claude Sonnet 4. معرف نموذج واجهة برمجة التطبيقات (API) هو `claude-sonnet-4-5-20250929`، وهو لقطة ثابتة وليس مؤشراً متغيراً.
GPT-5 هو نموذج الاستنتاج من OpenAI للمهام البرمجية والوكيلية عبر مختلف المجالات، ويتم الوصول إليه من خلال كل من Chat Completions و Responses API. لقطة النموذج هي `gpt-5-2025-08-07`. يقبل النموذج مدخلات نصية وصورية ويعيد نصوصاً، مع دعم لرموز الاستنتاج ومعامل `reasoning.effort` الذي يقبل قيم `minimal` و `low` و `medium` و `high`.
يظهر فرق عملي واحد على الفور. لا يدعم GPT-5 الضبط الدقيق (fine-tuning) أو المخرجات المتوقعة، وفقاً لوثائق نموذج OpenAI. في المقابل، يوفر Claude Sonnet 4.5 عناصر تحكم وكيلية، بما في ذلك التفكير المتداخل من خلال ترويسة تجريبية للاستنتاج المرتبط بالأدوات.
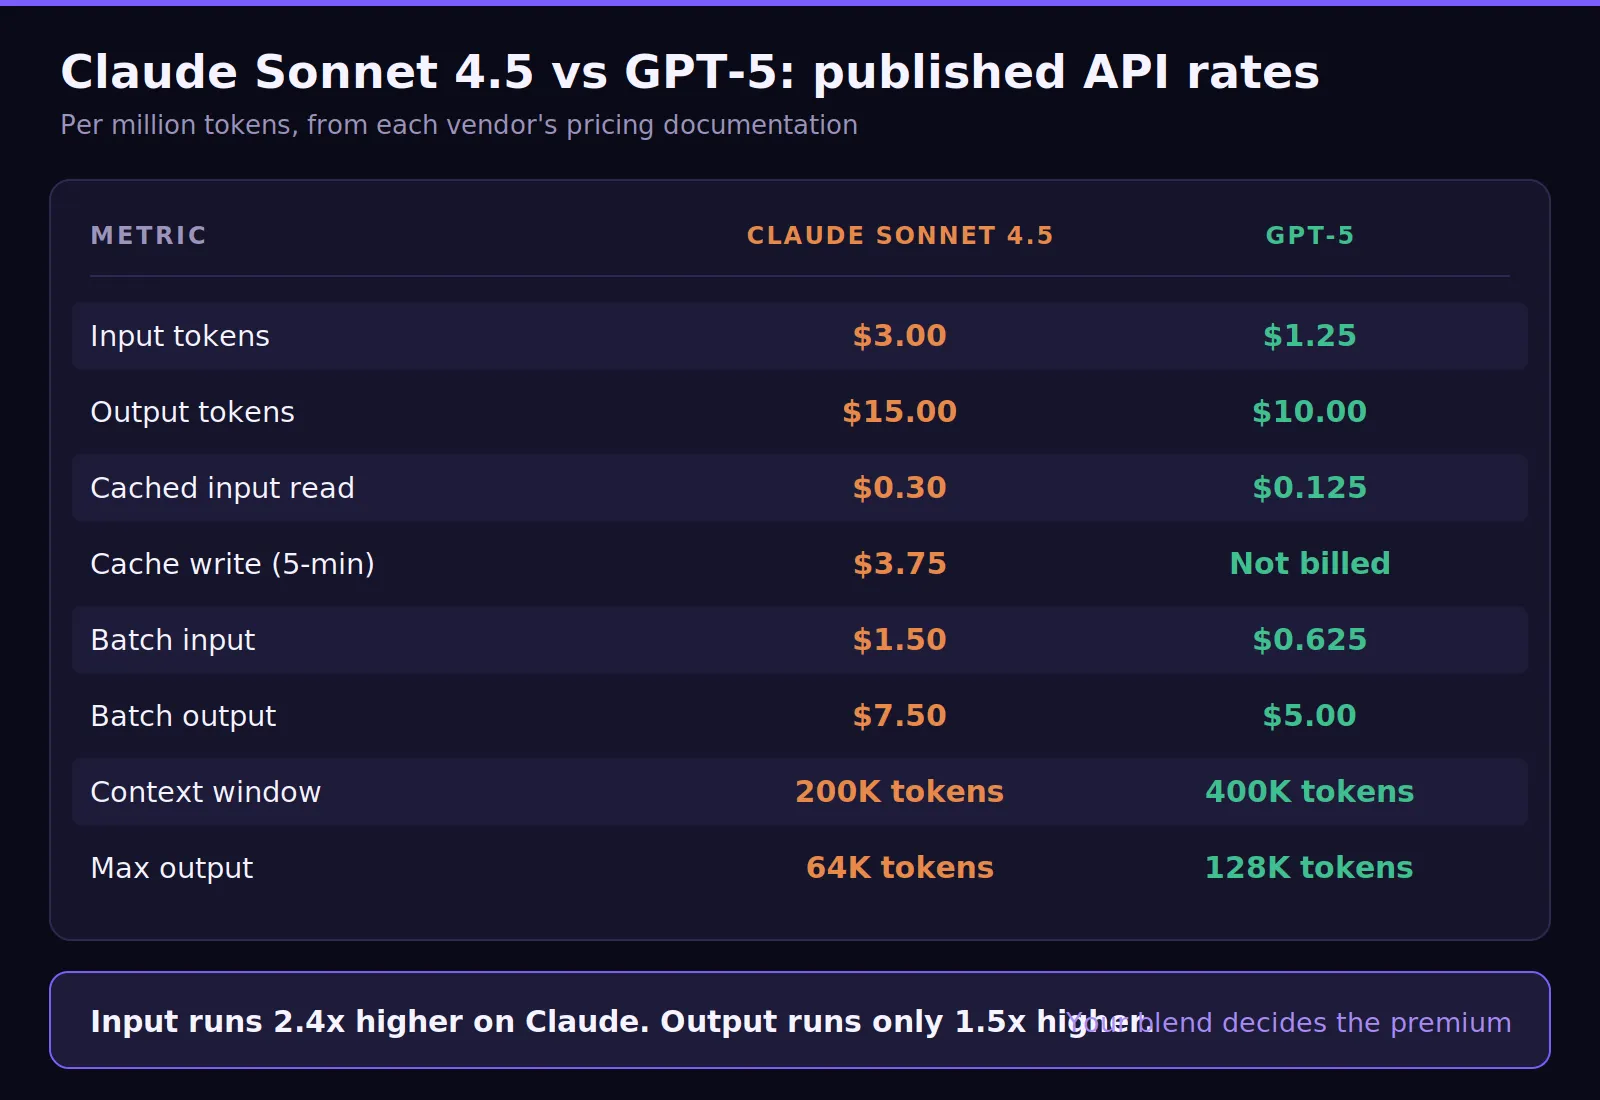
التسعير هو النقطة التي تختلف فيها النماذج بشكل أوضح. كل سعر أدناه مأخوذ من وثائق التسعير المنشورة من قبل الموردين. ومع ذلك، يجب على المشترين نمذجة التكاليف بناءً على عبء العمل، لأن تكاليف المدخلات، وطول المخرجات، وسلوك التخزين المؤقت، وإعادة المحاولات تؤثر على الفاتورة النهائية.
هناك نسبتان تهمان أكثر من الأرقام المطلقة. المدخلات أعلى بـ 2.4 مرة في Claude Sonnet 4.5، والمخرجات أعلى بـ 1.5 مرة. ونظراً لاختلاف هذه الفجوات، فإن التكلفة الإضافية المجمعة تعتمد على عدد الرموز التي يستهلكها وينتجها عبء العمل الخاص بك.
لنفترض إجراء 1,000 طلب بـ 30,000 رمز للمدخلات و2,000 رمز للمخرجات لكل طلب، بدون تخزين مؤقت. تبلغ تكلفة Claude Sonnet 4.5 مبلغ 90.00 دولاراً للمدخلات و30.00 دولاراً للمخرجات. بينما تبلغ تكلفة GPT-5 مبلغ 37.50 دولاراً للمدخلات و20.00 دولاراً للمخرجات.
هذا يؤدي إلى مقارنة بين 120.00 دولاراً مقابل 57.50 دولاراً. يعمل Claude بتكلفة تزيد بـ 2.09 مرة في هذا المثال. ميزة التكلفة لـ GPT-5 واضحة في اقتصاديات الرموز الخام، خاصة لسير عمل الدعم عالي الحجم، والتصنيف، وإدارة المحتوى.
الآن، لنقم بخدمة 90% من تلك المدخلات من التخزين المؤقت. تنخفض تكلفة Claude Sonnet 4.5 إلى 8.10 دولارات للقراءات المخزنة مؤقتاً، و9.00 دولارات للمدخلات الجديدة، و30.00 دولاراً للمخرجات. بينما يصل GPT-5 إلى 27.13 دولاراً. تنخفض التكلفة الإضافية لأن التخزين المؤقت يقلل من جانب المدخلات.
محاسبة التخزين المؤقت هي الفخ الذي يستحق الذكر. تفرض Anthropic رسوماً على عمليات الكتابة في التخزين المؤقت لمدة خمس دقائق بمقدار 1.25 ضعف المدخلات الأساسية. لا تدرج قائمة أسعار GPT-5 المنشورة من OpenAI أي رسوم منفصلة للكتابة في التخزين المؤقت. وبالتالي، يمكن لأسعار رموز الإجابة وتقلبات التخزين المؤقت أن تغير الخيار الأفضل.
التكلفة تجيب على سؤال واحد. أما ما إذا كان نموذج الذكاء الاصطناعي قادراً على الاحتفاظ بالمهمة في الذاكرة لفترة كافية لإنهائها، فهذا يجيب على سؤال أصعب. في المقارنة بين Claude Sonnet 4.5 و GPT-5، تستحق نافذة السياق، وحدود المخرجات، وعناصر تحكم الاستنتاج قراءة متأنية.
من السهل التقليل من شأن فجوة السياق. يقبل GPT-5 ضعف المدخلات ويصدر ضعف الحد الأقصى للمخرجات. وهذا أمر مهم لعمليات إعادة الهيكلة الكبيرة، وصفحات النصوص، وسير العمل المعقد، وتتبعات الوكيل الطويلة التي تصل كمهمة واحدة كبيرة.
يقدم نموذج Sonnet 4.5 ميزة يفتقر إليها GPT-5. إذ يقوم سلوك الوعي بالسياق لدى Anthropic بإدراج الميزانية المتبقية للنموذج مباشرة في الطلب، وذلك عبر `<budget:token_budget>200000</budget:token_budget>` في مطالبة النظام، مع ظهور `<system_warning>` متجدد بعد كل استدعاء للأداة. وبذلك، تعتمد خطط النموذج على السعة المتبقية الفعلية بدلاً من الاعتماد على التقديرات.
يدعم Claude Sonnet 4.5 أيضاً التفكير المتداخل مع الأدوات من خلال ترويسة تجريبية (beta header). يساعد هذا في مهام التفكير المعقدة، والتحليل العميق، والتحليل العلمي، والتحليل المالي، والمنطق الرياضي، والعمليات التجارية الوكيلة حيث تؤثر نتائج الأداة على الخطوة التالية.
يدعم GPT-5 مستويات جهد التفكير من خلال الوضع القياسي وإعدادات التفكير الأعلى. وهذا يمنح الفرق طريقة إضافية لضبط زمن الاستجابة، وجودة التحليل، وكفاءة التكلفة. ومع ذلك، يظل اختيار النموذج المناسب رهناً بالجودة المقاسة داخل عبء العمل المستهدف.
يمكن أن تساعد المعايير القياسية في التقييم الأولي، لكن لا ينبغي لها أن تحل محل الاختبارات الداخلية. تنشر Artificial Analysis مؤشر الذكاء ومقارنات النماذج، بينما تغطي مصادر أخرى أداء ART، وذكاء التحليل، ونتائج التفكير المتخصصة. تعامل مع هذه النتائج كإشارات أولية، وليس كدليل نهائي للشراء.
يركز تموضع Anthropic على هندسة البرمجيات، واستخدام الأدوات، والعمل الوكيل طويل الأمد. وهذا يجعل Claude Sonnet 4.5 مناسباً للبرمجة الوكيلة، وتوليد الأكواد، ومراجعة الأكواد، والتشغيل الذاتي. يكتسب النموذج أهمية خاصة عندما تساهم جودته في تقليل دورات المراجعة.
تعامل مع جودة النموذج على أنها مرتبطة بعبء العمل الخاص بك. تقيس معايير البرمجة المهام العامة، بينما يعمل مهندسو شركتك داخل مستودعات خاصة. إن اتفاقيات المستودعات، ورسوم بيانية التبعية، وثقافة المراجعة، وهيكل الاختبار هي التي تحدد ما إذا كان Claude Sonnet سيقدم أداءً متفوقاً.
قم بتشغيل كلا النموذجين على نفس التذاكر الداخلية العشرين، ثم قم بتقييمهما باستخدام معايير ثابتة. احسب المحاولات الفاشلة، والمطالبات المتابعة، وأخطاء الأدوات، وطلبات السحب المقبولة. قد يتفوق نموذج بتكلفة أعلى لكل استدعاء إذا كان يتطلب مراجعات أقل.
نادراً ما تكون المقارنة الأدق هي نتيجة لوحة صدارة عالمية. قد يجد الفريق تفوقاً واضحاً لـ Claude في مستودع معين، وتفوقاً لـ GPT-5 في مستودع آخر. ولهذا السبب يجب أن تأتي الإجابة على المقارنة بين Claude Sonnet 4.5 و GPT-5 من تجارب عملية على أحمال العمل الفعلية.
تأتي أسعار الرموز (tokens) المعلنة لـ GPT-5 أقل من Claude Sonnet 4.5 فيما يخص الإدخال، والإخراج، والقراءات المخزنة مؤقتاً، واستخدام الدفعات. وهذا يغير الحسابات لأحمال العمل الإنتاجية ذات الحجم الكبير. غالباً ما تميل أتمتة الدعم، والتصنيف، وفحوصات جودة اللغة الطبيعية، والأدوات الداخلية نحو استخدام GPT-5.
تساعد نافذة السياق الأكبر التي تبلغ 400,000 رمز في فئة أخرى من أحمال العمل. فقد تتناسب خطوط معالجة المستندات في استدعاء واحد بدلاً من تقسيم الردود ودمجها. عدد أقل من الأجزاء يعني عدداً أقل من عمليات الدمج، وعدد أقل من الإخفاقات، وتقليل التعقيدات التشغيلية.
لا ينبغي للتكلفة وحدها أن تحسم القرار. فجودة المخرجات، وسلوك إعادة المحاولة، ومعدل نجاح التخزين المؤقت، والمراجعة البشرية تؤثر جميعها على الإنفاق الإجمالي. كما أن تاريخ انقطاع المعرفة في GPT-5 يأتي متأخراً عن Claude Sonnet 4.5، وهو أمر قد يهم عند التعامل مع أطر عمل أو واجهات برمجة تطبيقات أو سير عمل مؤسسي أحدث.
قد يناسب GPT-5 أيضاً الجماهير العامة وحالات استخدام منصات الذكاء الاصطناعي الواسعة. ويمكنه دعم محتوى مماثل عبر الدعم الفني، والملخصات، والتحليلات، وسير عمل أنظمة إدارة المحتوى (CMS). أما بالنسبة للربط مع بحث Google، فقد تصبح نماذج مثل Gemini 3 Pro أو Cosmic AI أو غيرها من النماذج المتخصصة مقارنة منفصلة.
تتعامل معظم الفرق مع القرار كخيار ثابت واحد. وهذا عادة ما يكون إطاراً خاطئاً. النسخة الأفضل هي التقسيم حسب عبء العمل، ثم التساؤل عما إذا كان ينبغي لنموذج واحد أن يتولى كل شيء. هذا يجعل المقارنة بين GPT-5 و Claude Sonnet 4.5 أكثر فائدة من الناحية التشغيلية.
اختر Claude Sonnet 4.5 عندما:
اختر GPT-5 عندما:
اختر طبقة نموذج خاضعة للحوكمة عندما:
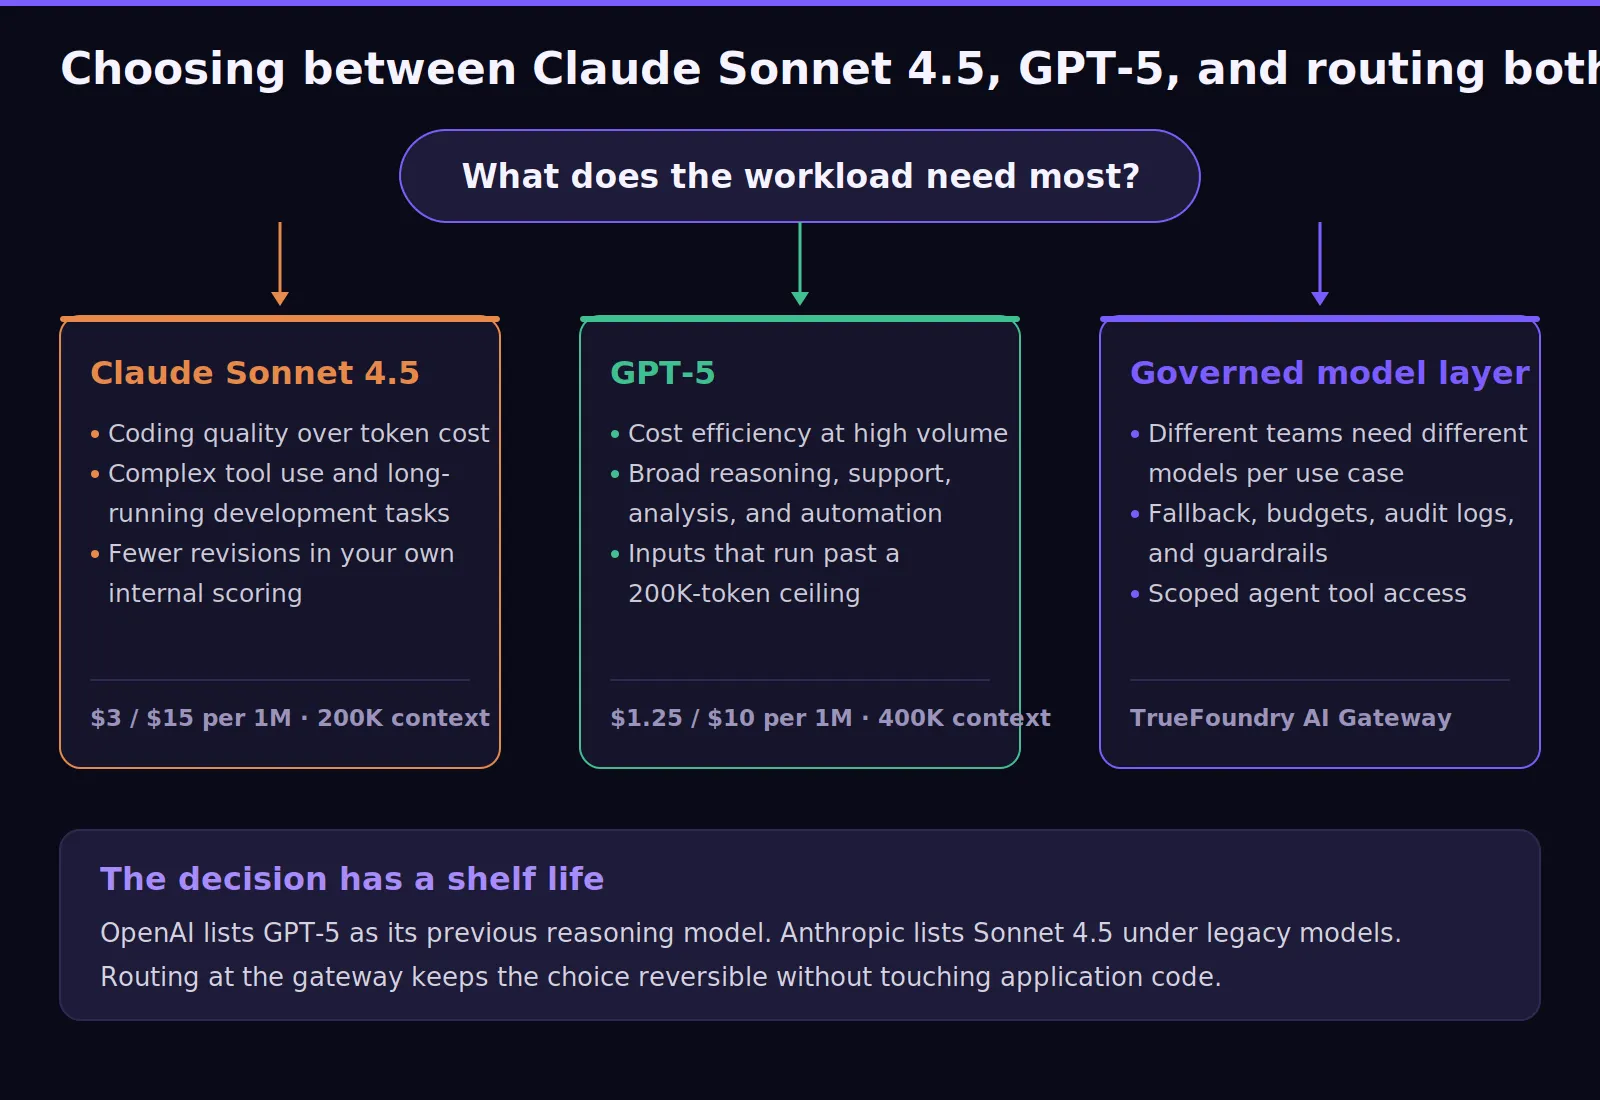
المقارنة أعلاه لها عمر افتراضي محدود. فنموذج GPT-5 يحمل بالفعل تصنيف نموذج سابق، ولدى Anthropic نماذج أحدث تتجاوز Claude Sonnet 4.5. يتطور مشهد الذكاء الاصطناعي بسرعة، وتعمل TrueFoundry على إبقاء تغييرات النماذج بعيدة عن كود التطبيق.
يمكن للفرق الموازنة بين Claude Sonnet 4.5 وGPT-5 بناءً على الجودة والتكلفة وزمن الاستجابة وعمق الاستنتاج. تظل طبقة الحوكمة مستقلة عن كلا المزودين، مما يتيح للمجموعات المختلفة تشغيل نماذج متنوعة للبرمجة، وأتمتة الدعم، والتحليلات، والمساعدين الذكيين الداخليين.
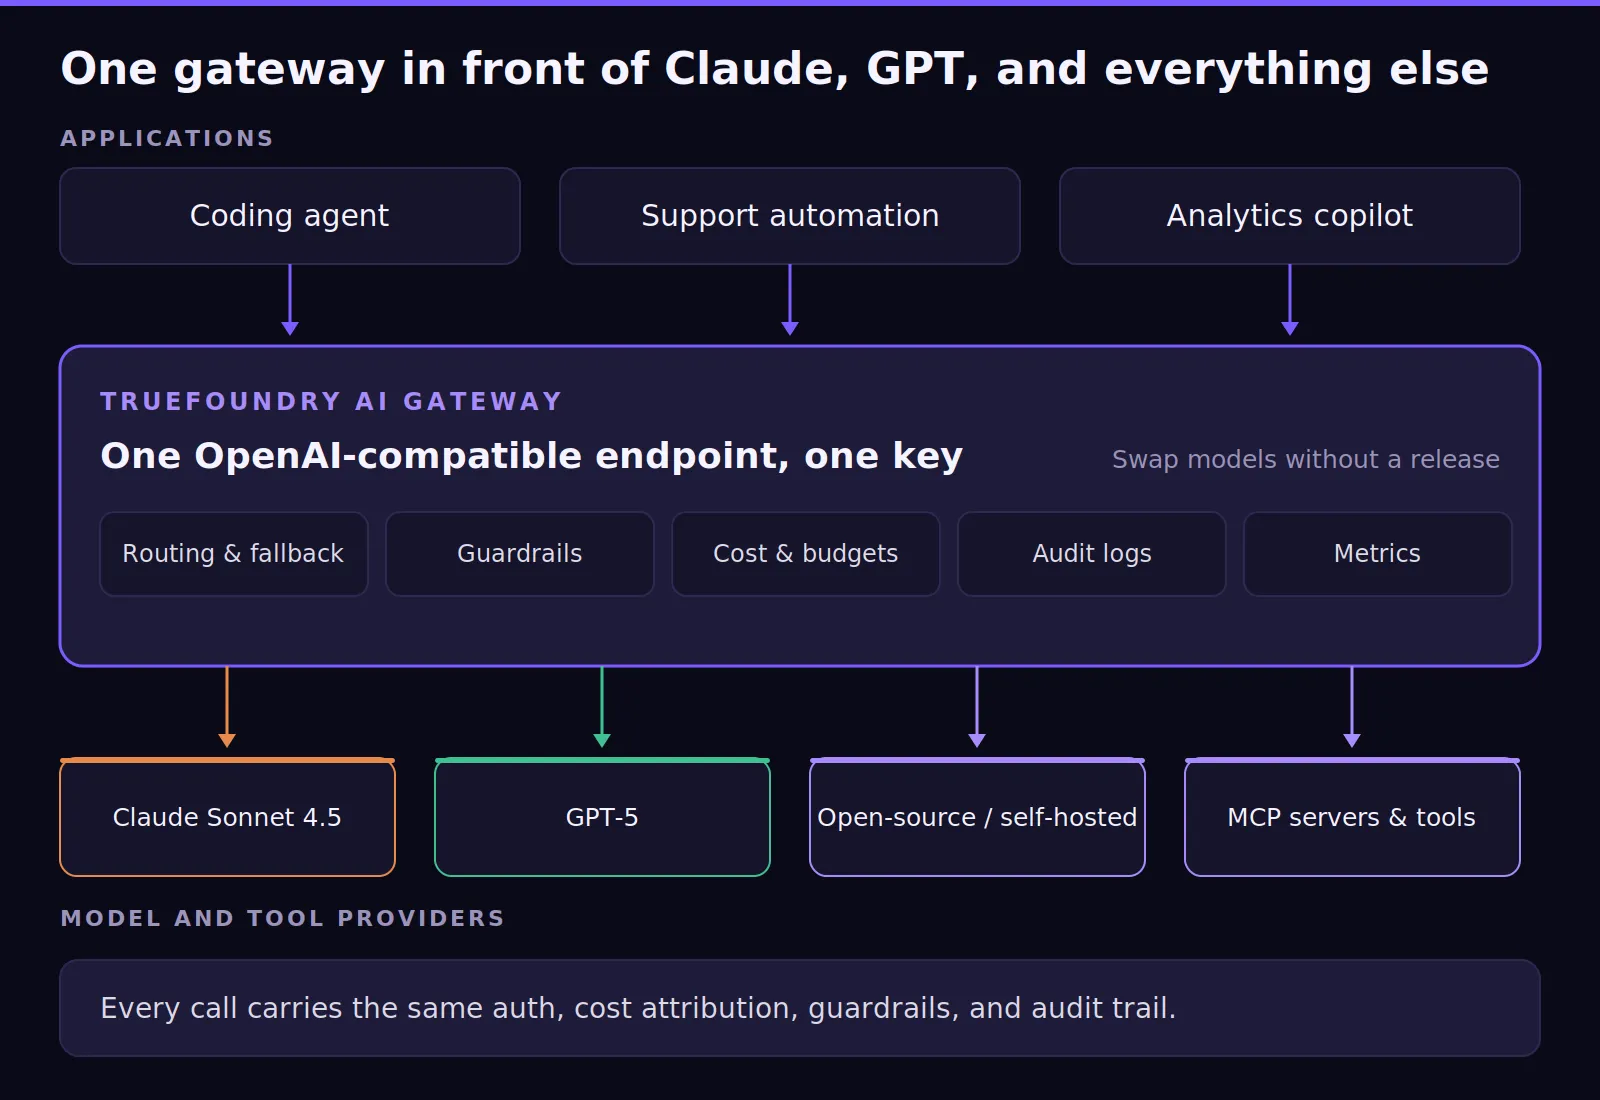
يقع بوابة الذكاء الاصطناعي (AI Gateway) بين التطبيقات ومزودي النماذج. فهي توفر نقطة نهاية واحدة متوافقة مع OpenAI، مع تطبيق المصادقة، وتسجيل البيانات، وضوابط الحماية، والتحكم في التكاليف. ويمكن لهذه الطبقة نفسها إدارة نماذج Claude وGPT والنماذج مفتوحة المصدر والمستضافة ذاتياً.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
بوابة نماذج اللغة الكبيرة (LLM Gateway) لتوجيه النماذج المتعددة. تعمل بوابة نماذج اللغة الكبيرة (LLM Gateway) على توجيه الطلبات عبر مختلف المزودين من خلال واجهة موحدة، بحيث يمكن لنموذج GPT-5 التعامل مع مهام التلخيص ذات الحجم الكبير، بينما يتولى Sonnet 4.5 مسارات البرمجة والوكلاء. يمنح النموذج الافتراضي اسماً ثابتاً وموحداً لكلا النموذجين، ويجعل تبديل الأهداف مجرد تغيير في الإعدادات بدلاً من إصدار جديد.
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
يتم تقييم القواعد بالترتيب، ويفوز أول تطابق. يعالج `retry_config` لكل هدف حالات الفشل المؤقتة لنفس النموذج، بينما يقوم `fallback_status_codes` بإعادة توجيه الطلب عندما لا تكون عمليات إعادة المحاولة مجدية. كما تكتشف TrueFoundry الهدف غير المستقر من خلال طلباته، والرموز (tokens)، وحالات الفشل في الدقيقة، ثم تقوم بعزله لفترة تبريد.
بوابة بروتوكول سياق الآلة (MCP Gateway) للوصول الآمن إلى الأدوات. تنظم بوابة بروتوكول سياق الآلة (MCP Gateway) كيفية وصول التطبيقات والوكلاء إلى الأدوات، وواجهات برمجة التطبيقات، وقواعد البيانات، وأنظمة الأعمال. يصبح الوصول المقيد أمراً بالغ الأهمية بمجرد أن يتمكن وكيل مدعوم بـ Claude أو GPT من استرجاع السجلات، أو استدعاء الخدمات، أو تشغيل سير العمل.
بوابة الوكلاء (Agent Gateway) لحوكمة سير العمل. تضيف بوابة الوكلاء (Agent Gateway) حوكمة على مستوى سير العمل عبر المهام المستقلة. فهي تساعد في التحكم في السلوك متعدد الخطوات، وحدود التنفيذ، والمراسلة بين الوكلاء، والتتبع الواعي للجلسة. تتحول الحلقات المفرطة والإجراءات غير الآمنة إلى بيانات قياس (telemetry)، بدلاً من أن تكون مفاجآت غير سارة في نهاية الشهر.
ضوابط الحماية، والتحكم في التكاليف، ومسارات التدقيق. إنها تحول GPT-5 وClaude Sonnet 4.5 إلى قرار إنتاجي خاضع للحوكمة. يمكن للوحة تحكم المقاييس تقديم تقارير حول زمن الاستجابة، والوقت المستغرق للرمز الأول، وتكلفة الاستدلال، ورموز الإدخال، ورموز الإخراج، ومقاييس التخزين المؤقت، وحظر تجاوز حدود الميزانية.
هذه القدرة تحول المقارنة إلى إجابة تشغيلية بدلاً من مجرد رأي لمرة واحدة. إن توجيه 10% من حركة المرور إلى نموذج آخر ومراقبة التكلفة لكل مهمة مكتملة أفضل من إعادة قراءة قائمة الأسعار. كما أنها تساعد الفرق على اتخاذ قرار مستنير.
حافظ على مرونة اختيار النموذج مع ضمان ثبات حوكمة الإنتاج. احجز عرضاً توضيحياً لترى كيف تقوم TrueFoundry بتوجيه نماذج Claude وGPT والنماذج مفتوحة المصدر والنماذج المخصصة عبر بوابة ذكاء اصطناعي واحدة خاضعة للحوكمة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















