October 16, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O Requesty oferece um gateway de LLM unificado para acessar centenas de modelos por meio de uma única API. Sua precificação pública é direta. Clientes que utilizam o modelo "pay-as-you-go" pagam uma margem de 5% sobre o custo dos modelos upstream. Não há taxas fixas por usuário ou requisitos de compromisso mínimo. Planos corporativos utilizam precificação personalizada.
Este modelo é ideal para equipes que desejam um AI Gateway gerenciado com amplo acesso a modelos e o mínimo de trabalho de infraestrutura. O Requesty inclui roteamento, cache, failover, controle de gastos e observabilidade para mais de 600 modelos. As equipes também podem utilizar suas próprias chaves de provedor, situação na qual o Requesty declara atualmente que a margem é de 0%.
Portanto, compradores corporativos devem olhar além da porcentagem anunciada. O custo real do Requesty AI depende da seleção de modelos, tráfego, contratos com provedores, volume de saída e novas tentativas de agentes. Requisitos de segurança e necessidades de implantação privada também podem alterar a decisão final sobre a plataforma.
O Requesty oferece três caminhos de precificação pública. Seu plano gratuito oferece acesso a modelos com limite de 200 requisições diárias e não exige cartão de crédito. O acesso "pay-as-you-go" adiciona 5% aos preços dos modelos upstream. A precificação corporativa depende de controles organizacionais, requisitos de suporte e termos negociados.
Uma chave de API permite que as aplicações acessem o endpoint unificado. O BYOK é importante para empresas que negociaram taxas com provedores como OpenAI, Anthropic ou outros fornecedores. Isso permite que as equipes mantenham esses contratos enquanto utilizam a camada de roteamento e monitoramento do Requesty.
Os exemplos a seguir consideram um modelo que custa $10 por milhão de tokens. Eles também pressupõem que o Requesty fornece o acesso ao modelo sob sua estrutura de 5% de pagamento conforme o uso. Cargas de trabalho BYOK seguiriam uma economia de gateway diferente, já que o Requesty lista atualmente uma margem de 0% para essa modalidade.
Cenário
Tokens mensais
Gasto do provedor
Taxa de 5% da Requesty
Total
Protótipo individual
5M
US$ 50
US$ 2,50
US$ 52,50
Pequena equipe de produto
50M
US$ 500
US$ 25
US$ 525
Carga de trabalho de produção em crescimento
500M
US$ 5.000
US$ 250
US$ 5.250
Plataforma de agentes multisserviço
2,5B
US$ 25.000
US$ 1.250
US$ 26.250
Carga de trabalho de grande empresa
10B
US$ 100.000
US$ 5.000
US$ 105.000
Estes números ilustram a estrutura de preços, e não o gasto esperado do cliente. Os custos reais dos modelos variam muito entre provedores e modelos. GPT, Gemini, Claude e Mistral também podem ter preços diferentes para tokens de entrada, saída e em cache.

Texto Alternativo: A página de preços da Requesty compara o uso gratuito e os planos pagos de gateway
Isso torna a Requesty fácil de entender para equipes em estágio inicial que desejam um acesso previsível do tipo pague conforme o uso. Simples de começar. Simples de explicar para o financeiro. Toda a página de preços cabe em uma única tela.
Área de Preços
O que a Requesty oferece
O que as equipes devem verificar
Preços padrão
Markup de 5% sobre os custos do modelo base
Mix real de provedores e modelos
Taxas de assinatura
Nenhuma assinatura listada
O plano corporativo pode ser diferente
Taxas por usuário
Sem taxas por usuário listadas
Necessidades administrativas e de equipe
Gasto mínimo
Sem gasto mínimo listado
Compromissos de volume, se negociados
Preços corporativos
Preços personalizados
SSO, RBAC, SLAs, suporte
O Requesty posiciona-se como um gateway gerenciado para grandes modelos de linguagem. A plataforma abrange acesso a modelos, confiabilidade, controle de custos, cache e monitoramento. Ela oferece suporte a OpenAI, Anthropic, Google, AWS Bedrock, Gemini, Mistral e outros provedores por meio de uma interface compatível.
A camada de gateway inclui vários recursos além do acesso aos modelos:
O Requesty também publica dados operacionais em nível de provedor, abrangendo taxas de sucesso, adoção de streaming e comportamento de cache-hit. Essas diferenças mostram por que a escolha do modelo, por si só, não determina o desempenho em produção. A confiabilidade do provedor pode afetar materialmente as decisões de roteamento.
O Requesty roteia o tráfego por meio de uma interface compatível com OpenAI. Integrações existentes com o SDK da OpenAI podem ser alteradas apenas mudando a URL base e a credencial do Requesty. O mesmo padrão funciona em várias ferramentas e frameworks de desenvolvimento comuns.
Se você já utiliza o SDK da OpenAI, basta apontá-lo para o endpoint do roteador em router.requesty.ai e alterar a string do modelo:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["REQUESTY_API_KEY"],
base_url="https://router.requesty.ai/v1",
)
response = client.chat.completions.create(
model="openai/gpt-4o",
messages=[{"role": "user", "content": "Resuma este relatório de incidente."}],
)
Os modelos seguem uma sintaxe de provedor/nome-do-modelo, e você também pode referenciar políticas de roteamento com política/nome-da-política para que o gateway escolha o modelo para você.

Figura 1: A margem de 5% cobre a camada de gateway hospedada, não apenas o acesso ao modelo
Texto alternativo: A taxa do gateway Requesty inclui roteamento, cache, monitoramento e failover
A porcentagem em si é direta, mas o tráfego de produção raramente é. As equipes financeiras precisam estimar o volume de solicitações, o tamanho do contexto, as saídas, as novas tentativas, o roteamento e a seleção do provedor. O cache também altera o gasto efetivo quando conteúdo repetido se torna elegível para um desconto de cache.
Cargas de trabalho de agentes tornam a previsão mais difícil, pois uma única ação do usuário pode acionar várias chamadas de modelo. Um roteador também pode alternar modelos após erros ou problemas de capacidade. Portanto, diferentes políticas de fallback podem alterar tanto a confiabilidade quanto o gasto total.
Para uma ilustração simples, considere 2,5 bilhões de tokens mensais em um modelo de US$ 10 por milhão. O gasto com o provedor chega a US$ 25.000. Uma taxa de pagamento conforme o uso de 5% da Requesty adiciona US$ 1.250. Esse cálculo muda no modelo BYOK, pois a Requesty afirma atualmente que suas próprias chaves de provedor não possuem margem de lucro.
A lição mais ampla é que a precificação por porcentagem acompanha os gastos com o provedor. As equipes devem modelar os padrões de uso para suas faturas em vez de confiar em preços médios de tokens. O guia de otimização de custos de LLM da TrueFoundry guia de otimização de custos de LLM explica como o roteamento, o cache, os orçamentos e a atribuição afetam os gastos com IA em produção.
Fator de custo
Por que é importante
Seleção de modelo
Modelos de fronteira podem aumentar o custo por solicitação
Comprimento da saída
Respostas mais longas aumentam o consumo de tokens
Tentativas de reexecução do agente
Fluxos de trabalho com várias etapas podem multiplicar a inferência
Taxa de acerto de cache
Menos acertos reduzem a economia gerada pelo cache
Seleção de rota
Os provedores podem ter preços diferentes
Controles corporativos
Requisitos avançados podem alterar os preços contratuais
O orçamento também deve levar em conta alertas, limites de gastos e comportamento de aplicação. O Requesty oferece suporte a limites orçamentários e interrupções automáticas. Essa distinção é importante porque monitorar gastos e interromper gastos atendem a requisitos operacionais diferentes.
O Requesty e o TrueFoundry utilizam modelos de precificação diferentes. O Requesty cobra uma margem de 5% sobre os custos dos modelos upstream para tráfego padrão no modelo pague conforme o uso. O TrueFoundry utiliza precificação baseada em planos, começando com um nível gratuito para desenvolvedores. Seus planos de preços então escalam de acordo com o volume de solicitações e os requisitos da plataforma.
A diferença torna-se mais relevante à medida que o uso aumenta. Os custos do Requesty sobem conforme os gastos com o provedor, portanto, modelos caros ou saídas mais longas aumentam as taxas do gateway. A precificação do TrueFoundry, por outro lado, segue as franquias de solicitações. Isso pode tornar os custos de governança mais fáceis de prever quando os gastos com modelos aumentam mais rapidamente do que o número de solicitações.
Área de precificação
Requesty AI
TrueFoundry
Preço inicial
Nível gratuito disponível
O plano para desenvolvedores começa em US$ 0/mês
Preço padrão
Markup de 5% sobre o custo do provedor
Pro a partir de US$ 499/mês
Controles avançados
Preços personalizados para empresas
Pro Plus a US$ 2.999/mês
Preços para empresas
Personalizado
Personalizado
Base de faturamento
Porcentagem do gasto com modelos
Franquias de planos baseadas em requisições
Implantação
Nuvem gerenciada
SaaS, VPC, local (on-premises), air-gapped
A implantação cria uma segunda diferença. O Requesty continua sendo um serviço de nuvem gerenciada, enquanto o da TrueFoundryAI Gateway também pode ser executado dentro da infraestrutura da empresa. Isso é importante quando prompts, logs ou controles de governança precisam permanecer dentro de limites de segurança aprovados.
Nenhum dos modelos de precificação é automaticamente mais barato. A precificação baseada em porcentagem pode funcionar bem para cargas de trabalho menores ou variáveis. Planos baseados em requisições podem se tornar mais previsíveis à medida que o uso em produção aumenta.
Equipes que comparam outros gateways hospedados também podem conferir a análise da TrueFoundry sobre a precificação do OpenRouter para outro modelo baseado em uso. O Guia de preços do LiteLLM oferece uma comparação útil para equipes que consideram uma infraestrutura de gateway de código aberto.
A decisão final deve levar em conta os preços da Requesty AI, o uso de modelos, as necessidades de implantação e o nível de governança exigido em produção.

Figura 2: A diferença de preço é, na verdade, uma diferença de implantação: pass-through hospedado versus um gateway que roda dentro do seu perímetro.
Texto alternativo: Requesty e TrueFoundry diferem principalmente nos limites de implantação corporativa
A Requesty funciona bem quando as equipes precisam de escolha de modelos sem ter que operar a infraestrutura de gateway. Seu serviço gerenciado reduz o trabalho de configuração, ao mesmo tempo em que oferece roteamento inteligente, failover, monitoramento e controle de orçamento. Isso pode torná-la a melhor alternativa à integração direta com provedores para algumas cargas de trabalho em estágio inicial.
A Requesty é uma boa opção quando:
Considere uma equipe de produto que gasta US$ 500 por mês em provedores através da chave unificada da Requesty. A taxa do gateway adicionaria cerca de US$ 25 sob a estrutura atual de 5%. Construir um roteamento e monitoramento equivalentes internamente raramente faria sentido nessa escala.
O cenário muda à medida que o tráfego é distribuído entre várias equipes e fluxos de trabalho de agentes. Ambientes maiores podem exigir controles de configuração mais rigorosos, metadados detalhados, redes privadas e políticas de identidade consolidadas. Esses requisitos geralmente são mais importantes do que a própria taxa percentual.
BANNER DE CONVERSÃO:
Título: Leve a governança de IA além do roteamento de modelos hospedados
Subtexto: Controle modelos, ferramentas, agentes, orçamentos e políticas a partir de um único gateway
CTA: Começar agora
Texto Alternativo: A TrueFoundry centraliza a governança de IA corporativa além do roteamento de modelos hospedados
Link:https://www.truefoundry.com/book-demo?ref=requesty_ai_pricing
O preço do Requesty AI pode continuar atraente mesmo quando os requisitos arquiteturais superam seu modelo de implantação. O Requesty é totalmente gerenciado e, atualmente, não oferece auto-hospedagem. Equipes corporativas podem utilizar a residência de dados na UE por meio de Frankfurt e selecionar endpoints de modelos regionais onde estiverem disponíveis.
Sua política de retenção de dados também exige uma leitura atenta. O registro (logging) de autoatendimento é ativado por padrão e pode reter o conteúdo dos prompts por até 30 dias. As equipes podem desativar o registro de conteúdo por chave. A retenção zero em toda a organização está disponível mediante solicitação por escrito.
O Requesty declara atualmente que seu programa SOC 2 Tipo II ainda está em andamento. Sua página de segurança lista a conclusão prevista para o terceiro trimestre de 2026. As equipes de compras corporativas devem verificar o status atual da certificação diretamente antes de depender dela para fins de conformidade.
As equipes corporativas devem se perguntar:
As mesmas perguntas se aplicam quando um aplicativo de chat se torna um fluxo de trabalho autônomo. Agentes podem chamar modelos repetidamente e invocar sistemas internos. O requisito de controle, então, vai além da seleção de modelos e passa a envolver identidade, ferramentas, custos e política de execução.
Para empresas que buscam a melhor opção além do roteamento de modelos gerenciados, o TrueFoundry atende a uma gama mais ampla de necessidades de infraestrutura. Seu AI Gateway centraliza o acesso a modelos, roteamento, guardrails, controle de custos e observabilidade. A mesma plataforma pode ser executada como SaaS ou dentro de ambientes corporativos privados.
O TrueFoundry também oferece suporte a provedores como OpenAI, Anthropic, Google e modelos auto-hospedados por meio de uma interface única. As equipes podem rastrear latência, custos, erros e análises em nível de solicitação em todo o tráfego de produção compartilhado. As políticas podem usar metadados personalizados para atribuição por equipe, cliente, projeto ou ambiente.
Três controles tornam-se importantes à medida que as cargas de trabalho se expandem:

Console do gateway da TrueFoundry mostrando os controles aplicados a uma única chamada de modelo: registro ativado, com cache, guardrail de entrada e saída, e slots de saída estruturada na mesma solicitação.
Texto Alternativo: Controles por chamada do AI Gateway da TrueFoundry para registro, cache e guardrails
A TrueFoundry também utiliza uma interface compatível com OpenAI, portanto, a adoção não requer um novo SDK. Aplicações existentes podem apontar suas URLs para o gateway, mantendo os formatos de solicitação familiares. O endpoint selecionado pode representar o SaaS da TrueFoundry ou um ambiente corporativo privado.
from openai import OpenAI
client = OpenAI(
api_key="sua_chave_api_truefoundry",
base_url="https://gateway.truefoundry.ai", # ou seu próprio endpoint VPC
)
Os controles de custo operam no caminho da solicitação. As equipes podem definir cotas baseadas em custo ou em tokens por usuário, serviço, modelo ou fluxo de trabalho. O gateway pode então limitar, reduzir ou bloquear a atividade de acordo com a política.
Essa estrutura torna-se útil quando o código da aplicação deve permanecer independente da lógica do provedor. Ela também torna o failover automático, o roteamento e os orçamentos consistentes entre as cargas de trabalho, em vez de implementar cada regra separadamente.
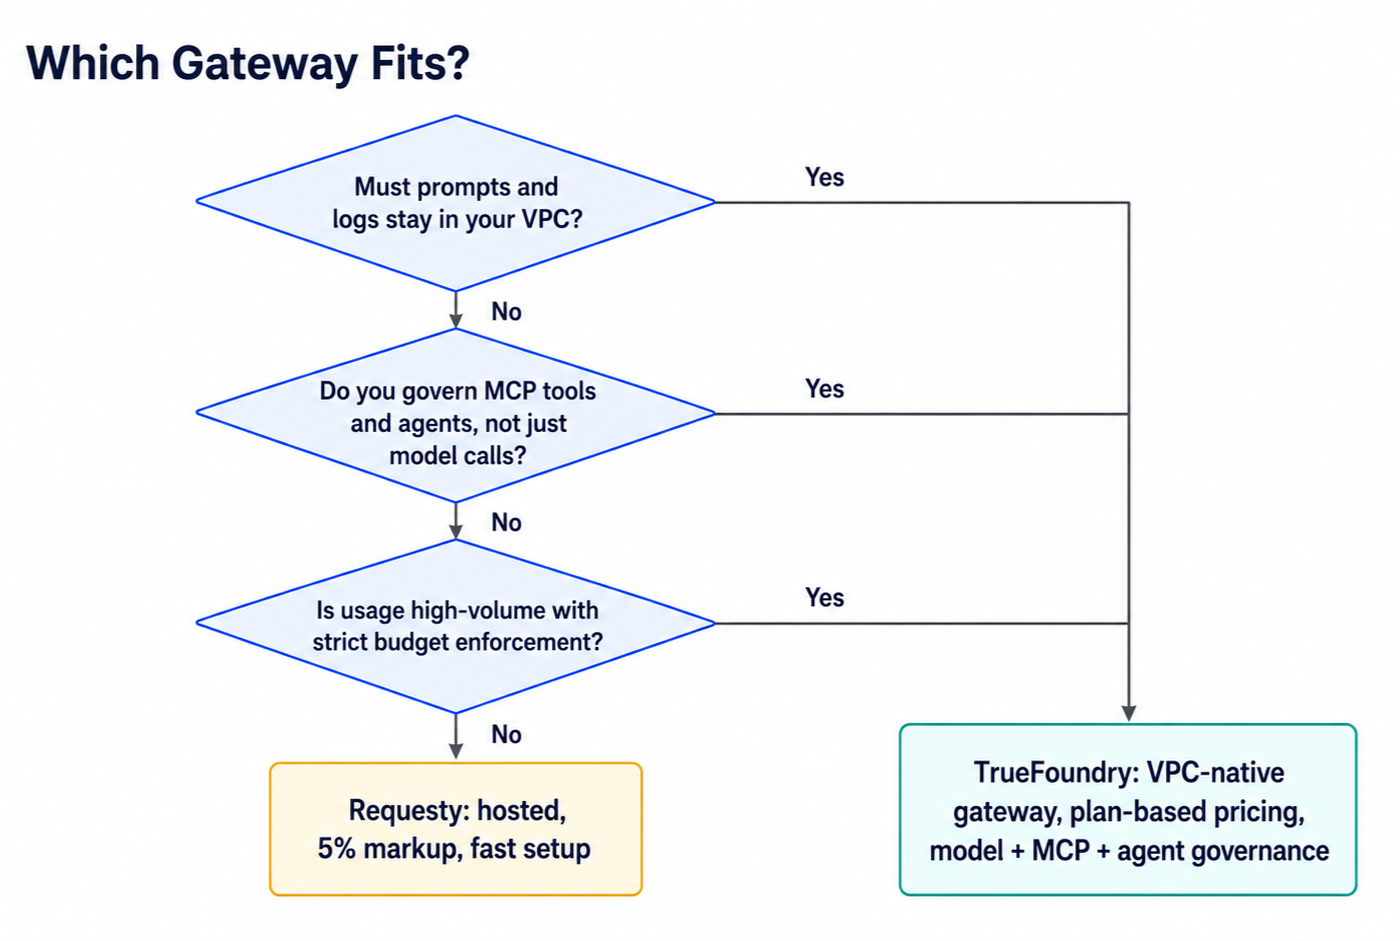
Figura 3: O limite de implantação e o escopo de governança decidem isso, não a marcação.
O Requesty resolve bem o acesso gerenciado a múltiplos provedores. A TrueFoundry atende empresas que precisam de um gateway, tráfego de modelos, ferramentas MCP e agentes sob uma única camada de infraestrutura governada.
Para empresas que comparam o preço total do Requesty AI com os requisitos de governança, os limites de implantação podem, em última análise, ser mais decisivos do que as taxas brutas dos modelos.
Agende uma demonstração com a TrueFoundry para avaliar seus requisitos de roteamento de modelos, governança de agentes, implantação e controle de custos.
O Requesty cobra uma margem de 5% sobre os custos dos modelos upstream para acesso padrão pré-pago. Não há taxas por assento listadas ou requisitos de gasto mínimo. O plano gratuito inclui 200 solicitações diárias. O Requesty afirma atualmente que o tráfego BYOK não possui margem (0%), enquanto os planos Enterprise utilizam preços personalizados para controles avançados e suporte.
O acesso direto aos provedores evita a taxa de 5% do Requesty no modelo pague conforme o uso. Essa taxa cobre roteamento gerenciado, fallbacks, cache, monitoramento, orçamentos e acesso unificado a modelos. O BYOK (traga sua própria chave) altera essa comparação, já que o Requesty atualmente não aplica margem de lucro quando os clientes fornecem suas próprias chaves de provedor. Portanto, o esforço de engenharia e os requisitos operacionais devem ser considerados juntamente com os preços brutos dos tokens.
A escolha do modelo geralmente gera a maior variação, pois os preços de entrada e saída diferem substancialmente. O tamanho da saída, as tentativas de reenvio, a seleção de rotas e o desempenho do cache também influenciam o gasto total. Requisitos corporativos podem adicionar preços personalizados para SSO, RBAC, logs de auditoria, guardrails e suporte. O BYOK pode alterar ainda mais a economia para empresas que já possuem acordos negociados com provedores.
O Requesty oferece SSO corporativo, RBAC, logs de auditoria, políticas de modelo, controles de gastos, guardrails e residência de dados na UE. A plataforma é totalmente gerenciada e, atualmente, não oferece suporte para auto-hospedagem. Seu programa SOC 2 Tipo II também está listado como em andamento. Portanto, as empresas devem comparar seus controles com seus requisitos internos de implantação, residência de dados e conformidade.
O TrueFoundry é uma alternativa sólida quando as empresas exigem SaaS juntamente com opções de implantação em VPC, local (on-premises) ou em ambientes isolados (air-gapped). Seu AI Gateway gerencia o acesso a modelos, roteamento, orçamentos e guardrails. O MCP e o Agent Gateways estendem esses controles para ferramentas corporativas e fluxos de trabalho autônomos. Esse escopo mais amplo atende a equipes cujos requisitos de infraestrutura vão além do simples roteamento de modelos hospedados.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada