



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O DeepSeek-V4-Pro entrou em fase de prévia em 24 de abril de 2026 e foi disponibilizado ao público em 13 de agosto de 2026 — pouco menos de quatro meses depois. O nome do modelo na API não mudou: você continua chamando o deepseek-v4-pro, e a versão final simplesmente substituiu a versão de prévia.
As especificações, a partir da página de Modelos e Preços da DeepSeek e do card do modelo GA, em setembro de 2026:
Dois detalhes são mais importantes do que a contagem de parâmetros.
Primeiro, os pesos são genuinamente abertos. O checkpoint da versão final foi publicado em deepseek-ai/DeepSeek-V4-Pro-0813 sob a licença MIT — não uma licença comunitária personalizada com teto de receita ou restrições de campo de uso. A licença MIT é uma das mais permissivas que existem. Esse é o fato isolado que torna este post relevante.
Segundo, o trabalho de eficiência é o grande diferencial da arquitetura. O card do modelo de prévia descreve um design de atenção híbrida que combina Compressed Sparse Attention e Heavily Compressed Attention, e relata que, com um contexto de 1 milhão de tokens, o V4-Pro requer aproximadamente 27% dos FLOPs de inferência por token e 10% do cache KV do DeepSeek-V3.2. O contexto longo é barato de servir aqui, de uma forma que não era na geração V3, o que é exatamente o que torna a matemática da auto-hospedagem interessante.
[CAPTURA DE TELA: Chat do DeepSeek — o seletor de Modo Especialista que direciona para o V4-Pro no aplicativo e na web]
A DeepSeek é incomumente direta sobre isso. O cartão do modelo GA afirma que o V4-Pro-0813 “é construído sobre a estrutura do modelo DeepSeek-V4-Pro (Preview), com um módulo de decodificação especulativa DSpark acoplado” — o modelo base é o mesmo; o pós-treinamento e o caminho de decodificação não são.
Os deltas publicados, da versão preview para a GA:
Fonte: Cartão do modelo DeepSeek-V4-Pro-0813, setembro de 2026.
Um aviso ao ler estes dados. A DeepSeek observa que as pontuações dos agentes de código foram produzidas usando seu próprio DeepSeek Harness em modo minimalista com esforço máximo de raciocínio, temperatura = 1.0, top_p = 0.95. Um salto de quase cinco vezes no DeepSWE é um resultado de pós-treinamento medido sob o próprio harness do fornecedor, não uma reprodução independente. A tendência é claramente real; a magnitude merece sua própria avaliação.
Junto com o modelo, a GA trouxe suporte nativo à API de Respostas da OpenAI com uma configuração de Codex de um clique, e o controle de reasoning_effort de três níveis que substitui a alternância binária de pensamento.
O cartão do modelo GA publica uma tabela comparativa direta contra concorrentes abertos e fechados. Aqui está a parte que todos reproduzem, e depois a parte que a maioria das publicações omite.
Fonte: Cartão do modelo DeepSeek-V4-Pro-0813, setembro de 2026.
Onde o V4-Pro lidera. Trabalho de agente estilo terminal e codificação com foco em segurança. Ele supera o Opus-4.8 no Terminal Bench 2.1, DeepSWE, Cybergym e AutomationBench. Para um modelo que você pode baixar, esse é um resultado genuíno.
Onde os modelos fechados ainda vencem. Conhecimento bruto e o trabalho mais difícil em repositórios. O Opus-4.8 está à frente no NL2Repo por mais de oito pontos, no DSBench-Hard, no Toolathlon-Verified e no HLE sem ferramentas. O Fable-5 com fallback lidera na maioria dos mesmos quesitos. Se sua carga de trabalho é dominada por mudanças complexas em repositórios com vários arquivos ou por perguntas de amplitude de conhecimento, os modelos fechados de fronteira continuam sendo a melhor resposta, e nenhum entusiasmo com licenças muda isso.
Onde os outros modelos abertos se posicionam. O Kimi K3 supera ligeiramente o V4-Pro no Terminal Bench 2.1 e no DeepSWE. O título de “melhor modelo de pesos abertos” é contestado, não definido. A afirmação interessante é mais restrita e duradoura: um modelo para download agora está próximo o suficiente da fronteira para que a questão da implementação seja real.
A DeepSeek introduziu cobranças de pico e fora de pico junto com a GA, em vigor desde as 16:00 UTC de 16 de agosto de 2026. As tarifas fora de pico são exatamente metade das de pico. Os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta-feira, excluindo feriados chineses; todo o restante, incluindo fins de semana, é considerado fora de pico.
Fonte: Modelos e Precificação DeepSeek, setembro de 2026.
Três pontos a observar. O preço de cache-hit é 30x menor que o de cache-miss, portanto, a estrutura do prompt é extremamente importante para qualquer coisa com um system prompt estável. A divisão entre pico/fora de pico é uma alavanca de agendamento, não um desconto — trabalho em lote movido para fora de pico reduz a conta pela metade. E a DeepSeek aumentou os preços na GA em relação ao preview, embora as taxas publicadas do preview sejam [VERIFICAR] — elas não estão mais na página de preços e não as obteremos de coberturas secundárias.
Uma observação operacional: o limite de concorrência da API para o deepseek-v4-pro é 500. A DeepSeek também confirmou em 10 de setembro de 2026 que continuará oferecendo a API V4 Pro após 14 de setembro de 2026 com a cobrança inalterada (alteração log).
[SCREENSHOT: Plataforma DeepSeek — painel de uso mostrando o consumo de tokens em horários de pico vs. fora de pico]
Quatro modos de falha surgem repetidamente com modelos de fronteira de pesos abertos, e o V4-Pro apresenta todos os quatro.
A conta da auto-hospedagem é por nó, não por GPU. O comando de referência de serviço do DeepSeek no cartão do modelo tem como alvo uma configuração única de 4 nós GB300 via vLLM, com cache KV FP8, paralelismo de especialistas e decodificação especulativa DSpark ativados. Um MoE de 1,7 trilhão de parâmetros não é algo que você coloca para rodar em uma A100 sobrando. Os pesos abertos lhe dão a opção de auto-hospedar; se o cálculo compensa os US$ 1,98 por milhão de tokens de saída depende inteiramente da sua utilização. Abaixo de uma carga de estado estável razoavelmente alta, a API vence.
Não existe um modelo de chat. O lançamento GA não traz nenhum modelo de chat Jinja. Em vez disso, o DeepSeek fornece uma pasta de codificação com scripts Python para transformar mensagens no formato OpenAI em entrada para o modelo e analisar a saída de volta. Qualquer coisa em sua pilha que dependa de tokenizer.apply_chat_template precisará de ajustes.
O V4-Pro não possui visão. A visão está na linha Flash, não na Pro. Uma estratégia de modelo único que pressupõe multimodalidade falha aqui, o que significa que você está roteando entre pelo menos dois modelos, quer tenha planejado isso ou não.
Residência e API agora são decisões separadas. Enviar prompts para api.deepseek.com é uma questão de fluxo de dados diferente de executar os mesmos pesos dentro da sua própria VPC. As equipes frequentemente confundem "podemos usar o DeepSeek V4" com "podemos chamar a API do DeepSeek", e essas questões recebem respostas diferentes na mesma análise de segurança. Seu próprio departamento jurídico decide o que é aceitável; o ponto é apenas que os pesos abertos tornam ambos os caminhos tecnicamente disponíveis.
Um modelo de fronteira de pesos abertos só muda sua economia se você realmente puder colocá-lo em algum lugar. Essa é a parte que a TrueFoundry faz.
Auto-hospede-o em sua própria VPC.OGateway de IA registra modelos de pesos abertos auto-hospedados ao lado de provedores hospedados: você implanta o V4-Pro em seu próprio Kubernetes com vLLM ou SGLang, aponta o gateway para o endpoint, e ele aparece no catálogo de modelos com o mesmo roteamento, limite de taxa, rastreamento de custos e observabilidade de qualquer modelo de API (documentação de modelos auto-hospedados). Como o vLLM e o SGLang oferecem, por padrão, uma API compatível com a da OpenAI, o gateway não precisa de um adaptador específico para o DeepSeek.
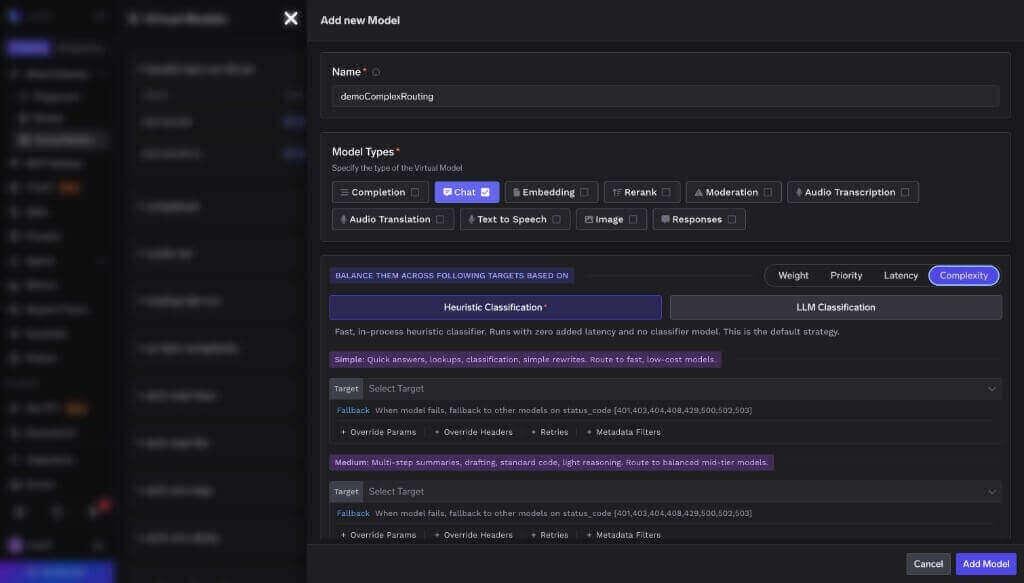
Ou chame a API e mantenha a opção em aberto. Se você ainda não está pronto para a auto-hospedagem, direcione para a API do DeepSeek através do gateway e mantenha o mesmo caminho de chamada que usaria posteriormente para uma implantação auto-hospedada. Mudar do endpoint hospedado para o seu próprio cluster torna-se uma alteração de configuração, em vez de uma reescrita da aplicação.
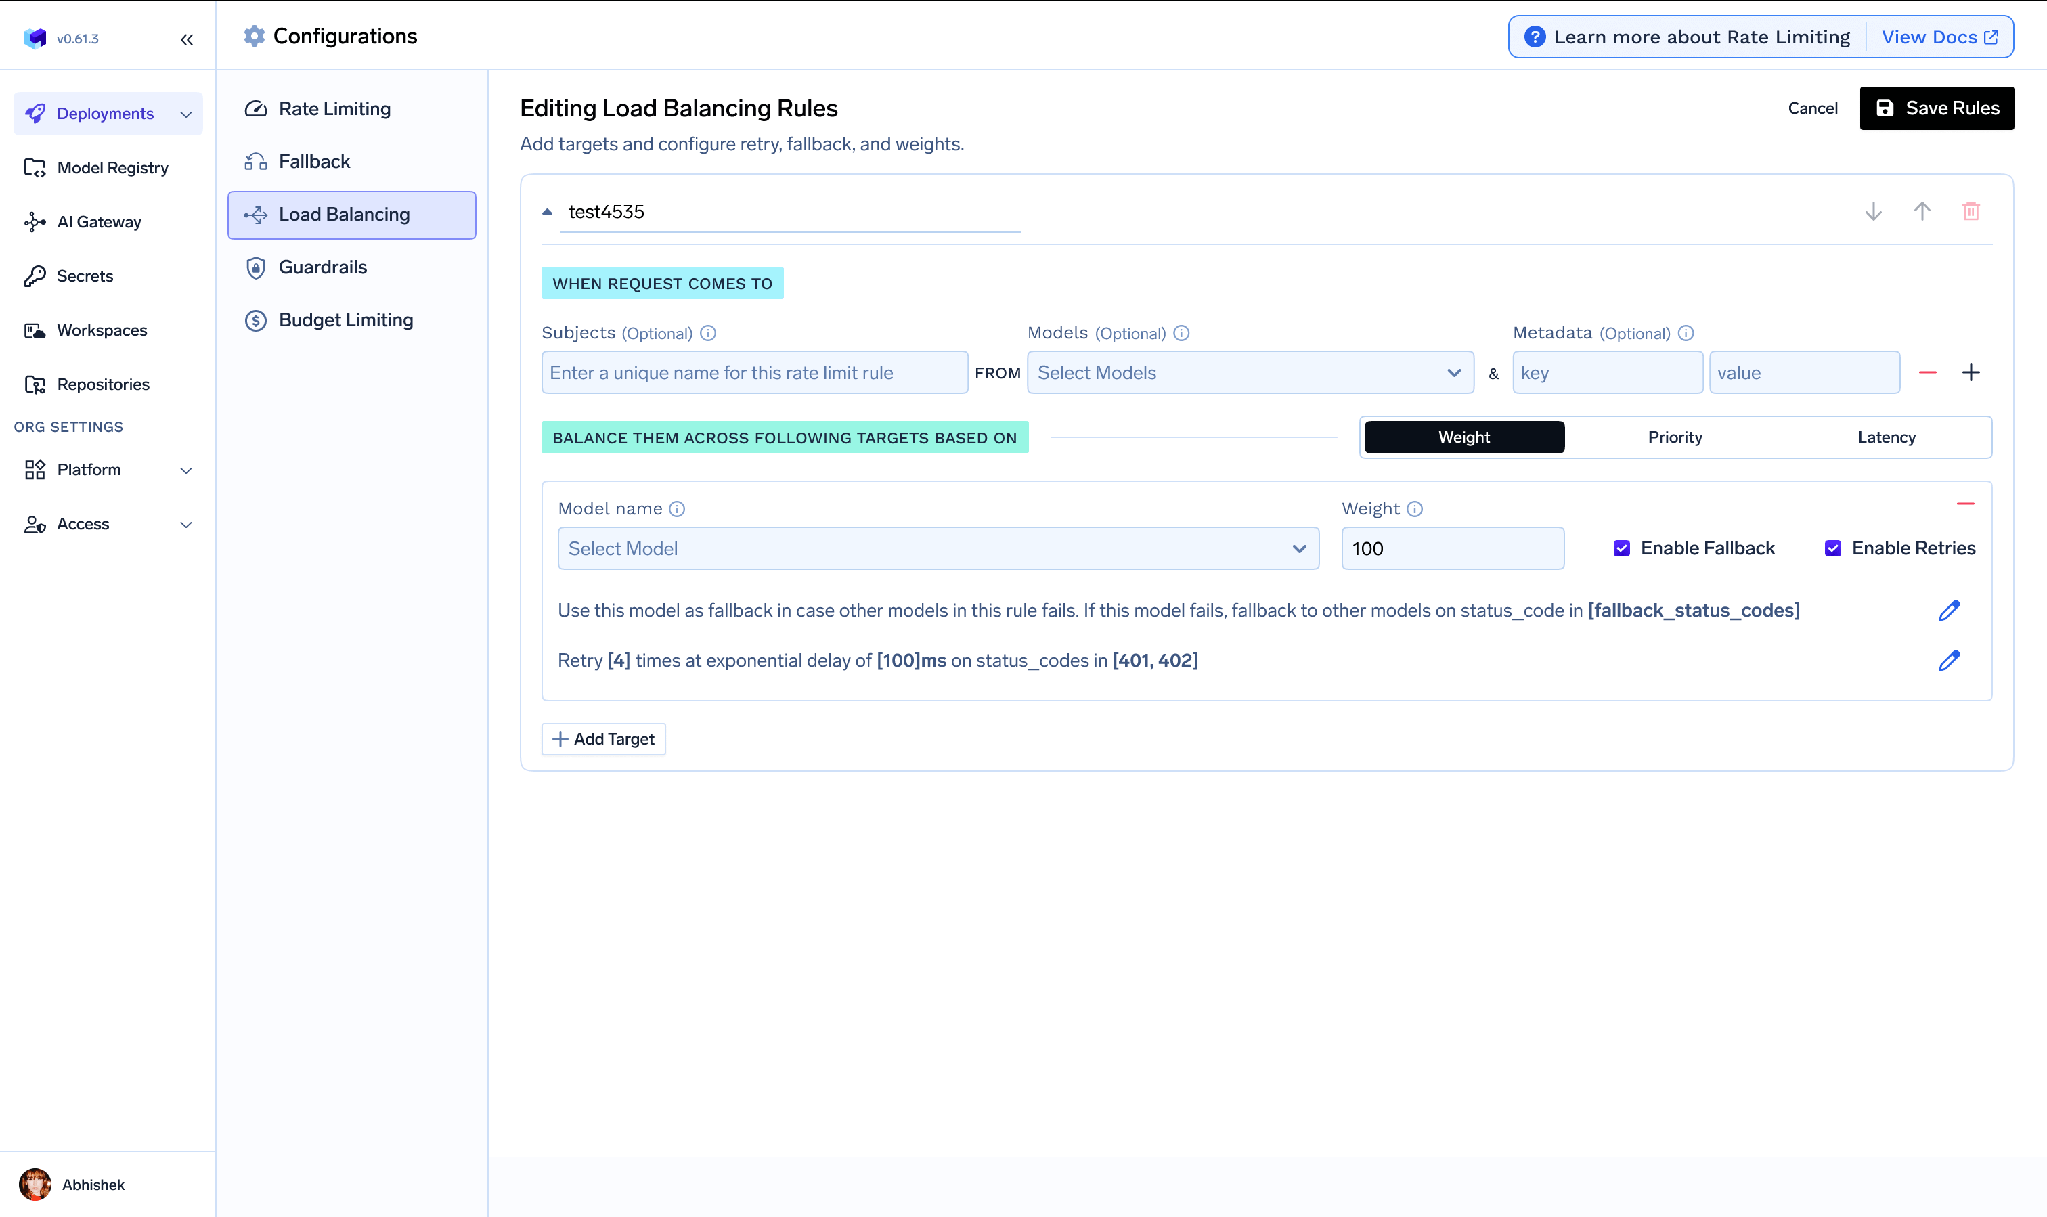
Roteie pela complexidade, não pelo hábito. A tabela de benchmark acima é um argumento a favor de uma frota mista, não de uma migração, e roteamento consciente de custo e qualidade é como você gerencia uma. Trabalho pesado de repositório para o Opus-4.8, execuções de agentes via terminal para o V4-Pro, classificação e extração para algo mais barato. No próprio benchmark de Roteamento Automático da TrueFoundry, com 550 prompts, a hierarquização de solicitações reduziu o custo em 69% mantendo 98% da qualidade base, com a latência média caindo de 7,6s para 4,0s; em tráfego com perfil de produção, a redução chegou a 80%.
Aplique as mesmas diretrizes de segurança (guardrails) de qualquer maneira. Um modelo auto-hospedado não herda a pilha de segurança de um provedor. As diretrizes de segurança no nível do gateway operam no caminho da solicitação e da resposta, independentemente de o modelo ser o endpoint do DeepSeek ou o seu próprio pod.

Meça antes de se comprometer. O custo e a latência por solicitação para cada equipe são a única maneira de descobrir se o preço fora de pico do V4-Pro ou um nó auto-hospedado realmente supera o que você utiliza hoje.

A versão resumida, em setembro de 2026:

O lançamento da versão GA do DeepSeek V4-Pro não é uma história sobre benchmarks. Pelos números que a própria DeepSeek publica, ele supera o Opus-4.8 em algumas tarefas de agentes, mas perde em trabalhos de repositório mais complexos e em conhecimento, enquanto o Kimi K3 disputa sua liderança entre os modelos abertos. Como uma entrada em um ranking, é um bom modelo com um desempenho irregular.
Como licença, é algo diferente. Um modelo com contexto de 1 milhão de tokens, próximo o suficiente da fronteira tecnológica para ser uma opção real e publicado sob a licença MIT, faz com que a questão da implementação deixe de ser retórica. Você pode executá-lo em sua própria VPC, manter os prompts em uma infraestrutura que você controla e pagar pelo processamento em vez de por tokens — se a sua utilização justificar um nó robusto e se você estiver disposto a gerenciar a pilha de servidores. Para a maioria das equipes hoje, isso não compensa, e a decisão correta é utilizar a API enquanto mantém o caminho da auto-hospedagem como uma alternativa.
Esta é a conclusão honesta: tudo se resume ao que você deseja controlar. Se você quer que outra pessoa execute o modelo, os modelos fechados de fronteira ainda são o caminho mais curto e os melhores para as tarefas mais difíceis. Se você quer a opção de mover o modelo para dentro do seu perímetro sem precisar reescrever a aplicação, um modelo de pesos abertos atrás de um gateway é a forma mais barata de garantir essa opção — e você deve garanti-la antes de precisar dela.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



O DeepSeek V4 é a família de modelos mixture-of-experts da DeepSeek. A prévia do V4, que abrange o V4-Pro e o V4-Flash, foi lançada em 24 de abril de 2026. O DeepSeek-V4-Pro chegou à disponibilidade geral como DeepSeek-V4-Pro-0813 em 13 de agosto de 2026.
Os pesos e o repositório são publicados sob a licença MIT no Hugging Face, em deepseek-ai/DeepSeek-V4-Pro-0813. Isso abrange os pesos e o código, não os dados de treinamento, então “pesos abertos” é um termo mais preciso do que “open source”.
Em setembro de 2026: US$ 0,66 por milhão de tokens de entrada fora do horário de pico e US$ 1,32 no pico quando não há acerto de cache, US$ 0,022 e US$ 0,044 quando há acerto de cache, e US$ 1,98 e US$ 3,96 por milhão de tokens de saída. Os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC em dias úteis.
Sim, e a DeepSeek publica receitas de serving para vLLM e SGLang. Seja realista quanto à escala: é um modelo de 1,7 trilhão de parâmetros, e a configuração de referência no model card é um nó GB300 com várias GPUs.
O AI Gateway do TrueFoundry adiciona cerca de 3 a 4 ms e sustenta mais de 350 RPS em 1 vCPU, o que é irrelevante diante de tempos de geração de vários segundos.
Não, e a dispersão dos benchmarks acima é o argumento contra isso. Rotear por tipo de tarefa entre modelos abertos e fechados costuma ser mais barato e melhor do que padronizar em um só.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















