October 15, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 10, 2026

Blazingly fast way to build, track and deploy your models!
Lembra quando um recurso de IA significava um modelo e um prompt? Essa configuração raramente sobrevive em produção hoje em dia. Uma aplicação real pode chamar vários provedores de LLM, extrair contexto de múltiplas fontes de dados, consultar bancos de dados vetoriais, transferir tarefas entre agentes e acionar chamadas de ferramentas dentro de uma única solicitação do usuário.
É por isso que as ferramentas de orquestração de LLM se tornaram críticas para equipes corporativas. Elas coordenam diferentes componentes entre modelos de linguagem, sistemas de recuperação, prompts, ferramentas, estado e automação de fluxo de trabalho. O objetivo geral é simples: tornar as aplicações de LLM confiáveis, observáveis, governadas e utilizáveis em escala de produção.
A parte mais difícil é a governança. Qual usuário pode chamar qual modelo? Qual agente pode usar qual ferramenta? Qual fluxo de trabalho é responsável pelo custo? Quais logs comprovam o que aconteceu durante uma auditoria? Frameworks ajudam as equipes a criar a lógica dos agentes, enquanto um plano de controle ajuda a executá-los com segurança.
Este guia compara as melhores ferramentas de orquestração de LLM em 2026 com base em critérios de produção. Ele abrange frameworks de desenvolvedor, plataformas de gateway, runtimes de agentes e serviços nativos da nuvem. Também explica o que a maioria das equipes ainda precisa além da orquestração: controles de acesso, observabilidade, orçamentos e governança.
O marketing dos fornecedores pode fazer com que todas as ferramentas de orquestração pareçam iguais. Os compradores devem primeiro definir os critérios de produção que importam. As plataformas de orquestração de LLM mais robustas coordenam prompts, modelos, memória, ferramentas e acesso a dados, ao mesmo tempo em que protegem dados sensíveis e melhoram a confiabilidade.
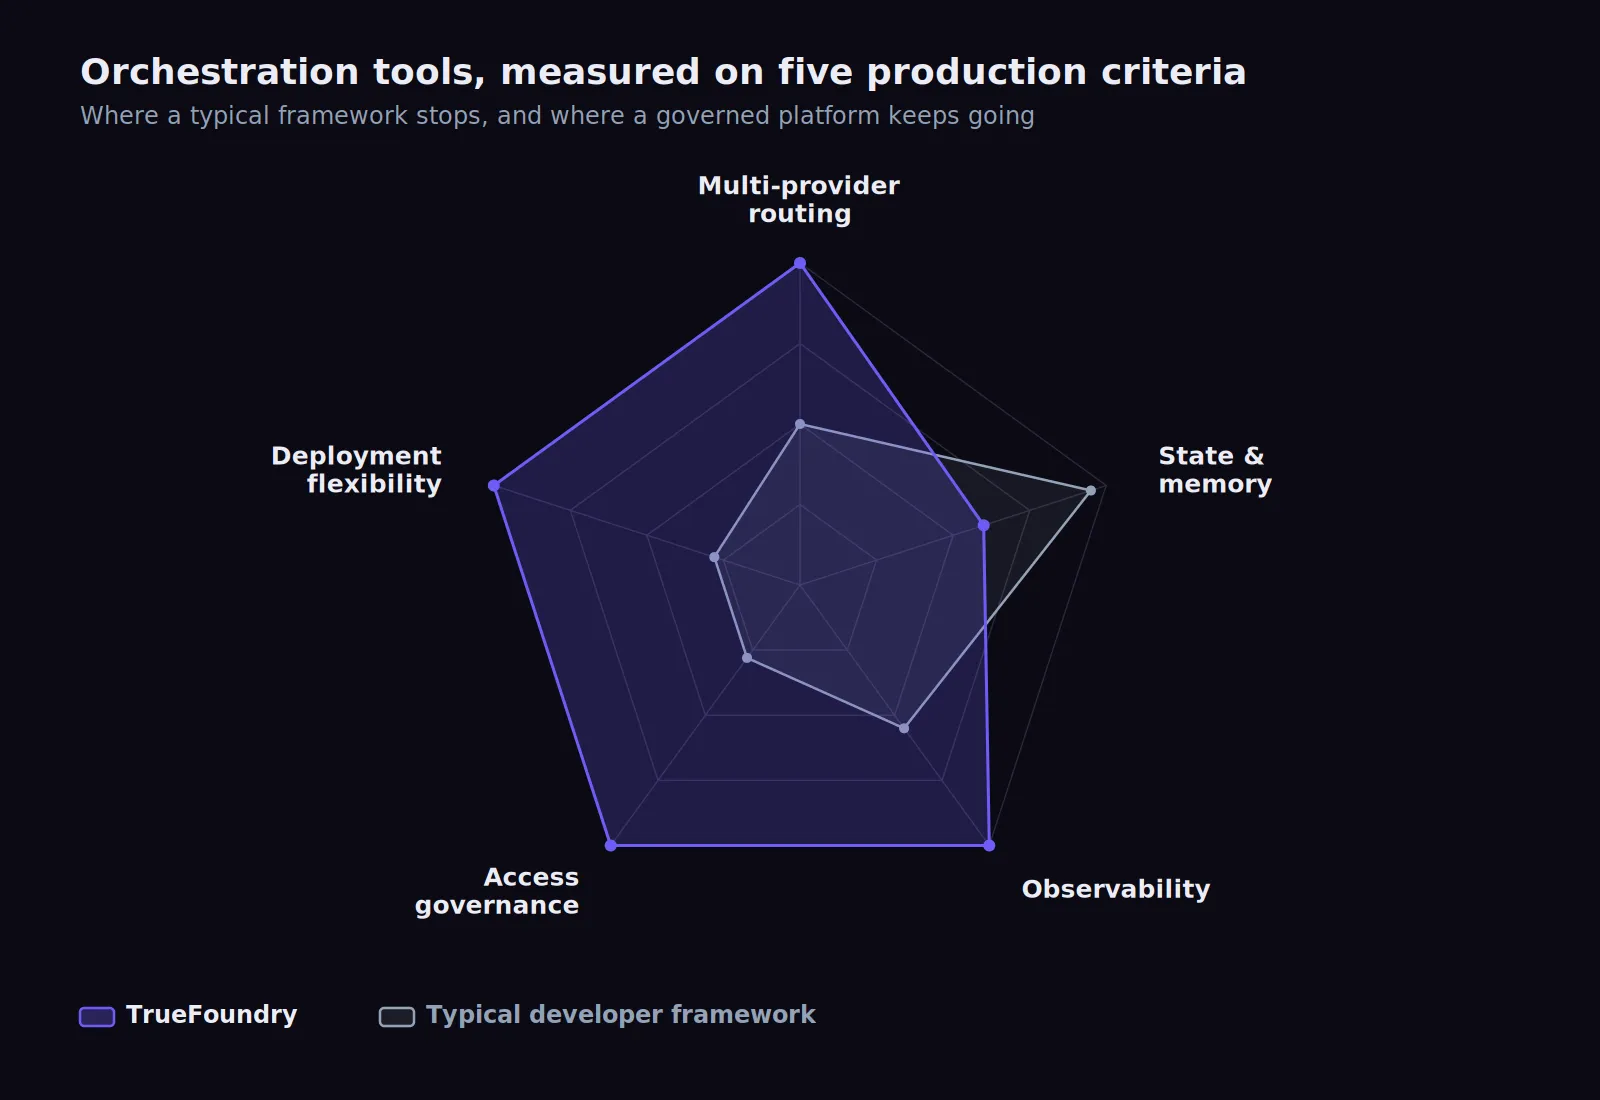
Uma avaliação útil deve cobrir cinco áreas. A maioria das ferramentas tem um bom desempenho em duas ou três. Poucas cobrem todo o caminho, desde a engenharia de prompts até a governança em tempo de execução, especialmente quando agentes de IA começam a atuar em sistemas corporativos.
As principais ferramentas para orquestração de LLMs dividem-se em quatro grupos: frameworks de desenvolvimento, frameworks de recuperação, plataformas de gateway e serviços gerenciados em nuvem. O grupo é importante porque cada um resolve uma parte diferente da prontidão para produção. Algumas ferramentas criam fluxos de trabalho, enquanto outras governam o caminho de execução.
A TrueFoundry é uma plataforma corporativa Gateway de IA e uma camada de governança de orquestração para IA em produção. Ela atua à frente de modelos, agentes e ferramentas para aplicar controle de acesso, roteamento, controle de gastos e auditabilidade. As equipes podem manter seus frameworks existentes enquanto adicionam governança por meio de um ponto de controle único em nível de infraestrutura.
A TrueFoundry é ideal para equipes corporativas que precisam de acesso governado a LLMs, implantação privada, roteamento entre múltiplos provedores, controle de custos e evidências de auditoria.

O LangChain ainda é o ponto de partida para muitas aplicações de LLM. O LangGraph é onde esses fluxos de trabalho se tornam mais robustos. Ele adiciona gerenciamento de estado baseado em grafos, persistência e execução com intervenção humana. Juntos, eles oferecem um framework de agentes de código aberto para equipes de engenharia que constroem lógica de fluxo de trabalho personalizada.
O LangChain e o LangGraph são ideais para equipes de engenharia que desenvolvem fluxos de trabalho de agentes personalizados, que exigem orquestração flexível em nível de código e estado durável.
O LlamaIndex conquista seu espaço através da recuperação de dados. Ele ajuda as equipes a conectar documentos, fontes de dados, índices, bancos de dados vetoriais e pipelines de recuperação a aplicações de LLM. É especialmente útil quando o produto depende da recuperação precisa de dados de documentos internos, arquivos jurídicos, conteúdo de suporte ou sistemas de conhecimento corporativo.
O LlamaIndex é ideal para equipes que desenvolvem RAG, assistentes de conhecimento, fluxos de trabalho de busca e pipelines de documentos sobre dados corporativos complexos.
O Portkey AI é uma plataforma de orquestração estilo gateway para roteamento, novas tentativas (retries), cache, observabilidade e controle de uso. Ele oferece às equipes uma interface única para diferentes provedores e modelos. É útil quando os desenvolvedores desejam uma configuração rápida de múltiplos provedores sem precisar criar lógica de roteamento em cada serviço da aplicação.
O Portkey AI é ideal para equipes que precisam de roteamento rápido entre múltiplos provedores, políticas de fallback, cache de prompts e observabilidade de gateway.

O Haystack surgiu a partir de sistemas de busca e resposta a perguntas. Seus pipelines baseados em componentes ajudam equipes a combinar recuperação, reranking, geração e ferramentas em fluxos de trabalho modulares. É útil para equipes que valorizam a estrutura de pipeline, busca em linguagem natural e inteligência documental mais do que a profundidade total de uma plataforma de orquestração de agentes.
O Haystack é ideal para equipes que desenvolvem aplicativos de busca, RAG e inteligência documental onde os pipelines de recuperação são a prioridade.

O Amazon Bedrock AgentCore é a via de planejamento da AWS mais robusta para novos projetos de agentes corporativos. O Bedrock Agents Classic ainda existe para usuários atuais, embora a AWS esteja direcionando novos recursos para o AgentCore. Ele é adequado para equipes que priorizam a AWS e desejam um ambiente de execução gerenciado, identidade, memória, observabilidade e acesso a ferramentas dentro da AWS.
O Amazon Bedrock AgentCore é ideal para equipes de plataforma que priorizam a AWS e desejam uma infraestrutura de tempo de execução de agente gerenciada e governança nativa da AWS.
O OpenAI Agents SDK ajuda os desenvolvedores a criar agentes com ferramentas, transferências, guardrails, sessões e rastreamento. É útil quando as equipes desejam uma orquestração de agentes intimamente ligada aos modelos da OpenAI e à API de Respostas. Ele oferece estrutura aos desenvolvedores sem se tornar uma plataforma completa de governança corporativa.
O OpenAI Agents SDK é ideal para desenvolvedores que criam agentes focados em OpenAI, utilizando chamadas de ferramentas, transferências, rastreamento e lógica de agente estruturada.

O IBM watsonx Orchestrate é uma plataforma de orquestração de IA para automação de fluxos de trabalho empresariais. Ele ajuda organizações a coordenar assistentes, agentes de IA, habilidades, dados e agentes humanos por meio de experiências em linguagem natural. É menos focado em frameworks de desenvolvimento e mais alinhado à automação de negócios corporativos.
O IBM watsonx Orchestrate é ideal para empresas que automatizam fluxos de trabalho de negócios entre equipes, sistemas, assistentes de IA e agentes específicos de domínio.
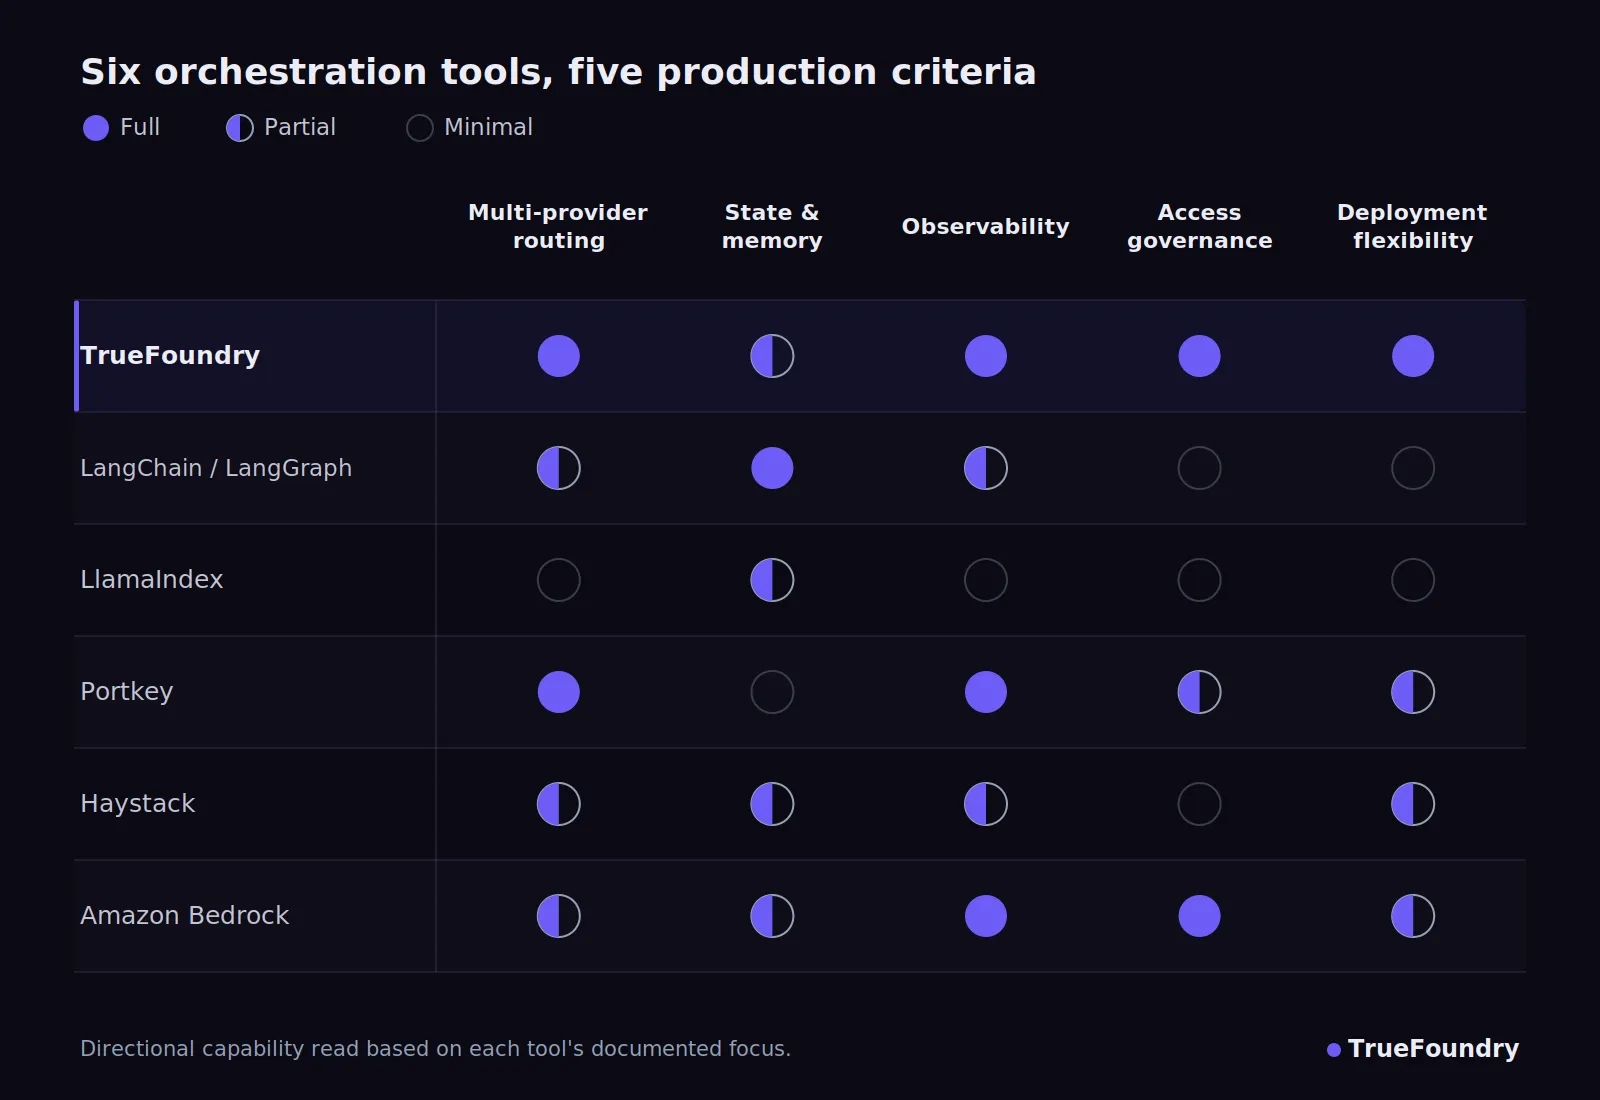
Ao comparar essas plataformas, um padrão se torna claro. Cada ferramenta resolve apenas uma parte do problema de produção. Frameworks de desenvolvimento criam fluxos de trabalho. Frameworks de recuperação conectam o conhecimento. Gateways roteiam chamadas. Serviços em nuvem gerenciam a infraestrutura dentro de seus próprios ecossistemas.
A lacuna aparece quando as equipes precisam de uma camada de responsabilidade única que abranja todos os componentes de IA. O gerenciamento de credenciais, a aplicação de políticas, a residência de dados, orçamentos em tempo real, evidências de auditoria e permissões de ferramentas geralmente permanecem fora do framework. Esse trabalho geralmente chega às equipes de plataforma depois que o protótipo se torna um produto.
Frameworks como LangChain, LangGraph, Haystack e LlamaIndex oferecem blocos de construção sólidos. Eles não substituem uma camada de governança. As equipes ainda precisam de identidade em nível de infraestrutura, controle de acesso, padrões de implantação e logs que sobrevivam a uma revisão de conformidade.
Plataformas de gateway lidam com o roteamento de forma mais direta. Elas ainda exigem uma avaliação cuidadosa em relação à residência, armazenamento, propriedade de políticas e implantação privada. Uma empresa regulamentada não pode tratar o roteamento de modelos como se fosse a mesma coisa que governança corporativa.
Serviços nativos de nuvem reduzem o trabalho de infraestrutura dentro de uma única nuvem. A limitação surge quando as equipes precisam de diferentes provedores de LLM, ferramentas externas, implantação híbrida ou governança entre nuvens. A camada de orquestração torna-se, então, fragmentada.
O custo é outra lacuna comum. Vincular gastos a uma equipe, fluxo de trabalho, agente e usuário em tempo real exige uma atribuição centralizada. Sem essa camada, a primeira fatura significativa geralmente se torna a primeira reunião séria de governança.
A TrueFoundry não exige que as equipes removam os frameworks que já utilizam. Ela adiciona uma camada de governança de infraestrutura sobre o código de orquestração existente. O LLM Gateway controla o acesso a modelos, roteamento, fallback, observabilidade, limites de taxa e custos entre provedores.
Cada chamada de modelo pode passar pelo ponto de controle do gateway, independentemente do framework que a acionou. Isso permite que políticas de acesso, regras de roteamento, logs e atribuição de custos sejam aplicados uma única vez na camada de infraestrutura, em vez de serem reconstruídos em cada serviço.
OMCP Gateway estende a mesma governança para chamadas de ferramentas. Quando um agente busca uma ferramenta externa ou fonte de dados por meio do Model Context Protocol, a ação pode seguir os mesmos padrões de autorização, observabilidade e auditoria de uma solicitação de modelo.
OGateway de Agentes ajuda a governar o comportamento de agentes de várias etapas. Ele pode oferecer suporte a limites de fluxo de trabalho, aplicação de políticas, controles de agente e rastreabilidade em fluxos de trabalho conectados a ferramentas. Isso é fundamental à medida que agentes em produção começam a atuar em sistemas corporativos ativos.
O controle de custos é realizado em tempo real no nível da equipe e do fluxo de trabalho. Orçamentos rígidos e políticas de roteamento ajudam a reduzir surpresas antes que os custos se acumulem. As equipes também podem revisar o custo do gateway de IA ao planejar quando a atribuição de custos se torna um requisito de produção.
A implantação é outra grande vantagem. A TrueFoundry pode ser executada em padrões de implantação SaaS, VPC, on-premise e air-gapped. Isso oferece aos compradores corporativos um controle mais rigoroso quando prompts, conclusões, rastreamentos e logs não podem sair de ambientes aprovados.
Para agentes conectados a ferramentas, os padrões de MCP corporativo tornam-se importantes porque ferramentas externas podem acessar sistemas ativos. A TrueFoundry ajuda as equipes a controlar essas chamadas antes da execução, em vez de descobrir riscos após a conclusão de um fluxo de trabalho.
Agende uma demonstração com a TrueFoundry para comparar seus frameworks, provedores e necessidades de implantação atuais com uma arquitetura de referência de Gateway de IA governada.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada