



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Vijf model providers betekent vijf SDK's, vijf API-sleutels, vijf facturen en vijf sets met rate limits. OpenRouter voegt dat samen tot één endpoint. Wijs de OpenAI SDK aan naar een andere basis-URL, verander de model-string, en dezelfde client kan Claude, Gemini, Llama of DeepSeek aanroepen.
Zover komt elke quickstart wel. Onder de motorkap is OpenRouter een marktplaats. Het kiest welke bedrijf elk verzoek verwerkt, beheert je geld en betaalt de providers. We hebben getraceerd wat er gebeurt tussen je code en het model, met getallen uit onze eigen tests waar we die hebben.
OpenRouter is een gehoste HTTP-API die inference-verzoeken routed naar third-party model providers via een enkel endpoint en credential, en je standaard factureert voor modelgebruik. Het accepteert drie verzoeksindelingen: OpenAI Chat Completions, de OpenAI Responses API en Anthropic's Messages API op /api/v1/messages. Er zijn client-SDK's voor TypeScript, Python en Go, maar dat is een getypte laag over dezelfde REST API, dus de standaard OpenAI SDK met een gewijzigde baseURL werkt net zo goed.
OpenRouter heeft twee kanten. Aan de ene kant werft het providers, stelt het het contract op waartegen ze integreren en betaalt het hen. Aan de andere kant beheert het je vooraf betaalde credits en consolideert het de facturering voor allemaal. Het bevindt zich zowel in je betalingspad als in je verzoekpad, wat het handig maakt, maar ook de reden is waarom overstappen meer vereist dan alleen het wijzigen van een URL.
Je huurt toegang tot de modellen van andere bedrijven. Er is geen self-hosted of air-gapped versie van OpenRouter, en het kernproduct is closed-source. De SDK's en documentatie zijn openbaar. Het begon als Window, een Chrome-extensie om meerdere modellen tegelijk te gebruiken, en heeft sindsdien server-side tools toegevoegd zoals web search, web fetch en execution in een gesandboxte shell die modellen halverwege een verzoek kunnen aanroepen.
Eén verzoek doorloopt deze stappen:
https://openrouter.ai/api/v1 met één API-sleutel, in elk van de drie indelingen.vendor/model-vorm, verwijst naar een lijst van provider-endpoints die dat model aanbieden.sort, order, only en data-policy overschrijven dat.attempt-veld in de respons is het enige in-band signaal dat dat is gebeurd.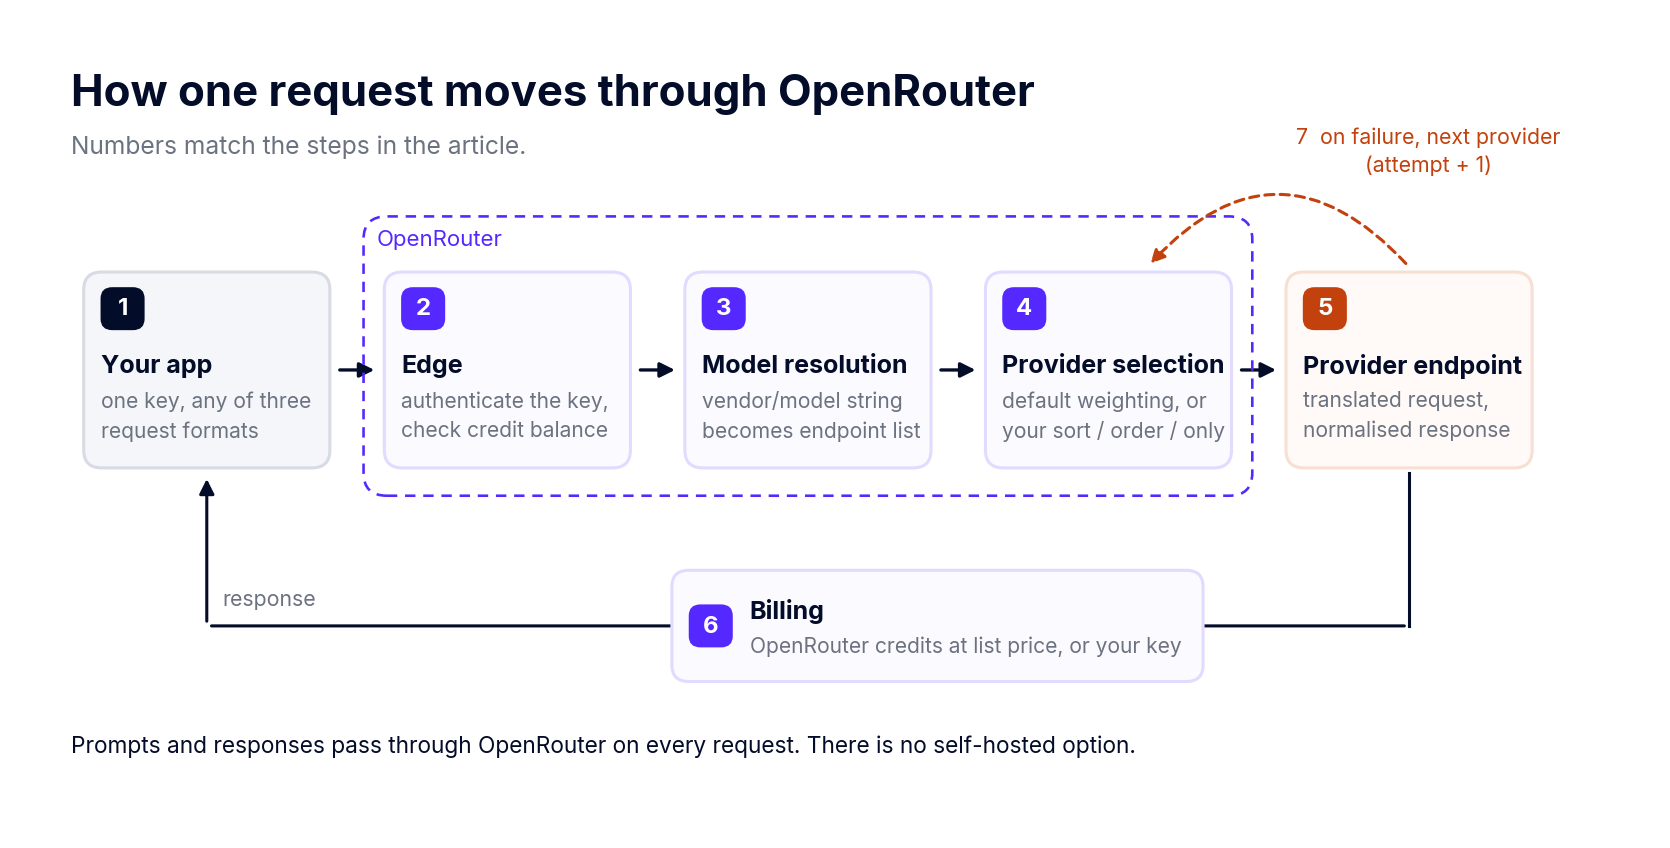
De model-string vertelt je niet wie het model uitvoert. De vendor-prefix geeft aan van wie het model is, niet op wiens servers het staat. Toen we anthropic/claude-3-haiku testen, werd het geleverd door Amazon Bedrock.
Voor open-weight modellen wordt het verschil nog groter. Op 5 oktober bevatte de API van OpenRouter 11 endpoints voor meta-llama/llama-3.3-70b-instruct. Over die 11 verspreid:
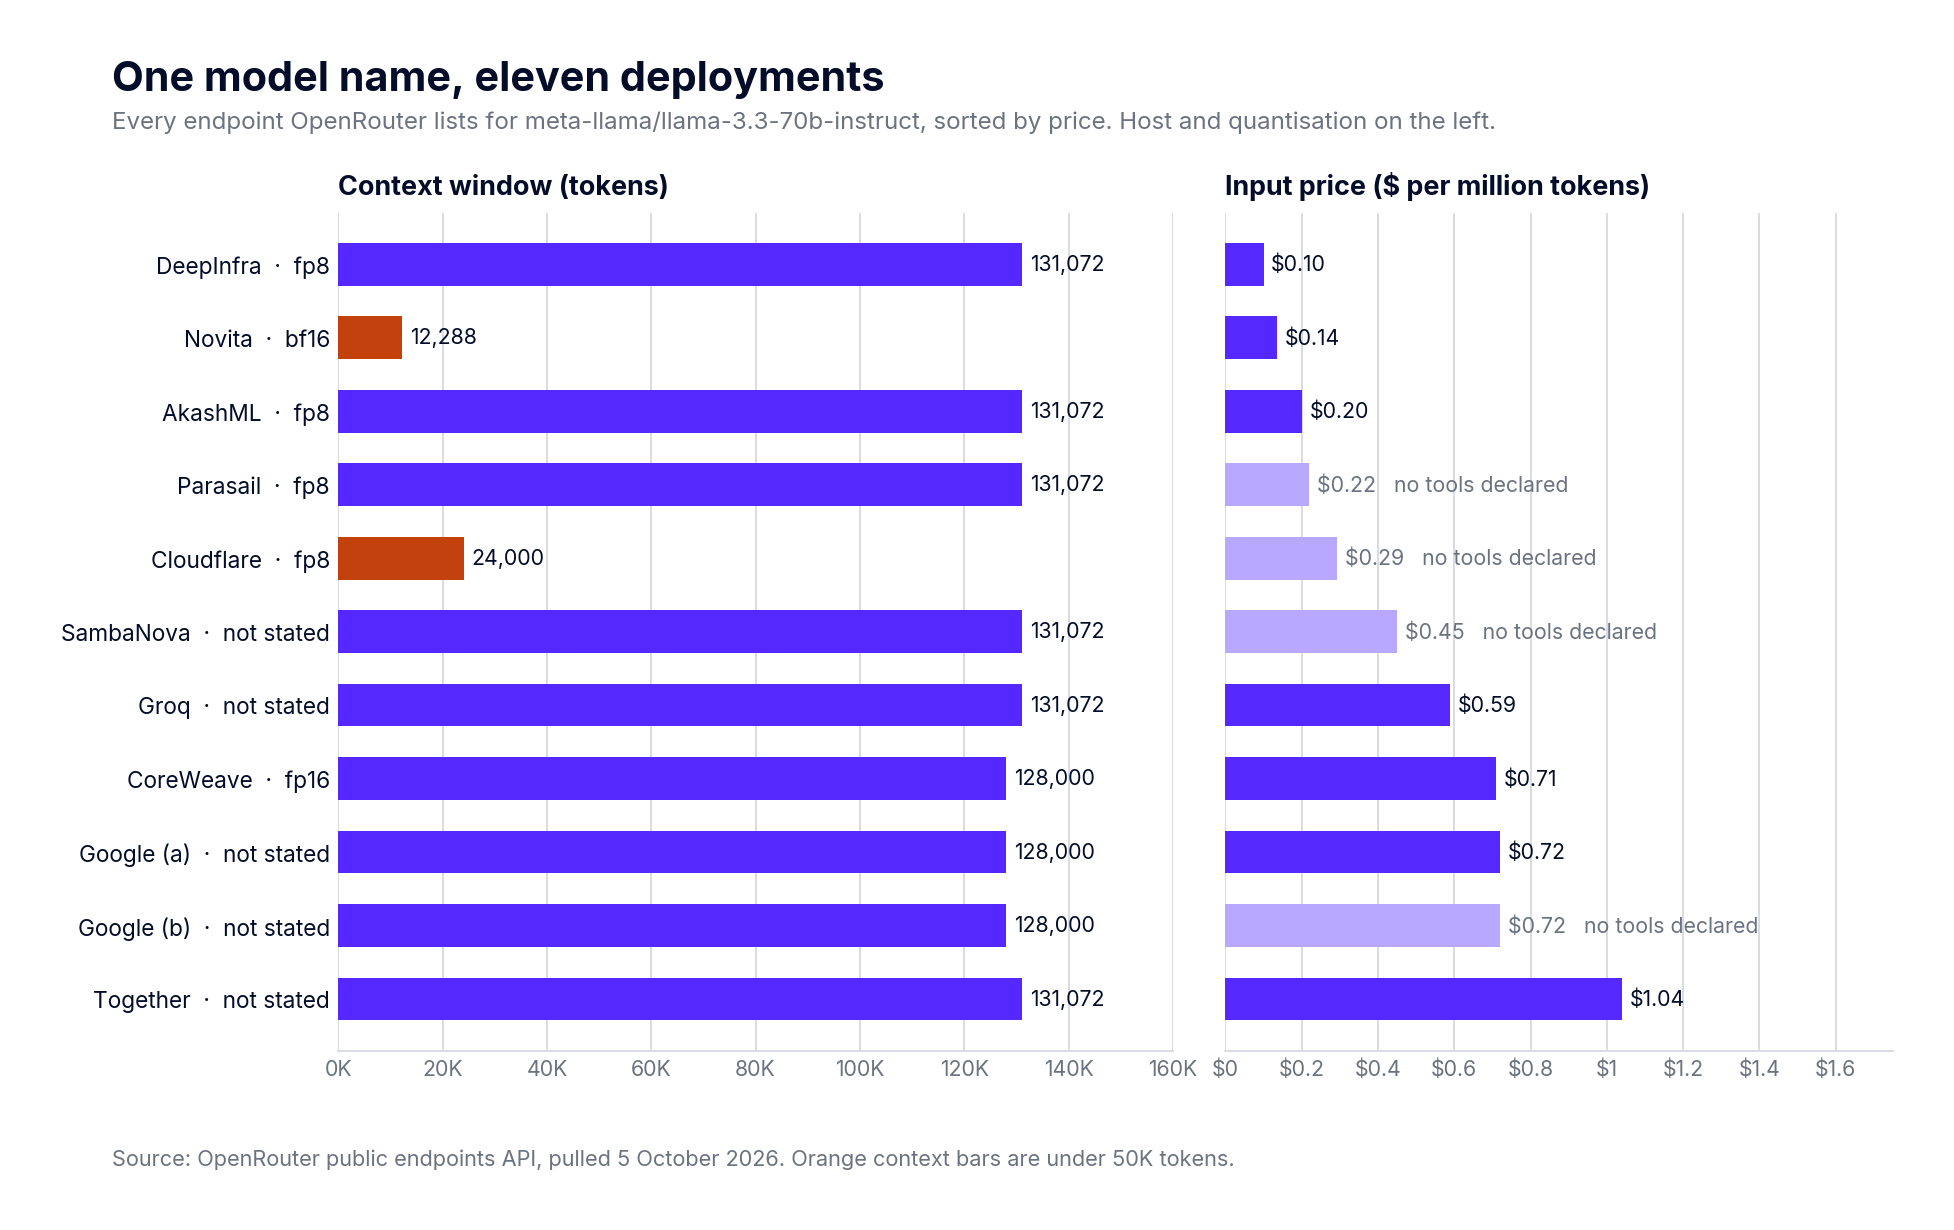
Zelfde naam, wezenlijk verschillende producten. Als je prompts lang zijn, zijn het 12K-endpoint en het 131K-endpoint niet onderling uitwisselbaar, en kiest de standaard router deels op basis van prijs. OpenRouter filtert wel op functionaliteit wanneer een verzoek dat nodig heeft: toen we acht verzoeken stuurden met tool_choice: required en geen vastgepinde provider, kwam elk verzoek terecht op een host die ondersteuning voor tools opgeeft. Maar opgegeven is niet hetzelfde als werkend. Eén host die ondersteuning voor tools opgeeft, gaf helemaal geen tool call terug toen we hiernaar vastpinden en er een afdwongen.
Lees /api/v1/models/{model}/endpoints voordat je een model-string vertrouwt, en pin of filter providers overal waar kwantisatie, contextlengte of tool-gedrag van belang zijn.
De API van OpenRouter bevatte 466 modellen verspreid over 65 vendor-namespaces op 5 oktober, vergeleken met 428 toen we deze voor het eerst ophaalden op 8 september. Embedding-modellen staan op een afzonderlijk endpoint, /api/v1/embeddings/models, waar er nog 33 stonden. Tel die bij elkaar op en je komt dicht bij de "500+ modellen" op de prijzenpagina van OpenRouter. De aantallen providers sluiten minder precies aan: de providers-endpoint gaf 112 items terug, waarvan één genaamd FakeProvider, tegenover "80+" in de marketing. Raadpleeg de API in plaats van af te gaan op een aantal in een blogbericht, inclusief dit bericht.
De standaard route verdeelt het verkeer. Het optimaliseert niet voor prijs of snelheid. In onze test van september met Llama 3.3 70B, met acht verzoeken per strategie, was de standaardoptie de langzaamste met een mediaan van 935 ms en kostte het dubbel zo veel als sort: price. sort: throughput was het snelst met 289 ms, voor sort: latency met 347 ms, en er zat een factor 10 verschil tussen de goedkoopste en duurste strategieën voor dezelfde prompt. Acht verzoeken is genoeg om aan te tonen dat de instructies werken en verschillen. Het is een te kleine steekproef om hosts te rangschikken. Als kosten of snelheid belangrijk voor je zijn, stel dan een sortering in.
Twee details over fallbacks. Een verkeerd gespelde provider-slug in order wordt stilzwijgend negeerd in plaats van geweigerd, dus een typfout verkleint alleen je lijst. En zoals hierboven opgemerkt, is attempt het enige signaal dat een fallback is geactiveerd.
De OpenAI SDK werkt direct als vervanging, en voor het meeste chatverkeer is dat alles wat nodig is. De randgevallen zijn parameters die een specifieke route niet ondersteunt; deze worden meestal geaccepteerd met een 200 en niet toegepast. We hebben de prediction-parameter van OpenAI naar GPT-4o mini gestuurd, die ondersteuning hiervoor opgeeft, en kregen een normale respons zonder enig teken dat het effect had. Als een parameter je output of je factuur verandert, controleer dan de respons op bewijs dat het heeft gewerkt.
Je betaalt de catalogusprijs van de provider per token. OpenRouter voegt daar geen opslag aan toe. De omzet komt uit een fee wanneer je credits koopt: 5,5% op het Standard-plan met een minimum van $ 0,80, 8% op Business en 5% voor crypto. Met je eigen provider-sleutel is de eerste $ 25.000 per maand aan gebruik tegen catalogusprijs kosteloos, en 5% daarna. Credits kunnen een jaar na aankoop verlopen. De prijzen zijn in veertien maanden tijd twee keer gewijzigd, dus raadpleeg de prijzenpagina van OpenRouter voordat je de kosten modeleert. Onze OpenRouter pricing breakdown gaat hier dieper op in.
Prompts en responsen verlopen altijd via OpenRouter. Je kunt de dienst niet zelf beheren of air-gapped houden. De beschikbare opties op de gehoste dienst zijn routing zonder dataretentie, een data_collection: "deny"filter die alleen naar providers meeneemt die je gegevens niet verzamelen, en in-region routing. In-region routing vereiste voorheen een Enterprise-contract. Sinds september is het beschikbaar op het self-serve Business-plan: stuur verzoeken naar eu.openrouter.ai of us.openrouter.ai en ze worden uitsluitend in die regio verwerkt, waarbij de aanvraag mislukt met een foutmelding als er geen in-region endpoint bestaat. De gedocumenteerde afwegingen: OpenRouter's eigen prompt- en respons-logging wordt overgeslagen op regionale endpoints, en Batch, web fetch, gesandboxte shell, bestand- en afbeelding-tools en de Auto Router zijn daar niet beschikbaar.
Beide onderwerpen worden behandeld in hun eigen artikelen. OpenRouter rate limits legt uit waarom je limiet voor gratis modellen afhangt van wat je hebt betaald, en OpenRouter prompt caching behandelt waarom dezelfde caching-functionaliteit negen verschillende prijzen heeft.
De documentatie van OpenRouter vermeldt dat het aan de edge draait om overhead minimaal te houden. Op de homepage stond voorheen een specifiek getal, rond de 25 ms, en veel gidsen herhalen dit nog steeds. Sinds 5 oktober vermeldt de homepage alleen nog "minimale latency". De documentatie voegt daar één detail aan toe: wanneer je wisselkoers- of wissel-saldo laag wordt, laat OpenRouter zijn edge-caches agressiever verlopen om de facturering nauwkeurig te houden, wat latency toevoegt totdat je opwaardeert.
Wij hebben het gemeten. Dezelfde 100 prompts zijn op drie manieren verzonden: rechtstreeks naar de provider, via OpenRouter met credits, en via OpenRouter met onze eigen provider-key. Verzoeken werden afgewisseld en per prompt gekoppeld, zodat de prompt-inhoud het verschil niet beïnvloedt, en elk verzoek werd vastgezet op de first-party provider van het model en per verzoek gecontroleerd.
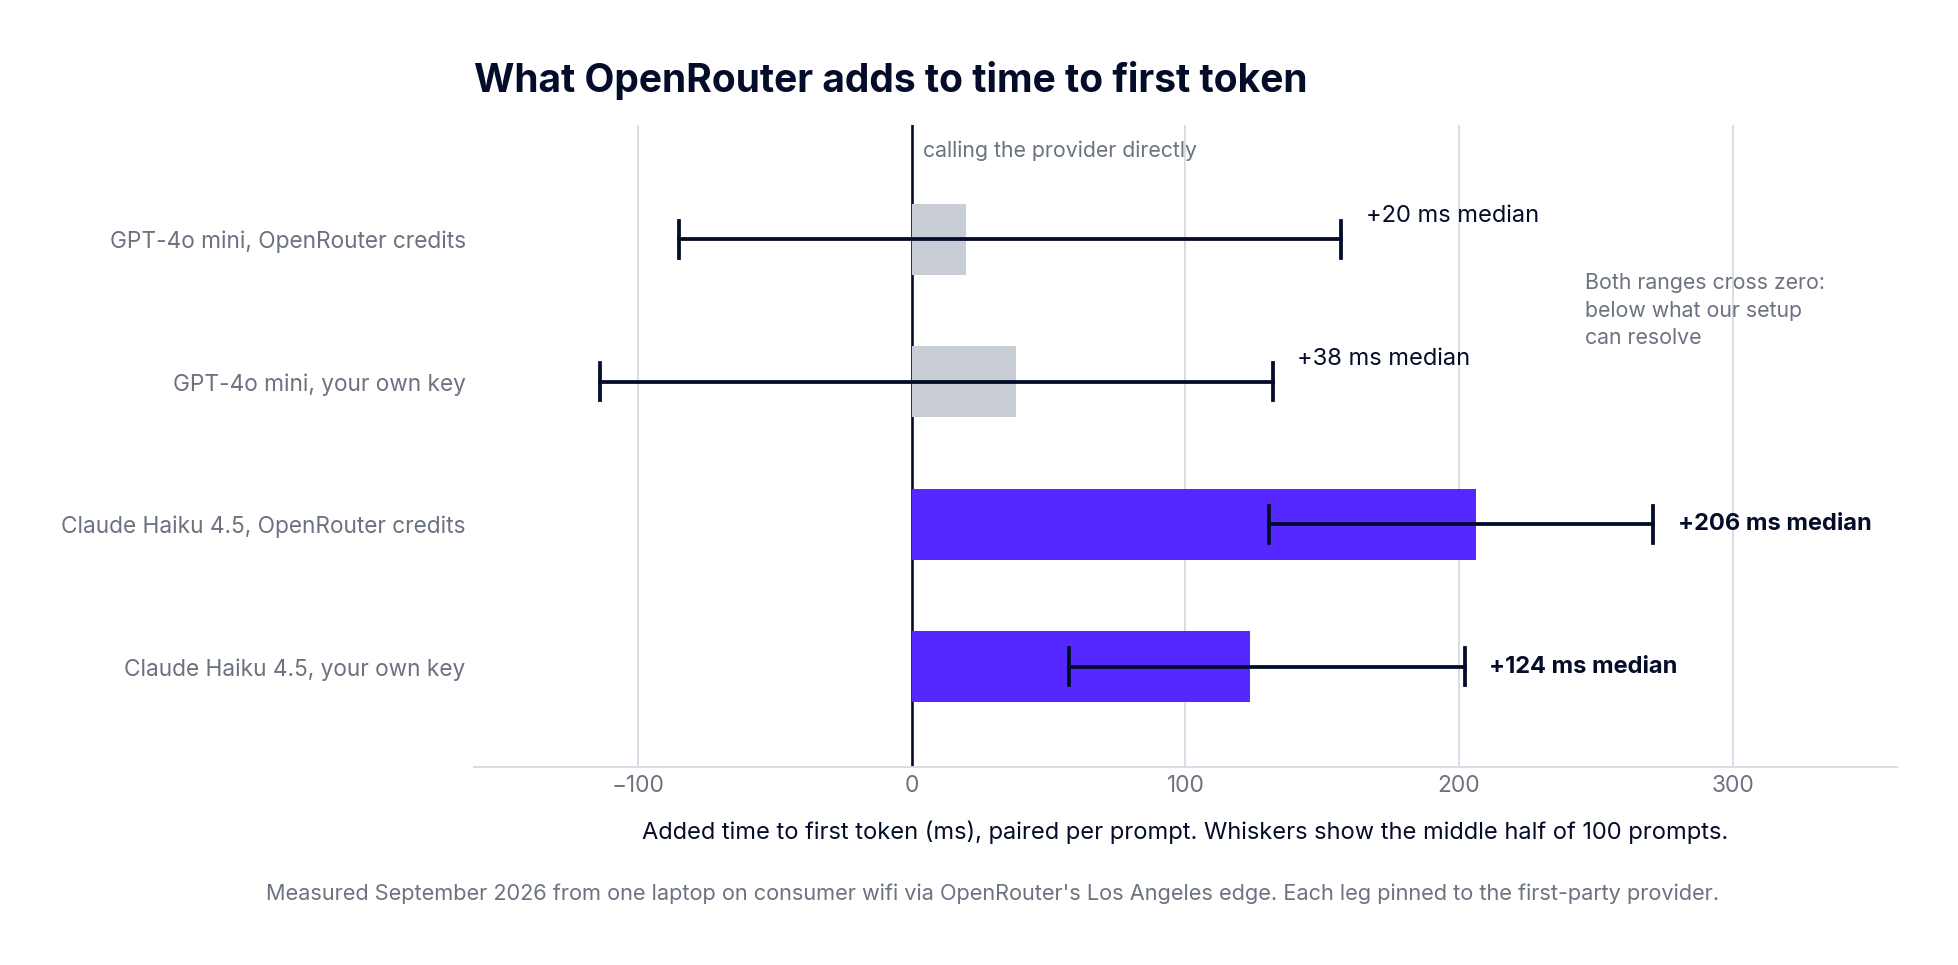
Bij GPT-4o mini konden we geen overhead meten. De mediane toegevoegde time to first token was 19,7 ms op credits, maar het middelste deel van de resultaten varieerde van 85 ms sneller tot 157 ms trager, wat betekent dat het werkelijke getal onder de resolutie van onze opstelling ligt. Bij Claude Haiku 4.5 was het ondubbelzinnig: 206 ms toegevoegd op credits en 124 ms met onze eigen key, waarbij het interkwartielbereik ruim boven nul lag. Zonder streaming, over twee tests, voegden credits 837 en 883 ms toe aan de volledige respons, terwijl onze eigen key binnen 42 ms bleef van rechtstreeks verbinden.
Credits en je eigen key gaan door dezelfde gateway en dezelfde vertaling, dus het verschil zit in het upstream-account. Onze beste verklaring, wat een aanname is, is de drukte op de gedeelde Anthropic-capaciteit van OpenRouter. Op een drukke provider levert het meebrengen van je eigen key niet alleen controle over de facturering op, maar ook lagere latency.
Dit alles is uitgevoerd vanaf één laptop op een consumenten-wifi-verbinding via de edge-locatie van OpenRouter in Los Angeles, in september 2026. Zie de verschillen als reëel en de absolute getallen als specifiek voor onze opstelling.
OpenRouter is in 2023 opgericht door Alex Atallah, mede-oprichter van OpenSea. Op 19 augustus 2026 kondigde Stripe een overeenkomst aan om het over te nemen. Begin oktober was de overname volgens de berichten nog niet afgerond en heeft geen van beide bedrijven een overnamesom bekendgemaakt; persberichten schatten deze op meer dan $ 7 miljard. OpenRouter heeft verklaard dat het product en de toezeggingen niet zullen veranderen.
De omzet van OpenRouter bestaat uit een toeslag op betalingen, de prijzen worden vastgesteld door een betalingsbedrijf en de neutraliteit tussen providers is een uitgesproken toezegging in plaats van iets dat in de structuur is ingebouwd. Een team dat op het punt staat om hier twee jaar lang op te bouwen, moet dat meenemen in de evaluatie, naast de routing- en latency-cijfers, en dan een beslissing nemen.
OpenRouter wordt vergeleken met LLM gateways zoals LiteLLM of die van ons. Beide plaatsen één API voor meerdere modellen. Het zijn verschillende producten. Onze uitleg over wat een LLM gateway is behandelt het algemene concept.
Twee rijen vereisen een korte toelichting. Het control plane en het data plane van OpenRouter zijn hetzelfde systeem, dus als het eruit liegt, ligt alles erachter er ook uit. De eigen engineering-blog beschrijft een database-storing van ongeveer 50 minuten in augustus 2025 die de routing platlegde, en stelt dat de totale uptime nog steeds beter is dan die van een individuele provider; in onze eigen tests over ongeveer 4.300 verzoeken hebben we geen enkele 4xx- of 5xx-fout gezien. En wat betreft identiteit: keys zijn eigendom van het lid dat ze heeft aangemaakt, en het deactiveren van die persoon via SCIM deactiveert hun keys, wat de juiste standaardinstelling is voor personen, maar een lastige voor productie-workloads.
OpenRouter is geschikt voor het prototypen over meerdere modellen, wanneer je één key en één factuur wilt en liever geen contract afsluit met elke provider die je probeert. Het is ook geschikt voor open-weight modellen, waarbij het kiezen van de host op basis van prijs of doorvoer echt geld bespaart, zolang je prompts je netwerk mogen verlaten, met of zonder regionale beperking.
Het is geen goede keuze wanneer prompts op je netwerk moeten blijven, wanneer workloads machine-identiteiten nodig hebben in plaats van keys die eigendom zijn van personen, of wanneer het onacceptabel is dat een storing bij één leverancier elk model offline haalt. Hetzelfde geldt als latency van belang is bij een drukke provider en je geen eigen key kunt meebrengen, of als de afdeling inkoop sowieso rechtstreekse contracten met elke provider wil.
De TrueFoundry AI Gateway draait in je VPC, on-premise of air-gapped, en roept providers rechtstreeks aan met je eigen contracten en keys. Het ontsluit 1.000+ LLMs via één OpenAI-compatibele API, voegt ongeveer 3 tot 4 ms aan overhead toe en verwerkt 350+ RPS op een enkele vCPU.
Je kunt OpenRouter in die opstelling behouden. Het wordt ondersteund als provider in TrueFoundry, zodat de catalogus beschikbaar blijft voor experimenten, terwijl je eigen rate limits, budgetten, toegangsbeheer en logging er vóór zitten. Voor teams die al op OpenRouter zitten, is dat meestal de eerste stap met het minste risico.
OpenRouter is één API voor een marktplaats. Het kiest wie elk verzoek afhandelt, beheert je credits en betaalt de providers. Voordat je een model-string als een stabiel product beschouwt, moet je de lijst met endpoints lezen, een routing-sortering instellen en de overhead meten op de providers die je daadwerkelijk gebruikt.
Als je die enkele API binnen je eigen infrastructuur wilt, bekijk hoe de TrueFoundry AI Gateway werkt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



OpenRouter is a hosted, OpenAI-compatible API that gives you access to hundreds of AI models from many providers through one endpoint and one API key. It picks which provider serves each request, bills you at the provider's list price, and charges a fee when you buy credits. You cannot run it yourself, so prompts always pass through OpenRouter's infrastructure.
Partly. OpenRouter offers free variants of some models, capped at 20 requests per minute and 50 requests per day, rising to 1,000 a day once you've bought at least 10 credits. Paid models are billed at the provider's list price, plus a fee on each credit purchase. Our post on OpenRouter rate limits has the detail.
Dat hangt af van de provider. In onze gepaarde tests was de toegevoegde time-to-first-token op GPT-4o mini te klein om te meten, terwijl Claude Haiku 4.5 via OpenRouter-credits ongeveer 206 ms toevoegde, of ongeveer 124 ms met onze eigen Anthropic-sleutel. OpenRouter zelf publiceert geen overhead-cijfer meer.
1,000+ LLMs through a single OpenAI-compatible API. Switching models means changing the model name in the request — same URL, same credentials — which is what makes swapping in a new provider a configuration change rather than an integration project.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.



Het laatste nieuws, artikelen en bronnen in je inbox



















