



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het platform van Vercel, en in het bijzonder de AI SDK en de 1-klik deploy-on-push-workflow, maakt het eenvoudig voor frontend-teams om binnen enkele minuten AI-demo's operationeel te hebben. De Vercel AI SDK is een gratis, open-source toolkit waarmee teams snel AI-functionaliteiten kunnen opleveren.
De prijzen van Vercel waren echter oorspronkelijk ontworpen voor statische websites en kortstondige webfuncties. Zodra de AI-workload van een applicatie langlopend wordt — zoals het streamen van responsen door multi-step agents of zware RAG-pipelines — verandert het Vercel AI-prijsmodel drastisch.
In plaats van vaste maandelijkse tarieven begint u te betalen per milliseconde serverless-uitvoeringstijd en per gigabyte aan overgedragen data. In de praktijk zien teams hun voorspelbare rekeningen van $20/maand enorm stijgen zodra chatbots en agents de bronlimieten van Vercel bereiken.
In deze gids leggen we uit hoe de prijzen voor Vercel AI werken, welke verborgen kosten AI-workloads met zich meebrengen en waarom engineering-teams uiteindelijk overstappen naar private cloud-platforms zoals TrueFoundry om deze kosten te vermijden.
Vercel gebruikt nu een hybride model dat gebruikersseats combineert met verbruiksquota en kosten voor overschrijding. Eenvoudig gezegd: hobbygebruik is gratis, maar professionele gebruikskosten groeien mee met de omvang van uw team en uw compute-behoeften. Hieronder vindt u een overzicht van elk niveau en de implicaties voor AI-applicaties.
Het Hobby-pakket is ontworpen voor persoonlijke projecten en is gratis. De voorwaarden van Vercel beperken dit tot persoonlijk, niet-commercieel gebruik, waardoor het niet de juiste keuze is voor een zakelijke applicatie. Het bevat functionaliteiten zoals een wereldwijde CDN, 1 miljoen CDN-verzoeken per maand, 100 GB snelle data-overdracht en Fluid Compute.
De limiet voor de functieduur is niet universeel 60 seconden. Met Fluid Compute ingeschakeld kunnen ondersteunde Node.js- en Python-functies op Hobby tot 300 seconden (5 minuten) draaien. Het oudere maximum van 60 seconden geldt voor functies die geen Fluid Compute gebruiken. Als een functie de geconfigureerde duur overschrijdt, kan deze een 504 timeout-fout retourneren.
Voor AI-applicaties betekent dit dat Hobby kan werken voor prototypes en korte verzoeken, maar u moet uw werkelijke workload testen tegen de duur- en verbruikslimieten. Langlopende agent-taken, documentverwerking en workflows met meerdere stappen vereisen mogelijk een andere uitvoeringsstrategie of pakket.
Het Pro-pakket begint bij $20 per maand, inclusief $20 aan maandelijkse verbruiksedits en gratis viewer-seats. Extra developer-seats kosten $20 per maand per stuk. In plaats van te vertrouwen op één vaste compute-vergoeding, combineert Pro het inbegrepen wisselgeld met verbruiksgebaseerde prijzen voor bronnen zoals compute en functie-aanroepen.
Bij Fluid Compute scheidt de facturering actieve CPU-tijd van toegewezen geheugentijd. CPU-kosten zijn van toepassing terwijl code wordt uitgevoerd; geheugenkosten lopen door zolang de functie-instantie actief blijft, inclusief wanneer deze wacht op een externe dienst zoals een AI-model of database. Dat onderscheid is van belang voor AI-applicaties: een verzoek dat lang wacht op een API gebruikt mogelijk weinig actieve CPU, maar brengt wel geheugenkosten met zich mee.
Pro-functies die Fluid Compute gebruiken, hebben een standaardduur van 300 seconden en kunnen langer draaien wanneer ze daarvoor zijn geconfigureerd. Vanaf juni 2026 kunnen ondersteunde Node.js- en Python-functies tot 30 minuten draaien op Pro en Enterprise met Fluid Compute; tijdsduren boven 800 seconden zijn in beta.
Pro kan productie-AI-applicaties ondersteunen, maar de kosten hangen af van het aantal developer-seats en het werkelijke verbruik van middelen. Schat voor de lancering het compute- en data-overdrachtsverbruik in, monitor het verbruiksdashboard en stel bestedingslimieten in. Voorkom dat u één voorbeeld of een vast tarief per verzoek gebruikt als een betrouwbare voorspelling voor elke AI-workload.
Het Enterprise-pakket maakt gebruik van aangepaste prijzen op basis van de vereisten van een organisatie. Vercel positioneert het voor teams die geavanceerde beveiliging, prestaties, observability, ondersteuning en servicegaranties op platformniveau nodig hebben. De gepubliceerde functionaliteiten omvatten SCIM-directory-synchronisatie, beheerde WAF-regelsets, multi-region compute en failover, en een SLA van 99,99%.
Enterprise biedt ook meer flexibiliteit voor het schalen van workloads. Ondersteunde Node.js- en Python-functies kunnen tot 30 minuten draaien met Fluid Compute, afhankelijk van de toepasselijke configuratie en beta-beperkingen. Een langere uitvoering betekent echter geen onbeperkte of gratis compute: kosten en gebruiksvoorwaarden hangen af van de Enterprise-overeenkomst.
Evalueer voor organisaties die AI-applicaties op schaal implementeren het Enterprise-pakket op basis van de beheeropties, ondersteuning, regionale vereisten en servicegaranties die u daadwerkelijk nodig hebt. Vraag, aangezien de prijzen op maat zijn, een offerte aan bij Vercel in plaats van uit te gaan van een aangenomen jaarlijkse instapprijs.
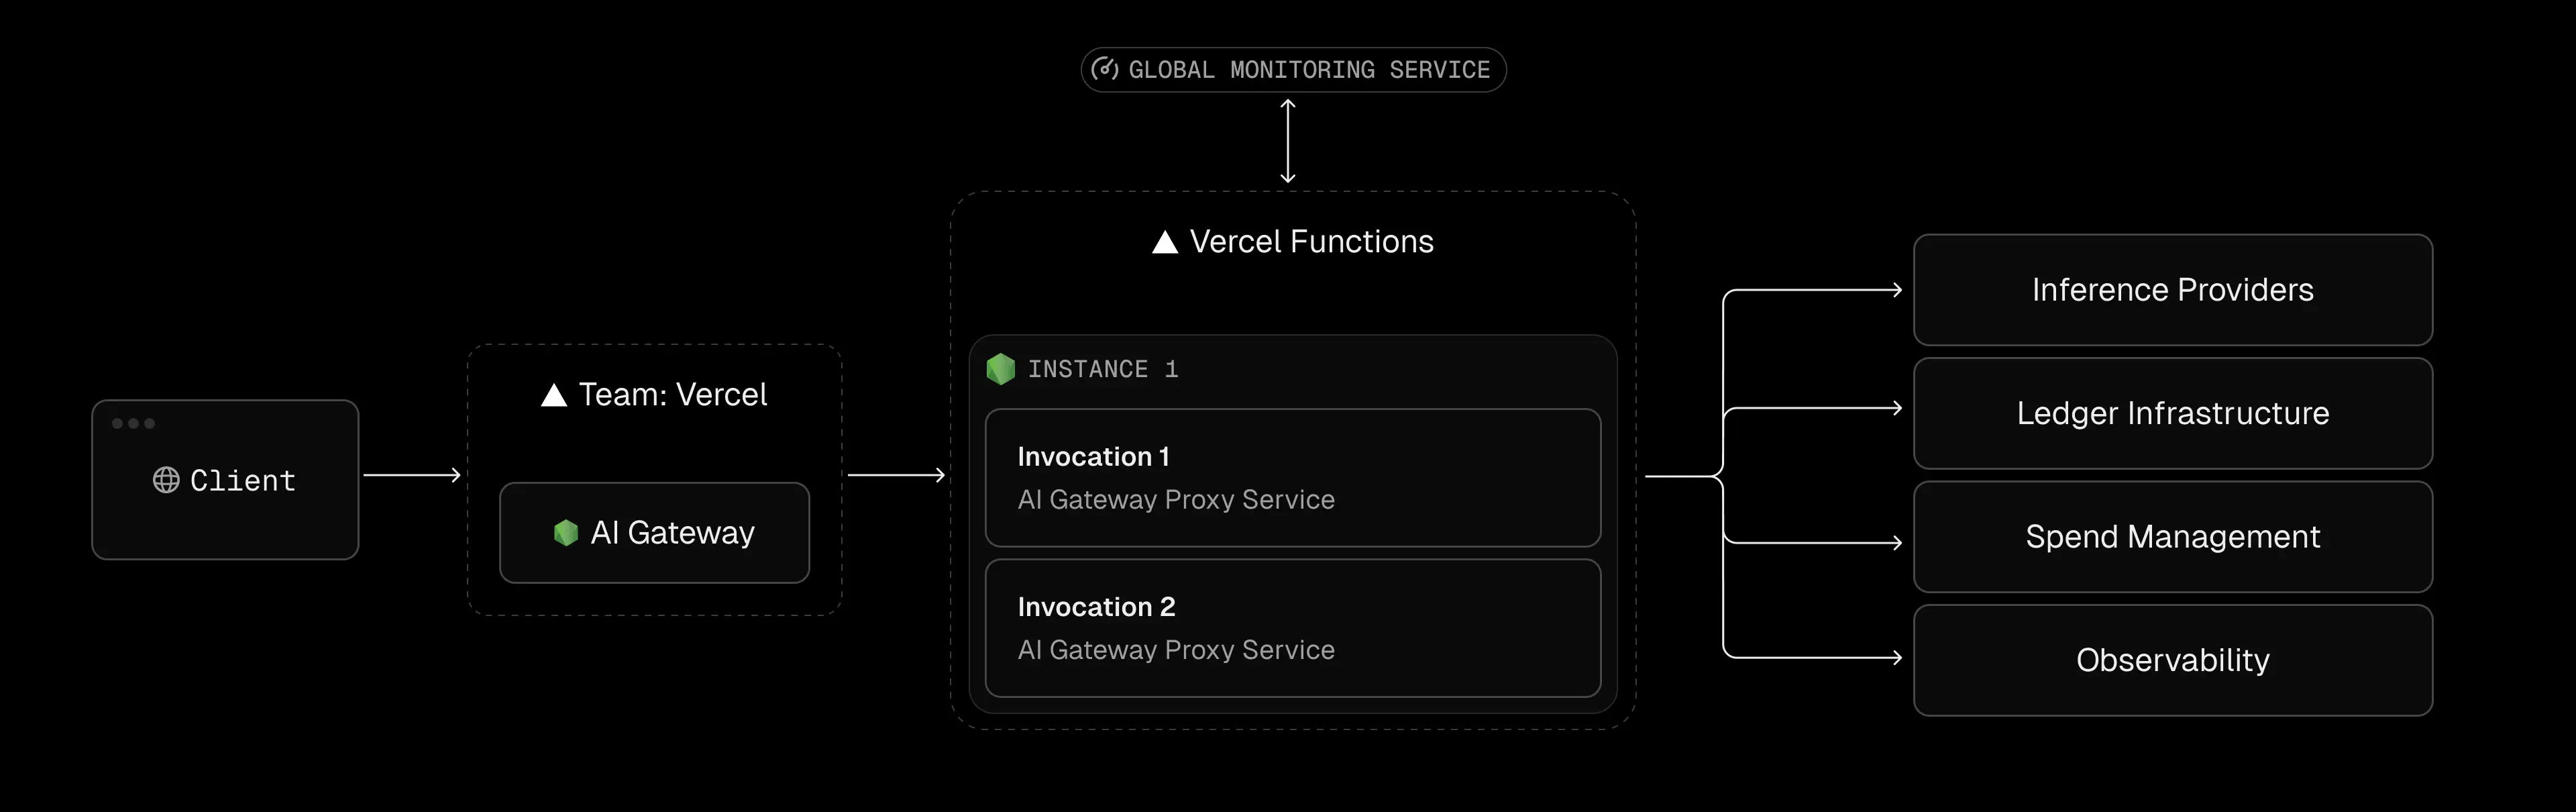
Vercel AI Gateway biedt één API om toegang te krijgen tot AI-modellen van verschillende providers. Om uw kosten te schatten, moet u het modelgebruik scheiden van de kosten voor het hosten van uw applicatie. Uw totale uitgaven kunnen AI-tokens, Vercel compute en data-overdracht omvatten.
Vercel AI Gateway biedt een gratis startpunt, met $5 aan maandelijkse credits die beschikbaar zijn voor in aanmerking komende teamaccounts na hun eerste verzoek. Zodra die credits zijn verbruikt, kan voor aanvullend gebruik de aankoop van credits vereist zijn.
AI Gateway dekt in aanmerking komende modelverzoeken en biedt functionaliteiten voor het routeren van verzoeken en het monitoren van het verbruik. Het dekt niet alle kosten van het draaien van uw applicatie. Vercel Functions, compute, geheugen en data-overdracht kunnen afzonderlijk worden gefactureerd onder uw Vercel-pakket.
De kosten voor AI Gateway hangen af van het model dat u selecteert en het aantal verwerkte input- en output-tokens. Langere prompts, grotere contextvensters en langere gegenereerde antwoorden kunnen het tokenverbruik verhogen. Uw rekening hangt af van de tarieven van het geselecteerde model en de toepasselijke facturatieregeling.
Verschillende AI-modellen hebben verschillende prijzen, zelfs wanneer ze vergelijkbare taken uitvoeren. Met AI Gateway kunt u modellen vergelijken en verzoeken routeren via een uniforme API. Vercel geeft aan dat het de catalogusprijzen van providers doorberekent zonder een opslag op tokens toe te voegen.
Uw applicatie kan afzonderlijke kosten met zich meebrengen voor de uitvoering van functies, toegewezen geheugen en data-overdracht. Deze kosten hangen af van uw pakket, regio, configuratie en verkeer. Een applicatie die functies laat draaien tijdens lange AI-responsen kan bijvoorbeeld meer factureerbare geheugentijd verbruiken.
De prijzen van Vercel zijn ontworpen rond het implementeren en schalen van webapplicaties, maar AI-workloads kunnen andere eisen stellen aan de beschikbare middelen. Streaming-responsen, herhaalde model-calls, retrieval-augmented generation (RAG) en gelijktijdige agent-taken kunnen allemaal invloed hebben op uw rekening. De belangrijkste kostenveroorzakers om op te letten zijn de uitvoering van functies, geheugengebruik, data-overdracht en limieten op gelijktijdigheid.
Het facturatiemodel van Vercel is afhankelijk van hoe uw functies draaien. Met Fluid Compute worden CPU en geheugen afzonderlijk gefactureerd. CPU-kosten zijn van toepassing terwijl de code actief wordt uitgevoerd, terwijl toegewezen geheugentijd kan blijven oplopen als een functie wacht op een externe dienst of een respons streamt. Dit onderscheid is belangrijk voor AI-applicaties, waar een functie een groot deel van de tijd kan wachten op een LLM om tokens te genereren.
Neem bijvoorbeeld een chat-applicatie die een LLM-respons naar een browser streamt. Een respons die 60 seconden duurt, kost niet automatisch hetzelfde als 60 seconden aan continue CPU-verwerking. De functie kan echter factureerbare geheugenbronnen blijven verbruiken zolang de stream open blijft. Op schaal kunnen langlopende streams en veel gelijktijdige verzoeken het verbruik van middelen verhogen.
De exacte kosten hangen af van de geheugentoewijzing van de functie, het actieve CPU-gebruik, de regio en de toepasselijke facturatietarieven. In plaats van een vaste prijs per respons toe te passen, kunt u de kosten het beste schatten op basis van de werkelijke uitvoerings- en geheugenwaarden van uw workload en vervolgens het verbruik monitoren in het dashboard van Vercel.
De les: Streaming is niet per definitie te duur voor serverless hosting, maar langlopende verzoeken en een hoge gelijktijdigheid vereisen zorgvuldige kostenbewaking.
AI-applicaties maken vaak gebruik van retrieval-augmented generation (RAG) om documenten op te halen, databases te doorzoeken en relevante informatie door te geven aan een model. Deze workflows kunnen de data-overdrachtskosten verhogen, vooral wanneer grote bestanden of datasets frequent tussen diensten worden uitgewisseld.
Vercel bevat een maandelijkse data-overdrachtsvergoeding op zijn betaalde pakketten, waarbij extra verbruik wordt gefactureerd volgens het toepasselijke tarief en de overdrachtscategorie. Pro bevat 1 TB Fast Data Transfer. De tarieven voor overschrijding variëren echter per regio, dus raadpleeg de officiële prijzenpagina van Vercel voordat u de kosten schat.
Het is ook belangrijk om onderscheid te maken tussen verschillende typen data-overdracht. Het verzenden van responsen van Vercel naar gebruikers, het ophalen van gegevens van een origin en het overdragen van bestanden via diensten zoals Vercel Blob kunnen anders worden gefactureerd. Het ophalen van een document binnen een functie telt niet automatisch als uitgaande Fast Data Transfer.
Het tien keer ophalen van een document van 100 MB verplaatst bijvoorbeeld in totaal ongeveer 1 GB aan data. Of dat kosten voor bandbreedte veroorzaakt, hangt af van het overdrachtspad en de toepasselijke marges.
Als uw RAG-pipeline elke maand honderden gigabytes verwerkt, controleer dan waar uw documenten, vectordatabase en model-endpoints zijn gehost. Het dicht bij elkaar houden van diensten en het vermijden van onnodige overdrachten kan helpen om de kosten onder controle te houden.
Vercel Functions schalen automatisch, maar gelijktijdigheid is niet onbeperkt. Vercel documenteert ondersteuning voor maximaal 30.000 gelijktijdige uitvoeringen op Pro en 100.000 of meer op Enterprise. Het documenteert ook een burst-limiet van 1.000 gelijktijdige uitvoeringen per 10 seconden, per regio. Raadpleeg de documentatie over het schalen van gelijktijdigheid voor de actuele limieten en toepasselijke voorwaarden.
Deze limieten zijn belangrijk voor AI-applicaties omdat een verzoek open kan blijven staan terwijl het wacht op de output van een model. Als veel gebruikers tegelijkertijd langlopende streams starten, kunnen gelijktijdige uitvoeringen zich opstapelen, zelfs als het CPU-gebruik relatief laag is.
Wanneer een functie de toepasselijke limieten overschrijdt, kunnen verzoeken worden geknepen en fouten retourneren zoals 503 FUNCTION_THROTTLED. Het precieze gedrag hangt af van de bereikte limiet; verzoeken worden niet noodzakelijkerwijs automatisch in een wachtrij geplaatst.
Voor teams die AI-chatdiensten of agent-workflows bouwen, is het raadzaam om voor de lancering realistisch verkeer te testen met belastingtests. Monitor gelijktijdigheid en functiefouten en overweeg of langlopende taken in een afzonderlijk worker-systeem moeten draaien. Het verplaatsen van geschikte achtergrondtaken uit functies die verzoeken afhandelen, kan helpen voorkomen dat pieken in AI-activiteit de rest van uw applicatie beïnvloeden.

Een veelvoorkomende misvatting is dat het gebruik van de Vercel AI SDK u verplicht om de infrastructuur van Vercel te gebruiken. In werkelijkheid is de AI SDK slechts een toolkit (open-source, gratis) voor het bouwen van AI-functionaliteiten in Next.js/TypeScript.
U kunt de SDK gebruiken om naar elke LLM-provider te routeren, inclusief self-hosted modellen — een belangrijke overweging bij het vergelijken van Vercel AI Gateway vs OpenRouter met het oog op flexibiliteit bij providers en kostenbeheersing. Er is geen verplichting om uw code op de servers van Vercel te laten draaien. Vrijwel alle onderdelen van de SDK (UI-componenten, providers, client-libraries) werken overal. Een team zou bijvoorbeeld hun Next.js-app met de AI SDK in een container kunnen plaatsen en deze kunnen implementeren op Kubernetes (EKS/GKE) of een cloud-VM. De code "weet" niet dat deze niet op Vercel staat.
Waarom teams toch vastlopen:
Meestal uit gemak. De hosting van Vercel integreert naadloos met de SDK – u commit code, en Vercel bouwt, Flaskt/deployt en biedt zelfs een ingebouwd AI Gateway-tabblad. Veel teams klikken standaard op "Deploy to Vercel".
De keerzijde is dat dit gemak het serverless-kostenmodel verbergt. Engineers kunnen enthousiast prototypes bouwen met Vercel, zonder zich te realiseren dat elke model-call wordt gefactureerd tegen de (vaak hogere) serverless-tarieven van Vercel, totdat de rekening op de mat valt.
Naarmate op Vercel gebouwde AI-projecten groeien, ontstaan er naast de prijsvragen rondom Vercel AI diverse operationele knelpunten:
Zelfs op betaalde pakketten hanteert Vercel strenge uitvoeringslimieten. Standaard hebben HTTP-functies op Pro een timeout na 5 minuten (configureerbaar tot 13 minuten met "Fluid Compute"). Op Hobby is dat slechts 60 seconden.
In de praktijk zal elke AI-agent of onderzoeksworkflow die langer dan een paar minuten draait, worden afgebroken. Een multi-step agent die bijvoorbeeld 10–15 minuten nodig heeft om databases te raadplegen, documenten samen te vatten en een rapport te genereren, zal gegarandeerd de limiet overschrijden en mislukken.
Teams melden frequente 504-fouten bij hun AI-taken zodra ze deze limieten overschrijden. In tegenstelling hiermee kunt u op uw eigen cloudinfrastructuur functies of containers naar behoefte onbeperkt (of ten minste urenlang) laten draaien.
De edge middleware van Vercel (zoals Next.js Edge Functions) kan de prestaties verbeteren, maar brengt lock-in met zich mee.
In de praktijk bouwen teams soms kritieke logica in Edge Functions voor meer snelheid, om er later achter te komen dat migreren van Vercel een grote herschrijving vereist.
Momenteel heeft Vercel geen native GPU-instanties voor AI-workloads. Dit betekent dat elke modelinference of het genereren van embeddings dat versnelling vereist, buiten het platform moet plaatsvinden.
Teams eindigen vaak met het hosten van GPT-achtige modellen of vector-zoekopdrachten op AWS/GCP/Render/Azure met GPU's, en roepen deze vervolgens aan vanuit Vercel-functies. Deze gesplitste opzet zorgt voor extra latency (elke call maakt een stap naar een externe dienst) en operationele complexiteit.
Daarentegen kan een infrastructuur gebouwd op Kubernetes (zoals TrueFoundry) CPU-only webcode en GPU-inference zij aan zij in hetzelfde cluster laten draaien, waardoor die fragmentatie verdwijnt.
Ondanks deze kanttekeningen is Vercel geen slechte keuze voor bepaalde AI-scenario's. De sterke punten komen naar voren bij:
Samengevat: Vercel AI-prijzen werken goed voor front-end-apps die AI licht gebruiken, of voor teams die time-to-market boven alles stellen. Het kantelpunt komt wanneer AI-workloads "serieuze" onderdelen van de applicatie worden, en niet meer alleen demonstraties.
Naarmate AI-functionaliteiten centraal komen te staan in het product, bereiken veel teams een omslagpunt en zoeken ze naar alternatieven. TrueFoundry positioneert zichzelf als een oplossing die het gemak van serverless biedt gecombineerd met de voordelige tarieven van de 'raw' cloud. Hieronder vindt u een vergelijking van belangrijke factoren voor AI-workloads:
Wat betekent dit in de praktijk? Veel teams merken dat hun maandelijkse rekeningen op Vercel onevenredig stijgen in vergelijking met hun werkelijke compute. In een praktijkvoorbeeld verbruikte een dienst ~1.276 GB-uur op Vercel (wat neerkwam op ~$2000/jaar), maar slechts ~101 GB-uur op standaard AWS Lambda (free tier) voor dezelfde belasting. Kort gezegd: vergelijkbare AI-workloads kunnen veel goedkoper draaien op zelfbeheerde cloudinfrastructuur. Met TrueFoundry bestaat uw rekening in feite uit reguliere cloud-compute (EC2, GKE-nodes, enz.) plus platformkosten, in plaats van de vermenigvuldigingsfactor die serverless oplegt.

TrueFoundry biedt een hybride aanpak: u behoudt het ontwikkelaarsvriendelijke model van serverless (automatisch schalen, eenvoudige API's), maar draait op uw eigen cloudaccount. De belangrijkste aspecten zijn:
Met TrueFoundry kunt u Next.js (en elke andere app) implementeren als standaard Docker-services op Kubernetes (EKS, GKE of AKS) binnen uw eigen cloudaccount. Zoals in een blog wordt uitgelegd: "TrueFoundry maakt het heel eenvoudig om applicaties te implementeren op Kubernetes-clusters in uw eigen cloudprovideraccount." Onder de motorkap draaien uw Next.js-endpoints in pods/nodes die u zelf beheert.
Dit betekent dat u wordt gefactureerd tegen de standaard cloudtarieven voor CPU en geheugen, zonder verborgen serverless-opslagen. Een inactieve WebSocket of een openstaande stream verbruikt nog steeds RAM op de node, maar die RAM is geprijsd tegen een fractie van wat een serverless GB-uur kost.
Aangezien u de Kubernetes-nodes beheert, bepaalt u zelf de timeouts en levensduur van functies. U kunt langlopende pods of jobs laten draaien voor minuten of uren, naargelang de behoefte. TrueFoundry legt geen limiet op van 5 of 15 minuten – dat bepaalt uw eigen infrastructuur.
Complexe agent-pipelines en onderzoekstaken draaien gewoon tot ze voltooid zijn (enkel onderhevig aan de normale maximale levensduur van een pod, indien ingesteld). Dit elimineert de bekende Vercel-frustratie van 504-fouten halverwege een stream. Als een AI-agent 20 minuten nodig heeft om af te ronden, kan dat op TrueFoundry; op Vercel zou deze na 5 minuten zijn mislukt.
Een belangrijk voordeel van TrueFoundry voor AI is de ingebouwde GPU-ondersteuning. Omdat het onder de motorkap Kubernetes is, kunt u GPU-nodepools koppelen en inference-workloads inplannen naast uw webdiensten. Dit betekent dat uw front-end API's en uw zware ML-inference in hetzelfde cluster kunnen draaien (wat latency en data-overdracht vermindert). De cloud-native architectuur van TrueFoundry "geeft ons expliciet toegang tot de verschillende hardware die door verschillende cloudproviders wordt aangeboden, vooral in het geval van GPU's".
In de praktijk betekent dit dat u LLM-inference of het genereren van embeddings kunt uitvoeren op door GPU's versnelde nodes zonder het platform te verlaten. Het is niet nodig om een afzonderlijke GPU-dienst te koppelen (en te betalen voor verkeer tussen regio's).
Vercel blijft een uitstekend platform voor frontend delivery. Maar zodra AI computes de backend vormen, veranderen de economische verhoudingen. De belangrijkste conclusie: voorkom dat u de op tijdsduur gebaseerde toeslag van Vercel betaalt voor zware AI-taken.
In tegenstelling tot eenvoudig HTTP-verkeer draaien AI-backends vaak veel langer per request en verplaatsen ze grote hoeveelheden data. Onder het Vercel AI pricing-model betekent dit dat u betaalt voor elke seconde compute en elke gigabyte aan uitgaand verkeer. Bij TrueFoundry betaalt u daarentegen voor ruwe nodes en seconden uptime – hetzelfde kostenmodel dat u zou zien als u een container op EC2 of GKE zou draaien.
Het eindresultaat is dat de schaalparameters voor kosten een stuk vloeiender verlopen. Teams merken dat hun maandelijkse uitgaven lineair meegroeien met de daadwerkelijk gebruikte compute, en niet met elke milliseconde aan functietijd. In veel gevallen kan wat op Vercel honderden per maand kostte, worden uitgevoerd voor tientallen op uw eigen cloud.
Als uw team te maken heeft met sterk stijgende Vercel-facturen of voortdurend kampt met timeouts, is het de moeite waard om een overstap van infrastructuur te overwegen. TrueFoundry is ontworpen om u de productiviteit van serverless te laten behouden (eenvoudige deployments, scaling) terwijl de nadelen ervan worden weggenomen.
Een snelle demo kan laten zien hoe het verplaatsen van uw AI workload naar TrueFoundry de kosten drastisch kan verlagen zonder dat dit ten koste gaat van de snelheid.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Vercel AI Gateway provides a unified interface for accessing multiple AI models through one API. It supports model selection, usage monitoring, and provider management, helping developers integrate LLMs without building separate integrations for every provider.
Vercel AI Gateway offers access without a separate gateway subscription fee. Model usage is billed according to the applicable provider rates and billing options. Function compute, bandwidth, and other Vercel platform charges are separate.
Vercel’s Hobby plan is free for personal projects. Pro starts at $20 per month, plus additional developer seats and usage charges where applicable. Enterprise pricing is custom. Your total cost depends on team size, compute, bandwidth, and other resources.
The $20 Vercel plan refers to Pro, which starts at $20 per month and includes team collaboration features and usage allowances. Additional developer seats and usage beyond included credits may increase your bill, depending on your deployment and resource consumption.
Yes. Vercel AI Gateway lets you access models from multiple providers through a unified API. This simplifies switching between models and managing usage. Availability, capabilities, and pricing depend on the selected model and provider.
Vercel AI workloads are subject to function-duration, memory, concurrency, and data-transfer limits. Fluid Compute changes how CPU and memory are billed. Vercel is not a general-purpose GPU hosting platform, so GPU-heavy inference typically requires external infrastructure.
Pro suits professional teams that need collaboration features and usage-based scaling. Enterprise targets organizations requiring advanced security, support, and contractual service commitments. Pricing is custom for Enterprise, so compare the specific features and usage terms in your proposal.



Het laatste nieuws, artikelen en bronnen in je inbox



















