



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
TL;DR TrueFoundry en Seldon komen samen in één platform. Seldon’s real-time ML serving sluit zich aan bij TrueFoundry’s AI Deploy en AI Gateway, wat enterprise-organisaties één enkel control plane biedt voor zowel klassieke ML als agents. Uw productie-modellen blijven draaien op dezelfde Kubernetes die u vandaag gebruikt, en u krijgt een helder pad naar LLM's en AI agents daarbovenop.
De meeste enterprise AI-teams werken nu aan weerszijden van één grens. Ze draaien klassieke ML-modellen in productie voor zaken als fraudescoring, churnvoorspelling en aanbevelingen. Tegelijkertijd bouwen ze agentic applicaties die redeneren, tools aanroepen en zelfstandig handelen. Die twee werelden bewogen vroeger op verschillende snelheden. Dat is niet langer zo. Beide worden tegelijkertijd bedrijfskritisch, en het beheren van twee afzonderlijke stacks, met twee leveranciers en twee governance-modellen, wordt snel duur en kwetsbaar.
Dat is het gat dat TrueFoundry en Seldon samen dichten. Seldon heeft meer dan tien jaar besteed aan het perfectioneren van real-time ML serving voor enkele van de meest veeleisende enterprise-organisaties ter wereld. TrueFoundry heeft het control plane gebouwd rond moderne AI, met deployment, een AI Gateway en governance voor LLM's en agents. We husselen de twee samen tot één platform, zodat teams één centrale plek krijgen om voorspellende modellen en agents te draaien op het Kubernetes-fundament dat ze al vertrouwen.
Deze fusie werkt omdat geen van beide kanten zijn ontwerp hoeft op te geven. Seldon en TrueFoundry maakten jaren geleden dezelfde architecturale keuze. Beide draaien als een control plane op de eigen Kubernetes van de klant, binnen hun VPC, on-prem, of air-gapped. Beide zijn cloud-agnostisch. Beide leunen op dezelfde standaardcomponenten voor verkeer, autoscaling en telemetrie, en beide geven een team een eigen namespace in plaats van te vragen om cluster-brede admin-rechten.
Seldon nam dat gedeelde fundament en ging diep in op één laag: het op schaal in real-time serven van klassieke ML. Wij namen hetzelfde fundament en gingen in de breedte, van deployment tot en met een gateway die modellen, agents en tools beheert. De twee platforms lagen dus nooit op een botsingskoers. Ze losten naburige onderdelen van hetzelfde probleem op, op dezelfde manier. Ze samenbrengen verbindt simpelweg twee lagen die toch al dezelfde taal spreken.
Seldon is al meer dan een decennium de ruggengraat voor real-time ML inference bij banken, telecombedrijven, verzekeraars, retailers en gezondheidszorgorganisaties. Die reputatie komt voort uit het diep ingaan op de moeilijkste onderdelen van productie ML serving:
Samen vormt dat een volwassen serving- en monitoringlaag met diepe wortels in gereguleerde omgevingen met lage latency, het soort waar een slechte voorspelling binnen enkele minuten verandert in een probleem voor de klant.
TrueFoundry heeft het control plane rondom het model gebouwd, de lagen die van een geservd model een beheerde, kostenbewuste en agent-ready applicatie maken:
Onze klanten draaien al bedrijfskritische AI via de Gateway op een schaal van meer dan een biljoen tokens per dag.
Hier is het gedeelte dat er echt toe doet. Wanneer Seldon’s servinglaag en TrueFoundry’s deploy- en gatewaylagen samenkomen, krijgt een enterprise-organisatie één control plane dat beide helften van haar AI afdekt.
Deploy draait de workloads. De Gateway beheert en routeert ze. Uw klassieke ML-modellen en uw agents bevinden zich op dezelfde Kubernetes, onder één set toegangscontroles, één observability-stack en één kostenoverzicht. Een enkel verzoek kan een fraudemodel, een LLM en een agent die een tool aanroept treffen, en elke stap wordt op dezelfde manier gelogd en beheerd.
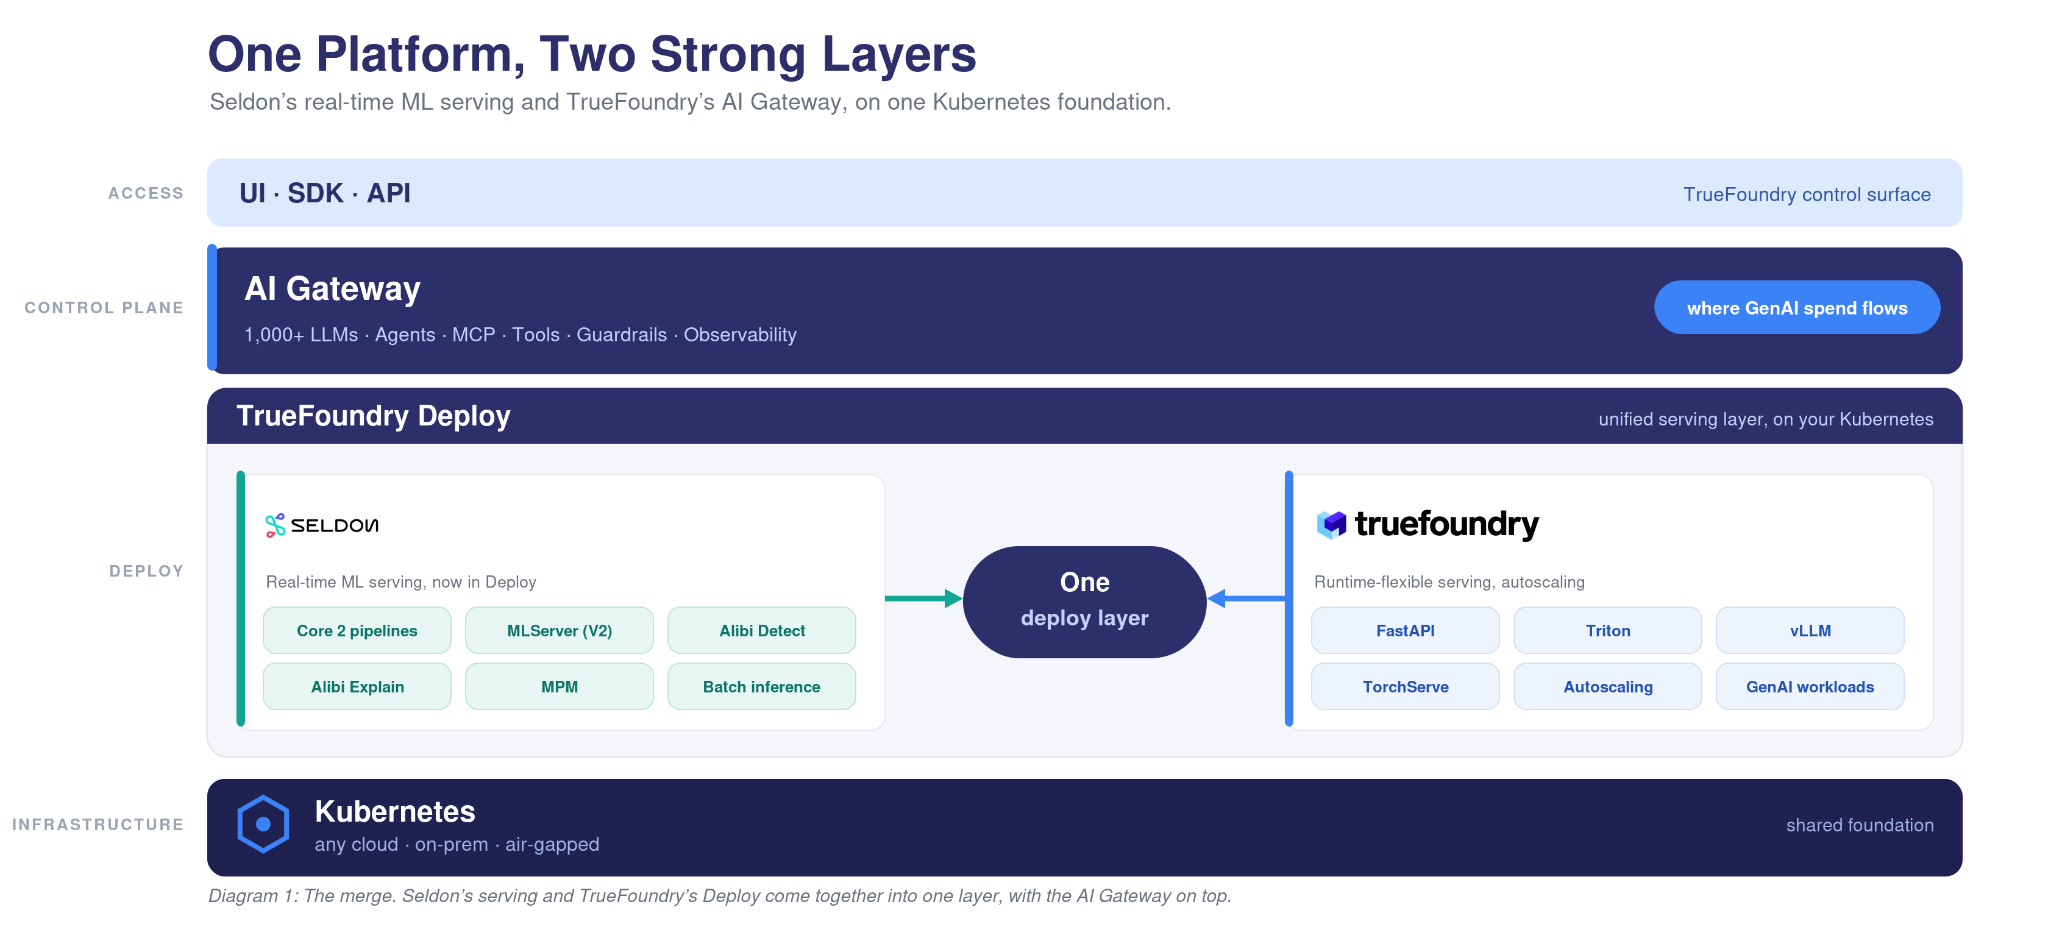
Het helpt om te kijken waar het geld naartoe beweegt. Voorspellende ML is voor het grootste deel gebouwd en draait gestaag. De nieuwe investeringen in enterprise AI gaan naar LLM's en agents, en die uitgaven stromen via de Gateway. Elke modelaanroep, elke agent-stap, elke tool-aanroep gaat er doorheen, wat de reden is waarom onze klanten er al meer dan een biljoen tokens per dag doorheen sturen.
Het gecombineerde platform doet dus twee nuttige dingen tegelijk. Het houdt de ML die u al gebouwd heeft draaiende, zonder onderbreking. En het plaatst u op het fundament waar de volgende golf van AI-uitgaven landt, zonder dat u een afzonderlijk platform hoeft op te zetten om daar te komen.
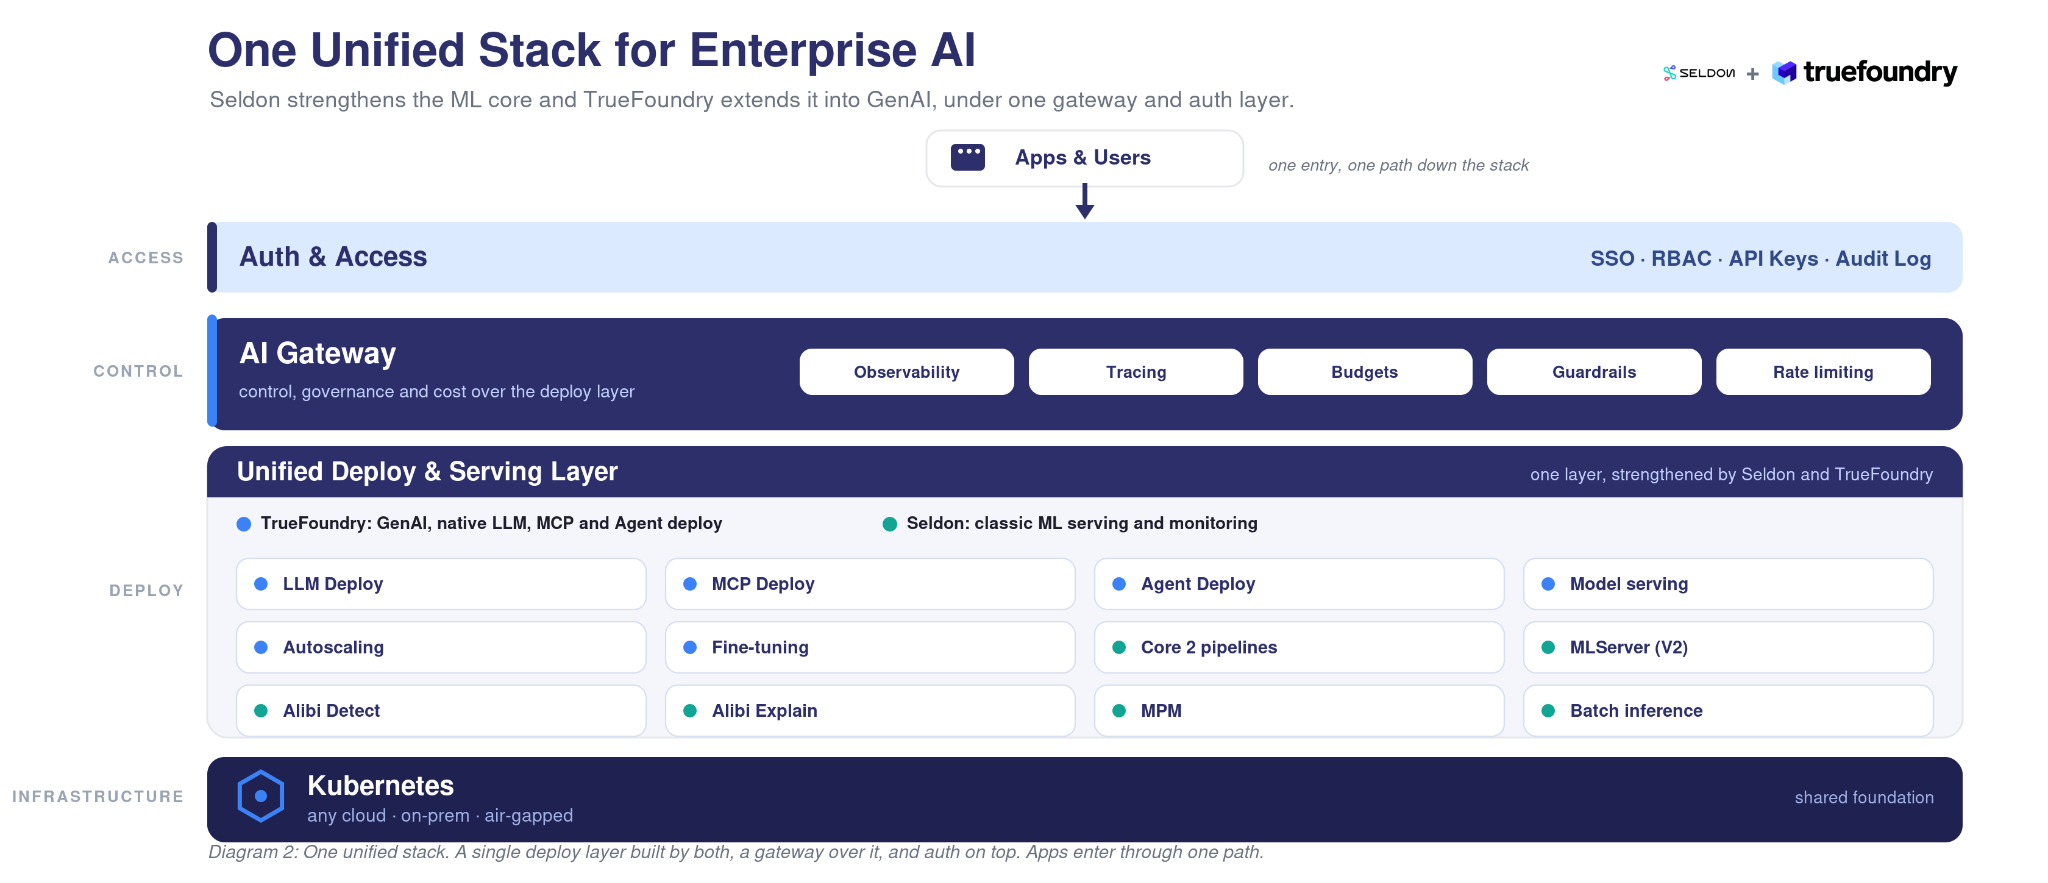
Als u vandaag Seldon gebruikt, blijft uw real-time ML draaien op de Kubernetes die u al beheert. Modellen die via het V2-protocol worden geservd blijven overdraagbaar, en Core 2 pipelines worden toegewezen aan Deploy’s eigen primitieven in plaats van te worden herschreven. Daarbovenop krijgt u de AI Gateway en de agentlaag zonder iets nieuws op te hoeven tuigen.
Als u vandaag TrueFoundry gebruikt, verandert er niets in uw stack, en Deploy wordt sterker. Het neemt Seldon’s serving- en monitoring-historie over, inclusief drift- en outlier-detectie, modelverklaringen en prestatie-monitoring die rechtstreeks overvloeien in het platform dat u al gebruikt.
Voor beiden geldt: het is één stack in plaats van twee. Één plek om een model te deployen, een aanroep te routen, te letten op drift, een agent te beheren en verantwoording af te leggen over de kosten, over klassieke ML en GenAI heen, op de infrastructuur die u al draait.
Enterprise-organisaties zouden niet één platform hoeven te draaien voor hun modellen en een ander voor hun agents. Met TrueFoundry en Seldon samen hoeft dat ook niet. Seldon’s real-time ML serving en TrueFoundry’s AI Gateway bevinden zich nu op één control plane voor enterprise AI, op de Kubernetes die u al draait. Uw productie-ML blijft doordraaien, en het pad naar agents en LLM's ligt er direct bovenop.
Ontdek hoe TrueFoundry’s AI Gateway ML en agents verenigt → Verken de AI Gateway
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It is a single layer that lets a company deploy, run, observe, and govern all of its AI in one place, from classic ML models to LLMs and agents. Instead of a different tool for each workload, you get one control point for deployment, access, guardrails, cost, and monitoring, running on infrastructure you control.
Yes. Your models keep running on the same Kubernetes you use today, on TrueFoundry’s AI Deploy together with Seldon’s serving layer. Models served over the V2 Open Inference Protocol stay portable, and there is nothing to rip out.
Generative AI native path forward. Your real-time ML keeps running as it does now, and you gain the AI Gateway and the agent layer on the same foundation, so you can add LLMs and agents whenever you are ready.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, hybrid, or across multiple clouds, and no data leaves your domain. This is the main reason regulated enterprises pick it over SaaS-only gateways.
More than 1,000, through a single OpenAI-compatible API. You switch models by changing the model name in the request, while keeping the URL and credentials the same.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP en Agents Register met toegangscontrole op toolniveau, zodat agents van LangGraph, CrewAI, AutoGen, of een aangepast framework centraal kunnen worden gereguleerd.



Het laatste nieuws, artikelen en bronnen in je inbox



















